Как пользоваться Claude Sonnet 5.5: настройка, сценарии и API
Как пользоваться Claude Sonnet 5.5: настройка уровня effort, 7 практических сценариев, цены API, миграция кода и проверка результатов без лишнего риска.

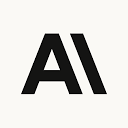


Если вы разбираетесь, как пользоваться Claude Sonnet 5.5, начните с одной ограниченной задачи, которую легко проверить, и уровня effort Medium: например, с краткого резюме тикета поддержки или клиентского брифа. В моем локальном синтетическом тесте на обращении в поддержку модель ответила за 2.82 секунды, использовала 194 входных и 291 выходной токен, а запрос обошелся в $0.003298. Она сохранила ключевые факты из тикета, но добавила правдоподобные предположения о способе устранения проблемы, которых в источнике не было. Практический вывод таков: Sonnet 5.5 позволяет получать черновики предельно дешево, однако проверка по-прежнему остается частью работы.
Как пользоваться Claude Sonnet 5.5: начните с одной задачи на Medium
Быстрее всего начать в приложении Claude. Выберите Sonnet 5.5, убедитесь, что установлен уровень Medium, передайте модели один комплект исходных материалов и запросите результат, который можно проверить строка за строкой.
В приложениях Anthropic и Claude Code уровень Medium задан по умолчанию. В Claude Platform по умолчанию используется High, поэтому при работе через API уровень стоит указывать явно. Medium подходит для первого теста на резюме обращений, клиентских брифах, регулярной аналитике и четко поставленных задачах с инструментами: обратная связь остается быстрой, но модель не ограничена самым низким уровнем.
Выберите Sonnet 5.5
Откройте новый чат в Claude. Нажмите на название модели рядом с кнопкой отправки, выберите Sonnet 5.5, затем откройте меню Effort. Если модели нет в первом списке, нажмите More models. Администраторы Enterprise могут ограничивать доступные модели и уровни effort.
Первый запуск — на Medium
Для ограниченной бизнес-задачи оставьте Medium. Переходите на High, только если требуется более глубокая оценка, длинная цепочка действий или более строгая проверка. Low имеет смысл после того, как собственные тесты подтвердят приемлемое качество.
Дайте источник и задайте формат
Вставьте один тикет, расшифровку звонка или набор документов. Укажите читателя и обязательные поля. Для обращения в поддержку запросите ровно четыре пункта: проблема, влияние, подтверждения и следующее действие. Добавьте: «Не придумывай факты. Отмечай каждый вывод, сделанный по косвенным данным».
Сверьте утверждения с источником
Сопоставьте с исходными данными каждое имя, число, причину, обязательство и рекомендуемое действие. Удаляйте неподтвержденные советы, даже если они звучат разумно. Сохраняйте промпт только после такой проверки на нескольких примерах из собственного рабочего процесса.
В синтетическом тикете из моего теста шесть операторов поддержки потеряли доступ после смены домена входа, двое оставались в системе, появлялась ошибка «Invalid organization», а в записях пользователей уже был указан новый домен. Sonnet 5.5 сохранила эти детали и соблюла формат из четырех пунктов. Но модель также предположила, что привязка организации, вероятно, все еще указывает на старый домен, и назвала один вариант исправления менее затрагивающим рабочий процесс. Ни того ни другого в тикете не было.
Расчет стоимости самого запроса прост. По опубликованному тарифу Anthropic 194 входных токена стоят $0.000388, а 291 выходной токен — $0.00291; итого $0.003298. Если бы 10,000 вызовов имели точно такой же объем токенов, расходы только на модель составили бы $32.98. Но это не стоимость 10,000 решенных обращений: вокруг вызова модели остаются поиск данных, интеграции, повторные попытки, хранение, мониторинг и ручная проверка.
Что представляет собой Claude Sonnet 5.5
Sonnet 5.5 — быстрая универсальная модель в семействе Anthropic 5.5. Ее удобно считать основной моделью для четко поставленной работы, тогда как Opus 5.5 — старший специалист для открытых задач, где особенно важна взвешенная оценка.
Это отдельный релиз, а не Sonnet 5. Прямой идентификатор в Claude API — claude-sonnet-5-5, без суффикса с датой. Модель принимает текст и изображения, возвращает текст, имеет контекстное окно на 1 млн токенов и может выдавать до 128,000 токенов. Если нужны цены и особенности токенизатора предыдущей модели, они отдельно разобраны в обзоре Claude Sonnet 5.
По данным Anthropic, Sonnet 5.5 генерирует ответ более чем на 30% быстрее Sonnet 5, а стоимость выполненной задачи в тестах компании может быть до 30% ниже. Второе утверждение связано с меньшим числом токенов на выполнение работы, а не со снижением тарифа за токен. Ставки остались такими же, как у Sonnet 5.
Результаты бенчмарков также приводит Anthropic: 70.6% у Sonnet 5.5 против 10.3% у Sonnet 5 в Terminal-Bench 4.0 и 55.5% против 34.1% в CursorBench 4.0. Эти цифры дают повод протестировать новую модель, но не отвечают на вопрос, пройдет ли проверку ваша политика обработки тикетов, кодовая база или шаблон документа. В отчете Anthropic о запуске проводится то же различие между результатами бенчмарков и устойчивым качеством суждений в открытых задачах.
Выбирайте effort по цене ошибки
Уровень effort управляет качеством, задержкой и расходом токенов, а не длиной текста. Более высокий уровень дает модели больше пространства для рассуждений и самопроверки, но может увеличить время ожидания и счет. Если нужен краткий ответ, укажите это в промпте отдельно.
Anthropic заново откалибровала эти уровни для Sonnet 5.5, поэтому Medium в новой модели не означает тот же объем рассуждений, что Medium в Sonnet 5. Проведите новую серию тестов на собственных примерах. Не переносите настройку автоматически только из-за совпадающего названия.
Семь полезных сценариев с наибольшей отдачей в ближайшей перспективе
Лучше всего работают сценарии с тремя свойствами: исходные данные доступны, у результата есть четкий формат, а человек или правило может его проверить.
1. Сортировка обращений в поддержку
Руководитель службы поддержки может объединить сообщение клиента, состояние аккаунта, недавнюю историю обращений и правила эскалации. Sonnet 5.5 вернет проблему, влияние, подтверждения, недостающие факты и следующее разрешенное действие. Польза — меньше повторного чтения перед маршрутизацией или передачей обращения. Советы, меняющие состояние аккаунта, возвраты, обещания и выводы о первопричине по-прежнему должен проверять человек.
Это лучший первый сценарий: каждое утверждение в результате можно привязать к конкретному полю источника. Ошибки модели тоже проявляются быстро. Если из резюме непонятно, откуда взялось утверждение, оно еще не готово запускать действие.
2. Клиентские брифы перед звонком
Руководитель по работе с клиентом может передать последнюю расшифровку звонка, техническое задание, открытые задачи и заметки о продлении. Запросите одностраничный документ с решениями, обязательствами, рисками, открытыми вопросами и повесткой следующей встречи. Вместо чистого листа перед каждым звонком команда получает повторяемый формат подготовки.
Разносите «подтверждено» и «предположительно» по отдельным разделам. Одно это различие не дает правдоподобной интерпретации модели превратиться в обязательство перед клиентом.
3. Проверка pull request
Технический руководитель может передать модели diff кода, правила репозитория и чек-лист по безопасности, тестам и обратной совместимости. Sonnet 5.5 подготовит первичный разбор с приоритетами по риску и предложит тесты. Выигрыш — в том, что ревьюер быстрее входит в контекст, а не в автоматическом одобрении. Решение о слиянии все равно должен принимать человек, отвечающий за систему.
4. Исправление ограниченных по масштабу ошибок
Разработчик с воспроизводимой ошибкой может предоставить неверное поведение, нужные файлы и критерии приемки. Для хорошо описанного исправления разумно начать с Medium. Переходите на High, если проблема затрагивает несколько сервисов или первый запуск пропускает проверку. Цикл реализации и тестирования становится короче, а критерии приемки не дают задаче бесконтрольно разрастись.
5. Операционные обзоры и черновики для совета директоров
Финансовая или операционная команда может передать исходные материалы вместе с утвержденным шаблоном презентации или документа. Sonnet 5.5 подготовит структурированный обзор, укажет на пробелы и оформит первый вариант. Anthropic отдельно позиционирует модель для качественных документов, слайдов и таблиц. Сборка занимает меньше времени, но каждое финансовое утверждение все равно должно ссылаться на исходную ячейку или документ.
6. Резюме инцидентов
Руководитель инцидента может загрузить хронологию, оповещения, выполненные действия и заметки ответственных. Попросите разнести подтвержденные события, гипотезы, влияние на клиентов, нерешенные вопросы и дальнейшие действия по отдельным блокам. Это дает более ясную передачу контекста и черновик разбора инцидента. Не позволяйте модели выдавать корреляцию за первопричину.
7. Визуальный контроль качества и доработка интерфейса
Продуктовый дизайнер или фронтенд-разработчик может передать скриншот, правила бренда и чек-лист приемки. Sonnet 5.5 найдет несоответствия, расставит приоритеты исправлений и поможет выполнить ограниченный этап доработки. Видимые дефекты устраняются быстрее, но вкус, проверка доступности и окончательное продуктовое решение остаются за человеком.
Три продукта, которые стоит создать
Сам по себе доступ к модели — еще не бизнес. Коммерческий продукт добавляет собственный контекст, управляемый процесс, доказательства и точку, где окончательное решение принимает человек.
1. Сортировка обращений со ссылками на источники — самая сильная возможность
Создайте помощника поддержки, который превращает тикет и данные аккаунта в структурированное резюме, прикладывает ссылку на источник к каждому утверждению, проверяет предложенное действие по правилам и отправляет черновик на одобрение. Руководители служб поддержки и подрядчики готовы платить за более быструю и единообразную маршрутизацию.
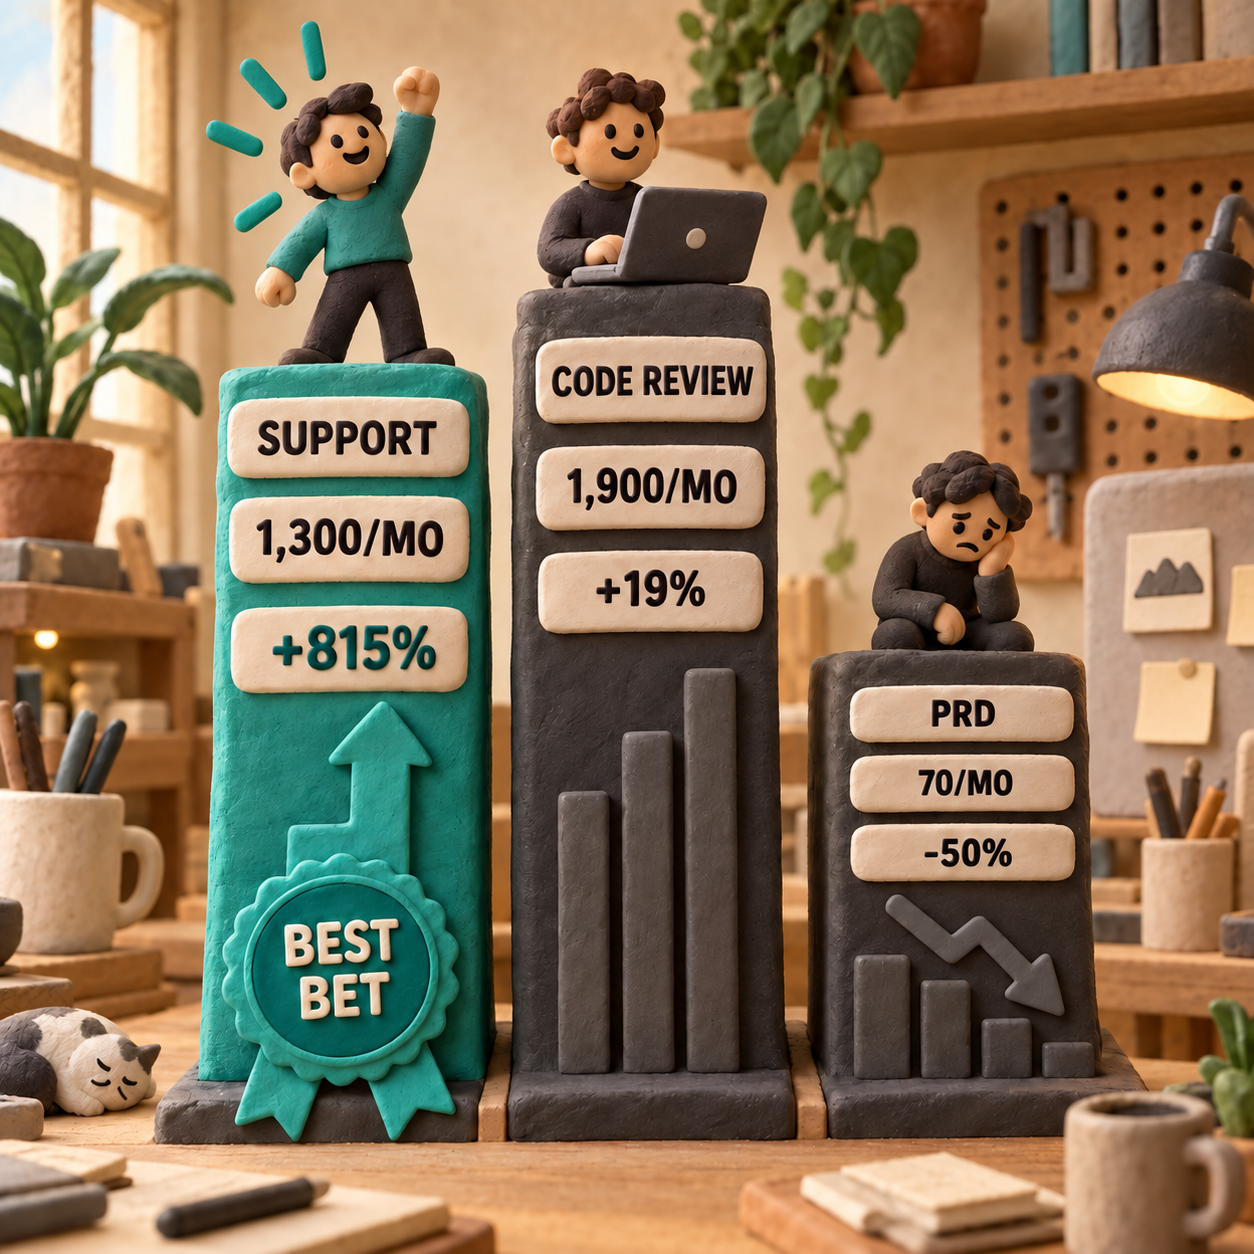
Спрос уже заметен: запрос ai customer service agent в данных этого исследования набирает 1,300 поисков в США в месяц, имеет коммерческий интент и вырос на 815% за год. Intercom оценивает Fin в $0.99 за результат. Сравнивать это напрямую с вызовом для составления резюме нельзя: решенный запрос — более крупная работа. Но цифра показывает, что покупатели уже принимают оплату автоматизации поддержки по факту использования.
Минимальная продаваемая версия требует одного коннектора к входящим сообщениям, одного коннектора к данным аккаунта, резюме из четырех полей, ссылок на источники, проверки по правилам и кнопок одобрения или отклонения. Главная сложность — интеграция и доверие. Если нельзя доказать происхождение рекомендации, клиент сохранит существующий процесс.
2. Слой проверки кода с учетом внутренних правил
Создайте приложение для GitHub, которое читает diff и правила конкретной команды, а затем выдает ревью с приоритетами по риску, пробелы в тестах и короткое резюме для слияния. Покупатели такого продукта — руководители разработки и платформенные команды.
Запрос ai powered code review platform набирает 1,900 поисков в США в месяц и вырос на 19% за год. Публичный тариф CodeRabbit начинается с $24 за разработчика в месяц при годовой оплате; более дорогие планы стоят $48 и $72. Для MVP достаточно одного провайдера репозиториев, вебхуков pull request, настраиваемых проверок, интерфейса комментариев и журнала, где видно, какое правило вызвало каждое замечание.
Главная проблема — плотная конкуренция. У универсального ревьюера нет защищаемого преимущества. Выберите болезненную нишу: например, проверки релизов в регулируемой отрасли, безопасность миграции данных или конкретный фреймворк. Ложные срабатывания измеряйте так же внимательно, как пропущенные дефекты.
3. Вертикальный инструмент из брифа в PRD, но не универсальный
Создайте узкий процесс, который превращает звонки, ограничения и прошлые решения в продуктовый бриф с критериями приемки и нерешенными вопросами. Продуктовое агентство или команда отраслевого ПО может купить его, если шаблон соответствует их работе.
Точный запрос ai product requirements document generator набирает лишь 70 поисков в США в месяц и снизился на 50% год к году. Это предупреждение, а не аргумент в пользу идеи. Универсальный отдельный генератор PRD — самый слабый продукт из трех. Жизнеспособен вариант, встроенный в более ценный процесс: например, первичное исследование в агентстве, внедрение в здравоохранении или управление изменениями в крупной компании.
MVP включает фиксированный пакет источников, один четко заданный шаблон, прослеживаемость решений и экспорт в систему, которой уже пользуется покупатель. Ограничения — слабый спрос и простота копирования. Не стоит создавать такой продукт без существующих отношений с клиентами или доступа к отраслевому каналу данных.
Цена не изменилась, но рабочий процесс может подешеветь
Sonnet 5.5 стоит $2 за миллион входных токенов, $10 за миллион выходных и $0.20 за миллион токенов, прочитанных из кэша. Это те же опубликованные ставки, что и у Sonnet 5. Заявление Anthropic о снижении стоимости связано с выполнением задач за меньшее число токенов.
Для прогноза это важное различие. Более короткая цепочка модели способна одновременно сократить задержку и расход токенов, хотя тариф не менялся. При этом общая стоимость продукта может почти не снизиться, если основная доля приходится на поиск данных, сторонние инструменты, повторные попытки и ручную проверку. Измеряйте стоимость принятого результата, а не одного вызова.
Подписка на приложение Claude и использование API — разные продукты. Оплата Pro, Max, Team или Enterprise не включает Claude Console и вызовы API. Общие границы тарифов разобраны в руководстве по планам Claude; для рабочего процесса через API отдельно нужны доступ к Console и оплата по счетчику.
Переносите процесс на API после того, как задача пройдет проверку
Безопасная последовательность миграции проста: проверьте промпт на репрезентативных примерах, закрепите новый идентификатор модели, явно задайте effort, затем исправьте контракт рассуждений и вызова инструментов — и лишь после этого направляйте производственный трафик.
Для обычного запроса с адаптивным рассуждением не передавайте поле thinking, а текстовые блоки читайте по их типу:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    output_config={"effort": "medium"},
    messages=[{
        "role": "user",
        "content": "Summarize this ticket as Issue, Impact, Evidence, and Next action.",
    }],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
При миграции нужно отдельно проверить четыре изменения.
thinking: {"type": "disabled"}больше не принимается прямым Claude API от Anthropic. Если предварительное рассуждение не нужно, используйтеthinking: {"type": "between_tools"}. Этот режим работает с Low, Medium и High, но не с Xhigh или Max.- Принудительные значения
tool_choice—anyи именованныйtool— больше не принимаются прямым API. Используйтеauto, включайте строгую схему там, где она поддерживается, и указывайте в промпте, когда должен запускаться инструмент. - Ответ может начинаться с блока
thinking. Разбирайте каждый блок содержимого по полюtype; нельзя предполагать, чтоcontent[0].textсуществует. - В цикле с инструментами возвращайте блоки рассуждений без изменений. В них находятся подписи, связанные с предыдущей беседой, поэтому история сообщений должна только дополняться.
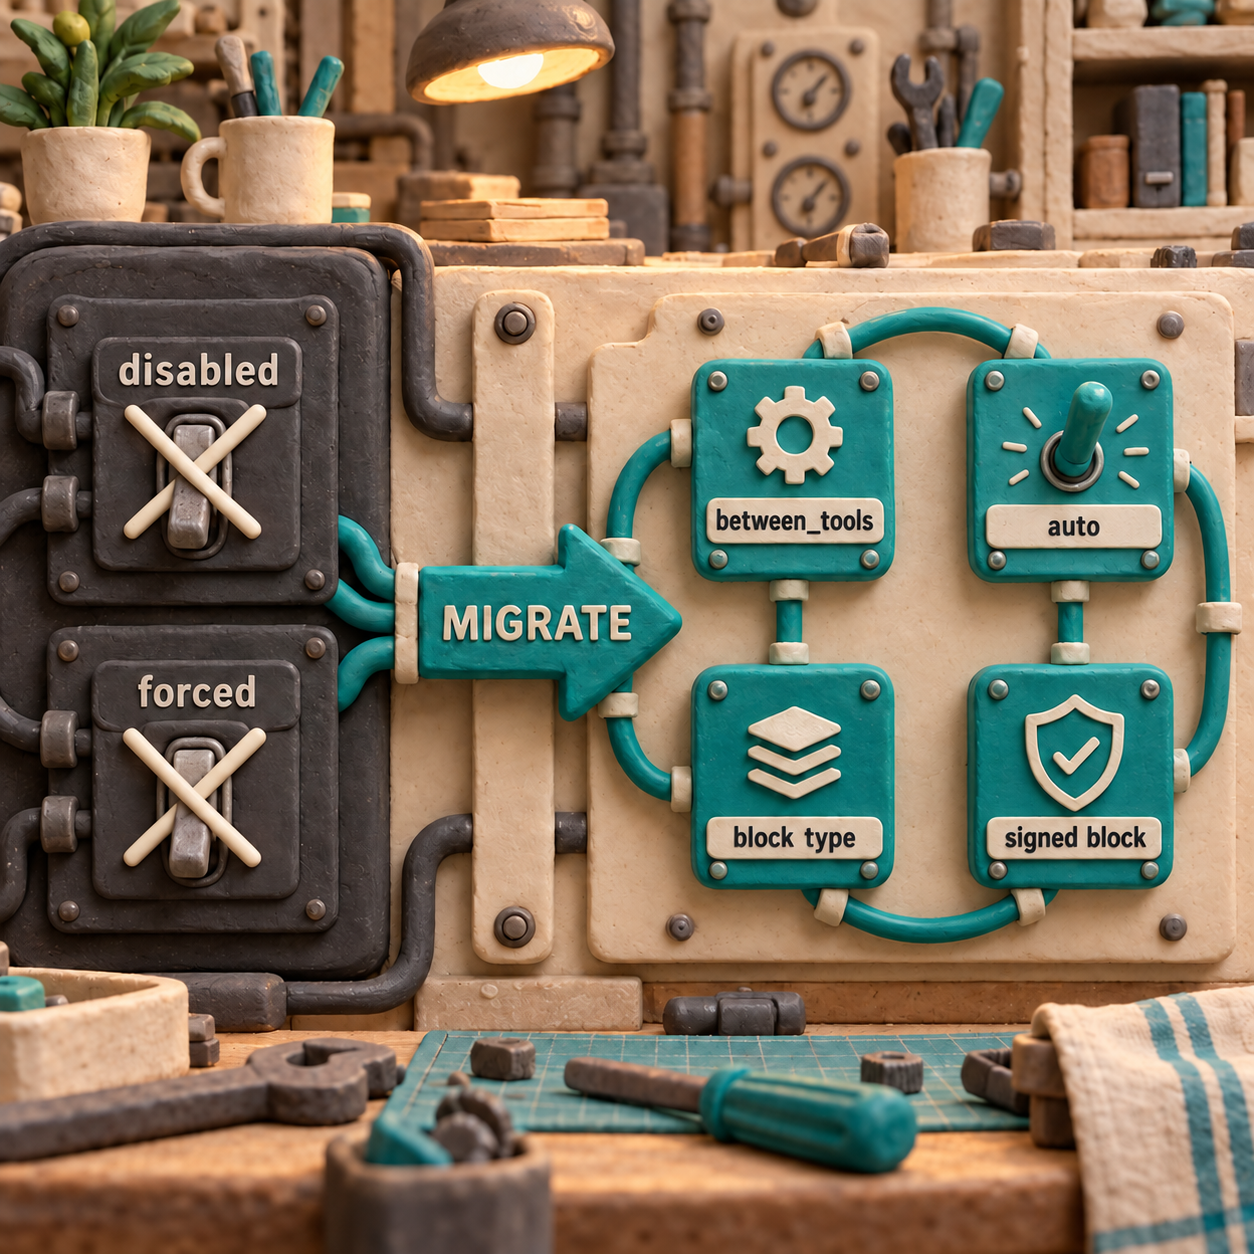
В этом минимальном примере используется between_tools, для выбора инструмента оставлен auto, а полный ответ ассистента сохраняется:
tools = [{
    "name": "lookup_ticket",
    "description": "Look up a support ticket",
    "strict": True,
    "input_schema": {
        "type": "object",
        "properties": {"ticket_id": {"type": "string"}},
        "required": ["ticket_id"],
        "additionalProperties": False,
    },
}]

messages = [{"role": "user", "content": "Use lookup_ticket for T-42."}]
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)

# Keep every block, including signed thinking blocks, exactly as returned.
messages.append({
    "role": "assistant",
    "content": [block.model_dump() for block in response.content],
})

tool_call = next(block for block in response.content if block.type == "tool_use")
messages.append({
    "role": "user",
    "content": [{
        "type": "tool_result",
        "tool_use_id": tool_call.id,
        "content": "Ticket T-42 is open and assigned to Support Ops.",
    }],
})

follow_up = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)
В руководстве Anthropic по миграции Sonnet 5.5 описаны ошибки 400 прямого API и новые поля. Мой локальный запрос с Medium и between_tools вернул HTTP 200 за 1.35 секунды. В отдельном цикле с адаптивным вызовом инструмента появился подписанный блок рассуждений, а повторная отправка полного блока без изменений успешно продолжила диалог.
Есть важный нюанс. Мои вызовы проходили через ИИ-шлюз. Этот слой совместимости вернул HTTP 200, когда я намеренно отправил старое значение disabled для thinking и принудительный tool_choice: any, хотя в документации Anthropic оба варианта приводят к ошибкам прямого API. То, что запрос принимает промежуточный слой, еще не доказывает совместимость прямой интеграции. Перед переходом изучите исходный запрос в Anthropic Playground или протестируйте прямой endpoint.
Чего Sonnet 5.5 не решает
Модель не превращает неподтвержденный вывод в факт. Локальный тест на обращении в поддержку показал это наглядно. Требуйте ссылки на источники для значимых утверждений и сохраняйте одобрение человеком для возвратов, изменений аккаунта, юридических обязательств, медицинских решений и действий в сфере безопасности.
Модель не делает Medium подходящим для любой задачи. Повышайте effort, когда на ваших примерах видны пропуски в рассуждениях или незавершенная работа. Для открытых задач, требующих устойчивого качества суждений, используйте Opus; место более высокого уровня объясняет сравнение с Opus 5.5.
Модель не превращает отдельный вызов в готовый продукт. Большая часть производственной работы приходится на коннекторы, разрешения, проверки политик, тестирование, наблюдаемость, резервное поведение и удобный интерфейс ревью.
Она также не отменяет необходимость в актуальных источниках. Если ответ по поддержке или исследованию зависит от действующих правил, требований или цен, дайте модели инструмент поиска или базу знаний и потребуйте провести проверку.
Что сделать в понедельник
Выберите одну очередь с однозначным источником истины. В понедельник возьмите 20 недавних примеров, удалите ненужные персональные данные и запустите Sonnet 5.5 на Medium с одной фиксированной схемой ответа. Оцените фактическую точность, неподтвержденные выводы, полноту, затраченное время и расход токенов. Меняйте идентификатор модели в существующем API и проводите описанные выше проверки миграции только после того, как промпт пройдет этот тест.
Как пользоваться Claude Sonnet?
В приложении Claude нажмите на название модели рядом с кнопкой отправки, выберите Sonnet 5.5, установите Medium и начните с одной ограниченной задачи, результат которой можно проверить. В Claude Code выполните /model и выберите Sonnet 5.5 либо запустите сеанс командой claude --model claude-sonnet-5-5.
Для каких задач лучше всего подходит Claude Sonnet 5?
Для текущего релиза Sonnet 5.5 начните с четко очерченной повседневной работы: подготовки резюме обращений и клиентских брифов, исправления ошибок, проверки кода и создания качественно оформленных деловых документов. Если задача открытая, а цена незаметной ошибки высока, используйте более высокий effort или Opus.
Можно ли пользоваться Claude Sonnet бесплатно?
Доступность и лимиты зависят от тарифа Claude и настроек организации. Доступ к приложению и оплата API разделены, поэтому платная подписка Claude не включает использование API. Актуальные границы тарифов приведены в руководстве по планам Claude выше.
Сколько стоит Claude Sonnet 5?
Claude Sonnet 5.5 стоит $2 за миллион входных токенов, $10 за миллион выходных и $0.20 за миллион токенов, прочитанных из кэша. По заявлению Anthropic, выполненная задача может стоить дешевле, чем в Sonnet 5, благодаря меньшему числу токенов, а не снижению этих ставок.
Если нужен рабочий процесс Claude, основанный на проверяемых источниках и адаптированный под ваш бизнес, изучите создание ИИ-систем для продакшена.
- Последнее обновление
- 28 сент. 2026 г.
- Категория
- AI
Сделать этот сайт предпочтительным в Google


Отметьте omidsaffari.com как предпочтительный источник — и Google будет поднимать его для вас в Top Stories, AI Overviews и AI Mode.

Jev или GLM-5.3-Flash: что выбрать для маршрутизации обращений
Jev или GLM-5.3-Flash: сравниваем цену, точность, задержку и работу с изображениями, чтобы выбрать маршрут для обращений с ИИ без лишних затрат.27 сент. 2026 г.AI
Claude Opus 5.5 vs Opus 5: цены, кодинг и миграция
Сравниваем Claude Opus 5.5 и Opus 5: цены, кодинг, thinking, изменения API и пять проверок, без которых нельзя безопасно перенести рабочие нагрузки.23 сент. 2026 г.AI
GPT-6 Sol или Luna: какую модель выбрать для работы
Сравниваем GPT-6 Sol и Luna по цене, возможностям и качеству кода. Разбираем, когда достаточно Luna, а когда переплата за Sol действительно оправдана.23 сент. 2026 г.AI
GPT-6 Luna бесплатно: где доступна и сколько стоит API
Разбираем, где GPT-6 Luna доступна бесплатно, какие тарифы нужны для Work и Codex, сколько стоит API и какие лимиты OpenAI пока не раскрыла.22 сент. 2026 г.AI
Как пользоваться MiMo V2.6: первый рабочий сценарий
Как пользоваться MiMo V2.6 в Studio и через API: выберите подходящий ключ и модель, запустите первую бизнес-задачу и сразу проверьте результат.22 сент. 2026 г.AI
MiMo V2.6 Pro vs Flash: когда стоит платить больше
Сравниваем MiMo V2.6 Pro vs Flash по цене, возможностям и тестам. Разбираем, когда брать Flash, а когда доплата за Pro действительно окупается.22 сент. 2026 г.AI
MiMo V2.6 бесплатно: доступ через OpenCode и цены API
Разбираем, где MiMo V2.6 доступна бесплатно, какие ограничения есть у OpenCode, сколько стоит Xiaomi API и во что обойдётся самостоятельный запуск.22 сент. 2026 г.AI