Jev или GLM-5.3-Flash: что выбрать для маршрутизации обращений
Jev или GLM-5.3-Flash: сравниваем цену, точность, задержку и работу с изображениями, чтобы выбрать маршрут для обращений с ИИ без лишних затрат.

- JJev
- PPrivatemode Decisions
- GGLM-5.3-Flash
- Lllama.cpp
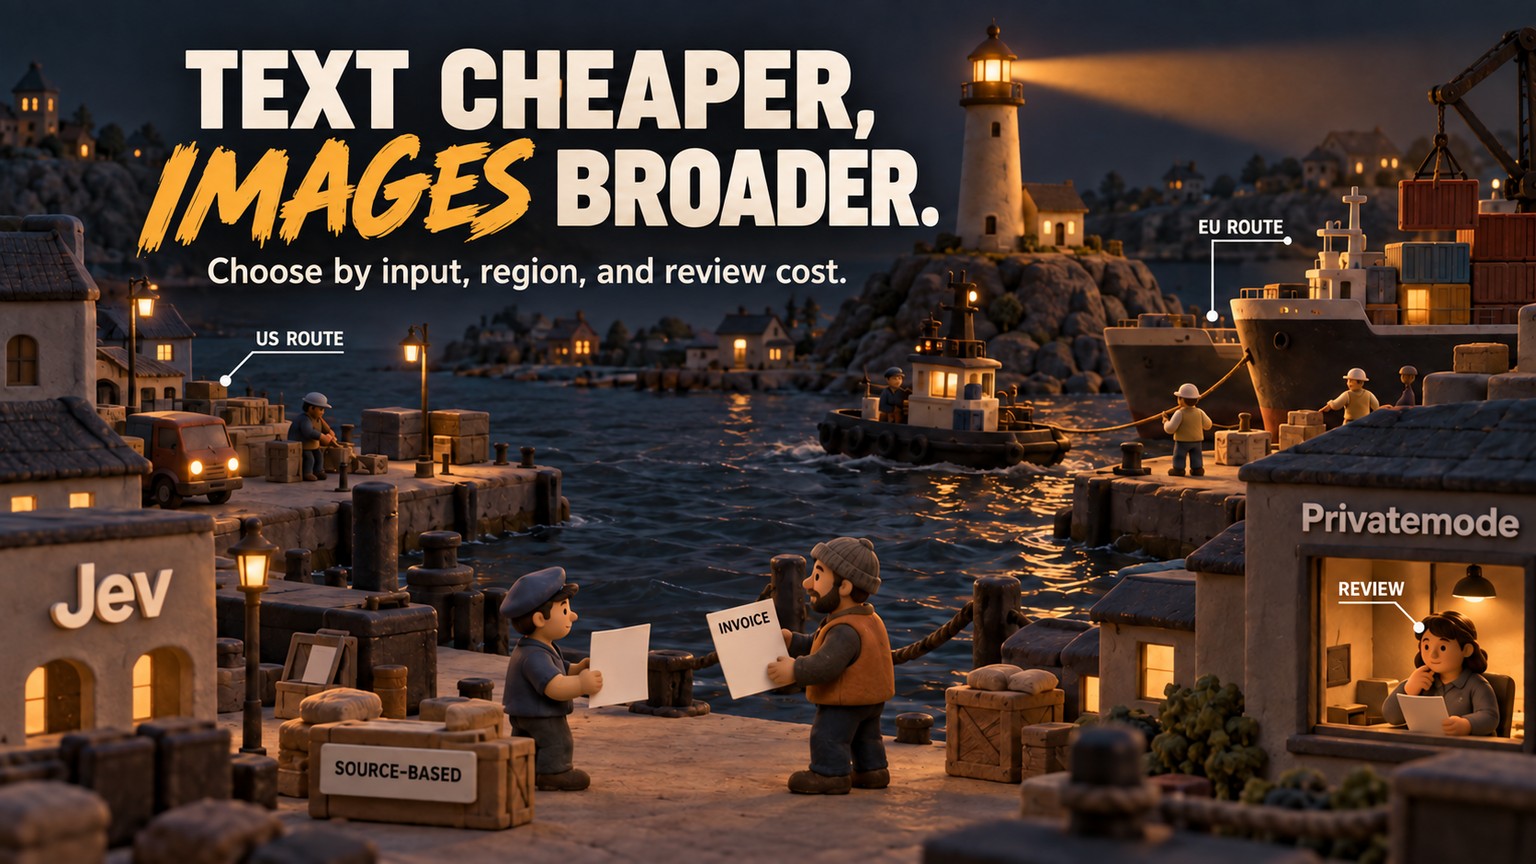
Jev или GLM-5.3-Flash — выбор зависит от задачи. Для массовой маршрутизации текста, где важна минимальная стоимость инференса, берите Jev. Если на решение влияют изображения, близость европейской инфраструктуры, конфиденциальная обработка или возможность сменить модель, лучше подходит GLM-5.3-Flash через Privatemode Decisions. При обращении на 500 токенов и четырех вариантах ответа текущие цены дают около $0.034 за 1,000 решений Jev против $0.146 для маршрута через Privatemode. Но достаточно одного скана счета, чтобы Jev выбыл без отдельного этапа OCR.
Что выбрать: Jev или GLM-5.3-Flash?
Jev стоит выбирать для массовой классификации только текстовых данных: направить обращение в нужную очередь, оценить выполнение условия политики или выбрать один ответ из заранее заданного набора. Низкая цена входных токенов делает его безусловным лидером по прямым затратам, а специализированный API сводит механику решения к простому примитиву.
GLM-5.3-Flash через Privatemode Decisions лучше подходит, если состояние может включать изображение, клиент находится ближе к европейскому сервису Privatemode, конфиденциальная обработка входит в требования закупки или той же библиотеке позже предстоит работать с другим сервером на базе vLLM. Каждое текстовое решение обойдется дороже, зато вы получаете мультимодальный ввод и более переносимую реализацию.
Для текстовой очереди в США разумнее по умолчанию выбрать Jev. Для очереди с изображениями в Германии — маршрут через Privatemode. Если ваша ситуация не похожа ни на одну из этих, таблицы функций недостаточно. Прогоните через обе системы один и тот же набор размеченных примеров и оцените стоимость ошибок и передачи человеку, а не только токенов.
Jev или GLM-5.3-Flash: что именно вы выбираете
Jev и GLM-5.3-Flash — не две взаимозаменяемые чат-модели. Jev — специализированная модель принятия решений. В API передаются состояние и типизированный вопрос, например Choice или Score, а в ответ приходят выбранный вариант, вероятности и показатель уверенности. Продукт создан для того узкого момента, когда программе нужно выбрать, а не вести диалог.
Privatemode Decisions — библиотечный слой над универсальной языковой моделью. Библиотека передает GLM-5.3-Flash именованные варианты, ограничивает следующий токен допустимыми индексами вариантов, считывает вероятности этих токенов и заново нормализует их. Один прямой проход и один выходной токен превращают универсальную мультимодальную модель в быстрый классификатор с жестко заданным выбором.
Из-за этого меняется и вопрос при покупке. Jev — готовый специализированный сервис. Privatemode Decisions — слой принятия решений вместе с моделью и API-эндпоинтом, который за ним стоит. Библиотека умеет обращаться к OpenAI-совместимому серверу vLLM, а собственный эндпоинт Privatemode работает в среде конфиденциальных вычислений. Переносимость дает библиотека; гарантии зашифрованной обработки Privatemode не переходят автоматически на произвольный сервер.
Есть и ловушка в названиях. Рассматриваемый здесь Jev Decisions API — не продукт Jev Router из OpenRouter. Второй выбирает модель для промпта. Если вы оцениваете именно его, смотрите отдельный разбор стоимости Jev Router. Если смешать эти продукты, сравнение цен и возможностей окажется полностью неверным.
Почему Jev выигрывает по цене маршрутизации текста
Для очереди обычных текстовых обращений Jev подходит лучше: его API изначально оперирует решениями. На текущей странице моделей TypeSafe для jev-1.13.0 указана цена $0.042 за миллион входных токенов, а выходные токены бесплатны. Сейчас псевдоним jev-latest указывает на эту версию; кроме того, ответ содержит версию в поле model, которую стоит сохранять в журнал тестирования.
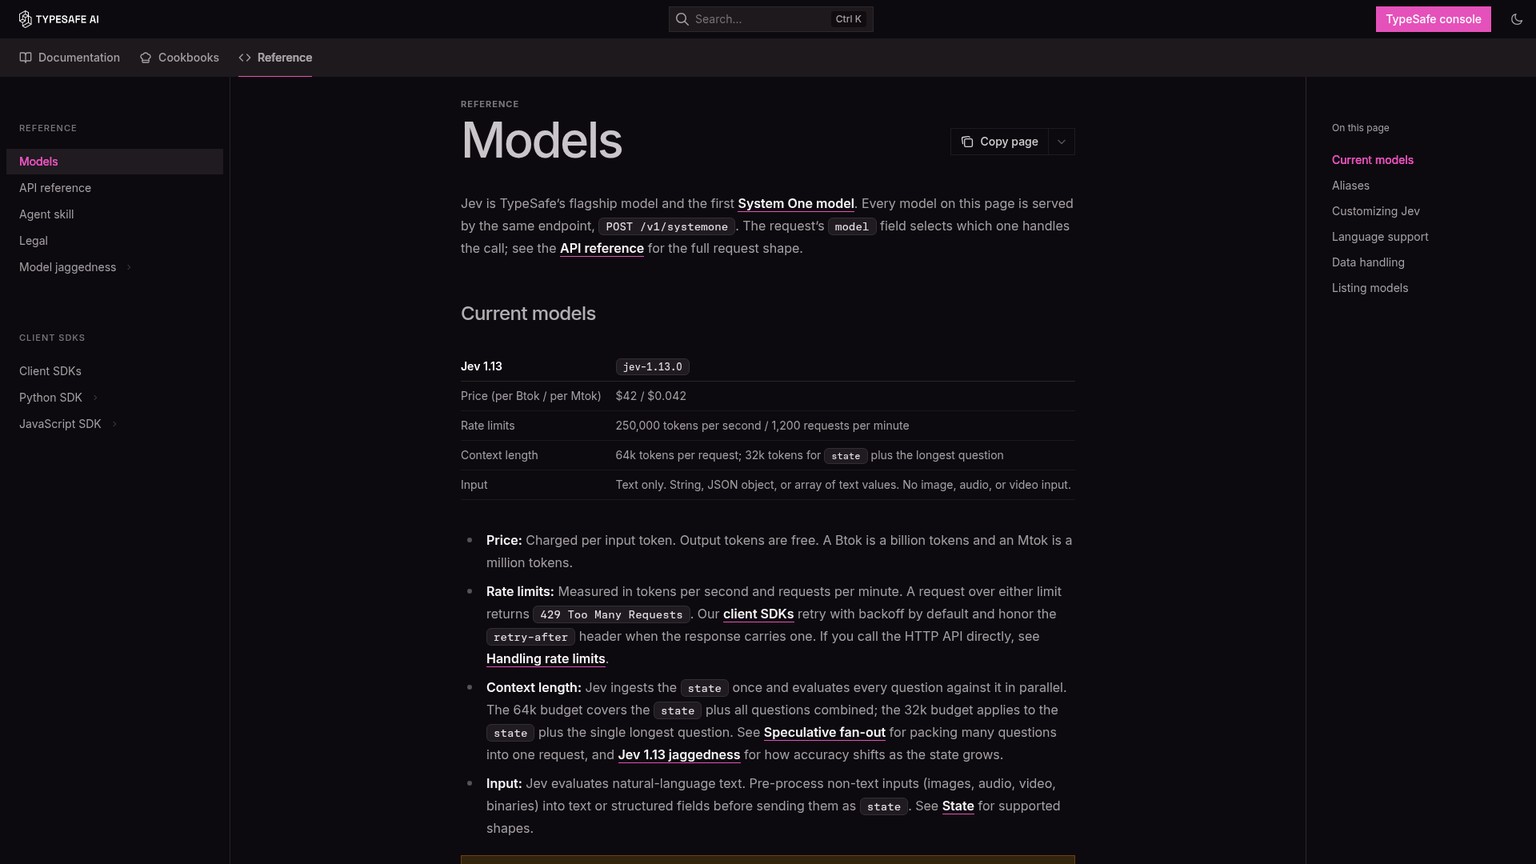
В обращении для маршрутизации само сообщение можно передать как состояние, а вариантами ответа сделать «оплату», «отмену», «ошибку» и «ни один из вариантов». Jev принимает строки и структурированный текст, включая JSON и массивы, но не изображения, аудио или видео. Один запрос ограничен 64,000 токенов, а состояние вместе с самым длинным вопросом — 32,000 токенов. Для маршрутизации обращений этого более чем достаточно, но прикрепленный скан от этого текстом не станет.
Преимущество здесь экономическое, а не магическое. По оценке поставщика, при формировании промпта решение с четырьмя вариантами добавляет примерно 270 постоянных токенов плюс еще 10 на каждый вариант. Вместе с обращением на 500 токенов получается 810 оплачиваемых входных токенов. При актуальной цене одно решение стоит $0.00003402.
Если Jev еще не используется в вашем стеке, настройка API разобрана в отдельной инструкции по маршрутизации обращений с Jev. Здесь сравнение начинается уже после настройки — с вопроса, достаточно ли вам узкого специалиста, работающего только с текстом.
Победитель категории: Jev для маршрутизации текстовых обращений и минимальной стоимости инференса.
Privatemode Decisions: GLM-5.3-Flash как модель принятия решений
Privatemode Decisions лучше соответствует задаче, когда в самом кейсе есть изображение или когда логика принятия решений должна переноситься между совместимыми серверами моделей. Первый коммит библиотеки появился 21 сентября 2026 года. В метаданных зафиксированной версии указаны 0.1.0, Python >=3.10 и ядро без зависимостей.
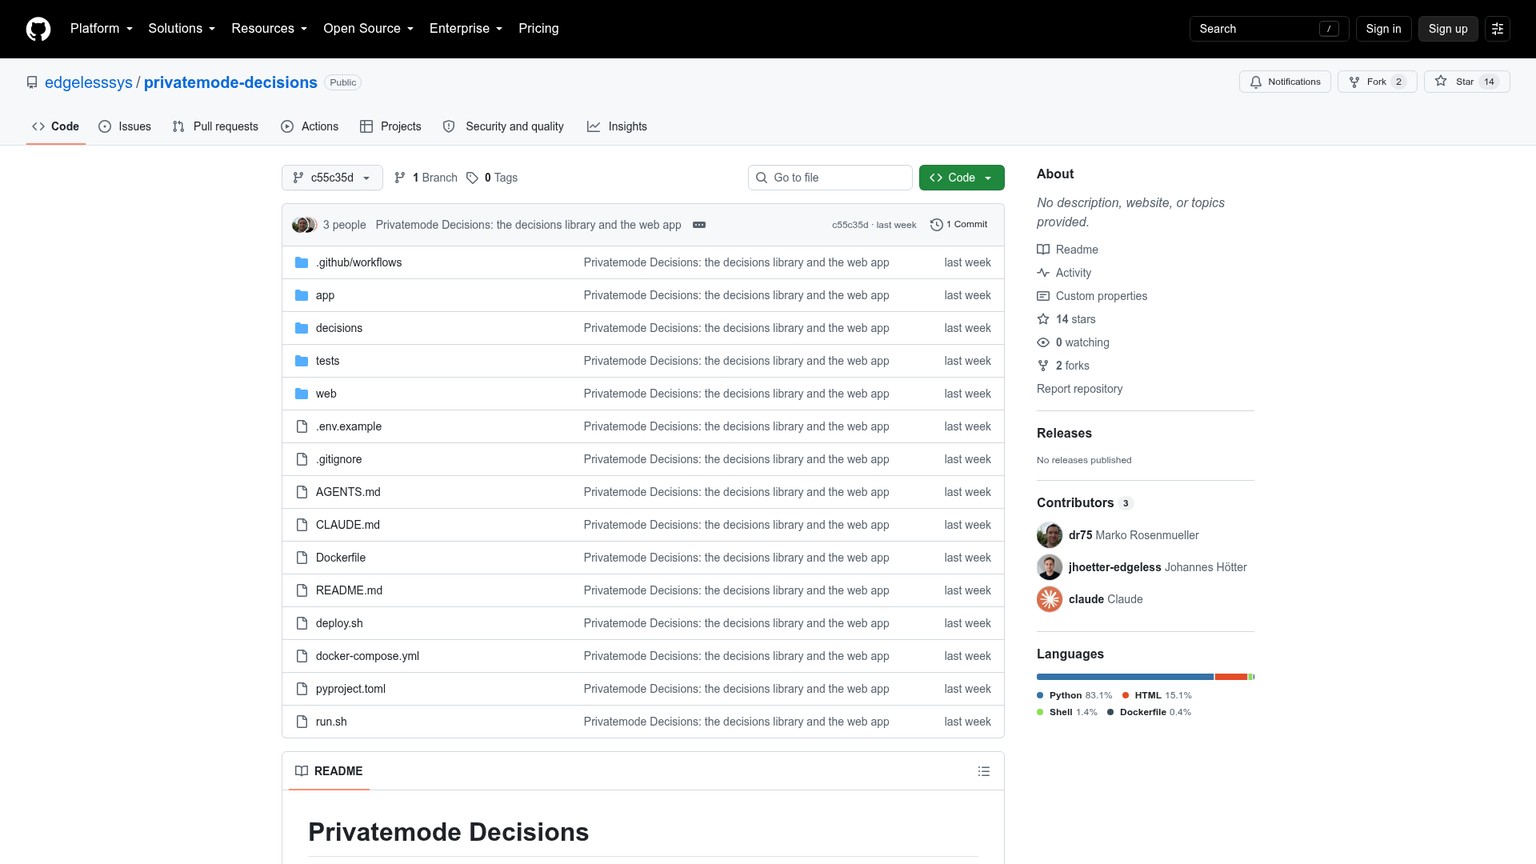
В актуальном каталоге Privatemode GLM-5.3-Flash доступна через эндпоинты chat completions, completions и messages. Модель принимает текст и изображения, а ее контекстное окно составляет 1 миллион токенов. Официальная карточка модели описывает ее как нативно мультимодальную модель типа mixture-of-experts с 320 млрд параметров, из которых активны 18 млрд.
Ключевая для чистоты теста деталь — имя модели. В примере кода используется glm-flash-latest, то есть плавающий псевдоним. Сегодня он указывает на предварительную версию glm-5.3-flash, но это не значит, что любой будущий запуск тоже будет тестом GLM-5.3-Flash. До сбора результатов выясните и запишите, какая модель реально обслуживает запрос. Кроме того, библиотека на 10 минут кэширует идентификаторы токенов вариантов отдельно для каждой модели, поэтому в контролируемом тесте важно исключить смену версии и устаревший кэш.
Метод с одним выходным токеном эффективен, но не безграничен. Индексы вариантов должны представляться одним токеном. Реализация поддерживает до 191 индекса, при этом вопрос со 151 вариантом требует двух чтений: хостинговый эндпоинт возвращает не более 128 запрошенных идентификаторов токенов с логарифмами вероятностей за один ответ. Для обычных схем маршрутизации этого достаточно; огромный плоский набор меток разумнее заменить иерархией.
Победитель категории: GLM-5.3-Flash через Privatemode Decisions по работе с изображениями, размеру контекста и переносимости среды выполнения.
Точность определяет рабочая задача, а не вероятность
Ни высокая вероятность, ни широкий бенчмарк не доказывают, что следующее обращение будет классифицировано верно. Обе системы нормализуют уверенность по вариантам заданного вопроса. Если правильного ответа в списке нет, модель все равно может с высокой уверенностью выбрать наименее неверный. Поэтому явный вариант none of these — часть постановки задачи, а не необязательный аварийный выход.
Опубликованное сравнение Privatemode охватывало 29 открытых размеченных наборов данных; обе системы смогли ответить на 28 текстовых наборах. Каждая лидировала на 10, а еще в восьми разница не превышала одного процентного пункта. Медианный разрыв составил 0.7 процентного пункта в пользу Jev при p=0.64. В одинаковых запусках с нулевой температурой менялось до 3.5% ответов, поэтому поставщик счел небольшие различия шумом. Это полезные измерения, опубликованные поставщиком, но они не являются бенчмарком этой статьи.
В независимом бенчмарке Kumzha на каждую задачу приходилось по 200 примеров, размеченных людьми. Для Banking77 авторы получили 83.5% точности у GLM-5.3-Flash и 81.5% у Jev 1.13, а для классификации промпт-инъекций — 91.0% против 86.0%. Это независимые данные, но они не подтверждают качество именно Privatemode Decisions. Ветка GLM использовала обычную генерацию с ограничениями через OpenRouter и небольшой объем рассуждений, тогда как Jev обращался напрямую к исходному серверу AWS в Орегоне. Различались и сетевые маршруты, и методы принятия решений.
Практический вывод намеренно осторожен: опубликованные данные не выявляют универсального лидера по точности. Они лишь показывают, что оба варианта заслуживают теста на ваших метках. В таблице результатов обычную ошибку следует отделять от ошибки с высокой уверенностью, потому что вторая с большей вероятностью минует проверку человеком.
Победитель категории: общего лидера по опубликованной точности на текстах нет. Jev или GLM побеждает только после прогона одной и той же размеченной нагрузки через обе системы.
Задержка зависит от региона клиента
Задержка в первую очередь определяется географией, а уже затем моделью. В одновременном замере Privatemode на четырех наборах данных медиана для Германии составила 180 мс у Privatemode и 264 мс у Jev. Для клиента в США порядок оказался обратным: 299 мс у Privatemode и 164 мс у Jev.
Отдельно в репозитории указано, что типичное решение Privatemode занимает около 150 мс с учетом сети. Это полезный ориентир, но не тот же замер, что региональный тест на четырех наборах. Значение из репозитория и результаты публикации следует воспринимать как два отдельных представления данных поставщика, а не объединенный бенчмарк.
Для службы поддержки во Франкфурте опубликованные задержки благоприятнее у европейского маршрута Privatemode. Для воркера в США лучшая медиана в данных поставщика у Jev. В корректном тесте нужно зафиксировать регион клиента и записывать как p50, так и p95: на очереди сказывается длинный хвост задержек, а не только медиана.
Победитель категории: Privatemode в опубликованных тестах для Германии; Jev — в опубликованном тесте для США.
Разница в цене и почему точки пересечения нет
Актуальные цены, проверенные 27 сентября 2026 года, однозначны. Jev 1.13 стоит $0.042 за миллион входных токенов, выходные токены бесплатны. В тарифах Privatemode для GLM-5.3-Flash указаны €0.20 за миллион входных токенов, €0.65 за миллион выходных и €0.05 за миллион кэшированных входных токенов; НДС начисляется там, где применимо. Для сопоставления в долларах ниже используется справочный курс ECB от 25 сентября: €1 равен $1.1403.
Типовой запрос включает состояние на 500 токенов и четыре варианта, среди которых none of these. По данным поставщиков об упаковке промпта Jev отправляет около 810 входных токенов, а Privatemode Decisions — около 635 входных и один выходной токен. Здесь GLM формирует более короткий промпт, но пересчитанная в доллары ставка за входные токены примерно в 5.43 раза выше, чем у Jev. В итоге одно решение обходится примерно в 4.28 раза дороже.
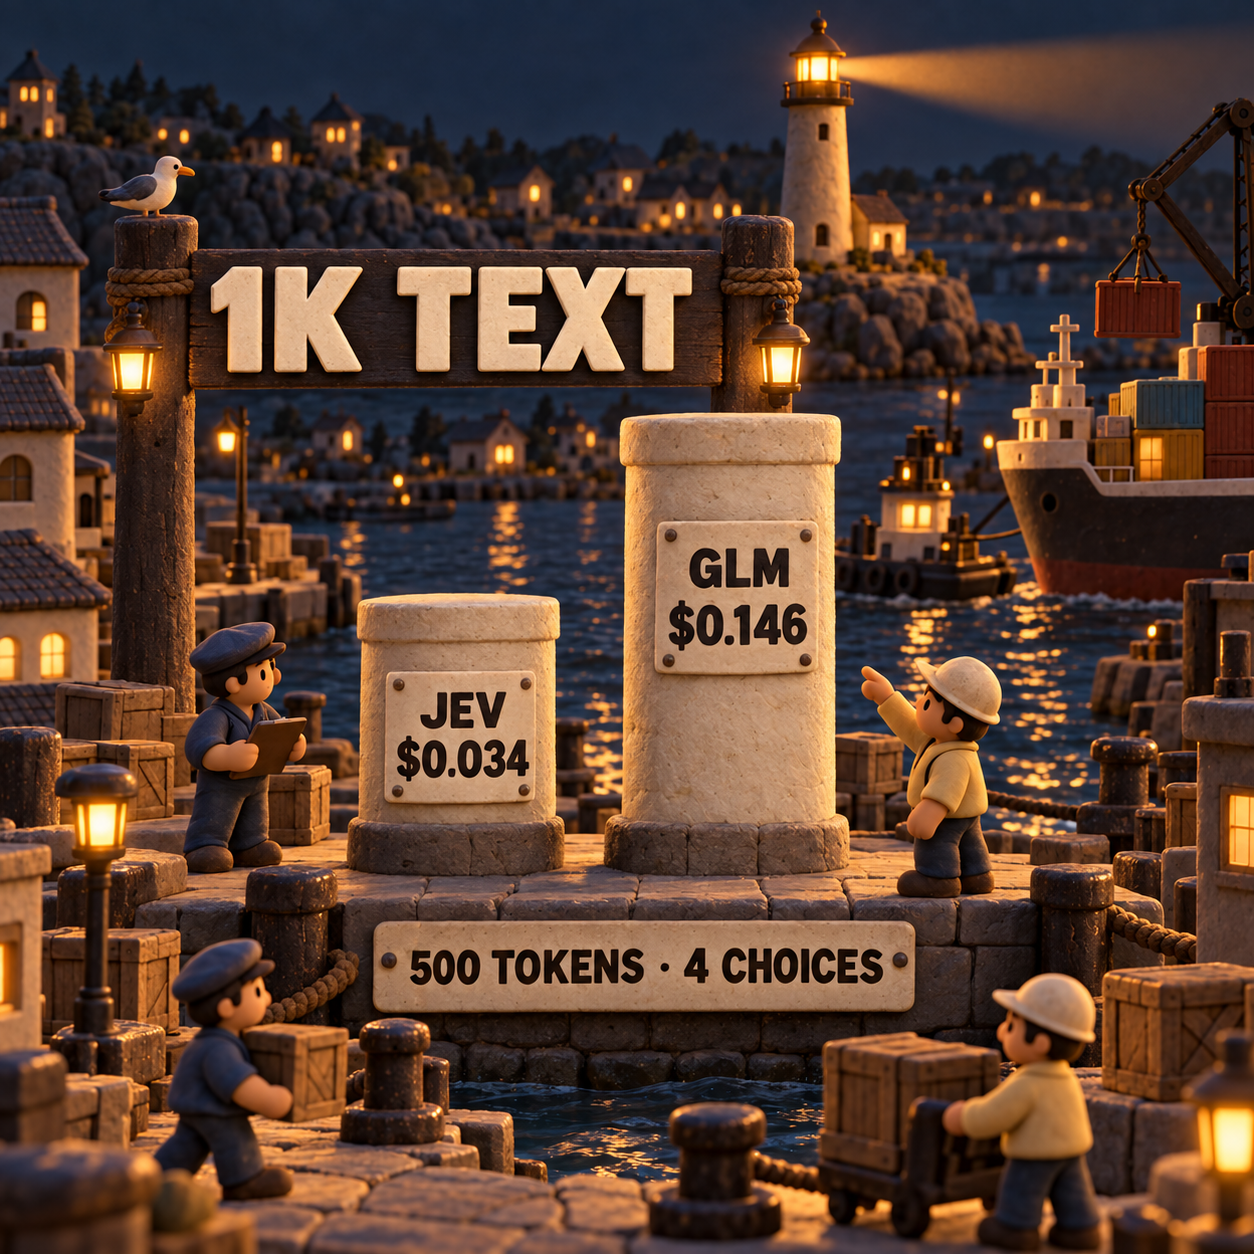
При этих тарифах и линейных оценках упаковки запроса точки пересечения в неотрицательной области нет. Хотя примерно до 21 варианта промпт Privatemode остается короче, разница в ставках слишком велика, чтобы линии пересеклись. Если оба маршрута дают одинаковый операционный результат, Jev остается дешевле.
Но инференс — не весь счет. Для 100,000 типовых решений разница в прямых затратах составляет около $11.1539. Допустим, час проверки стоит $30, а одна передача специалисту занимает две минуты, то есть обходится в $1. Тогда Privatemode должен предотвратить 12 передач человеку на каждые 100,000 решений, чтобы окупить надбавку за инференс. Это сценарий расчета, а не утверждение, что система действительно дает такой результат.
Главная метрика должна быть такой: (inference cost + review cost + retry cost) / correct decisions. Более дешевый вызов может проиграть, если создает больше эскалаций. Более дорогой может выиграть, если обрабатывает изображение без отдельного OCR-сервиса. Без учетных данных обеих систем честно опубликовать фактическую стоимость одного правильного решения невозможно.
Победитель категории: Jev по прямой стоимости обработки текста. Победитель всего процесса определяется измеренными ошибками, повторами, OCR и проверкой человеком.
Изображения меняют лидера при сортировке документов
В сравнении прямого ввода отсканированных счетов выигрывает GLM-5.3-Flash: Privatemode принимает изображения, а Jev — нет. Это принципиальная граница возможностей, а не небольшое отличие функций. В процессе на базе Jev перед вызовом решения понадобится OCR или еще одна модель компьютерного зрения, а значит — второй поставщик, дополнительный источник сбоев, новая задержка и отдельная стоимость.
Privatemode сообщает о точности 70.2% на 1,600 отсканированных документах RVL-CDIP из 16 классов. Jev не мог участвовать в этом тесте изображений. По данным поставщика, каждое изображение добавляло около 1,350 входных токенов, а оценочная стоимость 1 миллиона решений по документам составляла около €270. Эти результаты показывают, что маршрут способен принимать сканы, но ничего не говорят о том, как он справится именно с вашими счетами.
Пять синтетических счетов следует оставить отдельным тестом возможностей. Если взять базовое состояние на 500 токенов и заявленную прибавку в 1,350 токенов на изображение, одно решение Privatemode будет стоить около €0.00039765, или $0.00045344; пять — около €0.00198825, или $0.0022672. Не включайте эти пять результатов в оценку точности на 30 текстовых обращениях. Иначе GLM получит преимущество за участие в тесте, который Jev пройти не может, и сравнение текстовых задач потеряет смысл.
Победитель категории: GLM-5.3-Flash для непосредственной сортировки документов по изображениям.
Перед переходом прогоните одинаковый тест на 30 обращениях
Минимальный убедительный внутренний тест — зафиксированный набор из 30 размеченных синтетических обращений, который обе системы проходят с одинаковыми вариантами, в одном порядке и с явным вариантом none of these. Синтетические примеры позволяют не отправлять клиентские данные во время оценки. При этом они должны отражать короткие, неоднозначные и выходящие за рамки классификации обращения, на которых ломается промышленный маршрутизатор.
Зафиксируйте тестовый набор
Запишите 30 текстовых обращений, ожидаемые метки и разрешенные варианты в один версионируемый файл. Добавьте
none of these, не меняйте порядок вариантов, а пять изображений счетов оставьте отдельным набором для проверки возможностей.Зафиксируйте фактическую модель каждого сервиса
Вызывайте версию
jev-1.13.0или сохраняйте полеmodelиз ответа Jev. Определите, на какую модель указывает псевдонимglm-flash-latest, и запишите фактически обслуживающую запрос версию, прежде чем называть результат тестом GLM-5.3-Flash. Для обеих систем укажите эндпоинт и регион клиента.Прогоните идентичные запросы
Передайте обоим маршрутам одно и то же состояние и семантически одинаковые варианты. Не улучшайте незаметно промпт одной системы, не переставляйте метки только для одной и не учитывайте повторные попытки лишь на одной стороне.
Соберите операционные данные
Для каждого вызова сохраняйте p50 и p95 задержки на уровне прогона, входные токены, начисленную стоимость, выбранный вариант, вероятность или уверенность, правильность, повторный вызов и передачу человеку. Отдельно отмечайте неверные ответы с высокой уверенностью.
Проверяйте изображения отдельно от текстовой оценки
Отправьте пять синтетических изображений счетов через Privatemode. Запишите модель, токены, стоимость, задержку и метку. Для Jev отметьте невозможность прямого ввода вместо того, чтобы засчитывать ему ошибку текстовой классификации.
Рассчитайте стоимость правильного решения
Сложите затраты на инференс, повторные запросы, предварительную обработку и проверку человеком, затем разделите сумму на число правильных решений. Результаты общего теста на 30 текстовых обращениях и теста возможностей на пяти изображениях публикуйте отдельно.
Прямые затраты на запланированный текстовый прогон составят около $0.0010206 для Jev и €0.0038295, или $0.0043668, для Privatemode без учета повторов. Эта разница слишком мала, чтобы принять решение о покупке. Ценность теста в том, что он выявляет соответствие меток, калибровку, региональный хвост задержек и поведение при передаче человеку.
Цена перехода и кому не стоит менять систему
Переход с Jev на Privatemode Decisions — не простая замена имени модели. Jev Choice или Score превращается в библиотечный Choice с фиксированными индексами вариантов. Команде придется сопоставить существующую классификацию, заново настроить пороги уверенности, заменить клиентскую логику и правила повторных попыток, проверить OpenAI-совместимый эндпоинт и сделать видимой фактическую модель за псевдонимом. Если причиной перехода была конфиденциальная обработка, нужно использовать именно контур Privatemode, на который распространяются эти гарантии, а не произвольный хост vLLM.
Обратный переход тоже требует работы. Состояние с изображениями придется пропускать через OCR или другой этап компьютерного зрения. Длинные промпты должны укладываться в контекстные ограничения Jev. Все допущения промптов, специфичные для GLM, нужно преобразовать в вопросы Jev, а исторические вероятности нельзя считать взаимозаменяемой калибровкой.
Можно ли считать GLM-5.3-Flash альтернативой Jev?
Да — для текстовых решений с конечным числом вариантов, особенно если тому же процессу нужны изображения. Нет — если под «альтернативой» понимать замену без доработок с идентичными показателями уверенности, инфраструктурой и параметрами соответствия требованиям. Меняются форма API, предварительная обработка, жизненный цикл модели и границы развертывания.
Не уходите с Jev, если очередь работает только с текстом, набор меток стабилен, текущая точность устраивает, а экономия долей цента на тысячу решений важнее мультимодального ввода. Не уходите с Privatemode, если прямой прием изображений или конфиденциальный европейский сервис — жесткие требования. В обоих направлениях небольшого преимущества в открытом бенчмарке недостаточно, чтобы окупить риск миграции.
Что сделать в понедельник
Зафиксируйте тестовый набор до того, как кто-либо начнет подстраивать промпты под удачные примеры. В одной записи теста сохраните 30 синтетических обращений, пять синтетических счетов, схему категорий, ожидаемые метки, предполагаемую стоимость проверки и регион клиента. Добавьте поля для фактической версии модели, эндпоинта, p50, p95, токенов, начисленной стоимости, повторов, неверных ответов с высокой уверенностью и случаев передачи человеку.
Затем дождитесь учетных данных обеих систем и запустите общую нагрузку. До этого момента обоснованный вывод остается условным: Jev лидирует в дешевой маршрутизации текста, а GLM-5.3-Flash через Privatemode Decisions — в прямой обработке изображений и переносимости библиотечного подхода.
Частые вопросы
Чем GLM-5.3 отличается от GLM-5.3-Flash?
В Privatemode модель GLM-5.3 работает только с текстом и стоит €1.55 за миллион входных токенов и €7.74 за миллион выходных. GLM-5.3-Flash принимает изображения и стоит €0.20 за входные и €0.65 за выходные токены на миллион, поэтому у этого провайдера версия Flash дешевле и поддерживает несколько типов данных.
Насколько хороша GLM-5.3-Flash?
GLM-5.3-Flash — убедительный кандидат для задач принятия решений, где нужны изображения, длинный контекст или развертывание Privatemode. Но итоговое качество все равно определяется точностью, ошибками с высокой уверенностью, задержкой и стоимостью правильного решения на ваших метках.
GLM-5.3-Flash — модель с открытым исходным кодом?
Файлы модели опубликованы по лицензии MIT. Это отвечает на вопрос о лицензии модели, но конфиденциальность развертывания и условия сервиса по-прежнему зависят от места и способа запуска.
GLM-5.3-Flash поддерживает изображения?
Да. Официальная карточка описывает ее как нативно мультимодальную модель, а Privatemode заявляет поддержку изображений на входе эндпоинта GLM-5.3-Flash.
Как расшифровывается GLM?
В исходной научной статье GLM расшифровывается как General Language Model.
Есть ли у GLM-5.3-Flash компьютерное зрение?
Да. Модель принимает не только текст, но и изображения, поэтому может участвовать в тесте на отсканированных документах, который Jev не способен пройти напрямую.
Сколько параметров в GLM-5.3-Flash?
Согласно официальной карточке Z.ai, у модели 320 млрд параметров всего и 18 млрд активных параметров.
GLM-4.7-Flash — это MoE-модель?
Да, но это другая модель. Ее официальная карточка описывает архитектуру mixture-of-experts 30B-A3B, поэтому переносить эти характеристики на GLM-5.3-Flash нельзя.
GLM-5.3-Flash мультимодальна?
Да. В этом сравнении именно это преимущество определяет выбор для сортировки отсканированных документов.
Хотите проще определить место обоих вариантов в своем стеке? Получите AI Tools Map for Business Owners, сначала спроектируйте слой принятия решений и только потом добавляйте еще одну модель.
- Последнее обновление
- 27 сент. 2026 г.
- Категория
- AI
Сделать этот сайт предпочтительным в Google


Отметьте omidsaffari.com как предпочтительный источник — и Google будет поднимать его для вас в Top Stories, AI Overviews и AI Mode.
Claude Opus 5.5 vs Opus 5: цены, кодинг и миграция
Сравниваем Claude Opus 5.5 и Opus 5: цены, кодинг, thinking, изменения API и пять проверок, без которых нельзя безопасно перенести рабочие нагрузки.23 сент. 2026 г.AI
GPT-6 Sol или Luna: какую модель выбрать для работы
Сравниваем GPT-6 Sol и Luna по цене, возможностям и качеству кода. Разбираем, когда достаточно Luna, а когда переплата за Sol действительно оправдана.23 сент. 2026 г.AI
GPT-6 Luna бесплатно: где доступна и сколько стоит API
Разбираем, где GPT-6 Luna доступна бесплатно, какие тарифы нужны для Work и Codex, сколько стоит API и какие лимиты OpenAI пока не раскрыла.22 сент. 2026 г.AI
Как пользоваться MiMo V2.6: первый рабочий сценарий
Как пользоваться MiMo V2.6 в Studio и через API: выберите подходящий ключ и модель, запустите первую бизнес-задачу и сразу проверьте результат.22 сент. 2026 г.AI
MiMo V2.6 Pro vs Flash: когда стоит платить больше
Сравниваем MiMo V2.6 Pro vs Flash по цене, возможностям и тестам. Разбираем, когда брать Flash, а когда доплата за Pro действительно окупается.22 сент. 2026 г.AI
MiMo V2.6 бесплатно: доступ через OpenCode и цены API
Разбираем, где MiMo V2.6 доступна бесплатно, какие ограничения есть у OpenCode, сколько стоит Xiaomi API и во что обойдётся самостоятельный запуск.22 сент. 2026 г.AI
Grok 4.7 vs Grok 4.6: что выбрать для кода и API
Сравниваем Grok 4.7 и Grok 4.6: качество кода, API-тарифы, контекст и риски перехода. Парный тест покажет, когда обновление действительно выгодно.21 сент. 2026 г.AI