GLM-5.3-Flash vs Jev: cuál elegir para decisiones con IA
Compara GLM-5.3-Flash y Jev en precio, entradas, latencia y portabilidad. Descubre cuál conviene para enrutar texto o clasificar documentos con IA.

- JJev
- PPrivatemode Decisions
- GGLM-5.3-Flash
- Lllama.cpp
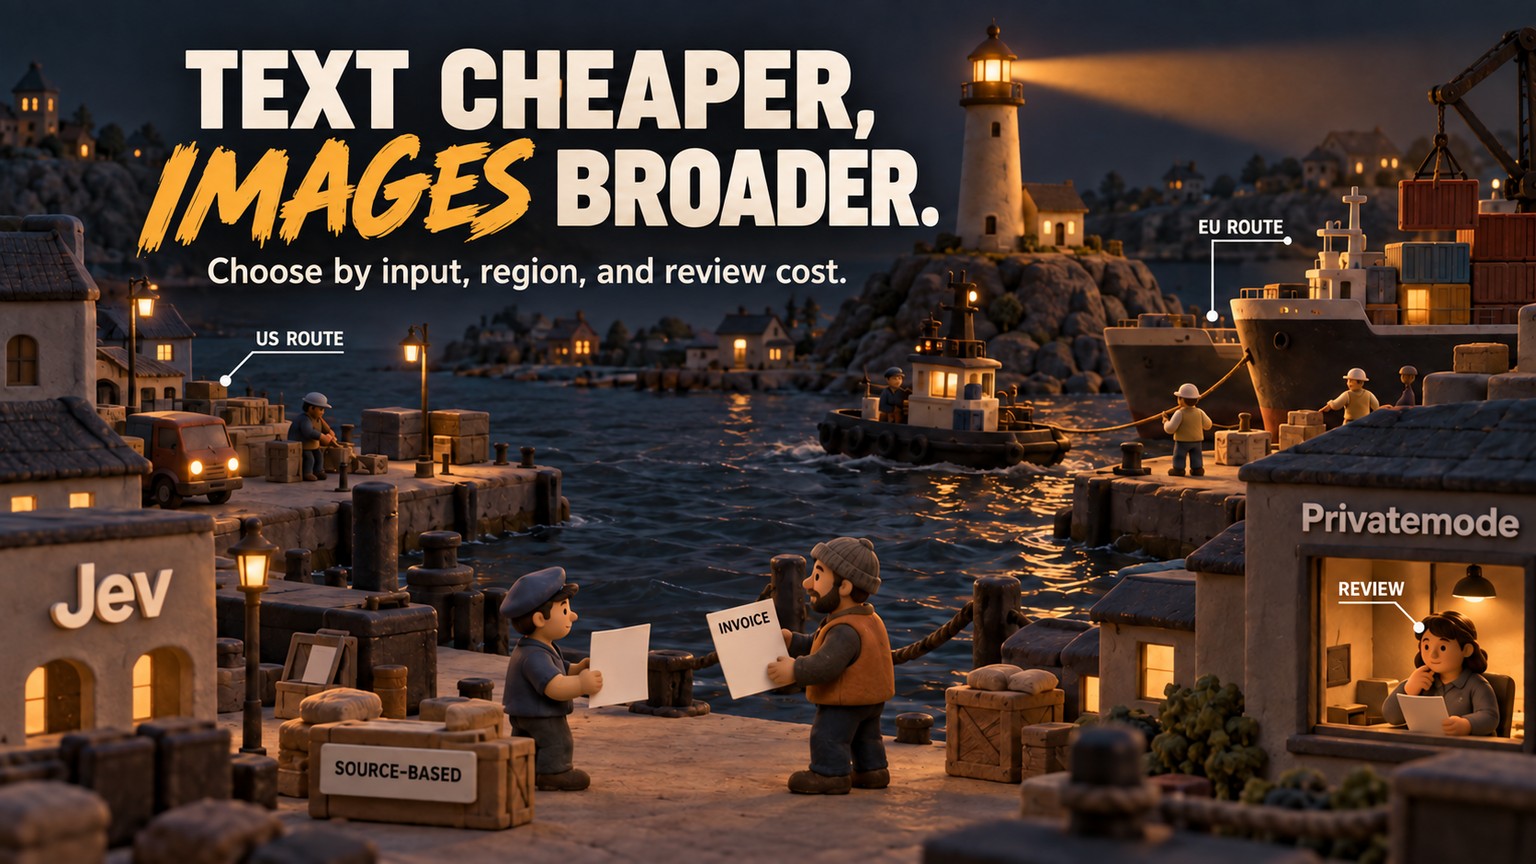
Elige Jev para enrutar grandes volúmenes de texto cuando lo prioritario sea reducir al mínimo el costo bruto de inferencia. Elige GLM-5.3-Flash mediante Privatemode Decisions si el flujo depende de imágenes, proximidad con Europa, procesamiento confidencial o libertad para cambiar de modelo. Con los precios de lista actuales, un ticket de 500 tokens y cuatro opciones cuesta aproximadamente $0.034 por cada 1,000 decisiones con Jev, frente a $0.146 por la ruta de Privatemode. Pero basta con que aparezca una factura escaneada para que Jev deje de ser viable sin un paso de OCR adicional.
¿Cuál conviene elegir?
Jev encaja mejor en la clasificación masiva de texto: dirigir un ticket de soporte, evaluar una condición de una política o escoger una respuesta entre alternativas conocidas. Su bajo precio de entrada le da una ventaja clara en costo bruto, y su API especializada mantiene simple la operación de decidir.
GLM-5.3-Flash mediante Privatemode Decisions tiene más sentido cuando el estado puede incluir una imagen, el cliente está más cerca del servicio europeo de Privatemode, el procesamiento confidencial forma parte de la compra o se busca una misma biblioteca que después pueda apuntar a otro servidor basado en vLLM. Cada decisión de texto cuesta más, pero a cambio se obtiene entrada multimodal y una implementación más portable.
Para una cola de texto operada desde Estados Unidos, Jev es la opción predeterminada más sólida. Para una cola de imágenes operada desde Alemania, la ruta de Privatemode parte con ventaja. Si ninguno de esos escenarios representa el caso real, no conviene decidir con una tabla de funciones: hay que ejecutar los mismos casos etiquetados en ambos sistemas y poner precio a los errores y a las derivaciones, no solo a los tokens.
GLM-5.3-Flash vs Jev: qué implica realmente la elección
Jev y GLM-5.3-Flash no son dos modelos de chat intercambiables. Jev es un modelo de decisión entrenado para ese propósito. Recibe un estado y una pregunta tipada, como Choice o Score, y devuelve una respuesta acompañada de probabilidades y una estadística de confianza. Está diseñado para ese instante concreto en el que el software debe elegir, no conversar.
Privatemode Decisions es una técnica de biblioteca construida alrededor de un modelo de lenguaje generalista. Presenta opciones con nombre a GLM-5.3-Flash, restringe el siguiente token a los índices válidos, lee sus probabilidades y vuelve a normalizarlas. Una sola pasada y un token de salida convierten un modelo multimodal amplio en un selector rápido y acotado.
Esa diferencia cambia la decisión de compra. Jev es el servicio especializado. Privatemode Decisions combina una capa de decisión con el modelo y el endpoint que la sostienen. La biblioteca puede conectarse a un servidor vLLM compatible con OpenAI, mientras que el endpoint propio de Privatemode incorpora su despliegue de computación confidencial. La portabilidad pertenece a la biblioteca; las garantías de procesamiento cifrado de Privatemode no se trasladan automáticamente a cualquier servidor.
También hay una posible confusión de nombres. La API Jev Decisions analizada aquí no es el producto de OpenRouter llamado Jev Router. Este último elige un modelo para un prompt. Si ese es el producto que se está evaluando, corresponde consultar la guía separada sobre los precios de Jev Router. Mezclar ambos productos invalida cualquier comparación de costos y capacidades.
Jev gana en costo para enrutar tickets de soporte
Jev se adapta mejor a una cola de tickets de texto convencionales porque su contrato ya está expresado en decisiones. La página de modelos de TypeSafe muestra jev-1.13.0 a $0.042 por millón de tokens de entrada, sin costo de salida. El alias jev-latest apunta actualmente a esa versión, y la respuesta incluye un campo model versionado que debe guardarse en el registro de pruebas.
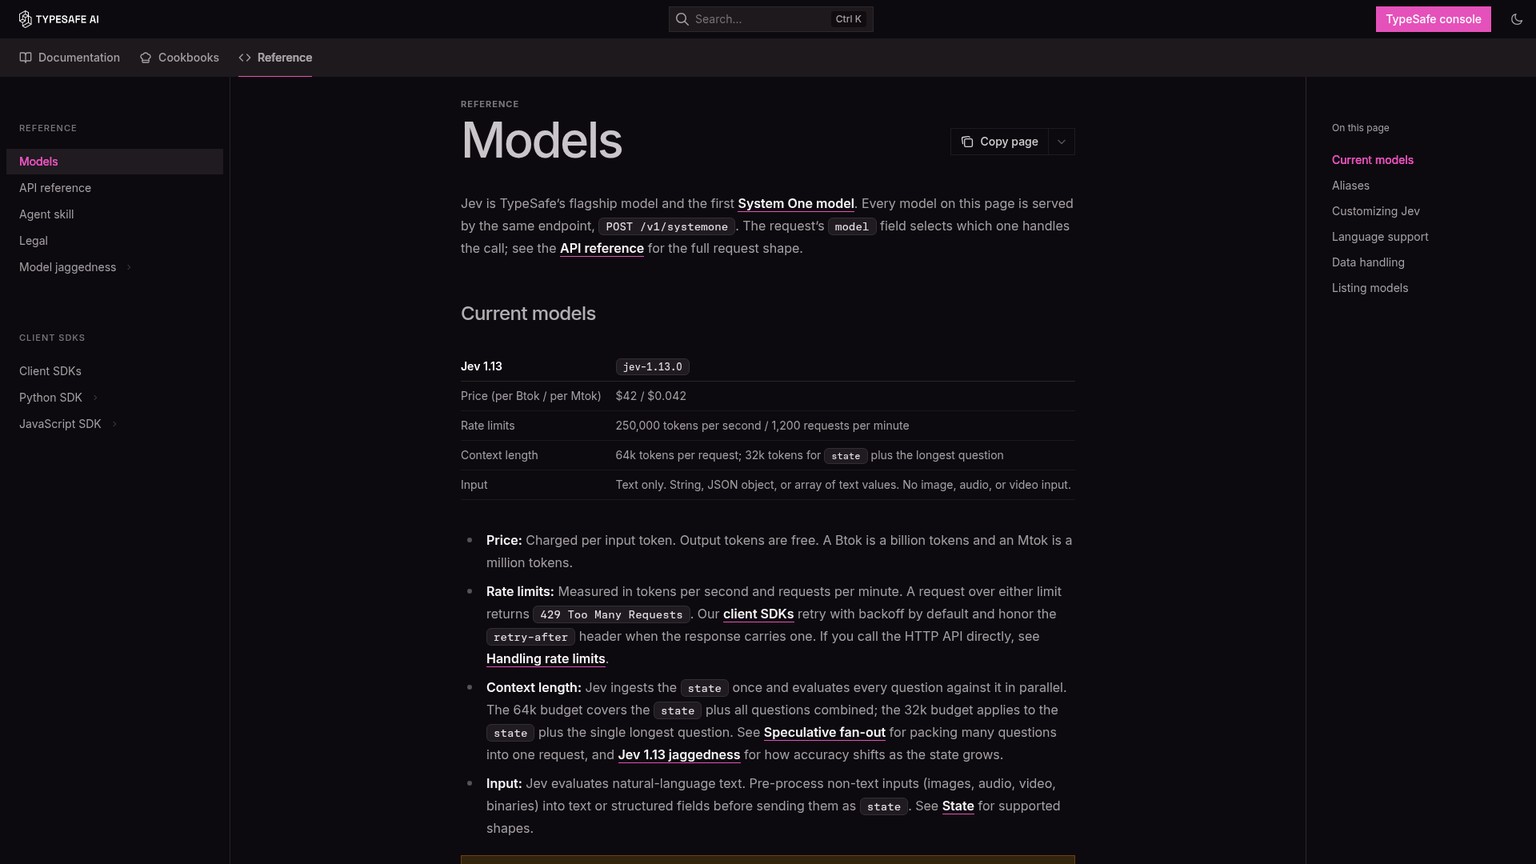
Una llamada de enrutamiento puede enviar el ticket como estado y ofrecer opciones como facturación, cancelación, error y ninguna de las anteriores. Jev admite cadenas y texto estructurado, incluidos JSON o arreglos, pero no imágenes, audio ni video. Cada solicitud tiene un límite de 64,000 tokens, con un máximo de 32,000 para el estado más la pregunta de mayor longitud. Es margen de sobra para enrutar tickets, pero no convierte un documento escaneado en texto.
La ventaja es económica, no mágica. Según la estimación de empaquetado del proveedor, una decisión con cuatro opciones agrega unos 270 tokens fijos y 10 por opción. Al sumar un ticket de 500 tokens, la entrada facturable llega a 810 tokens. Al precio vigente, cada decisión cuesta $0.00003402.
Para incorporar Jev a una arquitectura nueva, la guía existente de enrutamiento de tickets de soporte con Jev explica la configuración de la API. Esta comparativa parte del paso siguiente: decidir si un especialista limitado a texto sigue siendo suficiente.
Ganador de la categoría: Jev para enrutar soporte basado solo en texto y minimizar el costo bruto de inferencia.
Privatemode Decisions: GLM Flash como modelo de decisión
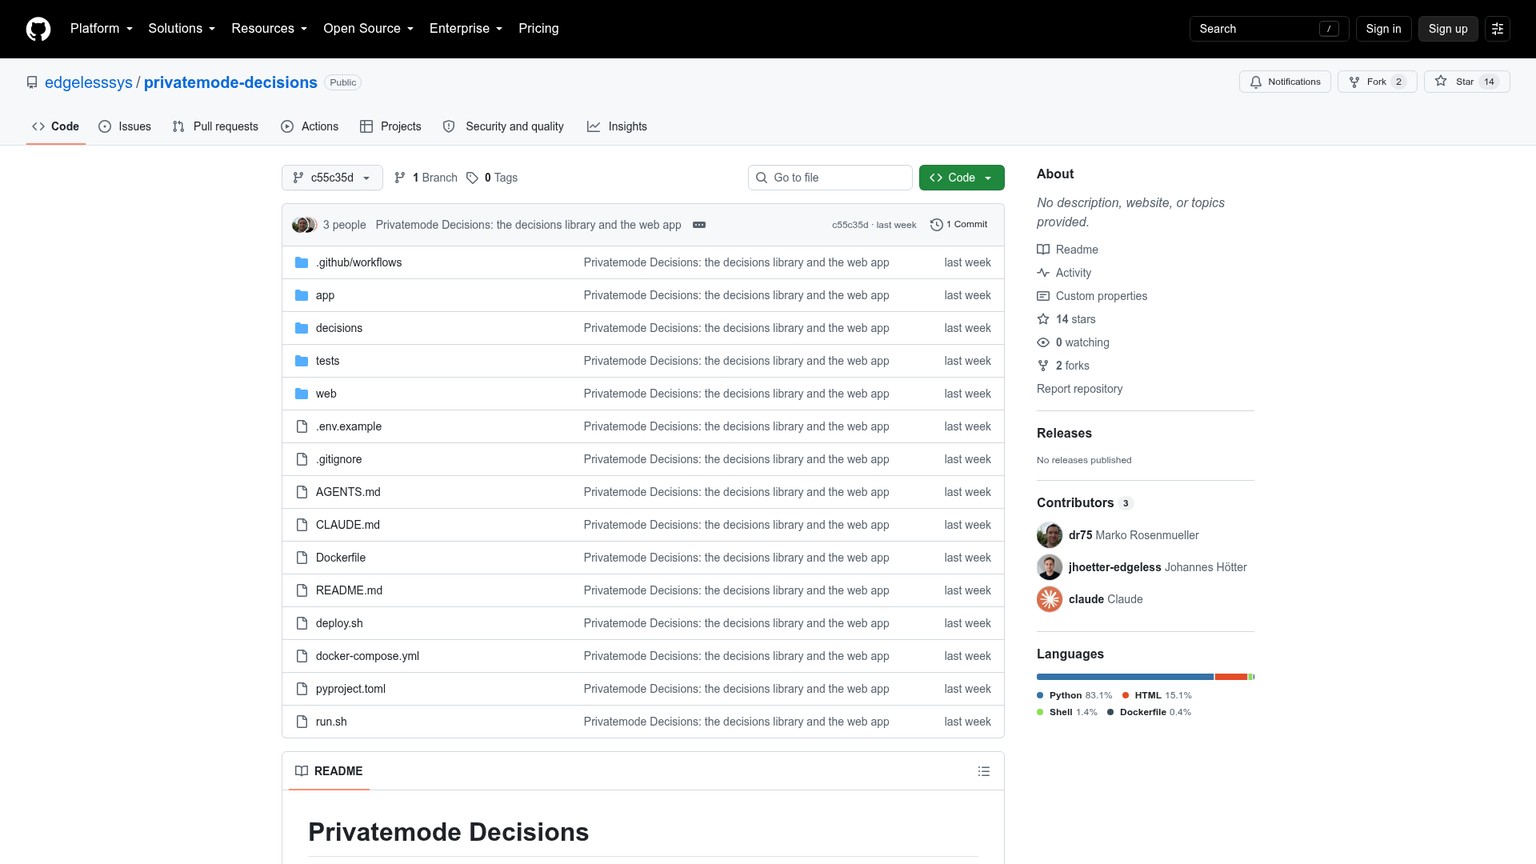
Privatemode Decisions ofrece una ruta mejor planteada cuando el propio caso contiene una imagen o cuando se busca una lógica de decisión que pueda moverse entre servidores de modelos compatibles. El primer commit de la biblioteca se publicó el 21 de septiembre de 2026. Los metadatos de la versión fijada indican 0.1.0, Python >=3.10 y un núcleo sin dependencias.
El catálogo actual de Privatemode ofrece GLM-5.3-Flash mediante endpoints de chat completions, completions y messages. Acepta texto e imágenes, con una ventana de contexto de 1 millón de tokens. Su ficha oficial lo describe como un modelo mixture-of-experts multimodal nativo, con 320 mil millones de parámetros totales y 18 mil millones activos.
El nombre del modelo es crucial para la integridad de la prueba. El código de ejemplo usa glm-flash-latest, un alias móvil. Hoy apunta a la versión preliminar glm-5.3-flash, pero eso no garantiza que todas las ejecuciones futuras sigan probando GLM-5.3-Flash. Antes de recopilar resultados, hay que resolver y registrar qué modelo atendió la solicitud. La biblioteca también conserva en caché los identificadores de tokens de las opciones durante 10 minutos por modelo, así que en una prueba controlada conviene descartar tanto un cambio de versión como una caché obsoleta.
El método de un solo token es eficiente, aunque tiene límites. Las opciones deben corresponder a índices de un único token. La implementación admite hasta 191 índices; una pregunta con 151 opciones requiere dos lecturas porque el endpoint alojado devuelve como máximo 128 identificadores de tokens de log-probability solicitados por respuesta. Para taxonomías de enrutamiento normales es más que suficiente. Ante un espacio plano de etiquetas gigantesco, una jerarquía puede ser una arquitectura más adecuada.
Ganador de la categoría: GLM-5.3-Flash mediante Privatemode Decisions en entrada de imágenes, contexto y portabilidad de ejecución.
La precisión depende de la carga, no de una probabilidad
Ni una probabilidad alta ni un benchmark amplio demuestran que el próximo ticket se clasificará bien. Ambos sistemas normalizan la confianza sobre la pregunta que reciben. Si falta la respuesta verdadera, el modelo todavía puede asignar mucha confianza a la alternativa menos equivocada. Por eso, incluir explícitamente none of these forma parte de la definición de la tarea; no es una salida opcional.
La comparación publicada por Privatemode abarcó 29 conjuntos públicos de datos etiquetados; ambos sistemas pudieron responder 28 conjuntos de texto. Cada uno lideró en 10 y, en otros ocho, la diferencia quedó dentro de un punto porcentual. La brecha mediana reportada fue de 0.7 puntos porcentuales a favor de Jev, con p=0.64. Ejecuciones idénticas con temperatura cero cambiaron hasta 3.5% de las respuestas, por lo que el proveedor trató las diferencias pequeñas como ruido. Son mediciones útiles reportadas por el proveedor, no un benchmark realizado para este artículo.
Un benchmark independiente de Kumzha probó 200 elementos etiquetados por personas en cada tarea. Registró una precisión de 83.5% en Banking77 para GLM-5.3-Flash y de 81.5% para Jev 1.13; en clasificación de inyección de prompts, los resultados fueron 91.0% frente a 86.0%. La evidencia es independiente, pero no valida Privatemode Decisions. La prueba de GLM usó generación restringida convencional mediante OpenRouter con razonamiento bajo, mientras que Jev se conectó directamente a un origen de AWS en Oregon. Tanto las rutas de latencia como los métodos de decisión eran diferentes.
La conclusión útil debe ser prudente: la evidencia publicada no permite declarar un ganador universal en precisión. Sí muestra que ambas opciones merecen probarse con las etiquetas propias. El cuadro de resultados debe distinguir entre una elección equivocada común y otra equivocada con confianza alta, porque esta última tiene más probabilidades de saltarse la revisión humana.
Ganador de la categoría: no existe un ganador general en precisión de texto según los datos publicados. Jev o GLM solo ganan después de repetir la misma carga etiquetada en ambos.
La latencia cambia según la región del cliente
Antes que del modelo, la latencia depende de la geografía. En la medición simultánea de Privatemode sobre cuatro conjuntos de datos, las medianas desde Alemania fueron de 180 ms para Privatemode y 264 ms para Jev. Desde un cliente en Estados Unidos, el orden se invirtió: 299 ms para Privatemode y 164 ms para Jev.
Por separado, el repositorio sitúa una decisión típica de Privatemode en unos 150 ms, incluido el tiempo de red. Sirve como referencia, pero no es la misma medición que la prueba regional con cuatro conjuntos de datos. El dato destacado del repositorio y la prueba del blog deben entenderse como dos perspectivas distintas comunicadas por el proveedor, no como un benchmark combinado.
Para un equipo de soporte en Frankfurt, la ruta europea de Privatemode tiene la latencia publicada más favorable. Para un proceso situado en Estados Unidos, Jev presenta la mejor mediana reportada por el proveedor. La prueba correcta debe fijar la región del cliente y registrar p50 y p95: una cola sufre sus solicitudes más lentas, no solo la solicitud central.
Ganador de la categoría: Privatemode en las pruebas reportadas desde Alemania; Jev en la prueba reportada desde Estados Unidos.
Diferencia de precio y por qué no hay punto de cruce
Los precios vigentes verificados el 27 de septiembre de 2026 son claros. Jev 1.13 cuesta $0.042 por millón de tokens de entrada y no cobra la salida. La tabla de precios de Privatemode sitúa GLM-5.3-Flash en €0.20 por millón de tokens de entrada, €0.65 por millón de tokens de salida y €0.05 por millón de tokens de entrada en caché, más IVA cuando corresponda. Para comparar en USD bajo las mismas condiciones, el cálculo siguiente aplica el tipo de referencia del BCE del 25 de septiembre: €1 equivale a $1.1403.
La decisión común parte de 500 tokens de estado y cuatro opciones, incluida none of these. Con el empaquetado de prompts indicado por el proveedor, Jev envía cerca de 810 tokens de entrada. Privatemode Decisions envía unos 635 tokens de entrada y genera un token de salida. Aquí GLM empaqueta menos tokens, pero su tarifa convertida por token de entrada es cerca de 5.43 veces la de Jev. El resultado es una decisión aproximadamente 4.28 veces más cara.
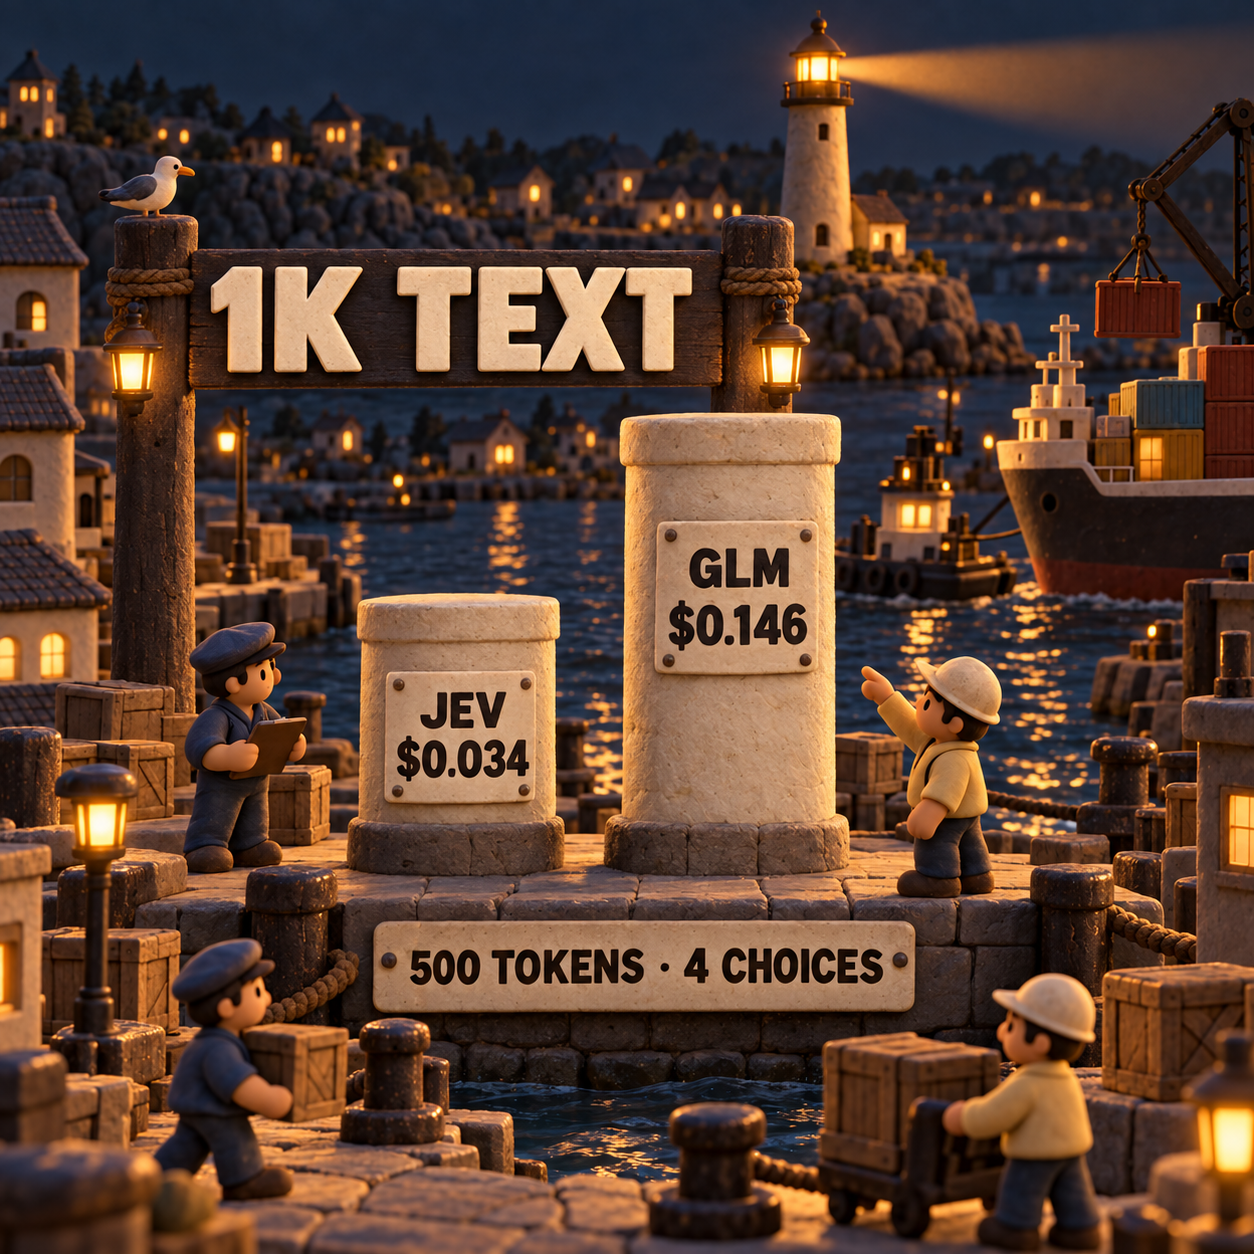
Con estos precios de lista y las estimaciones lineales de empaquetado, no existe un punto de cruce no negativo en el costo bruto por tokens. Aunque el prompt de Privatemode sigue siendo más corto por debajo de unas 21 opciones, la diferencia tarifaria es demasiado grande para que las líneas se crucen. Si ambas rutas producen el mismo resultado operativo, Jev continúa siendo más barato.
Sin embargo, la inferencia no es toda la factura. En 100,000 decisiones habituales, la diferencia bruta ronda $11.1539. Supongamos que una revisión cuesta $30 por hora y tarda dos minutos, es decir, $1 por derivación. Privatemode tendría que evitar 12 derivaciones humanas por cada 100,000 decisiones para compensar su sobrecosto de inferencia. Es un escenario, no una afirmación de que realmente lo consiga.
La métrica que importa es esta: (inference cost + review cost + retry cost) / correct decisions. Una llamada más barata puede perder si provoca más escalaciones. Una llamada más costosa puede ganar si procesa una imagen sin contratar un servicio de OCR separado. Sin credenciales para ambos sistemas, no sería honesto publicar un costo observado por decisión correcta.
Ganador de la categoría: Jev en costo bruto de texto. El ganador del flujo depende de los errores, reintentos, OCR y revisiones humanas medidos.
Las imágenes cambian el ganador en el triaje de documentos
GLM-5.3-Flash gana la comparación de entrada directa con facturas escaneadas porque Privatemode admite imágenes y Jev no. Es un límite de capacidad, no una diferencia menor entre funciones. Un flujo con Jev necesita OCR u otro modelo de visión antes de llamar al sistema de decisión, lo que añade un segundo proveedor, otra posibilidad de fallo, más latencia y un costo propio.
Privatemode reporta 70.2% de precisión en 1,600 documentos escaneados de RVL-CDIP distribuidos en 16 clases. Jev no pudo participar en esa prueba de imágenes. Según el proveedor, cada imagen añadió unos 1,350 tokens de entrada, y el costo estimado de 1 millón de decisiones sobre documentos es de alrededor de €270. Los resultados demuestran que la ruta puede ingerir documentos escaneados; no demuestran cómo se comportará con las facturas de una empresa concreta.
Conviene reservar cinco facturas sintéticas para una prueba de capacidad separada. Con la base habitual de 500 tokens más el incremento reportado de 1,350 tokens por imagen, una decisión de Privatemode costaría cerca de €0.00039765, o $0.00045344; cinco costarían alrededor de €0.00198825, o $0.0022672. Esos cinco resultados no deben mezclarse con la puntuación de precisión de los 30 tickets de texto. De lo contrario, GLM recibiría crédito por participar en una prueba a la que Jev no puede acceder y la comparación de texto dejaría de ser interpretable.
Ganador de la categoría: GLM-5.3-Flash para el triaje directo de imágenes de documentos.
Ejecuta la misma prueba de 30 tickets antes de cambiar
La comparación interna mínima que resulta creíble usa un conjunto fijo de 30 tickets sintéticos etiquetados, reproducidos con las mismas opciones, en el mismo orden y con una alternativa explícita none of these. Los casos sintéticos evitan enviar datos de clientes durante la evaluación. Aun así, deben representar los tickets breves, ambiguos y fuera de alcance que suelen romper un enrutador en producción.
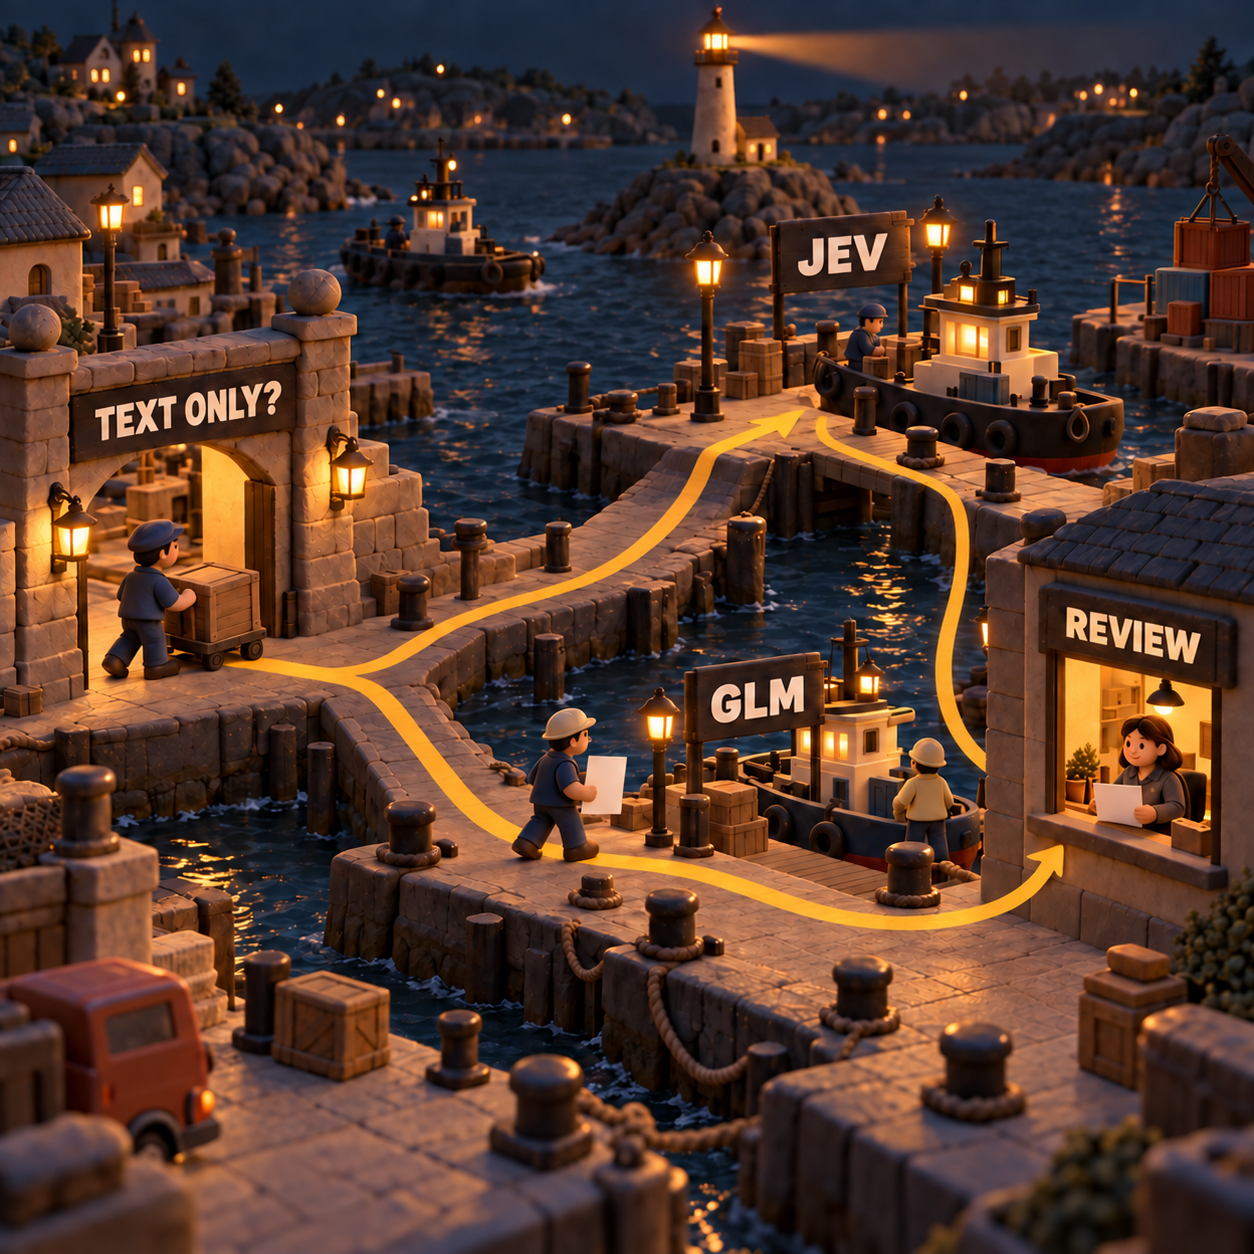
Congela el conjunto de prueba
Guarda 30 tickets de texto, sus etiquetas esperadas y las opciones permitidas en un único archivo versionado. Incluye
none of these, conserva el orden de las opciones y reserva las cinco imágenes de facturas como un conjunto de capacidad independiente.Registra la versión atendida por cada endpoint
Llama a la versión fija
jev-1.13.0o registra el campomodeldevuelto por Jev. Resuelveglm-flash-latesty anota el modelo que realmente atendió la solicitud antes de presentar el resultado como una prueba de GLM-5.3-Flash. Registra también el endpoint y la región del cliente para ambos.Repite decisiones idénticas
Envía el mismo estado y opciones con el mismo significado a ambas rutas. No mejores a escondidas uno de los prompts, cambies el orden de un conjunto de etiquetas ni contabilices los reintentos en un solo lado.
Captura el registro operativo
Para cada llamada, guarda la latencia p50 y p95 de la ejecución, tokens de entrada, costo facturado, opción seleccionada, probabilidad o confianza, acierto, reintento y derivación humana. Marca por separado las respuestas incorrectas con confianza alta.
Evalúa las imágenes fuera de la puntuación de texto
Envía cinco imágenes de facturas sintéticas a Privatemode. Registra modelo, tokens, costo, latencia y etiqueta. Marca Jev como no apto para entrada directa, en lugar de puntuarlo como un clasificador de texto que se equivocó.
Calcula el costo por decisión correcta
Suma los costos de inferencia, reintentos, preprocesamiento y revisión humana; después divide el total entre las decisiones correctas. Informa por separado el resultado compartido de los 30 tickets de texto y el resultado de capacidad de las cinco imágenes.
La inferencia bruta de la prueba de texto prevista costaría cerca de $0.0010206 con Jev, frente a €0.0038295, o $0.0043668, con Privatemode antes de reintentos. La diferencia es demasiado pequeña para decidir una compra. El valor de la prueba está en revelar el ajuste de las etiquetas, la calibración, la cola de latencia regional y el comportamiento de las derivaciones.
Costos de migración y quién no debería cambiar
Pasar de Jev a Privatemode Decisions no consiste en sustituir el nombre de un modelo. Una Choice o Score de Jev se convierte en una Choice de la biblioteca con índices de opción fijos. El equipo debe mapear la taxonomía existente, reconstruir los umbrales de confianza, sustituir el comportamiento del cliente y los reintentos, validar el endpoint compatible con OpenAI y hacer observable la resolución del alias. Si el motivo de la migración es el procesamiento confidencial, el despliegue debe permanecer en la ruta cubierta de Privatemode y no trasladarse a cualquier host vLLM.
El cambio en la dirección contraria también exige trabajo. El estado con imágenes necesita OCR u otra etapa de visión. Los prompts extensos deben respetar los límites de contexto de Jev. Cualquier supuesto específico de GLM debe convertirse en preguntas de Jev, y las probabilidades históricas no pueden tratarse como calibraciones intercambiables.
¿GLM-5.3-Flash es una alternativa a Jev?
Sí para decisiones de texto con un conjunto finito de opciones, sobre todo si el mismo flujo también necesita imágenes. No si “alternativa” significa reemplazo directo con idénticos niveles de confianza y las mismas propiedades de infraestructura y cumplimiento. Cambian la forma de la API, el preprocesamiento, el ciclo de vida del modelo y los límites del despliegue.
No conviene abandonar Jev si la cola solo contiene texto, las etiquetas son estables, la precisión actual es aceptable y ahorrar fracciones de centavo por cada mil decisiones importa más que admitir entradas multimodales. Tampoco conviene abandonar Privatemode si las imágenes directas o su servicio europeo confidencial son requisitos innegociables. En cualquiera de las dos direcciones, una ventaja marginal en un benchmark público no basta para compensar el riesgo de migración.
La acción para el lunes
Congela el conjunto de evaluación antes de que alguien ajuste los prompts a los ejemplos que favorecen su opción preferida. Reúne en un único registro los 30 tickets sintéticos, las cinco facturas sintéticas, la taxonomía de opciones, las etiquetas esperadas, el costo supuesto de revisión y la región del cliente. Añade campos para la versión real del modelo, el endpoint, p50, p95, tokens, costo facturado, reintentos, errores con confianza alta y derivaciones.
Después, espera a contar con ambas credenciales y ejecuta la carga compartida. Hasta entonces, la decisión defendible es condicional: Jev domina el enrutamiento económico de texto; GLM-5.3-Flash mediante Privatemode Decisions domina la entrada directa de imágenes y la ruta de biblioteca portable.
Preguntas frecuentes
¿Cuáles son las diferencias clave entre GLM-5.3 y GLM-5.3 Flash?
En Privatemode, GLM-5.3 solo admite texto y cuesta €1.55 por millón de tokens de entrada y €7.74 por millón de tokens de salida. GLM-5.3-Flash acepta imágenes y cuesta €0.20 de entrada y €0.65 de salida por millón de tokens, por lo que Flash es la opción más barata y multimodal en ese servicio.
¿GLM Flash es bueno?
GLM-5.3-Flash es un candidato sólido cuando una tarea de decisión requiere imágenes, contexto extenso o el despliegue de Privatemode. Que sea “bueno” depende todavía de la precisión, los errores con confianza alta, la latencia y el costo por decisión correcta sobre las etiquetas propias.
¿GLM-5.3-Flash es de código abierto?
Los archivos del modelo se publican con licencia MIT. Eso responde a la pregunta sobre la licencia del modelo, pero la privacidad del despliegue y los términos del servicio siguen dependiendo de dónde y cómo se ejecute.
¿GLM-5.3-Flash admite imágenes?
Sí. La ficha oficial lo describe como multimodal nativo, y Privatemode incluye entrada de imágenes para su endpoint de GLM-5.3-Flash.
¿Qué significa GLM?
El artículo de investigación original desarrolla las siglas GLM como General Language Model.
¿GLM-5.3-Flash tiene capacidades de visión?
Sí. Puede recibir imágenes además de texto, por eso puede participar directamente en una prueba con documentos escaneados a la que Jev no puede acceder.
¿Cuántos parámetros tiene GLM-5.3-Flash?
La ficha oficial de Z.ai reporta 320 mil millones de parámetros totales y 18 mil millones de parámetros activos.
¿GLM-4.7-Flash es un MoE?
Sí, pero es otro modelo. Su ficha oficial describe una arquitectura mixture-of-experts 30B-A3B, así que sus especificaciones no deben trasladarse a GLM-5.3-Flash.
¿GLM-5.3-Flash es multimodal?
Sí. En esta comparativa, esa es la ventaja decisiva para clasificar documentos escaneados.
¿Buscas una forma más simple de ubicar ambas opciones en tu arquitectura? Descarga el Mapa de herramientas de IA para empresas y define la capa de decisión antes de añadir otro modelo.
- Última actualización
- 27 sept 2026
- Categoría
- AI
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.
Claude Opus 5 vs Opus 5.5: qué cambia y cuándo migrar
Claude Opus 5 frente a Opus 5.5: comparamos precio, programación y cambios de API para saber cuándo migrar y cuándo mantener el modelo anterior.23 sept 2026AI
Comparativa GPT-6 Sol vs Luna: cuál elegir
Compara GPT-6 Sol y Luna en precio, capacidad y programación. Descubre cuándo conviene empezar con Luna y qué tareas justifican pagar más por Sol.23 sept 2026AI
GPT-6 Luna gratis: acceso, límites y precio real
GPT-6 Luna se puede probar gratis en la app de escritorio. Conoce qué planes permiten usarlo, cuáles son sus límites y cuánto cuesta la API.22 sept 2026AI
Xiaomi MiMo API: cómo usar MiMo V2.6 paso a paso
Aprende a configurar Xiaomi MiMo API en Studio y Python, elegir la clave y el modelo correctos, y validar tu primer flujo empresarial con controles claros.22 sept 2026AI
Xiaomi MiMo V2.6: Pro o Flash, ¿cuál conviene?
Compara Xiaomi MiMo V2.6 Pro y Flash en calidad, precio, caché y programación para elegir el modelo que reduce el costo por resultado aceptado.22 sept 2026AI
MiMo V2.6 gratis: dónde usarlo y cuánto cuesta después
Descubre dónde usar MiMo V2.6 gratis, qué datos puede recopilar la promoción, cuánto cuesta la API de Xiaomi y cuándo conviene alojarlo por cuenta propia.22 sept 2026AI
Grok 4.7 vs Grok 4.6: cuál conviene y cuándo migrar
Grok 4.7 vs Grok 4.6: compare rendimiento, contexto, precios y costo por tarea para decidir qué modelo probar y qué flujos conviene mantener.21 sept 2026AI