GLM-5.3-Flash ou Jev: qual escolher para decisões de IA?
Compare Jev e GLM-5.3-Flash em preço, imagens, latência e privacidade para escolher a melhor opção em roteamento de tickets e triagem de documentos.

- JJev
- PPrivatemode Decisions
- GGLM-5.3-Flash
- Lllama.cpp
Escolha o Jev para roteamento de texto em grande volume quando o menor custo bruto de inferência for decisivo; prefira o GLM-5.3-Flash via Privatemode Decisions quando imagens, proximidade com a Europa, processamento confidencial ou portabilidade de modelos definirem o fluxo. Em um ticket de 500 tokens com quatro opções, os preços de tabela atuais resultam em cerca de $0.034 por 1,000 decisões com Jev, contra $0.146 pelo caminho da Privatemode. Mas basta uma fatura digitalizada para inviabilizar o Jev sem uma etapa separada de OCR.
Qual deles é a melhor escolha?
O Jev é a melhor escolha para classificar texto em escala: encaminhar um ticket de suporte, avaliar uma condição de política ou selecionar uma resposta dentro de um conjunto conhecido. O baixo preço de entrada lhe dá uma vantagem clara no custo bruto, enquanto a API especializada mantém simples a operação de decisão.
Escolha o GLM-5.3-Flash via Privatemode Decisions quando o contexto puder incluir uma imagem, o cliente estiver mais perto do serviço europeu da Privatemode, o processamento confidencial fizer parte dos critérios de compra ou houver interesse em direcionar a mesma biblioteca para outro servidor baseado em vLLM no futuro. Cada decisão de texto custa mais, mas o fluxo ganha entrada multimodal e uma implementação mais portátil.
Para uma fila de texto nos EUA, o Jev é o ponto de partida mais forte. Para uma fila de imagens na Alemanha, a rota da Privatemode leva vantagem. Se nenhum desses cenários representar o seu caso, não decida por uma tabela de recursos. Rode os mesmos casos rotulados nas duas opções e coloque preço nos erros e encaminhamentos, não apenas nos tokens.
Jev vs GLM-5.3-Flash: o que essa escolha realmente envolve
Jev e GLM-5.3-Flash não são dois modelos de chat equivalentes. O Jev é um modelo treinado especificamente para tomar decisões. Você envia um estado e uma pergunta tipada, como Choice ou Score, e a API devolve uma resposta com probabilidades e uma medida de confiança. O produto foi feito para o momento específico em que um software precisa escolher, não conversar.
O Privatemode Decisions é uma técnica implementada em biblioteca sobre um modelo de linguagem generalista. Ela apresenta opções nomeadas ao GLM-5.3-Flash, restringe o próximo token aos índices válidos, lê as probabilidades desses tokens e faz uma nova normalização. Uma única passagem pelo modelo e um token de saída transformam um modelo multimodal amplo em um seletor rápido e restrito.
Essa diferença muda a decisão de compra. O Jev é o serviço especializado. O Privatemode Decisions combina a camada de decisão com o modelo e o endpoint que a sustentam. A biblioteca pode apontar para um servidor vLLM compatível com OpenAI, enquanto o endpoint da própria Privatemode acrescenta sua implantação de computação confidencial. A portabilidade pertence à biblioteca; as garantias de processamento criptografado da Privatemode não acompanham automaticamente a migração para um servidor qualquer.
Há ainda uma armadilha nos nomes. A API Jev Decisions comparada aqui não é o produto Jev Router disponível na OpenRouter. Este último escolhe um modelo para um prompt. Se esse for o produto em avaliação, consulte o guia separado de preços do Jev Router. Misturar os dois produtos invalida qualquer comparação de custo e capacidade.
Jev leva vantagem no custo do roteamento de suporte por texto
O Jev se encaixa melhor em uma fila de tickets comuns de texto porque seu contrato já trabalha diretamente com decisões. A página de modelos da TypeSafe informa atualmente o jev-1.13.0 a $0.042 por milhão de tokens de entrada, sem cobrança pela saída. O alias jev-latest aponta hoje para essa versão, e a resposta inclui um campo model versionado que deve ser registrado no log do teste.
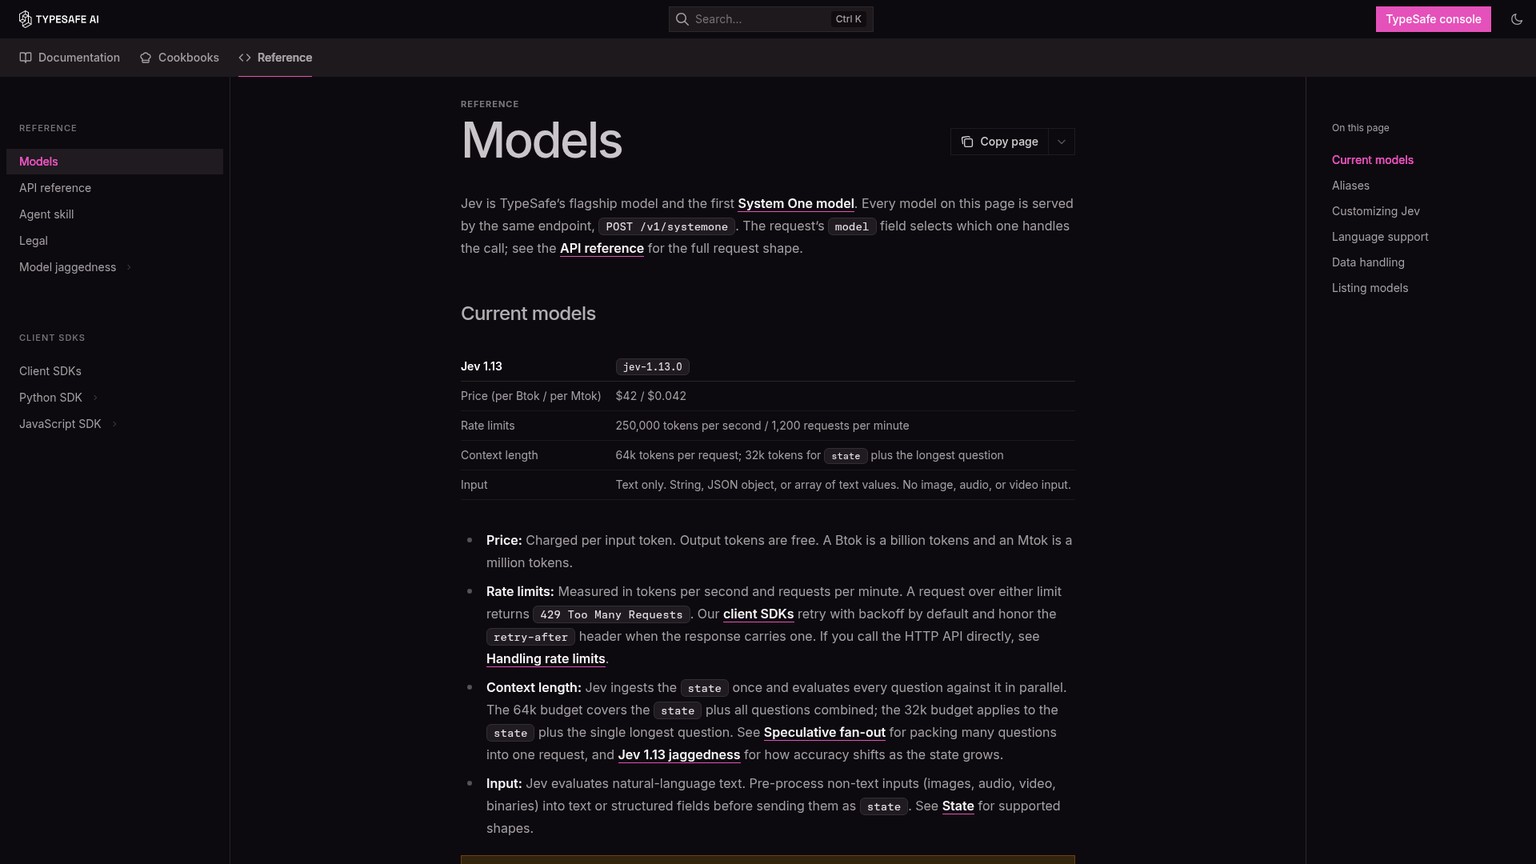
Uma chamada de roteamento de suporte pode enviar o ticket como estado e opções como cobrança, cancelamento, bug e nenhuma das anteriores. O Jev aceita strings e texto estruturado, como JSON ou arrays, mas não imagens, áudio ou vídeo. O limite por requisição é de 64,000 tokens, com um teto de 32,000 tokens para o estado somado à pergunta mais longa. É bastante espaço para rotear tickets, mas isso não converte um documento digitalizado anexado em texto.
A vantagem é econômica, não mágica. Pela estimativa de empacotamento do fornecedor, uma decisão com quatro opções acrescenta aproximadamente 270 tokens fixos e 10 por opção. Somando um ticket de 500 tokens, a entrada faturável chega a 810 tokens. No preço vigente, o custo é de $0.00003402 por decisão.
Para quem ainda não usa o Jev, o guia existente de roteamento de tickets de suporte com Jev explica a configuração da API. Esta comparação começa depois dessa etapa, no momento de decidir se um especialista limitado a texto ainda basta.
Vencedor da categoria: Jev para roteamento de suporte somente por texto e custo bruto de inferência.
Privatemode Decisions: GLM Flash como modelo de decisão
O Privatemode Decisions é o caminho mais adequado quando o próprio caso contém uma imagem ou quando a lógica de decisão precisa circular entre servidores de modelos compatíveis. O primeiro commit da biblioteca foi publicado em 21 de setembro de 2026. Os metadados da versão fixada indicam a versão 0.1.0, Python >=3.10 e um núcleo sem dependências.
O catálogo atual da Privatemode disponibiliza o GLM-5.3-Flash por endpoints de chat completions, completions e messages. O modelo aceita texto e imagens e oferece uma janela de contexto de 1 milhão de tokens. Seu model card oficial o descreve como um modelo mixture-of-experts multimodal nativo, com 320 bilhões de parâmetros totais e 18 bilhões ativos.
O nome do modelo é um detalhe crítico para a integridade do teste. O código de exemplo usa glm-flash-latest, um alias móvel. Hoje, ele aponta para a prévia glm-5.3-flash, mas isso não transforma toda execução futura em um teste do GLM-5.3-Flash. Resolva e registre o modelo efetivamente servido antes de coletar os resultados. A biblioteca também mantém os IDs dos tokens de opção em cache por 10 minutos para cada modelo; em um teste controlado, vale descartar uma troca de versão combinada com cache antigo.
O método de um token é eficiente, mas tem limites. As opções precisam corresponder a índices formados por um único token. A implementação aceita até 191 índices, enquanto uma pergunta com 151 opções exige duas leituras porque o endpoint hospedado devolve no máximo 128 IDs de tokens solicitados para log-probability em cada resposta. Isso sobra para taxonomias comuns de roteamento; diante de um espaço gigantesco e plano de rótulos, uma hierarquia pode ser a arquitetura mais adequada.
Vencedor da categoria: GLM-5.3-Flash via Privatemode Decisions para entrada de imagens, contexto e portabilidade em tempo de execução.
Acurácia depende da carga de trabalho, não da probabilidade
Nem uma probabilidade alta nem um benchmark abrangente provam que o próximo ticket será classificado corretamente. Os dois sistemas normalizam a confiança dentro da pergunta recebida. Se a resposta real não estiver entre as opções, o modelo ainda pode demonstrar muita confiança na alternativa disponível menos errada. Por isso, uma opção explícita none of these faz parte da definição da tarefa — não é apenas uma saída de emergência.
A comparação publicada pela Privatemode incluiu 29 conjuntos públicos de dados rotulados, e os dois sistemas conseguiram responder a 28 conjuntos de texto. Cada um liderou em 10, enquanto outros oito ficaram separados por até um ponto percentual. A diferença mediana informada foi de 0.7 ponto percentual a favor do Jev, com p=0.64. Repetições idênticas com temperatura zero alteraram até 3.5% das respostas, motivo pelo qual o fornecedor tratou diferenças pequenas como ruído. São medições úteis divulgadas pelo fornecedor, não um benchmark realizado para este artigo.
Um benchmark independente de Kumzha testou 200 itens rotulados por pessoas em cada tarefa. Ele informou acurácia de 83.5% no Banking77 para o GLM-5.3-Flash e 81.5% para o Jev 1.13; na classificação de injeção de prompt, os números foram 91.0% e 86.0%. A evidência é independente, mas não valida o Privatemode Decisions. A trilha do GLM usou geração restrita comum pela OpenRouter com baixo nível de raciocínio, enquanto o Jev acessou diretamente uma origem da AWS no Oregon. Os caminhos de latência e os métodos de decisão eram diferentes.
A conclusão útil é intencionalmente contida: as evidências publicadas não apontam um vencedor universal em acurácia. Elas mostram, porém, que os dois caminhos merecem um teste com os seus rótulos. O placar deve separar uma escolha errada comum de uma escolha errada com alta confiança, pois esta última tem mais chance de escapar da revisão humana.
Vencedor da categoria: não existe vencedor geral em acurácia de texto publicada. Jev ou GLM só vence depois que a mesma carga rotulada passa pelos dois.
A latência muda conforme a região do cliente
Antes de ser resultado do modelo, a latência é resultado da geografia. Na medição simultânea da Privatemode em quatro conjuntos de dados, as medianas na Alemanha foram de 180 ms para a Privatemode e 264 ms para o Jev. Para um cliente nos EUA, a ordem se inverteu: 299 ms para a Privatemode e 164 ms para o Jev.
Separadamente, o repositório descreve cerca de 150 ms como o tempo típico de uma decisão da Privatemode, já incluindo a rede. É uma boa referência inicial, mas não se trata da mesma medição do teste regional com quatro conjuntos de dados. Considere o destaque do repositório e o teste do blog como duas visões distintas informadas pelo fornecedor, não como um benchmark combinado.
Para uma equipe de suporte em Frankfurt, a rota europeia da Privatemode apresenta a latência publicada mais favorável. Para um worker nos EUA, o Jev tem a melhor mediana informada pelo fornecedor. O teste adequado fixa a região do cliente e registra p50 e p95, porque uma fila sente a cauda lenta, não apenas a requisição mediana.
Vencedor da categoria: Privatemode nos testes informados para a Alemanha; Jev no teste informado para os EUA.
Diferença de preço e por que não há ponto de equilíbrio
Os preços vigentes verificados em 27 de setembro de 2026 são diretos. O Jev 1.13 custa $0.042 por milhão de tokens de entrada, com saída gratuita. A tabela de preços da Privatemode informa o GLM-5.3-Flash a €0.20 por milhão de tokens de entrada, €0.65 por milhão de tokens de saída e €0.05 por milhão de tokens de entrada em cache, além de IVA quando aplicável. Para uma comparação equivalente em dólares, o cálculo abaixo usa a taxa de referência do BCE de 25 de setembro: €1 para $1.1403.
A decisão comum considera 500 tokens de estado e quatro opções, incluindo none of these. Com o empacotamento de prompt informado pelo fornecedor, o Jev envia cerca de 810 tokens de entrada. O Privatemode Decisions envia aproximadamente 635 tokens de entrada e gera um token de saída. Embora o GLM empacote menos tokens nesse cenário, sua tarifa convertida por token de entrada é cerca de 5.43 vezes a do Jev. Com isso, cada decisão fica aproximadamente 4.28 vezes mais cara.
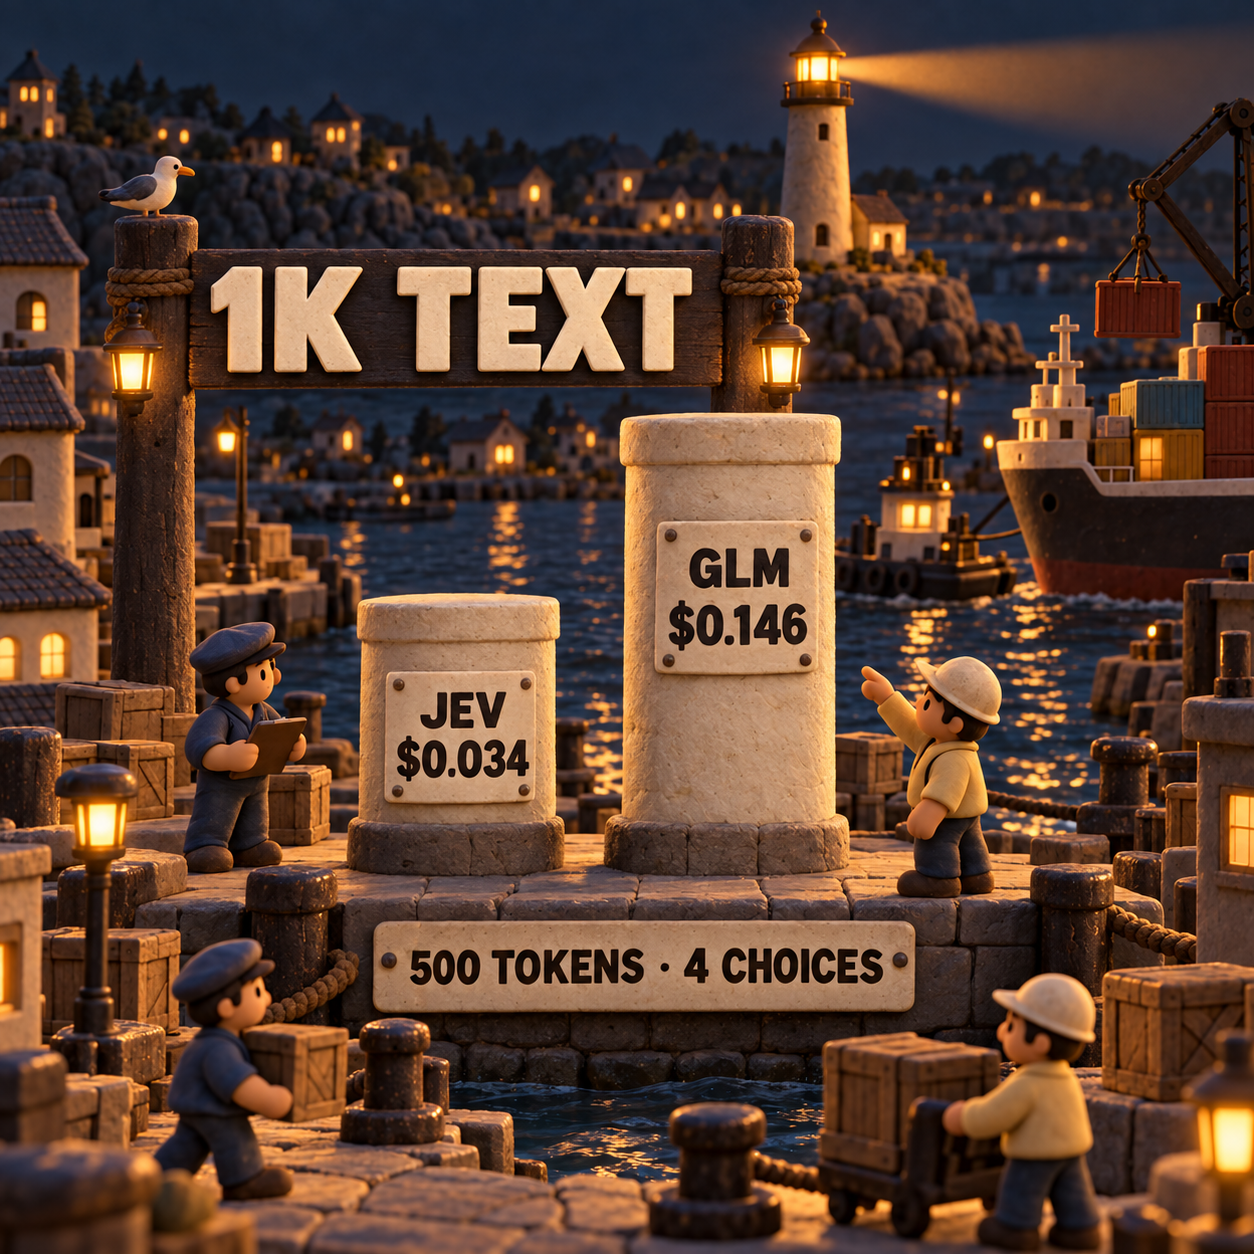
Não existe um ponto de equilíbrio não negativo em tokens brutos com esses preços de tabela e estimativas lineares de empacotamento. Apesar de o prompt da Privatemode permanecer menor abaixo de aproximadamente 21 opções, a diferença entre as tarifas é grande demais para que as linhas se cruzem. Se os dois caminhos entregarem o mesmo resultado operacional, o Jev continuará mais barato.
Mas a inferência não é a conta inteira. Em 100,000 decisões comuns, a diferença bruta fica em cerca de $11.1539. Suponha que uma revisão custe $30 por hora e leve dois minutos, ou $1 por encaminhamento. A Privatemode precisaria evitar 12 encaminhamentos humanos a cada 100,000 decisões para compensar o adicional de inferência. Esse é um cenário, não uma afirmação de que ela faça isso.
Esta é a métrica que importa: (inference cost + review cost + retry cost) / correct decisions. Uma chamada mais barata pode perder se gerar mais escalonamentos. Uma chamada mais cara pode vencer se processar uma imagem sem um serviço separado de OCR. Sem credenciais para os dois lados, não há como publicar com honestidade um custo observado por decisão correta.
Vencedor da categoria: Jev no custo bruto de texto. O vencedor do fluxo depende de erros medidos, novas tentativas, OCR e revisão humana.
Imagens mudam o vencedor na triagem de documentos
O GLM-5.3-Flash vence a comparação de entrada direta para faturas digitalizadas porque a Privatemode aceita imagens e o Jev não. É um limite de capacidade, não uma diferença pequena de recurso. Um fluxo com Jev precisa de OCR ou de outro modelo de visão antes da chamada de decisão, o que acrescenta um segundo fornecedor, outro ponto de falha, mais latência e um custo próprio.
A Privatemode informa acurácia de 70.2% em 1,600 documentos digitalizados do RVL-CDIP, distribuídos em 16 classes. O Jev não pôde participar desse teste com imagens. Segundo o fornecedor, cada imagem acrescentou cerca de 1,350 tokens de entrada, com custo estimado de aproximadamente €270 para 1 milhão de decisões sobre documentos. Esses resultados confirmam que a rota aceita documentos digitalizados; não demonstram como ela se sairá com as suas faturas.
Mantenha cinco faturas sintéticas em um teste de capacidade separado. Considerando a base comum de 500 tokens mais o acréscimo informado de 1,350 tokens por imagem, uma decisão na Privatemode custaria cerca de €0.00039765, ou $0.00045344; cinco custariam aproximadamente €0.00198825, ou $0.0022672. Não misture esses cinco resultados ao placar de acurácia dos 30 tickets de texto. Caso contrário, o GLM receberá crédito por entrar em um teste que o Jev não pode fazer, e a comparação de texto ficará impossível de interpretar.
Vencedor da categoria: GLM-5.3-Flash na triagem direta de imagens de documentos.
Antes de migrar, rode o mesmo teste com 30 tickets
A menor comparação interna que ainda oferece alguma credibilidade usa um conjunto congelado de 30 tickets sintéticos rotulados, repetido com opções e ordem idênticas e uma alternativa explícita none of these. Os casos sintéticos evitam o envio de dados de clientes durante a avaliação. Ainda assim, devem representar os tickets curtos, ambíguos e fora de escopo que derrubam um roteador em produção.
Congele o conjunto de teste
Reúna 30 tickets de texto, os rótulos esperados e as opções permitidas em um único arquivo versionado. Inclua
none of these, mantenha fixa a ordem das opções e reserve as cinco imagens de faturas como um conjunto de capacidade separado.Registre o que cada endpoint serviu
Chame o
jev-1.13.0versionado ou registre o campomodeldevolvido pelo Jev. Resolvaglm-flash-lateste anote o modelo efetivamente servido antes de chamar o resultado de teste do GLM-5.3-Flash. Registre também o endpoint e a região do cliente nos dois casos.Repita decisões idênticas
Envie o mesmo estado e opções semanticamente idênticas para os dois caminhos. Não melhore discretamente um dos prompts, altere a ordem de um conjunto de rótulos nem contabilize novas tentativas em apenas um lado.
Capture o registro operacional
Em cada chamada, salve a latência p50 e p95 no nível da execução, os tokens de entrada, o custo faturado, a opção selecionada, a probabilidade ou confiança, o acerto, a nova tentativa e o encaminhamento humano. Sinalize separadamente as escolhas erradas com alta confiança.
Teste imagens fora do placar de texto
Envie cinco imagens de faturas sintéticas pela Privatemode. Registre modelo, tokens, custo, latência e rótulo. Marque o Jev como não qualificado para entrada direta, em vez de pontuá-lo como um classificador de texto que errou.
Calcule o custo por decisão correta
Some os custos de inferência, novas tentativas, pré-processamento e revisão humana e divida pelo total de decisões corretas. Apresente separadamente o resultado compartilhado dos 30 tickets de texto e o resultado de capacidade das cinco imagens.
A inferência bruta para a execução de texto planejada custaria cerca de $0.0010206 no Jev, contra €0.0038295, ou $0.0043668, na Privatemode antes de novas tentativas. A diferença é pequena demais para decidir uma compra. O valor da execução está em revelar a adequação dos rótulos, a calibração, a cauda regional de latência e o comportamento dos encaminhamentos.
Custos de migração e quem não deve trocar
Sair do Jev para o Privatemode Decisions não se resume a trocar o nome do modelo. Uma Choice ou Score do Jev vira uma Choice da biblioteca com índices fixos para as opções. A equipe precisa mapear a taxonomia existente, recriar os limites de confiança, substituir o cliente e o comportamento de novas tentativas, validar o endpoint compatível com OpenAI e tornar observável a resolução do alias. Se o processamento confidencial motivou a mudança, a implantação deve permanecer no caminho coberto pela Privatemode, e não em um host vLLM qualquer.
O movimento inverso também exige trabalho. O estado em imagem passa a precisar de OCR ou de outra etapa de visão. Prompts longos precisam caber nos limites de contexto do Jev. Toda suposição de prompt específica do GLM deve ser convertida em perguntas para o Jev, e as probabilidades históricas não podem ser tratadas como calibrações intercambiáveis.
O GLM-5.3-Flash é uma alternativa ao Jev?
Sim, para decisões de texto com um conjunto finito de opções — sobretudo quando o mesmo fluxo também precisa de imagens. Não, se “alternativa” significar uma substituição direta, com confiança, infraestrutura e propriedades de conformidade idênticas. O formato da API, o pré-processamento, o ciclo de vida do modelo e o perímetro de implantação mudam.
Não abandone o Jev se a fila aceitar apenas texto, os rótulos forem estáveis, a acurácia atual for satisfatória e economizar frações de centavo a cada mil decisões importar mais do que a entrada multimodal. Também não deixe a Privatemode se imagens diretas ou o serviço europeu confidencial forem requisitos rígidos. Nos dois sentidos, uma vantagem marginal em benchmarks públicos não compensa o risco da migração.
O que fazer na segunda-feira
Congele o conjunto de avaliação antes que alguém ajuste os prompts em torno dos exemplos preferidos. Coloque os 30 tickets sintéticos, cinco faturas sintéticas, a taxonomia de opções, os rótulos esperados, a premissa de custo de revisão e a região do cliente em um único registro de teste. Adicione campos para a versão efetiva do modelo, endpoint, p50, p95, tokens, custo faturado, novas tentativas, escolhas erradas com alta confiança e encaminhamentos.
Em seguida, aguarde as duas credenciais e execute a carga compartilhada. Até lá, a decisão defensável é condicional: o Jev domina o roteamento barato de texto; o GLM-5.3-Flash via Privatemode Decisions domina a entrada direta de imagens e a rota de biblioteca portátil.
Perguntas frequentes
Quais são as principais diferenças entre GLM-5.3 e GLM-5.3-Flash?
Na Privatemode, o GLM-5.3 aceita apenas texto e custa €1.55 por milhão de tokens de entrada e €7.74 por milhão de tokens de saída. O GLM-5.3-Flash aceita imagens e custa €0.20 pela entrada e €0.65 pela saída por milhão de tokens. Portanto, o Flash é a opção mais barata e multimodal nesse serviço.
O GLM Flash é bom?
O GLM-5.3-Flash é um candidato sólido quando uma tarefa de decisão exige imagens, contexto longo ou a implantação da Privatemode. Ainda assim, ser “bom” depende da acurácia, dos erros com alta confiança, da latência e do custo por decisão correta nos seus próprios rótulos.
O GLM-5.3-Flash é open source?
Os arquivos do modelo são publicados sob a licença MIT. Isso responde à questão da licença do modelo, mas a privacidade da implantação e os termos do serviço ainda dependem de onde e como ele é executado.
O GLM-5.3-Flash aceita imagens?
Sim. O model card oficial o descreve como multimodal nativo, e a Privatemode inclui entrada de imagens no endpoint do GLM-5.3-Flash.
O que significa GLM?
O artigo científico original define GLM como General Language Model.
O GLM-5.3-Flash tem recursos de visão?
Sim. Ele recebe imagens e texto, razão pela qual pode participar de um teste com documentos digitalizados no qual o Jev não consegue entrar diretamente.
Quantos parâmetros tem o GLM-5.3-Flash?
O model card oficial da Z.ai informa 320 bilhões de parâmetros totais e 18 bilhões de parâmetros ativos.
O GLM-4.7-Flash é um MoE?
Sim, mas é outro modelo. Seu card oficial descreve uma arquitetura mixture-of-experts 30B-A3B; portanto, não transfira essas especificações para o GLM-5.3-Flash.
O GLM-5.3-Flash é multimodal?
Sim. Nesta comparação, essa é a vantagem decisiva na triagem de documentos digitalizados.
Quer uma forma mais simples de posicionar as duas opções na sua stack? Baixe o Mapa de ferramentas de IA para empresários e organize a camada de decisão antes de adicionar outro modelo.
- Última atualização
- 27 de set. de 2026
- Categoria
- AI
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.
Claude Opus 5.5 vs Opus 5: qual vale mais a pena?
Claude Opus 5.5 reduz preços e avança nos benchmarks publicados, mas traz mudanças na API. Compare custos, desempenho e riscos antes de migrar.23 de set. de 2026AI
GPT-6 Sol ou Luna: qual escolher e quando pagar mais
Compare GPT-6 Sol e Luna em preço, programação e adequação à tarefa — e veja quando a qualidade do Sol realmente compensa o custo 20× maior.23 de set. de 2026AI
GPT-6 Luna grátis: onde usar e quanto custa
O GPT-6 Luna é grátis no app para desktop, mas Work, Codex e API seguem regras diferentes. Veja acesso, preços, limites e quando vale pagar.22 de set. de 2026AI
Xiaomi MiMo: como usar o MiMo-V2.6 na prática
Aprenda a testar o Xiaomi MiMo no Studio, configurar a API do MiMo-V2.6, escolher entre Flash e Pro e levar o fluxo à produção com segurança.22 de set. de 2026AI
Xiaomi MiMo V2.6: Pro ou Flash? O custo decide
Compare Xiaomi MiMo V2.6 Pro e Flash em preço, benchmarks, cache e qualidade. Veja quando pagar pelo Pro e quando manter o Flash como padrão.22 de set. de 2026AI
MiMo V2.6 grátis: o que custa zero e o que é pago
Entenda onde o MiMo V2.6 é grátis, quando a promoção termina, o que a licença MIT cobre e quanto custam as APIs Flash, Pro e UltraSpeed na prática.22 de set. de 2026AI
Grok 4.7 vs Grok 4.6: qual modelo escolher?
Grok 4.7 vs Grok 4.6: compare desempenho, preços da API, contexto e custos de migração para decidir qual modelo usar em cada carga de trabalho.21 de set. de 2026AI