Jev o GLM-5.3-Flash: quale scegliere per il routing AI?
Confronto tra Jev e GLM-5.3-Flash su costi, accuratezza, latenza, immagini e portabilità, con un test pratico per scegliere il workflow giusto.

- JJev
- PPrivatemode Decisions
- GGLM-5.3-Flash
- Lllama.cpp
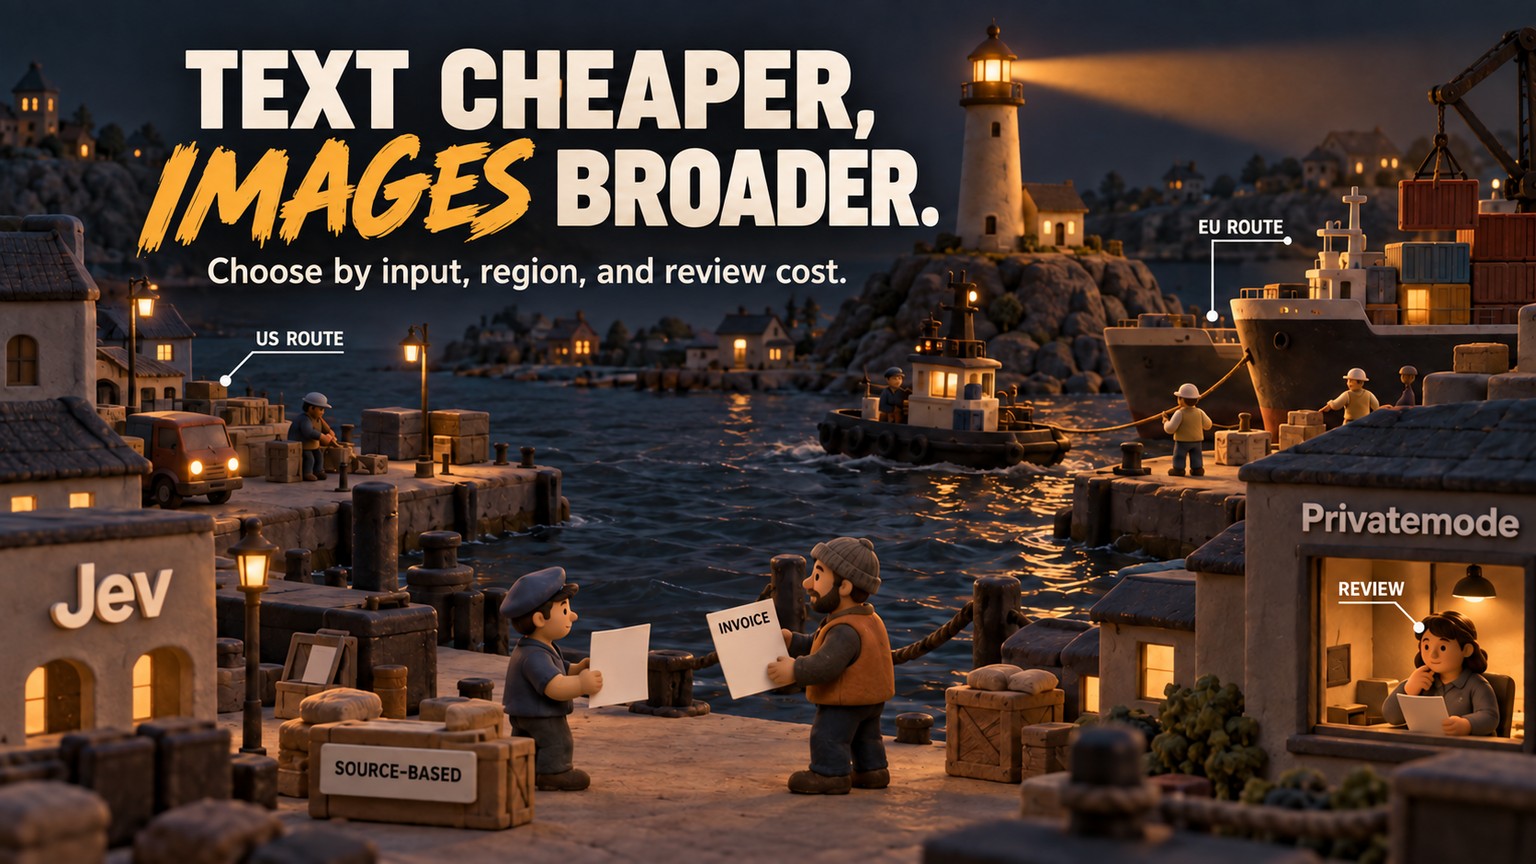
Scegli Jev per il routing testuale ad alto volume quando conta soprattutto ridurre al minimo il costo puro di inferenza. Scegli GLM-5.3-Flash tramite Privatemode Decisions quando il flusso dipende da immagini, vicinanza geografica all’infrastruttura europea, elaborazione riservata o portabilità del modello. Per un ticket da 500 token e quattro opzioni, ai prezzi di listino attuali 1,000 decisioni costano circa $0.034 con Jev e $0.146 passando da Privatemode; basta però una fattura scansionata per escludere Jev, a meno di aggiungere prima un passaggio OCR.
Quale soluzione conviene scegliere?
Jev è la scelta più lineare per classificare grandi volumi di solo testo: smistare un ticket di assistenza, valutare una condizione prevista da una policy o selezionare una risposta all’interno di un insieme noto. Il basso prezzo dei token in input gli assicura il vantaggio sul costo puro, mentre l’API specializzata mantiene essenziale la logica decisionale.
GLM-5.3-Flash tramite Privatemode Decisions è più adatto quando lo stato può includere un’immagine, il client si trova più vicino al servizio europeo di Privatemode, l’elaborazione riservata è un requisito d’acquisto oppure si vuole conservare la possibilità di indirizzare la stessa libreria verso un altro server basato su vLLM. Ogni decisione testuale costa di più, ma in cambio si ottengono input multimodali e un’implementazione più portabile.
Per una coda testuale gestita dagli Stati Uniti, Jev è il punto di partenza più solido. Per una coda di immagini gestita dalla Germania, è preferibile il percorso Privatemode. Se nessuno dei due profili descrive il caso reale, una tabella di funzionalità non basta: occorre sottoporre a entrambi gli stessi esempi etichettati e quantificare errori e passaggi all’operatore, non soltanto i token.
Jev e GLM-5.3-Flash: cosa cambia davvero nella scelta
Jev e GLM-5.3-Flash non sono due chatbot intercambiabili. Jev è un modello addestrato appositamente per prendere decisioni. Si inviano uno stato e una domanda tipizzata, per esempio Choice o Score, e l’API restituisce una risposta con probabilità e un indicatore di confidenza. È pensato per il momento circoscritto in cui il software deve scegliere, non conversare.
Privatemode Decisions è invece una tecnica implementata come libreria sopra un modello linguistico generalista. Presenta a GLM-5.3-Flash opzioni con un nome, limita il token successivo agli indici validi, legge le probabilità di quei token e le normalizza nuovamente. Un solo forward pass e un solo token in output trasformano un ampio modello multimodale in un selettore vincolato e rapido.
Questa differenza cambia la domanda d’acquisto. Jev è il servizio specializzato; Privatemode Decisions è il livello decisionale, insieme al modello e all’endpoint che lo sostengono. La libreria può puntare a un server vLLM compatibile con OpenAI, mentre l’endpoint di Privatemode aggiunge la propria infrastruttura di confidential computing. La portabilità appartiene alla libreria; le garanzie di elaborazione cifrata di Privatemode non si trasferiscono automaticamente a un server qualsiasi.
C’è anche un possibile equivoco nel nome. L’API Jev Decisions confrontata qui non è il prodotto su OpenRouter chiamato Jev Router, che sceglie un modello in base al prompt. Se è quello il prodotto in valutazione, va consultata la guida separata sui prezzi di Jev Router. Confondere i due prodotti rende errato qualsiasi confronto tra costi e capacità.
Jev vince sul costo del routing dei ticket testuali
Per una coda di normali ticket testuali, Jev offre l’incastro più naturale perché il suo contratto API è già espresso in termini di decisioni. La pagina dei modelli TypeSafe indica attualmente jev-1.13.0 a $0.042 per milione di token in input, senza costi per l’output. L’alias jev-latest al momento risolve proprio a questa versione; la risposta include inoltre un campo model versionato, da registrare nel log dei test.
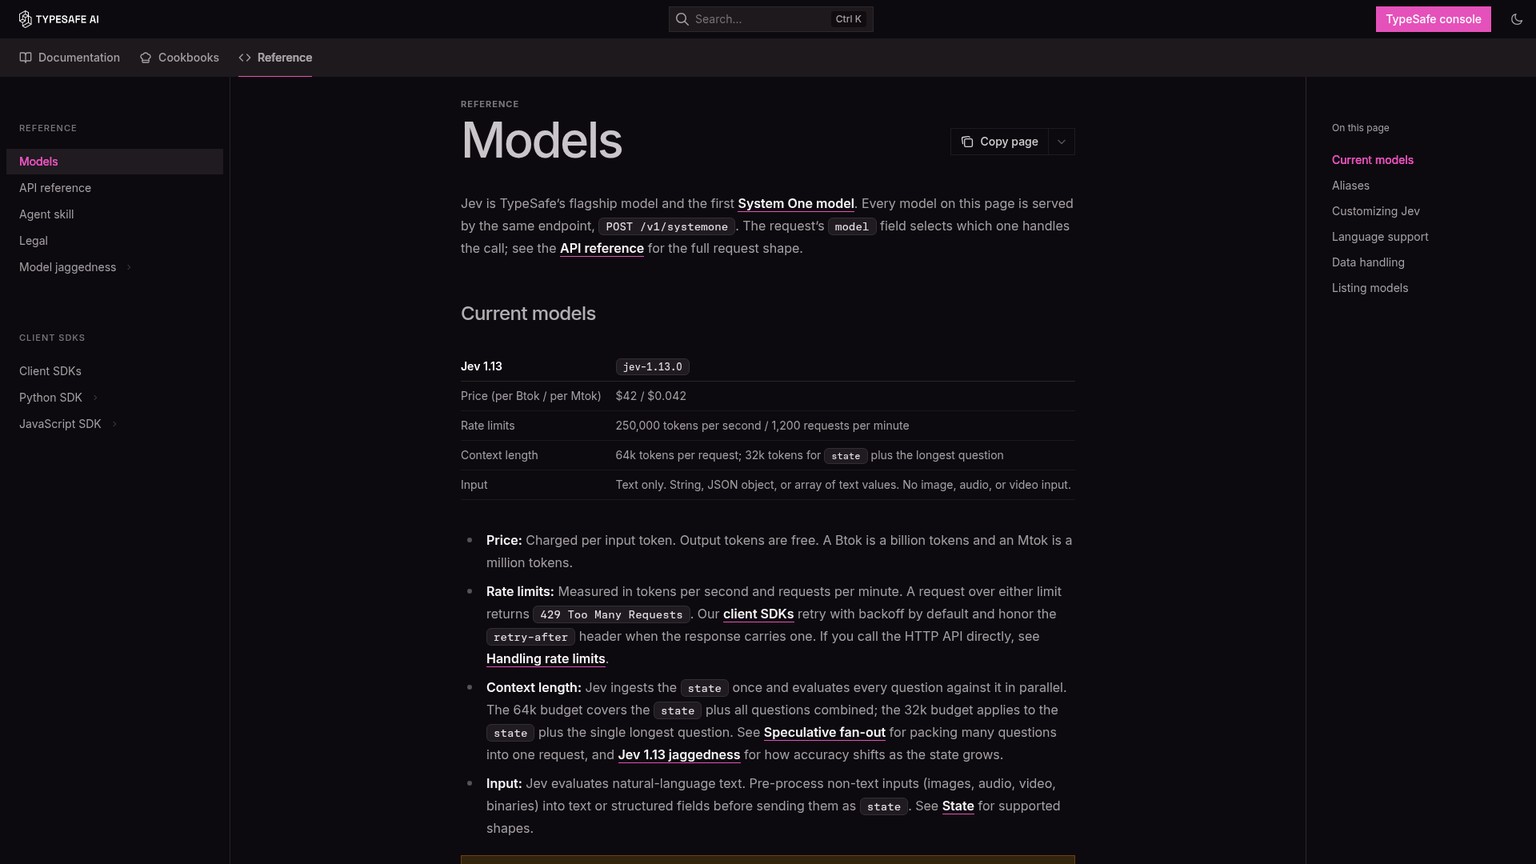
Una chiamata per il routing dell’assistenza può includere il ticket nello stato e opzioni come fatturazione, cancellazione, bug e nessuna delle precedenti. Jev accetta stringhe e testo strutturato, tra cui JSON o array, ma non immagini, audio o video. Il limite per richiesta è di 64,000 token, con un tetto di 32,000 token per lo stato più la domanda più lunga. Sono limiti generosi per smistare ticket, ma non trasformano una scansione allegata in testo.
Il vantaggio è economico, non misterioso. Secondo la stima del vendor sul confezionamento del prompt, una decisione con quattro opzioni aggiunge circa 270 token fissi più 10 per opzione. Con un ticket da 500 token, l’input fatturabile arriva quindi a 810 token. Al prezzo attuale, il costo è di $0.00003402 per decisione.
Se Jev è una novità nello stack, la guida già disponibile sul routing dei ticket di assistenza con Jev spiega come configurare l’API. Questo confronto parte dal passaggio successivo: stabilire se uno specialista di solo testo sia ancora sufficiente.
Vincitore di categoria: Jev per il routing dell’assistenza basato solo su testo e per il costo puro di inferenza.
Privatemode Decisions: GLM Flash come modello decisionale
Privatemode Decisions offre il percorso più adatto quando il caso contiene un’immagine o quando serve una logica decisionale trasferibile tra server di modelli compatibili. Il primo commit della libreria risale al 21 settembre 2026. I metadati della versione fissata indicano 0.1.0, Python >=3.10 e un nucleo senza dipendenze.
Il catalogo Privatemode attivo espone GLM-5.3-Flash tramite endpoint chat completions, completions e messages. Accetta testo e immagini, con una finestra di contesto da 1 milione di token. La model card ufficiale lo descrive come un modello mixture-of-experts multimodale nativo, con 320 miliardi di parametri totali e 18 miliardi attivi.
Per l’integrità del test, il nome del modello è un dettaglio decisivo. Il codice di esempio usa glm-flash-latest, un alias mobile. Oggi corrisponde alla preview glm-5.3-flash, ma ciò non significa che ogni esecuzione futura utilizzerà GLM-5.3-Flash. Prima di raccogliere i risultati bisogna risolvere e registrare il modello effettivamente servito. La libreria memorizza inoltre nella cache gli ID token delle opzioni per 10 minuti per ogni modello: durante un test controllato conviene quindi escludere sia un cambio di versione sia una cache obsoleta.
Il metodo a un solo token è efficiente, ma presenta alcuni vincoli. Le opzioni devono corrispondere a indici rappresentabili con un singolo token. L’implementazione gestisce fino a 191 indici, mentre una domanda con 151 opzioni richiede due letture perché l’endpoint in hosting restituisce al massimo 128 ID token di log-probabilità richiesti in una singola risposta. È più che sufficiente per le comuni tassonomie di routing; per uno spazio di etichette enorme e piatto, una gerarchia può essere una soluzione migliore.
Vincitore di categoria: GLM-5.3-Flash tramite Privatemode Decisions per input di immagini, ampiezza del contesto e portabilità del runtime.
L’accuratezza dipende dal carico di lavoro, non dalla probabilità
Né una probabilità elevata né un benchmark ampio dimostrano che il ticket successivo verrà classificato correttamente. Entrambi i sistemi normalizzano la confidenza rispetto alla domanda ricevuta. Se manca la risposta corretta, il modello può comunque assegnare grande sicurezza all’opzione fornita meno sbagliata. Inserire esplicitamente none of these fa quindi parte della definizione del compito: non è una via di fuga facoltativa.
Il confronto pubblicato da Privatemode ha esaminato 29 dataset pubblici etichettati; entrambi i sistemi erano in grado di rispondere a 28 dataset testuali. Ciascuno ha prevalso su 10, mentre in altri otto la differenza è rimasta entro un punto percentuale. Il divario mediano riportato era di 0.7 punti percentuali a favore di Jev, con p=0.64. Ripetendo esecuzioni identiche a temperatura zero è cambiato fino al 3.5% delle risposte, perciò il vendor ha trattato gli scarti ridotti come rumore. Sono misurazioni utili dichiarate dal vendor, non il benchmark di questo articolo.
Un benchmark indipendente di Kumzha ha utilizzato 200 elementi etichettati da persone per ciascun compito. Ha riportato un’accuratezza dell’83.5% su Banking77 per GLM-5.3-Flash e dell’81.5% per Jev 1.13; nella classificazione della prompt injection, i risultati sono stati rispettivamente 91.0% e 86.0%. La fonte è indipendente, ma non convalida Privatemode Decisions. Il percorso GLM impiegava una normale generazione vincolata tramite OpenRouter con reasoning basso, mentre Jev interrogava direttamente un’origine AWS in Oregon. Sia i percorsi di latenza sia i metodi decisionali erano diversi.
La conclusione utile è volutamente prudente: le prove pubblicate non individuano un vincitore universale per accuratezza. Dimostrano però che entrambi i percorsi sono abbastanza credibili da meritare un test sulle proprie etichette. La scheda di valutazione dovrebbe distinguere un semplice errore da un errore commesso con alta confidenza, perché quest’ultimo ha maggiori probabilità di evitare la revisione umana.
Vincitore di categoria: nessun vincitore generale per l’accuratezza sul testo. Jev o GLM prevalgono soltanto dopo aver riprodotto su entrambi lo stesso carico etichettato.
La latenza cambia in base alla regione del client
Prima ancora che dal modello, la latenza dipende dalla geografia. Nella misurazione simultanea di Privatemode su quattro dataset, le mediane rilevate in Germania erano 180 ms per Privatemode e 264 ms per Jev. Per un client negli Stati Uniti, l’ordine si invertiva: 299 ms per Privatemode e 164 ms per Jev.
Il repository descrive separatamente una tipica decisione Privatemode come un’operazione da circa 150 ms, tempo di rete incluso. È un riferimento orientativo utile, ma non coincide con il test regionale sui quattro dataset. Il dato in evidenza nel repository e il test del blog vanno considerati due rilevazioni distinte dichiarate dal vendor, non un unico benchmark.
Per un centro assistenza a Francoforte, il percorso europeo di Privatemode presenta la latenza pubblicata più favorevole. Per un worker negli Stati Uniti, la mediana dichiarata dal vendor favorisce Jev. Un test corretto mantiene fissa la regione del client e registra sia p50 sia p95, perché una coda risente della lunga coda di latenza, non solo della richiesta mediana.
Vincitore di categoria: Privatemode nei test pubblicati dalla Germania; Jev nel test pubblicato dagli Stati Uniti.
Differenza di prezzo e assenza di un punto di pareggio
I prezzi attivi verificati il 27 settembre 2026 sono chiari. Jev 1.13 costa $0.042 per milione di token in input e non addebita l’output. Il listino di Privatemode fissa GLM-5.3-Flash a €0.20 per milione di token in input, €0.65 per milione di token in output e €0.05 per milione di token in input dalla cache, oltre all’IVA ove applicabile. Per confrontare valori omogenei in USD, il calcolo seguente usa il tasso di riferimento BCE del 25 settembre, pari a €1 per $1.1403.
La decisione comune presuppone 500 token di stato e quattro opzioni, compresa none of these. In base al confezionamento del prompt dichiarato dal vendor, Jev invia circa 810 token in input. Privatemode Decisions ne invia circa 635 e genera un token in output. In questo scenario GLM utilizza meno token, ma il suo costo convertito per token in input è circa 5.43 volte quello di Jev. Il risultato è una decisione circa 4.28 volte più costosa.
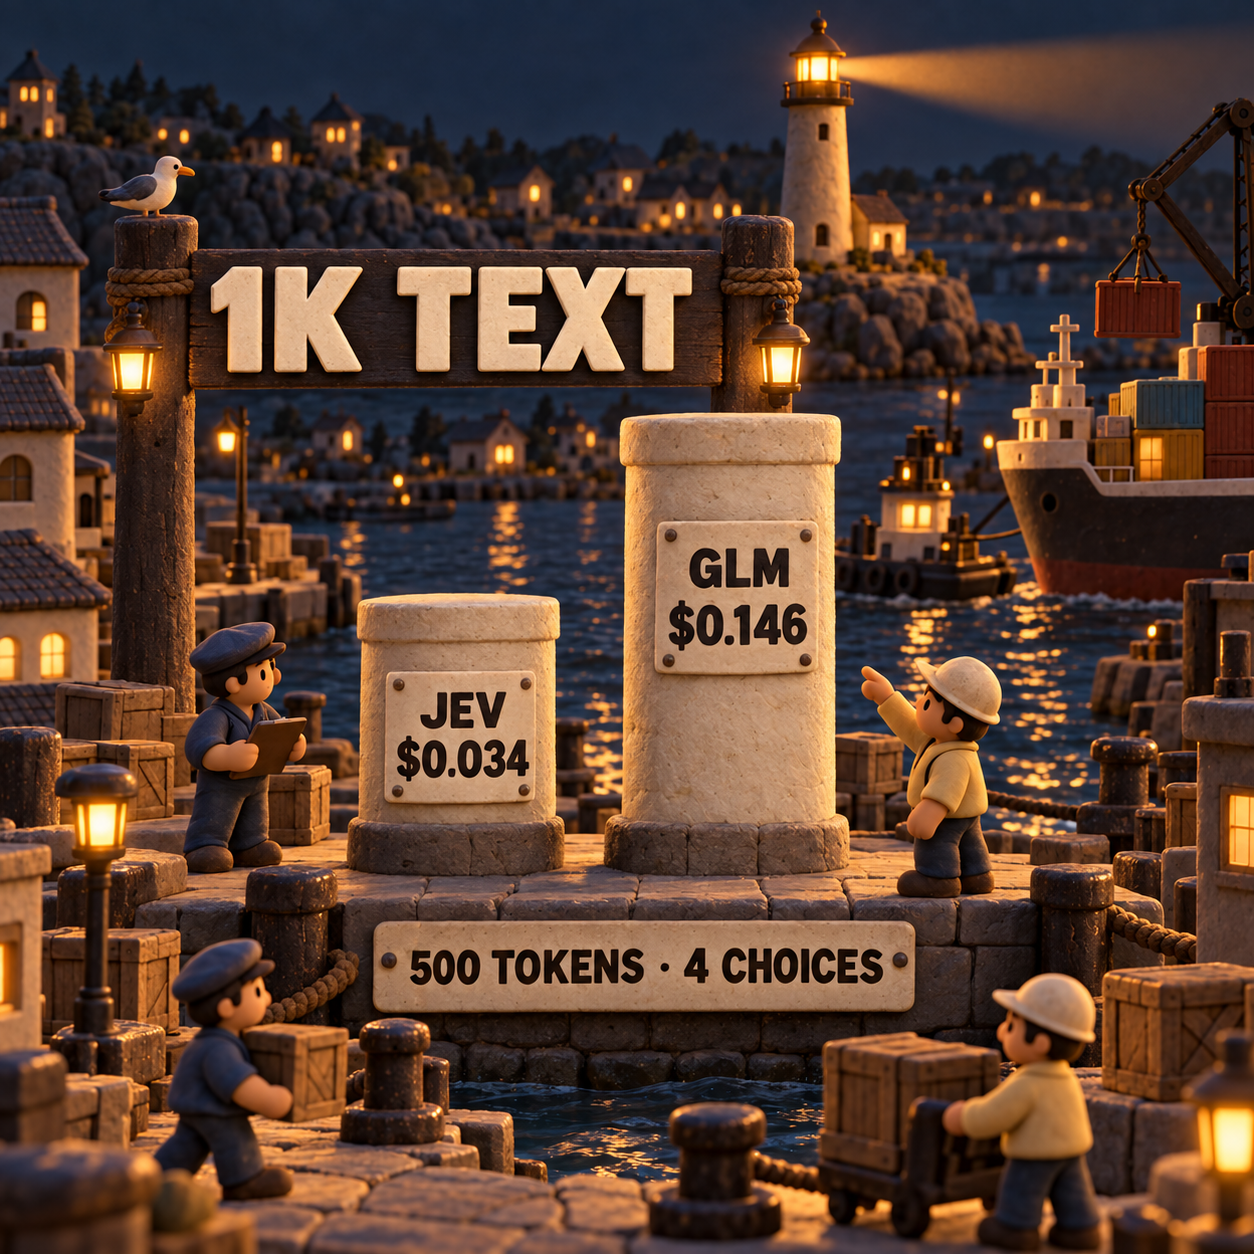
Con questi listini e le stime lineari di confezionamento non esiste un punto di pareggio non negativo per i token grezzi. Anche se sotto le 21 opzioni il prompt di Privatemode rimane più corto, la differenza tariffaria è troppo ampia perché le due rette si incontrino. A parità di risultato operativo, Jev resta più economico.
L’inferenza, però, non è l’intera fattura. Su 100,000 decisioni comuni, la differenza grezza è di circa $11.1539. Supponiamo che una revisione costi $30 l’ora e richieda due minuti, cioè $1 per passaggio all’operatore. Per recuperare il sovrapprezzo di inferenza, Privatemode dovrebbe evitare 12 passaggi umani ogni 100,000 decisioni. È uno scenario, non l’affermazione che ciò accada davvero.
La metrica da presidiare è questa: (inference cost + review cost + retry cost) / correct decisions. Una chiamata più economica può risultare perdente se genera più escalation. Una chiamata più costosa può vincere se gestisce un’immagine senza un servizio OCR separato. Senza le credenziali di entrambi, non è possibile pubblicare in modo rigoroso un costo osservato per decisione corretta.
Vincitore di categoria: Jev sul costo puro del testo. Il vincitore del workflow dipende da errori, tentativi, OCR e revisione umana misurati.
Con le immagini cambia il vincitore nel triage documentale
GLM-5.3-Flash vince il confronto sull’input diretto delle fatture scansionate, perché Privatemode accetta immagini e Jev no. È un limite di capacità, non una piccola differenza funzionale. Un workflow Jev richiede prima OCR o un altro modello di visione, aggiungendo un secondo fornitore, un’ulteriore modalità di errore, più latenza e un costo proprio.
Privatemode dichiara un’accuratezza del 70.2% su 1,600 documenti scansionati RVL-CDIP distribuiti in 16 classi. Jev non poteva partecipare a quel test sulle immagini. Secondo il vendor, ogni immagine ha aggiunto circa 1,350 token in input; la stima è di circa €270 per 1 milione di decisioni su documenti. Questi risultati dimostrano che il percorso può acquisire scansioni, non come si comporterà sulle proprie fatture.
Cinque fatture sintetiche vanno mantenute come test di capacità separato. Con la base comune di 500 token più l’incremento dichiarato di 1,350 token per immagine, una decisione Privatemode costerebbe circa €0.00039765, o $0.00045344; cinque costerebbero circa €0.00198825, o $0.0022672. Quei cinque risultati non devono confluire nel punteggio di accuratezza dei 30 ticket testuali. Altrimenti GLM ottiene credito per aver partecipato a un test a cui Jev non può accedere e il confronto sul testo diventa illeggibile.
Vincitore di categoria: GLM-5.3-Flash per il triage diretto di immagini documentali.
Prima di migrare, esegui lo stesso test su 30 ticket
Il confronto interno minimo credibile usa un insieme immutabile di 30 ticket sintetici etichettati, riprodotti con opzioni e ordine identici e con un’opzione esplicita none of these. I casi sintetici evitano di inviare dati dei clienti durante la valutazione. Devono comunque rappresentare i ticket brevi, ambigui e fuori ambito che mandano in crisi un router in produzione.
Rendi immutabile il set di prova
Raccogli in un unico file versionato 30 ticket testuali, le etichette attese e le opzioni consentite. Includi
none of these, mantieni fisso l’ordine delle scelte e separa le cinque immagini di fatture come set dedicato alle capacità.Registra la versione servita da ogni endpoint
Chiama la versione fissa
jev-1.13.0oppure registra il campomodelrestituito da Jev. Risolviglm-flash-lateste annota il modello effettivamente servito prima di definire il risultato un test di GLM-5.3-Flash. Per entrambi, registra anche endpoint e regione del client.Riproduci decisioni identiche
Invia ai due percorsi lo stesso stato e opzioni semanticamente identiche. Non migliorare di nascosto un prompt, non riordinare le etichette per uno solo dei sistemi e non conteggiare i tentativi soltanto da una parte.
Raccogli il record operativo
Per ogni chiamata, salva a livello di esecuzione latenza p50 e p95, token in input, costo fatturato, scelta selezionata, probabilità o confidenza, correttezza, tentativi e passaggi all’operatore. Contrassegna separatamente gli errori ad alta confidenza.
Valuta le immagini fuori dal punteggio testuale
Invia cinque fatture sintetiche tramite Privatemode. Registra modello, token, costo, latenza ed etichetta. Per Jev indica l’inidoneità all’input diretto, invece di conteggiarlo come classificatore testuale in errore.
Calcola il costo per decisione corretta
Somma i costi di inferenza, nuovi tentativi, pre-elaborazione e revisione umana, quindi dividi per il numero di decisioni corrette. Presenta separatamente il risultato testuale condiviso sui 30 ticket e il test di capacità sulle cinque immagini.
L’inferenza pura dell’esecuzione testuale prevista costerebbe circa $0.0010206 con Jev e €0.0038295, o $0.0043668, con Privatemode prima di eventuali nuovi tentativi. La differenza è troppo piccola per decidere un acquisto. Il valore dell’esecuzione sta nel far emergere adeguatezza delle etichette, calibrazione, coda della latenza regionale e gestione dei passaggi all’operatore.
Costi di migrazione e casi in cui non conviene cambiare
Passare da Jev a Privatemode Decisions non significa sostituire il nome di un modello. Una Choice o Score di Jev diventa una Choice della libreria con indici di opzione fissi. Il team deve mappare la tassonomia esistente, ricreare le soglie di confidenza, sostituire il comportamento del client e dei nuovi tentativi, convalidare l’endpoint compatibile con OpenAI e rendere osservabile la risoluzione dell’alias. Se il motivo della migrazione è l’elaborazione riservata, il deployment deve rimanere sul percorso Privatemode coperto, non su un host vLLM arbitrario.
Anche migrare nella direzione opposta richiede lavoro. Lo stato costituito da immagini necessita di OCR o di un altro stadio di visione. I prompt lunghi devono rientrare nei limiti di contesto di Jev. Ogni assunzione specifica dei prompt GLM va convertita in domande Jev e le probabilità storiche non possono essere considerate come una calibrazione intercambiabile.
GLM-5.3-Flash è un’alternativa a Jev?
Sì, per decisioni testuali a scelta finita, soprattutto se lo stesso workflow deve gestire anche immagini. No, se per “alternativa” si intende una sostituzione immediata con proprietà identiche di confidenza, infrastruttura e conformità. Cambiano la forma dell’API, la pre-elaborazione, il ciclo di vita del modello e il perimetro del deployment.
Non abbandonare Jev se la coda contiene solo testo, le etichette sono stabili, l’accuratezza attuale è adeguata e risparmiare frazioni di centesimo ogni mille decisioni conta più dell’input multimodale. Non abbandonare Privatemode se le immagini dirette o il suo servizio europeo riservato sono requisiti inderogabili. In entrambi i sensi, un vantaggio marginale su un benchmark pubblico non basta a ripagare il rischio di migrazione.
La prossima mossa, lunedì
Rendi immutabile il set di valutazione prima che qualcuno ottimizzi i prompt sugli esempi preferiti. Riunisci in un unico record di test i 30 ticket sintetici, le cinque fatture sintetiche, la tassonomia delle scelte, le etichette attese, l’ipotesi sul costo della revisione e la regione del client. Aggiungi campi per versione effettiva del modello, endpoint, p50, p95, token, costo fatturato, tentativi, errori ad alta confidenza e passaggi all’operatore.
Attendi quindi le credenziali per entrambi e avvia il carico condiviso. Fino a quel momento, la decisione sostenibile rimane condizionale: Jev domina il routing testuale economico; GLM-5.3-Flash tramite Privatemode Decisions domina l’input diretto di immagini e il percorso portabile della libreria.
Domande frequenti
Quali sono le differenze principali tra GLM-5.3 e GLM-5.3 Flash?
Su Privatemode, GLM-5.3 gestisce solo testo e costa €1.55 per milione di token in input e €7.74 per milione di token in output. GLM-5.3-Flash accetta immagini e costa €0.20 in input e €0.65 in output per milione di token: su questa piattaforma, Flash è quindi l’opzione più economica e multimodale.
GLM Flash è un buon modello?
GLM-5.3-Flash è un candidato credibile quando un compito decisionale richiede immagini, un contesto lungo o il deployment di Privatemode. La sua effettiva qualità dipende comunque da accuratezza, errori ad alta confidenza, latenza e costo per decisione corretta sulle proprie etichette.
GLM-5.3-Flash è open source?
I file del modello sono pubblicati sotto licenza MIT. Questo chiarisce la licenza del modello, mentre privacy del deployment e condizioni del servizio dipendono ancora da dove e come viene eseguito.
GLM-5.3-Flash supporta le immagini?
Sì. La model card ufficiale lo descrive come multimodale nativo e Privatemode indica il supporto all’input di immagini per il proprio endpoint GLM-5.3-Flash.
Che cosa significa GLM?
Il paper di ricerca originale espande l’acronimo GLM in General Language Model.
GLM-5.3-Flash dispone di capacità di visione?
Sì. Può accettare immagini oltre al testo, perciò può partecipare direttamente a un test su documenti scansionati dal quale Jev resta escluso.
Quanti parametri ha GLM-5.3-Flash?
La model card ufficiale di Z.ai riporta 320 miliardi di parametri totali e 18 miliardi di parametri attivi.
GLM-4.7-Flash è un MoE?
Sì, ma è un modello diverso. La sua scheda ufficiale descrive un’architettura mixture-of-experts 30B-A3B; le relative specifiche non vanno quindi attribuite a GLM-5.3-Flash.
GLM-5.3-Flash è multimodale?
Sì. In questo confronto, è il vantaggio determinante per il triage dei documenti scansionati.
Vuoi un modo più semplice per collocare entrambe le opzioni nel tuo stack? Scarica la mappa degli strumenti AI per imprenditori e definisci il livello decisionale prima di aggiungere un altro modello.
- Ultimo aggiornamento
- 27 set 2026
- Categoria
- AI
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.
Claude Opus 5.5: vale il passaggio da Opus 5?
Claude Opus 5.5 costa meno, ma cinque modifiche API possono davvero bloccare la migrazione. Prezzi, benchmark e percorso di test rispetto a Opus 5.23 set 2026AI
Quale modello GPT-6 scegliere: Sol o Luna?
Confronta GPT-6 Sol e Luna per prezzi API, qualità nel coding e costi di revisione. Scopri quando conviene partire da Luna e quando passare a Sol.23 set 2026AI
GPT-6 Luna gratis: dove usarlo e quanto costa davvero
GPT-6 Luna è gratis nell’app desktop per gli utenti Free e Go. Scopri dove funziona, quali piani lo includono e quanto costa davvero usare l’API.22 set 2026AI
MiMo AI V2.6: dalla prova in Studio alla prima API
Scopri come provare MiMo AI V2.6 in Studio, configurare chiavi e API corrette e portare in produzione un primo flusso di lavoro verificabile.22 set 2026AI
AI per programmare: MiMo V2.6 Pro o Flash?
Confronto tra MiMo V2.6 Pro e Flash per coding, agenti e UI: prezzi, benchmark e una regola pratica per scegliere il modello più conveniente.22 set 2026AI
MiMo V2.6 gratis? Accessi, licenza e costi reali
MiMo V2.6 è gratis solo in alcuni casi: ecco cosa offre OpenCode, cosa copre la licenza MIT e quanto costano le API Flash, Pro e UltraSpeed.22 set 2026AI
Grok API: confronto tra Grok 4.7 e Grok 4.6
Grok API, confronto tra Grok 4.7 e 4.6: benchmark, prezzi, limiti e un test in tre attività per scegliere il modello giusto senza migrazioni alla cieca.21 set 2026AI