Gestione ticket assistenza con Jev: routing e controllo umano
Scopri come usare Jev per classificare i ticket, stimare gravità e urgenza e automatizzare il routing, mantenendo il controllo umano sui casi incerti.

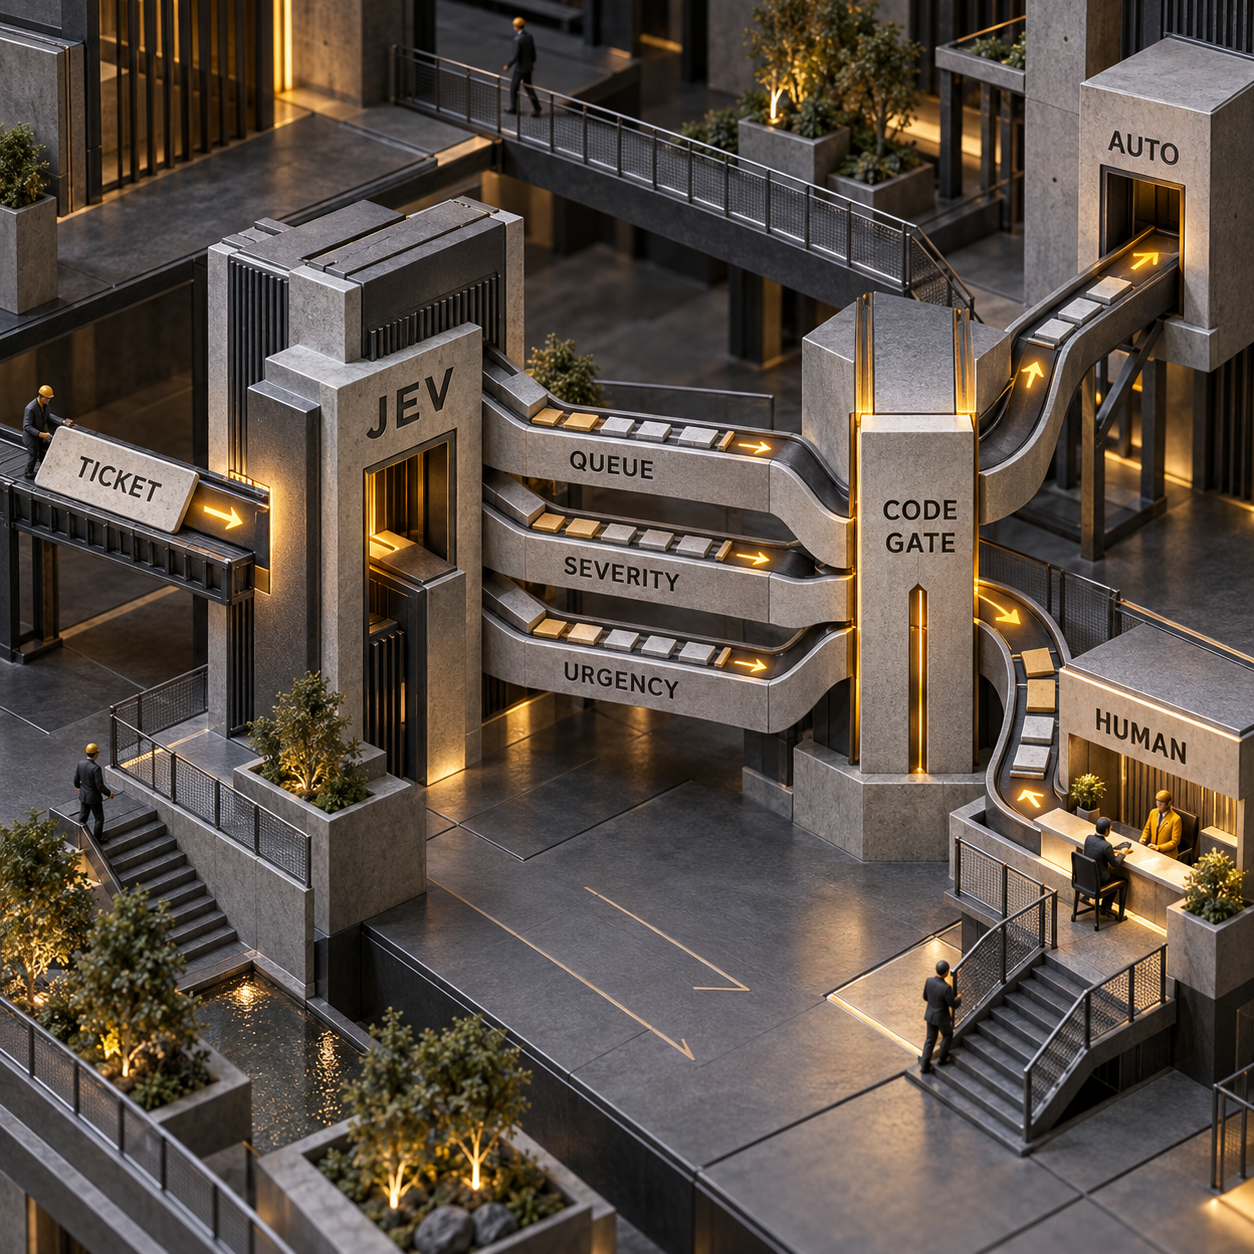
In un flusso di gestione ticket assistenza, Jev può trasformare un unico messaggio confuso in tre segnali subito utilizzabili dal software: una coda, un punteggio di gravità e la probabilità che il ticket sia urgente. Il vantaggio non sta solo nel fatto che le risposte sono tipizzate. Il codice può anche esaminarle, registrarle e stabilire quando non sono abbastanza affidabili.
Conviene partire da un compito reversibile: instradare un ticket mantenendo nel codice una coda per la revisione umana. Jev garantisce la struttura della risposta, non che billing sia la risposta corretta. È questa distinzione a separare una demo da un flusso davvero operativo.
Gestione ticket assistenza: partire da una decisione, non da un agente autonomo
Jev è un modello decisionale, non un chatbot. Gli si invia del testo o un JSON strutturato chiamato state, quindi si formulano domande le cui possibili risposte hanno una struttura definita in anticipo. Invece di scrivere una replica, restituisce valori e probabilità. TypeSafe lo definisce un modello System One: è pensato per prendere decisioni rapide e circoscritte all'interno di normali applicazioni software.
Si può immaginare come un centralino semantico. Un comune if verifica un dato preciso, per esempio se una fattura è scaduta. Jev affronta invece la parte sfumata — per esempio capire se il messaggio di un cliente trasmette urgenza — e poi restituisce il controllo al codice tradizionale.
Per il primo flusso di assistenza, è sufficiente passargli un ticket e chiedere:
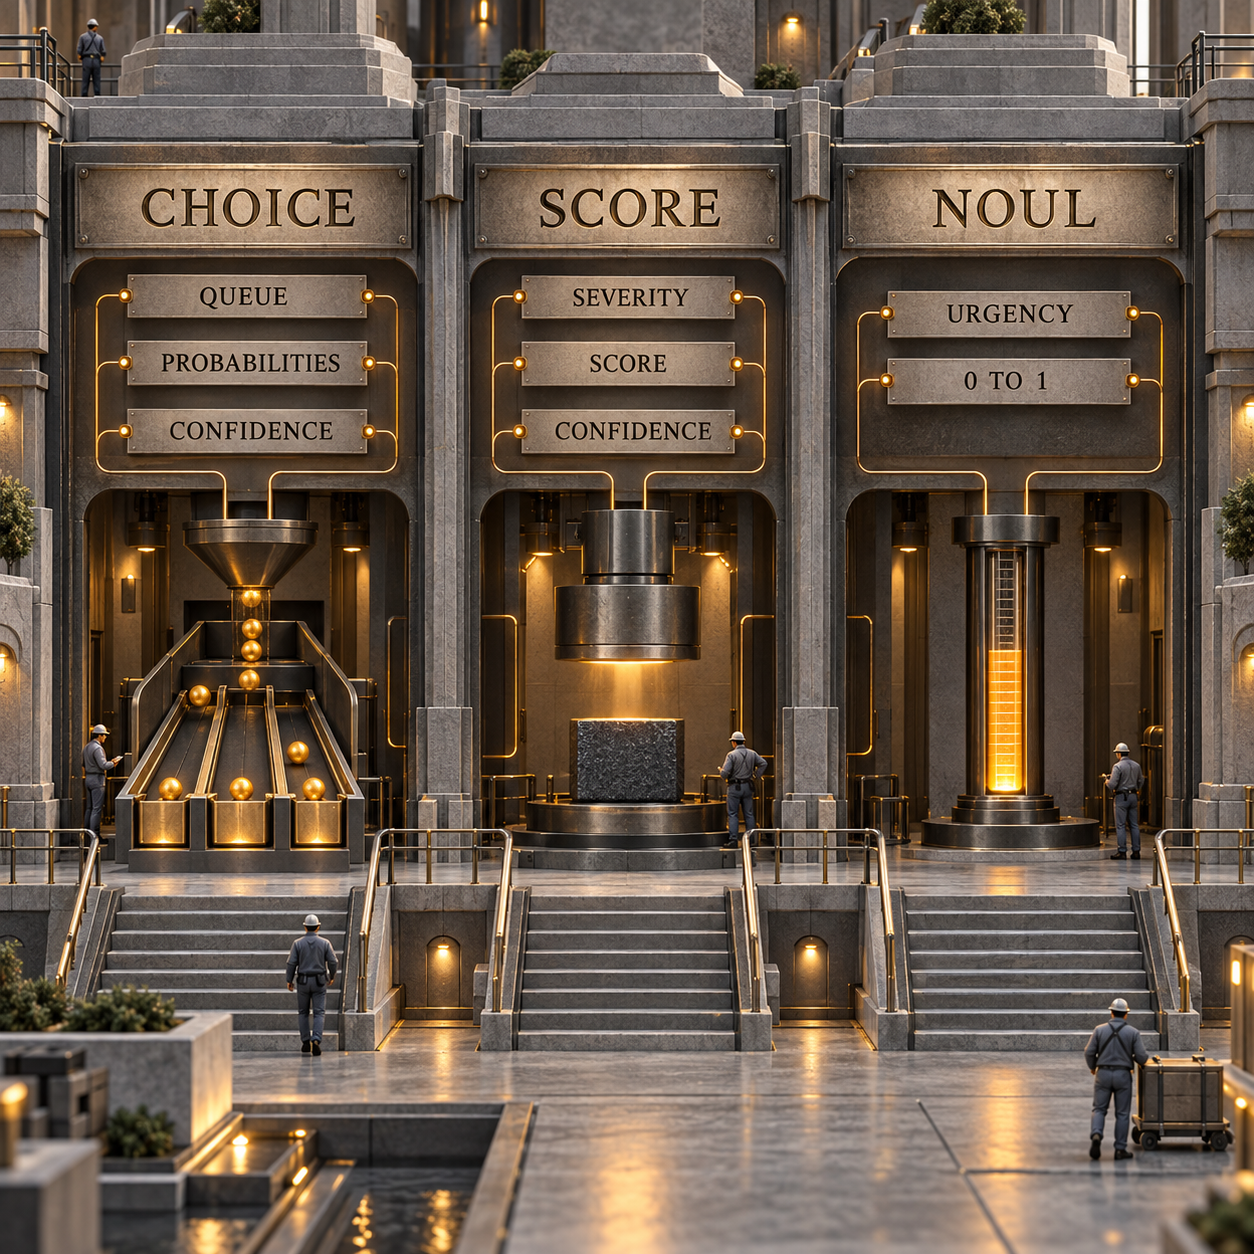
- Choice: a quale coda predefinita va assegnato il ticket?
- Score: dove si colloca la gravità su una scala ordinata?
- Noul: qual è la probabilità che il cliente stia esprimendo urgenza?
Le tre domande possono viaggiare nella stessa richiesta e vengono valutate in modo indipendente sul medesimo stato. Al momento Jev accetta soltanto testo, comprese stringhe e strutture JSON composte da testo. Non può ricevere allegati, immagini, clip audio o video.
Choice, Score e Noul rispondono a domande diverse
Ogni primitiva serve a un tipo di domanda specifico. Scegliere quella giusta conta più di formulare istruzioni brillanti.
La coda richiede una Choice perché billing, technical, sales e other sono alternative. La gravità richiede uno Score perché i livelli compongono una scala ordinata. L'urgenza richiede un Noul quando si vuole semplicemente sapere se il messaggio esprime pressione temporale.
È importante osservare l'intera distribuzione. Se una Choice assegna probabilità simili a billing e technical, segnala che il confine tra le due code è incerto. Per Choice e Score, il singolo campo confidence riassume la dispersione. Nel caso di Noul, la zona ambigua è vicina a 0.5, perché il valore restituito rappresenta già la probabilità del sì.
Come costruire il primo routing dei ticket
Il primo passo è verificare l'accesso. TypeSafe ha rilasciato Jev in early access il 15 settembre 2026, ma questo ambiente di pubblicazione non disponeva di una chiave TypeSafe. Una richiesta all'endpoint dei modelli priva di chiave ha restituito HTTP 403 con un errore di autenticazione. Il flusso seguente è eseguibile con un accesso autorizzato, ma nessun risultato citato nell'articolo viene presentato come prodotto da questa esecuzione.
Servono Python 3.10 o successivo, il pacchetto typesafe-sdk installato e la variabile TYPESAFE_API_KEY configurata nell'ambiente. L'SDK legge quella variabile e usa jev-latest per impostazione predefinita. Nell'esempio il modello è indicato esplicitamente, così la richiesta resta facile da verificare.
from time import perf_counter

from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = {
    "id": "T-001",
    "message": (
        "Our SSO connection stopped working after renewal. "
        "The invoice is paid, but the whole team is locked out."
    ),
}

started = perf_counter()
with TypeSafeClient() as client:
    response = client.system_one(
        model="jev-latest",
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which support queue should handle `message`?",
                criteria={
                    "billing": "Invoices, payments, refunds, or subscriptions",
                    "technical": "Bugs, outages, access, or integrations",
                    "sales": "Plans, pricing, upgrades, or a new account",
                    "other": "Anything that does not clearly fit the other queues",
                },
            ),
            "severity": Score(
                instructions="How severe is the customer impact in `message`?",
                criteria=[
                    "Minor inconvenience",
                    "One person is blocked",
                    "Several users are blocked",
                    "Security risk or data loss",
                ],
            ),
            "urgent": Noul(
                instructions="Does `message` express urgency or time pressure?",
            ),
        },
    )
latency_ms = round((perf_counter() - started) * 1000, 1)

queue = response.answers["queue"]
severity = response.answers["severity"]
urgent = response.answers["urgent"]

# These are conservative test gates for this reversible workflow,
# not universal thresholds. Tune them on labelled tickets.
needs_human = (
    queue.choice == "other"
    or queue.confidence < 0.75
    or severity.confidence < 0.70
    or 0.35 < urgent.noul < 0.65
)

record = {
    "ticket_id": ticket["id"],
    "model": response.model,
    "input_tokens": response.usage.input_tokens,
    "latency_ms": latency_ms,
    "queue": queue.choice,
    "queue_probabilities": queue.probabilities,
    "queue_confidence": queue.confidence,
    "severity": severity.score,
    "severity_confidence": severity.confidence,
    "urgency_probability": urgent.noul,
    "handoff": needs_human,
}
print(record)
Le soglie dell'esempio sono volutamente specifiche per questo caso. Assegnare un ticket alla coda sbagliata è di solito reversibile, ma il costo dell'errore cambia da un contesto all'altro. Una startup di due persone può tollerare un instradamento errato che sarebbe inaccettabile per l'help desk di un ospedale. Anche la guida di TypeSafe sulla confidence raccomanda di definire i limiti in base alla posta in gioco e di calibrarli sui propri dati.
C'è un altro dato da registrare: jev-latest è un alias. Al momento della pubblicazione punta a jev-1.13.0; il campo model della risposta indica quale versione ha effettivamente risposto. Se una versione successiva cambia i risultati, un log privo dell'ID risolto del modello non permette di capirne il motivo.
Il guasto più subdolo: una risposta valida con il significato sbagliato
Il ticket di esempio contiene volutamente due segnali forti. “Renewal” e “invoice” rimandano alla fatturazione, mentre “SSO” e “locked out” indicano l'assistenza tecnica. Con la scala definita nel codice, un set di test etichettato potrebbe considerare technical la coda corretta, perché il blocco immediato riguarda l'accesso.
Jev potrebbe comunque restituire una Choice billing perfettamente valida. Il JSON verrebbe interpretato senza errori, il campo sarebbe presente e il valore apparterrebbe alle opzioni consentite. Eppure, rispetto all'etichetta attesa, la risposta sarebbe sbagliata.
Questo errore mette in luce due controlli distinti:
- Fallback in esecuzione: affidare a una persona i casi a bassa confidence, quelli classificati come
othere i Noul ambigui. - Fallback di valutazione: confrontare ogni decisione di test con un'etichetta umana, comprese quelle ad alta confidence. Una soglia non intercetta un'etichetta sbagliata prodotta con sicurezza.
“Type safe” non significa “accurato per costruzione”. La sicurezza dei tipi protegge l'interfaccia tra il modello e il codice. L'accuratezza va misurata sui ticket, sulle etichette, sui criteri, sulla versione del modello e sulla lingua effettivamente usati.
Un test indipendente e preliminare sull'instradamento delle email conferma il punto. Su 1,565 email aziendali in tedesco e inglese, l'autore ha rilevato per Jev un'accuratezza complessiva del 96.4%, inferiore a quella di due modelli Gemini. Nello stesso test, gli errori di Jev si concentravano sui casi con confidence più bassa, rendendo utile una revisione umana selettiva. È il dataset di un singolo professionista, non un risultato universale di produzione.
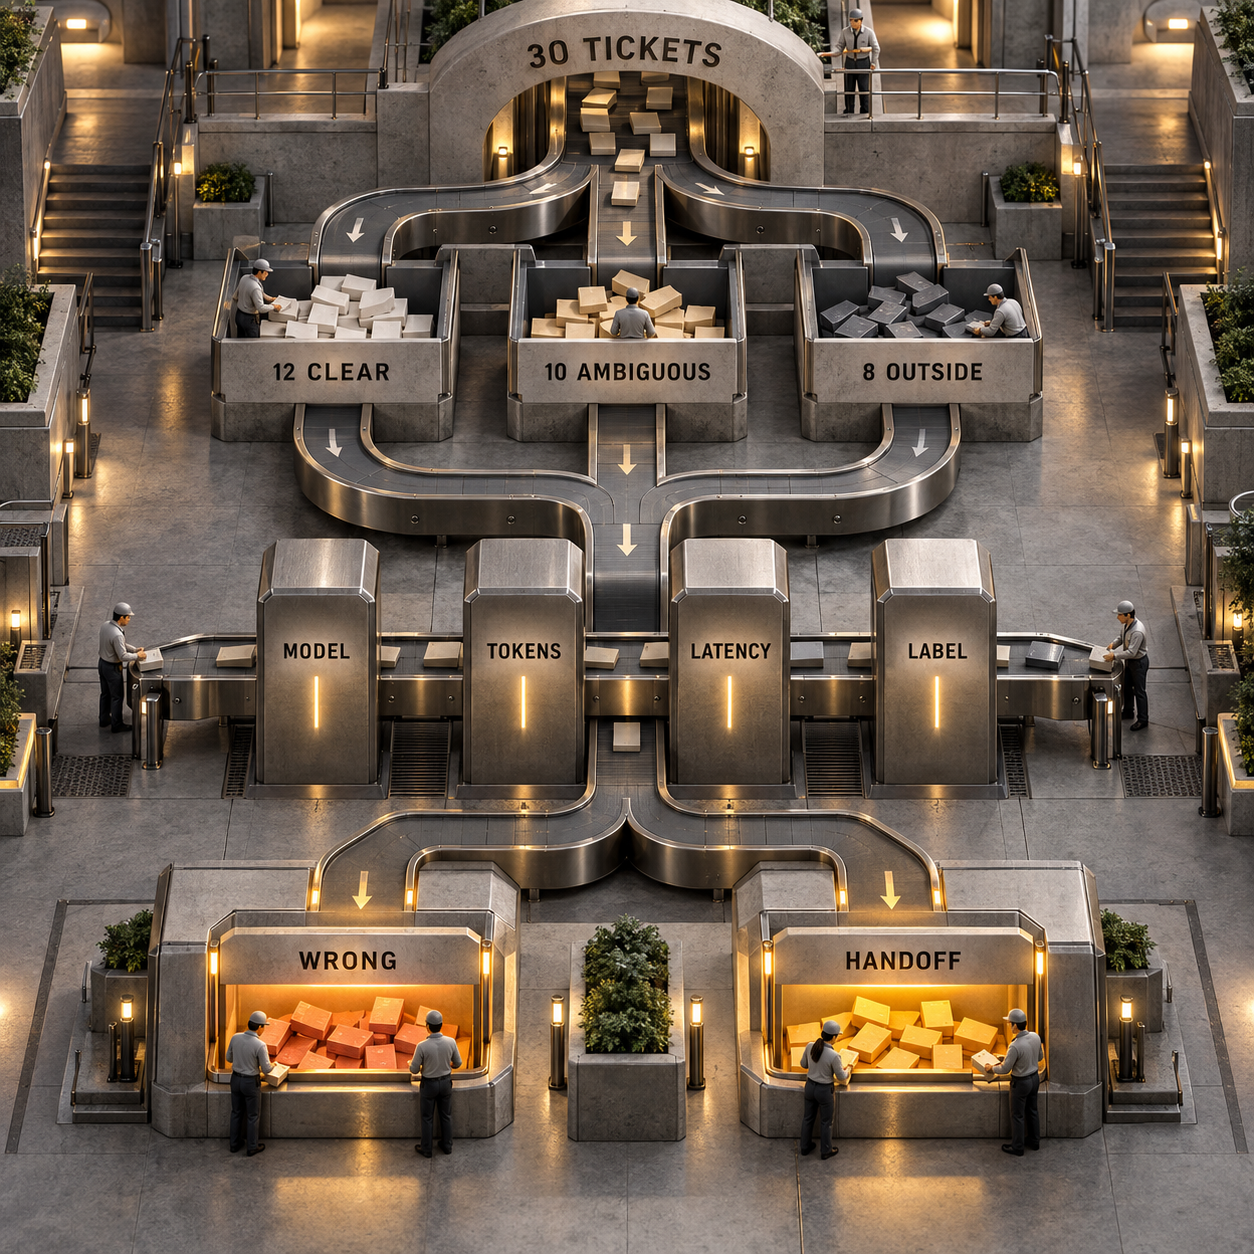
Prima del routing, verificare il flusso su 30 ticket
Trenta ticket non bastano a dimostrare l'accuratezza in produzione. Possono però far emergere un insieme di etichette mal progettato, l'assenza del percorso other, un'istruzione fuorviante, un errore nei campi della risposta o un fallback che non scatta mai. Va trattato come un piccolo collaudo del flusso, non come un benchmark.
Il set di prova va preparato prima di guardare le risposte di Jev:
Ogni riga deve avere un ID ticket stabile, la coda prevista, una breve motivazione dell'etichetta e l'indicazione se il caso richiede una persona. Vanno poi registrati la versione risolta del modello, i token di input, la latenza misurata dal client, la coda restituita con le relative probabilità, la gravità con la sua confidence, la probabilità di urgenza, l'eventuale etichetta errata e l'handoff effettivo.
È utile esaminare separatamente almeno quattro segmenti:
- Etichette sbagliate nei casi che il codice avrebbe instradato automaticamente
- Etichette sbagliate ad alta confidence, perché il controllo in esecuzione non le rileva
- Tasso di handoff per i casi chiari, perché una cautela eccessiva genera lavoro manuale
- Casi fuori ambito che non sono finiti in
other
Se l'accesso è ancora in lista d'attesa, conviene lasciare pronti il set di prova e lo script. Le colonne dei risultati non vanno riempite con valori presi dalla documentazione o dal test di qualcun altro. L'artefatto corretto è un foglio di esecuzione bloccato dall'accesso, accompagnato da codice eseguibile.
Il calcolo dei costi cambia la voce “classificazione”, non l'intero stack di assistenza
Jev 1.13 costa $0.042 per milione di token di input, mentre l'output non viene conteggiato. A questa tariffa, un ipotetico ticket da 500 token di input costa $0.000021. Centomila ticket delle stesse dimensioni costerebbero $2.10.
È una cifra notevole, ma non rappresenta il prezzo di sostituzione di un software per l'assistenza clienti. Zendesk parte da $19 per operatore al mese con pagamento annuale; Intercom parte da $29 per postazione al mese e applica una tariffa a partire da $0.99 per ogni risultato Fin. Questi prodotti comprendono caselle di posta, archiviazione dei ticket, interfacce per gli operatori, report e altri strumenti operativi. Jev fornisce soltanto il segnale decisionale.
A cambiare è un'ipotesi di budget più circoscritta: la classificazione semantica ripetuta non deve più consumare ogni volta una costosa chiamata a un modello generativo. Denaro e lavoro si spostano verso integrazione, esempi etichettati, monitoraggio, gestione delle eccezioni e persone incaricate degli handoff. Con un volume ordinario di messaggi, il risparmio grezzo sull'inferenza può contare meno della possibilità di sapere per quali ticket il modello dichiara incertezza.
La divisione del lavoro è chiara: Jev può scegliere un percorso, mentre un modello generativo può preparare il testo. Per il lato della risposta, si può vedere come ChatGPT prepara risposte Zendesk a partire dallo storico dei ticket. Il codice applicativo deve comunque far rispettare regole, autorizzazioni e azioni.
Sette flussi di lavoro, ordinati per chi ne ricava più valore
Sono possibili applicazioni di un modello decisionale vincolato, non risultati già osservati.
Jev dà il meglio quando le possibili risposte sono note, la decisione si ripete spesso e le conseguenze di una diramazione sbagliata possono essere contenute. È poco adatto se l'output deve essere una risposta, una spiegazione, un calcolo, un confronto preciso tra date o una lunga catena di ragionamento.
Due prodotti che vale la pena costruire
1. Un livello di routing per l'assistenza con controllo basato sulla confidence
È l'opportunità più solida. L'idea è vendere un sottile livello di routing ai team che già usano un help desk, ma continuano a smistare i ticket a mano o a mantenere fragili regole per parole chiave. Il prodotto leggerebbe il ticket, applicherebbe la scala di code definita dal team, riscriverebbe nell'help desk la coda scelta e le probabilità e affiderebbe a una persona i casi incerti o senza corrispondenza.
La domanda è abbastanza specifica da essere rilevante: customer service automation registra circa 880 ricerche mensili negli Stati Uniti, mentre help desk automation e customer support automation ne registrano circa 260 ciascuna. Le piattaforme di assistenza esistenti partono da circa $19–$29 per postazione al mese, quindi la proposta non è «sostituire l'help desk». È «rendere misurabile una decisione di routing all'interno dell'help desk che si sta già pagando».
La versione minima vendibile richiede un connettore, quattro definizioni di coda modificabili, un percorso other, fasce di confidence, una casella per la revisione e un report settimanale sulle etichette errate. Il punto critico è l'onboarding. Ogni cliente traccia confini diversi tra le code e uno schema generico diventa la principale fonte di errore del prodotto. Il vantaggio difendibile sta nel ciclo di valutazione e feedback, non nella chiamata API.
2. Una console QA per il routing in shadow mode
La sicurezza può essere venduta prima dell'automazione. Un responsabile dell'assistenza carica ticket etichettati, prova uno schema di domande candidato senza modificare le assegnazioni reali e riceve conteggi della matrice di confusione, errori ad alta confidence, tassi di handoff, confronti tra versioni e un elenco dei casi che richiedono criteri migliori.
Le stesse 260 ricerche mensili per help desk automation mostrano interesse per il compito, mentre un CPC di $129.46 su customer support automation segnala che i fornitori attribuiscono valore commerciale a questo traffico. L'MVP può comprendere un importatore CSV, una chiamata diretta a Jev, la revisione affiancata delle etichette e un log delle decisioni esportabile. Dovrebbe supportare prima il controllo su 30 ticket e poi dataset privati più ampi.
Il rischio è che un dashboard curato induca i team ad aspettarsi garanzie statistiche. Il prodotto deve dichiarare che cosa può e non può dimostrare un campione ridotto, proteggere i dati dei ticket ed evitare di presentare la confidence come accuratezza certa. È un buon prodotto complementare al livello di routing, ma un'attività autonoma più debole perché la valutazione è episodica.
Limiti che impongono di fermarsi
Jev non va usato quando servono testo in prosa, una risposta al cliente, codice o una spiegazione del ragionamento. È anche lo strumento sbagliato per aritmetica, conteggi, confronti tra date o regole deterministiche di idoneità che il codice tradizionale può applicare con precisione.
La documentazione descrive Jev 1.13 come meno affidabile di fronte a trabocchetti letterali, riferimenti indiretti, contesto irrilevante, contenuti avversari, istruzioni contraddittorie e precisione numerica. La lingua principale di addestramento è l'inglese; per le altre lingue è documentata un'accuratezza inferiore. Prima che Jev possa esaminarli, gli allegati devono essere convertiti in testo da un altro sistema.
Il limite di contesto è di 64,000 token per l'intera richiesta, con un secondo limite di 32,000 token per lo stato più la domanda più lunga. Sono tetti, non obiettivi. Le linee guida ufficiali avvertono che uno stato irrilevante può ridurre l'accuratezza: conviene quindi recuperare solo la policy e i dettagli del ticket necessari per le domande correnti.
Il vero punto di arresto sono le conseguenze. Un'etichetta di assistenza è reversibile. Un rimborso, la sospensione di un account, una decisione di assunzione, una priorità medica o un trasferimento di denaro non sono semplici etichette. Le azioni ad alto impatto devono restare dietro controlli deterministici, una conferma, una persona qualificata o un sistema progettato e validato per quel settore.
Cosa fare lunedì
Chi gestisce le operazioni di assistenza può esportare 30 ticket recenti lunedì mattina. Prima che qualcuno veda l'output del modello, vanno etichettati 12 esempi chiari, 10 ambigui e 8 fuori ambito. Poi si può richiedere l'early access, eseguire lo script in shadow mode quando arriva una chiave e analizzare i casi sbagliati ad alta confidence prima di calibrare una soglia. Il risultato non va collegato al routing reale finché l'etichetta umana, la versione del modello e l'esito del fallback non sono registrati nello stesso log.
Che cos'è Jev AI?
Jev è il modello decisionale di TypeSafe AI per flussi software strutturati. Legge testo o uno stato strutturato composto da testo e restituisce risposte vincolate di tipo Choice, Score e Noul, accompagnate da probabilità, invece di generare prosa.
Da dove viene il nome Jev?
Secondo TypeSafe, il nome richiama William Stanley Jevons. La denominazione più ampia “System One” rimanda invece alla componente rapida e intuitiva della distinzione tra System 1 e System 2.
Esiste un video su come usare Jev?
I video possono aiutare a orientarsi, ma l'implementazione dovrebbe partire dalla documentazione aggiornata dell'API e dell'SDK TypeSafe, perché campi delle richieste, alias dei modelli, accesso e limiti possono cambiare. Il flusso diretto è questo: ottenere una chiave autorizzata, inviare lo stato insieme a domande tipizzate, esaminare le distribuzioni restituite e mantenere il fallback nel codice.
Per costruire un flusso di assistenza con routing basato sulla confidence, modellato sulle regole e sui ticket reali dell'azienda, il punto di partenza giusto è lo sviluppo di soluzioni AI per il servizio clienti.
- Ultimo aggiornamento
- 21 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.
Configurare Claude Code per leggere AGENTS.md
Scopri come configurare Claude Code per leggere AGENTS.md, scegliere il file di istruzioni corretto e gestire provider, versioni e file CLAUDE.md.19 set 2026Build
Claude Code MCP nei job automatici: il timeout giusto all’avvio
Configura l’attesa iniziale dei server in Claude Code MCP, separa i diversi timeout e verifica gli strumenti obbligatori prima che parta il job.17 set 2026Build
Bloccare l’addestramento AI su Cloudflare senza penalizzare la SEO
Configura Cloudflare per negare l’addestramento AI senza perdere l’indicizzazione: verifica la migrazione, il robots.txt e l’accesso dei crawler.16 set 2026Build
App dettatura vocale offline: Murmure alla prova
Murmure offre dettatura vocale offline e gratuita su desktop. Testiamo dizionario, regole, privacy, LLM, limiti e costi per capire a chi conviene.14 set 2026Build
FFmpeg API di RenderIO: prezzi, crediti e soglie di upgrade
Scopri i prezzi della FFmpeg API di RenderIO, il costo reale dei crediti e le soglie esatte oltre le quali conviene passare a Growth o Business.14 set 2026Build
Dettatura vocale gratis: quanto costa davvero Dictare
Dictare offre dettatura vocale gratis e locale per i coding agent. Scopri quali costi restano: hardware, configurazione, consumi e piano dell’agente.13 set 2026Build
Claude Code evals: misurare davvero l’effetto di un plugin
Scopri come i Claude Code evals confrontano un plugin con un controllo, misurano il delta, stimano i costi e trasformano una regressione in un gate CI.12 set 2026Build