Jevで実装するカスタマーサポート自動化:チケット振り分けガイド
TypeSafeの意思決定モデルJevを使い、問い合わせをキュー、重要度、緊急度に分ける実装手順を解説します。Choice・Score・Noulの使い分け、信頼度で人に引き継ぐ設計、30件のチケットによる検証、料金計算、導入前に知るべき制約まで、カスタマーサポート自動化に必要な判断軸をまとめました。

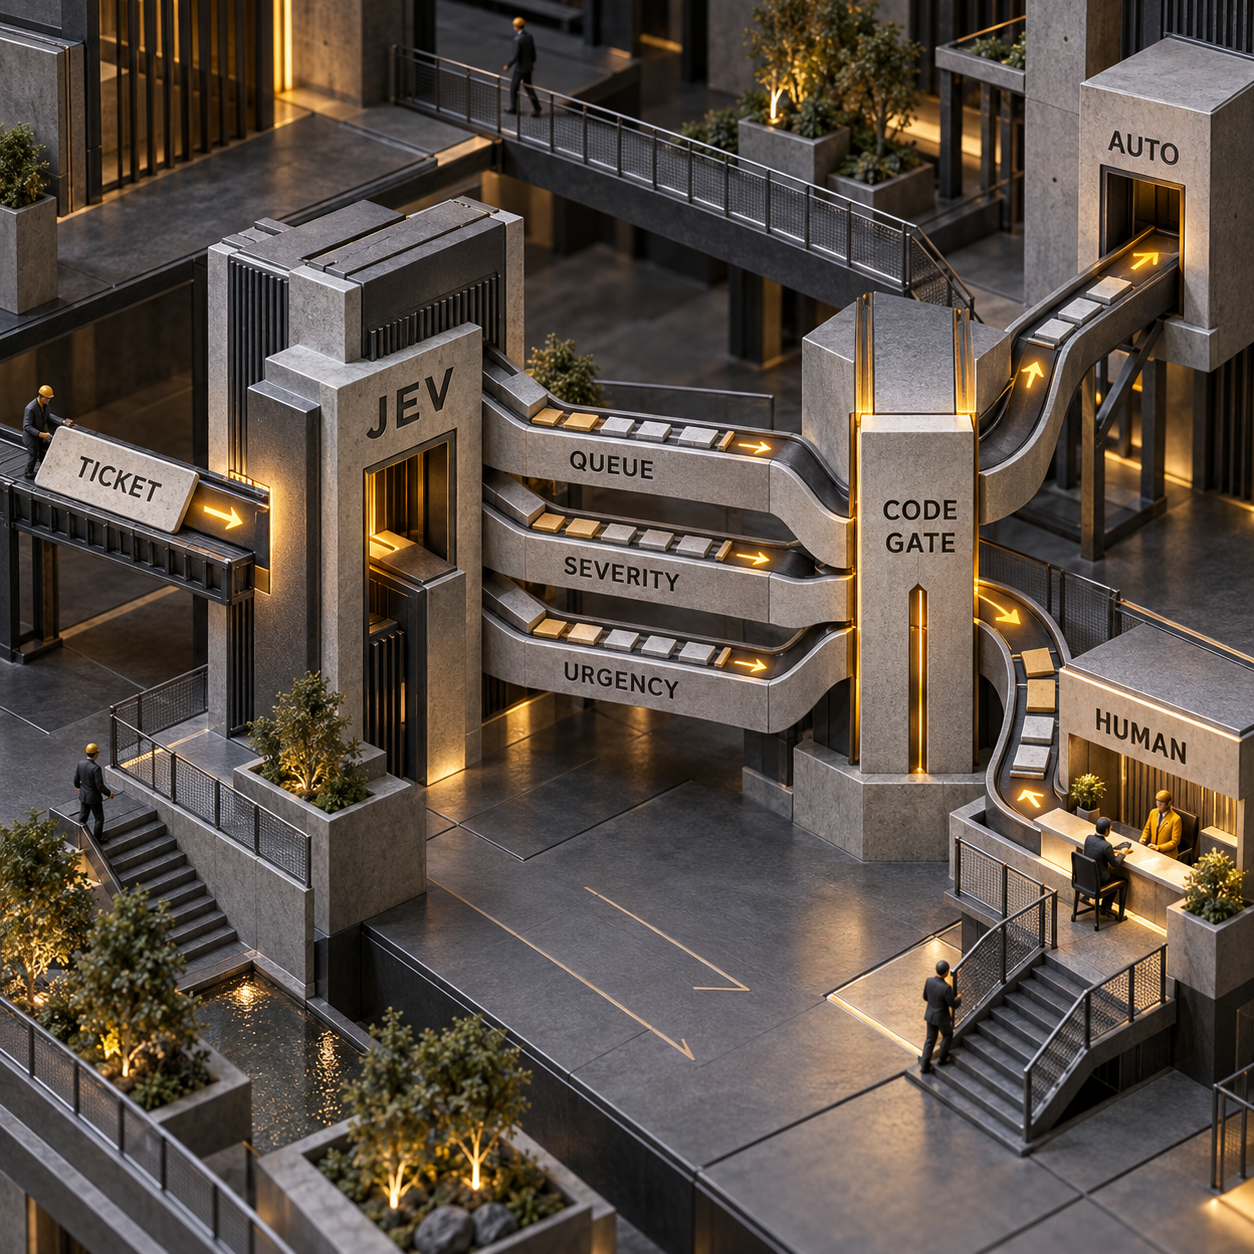
カスタマーサポート自動化でJevが担えるのは、まとまりのない問い合わせ文を、ソフトウェアがすぐ扱える3つの信号へ変えることです。振り分け先のキュー、重要度スコア、そしてチケットが緊急である確率を返します。重要なのは、単に型のある回答が得られる点ではありません。コード側で結果を検査・記録し、信用せず人に回す条件まで決められる点にあります。
最初は、やり直しの利く仕事を1つだけ任せます。チケットを振り分けつつ、人が確認するキューをコードに残してください。Jevが保証するのは回答の形式であり、billingという判断の正しさではありません。この違いを押さえることが、デモを実運用のワークフローへ変える第一歩です。
自律型エージェントではなく、カスタマーサポート自動化の判断を1つ任せる
Jevはチャットボットではなく、意思決定モデルです。stateと呼ばれるテキストまたは構造化JSONを送り、あらかじめ回答形式を定めた質問を渡します。返ってくるのは文章ではなく、値と確率です。TypeSafeはJevをSystem Oneモデルと呼んでいます。一般的なソフトウェアの中で、狭い範囲の判断をすばやく下すためのモデルという位置づけです。
意味を理解するスイッチボードと考えると分かりやすいでしょう。通常のif文なら、請求書の支払期限が過ぎたかといった明確な事実を判定できます。Jevは、顧客の文面から緊急性を感じ取るような曖昧な部分を受け持ち、その後の制御を通常のコードへ戻します。
最初のサポートワークフローでは、1件のチケットに対して次の3点を尋ねます。
- Choice: 決められたキューのうち、どこへ送るべきか
- Score: 段階が定義された評価基準上で、重要度はどこに位置するか
- Noul: 顧客が緊急性を訴えている確率はどれくらいか
3つの質問は1回のリクエストで送り、同じstateに対してそれぞれ独立に評価できます。現在、Jevが受け取れるのはテキストだけです。テキストで構成された文字列やJSON構造は扱えますが、添付ファイル、画像、音声、動画は受け付けません。
Choice、Score、Noulは、同じ回答の呼び方を変えただけではない
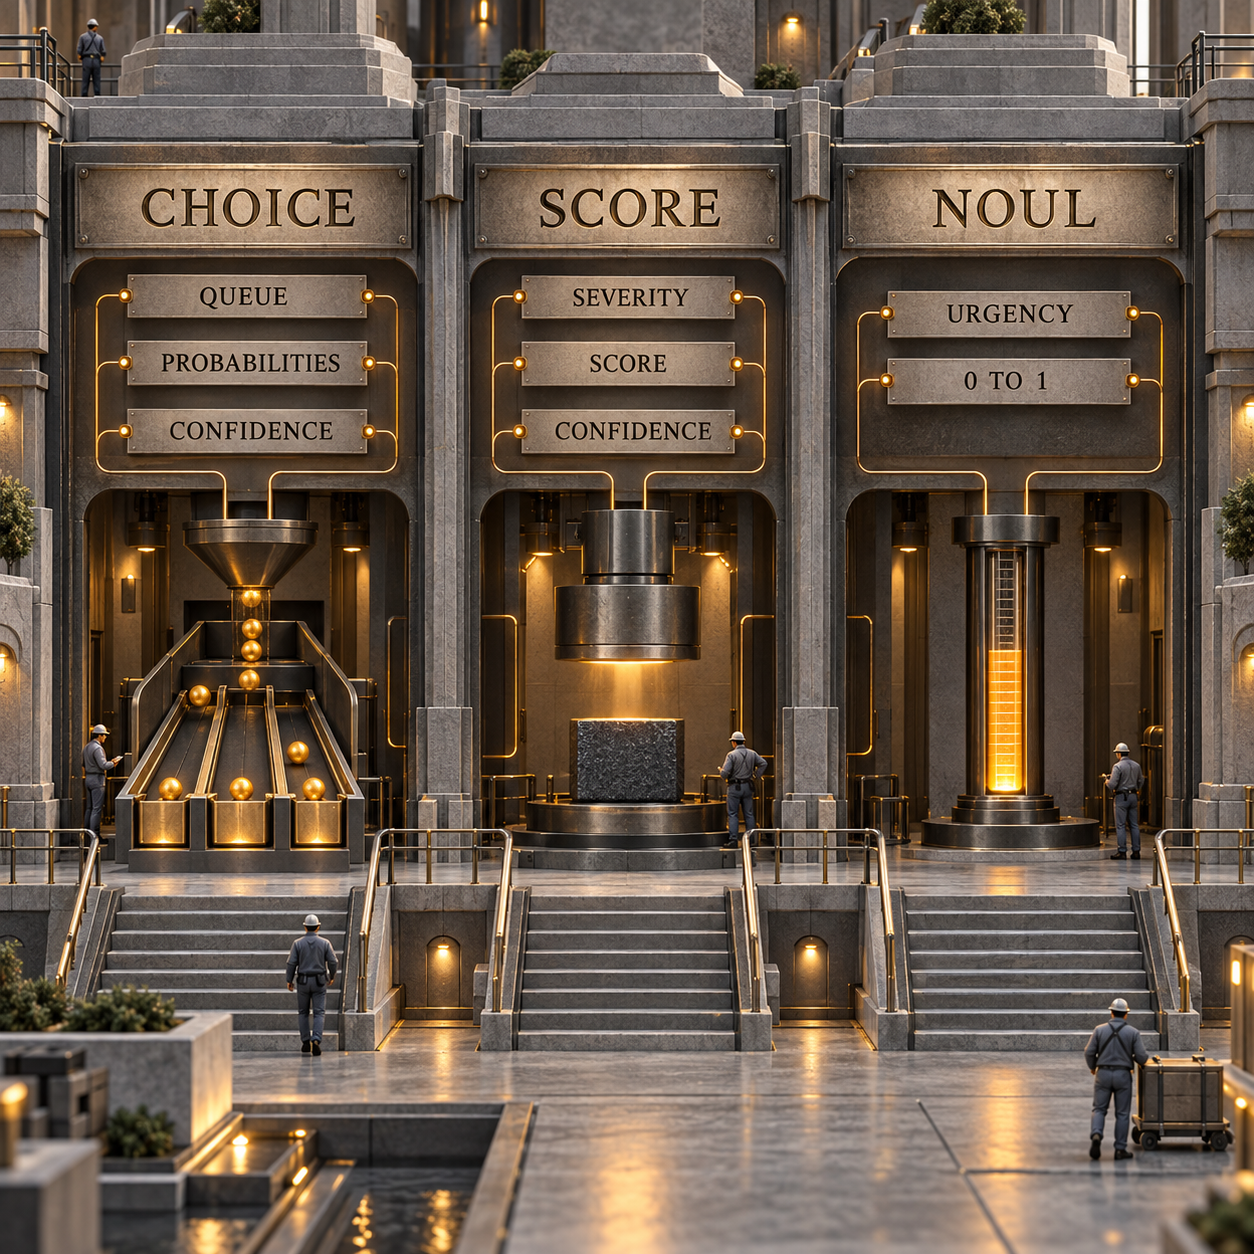
3つのプリミティブは、それぞれ異なる問いに答えます。巧みな指示文を書くことより、用途に合った型を選ぶことのほうが重要です。
振り分け先は、billing、technical、sales、otherという候補から選ぶためChoiceです。重要度は順序のある評価基準に沿うためScoreです。緊急度について「文面に時間的な切迫感があるか」を問うならNoulが適しています。
確率分布全体にも目を向けてください。Choiceでbillingとtechnicalの確率が近ければ、キューの境界が曖昧だという信号です。ChoiceとScoreでは、その分布の広がりが単一のconfidence値に要約されます。Noulの場合は返り値自体が「はい」の確率なので、0.5付近が曖昧な領域です。
最初のチケット振り分けを実装する
まず確認すべきはアクセス権です。TypeSafeは2026年9月15日にJevを早期アクセスとして公開しましたが、この記事の制作環境にはTypeSafeのキーがありませんでした。キーなしでmodelsエンドポイントへ送ったリクエストは、認証エラーのHTTP 403を返しました。以下のワークフローは正規のアクセス権があれば実行できますが、この記事に記載した結果を、この制作時に実行して得たものとして扱ってはいません。
Python 3.10以降を用意してtypesafe-sdkをインストールし、環境変数TYPESAFE_API_KEYを設定します。SDKはこの変数を読み込み、デフォルトではjev-latestを使用します。監査しやすいよう、ここではモデル名を明示します。
from time import perf_counter

from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = {
    "id": "T-001",
    "message": (
        "Our SSO connection stopped working after renewal. "
        "The invoice is paid, but the whole team is locked out."
    ),
}

started = perf_counter()
with TypeSafeClient() as client:
    response = client.system_one(
        model="jev-latest",
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which support queue should handle `message`?",
                criteria={
                    "billing": "Invoices, payments, refunds, or subscriptions",
                    "technical": "Bugs, outages, access, or integrations",
                    "sales": "Plans, pricing, upgrades, or a new account",
                    "other": "Anything that does not clearly fit the other queues",
                },
            ),
            "severity": Score(
                instructions="How severe is the customer impact in `message`?",
                criteria=[
                    "Minor inconvenience",
                    "One person is blocked",
                    "Several users are blocked",
                    "Security risk or data loss",
                ],
            ),
            "urgent": Noul(
                instructions="Does `message` express urgency or time pressure?",
            ),
        },
    )
latency_ms = round((perf_counter() - started) * 1000, 1)

queue = response.answers["queue"]
severity = response.answers["severity"]
urgent = response.answers["urgent"]

# These are conservative test gates for this reversible workflow,
# not universal thresholds. Tune them on labelled tickets.
needs_human = (
    queue.choice == "other"
    or queue.confidence < 0.75
    or severity.confidence < 0.70
    or 0.35 < urgent.noul < 0.65
)

record = {
    "ticket_id": ticket["id"],
    "model": response.model,
    "input_tokens": response.usage.input_tokens,
    "latency_ms": latency_ms,
    "queue": queue.choice,
    "queue_probabilities": queue.probabilities,
    "queue_confidence": queue.confidence,
    "severity": severity.score,
    "severity_confidence": severity.confidence,
    "urgency_probability": urgent.noul,
    "handoff": needs_human,
}
print(record)上のしきい値は、このワークフローに合わせて意図的に設定したものです。サポートキューの誤振り分けは一般にやり直せますが、その損失は現場によって異なります。2人のスタートアップなら許容できる誤振り分けでも、病院のヘルプデスクでは許されないかもしれません。TypeSafeの信頼度に関するガイドにも、境界値は判断の重さに合わせ、自社データで調整すべきだとあります。
もう1つ記録しておきたいのが、jev-latestはエイリアスだという点です。公開時点ではjev-1.13.0を指しており、実際に応答したバージョンはレスポンスのmodelフィールドで確認できます。後のバージョンで結果が変わっても、解決後のモデルIDがログになければ原因を追えません。
見落としやすい失敗は「形式は正しいが、意味が間違っている回答」
サンプルのチケットには、あえて2種類の強い手掛かりを入れています。「renewal(更新)」と「invoice(請求書)」はbillingを示す一方、「SSO」と「locked out(アクセス不能)」はtechnicalを示します。コード内の評価基準に従えば、ラベル付きテストセットでは、目の前の障害がアクセス不能であることを理由にtechnicalを正解とするかもしれません。
それでもJevが、形式上は完全に正しいbillingというChoiceを返す可能性があります。JSONは解析でき、必要なフィールドも存在し、値は許可された選択肢の1つです。それでも、人が付けた正解ラベルと比べれば誤答です。
この失敗から、制御を2層に分ける必要性が見えてきます。
- 実行時のフォールバック: 信頼度が低いケース、
other、Noulが曖昧なケースは人へ送ります。 - 評価時のフォールバック: 信頼度が高い判断も含め、テスト時の全判断を人のラベルと照合します。自信を持って間違えたラベルは、しきい値だけでは検出できません。
「型安全」を「構造上、必ず正確」と取り違えてはいけません。型安全が守るのは、モデルとコードの間のインターフェースです。精度は、実際に使うチケット、ラベル、評価基準、モデルバージョン、言語の組み合わせごとに測る必要があります。
独立した初期のメール振り分けテストも、この点をよく示しています。ドイツ語と英語の業務メール1,565件を使ったテストで、実施者が報告したJevの全体精度は96.4%で、2つのGeminiモデルを下回りました。一方、Jevの誤りは信頼度の低い領域に集中し、選択的に人が確認する仕組みが有効だったとも報告されています。これは1人の実施者が使ったデータセットの結果であり、あらゆる本番環境に当てはまる数字ではありません。
自動振り分けの前に30件のチケットでワークフローを点検する
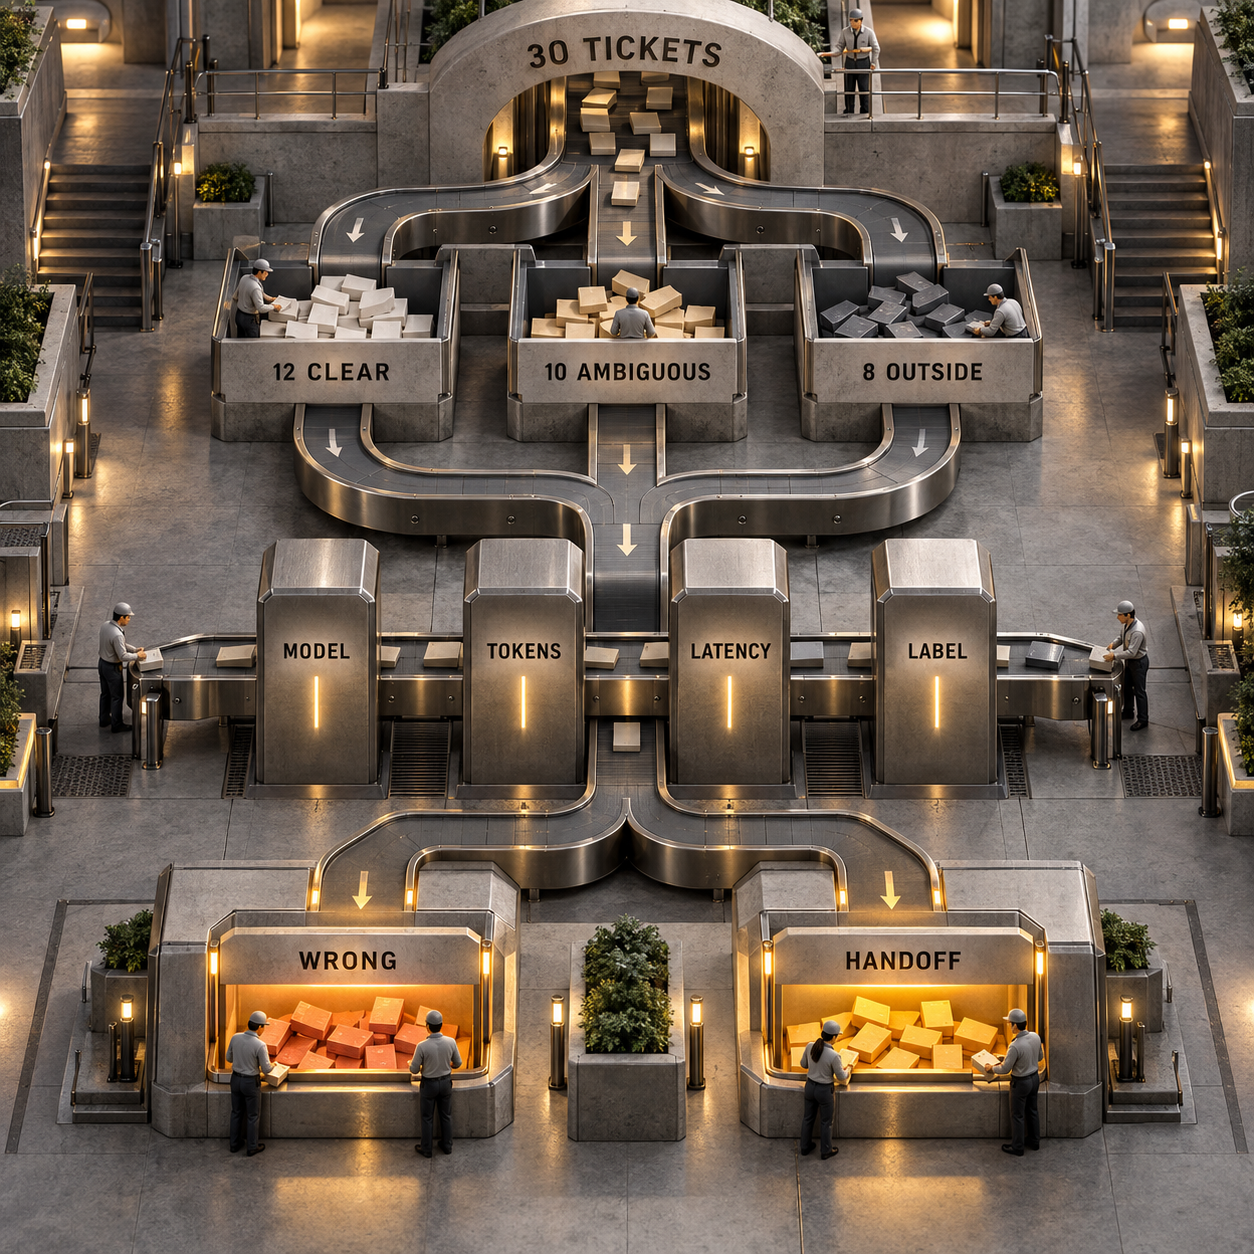
30件だけで本番精度を証明することはできません。それでも、ラベル設計の不備、otherの欠落、誤解を招く指示、レスポンスフィールドの扱い間違い、まったく発動しないフォールバックは見つけられます。ベンチマークではなく、小規模なワークフロー点検として使います。
Jevの回答を見る前に、次のテストデータを作ってください。
各行には、固定のチケットID、期待するキュー、そのラベルを選んだ短い理由、人による対応が必要かどうかを付けます。実行後は、解決後のモデルバージョン、入力トークン数、クライアント側で測ったレイテンシー、返されたキューと確率、重要度とその信頼度、緊急度の確率、誤ラベルのフラグ、実際に人へ引き継いだかどうかを記録します。
少なくとも次の4つは、切り分けて確認してください。
- コードが自動振り分けするケースのうち、ラベルが間違っていたもの
- 実行時のゲートでは拾えない、信頼度の高い誤ラベル
- 慎重すぎて手作業が増えていないかを確かめる、明確なケースの引き継ぎ率
otherに入らなかった対象外のケース
まだ早期アクセスの順番待ちなら、テストデータとスクリプトだけを準備しておきます。ドキュメントや他人のテストから数値を持ってきて、結果欄を埋めてはいけません。正直な成果物は、実行可能なコードを添えた「アクセス待ち」の記録表です。
コストが変わるのは分類処理であり、サポート全体ではない
Jev 1.13の料金は、入力100万トークン当たり$0.042で、出力には課金されません。この単価なら、入力が500トークンのチケット1件を処理するモデル入力費は仮に$0.000021です。同じサイズのチケット100,000件でも$2.10です。
印象的な安さですが、カスタマーサポートソフトウェアの代替価格ではありません。Zendeskは年払いで1エージェント当たり月額$19から、Intercomは1シート当たり月額$29からで、Finは1件の成果につき$0.99から課金されます。こうした製品には、受信箱、チケット保管、担当者向け画面、レポートなど、運用に必要な仕組みが含まれています。Jevが提供するのは意思決定の信号だけです。
見直せる予算項目は、もっと限定的です。繰り返し発生する意味ベースの分類に、毎回高価な生成モデルを呼ぶ必要がなくなります。その代わり、統合、ラベル付き事例、監視、例外処理、引き継ぎを受ける人に費用と労力が移ります。一般的な受信量なら、生の推論費を削減することより、モデルがどのチケットに自信を持てないのか分かることのほうが価値を持つかもしれません。
ここには明確な役割分担があります。Jevは振り分け先を選び、生成モデルは文章を用意します。返信側のワークフローについては、ChatGPTがチケット履歴からZendeskの返信案を作る方法も参照してください。ただし、ポリシー、権限、実行する操作は、引き続きアプリケーションコードで制御すべきです。
効果を得やすい順に見る7つのワークフロー
以下は、制約付き意思決定モデルの用途として考えられる例であり、実績を示すものではありません。
Jevが力を発揮するのは、回答候補が分かっていて、同じ判断を頻繁に繰り返し、誤った分岐の影響を封じ込められる場面です。返信、説明、計算、正確な日付比較、長い推論過程が必要なら適していません。
構築する価値がある2つの製品
1. 信頼度ゲート付きサポート振り分けレイヤー
最も有望なのはこちらです。すでにヘルプデスクを導入していても、チケットを手作業で仕分けたり、壊れやすいキーワードルールを保守したりしているチームへ、薄い振り分けレイヤーを提供します。チケットを読み、チーム独自のキュー評価基準を適用し、選ばれたキューと確率をヘルプデスクへ書き戻します。不確かなケースや一致しないケースは人へ送ります。
需要は十分に具体的です。customer service automationの米国での月間検索数は約880、help desk automationとcustomer support automationはそれぞれ約260です。既存のサポートプラットフォームは1シート当たり月額$19〜$29程度からなので、「ヘルプデスクを置き換える」と売り込むべきではありません。「すでに費用を払っているヘルプデスクの中で、1つの振り分け判断を測定可能にする」という提案です。
販売できる最小構成に必要なのは、1つのコネクター、編集可能な4つのキュー定義、otherへの経路、信頼度の帯域、確認用の受信箱、週次の誤ラベルレポートです。難所は導入時の設計です。キューの境界は顧客ごとに異なり、汎用的な分類設計そのものが製品の失敗要因になります。参入障壁になるのはAPI呼び出しではなく、評価とフィードバックのループです。
2. シャドーモードのルーティングQAコンソール
自動化を売る前に、安全性を支える層を提供します。サポート責任者がラベル付きチケットをアップロードし、本番の割り当てを変えずに候補となる質問設計を実行します。出力するのは、混同行列の件数、信頼度の高い誤り、引き継ぎ率、バージョン比較、評価基準を改善すべきケースの一覧です。
help desk automationにも同じく月間260件の検索があり、この業務への関心が確認できます。さらに、customer support automationのCPCが$129.46であることから、ベンダーにとって商業価値の高いトラフィックだと分かります。MVPは、CSVインポーター、Jevの直接呼び出し、ラベルを並べて確認する画面、エクスポート可能な意思決定ログで構成できます。まず30件の点検に対応し、その後、より大きな非公開データセットへ広げます。
注意したいのは、整ったダッシュボードを見ると、チームが統計的な保証まで期待しやすいことです。小さなサンプルで証明できることと、できないことを製品上で明示し、チケットデータを保護し、信頼度を正解率そのもののように見せない必要があります。振り分けレイヤーと組み合わせる製品としては有効ですが、評価作業は断続的にしか発生しないため、単独の事業としてはやや弱いでしょう。
導入を止めるべき条件
文章、顧客への返信、コード、推論の説明が必要ならJevを使わないでください。算術、件数集計、日付比較、通常のコードで正確に処理できる決定論的な資格判定にも不向きです。
Jev 1.13は、字面を利用したひっかけ、間接的な表現、無関係な文脈、敵対的な内容、矛盾する指示、数値精度に弱いと文書化されています。主な学習言語は英語で、ほかの言語では精度が低いことも明記されています。添付ファイルは、別のシステムでテキストへ変換しなければJevに渡せません。
コンテキスト上限はリクエスト全体で64,000トークンです。これとは別に、stateと最長の質問を合わせて32,000トークンという上限もあります。どちらも目標値ではなく、あくまで上限として扱ってください。無関係なstateは精度を下げる可能性があると公式ガイドが警告しているため、その時点の質問に必要なポリシーとチケット情報だけを取り出します。
最終的な判断基準は、結果の重大さです。サポートラベルはやり直せます。しかし、返金、アカウント停止、採用判断、医療上の優先順位、送金は、単なるラベルではありません。重大な結果を伴う操作は、決定論的なチェック、確認、資格を持つ人、または当該領域向けに設計・検証されたシステムの管理下に置いてください。
月曜日に始めること
サポート業務を担当しているなら、月曜の朝に最近のチケット30件をエクスポートします。モデルの出力を誰かが見る前に、明確な例を12件、曖昧な例を10件、対象外の例を8件に分けてラベルを付けてください。早期アクセスを申請し、キーが届いたらシャドーモードでスクリプトを実行します。しきい値を調整する前に、信頼度が高いのに誤ったケースを確認します。人のラベル、モデルバージョン、フォールバック結果を同じログへ残せるまでは、本番の振り分けに接続しないでください。
Jev AIとは何ですか?
Jevは、構造化されたソフトウェアワークフロー向けにTypeSafe AIが提供する意思決定モデルです。テキスト、またはテキストで構造化されたstateを読み、文章を生成する代わりに、確率を伴うChoice、Score、Noul形式の回答を返します。
Jevという名前の由来は何ですか?
TypeSafeによると、名称はWilliam Stanley Jevonsに由来します。より広い「System One」という呼び方は、System 1とSystem 2の区別における、速く直感的な側を指しています。
Jevの使い方を動画で確認できますか?
動画は概要をつかむ助けになりますが、実装時は最新のTypeSafe APIおよびSDKドキュメントを起点にしてください。リクエストフィールド、モデルのエイリアス、アクセス条件、上限は変わる可能性があるためです。基本の流れは、正規のキーを取得し、stateと型付きの質問を送り、返された分布を確認し、フォールバックをコードに残すことです。
実際のキュー規則とチケットに合わせた、信頼度ゲート付きのサポートワークフローを構築するなら、AIカスタマーサービス開発をご覧ください。
- 最終更新
- 2026年9月21日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。
Claude Code 使い方ガイド:AGENTS.mdを直接読み込む設定
Claude Code v2.1.277以降でAGENTS.mdをプロジェクト指示として直接読み込む条件を解説します。Project instructionsの4モード、CLAUDE.mdとの優先関係、非対応プロバイダー、確実な検証手順まで、設定時の落とし穴をわかりやすく整理しました。2026年9月19日Build
Claude Code MCPの起動待機を制御する方法
Claude Code MCPの初回起動待機をCLAUDE_CODE_MCP_STARTUP_WAIT_MSで制御する方法を解説。0の意味、MCP_TIMEOUTとの違い、4つの時計を分ける設計、CIで必須サーバーの接続状態を判定する手順と検証結果まで、無人ジョブを安全に運用する要点が分かります。2026年9月17日Build
Cloudflare AIクローラー設定でAI学習を拒否し、検索流入を守る
Cloudflare AIクローラー設定で、検索流入を維持しながらAI学習だけを拒否する方法を解説。Search、Training、Agentの移行結果、robots.txt、Googlebot・Applebot・Bingbotへの影響、変更後に実施すべき4段階の検証手順まで、運用担当者向けに整理します。2026年9月16日Build
音声入力アプリMurmureを検証:オフライン運用の実力
無料で使えるオフライン音声入力アプリMurmure 1.11.3を、技術用語を含む19.817秒の音声で検証。辞書と整形ルールの精度、ローカル/リモートLLMの違い、Windows・macOS・Linuxの注意点、料金、向いている人、見送る条件までを実測結果から詳しく解説します。2026年9月14日Build
FFmpeg APIの料金を解剖:RenderIOはいつ割安になる?
RenderIOのFFmpeg API料金を、月額プラン、コマンドクレジット、超過料金、チェーン実行、動画ダウンロードまで検証。Starter・Growth・Businessの損益分岐点と、実行時間・ストレージ・Webhookで上位プランが必要になる条件を、具体的な数字で解説します。2026年9月14日Build
AI 音声入力は本当に無料?Dictareの料金と実質コスト
AI 音声入力ツールDictareは、ソフトウェア料金が$0で、有料プランや公開された利用上限もありません。ローカル処理に必要なマシン、導入・運用時間、別契約となるコーディングエージェントの費用を切り分け、SpokenlyとWispr Flowの料金も比較。無料運用の条件と選び方を明快に解説します。2026年9月13日Build
Claude Code プラグインのeval入門:効果を差分で検証する
Claude Code 2.1.269で追加されたネイティブplugin evalを使い、プラグインあり・なしの実行を比較する方法を解説します。ケースとgraderの設計、WITH・W/OUT・Δの読み方、意図的な回帰テスト、コスト管理、CIゲートへの組み込みまで、再現可能なリリース判定を具体例とともに整理します。2026年9月12日Build