decision model比較2026:Jevの代替7選を料金と導入条件で選ぶ
Jevの代替となるdecision modelを、料金・入力形式・ライセンス・実行環境で比較。Perplexity、Cloudflare Clef、Microsoft、OpenAI、Liquid d1、Strandsの向き不向きを整理し、月額費用の試算と移行時の確認点から、自社の判断業務に合う候補を選べます。
公開日
 著者 Omid Saffari






Jevの代替となるdecision model(判断モデル)を探していて、ホステッドAPIの料金を抑えたいなら、まず検証したいのは入力100万トークン当たり$0.02のPerplexityです。すでにCloudflareでアプリケーションを動かしているならClef-flash、画像を使った判断をローカルで処理したいならLiquid AI d1-3Bが有力な出発点になります。ただし、月100万回の判断で毎回1,000入力トークンが課金される場合、JevからPerplexityに替えて削減できる基本入力料金は$22にとどまります。採用した判断に誤りが混じる割合を悪化させず、アプリケーションに必要な環境で動かせる選択肢を選びましょう。
料金、ライセンス、デプロイに関するドキュメントは2026年10月11日に確認しています。 以下の料金は各提供元が公表したものです。月額の数値は明記した前提に基づく試算であり、本番テストの請求額ではありません。この比較ではモデルを実行していません。
decision modelは用途別にどう選ぶ?
まず実行環境の制約を確認し、そのうえで自社の判断業務における品質を比較します。ホステッドAPIは、提供元がモデルを運用する方式です。オープンウェイトは、ライセンスに従ってモデルファイルを入手し、自分で推論を実行できることを意味します。計算資源まで無料で提供されるわけではありません。
ホステッドの料金は、セルフホスト時の推論料金を示すものではありません。ダウンロードできるLiquidとStrandsのモデルで未公表とあるのは、提供元のページに入力トークン当たりの固定料金が示されていないという意味です。ハードウェア、電力、ホスティング、運用の費用は別途かかります。ライセンスとチェックポイントの詳細は、各候補の節で説明します。
比較の基準となるTypeSafeの現行モデルはJev 1.13、モデルIDはjev-1.13.0です。料金は入力100万トークン当たり$0.042で、出力は無料です。入力はテキストとJSONなどの構造化テキストで、画像・音声・動画には対応しません。公表されている入力料金で比べると、MicrosoftはJevと同額、OpenAIの基本料金はそれより高く、PerplexityとClef-flashは安くなります。TypeSafeのモデル一覧
すでにJevを組み込んでいるなら、アプリケーションに必要な判断の定義という、大切な資産があるはずです。その定義を維持しましょう。請求に関するチケットは経理へ、アカウントにアクセスできない問題はサポートへ送る必要があるなら、まずその業務で代替候補の適性を確かめます。目を引くベンチマークの数値で選ぶのは、その後です。
比較対象と評価基準
提供元が管理するAPI、モデルカード、リポジトリのいずれかがあり、デプロイを判断できるだけの情報が公開されているモデルを優先しました。提供元のページを確認できないコミュニティ製クローンは対象に含めていません。6社の製品を7つの選択肢として紹介します。Cloudflareのモデル群は同じ節にまとめ、Liquidの2モデルは推奨用途が異なるため分けています。
評価するのは、必要な入力形式、ホステッドかローカルか、ウェイトのライセンス、実際の業務を妨げうる公開済みの制限、そして使える判断を得るための費用です。使える判断とは、高額な修正作業や不要なエスカレーションを挟まず、アプリケーションが採用できる判断を指します。
紹介順は、ホステッド料金の引き下げで最も有力な候補から始め、既存プラットフォームとの相性、ローカル実行の順に進みます。精度ランキングではありません。各社のテストは、データセット、ハードウェア、入力長、ネットワーク経路が異なります。本記事の性能値はすべてベンダー公表値であり、自社のチケットでJevを上回ることを証明するものではありません。
用途の範囲にも注意が必要です。これらのモデルは、あらかじめ定義した結果から選択したり、スコアを付けたりします。サポートの返信文や説明文が必要なら、生成処理は残してください。より広い選択肢については、JevとGLM-5.3-Flashの比較で詳しく扱っています。
導入候補となる7つの選択肢
1. Perplexity pplx-decider-v1.1-27b:ホステッド料金を下げるなら最初に検証
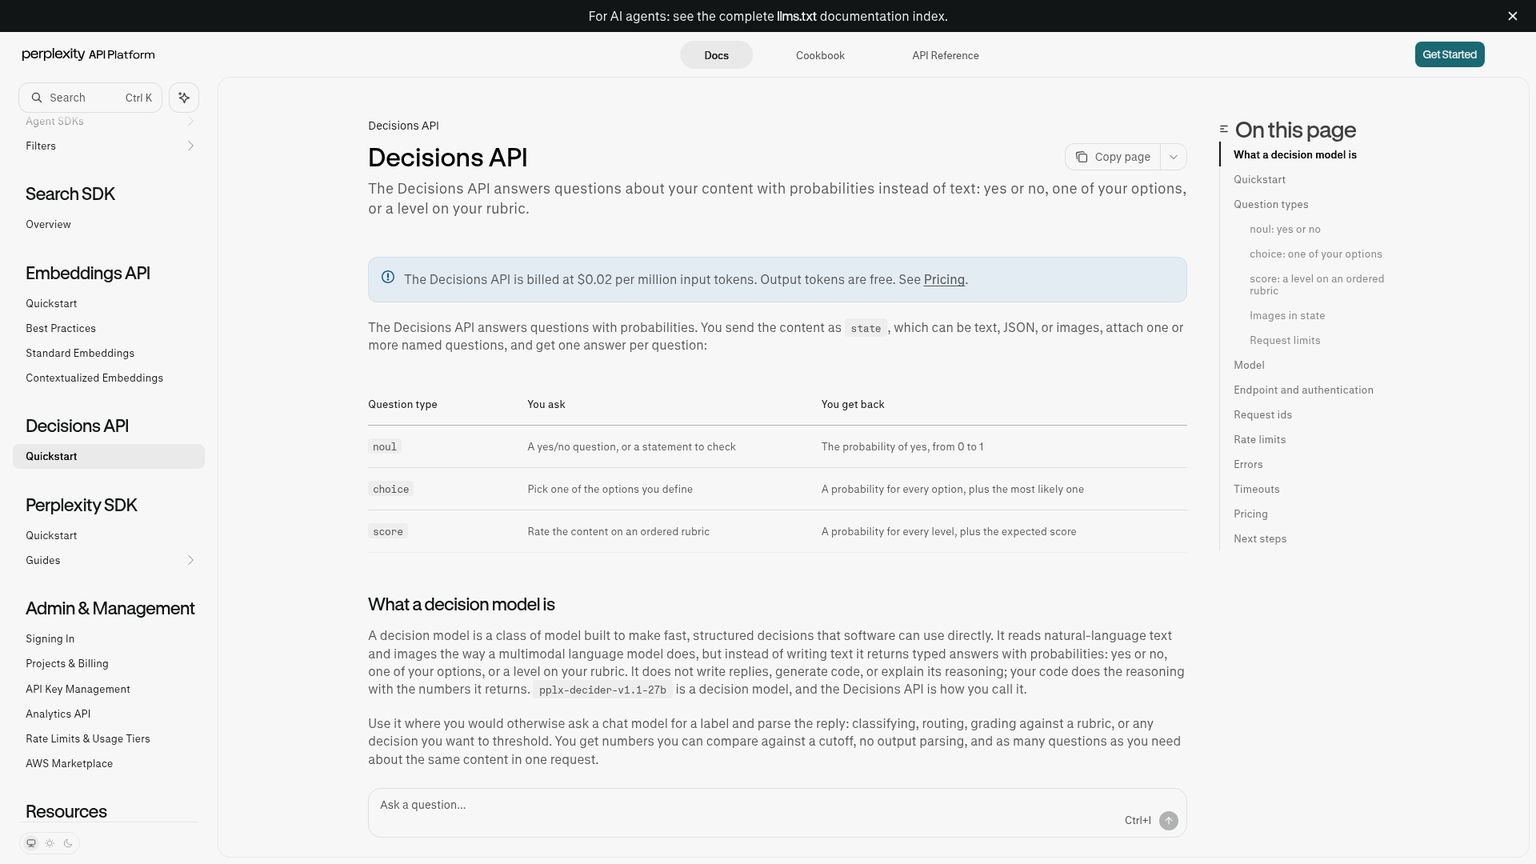
Perplexity pplx-decider-v1.1-27bは、PerplexityのホステッドDecisions APIと、ダウンロード可能なチェックポイントの両方で利用できる判断モデルです。通常のサポート振り分けや大量のラベル付けで、Jevの入力コストを下げることが目的なら、私が最初に検証する候補です。この比較に含めたホステッドサービスの公表料金では最安です。ただし、リクエスト上限、ローカル実行の要件、誤り率が自社の業務に合わなければ、推奨は変わります。
向いている用途: ホステッド環境での振り分け、ラベル付け、評価基準に沿った採点の低コスト化。
特徴: 直接利用できるAPIに加え、オープンウェイトで運用する方法もあります。
料金: 入力1Mトークン当たり$0.02。出力は無料で、リクエスト単位の料金もありません。
無料トライアル: 参照したDecisionsガイドには記載されていません。
入力と実行環境: PerplexityのAPI経由でテキスト、JSON、インライン画像に対応。提供されているローカル実装にはCUDA対応ハードウェアが必要です。
ライセンス: ダウンロード可能なチェックポイントはApache-2.0。ホステッド版は別サービスです。APIガイド、チェックポイントのライセンス
ホステッド版で制約となるのは処理量です。Perplexityのドキュメントでは、すべてのプランで組織当たり毎秒10リクエストとされています。共通の判断材料に対して最大128問を設定でき、入力の合計は262,144トークン未満です。リクエストの制限 別々の顧客チケットは、すべてにラベルが必要だからといって、自動的に共通のstateを持つリクエストになるわけではありません。無関係な案件を詰め込んで、判断する内容そのものを変えないようにしてください。ホステッド版の制限
この上限では、100万件のリクエストを個別に送ると、完璧にスケジュールし、再試行が一度もなくても、少なくとも27.8時間かかります。これは計算上の下限であり、実測した処理時間ではありません。夜間に過去データをまとめて処理する場合と、チケットが少しずつ届く場合では、同じ低価格APIでも求められる処理能力が大きく異なります。
セルフホストには別の制約があります。提供元の構成例では、約49 GiBのウェイトに加えて作業用メモリが必要です。また、prepareの実装は、結合した入力が8,192トークンを超えると拒否します。評価に使われたアテンションとキャリブレーションの設定も維持する必要があります。モデルカードには認証が必要な非公開リポジトリへのアクセスに関する記述も残っているため、ローカル導入を決める前に、自分のアカウントでチェックポイントをダウンロードできるか確認してください。Perplexityのモデルカード
ホステッド版のコンテキスト上限を、そのままローカル導入の要件に書き写してはいけません。ローカル版は、実際の前処理、メモリ使用量、モデルのリビジョンを含め、独立した実行環境として評価する必要があります。そうしないと、主系サービスを苦しめた長い記録で、代替経路も同じように失敗しかねません。
- 比較対象の中で、公表されているホステッド入力料金が最も低いです。
- テキストと画像を同じ判断リクエストに含められます。
- Apache-2.0のチェックポイントがあり、ホステッド以外の運用も選べます。
- 組織単位のリクエスト上限が、過去データの一括処理やアクセスの急増を制約します。
- 提供されているローカル構成には、大容量のGPUメモリが必要です。
- ホステッド版とローカルの参照実装では、入力上限が大きく異なります。
最初の比較は、誤りを直接確認できる規模の業務に絞りましょう。
既存の振り分け先の定義を維持する
Jevの実装からラベルと境界事例を引き継ぎます。定義に収まらないチケットには、「その他」や「要確認」という結果を明示的に残してください。Jevでサポートチケットを振り分けるガイドに、比較の基準となるワークフローを掲載しています。
Perplexity固有のリクエスト形式を使う
モデルを
pplx-decider-v1.1-27bに設定し、stateと名前付きのquestionsをPOST /v1/decisionsに送ります。choiceの質問を使い、各振り分け先の説明をcriteriaに指定します。リクエストとレスポンスの仕様は、公式APIリファレンスに従ってください。実際の割り当ては変えずに回答を記録する
質問名に対応する回答を読み取ります。選択されたラベル、返された確率、課金対象の入力使用量、リクエストの状態を、現在のJevの結果と並べて保存します。プロバイダー側の障害と、正常に返った確信度の低い判断は区別してください。
比較結果を見る前に切り替え条件を決める
許容できる誤振り分け率、確認作業量、応答期限を決めます。実際の業務を代表するラベル付きデータで、その条件を満たした場合にだけ候補を本番へ進めます。入力料金が下がるだけでは、切り替え条件を満たしません。
2. Cloudflare Clef・Clef-flash・Clef-omni:必要な入力形式で選ぶ
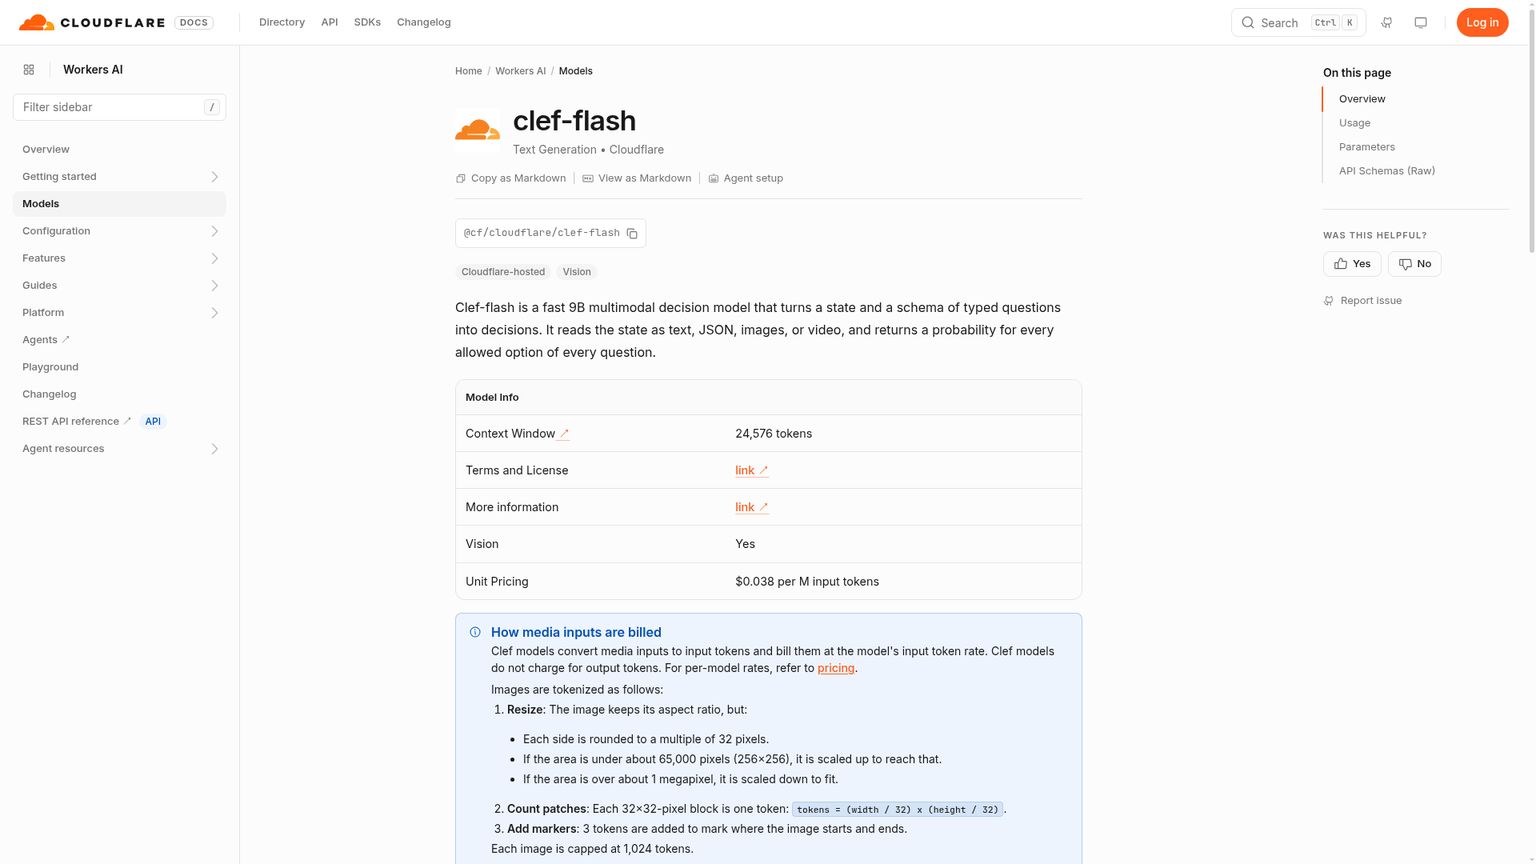
既存のWorkersアプリケーション内で判断を行うなら、Cloudflare Clef-flashが実用的な第一候補です。このモデル群はWorkers AIでのホスティングとApache-2.0のウェイトを組み合わせているため、将来のセルフホストも選択肢に残しながら、マネージド環境を評価できます。読み取る必要がある判断材料と、ホステッドエンドポイントの制限に合わせてモデルを選びましょう。最も安いモデルを選んでも、必要な音声対応やコンテキスト容量の代わりにはなりません。
向いている用途: Workersアプリケーションに近い環境での振り分けと分類。
特徴: Workers AIのバインディングとRESTアクセスに加え、ウェイトをダウンロードできます。
料金: 入力1Mトークン当たり、Clef-flashは$0.038、Clefは$0.240、Clef-omniは$0.150です。
無料トライアル: Workers AI共通の日次無料枠があります。Clef専用の無制限トライアルではありません。
入力と実行環境: ClefとClef-flashはテキスト、JSON、画像、動画フレームに対応。Clef-omniは音声と音声付き動画の直接入力にも対応します。Workers AIのホステッド環境、または自前の配信基盤で実行します。
ライセンス: 3モデルともウェイトはApache-2.0です。Workers AIの料金、当初のリリース、Clef-omniのモデルカード
ClefとClef-flashは2026年10月1日に登場しました。10月9日の更新でClef-omniが加わり、ホステッド版を選ぶ際の条件も変わっています。特に影響が大きいのは、Clef-flashのホステッド版のコンテキストウィンドウが現在24,576トークンであることです。収まるようにstateのテキストが切り詰められる場合があります。そのため、長い障害対応履歴では、アプリケーションに回答が返っていても、必要な判断材料が失われる可能性があります。現在のClef-flashのドキュメント、10月の更新
そのため、flashで最初に試すなら、際限なく増える会話アーカイブより、短い受付フォームのほうが適しています。入力上限を意識して、振り分けルールと判断を左右する顧客情報をその範囲に収めてください。送信前に記録を短くするなら、評価に使うのも短縮後の記録です。完全な会話記録が渡るという理想条件で評価してはいけません。
Cloudflare Clefは、テキストと画像を扱う、より大きなモデルです。ホステッド版のコンテキストは65,536トークンです。評価で実用的な改善が確認できる場合や、flashのコンテキストでは足りない場合に、高い料金を払う理由が生まれます。モデルが大きいというだけで、品質が上だとは判断できません。Clefのドキュメント
判断材料に音が含まれるなら、Cloudflare Clef-omniが候補になります。たとえば現場保守用のアプリでは、技術者の説明と機械の録音を併せて分類する必要があるかもしれません。特徴は音声・動画を直接入力できることです。静止フレームを取り出し、そこに答えが含まれることを期待する方式とは異なります。ドキュメントではコンテキストが64,000トークンとされ、メディアには別の制限があります。音声クリップは最大300秒、動画は最大60秒で、件数やバイト数にも上限があります。Clef-omniのドキュメント
オープンウェイトだからといって、omniをスマートフォンで動かせるわけではありません。Cloudflareの参照構成では、bfloat16の基盤モデルに約64 GBのGPUメモリが必要とされています。これは予算に含めるべき実行要件であり、ホステッド版のトークン料金ではありません。Clef-omniのモデルカード
Cloudflareの1日10,000 Neuronsの無料枠は、Workers AI全体で共有されます。Neuronsは計算資源の課金単位です。無料枠を超える利用にはWorkers Paidが必要です。トークン料金はモデルの利用料として扱い、Workersの契約料金やアプリケーションのその他の使用料も導入予算に含めてください。無料枠と課金ルール
- Workersに直接統合できるため、別のアプリケーション基盤を増やさずに済みます。
- Apache-2.0のウェイトがあり、セルフホストも選べます。
- 通常のテキスト振り分けから音声・動画を使う判断まで、モデル群でカバーします。
- ホステッド版Clef-flashのコンテキストは、以前の公開時の説明から想像するより小さくなっています。
- 長いstateを切り詰めると、判断に必要な情報が失われる場合があります。
- 公開されている構成でClef-omniをセルフホストするには、大容量メモリが必要です。
3. Microsoft-Decision-1:Foundryでのラベル付けとエージェント実行判定に
Microsoft-Decision-1は、すでにMicrosoft Foundryを運用している開発者向けの、判断にスコアを付けるホステッドモデルです。料金は入力100万トークン当たり$0.042で、Jevの現行公表料金と同じです。トークン料金の直接的な削減より、プラットフォームとの相性と業務での品質を検証しましょう。フィードバックへのラベル付けや、エージェントを続行・再試行・エスカレーションのどれに進めるかという判定が、試しやすい用途です。公開されているリクエスト仕様はテキストまたはJSONを受け取ります。基盤となるモデル群から画像対応まで推測しないでください。Microsoftの発表、Foundryのガイド
向いている用途: Foundry環境でのラベル付け、優先順位付け、エージェントの実行判定。
特徴: Entra IDまたはAPIキーを使うFoundryへのデプロイ手順が公開されています。
料金: 入力1Mトークン当たり$0.042。出力は無料です。
無料トライアル: 参照した判断モデルのページには記載されていません。
入力と実行環境: テキストまたはJSON。Microsoft FoundryとOpenRouterで利用できます。
ライセンス: ホステッドサービスです。参照した提供元のページでは、ダウンロード可能なウェイトのライセンスは公表されていません。Microsoftの料金と利用方法、デプロイの要件
Microsoftの2026年10月9日の投稿では、基盤モデルはQwen3.5-9Bとされています。他のモデルを基盤にするという説明は将来の計画であり、現在提供されているアーキテクチャではありません。また、基盤モデルがオープンであることは、Microsoftが事後学習したモデルをダウンロードできる根拠にはなりません。Microsoftがウェイトを別途公開しない限り、ホステッドの候補として扱います。アーキテクチャの出典
運用上の利点は、アプリケーションですでに使っている基盤の中で評価を進められることです。たとえば、汎用モデルで顧客のフィードバックにラベルを付け、プロダクトマネージャーが週次レポートを読む運用を考えます。テーマと「未分類」の扱いを定義し、同じフィードバックで両システムを比較してください。曖昧なコメントに、根拠なく具体的すぎるラベルが付いていないかを調べます。形式が完全に整ったラベルでも、レポートの読み手を誤らせることはあります。
Microsoftは、36のベンチマークを使った比較で平均精度が最も高かったと報告しています。これはベンダー公表値です。また、レイテンシーの比較では、同じリージョンのFoundry経由でMicrosoft-Decision-1を測定しています。この条件は重要です。自社アプリケーションからの応答時間や、独自の分類体系での精度を保証するものではありません。Microsoftによる評価の説明
導入に必要な作業も具体的です。Foundryプロジェクト、モデルをデプロイする権限、認証方法が必要で、無関係なSDKのモデル名を書き換えるだけでは済みません。ガイドに記載されているのは数値による判断であり、文章による説明ではありません。確認担当者にラベルの理由を説明する必要があるなら、根拠となる情報を保持し、別の処理で説明を用意してください。Foundryの設定と出力仕様
- Foundryの既存の認証・デプロイ手順に組み込めます。
- 二値判定、選択式の判断、順序付きの採点に対応します。
- Microsoft自身の発表で入力料金が明示されています。
- Jevから移行しても、基本入力料金は下がりません。
- 提供元のページでは、オープンウェイトでの導入方法を確認できません。
- 公開されている入力仕様はテキストとJSONであり、マルチモーダルの代替として使えるとは限りません。
4. OpenAI Decisions API:既存のOpenAI連携に判断処理を組み込む
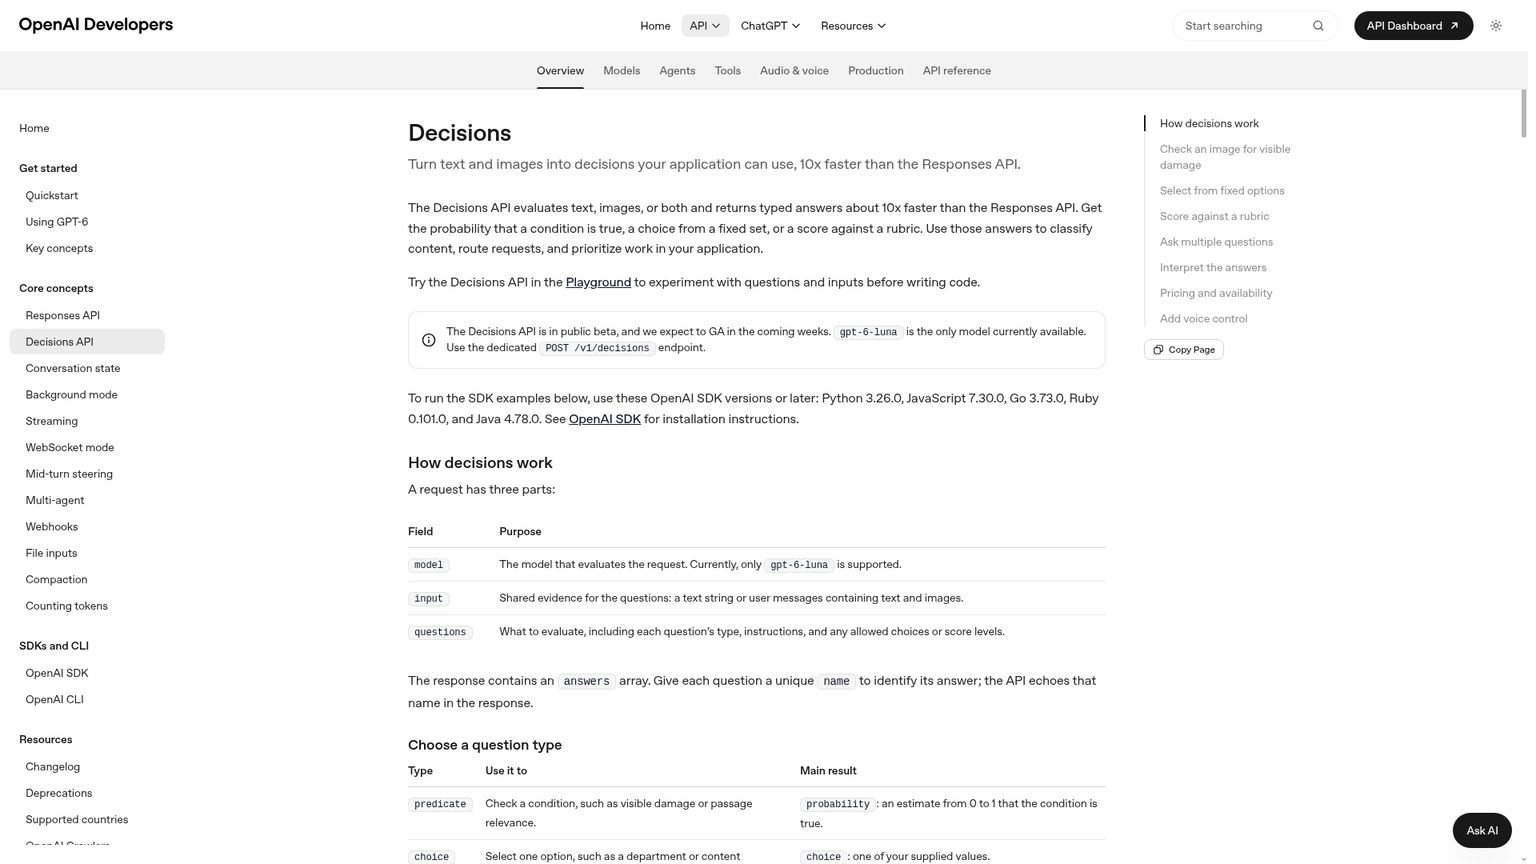
OpenAI Decisions APIは、gpt-6-lunaを使い、テキストと画像から型付きの回答を返します。アプリケーションがすでにOpenAIを使っていて、その連携の中で分類、決められた選択肢からの選択、評価基準に沿った採点を行いたい場合に適した候補です。基本料金は入力100万トークン当たり$0.10で、判断処理のコストはJevより高くなります。統合のしやすさや実測した業務品質が、その差額に見合う場合に選びましょう。OpenAI Decisionsのガイド
向いている用途: 既存のOpenAIアプリケーションで、テキスト・画像にラベルを付けたり、処理を進めるか判定したりする用途。
特徴: 専用エンドポイントからpredicate、choice、scoreの回答を得られます。
料金: 基本料金は入力1Mトークン当たり$0.10。出力、キャッシュ読み取り、キャッシュ書き込みの料金はありません。リージョンによる割増料金と、長いコンテキストに対する入力料金の倍率が適用されます。
無料トライアル: Decisionsガイドには記載されていません。
入力と実行環境: ホステッドのPOST /v1/decisionsエンドポイント経由で、テキストとインライン画像を入力します。
ライセンス: ホステッドAPIへのアクセスです。ガイドにはオープンウェイトの配布ライセンスは示されていません。現在のガイドと料金
APIは2026年10月6日にパブリックベータとなりました。導入の判断には、この提供段階も含めてください。新しいAPIにも検証する価値はありますが、フォールバックに採用する前に、レスポンスの解析、例外処理、アカウントからのアクセスが自社の実装で成立するか確かめる必要があります。OpenAIの変更履歴
移行時の課題は、リクエストとレスポンスの仕様です。OpenAIはinputと名前付き質問の配列を使い、yes/no型はpredicateです。Jev向けに作った質問オブジェクトを、そのまま転送することはできません。レスポンスに回答拒否が含まれる場合もあり、確率とは別に処理する必要があります。リクエストと回答の形式
たとえば返品処理では、商品写真に目で確認できる損傷があるかを問い、適切な確認先を選べます。ただし、それで誰が損傷を起こしたか、保証が適用されるか、返金が承認されるかまで分かるわけではありません。それぞれ別の判断であり、別の根拠や固定の業務ルールが必要です。
- テキストと画像をまとめて評価できます。
- 型付きの回答なので、文章で返されたラベルを解析する必要がありません。
- 専用ガイドで、判断処理の課金と他のモデルエンドポイントの課金を区別しています。
- 基本入力料金はJevや、最も安いホステッド候補より高くなります。
- パブリックベータであることを導入計画に織り込む必要があります。
- 固有のリクエスト形式と回答拒否に対応するアダプターが必要です。
5. Liquid AI d1-3B:テキストと画像をローカルで扱う第一候補
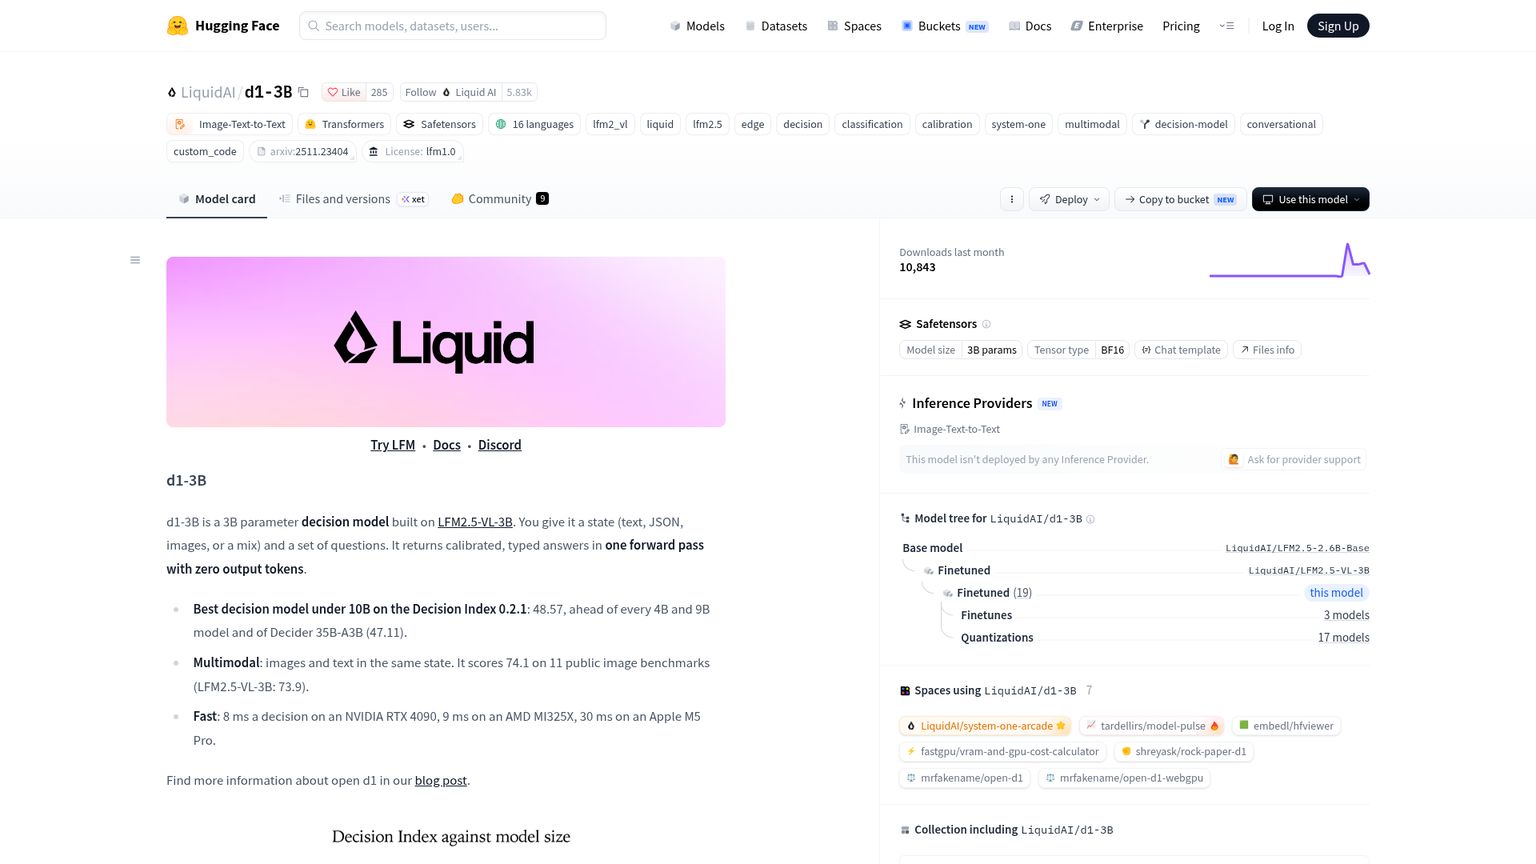
Liquid AI d1-3Bは、テキストと画像を入力できるオープンウェイトの判断モデルで、2026年10月7日に公開されました。説明文と画像の両方を分類する必要があるデスクトップアプリやエッジアプリなら、本記事のローカル候補の中で最初に検証したいモデルです。魅力は推論を実行する場所を自分で管理できることにあります。GPUを動かすほうが、非常に安いホステッドAPIより低コストだと約束するものではありません。Liquid AIのリリース発表
向いている用途: ローカルでの画像分類、画像を使った検査、テキストの振り分け。
特徴: ダウンロード可能なモデルで、ローカルハードウェアでの測定結果が公開されています。
料金: この公開チェックポイントについて、入力1Mトークン当たりの料金は未公表です。自前の計算資源の費用を見積もってください。
無料トライアル: ライセンスに従ってウェイトをダウンロードできます。計算資源は別途必要です。
入力と実行環境: テキスト、JSON、画像に対応。提供元のサンプルは、カスタムのTransformersコードでCUDA、Apple MPS、CPUに対応しています。
ライセンス: LFM Open License v1.0です。モデルカード、ウェイトのライセンス
基盤はLFM2.5-VL-3Bで、公開されているコンテキスト長は32,768トークンです。たとえば、作業者が製品画像を入力し、あらかじめ用意した検査項目を選ぶデスクトップの品質確認ツールが考えられます。ワークフローの残りもローカルで完結していれば、ホステッドの判断APIを呼び出さずにアプリケーションを動かし続けられます。ただし、撮影条件、画像のリサイズ、不良の定義を検証する必要は残ります。アーキテクチャとコンテキスト
Liquidが公表した単一質問の処理時間は、Jetson AGX Thorで16 ms、AGX Orinで26 ms、Orin Nanoで50 msです。これらはベンダーが公表したハードウェア上の測定値であり、自社の入力サイズでの性能を保証するものでも、インターネット経由のAPIリクエスト全体との比較でもありません。検証するハードウェアを絞る材料として使い、その後でアプリケーション全体を測定してください。Liquidの処理時間の表
ライセンスは調達時の制約になります。Liquidの両チェックポイントはLFM Open License v1.0を採用しており、商用利用条件には年間売上高1,000万米ドルの基準があります。自社の導入が条件を満たすと判断する前に、対象法人の定義と第5条を読んでください。条件に関わる場合はLiquidに確認しましょう。調達資料でこのモデルをApache-2.0と記載してはいけません。ライセンス全文
名称も区別する必要があります。Liquidは、ホステッドのd1を別枠で掲載しており、d1-3Bやd1-omni-600Mとは別です。ホステッド版のドキュメントと発表では入力のみの課金が説明されていますが、この比較で確認したページには100万トークン当たりのドル料金は公表されていません。ホステッドモデルの料金や制限を、ダウンロード版にそのまま当てはめないでください。Liquidのモデル一覧、ホステッドd1のガイド
オフライン製品での切り替え条件は、実際に使うデバイス上で品質とレイテンシーの基準を満たすことです。他のソフトウェアも動かした状態で、実際に近い画像を使い、継続運転を試してください。単独の推論が一度成功しても、必要な処理能力を判断するための出発点にすぎません。
- 判断の推論を、自分で運用するハードウェア内に収められます。
- テキストと画像の両方に対応します。
- 提供元の測定結果から、検証するエッジハードウェアを具体的に選べます。
- LFMの商用利用条件を確認する必要があります。
- 配信、処理能力の確保、実行環境の保守を自分で担います。
- ダウンロードできても、推論費用が固定額や無料になるわけではありません。
6. Liquid AI d1-omni-600M:小型デバイスの音声判断向け、研究段階の制約に注意
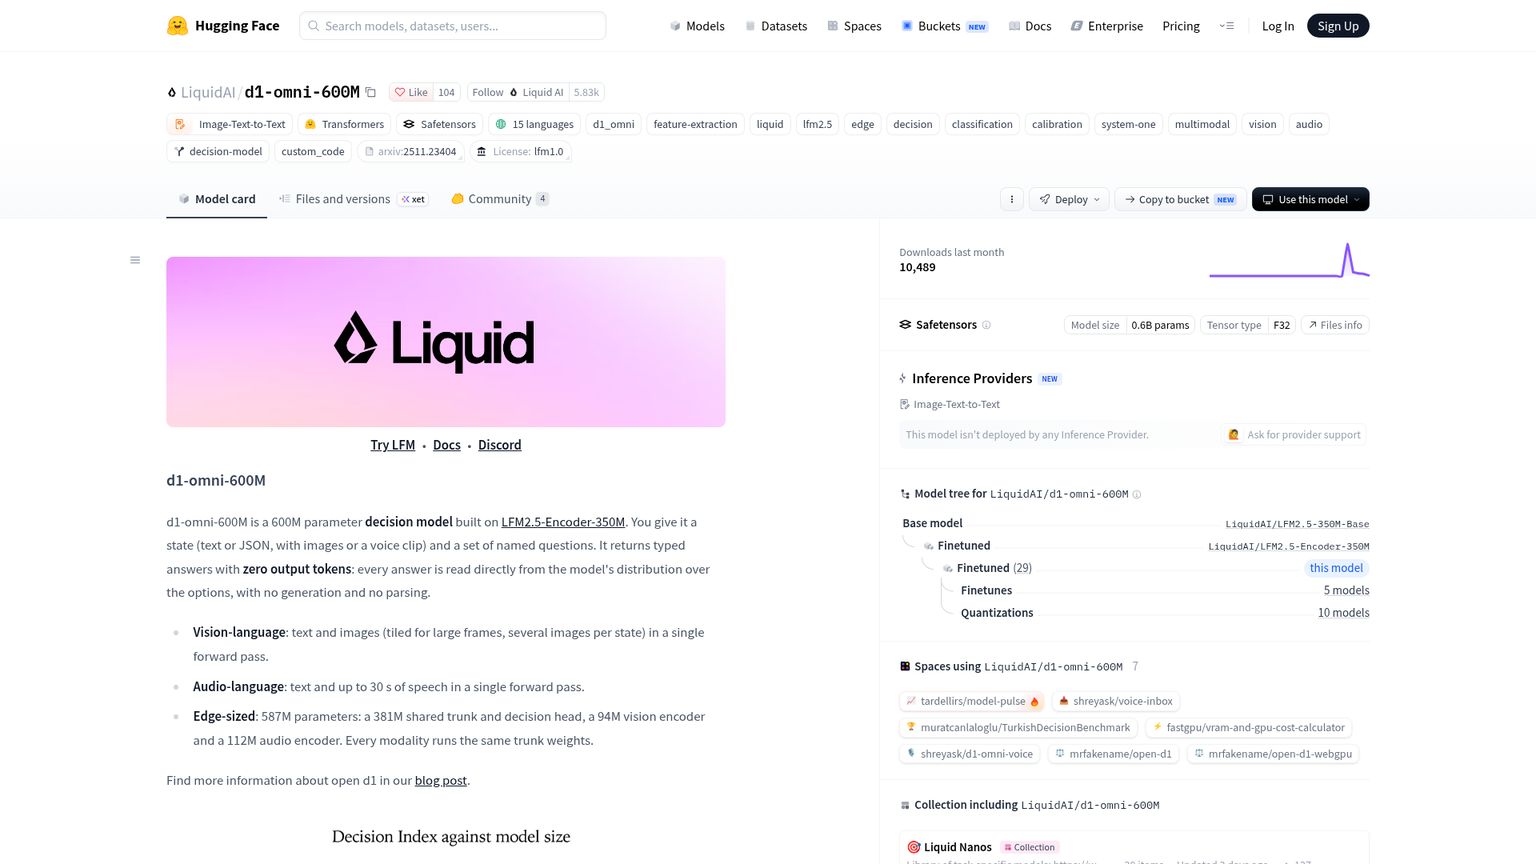
Liquid AI d1-omni-600Mは、小型の実験的な姉妹モデルです。テキストと画像、またはテキストと音声を扱います。限られた種類の音声指示を判別するデバイス向けの候補であり、あらゆるマルチモーダルのホステッドサービスを置き換えられると考えるべきではありません。小ささはローカル実行の魅力になりますが、入力と学習の制限が適否を左右します。音声コマンドの試験導入は、制限のない録音分析より狭い用途として捉えてください。リリースの位置付け、モデルカード
向いている用途: 小型デバイスでの、発話意図の判別や画像を使った判断の実験。
特徴: 音声入力を扱える、小型の公開チェックポイントです。
料金: この公開チェックポイントの入力1Mトークン当たりの料金は未公表です。
無料トライアル: ライセンスに従ってウェイトをダウンロードできます。計算資源の費用はかかります。
入力と実行環境: テキスト/JSONと画像、または音声に対応。ローカルのCUDA、MPS、CPUで動かすサンプルがあります。
ライセンス: LFM Open License v1.0で、同じ商用利用条件が適用されます。モデルカード、ライセンス
モデルカードでは5億8,700万パラメーターとされ、音声の学習は英語話者とアシスタントの間の依頼を基にしています。音声クリップは30秒で切り詰められます。そのため、長い多言語の顧客通話より、「検査を一時停止して」といった指示のほうが適切な評価対象です。音声を入力できることは、あらゆる種類の音に対する性能の裏付けにはなりません。音声の対象範囲
見落としやすい制限もあります。モデルのコンテキスト全体は16,384ポジションですが、画像を使うとstateと質問のテキストは896トークンで切り詰められます。画像に長い操作マニュアルを添える場合、コンテキスト全体の数値からは余裕があるように見えても、テキスト側の上限を先に超える可能性があります。コンテキストの詳細
キオスク端末では、コマンド一覧と端末内のルールを簡潔にし、認識できない依頼を処理する経路も用意してください。明瞭な指示だけでなく、周囲の会話が入った場合や文脈が不足した場合も、同じように評価します。役に立つのは、常に正しそうな選択肢を返すシステムではなく、指示が不明確なときに判断を控えられるシステムです。
Liquidの公開時の発表には、この実験モデルの速度測定値はありません。より大きなd1-3Bの処理時間を流用したり、パラメーター数が少ないことからレイテンシーを保証できると考えたりしないでください。アプリケーションにはメディアの処理とモデルの読み込みが必要で、実行環境をデバイスの運用予算内に収める必要もあります。公開時に測定された範囲
- 小型で、リソースに制約のあるローカルデバイスの候補になります。
- 画像に加えて、音声を使う判断にも対応します。
- オープンウェイトなので、デプロイ構成を確認し、自分で運用できます。
- 実験的なリリースで、公開されている音声学習の対象範囲も限定的です。
- 画像付きリクエストのテキスト上限は、コンテキスト全体の数値より大幅に小さくなります。
- 公開時の発表に、このモデル固有の速度測定結果はありません。
7. Amazon Strands Decider 2B:中身を確認できるローカルのエージェント実行判定
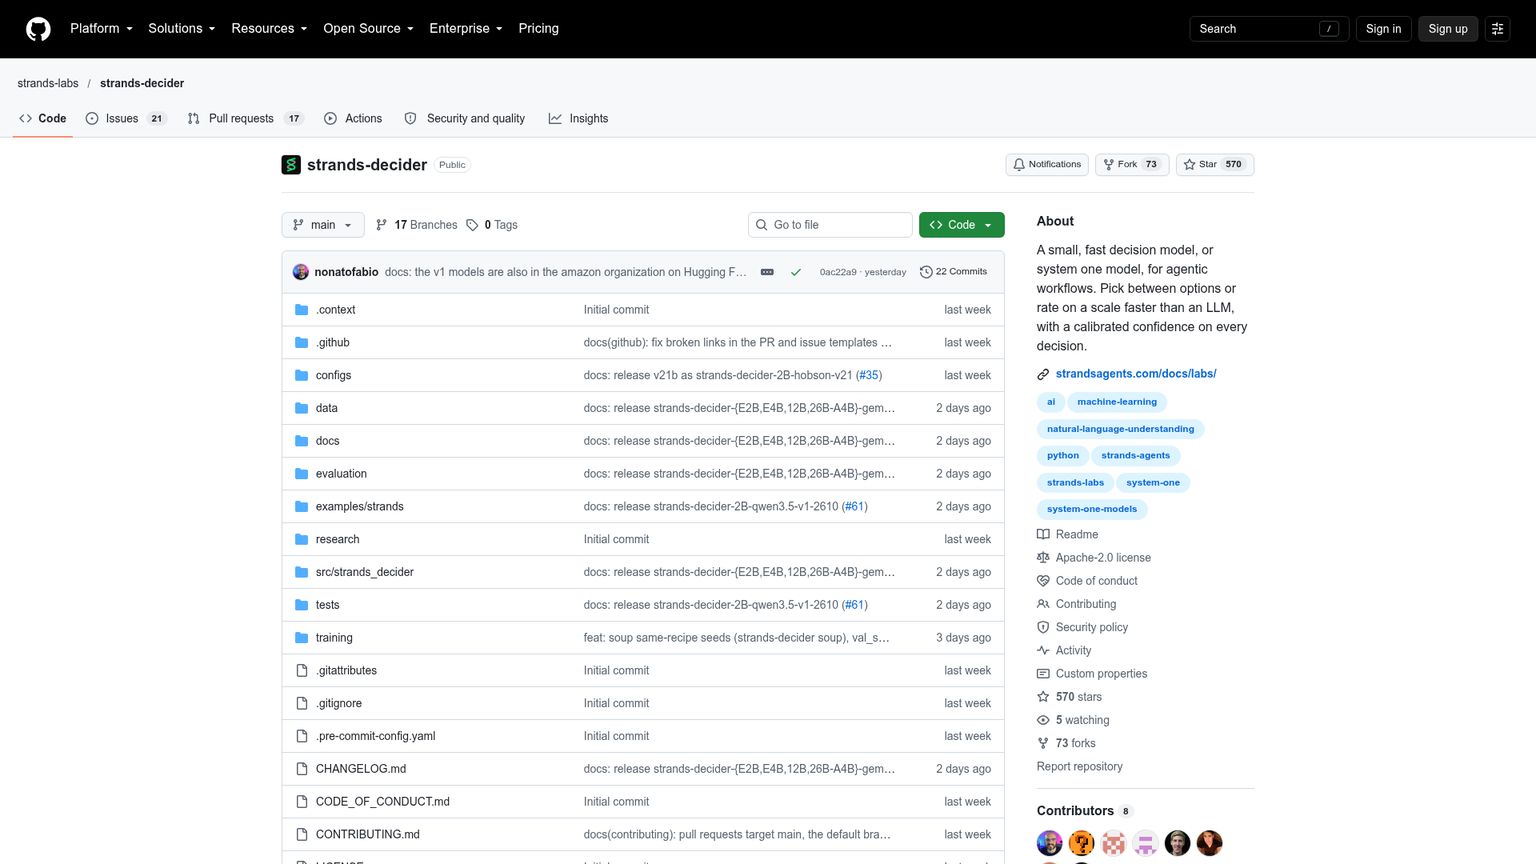
Amazon Strands Decider 2Bは、Strands Labsが公開する判断モデルです。推論コード、学習資料、評価結果が公開されています。ホステッドのJevから離れる理由が、自前のエージェント実行環境内で小さな判断コンポーネントを管理することにあるなら、有力な候補です。まずは、提案された操作が短いポリシーに適合するかを調べるような、範囲の限られた業務から始めましょう。付属のローカルサーバーを、完成したホステッド製品と捉えてはいけません。提供元のリポジトリ
向いている用途: ローカルでのエージェント実行判定、振り分け、学習手法の実験。
特徴: モデルのウェイト、コード、評価の詳細をまとめて確認できます。
料金: ホステッドの入力1Mトークン当たりの料金は未公表です。実行環境は自分で用意します。
無料トライアル: Apache-2.0のモデルとコードをダウンロードできます。計算資源は別途必要です。
入力と実行環境: テキストに対応し、視覚処理を使う場合は画像も追加できます。CUDA、Apple Silicon、CPUを選べます。
ライセンス: 記載したQwenベースのチェックポイントとプロジェクトはApache-2.0です。現在のモデルカード
チェックポイントは正確に固定してください。リポジトリが現在参照しているのは**strands-decider-2B-qwen3.5-v1-2610**です。Qwen3.5-2B-Baseを基盤とし、学習済みアダプターと、許可された回答を採点する判断ヘッドを備えています。旧名称のhobson-v19とhobson-v21も残っているため、性能を記載するときはバージョンを併記する必要があります。バージョンとアーキテクチャ
この区別は、よく引用される115 msという処理時間にも関わります。リポジトリの詳細表では、RTX 3090で測定したこの中央値はv19の値です。新しいバージョンの欄には、アーキテクチャと規模を共有すると記されています。つまり、これはベンダーが公表した過去の測定値であり、現在のチェックポイントを新たに測った結果ではありません。導入予定のチェックポイントに対応する測定値を使ってください。バージョン別の性能表
付属サーバーはlocalhostにバインドし、認証機能はありません。ローカルでの実験には役立ちますが、ネットワークサービスにするなら、アクセス制御、同時実行の設計、デプロイの責任分担、監視も必要です。社内エージェントなら、モデルのプロセスがコールド状態、処理中、利用不能のときにどうするかを、運用担当者が決めなければなりません。「ローカルで動かす」はデプロイ方式であって、可用性の確保策ではありません。推論サーバーの手順
最初の具体例としては、「提案された操作は記録を読むだけか、それとも記録を変更するか」を判別する方法があります。その場合も、ユーザーの権限と許可された操作は、固定のアプリケーションルールで確認してください。モデルが安全と判断しても、認証済みユーザーに実行権限がなければ、操作は引き続きブロックします。
- Apache-2.0のモデルとコードを使い、自前で運用するコンポーネントを構築できます。
- 学習と評価の資料が公開されており、その前提を確認できます。
- 小型モデルをCPUやApple Siliconで動かせるため、評価環境の選択肢が広がります。
- ここでは、提供元が運用するホステッドの入力料金やマネージドエンドポイントは確認できません。
- ローカルのサンプルサーバーは、完成した本番サービスではありません。
- 過去のレイテンシーは、測定対象のチェックポイントと結び付けて扱う必要があります。
月額料金で変わること、変わらないこと
削減率が大きくても、削減額は小さい場合があります。月100万回の判断を行い、毎回1,000入力トークンが課金されると仮定します。合計は10億入力トークンです。確認済みの基本料金で計算すると、入力のみのモデル料金は、Perplexityが$20、Clef-flashが$38、JevまたはMicrosoft-Decision-1が$42、OpenAI Decisionsが$100、Clef-omniが$150、Clefが$240になります。Perplexity、Cloudflare、TypeSafe、Microsoft、OpenAI
これは、課金対象のトークン数を意図的にそろえた試算です。同じ業務データでも、トークナイザー、質問の構成、メディア処理が異なれば、課金される総量も変わります。数値には、無料枠、プラットフォームの契約料金、リージョンや長いコンテキストによる割増、再試行、後段の生成処理、担当者の確認作業を含めていません。
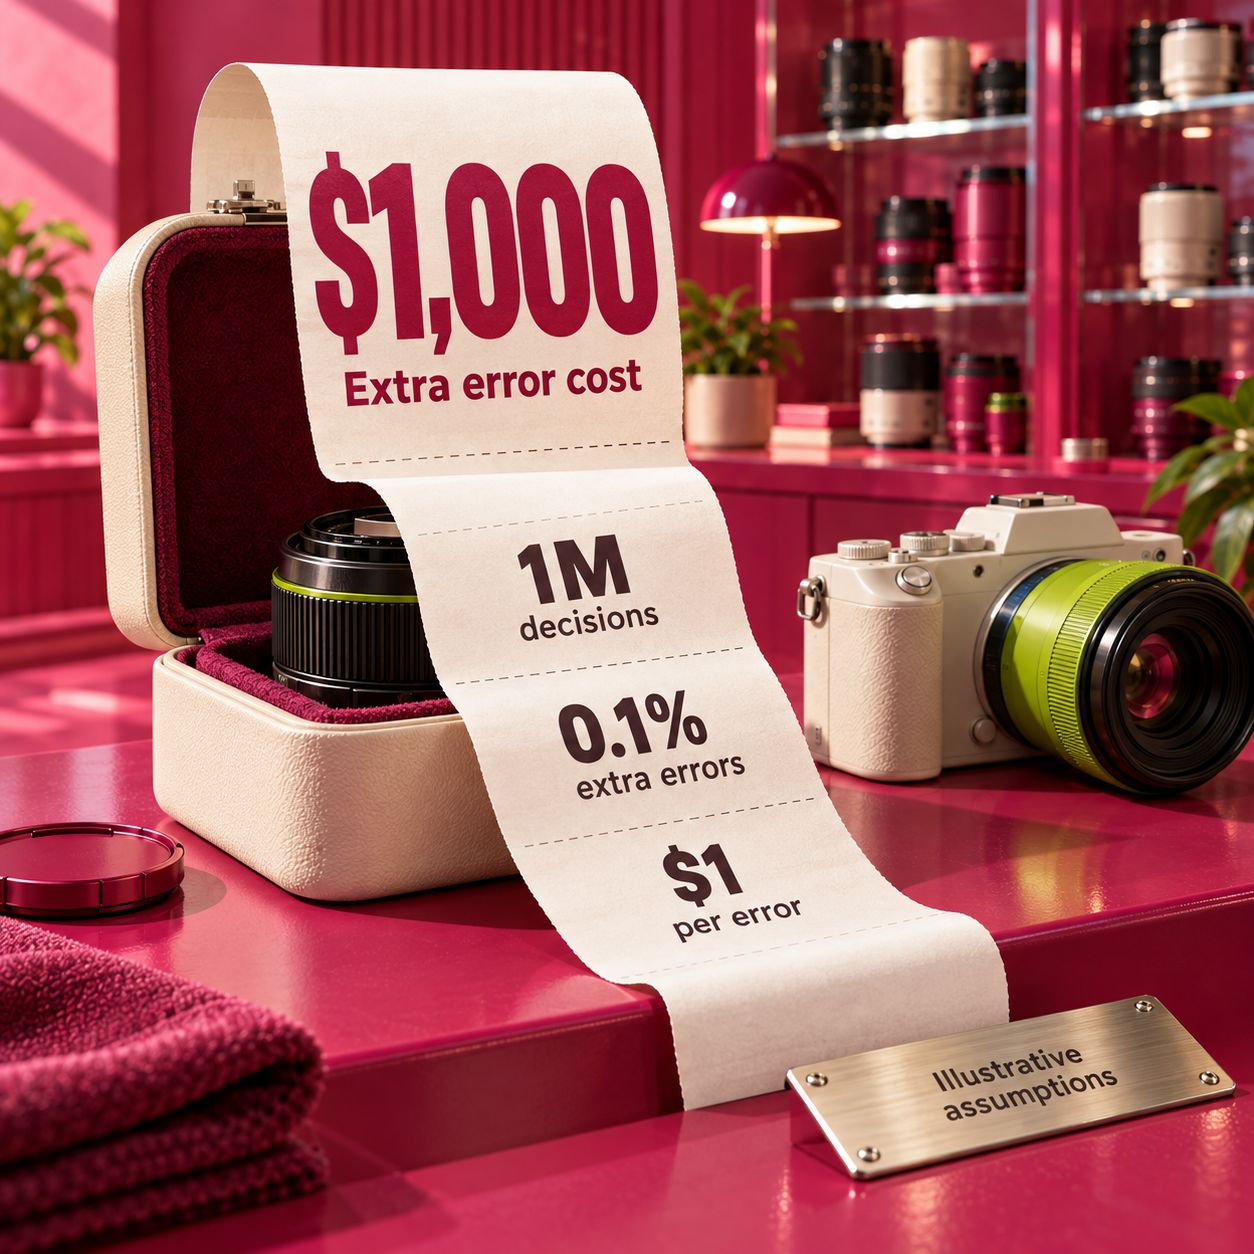
次に、候補モデルの誤り率が0.1パーセントポイント高く、増えた誤りへの対応に1件当たり$1かかると仮定します。100万回の判断では、誤りが1,000件増え、追加費用は$1,000になります。これは説明のための仮定であり、測定した失敗率でも、人件費の相場でもありません。トークン単価だけでなく、採用する判断全体を最適化すべき理由を示しています。
セルフホストでも、同じように採算を確認します。追加インフラ予算を月$100とすると、Perplexityの100万トークン当たり$0.02という基本料金と同水準になるには、運用や品質差を考慮する前でも、月50億入力トークンが必要です。$100は仮定であり、GPUの見積価格ではありません。余っている既存ハードウェアがあれば計算は変わります。また、トークン料金が下がらなくても、データをローカルに保つことや、オフライン製品を支えることが導入理由になります。
将来の費用を見積もる前に、実際の業務で課金量を測定してください。たとえば、Liquidの別サービスであるホステッドd1は、各質問についてテキストと添付画像を再度カウントします。そのため、複数の質問を同じHTTP呼び出しで送っても、共通の判断材料への課金が一度だけになるとは限りません。この課金ルールから、公開チェックポイントのドル料金が分かるわけでもありません。Liquidの課金に関する説明
本番で使うなら、どれを選ぶべき?
通常の振り分けでホステッド費用を下げたいなら、まずPerplexityを検証します。 Workers内に収めることでアプリケーションがシンプルになるなら、Clef-flashを先に試しましょう。選択を左右するのは、候補がリクエスト頻度、入力長、実測した誤振り分け率と確認作業量の許容範囲に合うかどうかです。正しい振り分け先を決める情報が欠ければ、安い料金も使い慣れた基盤も、その欠落を補えません。
ラベル付けでは、曖昧な事例でも自社の分類体系を維持できる候補を優先します。 FoundryならMicrosoft-Decision-1が自然な候補で、価格重視のホステッドならPerplexityが候補です。同じコメントが複数のテーマに属しうるかも確認してください。単一選択の質問では答えが1つに絞られるため、複数ラベルの問題は別々のチェックに分解するなど、意図に合う形で表現する必要があります。
エージェントの実行判定では、安定して運用できる実行環境を選び、権限の制御はコードに残します。 ローカルのコンポーネントならStrandsを検証する価値があります。既存のホステッド連携には、MicrosoftやOpenAIが合う場合もあります。モデルは提案された操作について推定を返せますが、権限、支出ルール、許可された操作の強制は、アプリケーションが別途担わなければなりません。
デバイス内で処理するなら、テキストと画像にはd1-3B、用途を絞った音声実験にはd1-omni-600Mから始めます。 ライセンスや確認可能な学習手法がプロジェクトに合うなら、Strandsもローカル候補です。この選択では、ホステッド料金を比較する前に、デバイス、入力の前処理、許可される商用利用の条件で適否が決まります。
ホステッドアプリケーションで音声・動画を使って判断するなら、Clef-omniを検証します。 メディアを扱う経路そのものに、実質的な違いがあります。安いテキストモデルを代わりに使えるのは、前処理を意図的に追加し、その処理で失われる情報を検証した場合です。
予備の選択肢を用意するなら、どの障害に備えるのかを決めてください。同じゲートウェイの背後にある2つのモデルIDは、どちらもそのゲートウェイに依存します。ローカルのフォールバックも、入力の取得に同じ停止中の上流サービスを使うなら失敗します。リクエスト経路全体を図にして、停止時にも処理を続けたい依存先を切り離しましょう。
ワークフロー全体を替える前に、判断処理を1つ移す
置き換えが成功したといえるのは、有効なJSONが返ったときではなく、アプリケーションが求める判断の仕様を維持できたときです。プロバイダー固有のフィールドに対応しつつ、振り分け先の名称、評価基準の意味、フォールバックの動作は変えずに保ってください。そうすれば、モデルの変更とポリシーの変更を混在させず、判断が食い違った理由を検証できます。
判断の定義と根拠となる情報を固定する
新しいサポートチケットの振り分けなど、既存の呼び出しを1つ選びます。許可するラベル、ポリシーのバージョン、入力フィールド、情報不足と見なす条件を記録してください。ラベル付きデータには、答えが明らかな例だけでなく、曖昧な例や対象外の業務も含めます。
プロバイダーごとの入出力に対応する
判断材料、質問の定義、回答の読み取り方を明示的に対応付けます。OpenAIは入力フィールドと名前付き質問の配列を使い、PerplexityとMicrosoftの公開サンプルはstateとキー付きの質問を使います。画像の格納方法も異なります。基本要素の名前が似ていても、通信上の形式まで同じと考えず、提供元の公式ガイドで確認してください。
現行の判断と並行して候補を動かす
実際の処理は現行ワークフローに任せ、候補モデルは回答の記録だけを行います。採用された誤判断、担当者への引き継ぎ、リクエスト失敗、課金使用量、応答が遅いケースを比較してください。両モデルに同じ判断材料を渡し、前処理の変更をモデルの改善と取り違えないようにします。
このモデルと業務に合うしきい値を設定する
別のAPIが確率やconfidenceという名前のフィールドを返すだけでは、Jevのしきい値を流用できません。ラベル付きの事例で、スコアと実際の正しさの関係を再確認してください。情報不足、プロバイダー障害、回答拒否については、別の確認経路を設けます。
段階的に切り替え、元に戻せる状態を保つ
選んだワークフローだけを変更します。以前のモデル設定と、それに戻す手段を残してください。チェックポイント、モデルのエイリアス、質問文、前処理が変わったら再評価します。どの変更も、設定したしきい値で採用される判断に影響しうるためです。
出発点がJevへの直接の判断リクエストではなくJev Routerなら、まず課金の境界を確認してください。ルーティングサービスと、それが選ぶ後段のモデルは、請求の別々の部分です。Jev Routerの料金ガイドで、この違いを説明しています。判断モデルが安くても、回答の生成まで無料になるわけではありません。
避けたい選び方
Jevの現行基本料金だけが不満なら、トークン料金の削減を目的にMicrosoft-Decision-1へ移行するのは避けましょう。公表料金は同じです。プラットフォームとの相性や品質で選ぶ価値はありえますが、それは別の理由です。
入力サイズを管理しないまま、際限なく増える判断材料のアーカイブをホステッドのClef-flashに渡すのは避けてください。切り詰めた後に正常な回答が返っても、重要な情報が判断に届かなかったことを見落とすおそれがあります。上限に収まる業務で使うか、適切なコンテキスト容量がある方法を検証しましょう。
omniという名前だけを根拠に、d1-omni-600Mを長時間の録音の制限なき分析に使うのは避けましょう。公開されている音声の対象範囲、クリップの切り詰め、実験的な提供段階は、いずれも重要です。この比較のホステッド候補で、より多様なメディアが必要な場合に検討するのはClef-omniです。ただし、同モデルにも固有の制限があります。
オープンウェイトを、無料の本番サービスと同じ意味で捉えるのは避けてください。Liquidには条件付きのライセンスがあり、Perplexityの参照構成には大容量メモリが必要で、Strandsのホスティングは自分で担います。モデルのダウンロードは、運用責任を引き受ける出発点です。
未確認のクローンを緊急時のフォールバックにするのは避けましょう。製品名が似ていたり、エンドポイントが互換に見えたりするだけでは、提供元、利用可能なライセンス、保守される実行環境、独立した障害経路を確認したことにはなりません。除外する理由は裏付けが不足していることであり、コミュニティ製プロジェクトがすべて低性能だと主張しているわけではありません。
よくある質問
Jevの代替に無料で使えるものはありますか?
Cloudflareには、Workers AI共通の日次無料枠があります。複数の候補がウェイトも公開していますが、計算資源は自分で用意し、ライセンスに従う必要があります。Liquidのホステッド版ドキュメントには、テキスト専用のd1:freeモデルが別途掲載されていますが、今回確認したページには利用枠の記載がありません。無料でアクセスできる方法があっても、本番運用の費用がゼロになる保証とは捉えないでください。Liquidのホステッドモデルのガイド
Jevの代替でウェイトが公開されているモデルはどれですか?
Clefのモデル群、ここで挙げたPerplexityのチェックポイント、Liquidの2つのd1チェックポイント、Strands Deciderには、提供元が公開するウェイトの入手方法があります。Clef、Perplexity、ここで挙げたStrandsのチェックポイントはApache-2.0です。Liquidは商用利用条件付きのLFM Open License v1.0を採用しています。OpenAI DecisionsとMicrosoft-Decision-1は、この比較ではホステッドの選択肢であり、参照した提供元のページにオープンウェイトのライセンスは示されていません。
Jevの代替は、まずどれから試すべきですか?
ホステッドの入力料金を下げたいならPerplexity、既存のWorkersアプリケーションならClef-flash、FoundryならMicrosoft-Decision-1、OpenAIとの既存連携ならOpenAI Decisionsを先に検証します。ローカル運用では、テキストと画像ならd1-3B、用途を絞った音声実験ならd1-omni-600M、中身を確認できるエージェントのコンポーネントならStrandsから始めましょう。最終的な選択は、自社の業務での評価によって決まります。
次の業務で着手すること
どんな誤りが大きな損失につながるかを、担当者が説明できる判断処理を選びましょう。価格、プラットフォーム、メディア入力、ローカル運用のうち、必要な理由に合わせて候補を1つ選びます。同じ判断材料を使ってJevと並行比較し、採用された誤判断、確認作業量、応答期限が許容範囲に収まる場合にだけ切り替えてください。通常の業務で新しい処理経路を信頼できるようになるまで、元の設定を使える状態で残しておきます。
まずどの判断を見直すべきかを整理するには、AI業務ワークフロー監査チェックリストをご活用ください。
- 公開日
- カテゴリー
- Build
- 言語

OpenAI Decisions APIの使い方:問い合わせの自動振り分けと料金
OpenAI Decisions APIの使い方を、問い合わせチケットの自動振り分けを軸に解説します。三つのリクエスト例、回答拒否への対応、信頼度のしきい値、料金と制約を整理。既存のLLM呼び出しやルール処理を残すべき場面も含め、移行の手間に見合うかを実データで判断するための手順を紹介します。2026年10月11日Build
Claude Code Remote Controlの使い方:スマホ接続とエラー対処
Claude Code Remote Controlで、パソコンの作業をスマホやブラウザから続ける方法を解説します。CLI・VS Code・Desktopの設定、対応プラン、通知、ログインや接続エラーの対処まで整理。ローカルで実行される処理と、Anthropicに保存されるセッション記録の違いも確認できます。2026年10月9日Build
Cursorのスマホ操作ガイド:iPhoneでRemote Controlを設定する
Cursorをスマホから操作したい開発者向けに、iPhoneとPCのペアリング手順、スリープを防ぐ設定、Enterpriseの利用条件を解説します。ローカルとクラウドの実行環境、料金の考え方、Claude CodeやCodexとの違いも整理し、離席中の進捗確認や短い指示に役立つ活用例を紹介します。2026年10月9日Build
Firecrawl 料金ガイド2026:プラン別の実費とクレジットの計算方法
Firecrawlの料金プランを、クレジット消費と実際の処理量から比較します。通常ページの取得、JSON抽出、毎週のクロールはいくらかかるのか。月払い・年払い、追加クレジット、失敗ページの課金、無料枠、セルフホストや代替サービスまで整理し、パイプラインに合うプランと支出上限の決め方を解説します。2026年10月9日Build
Claude Code 料金比較:GitHub Copilotとの違いと2026年の選び方
Claude CodeとGitHub Copilotの料金・利用制限・対応モデルを比較。個人開発者と10人チームの費用、ターミナルとエディターでの使い勝手、チーム管理やデータの扱いまで整理します。追加利用料や上位プランへの切り替え、併用時の月額費用を押さえ、自分の開発環境に合う選び方を解説します。2026年10月8日Build
LangGraphとCrewAIを比較:承認フロー・状態管理・料金で選ぶ
LangGraphとCrewAIを、企業調査から営業メールの下書き、人による承認までの同じ業務で比較します。状態管理とメモリ、MCP連携、可観測性、ホスティング料金の違いをコード例と費用試算で解説。個人開発、スタートアップ、大企業それぞれの選び方と、本番運用で必要になる復旧・移行の判断材料が分かります。2026年10月7日Build
MCPサーバーをPythonで自作する:注文照会から認証・公開まで
PythonでMCPサーバーを自作し、読み取り専用の注文照会をMCP Inspectorで検証。Claude CodeとCursorへの接続から、OAuth認証付きHTTPサービスの構築、RenderやCloudflare Workersへの公開までを、コードと料金例で解説します。権限設計とログ管理も確認できます。2026年10月7日Build