Alternativas ao Jev em 2026: qual modelo de decisão escolher?
Compare alternativas ao Jev por preço em USD, licença e implantação: Perplexity, Cloudflare, Microsoft, OpenAI, Liquid e Strands. Saiba qual avaliar primeiro.
Publicado em
 Por Omid Saffari






Entre as alternativas ao Jev, a API da Perplexity, a US$ 0.02 por milhão de tokens de entrada, é a primeira que vale avaliar para reduzir a conta de um serviço hospedado. Clef-flash faz mais sentido se sua aplicação já roda na Cloudflare, enquanto Liquid AI d1-3B é o ponto de partida para decisões locais com imagens. Com um milhão de decisões mensais e 1,000 tokens de entrada faturados por decisão, trocar Jev por Perplexity economiza apenas US$ 22 na cobrança básica de entrada. Escolha a opção que mantenha a taxa de erro das decisões aceitas e rode no ambiente de que sua aplicação precisa.
Preços, licenças e documentação de implantação verificados em 11 de outubro de 2026. Os preços abaixo são os divulgados pelos próprios fornecedores. Os valores mensais são cálculos baseados nas premissas indicadas, não contas de um teste em produção. Nenhum modelo foi executado para este comparativo.
Alternativas ao Jev: qual faz sentido para cada tarefa?
Comece pelas restrições de implantação e depois compare a qualidade nas decisões da sua aplicação. Em uma API hospedada, o fornecedor opera o modelo. Pesos abertos permitem obter os arquivos do modelo e executar a inferência por conta própria, respeitando a licença; isso não significa que alguém fornecerá processamento gratuito.
Os preços dos serviços hospedados não representam o custo de inferência em infraestrutura própria. Nos modelos da Liquid e do Strands disponíveis para download, não divulgado significa que as páginas dos fornecedores não informam uma tarifa fixa por token de entrada. Hardware, energia, hospedagem e operação continuam tendo custo. Os detalhes de licença e checkpoint estão nas seções de cada opção.
A referência atual da TypeSafe é o Jev 1.13, com ID de modelo jev-1.13.0, a US$ 0.042 por milhão de tokens de entrada e saída gratuita. Ele aceita texto e texto estruturado, como JSON, mas não imagens, áudio ou vídeo. Assim, a Microsoft cobra a mesma tarifa de entrada publicada para Jev; a OpenAI custa mais na tarifa básica; Perplexity e Clef-flash custam menos. Catálogo de modelos da TypeSafe
Uma integração existente com Jev já tem algo valioso: a definição das decisões de que a aplicação precisa. Preserve essa definição. Se chamados de cobrança devem ir para o financeiro e problemas de acesso à conta devem ir para o suporte, o substituto precisa se provar nesses casos antes que um benchmark de destaque influencie a escolha.
Como selecionamos os modelos
A seleção prioriza modelos com API, ficha técnica ou repositório mantidos pelo próprio fornecedor e documentação suficiente para decidir como implantá-los. Clones da comunidade sem uma página verificada do responsável ficam fora do comparativo. A lista reúne seis fornecedores em sete opções de escolha: a família Cloudflare ocupa uma seção, enquanto os dois modelos da Liquid pedem recomendações separadas.
Os critérios são práticos: tipos de entrada necessários, operação hospedada ou local, licença dos pesos, limites documentados que podem inviabilizar a carga de trabalho e custo de uma decisão aproveitável. Uma decisão aproveitável é aquela que a aplicação pode aceitar sem uma correção cara ou um encaminhamento desnecessário para outra instância.
A ordem começa pelo candidato mais forte entre os serviços hospedados de menor preço, passa pelas opções que se encaixam em plataformas específicas e chega às alternativas locais. Não é um ranking de precisão. Os testes dos fornecedores usam conjuntos de dados, hardware, tamanhos de entrada e caminhos de rede diferentes. Todos os números de desempenho citados aqui foram divulgados pelos fornecedores; nenhum demonstra que um modelo superará Jev nos seus chamados.
Também é preciso delimitar a tarefa. Esses modelos escolhem ou atribuem pontuações entre resultados definidos. Se você precisa de uma resposta de suporte por escrito ou de uma explicação, mantenha uma etapa de geração. Nosso comparativo Jev vs GLM-5.3-Flash explora essa escolha mais ampla.
As sete opções para avaliar
1. Perplexity pplx-decider-v1.1-27b: comece por aqui para pagar menos na API hospedada
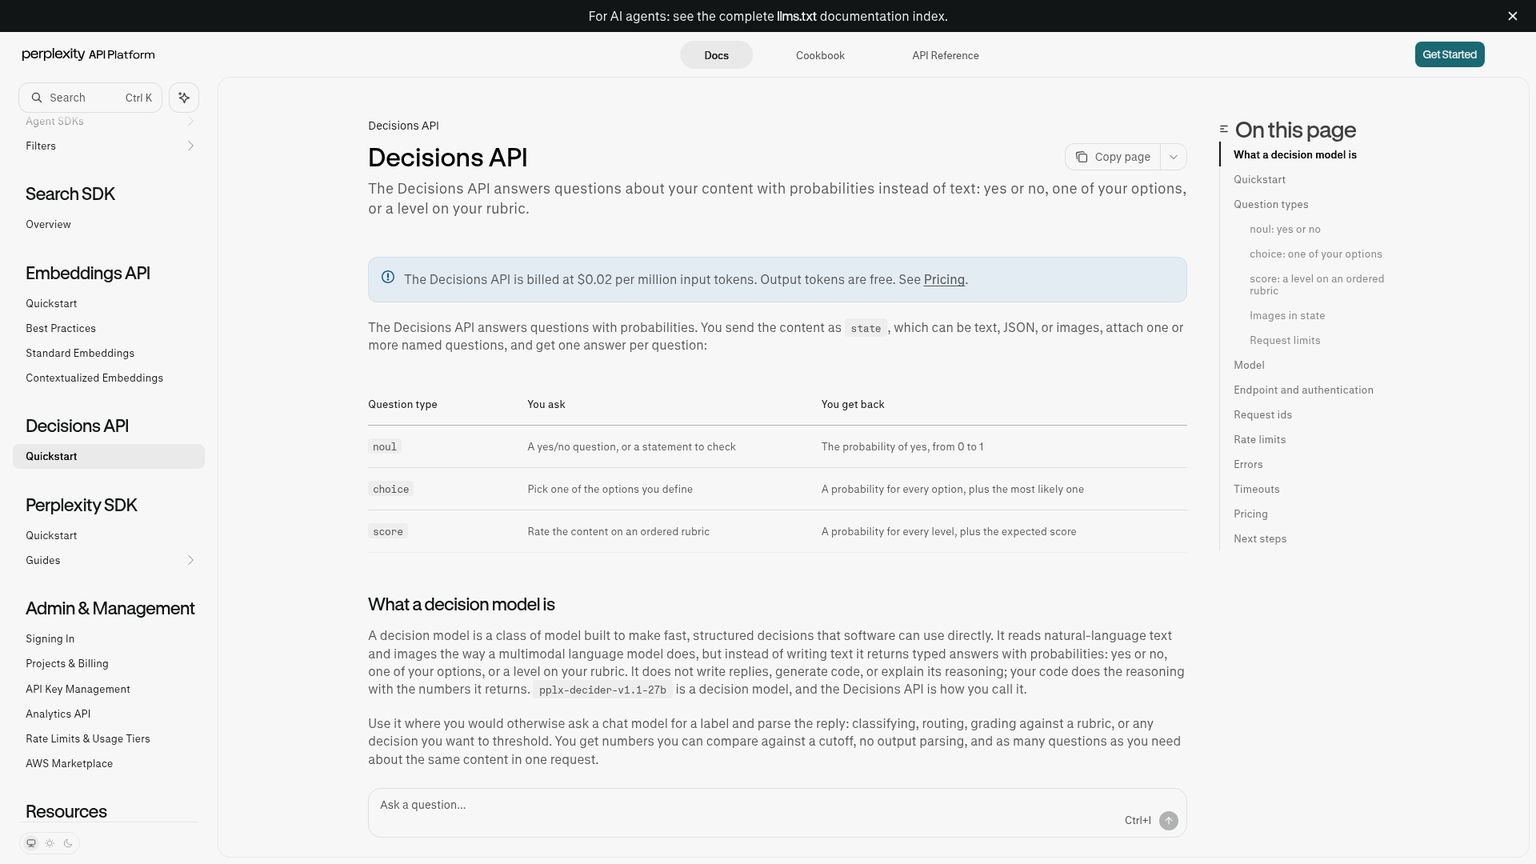
Perplexity pplx-decider-v1.1-27b é um modelo de decisão disponível pela Decisions API, a API de decisão hospedada da Perplexity, e como checkpoint para download. É o primeiro candidato que eu avaliaria para roteamento comum de suporte ou rotulagem em lote quando o objetivo é simplesmente reduzir o custo de entrada do Jev. Sua tarifa é a menor entre as tarifas publicadas dos serviços hospedados desta seleção. A recomendação muda se o limite de requisições, os requisitos de execução local ou a taxa de erro não atenderem à sua carga de trabalho.
Melhor para: Roteamento, rotulagem e pontuação por critérios com menor custo em serviço hospedado.
Diferencial: API direta e uma opção separada de implantação com pesos abertos.
Preço: US$ 0.02 por 1M de tokens de entrada; saída gratuita; sem taxa por requisição.
Teste gratuito: não divulgado no guia da Decisions citado.
Entradas e ambiente de execução: Texto, JSON e imagens embutidas na requisição pela API da Perplexity; hardware CUDA para a implementação local fornecida.
Licença: Apache-2.0 para o checkpoint disponível para download; o acesso hospedado continua sendo um serviço separado. Guia da API, licença do checkpoint
O gargalo da versão hospedada é a vazão: a Perplexity documenta 10 requisições por segundo por organização em todos os planos. São permitidas até 128 perguntas sobre evidências compartilhadas, com entrada total inferior a 262,144 tokens. Limites de requisição Um lote de chamados independentes não vira automaticamente uma requisição com estado compartilhado só porque todos precisam de um rótulo. Evite juntar casos sem relação de uma forma que altere a tarefa. Limites do serviço hospedado
Com esse teto, um milhão de requisições separadas levaria pelo menos 27.8 horas, mesmo com agendamento perfeito e sem novas tentativas. Esse é um limite mínimo calculado, não uma medição de velocidade. Processar um acervo acumulado durante a noite e receber um fluxo pequeno e constante de chamados impõem demandas muito diferentes à mesma API barata.
A execução em infraestrutura própria tem outro gargalo. A configuração fornecida pelo fabricante exige cerca de 49 GiB para os pesos, além da memória de trabalho, e sua implementação de prepare rejeita entradas combinadas acima de 8,192 tokens. As configurações de atenção e calibração usadas na avaliação precisam ser preservadas. A ficha também mantém uma referência a acesso autenticado a repositório privado; por isso, confirme que sua conta consegue baixar o checkpoint antes de se comprometer com a implantação local. Ficha do modelo da Perplexity
Não copie o limite de contexto hospedado para uma especificação de implantação local. A versão local precisa ser avaliada como um ambiente de execução próprio, incluindo o pré-processamento real, o uso de memória e a revisão do modelo. Caso contrário, a alternativa de contingência pode falhar justamente nos registros longos que já causaram dificuldades ao serviço principal.
- Menor tarifa de entrada publicada entre os serviços hospedados desta seleção.
- Texto e imagens podem fazer parte da mesma requisição de decisão.
- O checkpoint Apache-2.0 oferece uma opção além do serviço hospedado.
- O limite de requisições por organização pode restringir o processamento de acervos ou picos de tráfego.
- A configuração local fornecida exige bastante memória de GPU.
- Os limites de entrada do serviço hospedado e da implementação local de referência são muito diferentes.
Na primeira comparação, escolha uma tarefa pequena o suficiente para inspecionar os erros diretamente.
Mantenha as definições atuais das filas
Use os rótulos e os casos limítrofes da sua implementação com Jev. Preserve uma saída explícita de outros ou revisão para chamados que não se encaixem nessas definições. Nosso guia de roteamento de chamados com Jev apresenta um fluxo de referência para a comparação.
Use o formato nativo de requisição da Perplexity
Defina o modelo como
pplx-decider-v1.1-27be enviestatecomquestionsnomeadas paraPOST /v1/decisions. Use uma pergunta do tipochoicecomcriteriaque descrevam cada fila. Siga a referência da API nativa para o contrato de requisição e resposta.Registre as respostas sem alterar os encaminhamentos
Leia a resposta associada ao nome da pergunta. Armazene o rótulo selecionado, as probabilidades retornadas, o consumo de entrada faturado e o status da requisição ao lado do resultado atual do Jev. Separe falhas do fornecedor de decisões válidas com baixa confiança.
Defina a condição de troca antes de saber quem venceu
Estabeleça uma taxa aceitável de encaminhamentos errados, um volume de revisão e um prazo de resposta. Coloque o candidato em operação apenas se ele atender a essas condições em uma amostra representativa e rotulada do trabalho. Uma conta menor de tokens de entrada, por si só, não atende ao critério.
2. Cloudflare Clef, Clef-flash e Clef-omni: escolha pelos tipos de entrada
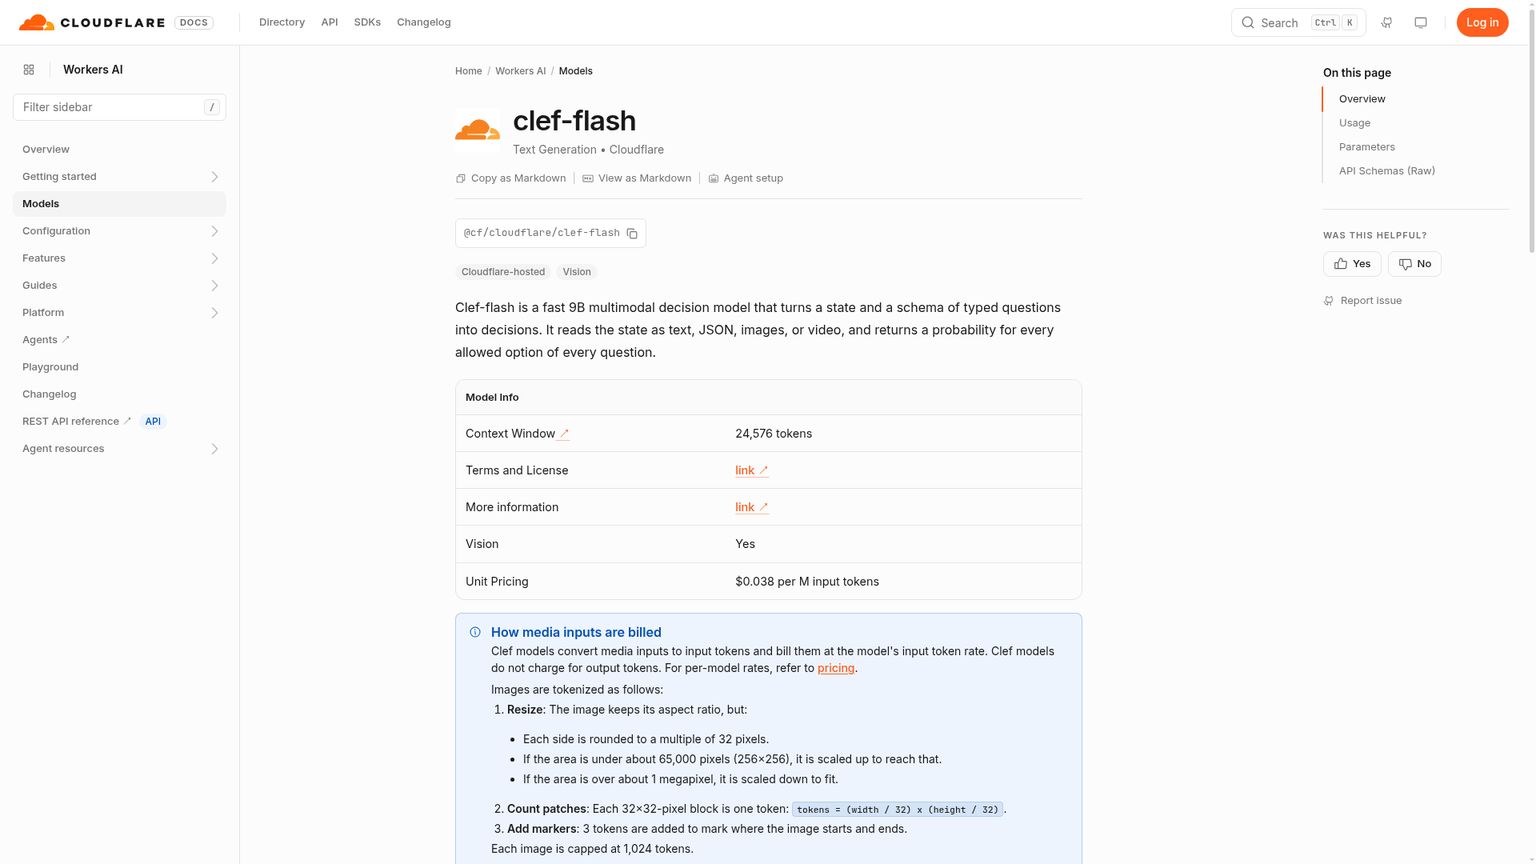
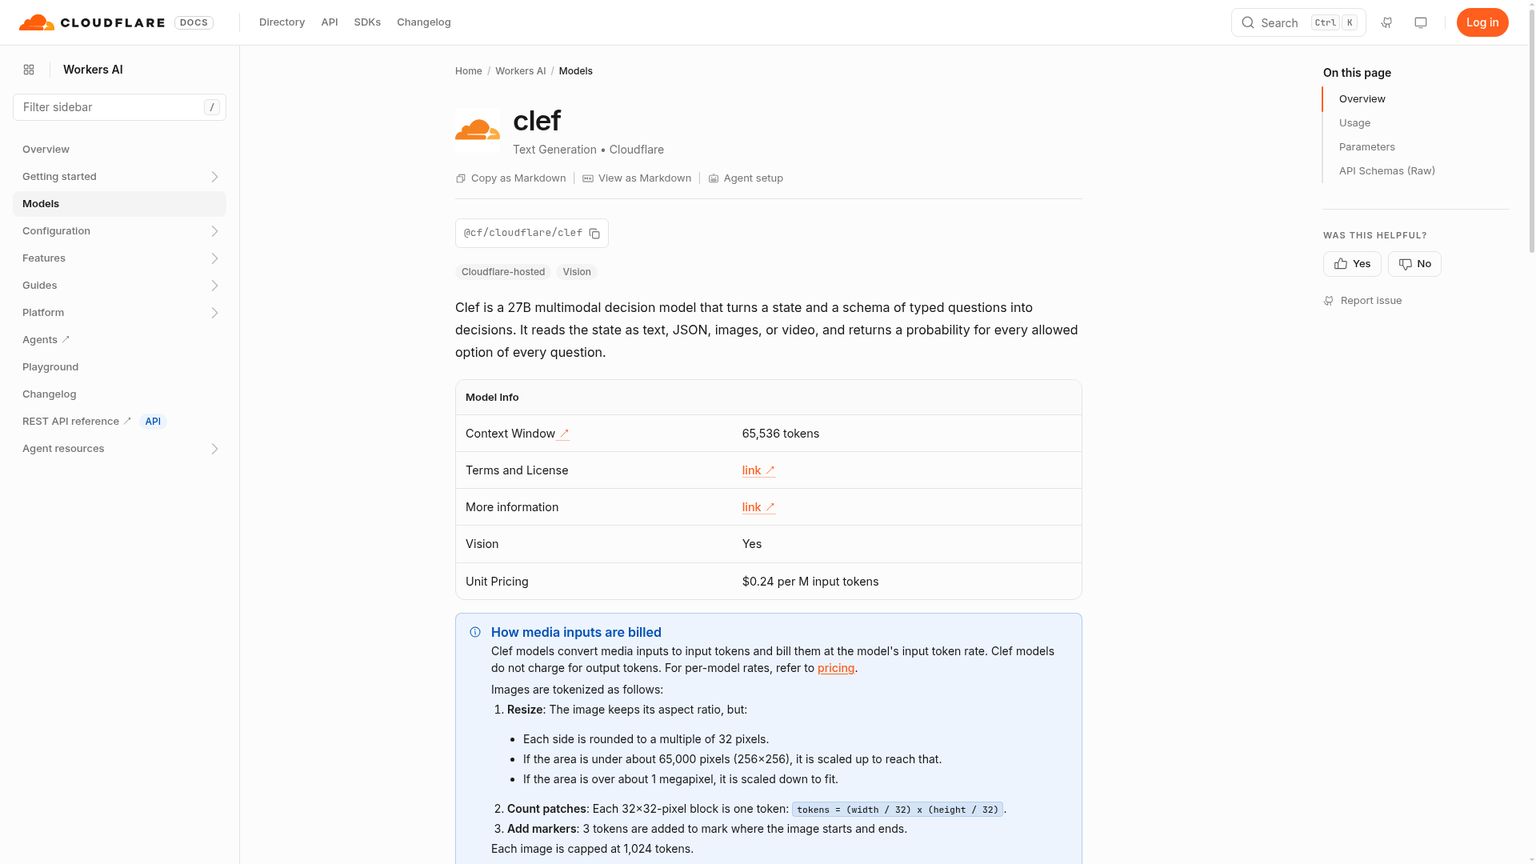
Cloudflare Clef-flash é a primeira escolha prática quando a decisão deve acontecer dentro de uma aplicação que já usa Workers. A família combina hospedagem no Workers AI com pesos Apache-2.0, permitindo avaliar uma implantação gerenciada sem abrir mão de operar em infraestrutura própria depois. Escolha a variante pelas evidências que ela precisa ler e pelos limites do endpoint hospedado. A opção mais barata da família não substitui suporte a áudio nem uma janela de contexto suficiente.
Melhor para: Roteamento e classificação próximos de uma aplicação Workers.
Diferencial: Bindings do Workers AI e acesso REST, além de pesos para download.
Preço: Clef-flash US$ 0.038; Clef US$ 0.240; Clef-omni US$ 0.150 por 1M de tokens de entrada.
Teste gratuito: Workers AI oferece uma franquia diária gratuita compartilhada, não um teste separado e ilimitado do Clef.
Entradas e ambiente de execução: Clef e Clef-flash processam texto, JSON, imagens e quadros de vídeo; Clef-omni acrescenta entrada direta de áudio e vídeo com som. Execução hospedada no Workers AI ou na sua própria infraestrutura.
Licença: Pesos Apache-2.0 nas três variantes. Preços do Workers AI, lançamento original, ficha do Clef-omni
Clef e Clef-flash chegaram em 1 de outubro de 2026; a atualização de 9 de outubro acrescentou Clef-omni e alterou as condições das opções hospedadas. A mudança de maior impacto é que Clef-flash agora tem uma janela de contexto hospedada de 24,576 tokens. O texto do estado pode ser truncado para caber. Assim, um histórico longo de incidentes pode perder evidências relevantes mesmo que a aplicação receba uma resposta. Documentação atual do Clef-flash, atualização de outubro
Por isso, um formulário curto de entrada é um ponto de partida melhor para flash do que um arquivo de conversas sem limite de tamanho. Reserve espaço de entrada para a política das filas e para as evidências decisivas do cliente. Se você encurtar o registro antes do envio, avalie essa versão reduzida, não uma transcrição completa idealizada.
Cloudflare Clef é a opção maior para texto e imagens, com contexto hospedado de 65,536 tokens. O preço mais alto merece consideração quando sua avaliação demonstra um ganho útil ou quando o contexto hospedado de flash é pequeno demais. Ser maior, por si só, não garante uma vantagem de qualidade. Documentação do Clef
Cloudflare Clef-omni é o candidato relevante quando as evidências incluem som. Uma aplicação de assistência em campo pode precisar classificar uma gravação de uma máquina junto com a descrição do técnico. O diferencial está na entrada direta de áudio/vídeo, não apenas em extrair quadros estáticos e esperar que contenham a resposta. A documentação especifica contexto de 64,000 tokens, com limites de mídia separados: trechos de áudio de até 300 segundos e vídeos de até 60 segundos, além de tetos de quantidade e tamanho em bytes. Documentação do Clef-omni
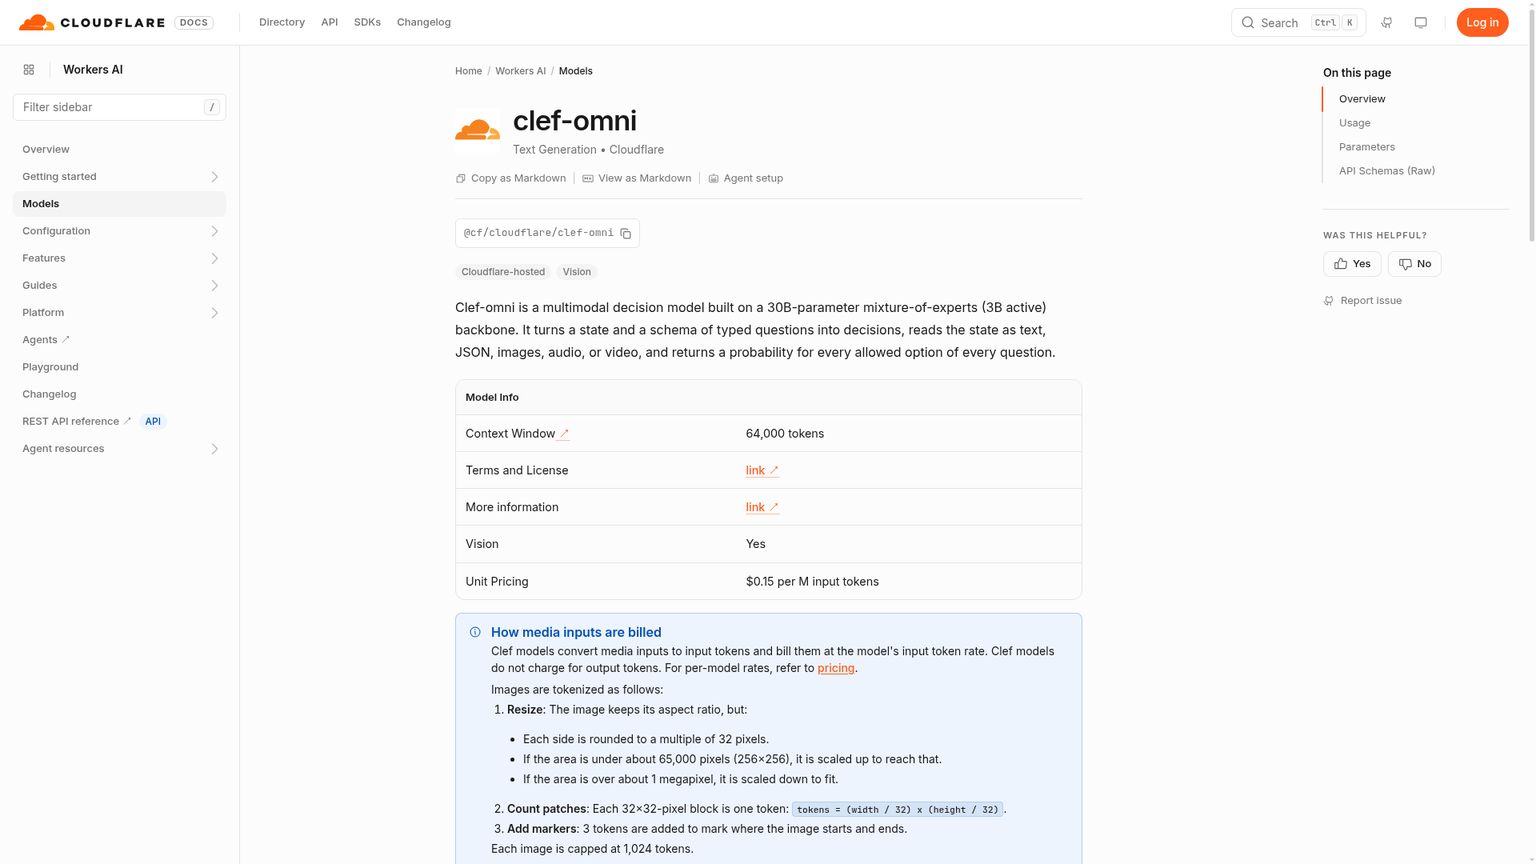
Ter pesos abertos não torna omni um modelo pronto para rodar em um celular. A configuração de referência da Cloudflare descreve cerca de 64 GB de memória de GPU para a arquitetura-base em bfloat16. Esse é um requisito de execução a incluir no orçamento, não uma cobrança por token do serviço hospedado. Ficha do modelo Clef-omni
A franquia gratuita de 10,000 Neurons por dia da Cloudflare é uma capacidade compartilhada do Workers AI; Neurons são sua unidade de cobrança de processamento. O uso além da franquia exige Workers Paid. Trate as tarifas por token como cobranças do modelo e inclua o restante da assinatura Workers e do consumo da aplicação no orçamento da implantação. Regras de franquia e cobrança
- A integração nativa com Workers evita acrescentar outra plataforma à aplicação.
- Os pesos Apache-2.0 mantêm a opção de hospedagem própria.
- A família cobre desde roteamento comum de texto até decisões com áudio/vídeo.
- O contexto hospedado de Clef-flash é menor do que indicam descrições antigas do lançamento.
- Truncar um estado longo pode remover as evidências necessárias à decisão.
- Hospedar Clef-omni por conta própria exige bastante memória na configuração documentada.
3. Microsoft-Decision-1: rotulagem e controle de agentes no Foundry
Microsoft-Decision-1 é um modelo hospedado de pontuação de decisões para quem já desenvolve no Microsoft Foundry. Sua tarifa de US$ 0.042 por milhão de tokens de entrada é igual à publicada atualmente para Jev; portanto, avalie o encaixe na plataforma e a qualidade na tarefa, em vez da economia direta com tokens. Rotular feedback ou decidir se um agente deve continuar, tentar novamente ou encaminhar o caso são bons pontos de partida. A requisição documentada aceita texto ou JSON; não deduza suporte a imagens a partir da família do modelo-base. Anúncio da Microsoft, guia do Foundry
Melhor para: Rotulagem, priorização e pontos de controle de agentes em uma implantação Foundry.
Diferencial: Processo de implantação documentado no Foundry, com Entra ID ou chave de API.
Preço: US$ 0.042 por 1M de tokens de entrada; saída gratuita.
Teste gratuito: não divulgado nas páginas citadas sobre o modelo de decisão.
Entradas e ambiente de execução: Texto ou JSON; Microsoft Foundry e OpenRouter.
Licença: Serviço hospedado; essas páginas do fornecedor não publicam uma licença para pesos disponíveis para download. Preços e acesso da Microsoft, requisitos de implantação
A publicação da Microsoft de 9 de outubro de 2026 identifica Qwen3.5-9B como modelo-base. A discussão sobre adotar outros modelos-base é um plano futuro, não a arquitetura contratada hoje. Da mesma forma, um modelo-base aberto não concede permissão para baixar o modelo da Microsoft após o pós-treinamento. Esta é uma opção hospedada, a menos que a Microsoft disponibilize os pesos separadamente. Fonte sobre a arquitetura
A vantagem operacional é poder avaliar o modelo dentro da plataforma que sua aplicação já usa. Imagine que o feedback dos clientes seja rotulado por um modelo generalista antes de entrar no relatório semanal lido por um gerente de produto. Defina os temas e uma saída para itens não classificados, compare os dois sistemas no mesmo feedback e veja se comentários vagos recebem rótulos específicos sem justificativa. Mesmo um rótulo perfeitamente estruturado pode distorcer o relatório.
A Microsoft informa a maior precisão média em seu comparativo com 36 benchmarks. Esse resultado foi divulgado pelo fornecedor, e a comparação de latência mede Microsoft-Decision-1 pelo Foundry na mesma região. Essas condições importam: elas não determinam o tempo de resposta a partir da sua aplicação nem a precisão na sua taxonomia particular. Descrição da avaliação da Microsoft
O requisito de implantação é concreto. Você precisa de um projeto Foundry, permissões para implantar modelos e um método de autenticação; não basta trocar o nome do modelo em um SDK sem relação com a plataforma. O guia documenta decisões numéricas, não explicações por escrito. Se o fluxo precisa justificar um rótulo a quem faz a revisão, preserve as evidências de apoio e produza a explicação em outra etapa. Configuração do Foundry e contrato de saída
- Encaixa-se nos fluxos existentes de identidade e implantação do Foundry.
- Aceita decisões binárias, escolhas e pontuação em escala ordenada.
- O próprio anúncio da Microsoft informa uma tarifa de entrada clara.
- Não reduz a tarifa básica de entrada em relação ao Jev.
- As páginas do fornecedor não estabelecem uma opção de implantação com pesos abertos.
- A entrada documentada é texto/JSON, sem promessa de substituição multimodal.
4. OpenAI Decisions API: para quem já tem uma integração OpenAI
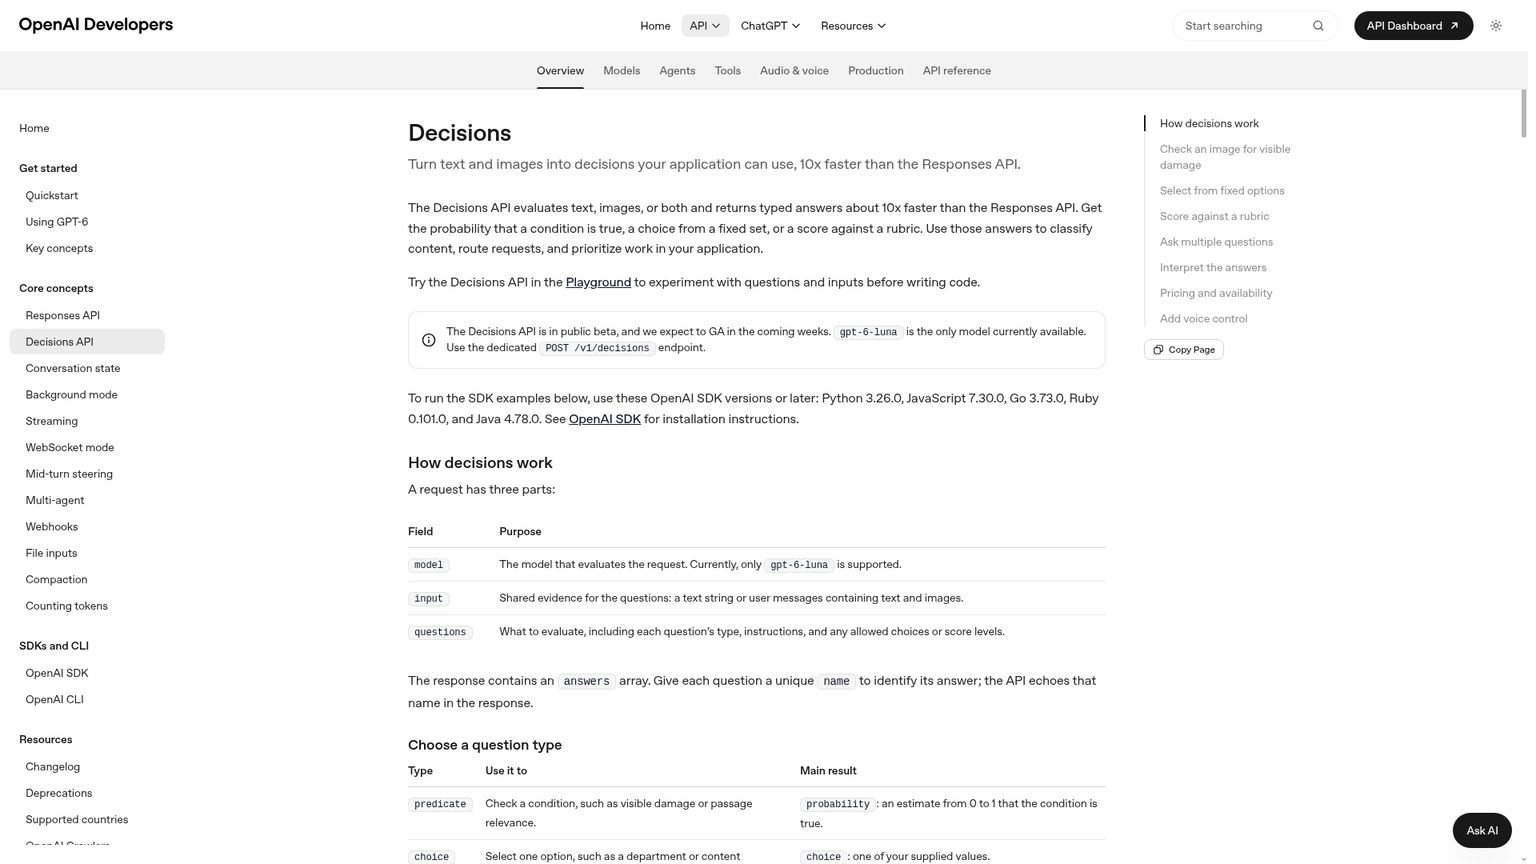
OpenAI Decisions API transforma texto e imagens em respostas tipadas usando gpt-6-luna. É uma candidata razoável quando sua aplicação já usa OpenAI e você quer acrescentar classificação, escolha entre opções delimitadas ou pontuação por critérios à integração. A US$ 0.10 por milhão de tokens de entrada, sua camada de decisão custa mais que Jev na tarifa básica. Escolha-a se a integração ou a qualidade medida na tarefa justificar a diferença. Guia da OpenAI Decisions
Melhor para: Rótulos de texto/imagem e pontos de controle em uma aplicação que já usa OpenAI.
Diferencial: Respostas predicate, choice e score em um endpoint dedicado.
Preço: US$ 0.10 por 1M de tokens de entrada na tarifa básica; sem cobrança de saída, leitura ou gravação em cache. Aplicam-se adicionais regionais e multiplicadores de entrada para contexto longo.
Teste gratuito: não divulgado no guia da Decisions.
Entradas e ambiente de execução: Texto e imagens embutidas na requisição pelo endpoint hospedado POST /v1/decisions.
Licença: Acesso à API hospedada; o guia não fornece licença de distribuição de pesos abertos. Guia atual e preços
A API entrou em beta público em 6 de outubro de 2026. Considere esse estágio ao planejar a implantação. Uma API nova ainda pode valer a avaliação, mas, antes de adotá-la como contingência, comprove que ela funciona com seu leitor de respostas, tratamento de exceções e acesso de conta. Histórico de alterações da OpenAI
O principal obstáculo da migração é o contrato de requisição e resposta. A OpenAI usa input e um array de perguntas nomeadas; seu tipo de sim/não é predicate. Um objeto de perguntas no formato do Jev não pode ser simplesmente encaminhado sem alterações. A resposta também pode conter uma recusa, que precisa de tratamento separado de uma probabilidade. Padrões de requisição e resposta
Por exemplo, um fluxo de devoluções pode perguntar se a foto de um produto mostra danos visíveis e selecionar a fila de revisão adequada. Isso não determina quem causou o dano, se há cobertura de garantia ou se um reembolso está autorizado. São decisões separadas, que exigem outras evidências ou regras fixas de negócio.
- Texto e imagens podem ser avaliados em conjunto.
- As respostas tipadas dispensam a interpretação de um rótulo escrito.
- O guia dedicado distingue a cobrança de decisões da cobrança de outros endpoints de modelos.
- Tarifa básica de entrada maior que a do Jev e das alternativas hospedadas mais baratas.
- O estágio de beta público precisa ser considerado no planejamento da implantação.
- Os formatos nativos de requisição e o tratamento de recusas exigem um adaptador.
5. Liquid AI d1-3B: por onde começar com texto e imagens locais
Liquid AI d1-3B é um modelo de decisão com pesos abertos para entradas de texto e imagens, lançado em 7 de outubro de 2026. É o primeiro candidato local desta lista que eu avaliaria para uma aplicação de desktop ou de borda que precise classificar tanto uma descrição quanto uma imagem. O atrativo é controlar onde a inferência acontece. Isso não é uma promessa de que operar uma GPU custará menos do que uma API hospedada muito barata. Lançamento da Liquid AI
Melhor para: Classificação local de imagens, verificações visuais e roteamento de texto.
Diferencial: Modelo para download com medições documentadas em hardware local.
Preço: Por 1M de tokens de entrada: não divulgado para este checkpoint aberto. Faça o orçamento do seu próprio processamento.
Teste gratuito: Pesos disponíveis para download sujeitos à licença; o processamento é à parte.
Entradas e ambiente de execução: Texto, JSON e imagens; os exemplos do fornecedor oferecem suporte a CUDA, Apple MPS e CPU por meio de código personalizado para Transformers.
Licença: LFM Open License v1.0. Ficha do modelo, licença dos pesos
O modelo é baseado em LFM2.5-VL-3B e documenta um contexto de 32,768 tokens. Pense em uma ferramenta de controle de qualidade para desktop em que um operador fornece a imagem de um produto e seleciona uma pergunta de inspeção conhecida. A execução local permite que a aplicação continue funcionando sem uma chamada de decisão hospedada, desde que o restante do fluxo também seja local. Isso não elimina a necessidade de validar as condições da câmera, o redimensionamento das imagens ou a definição de defeito. Arquitetura e contexto
A Liquid informa tempos para uma única pergunta de 16 ms no Jetson AGX Thor, 26 ms no AGX Orin e 50 ms no Orin Nano. São medições em hardware divulgadas pelo fornecedor, não uma promessa para o tamanho da sua entrada nem uma comparação com uma requisição completa de API pela internet. Use-as para identificar hardware que vale avaliar e, depois, meça a aplicação inteira. Tabela de tempos da Liquid
A licença é uma restrição de contratação. Os dois checkpoints da Liquid usam a LFM Open License v1.0, cuja condição de uso comercial faz referência a um limite de receita anual de US$ 10 milhões. Leia a definição de pessoa jurídica e a Seção 5 antes de presumir que sua implantação se enquadra; confirme os termos com a Liquid se a condição se aplicar ao seu caso. Não marque este modelo como Apache-2.0 em uma planilha de compras. Texto da licença
O nome também merece atenção. A Liquid lista o d1 hospedado separadamente de d1-3B e d1-omni-600M. A documentação e o anúncio do serviço hospedado explicam a cobrança apenas pela entrada, mas não publicam uma tarifa em dólares por milhão nas páginas consultadas para este comparativo. A tarifa e os limites do modelo hospedado não devem ser atribuídos a esses modelos para download. Catálogo de modelos da Liquid, guia do d1 hospedado
Para um produto offline, a condição de troca é o modelo atingir seus requisitos de qualidade e latência no dispositivo que será usado de fato. Teste com os outros programas em execução, imagens realistas e uso contínuo. Uma inferência isolada bem-sucedida é só o começo da avaliação de capacidade.
- Mantém a inferência de decisão no hardware que você opera.
- Aceita texto e imagens.
- As medições do fornecedor indicam hardware de borda específico para avaliar.
- As condições de uso comercial da LFM exigem atenção.
- A operação do serviço, a capacidade e a manutenção do ambiente ficam por sua conta.
- Poder baixar o modelo não garante uma conta de inferência fixa nem zerada.
6. Liquid AI d1-omni-600M: decisões simples por voz, com limites de uma versão de pesquisa
Liquid AI d1-omni-600M é a variante compacta e experimental para texto com imagens ou texto com áudio. Vale incluí-la na seleção para um dispositivo que precise distinguir um conjunto pequeno de intenções faladas, sem presumir que substitua qualquer serviço multimodal hospedado. O tamanho torna a execução local interessante, mas os limites de entrada e treinamento são decisivos. Um piloto de comandos de voz é uma tarefa mais restrita do que analisar gravações sem delimitação. Estágio do lançamento, ficha do modelo
Melhor para: Experimentos com intenções faladas ou decisões a partir de imagens em dispositivos pequenos.
Diferencial: Checkpoint aberto e compacto com entrada de áudio.
Preço: Por 1M de tokens de entrada: não divulgado para este checkpoint aberto.
Teste gratuito: Pesos disponíveis para download sujeitos à licença; seus custos de processamento continuam existindo.
Entradas e ambiente de execução: Texto/JSON com imagens ou áudio; exemplos locais para CUDA, MPS ou CPU.
Licença: LFM Open License v1.0, com a mesma condição de uso comercial. Ficha do modelo, licença
A ficha documenta 587 milhões de parâmetros, com treinamento de áudio baseado em solicitações entre uma pessoa que fala inglês e um assistente. Os trechos de áudio são cortados em 30 segundos. Portanto, um comando como “pausar a inspeção” é um alvo de avaliação mais adequado do que uma ligação longa e multilíngue de um cliente. Aceitar áudio como entrada não comprova desempenho em todo tipo de som. Escopo de áudio
Há um limite particularmente fácil de ignorar: o modelo tem 16,384 posições de contexto no total, mas, com imagens, o texto do estado e das perguntas é cortado em 896 tokens. Um manual de operação longo anexado a uma imagem pode exceder o limite de texto relevante muito antes do que a capacidade total de contexto sugere. Detalhes do contexto
Em um quiosque, mantenha a lista de comandos e a política local concisas e inclua uma saída para solicitações não reconhecidas. Avalie falas ao fundo e falta de contexto com o mesmo cuidado dedicado a comandos claros. O resultado útil é um sistema que se abstém quando a instrução é ambígua, em vez de sempre fornecer uma opção que parece válida.
O lançamento da Liquid não apresenta medições de velocidade para este modelo experimental. Não use os tempos do modelo maior d1-3B nem deduza uma garantia de latência a partir do menor número de parâmetros. A aplicação ainda precisa processar mídia, carregar o modelo e encaixar seu ambiente de execução nos recursos disponíveis do dispositivo. Escopo das medições do lançamento
- O tamanho reduzido é relevante para dispositivos locais com recursos limitados.
- Oferece decisões com áudio além das decisões com imagens.
- Os pesos abertos permitem inspecionar e operar a implantação.
- Versão experimental com escopo documentado de treinamento de áudio restrito.
- Requisições com imagens têm um limite de texto muito menor que o contexto total.
- O lançamento não apresenta um resultado de velocidade específico para este modelo.
7. Amazon Strands Decider 2B: controle local de agentes com implementação aberta à análise
Amazon Strands Decider 2B é um modelo de decisão aberto do Strands Labs, com código de inferência, material de treinamento e avaliações publicados. É a opção mais adequada quando o motivo para abandonar uma chamada hospedada ao Jev é controlar um pequeno componente de decisão dentro do ambiente do seu próprio agente. Comece com uma tarefa delimitada, como verificar uma ação proposta à luz de uma política curta. Não trate o servidor local fornecido como um produto hospedado completo. Repositório do desenvolvedor
Melhor para: Pontos de controle locais de agentes, roteamento e experimentos com o método de treinamento.
Diferencial: Pesos do modelo, código e detalhes de avaliação disponíveis em conjunto.
Preço: Tarifa hospedada por 1M de tokens de entrada: não divulgada; você fornece o ambiente de execução.
Teste gratuito: Modelo e código Apache-2.0 disponíveis para download; processamento à parte.
Entradas e ambiente de execução: Texto e imagens opcionais pela modalidade de visão; opções para CUDA, Apple Silicon e CPU.
Licença: Apache-2.0 para o checkpoint citado, baseado em Qwen, e para o projeto. Ficha do modelo atual
Fixe o checkpoint exato: strands-decider-2B-qwen3.5-v1-2610 é a referência atual descrita pelo repositório. Ele usa Qwen3.5-2B-Base como arquitetura-base, com um adaptador treinado e uma cabeça de decisão, a parte que pontua as respostas permitidas. Os nomes antigos hobson-v19 e hobson-v21 continuam visíveis; por isso, toda afirmação de desempenho precisa indicar a versão correspondente. Versão e arquitetura
Essa distinção afeta o tempo de 115 ms, frequentemente citado. A tabela detalhada do repositório atribui essa mediana em RTX 3090 à v19, enquanto as colunas mais novas informam que compartilham a arquitetura e o tamanho. Trata-se de um tempo histórico divulgado pelo fornecedor, não de uma nova medição do checkpoint atual. Use a medição associada ao checkpoint que pretende implantar. Tabela de desempenho por versão
O servidor fornecido escuta em localhost e não tem autenticação. Isso é útil para um experimento local, mas um serviço em rede também exige controle de acesso, planejamento de concorrência, responsáveis pela implantação e monitoramento. Em um agente interno, o responsável precisa definir o que acontece quando o processo do modelo ainda não está aquecido, está ocupado ou fica indisponível. “Rodar localmente” é uma opção de implantação, não uma estratégia de disponibilidade. Instruções de execução do serviço
Um primeiro ponto de controle concreto poderia distinguir “a ação proposta apenas lê um registro” de “a ação proposta altera um registro”. Regras fixas da aplicação ainda devem verificar as permissões do usuário e as operações permitidas. Se o modelo considerar uma operação segura, mas o usuário autenticado não tiver permissão para executá-la, ela continua bloqueada.
- Modelo e código Apache-2.0 permitem operar o componente localmente.
- O material de treinamento e avaliação publicado permite examinar as premissas.
- As opções de execução do modelo pequeno em CPU e Apple Silicon ampliam as possibilidades de avaliação.
- Este comparativo não estabelece uma tarifa de entrada nem um endpoint gerenciado pelo fornecedor.
- Um servidor local de exemplo não é um serviço pronto para produção.
- Os números históricos de latência precisam permanecer associados ao checkpoint medido.
Quanto uma API de IA barata muda na conta mensal?
Uma grande economia percentual pode representar poucos dólares. Considere um milhão de decisões por mês, cada uma com 1,000 tokens de entrada faturados. Isso totaliza um bilhão de tokens de entrada. Nas tarifas básicas verificadas, a conta do modelo apenas pela entrada é de US$ 20 para Perplexity, US$ 38 para Clef-flash, US$ 42 para Jev ou Microsoft-Decision-1, US$ 100 para OpenAI Decisions, US$ 150 para Clef-omni e US$ 240 para Clef. Perplexity, Cloudflare, TypeSafe, Microsoft, OpenAI
O cenário usa deliberadamente uma quantidade padronizada de tokens faturáveis. Tokenizadores, formatos de perguntas e processamento de mídia diferentes podem gerar totais faturados distintos para a mesma entrada de negócio. Os valores não incluem franquias gratuitas, assinaturas de plataforma, adicionais regionais ou por contexto longo, novas tentativas, geração posterior nem revisão pela equipe.
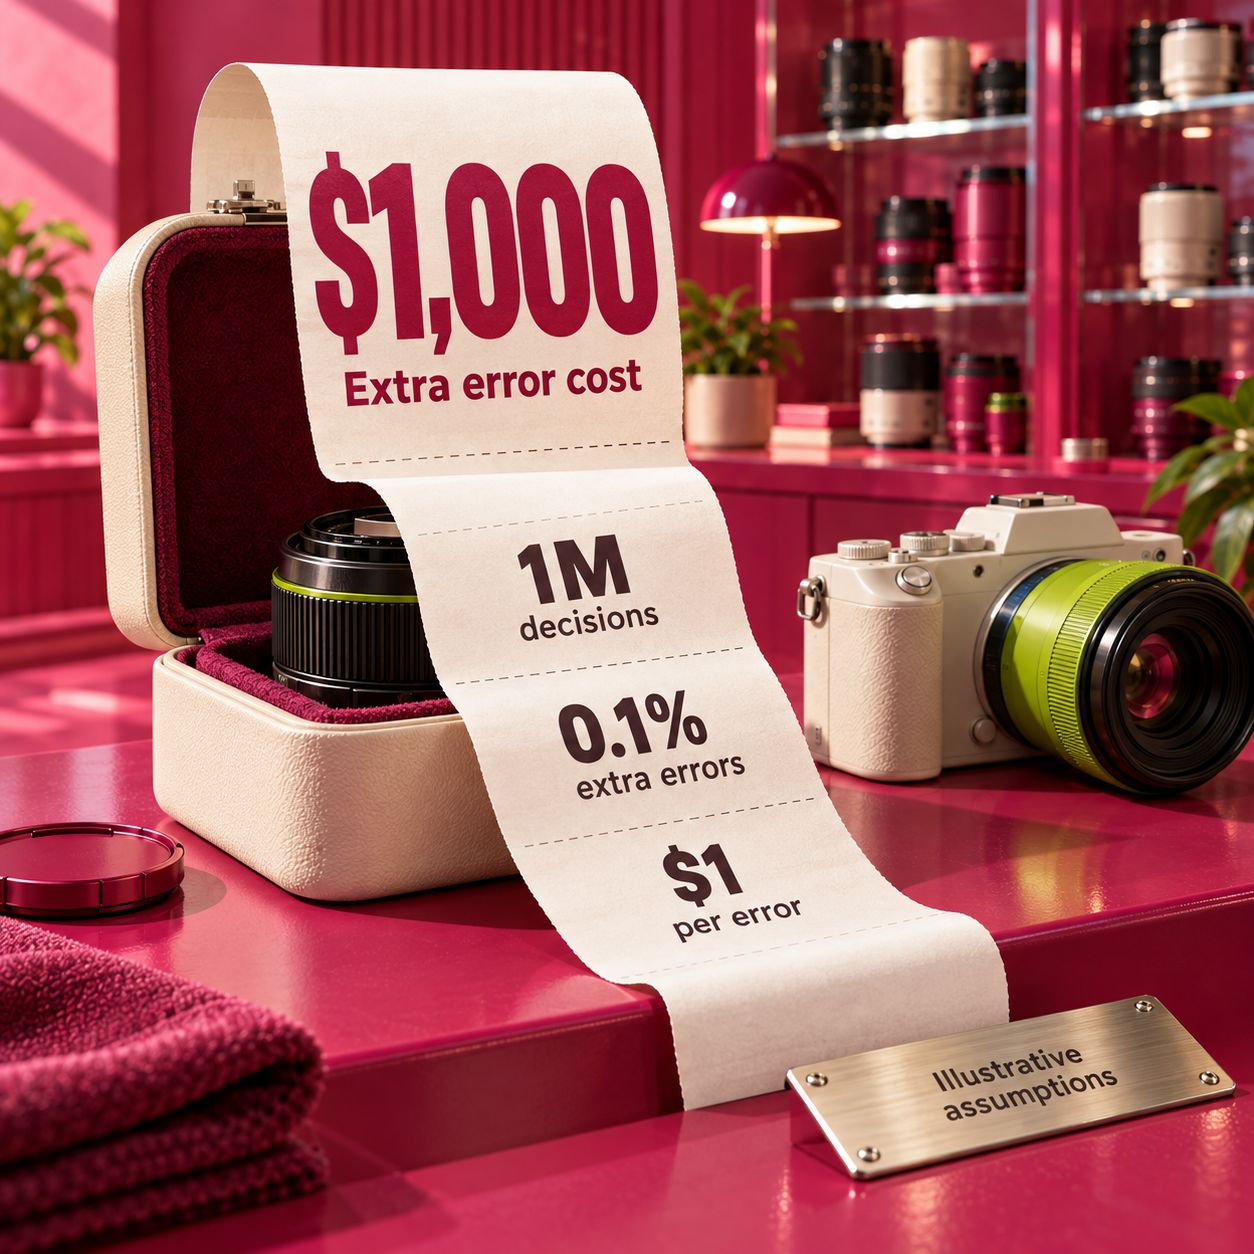
Agora suponha que um candidato gere 0.1 ponto percentual a mais de erros e que cada erro adicional custe US$ 1 para resolver. Em um milhão de decisões, isso significa 1,000 erros adicionais e US$ 1,000 de custo extra. São premissas ilustrativas, não taxas de falha medidas nem um preço de mercado para o tempo da equipe. Elas mostram por que a otimização deve se concentrar nas decisões aceitas, não apenas no preço do token.
A hospedagem própria exige uma conta parecida. Se o orçamento adicional de infraestrutura fosse de US$ 100 por mês, igualar a tarifa básica da Perplexity de US$ 0.02 por milhão exigiria cinco bilhões de tokens de entrada por mês, antes de considerar a operação ou diferenças de qualidade. Os US$ 100 são uma premissa, não uma cotação de GPU. Hardware ocioso já disponível pode mudar a conta; manter os dados localmente ou viabilizar um produto offline também pode justificar a escolha mesmo sem economia com tokens.
Meça a cobrança na carga de trabalho real antes de extrapolar. Por exemplo, o serviço hospedado d1 da Liquid, oferecido separadamente, contabiliza novamente o texto e as imagens fornecidas em cada pergunta. Enviar várias perguntas em uma chamada HTTP, portanto, não significa pagar pelas evidências apenas uma vez. Essa regra de cobrança não define uma tarifa em dólares para os checkpoints abertos. Explicação da cobrança da Liquid
Qual opção levar para produção?
Para roteamento comum, avalie Perplexity primeiro se o objetivo for reduzir o custo do serviço hospedado. Comece por Clef-flash quando permanecer no Workers simplificar a aplicação. O que pode mudar a escolha é o candidato atender à taxa de requisições, ao tamanho das entradas e aos limites medidos de encaminhamentos errados e revisão. Nem uma tarifa menor nem uma plataforma conhecida compensam a perda da evidência que determina a fila correta.
Para rotulagem, prefira o candidato que preserve sua taxonomia em exemplos ambíguos. Microsoft-Decision-1 é uma opção natural no Foundry; Perplexity é a opção hospedada orientada a preço. Teste se um comentário pode pertencer a mais de um tema. Uma pergunta de escolha única força um único resultado; por isso, um problema com múltiplos rótulos precisa ser dividido em verificações separadas ou representado de outra forma adequada.
Para pontos de controle de agentes, escolha um ambiente que consiga operar com confiabilidade e mantenha a autoridade no código. Vale avaliar Strands para um componente local; Microsoft ou OpenAI podem se encaixar em uma integração hospedada já estabelecida. O modelo pode fornecer uma estimativa sobre a ação proposta. Sua aplicação deve aplicar, separadamente, as permissões, as regras de gastos e as restrições às operações.
Para execução no dispositivo, comece com d1-3B para texto e imagens e d1-omni-600M para um experimento restrito de voz. Strands é outra opção local quando a licença e o método de treinamento disponível para análise se encaixam melhor no projeto. O dispositivo, o pré-processamento das entradas e o uso comercial permitido decidem esse caminho antes da comparação de preços de serviços hospedados.
Para decisões com áudio/vídeo em uma aplicação hospedada, avalie Clef-omni. Seu suporte a mídia é uma diferença substancial. Um modelo de texto mais barato só é uma alternativa se você acrescentar deliberadamente uma etapa de pré-processamento e validar a informação perdida nessa etapa.
Ao escolher um segundo fornecedor, defina qual falha ele deve cobrir. Dois IDs de modelo atrás do mesmo gateway continuam dependendo desse gateway. Uma contingência local também falha se precisar do mesmo serviço indisponível a montante para buscar a entrada. Desenhe o caminho completo da requisição e isole a dependência cuja indisponibilidade você precisa suportar.
Migre uma decisão antes de migrar o fluxo inteiro
Uma substituição dá certo quando preserva o contrato de decisão da aplicação, não apenas quando retorna JSON válido. Mantenha estáveis os nomes das filas, o significado dos critérios de avaliação e o comportamento de contingência enquanto adapta os campos específicos de cada fornecedor. Assim, fica possível revisar as divergências sem misturar uma mudança de modelo com uma mudança de política.
Fixe a decisão e as evidências
Escolha uma chamada existente, como a atribuição de fila de um novo chamado de suporte. Registre os rótulos permitidos, a versão da política, os campos de entrada e o que caracteriza informação insuficiente. Inclua casos ambíguos e fora do escopo no conjunto rotulado, não apenas exemplos óbvios.
Adapte a integração com o fornecedor
Mapeie explicitamente as evidências, as definições das perguntas e a leitura das respostas. A OpenAI usa o campo input e um array de perguntas nomeadas; os exemplos documentados da Perplexity e da Microsoft usam state e perguntas identificadas por chaves. O formato de envio das imagens também difere. Confira o guia nativo do fornecedor, em vez de presumir que nomes parecidos de tipos básicos significam formatos de transmissão idênticos.
Execute o candidato em paralelo à decisão atual
Deixe o fluxo atual no controle enquanto o candidato apenas registra uma resposta. Compare decisões erradas aceitas, encaminhamentos, requisições com falha, consumo faturado e os tempos de resposta mais lentos. Use as mesmas evidências nos dois modelos para que uma mudança de pré-processamento não pareça uma melhoria do modelo.
Defina os limiares deste modelo e desta tarefa
Um limiar do Jev não se transfere automaticamente só porque outra API retorna uma probabilidade ou um campo chamado confidence. Verifique novamente a relação entre as pontuações e os acertos observados nos exemplos rotulados. Defina um fluxo de revisão separado para falta de evidências, falhas do fornecedor e recusas.
Adote aos poucos e facilite a reversão
Altere apenas o fluxo escolhido. Preserve a configuração anterior do modelo e uma forma de voltar a ela. Reavalie quando houver mudanças no checkpoint, no alias do modelo, na redação das perguntas ou no pré-processamento, pois qualquer uma delas pode alterar as decisões aceitas pelos seus limiares.
Se seu ponto de partida for Jev Router, e não uma chamada direta de decisão ao Jev, primeiro identifique onde cada cobrança ocorre. O serviço de roteamento e o modelo selecionado por ele são partes diferentes da conta. O guia de preços do Jev Router explica essa distinção; um modelo de decisão barato não torna gratuita a resposta gerada.
Escolhas que vale evitar
Evite migrar para Microsoft-Decision-1 para economizar tokens quando sua única reclamação for a tarifa básica atual do Jev. As tarifas publicadas são iguais. A plataforma ou a qualidade ainda podem justificar a escolha, mas o motivo será outro.
Evite Clef-flash hospedado para um acervo de evidências sem limite de tamanho, a menos que você controle o limite da entrada. Uma resposta válida após o truncamento pode esconder que um fato crucial nunca chegou à decisão. Use uma carga de trabalho que caiba ou avalie uma opção com contexto adequado.
Evite d1-omni-600M para análise irrestrita de gravações longas só por causa da palavra omni. O escopo documentado de fala, o corte dos trechos e o estágio experimental são relevantes. Clef-omni é a opção hospedada desta seleção quando a exigência é trabalhar com mídia mais rica, respeitando seus próprios limites.
Evite tratar pesos abertos como sinônimo de serviço gratuito em produção. A Liquid tem uma licença com condições, a configuração de referência da Perplexity exige bastante memória e o Strands deixa a hospedagem por sua conta. Baixar um modelo é o início de um compromisso de operação.
Evite um clone não verificado como contingência de emergência. Um nome parecido ou um endpoint aparentemente compatível não comprovam a existência de um responsável, de uma licença utilizável, de um ambiente mantido ou de uma alternativa que falhe de forma independente. A exclusão decorre da falta de evidências, não de uma afirmação de que todo projeto da comunidade tem desempenho ruim.
Perguntas frequentes
Existe alguma alternativa gratuita ao Jev?
A Cloudflare oferece uma franquia diária gratuita compartilhada do Workers AI. Várias alternativas também disponibilizam pesos para download, mas você fornece o processamento e precisa seguir a licença. A documentação do serviço hospedado da Liquid lista separadamente um modelo d1:free somente para texto, sem divulgar uma franquia na página consultada aqui. Uma forma de acesso gratuito não garante uma implantação em produção sem custo. Guia do modelo hospedado da Liquid
Quais alternativas ao Jev têm pesos abertos?
A família Clef, o checkpoint citado da Perplexity, os dois checkpoints d1 da Liquid e Strands Decider têm formas de acesso aos pesos publicadas pelos próprios fornecedores. Clef, Perplexity e o checkpoint citado do Strands usam Apache-2.0; a Liquid usa LFM Open License v1.0, com uma condição de uso comercial. OpenAI Decisions e Microsoft-Decision-1 são opções hospedadas neste comparativo, sem licença de pesos abertos fornecida pelas páginas citadas dos fornecedores.
Qual alternativa ao Jev devo avaliar primeiro?
Avalie Perplexity primeiro para reduzir a tarifa de entrada hospedada, Clef-flash para uma aplicação que já usa Workers, Microsoft-Decision-1 para Foundry e OpenAI Decisions para uma integração OpenAI. Na operação local, comece por d1-3B para texto e imagens, d1-omni-600M para um experimento restrito de voz ou Strands para um componente de agente cuja implementação possa ser examinada. A avaliação na sua carga de trabalho determina a escolha final.
Por onde começar na segunda-feira
Escolha uma chamada de decisão cujo responsável saiba explicar o que seria um erro caro. Selecione um candidato pelo motivo que importa no seu caso: preço, plataforma, entrada de mídia ou operação local. Compare-o em paralelo ao Jev, usando as mesmas evidências, e só faça a troca se os erros aceitos, a carga de revisão e os prazos de resposta forem satisfatórios. Mantenha a configuração original pronta até que a nova opção demonstre confiabilidade no trabalho do dia a dia.
Use o Checklist de auditoria de fluxos de trabalho com IA para empresas para identificar qual decisão vale mudar primeiro.
- Publicado
- Categoria
- Build
- Idioma

Rotulagem de dados e triagem com a OpenAI Decisions API
Use a OpenAI Decisions API para rotulagem de dados e triagem de chamados. Veja exemplos, preços, recusas, limites e quando manter sua integração atual.11 de out. de 2026Build
Claude Code Remote Control: continue programando pelo celular
Acesse o Claude Code pelo celular ou navegador com Remote Control. Veja como conectar sessões do terminal, VS Code e Desktop e resolver falhas de acesso.9 de out. de 2026Build
Programar pelo celular: use o Cursor no iPhone
Veja como usar o Cursor no iPhone para acompanhar agentes locais, enviar instruções e manter o notebook acessível, com os requisitos e preços do serviço.9 de out. de 2026Build
Preço do Firecrawl: planos e custo por página em 2026
Veja o preço do Firecrawl, os planos e a cobrança por créditos. Compare coletas simples, extração em JSON e crawls semanais para calcular sua conta em USD.9 de out. de 2026Build
Claude Code: preço e comparação com GitHub Copilot em 2026
Compare Claude Code e GitHub Copilot: preços em USD, limites de uso, modelos e custos para uma ou dez pessoas. Veja quando escolher cada um ou usar ambos.8 de out. de 2026Build
Agentes de IA em produção: quando usar LangGraph ou CrewAI
Compare LangGraph e CrewAI para agentes de IA em produção: estado, memória, revisão humana, MCP e custos de hospedagem no mesmo fluxo de aprovação.7 de out. de 2026Build
Servidor MCP em Python: da consulta local ao HTTP autenticado
Crie um servidor MCP em Python para consultar pedidos, teste no Inspector, conecte Claude Code e Cursor e configure autenticação e hospedagem HTTP.7 de out. de 2026Build