Alternatives à Jev : quel modèle de décision IA choisir ?
Comparez les alternatives à Jev selon leurs tarifs en USD, leurs licences, leurs limites et leur déploiement : API hébergée ou modèles exécutés en local.
Publié le
 Par Omid Saffari






Parmi les alternatives à Jev, l’API de Perplexity, à $0.02 par million de tokens d’entrée, est la première à évaluer pour réduire la facture d’un service hébergé. Clef-flash convient mieux à une application déjà sur Cloudflare, tandis que Liquid AI d1-3B constitue le point de départ pour des décisions sur images en local. Pour un million de décisions mensuelles consommant chacune 1,000 tokens d’entrée facturés, passer de Jev à Perplexity ne fait économiser que $22 sur les frais d’entrée au tarif de base. Retenez la solution qui maintient votre taux d’erreurs parmi les décisions acceptées et s’exécute là où votre application en a besoin.
Tarifs, licences et documentation de déploiement vérifiés le 11 octobre 2026. Les prix ci-dessous proviennent des éditeurs. Les montants mensuels sont des calculs fondés sur des hypothèses explicites, pas des factures issues d’un test en production. Aucun modèle n’a été exécuté pour ce comparatif.
Alternatives à Jev : quelle solution pour quel usage ?
Partez des contraintes de déploiement, puis comparez la qualité sur vos propres décisions. Avec une API hébergée, le fournisseur exploite le modèle. Des poids ouverts permettent d’obtenir les fichiers du modèle et d’exécuter soi-même l’inférence, dans le respect de leur licence ; ils ne fournissent pas de puissance de calcul gratuite.
Les tarifs hébergés ne chiffrent pas l’inférence en auto-hébergement. Pour les modèles téléchargeables de Liquid et Strands, non publié signifie que les pages des éditeurs ne donnent aucun tarif fixe par token d’entrée. Le matériel, l’électricité, l’hébergement et l’exploitation restent à votre charge. Les licences et les checkpoints sont détaillés dans chaque section.
La référence actuelle de TypeSafe est Jev 1.13, identifiant jev-1.13.0, à $0.042 par million de tokens d’entrée, avec une sortie gratuite. Le modèle accepte du texte et du texte structuré comme le JSON, mais pas d’images, d’audio ou de vidéo. Microsoft affiche donc le même tarif d’entrée que Jev ; OpenAI coûte plus cher au tarif de base ; Perplexity et Clef-flash coûtent moins cher. Catalogue des modèles TypeSafe
Une intégration Jev existante possède déjà un atout : elle définit les décisions dont votre application a besoin. Conservez cette définition. Si les tickets de facturation doivent aller au service financier et les problèmes d’accès au support, le remplaçant doit faire ses preuves sur ces cas avant qu’un benchmark mis en avant n’oriente le choix.
Comment avons-nous sélectionné ces modèles ?
La sélection privilégie les modèles dont l’éditeur maintient une API, une fiche de modèle ou un dépôt, avec une documentation suffisante pour décider d’un déploiement. Les clones communautaires sans page d’éditeur vérifiée restent hors du comparatif. La liste couvre six éditeurs et sept options : la famille Cloudflare occupe une seule section, tandis que les deux modèles Liquid appellent des recommandations distinctes.
Les critères sont concrets : types d’entrées nécessaires, fonctionnement hébergé ou local, licence des poids, limite documentée susceptible de bloquer votre usage et coût d’une décision exploitable. Une décision exploitable est une décision que l’application peut accepter sans correction coûteuse ni escalade inutile.
L’ordre commence par le candidat hébergé le plus intéressant pour réduire le tarif, puis passe aux choix de plateforme et aux options locales. Ce n’est pas un classement de précision. Les tests des fournisseurs diffèrent par leurs jeux de données, leur matériel, la longueur des entrées et les trajets réseau. Tous les chiffres de performance cités sont communiqués par les fournisseurs ; aucun ne prouve qu’un modèle fera mieux que Jev sur vos tickets.
Le périmètre fonctionnel compte aussi. Ces modèles choisissent ou notent des résultats prédéfinis. Si vous avez besoin d’une réponse rédigée pour le support ou d’une explication, conservez une étape de génération. Notre comparatif Jev et GLM-5.3-Flash examine ce choix plus large.
Sept options à comparer
1. Perplexity pplx-decider-v1.1-27b : le premier candidat pour réduire le tarif hébergé
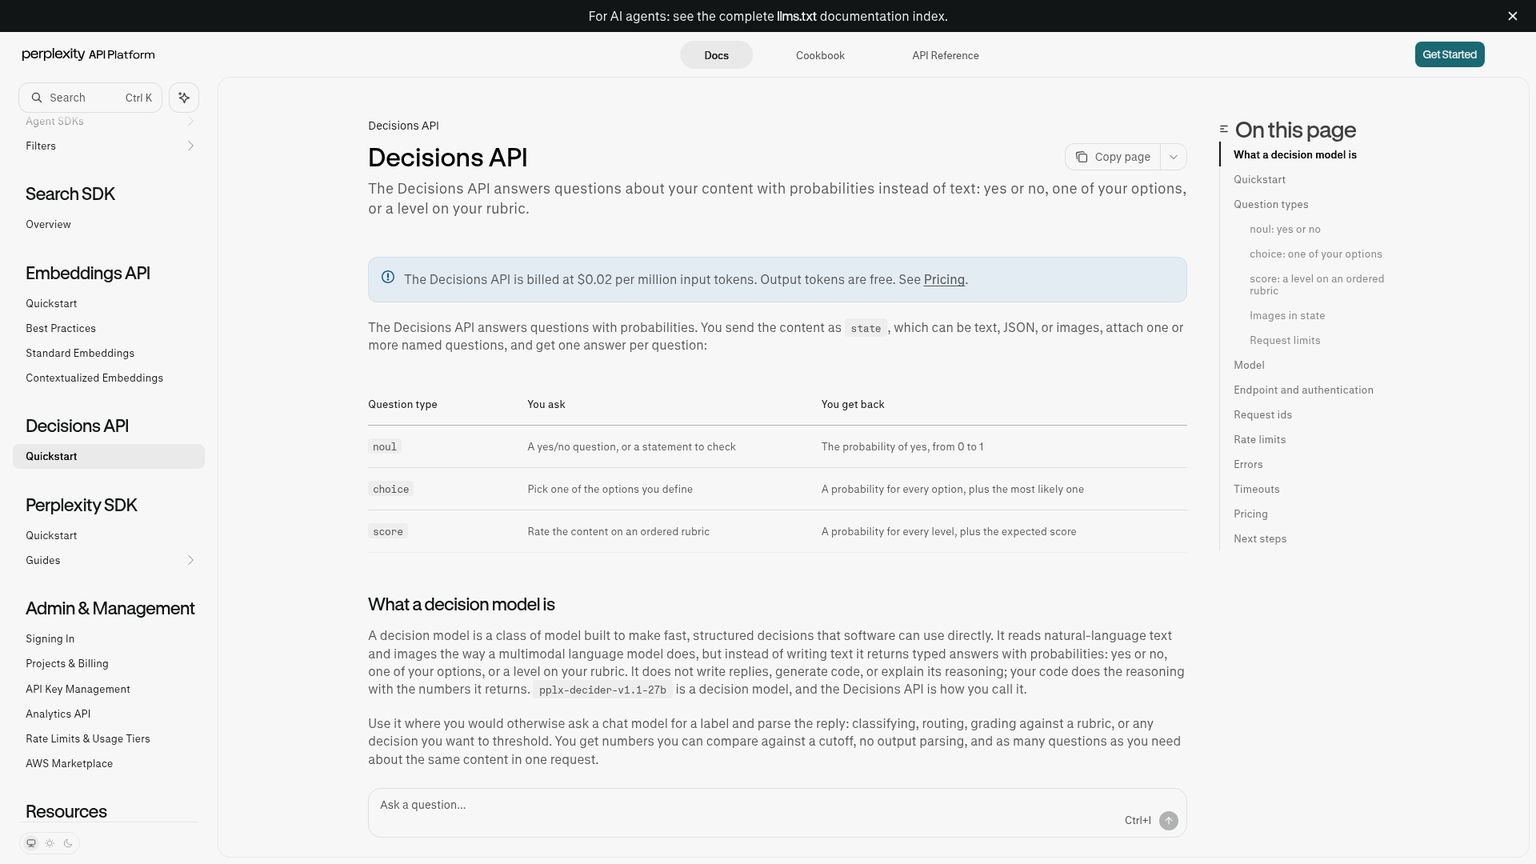
Perplexity pplx-decider-v1.1-27b est un modèle de décision accessible via l’API Decisions hébergée de Perplexity et sous forme de checkpoint téléchargeable. C’est le premier que j’évaluerais pour du routage courant de tickets ou de l’étiquetage en masse si l’objectif se limite à réduire le coût des entrées de Jev. Son tarif hébergé publié est le plus bas de cette sélection. Cette recommandation ne tient plus si son plafond de requêtes, ses exigences d’exécution locale ou son taux d’erreurs ne conviennent pas à votre charge.
À privilégier pour : Le routage, l’étiquetage et la notation selon une grille, en hébergement à moindre coût.
Point fort : Une API directe et une voie de déploiement distincte avec des poids ouverts.
Tarifs : $0.02 par 1M de tokens d’entrée ; sortie gratuite ; aucun frais par requête.
Essai gratuit : Non publié dans le guide Decisions cité.
Entrées et exécution : Texte, JSON et images intégrées à la requête via l’API Perplexity ; matériel CUDA pour l’implémentation locale fournie.
Licence : Apache-2.0 pour le checkpoint téléchargeable ; l’accès hébergé reste un service distinct. Guide de l’API, licence du checkpoint
La principale limite du service hébergé est son débit : Perplexity documente 10 requêtes par seconde et par organisation, quelle que soit l’offre. Une requête peut contenir jusqu’à 128 questions portant sur des éléments communs, avec un total d’entrée inférieur à 262,144 tokens. Limites des requêtes Des tickets clients distincts ne forment pas automatiquement une requête à état partagé au seul motif qu’ils nécessitent tous une étiquette. Évitez de regrouper des cas sans rapport si cela change la tâche. Limites du service hébergé
Avec ce plafond, un million de requêtes distinctes nécessiterait au minimum 27.8 heures, même avec une planification parfaite et aucune nouvelle tentative. Il s’agit d’une borne basse calculée, pas d’une mesure de vitesse. Un rattrapage nocturne et un flux régulier de tickets sollicitent très différemment la même API bon marché.
L’auto-hébergement a une autre contrainte. La configuration fournie par l’éditeur demande environ 49 GiB pour les poids, auxquels s’ajoute la mémoire de travail, et son implémentation de prepare refuse les entrées combinées au-delà de 8,192 tokens. Il faut conserver les réglages d’attention et de calibration utilisés lors de l’évaluation. La fiche mentionne encore un accès authentifié à un dépôt privé : vérifiez que votre compte peut télécharger le checkpoint avant de vous engager dans un déploiement local. Fiche du modèle Perplexity
Ne reportez pas la capacité de contexte du service hébergé dans les spécifications d’un déploiement local. Évaluez ce dernier comme un environnement d’exécution à part entière, avec son prétraitement réel, sa consommation mémoire et sa révision du modèle. Sinon, le secours risque d’échouer précisément sur les longs dossiers qui mettaient déjà le service principal en difficulté.
- Le tarif d’entrée hébergé publié le plus bas de cette sélection.
- Texte et images peuvent figurer dans la même requête de décision.
- Le checkpoint Apache-2.0 offre une voie au-delà du service hébergé.
- Le plafond de requêtes par organisation peut freiner un rattrapage ou un pic de trafic.
- La configuration locale fournie demande beaucoup de mémoire GPU.
- Les limites d’entrée du service hébergé et de l’implémentation locale de référence diffèrent fortement.
Pour une première comparaison, limitez la tâche afin de pouvoir examiner directement les erreurs.
Conservez les définitions des files existantes
Reprenez les étiquettes et les cas limites de votre implémentation Jev. Gardez une issue explicite « autre » ou « à examiner » pour les tickets qui sortent de ces définitions. Notre guide de routage des tickets de support avec Jev fournit un workflow de référence.
Utilisez le format de requête natif de Perplexity
Choisissez le modèle
pplx-decider-v1.1-27bet envoyezstateainsi que desquestionsnommées àPOST /v1/decisions. Utilisez une questionchoiceavec descriteriadécrivant chaque file. Suivez la référence native de l’API pour le contrat de requête et de réponse.Enregistrez les réponses sans changer les affectations
Lisez la réponse associée au nom de la question. Stockez l’étiquette choisie, les probabilités renvoyées, la consommation d’entrée facturée et le statut de la requête à côté du résultat Jev actuel. Distinguez les défaillances du fournisseur des décisions valides à faible confiance.
Fixez les conditions de bascule avant de connaître le gagnant
Définissez un taux acceptable de mauvais routage, un volume de révision et un délai de réponse. Ne retenez le candidat que s’il satisfait ces conditions sur des cas étiquetés représentatifs. Une facture d’entrée plus basse ne suffit pas.
2. Cloudflare Clef, Clef-flash et Clef-omni : choisir selon les entrées à traiter
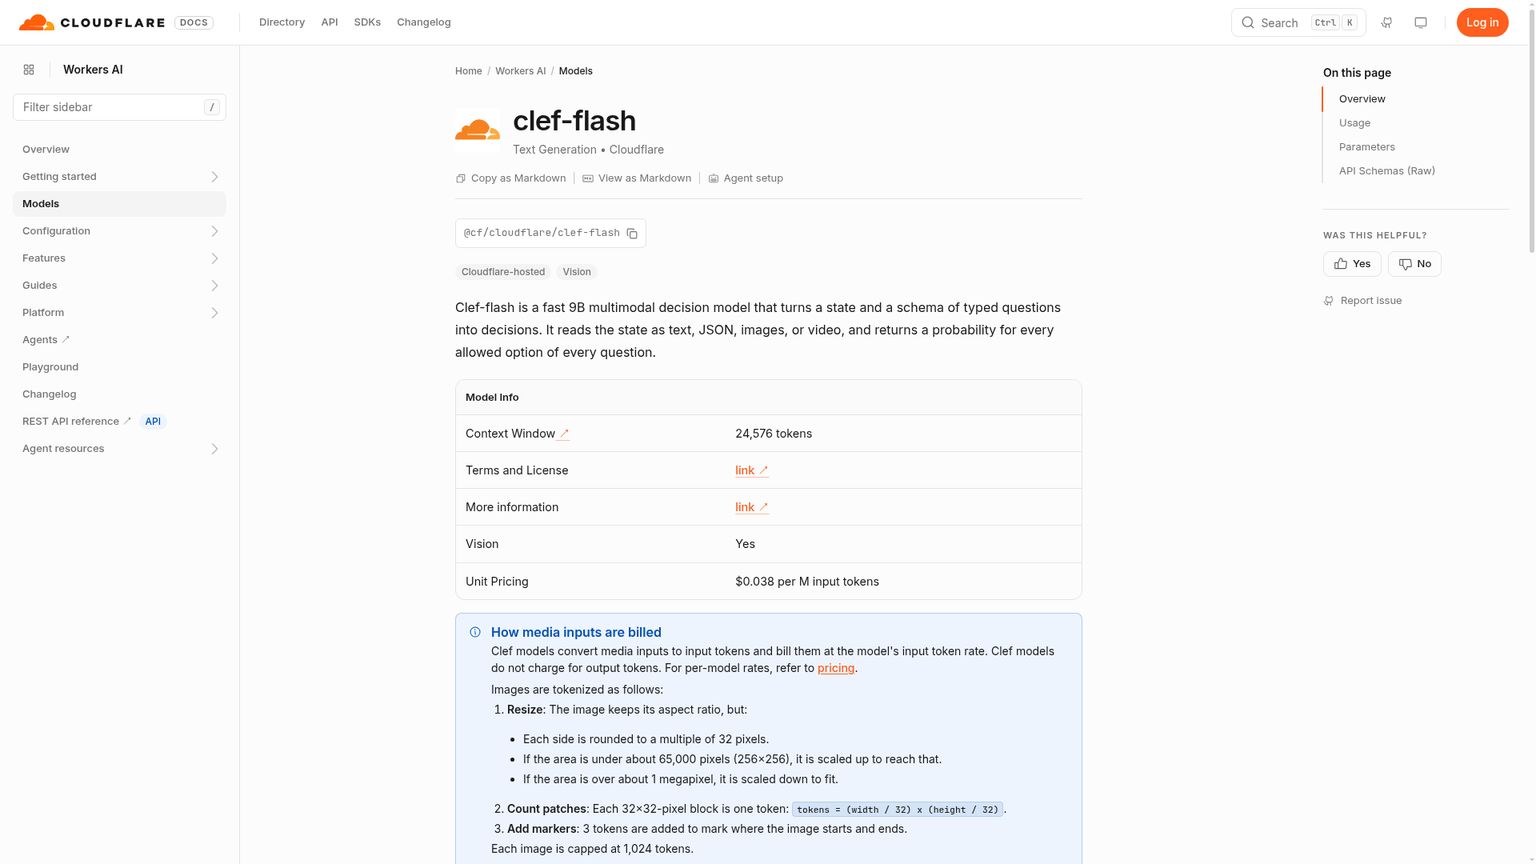
Cloudflare Clef-flash est le premier choix pratique lorsque la décision doit s’intégrer à une application Workers existante. La famille associe un hébergement Workers AI à des poids sous Apache-2.0 : vous pouvez évaluer un déploiement géré tout en conservant la possibilité de l’auto-héberger plus tard. Choisissez la variante selon les éléments qu’elle doit lire et les limites de son endpoint hébergé. Le modèle le moins cher de la famille ne remplace ni la prise en charge de l’audio ni un contexte suffisant.
À privilégier pour : Le routage et la classification au plus près d’une application Workers.
Point fort : Les bindings Workers AI, l’accès REST et les poids téléchargeables.
Tarifs : Clef-flash $0.038 ; Clef $0.240 ; Clef-omni $0.150 par 1M de tokens d’entrée.
Essai gratuit : Workers AI fournit un quota gratuit quotidien partagé, pas un essai Clef distinct et illimité.
Entrées et exécution : Clef et Clef-flash traitent le texte, le JSON, les images et les images extraites de vidéos ; Clef-omni ajoute l’audio direct et la vidéo avec son. Hébergement Workers AI ou votre propre stack d’inférence.
Licence : Poids sous Apache-2.0 pour les trois modèles. Tarifs Workers AI, annonce initiale, fiche Clef-omni
Clef et Clef-flash sont arrivés le 1 octobre 2026 ; la mise à jour du 9 octobre a ajouté Clef-omni et modifié les compromis du service hébergé. Le changement le plus déterminant : Clef-flash dispose désormais d’une fenêtre de contexte hébergée de 24,576 tokens. Le texte de son état peut être tronqué pour y tenir. Un long historique d’incident peut donc perdre des éléments utiles alors même que l’application reçoit une réponse. Documentation actuelle de Clef-flash, mise à jour d’octobre
Un formulaire de prise en charge court constitue donc un meilleur premier usage de flash qu’une archive de conversations sans limite de taille. Faites tenir les règles d’affectation et les éléments clients décisifs dans un budget d’entrée défini. Si vous raccourcissez le dossier avant l’envoi, évaluez cette version raccourcie, pas une transcription complète idéale.
Cloudflare Clef est l’option texte et images de plus grande taille, avec un contexte hébergé de 65,536 tokens. Son prix supérieur mérite examen si vos évaluations montrent un progrès utile ou si le contexte hébergé de flash est trop court. Sa taille seule ne garantit pas une meilleure qualité. Documentation Clef
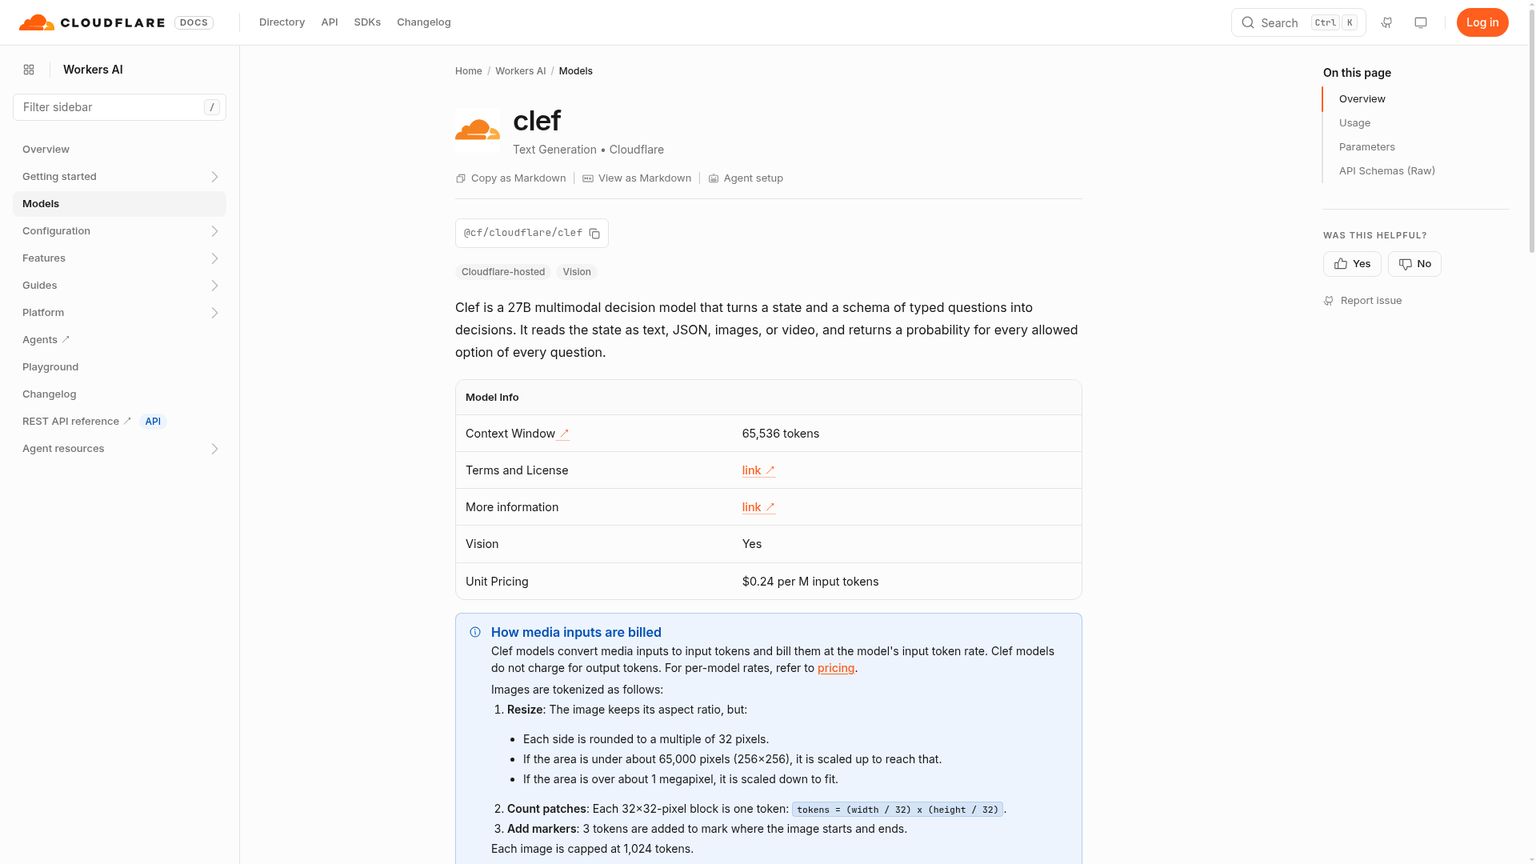
Cloudflare Clef-omni devient pertinent lorsque les éléments à analyser comprennent du son. Une application d’intervention sur site peut, par exemple, devoir classifier l’enregistrement d’une machine avec la description d’un technicien. La différence tient à l’entrée audio/vidéo directe, au lieu d’extraire des images fixes en espérant qu’elles contiennent la réponse. La documentation précise un contexte de 64,000 tokens, avec des limites propres aux médias : clips audio jusqu’à 300 secondes, vidéos jusqu’à 60 secondes, ainsi que des plafonds de nombre et de taille en octets. Documentation Clef-omni
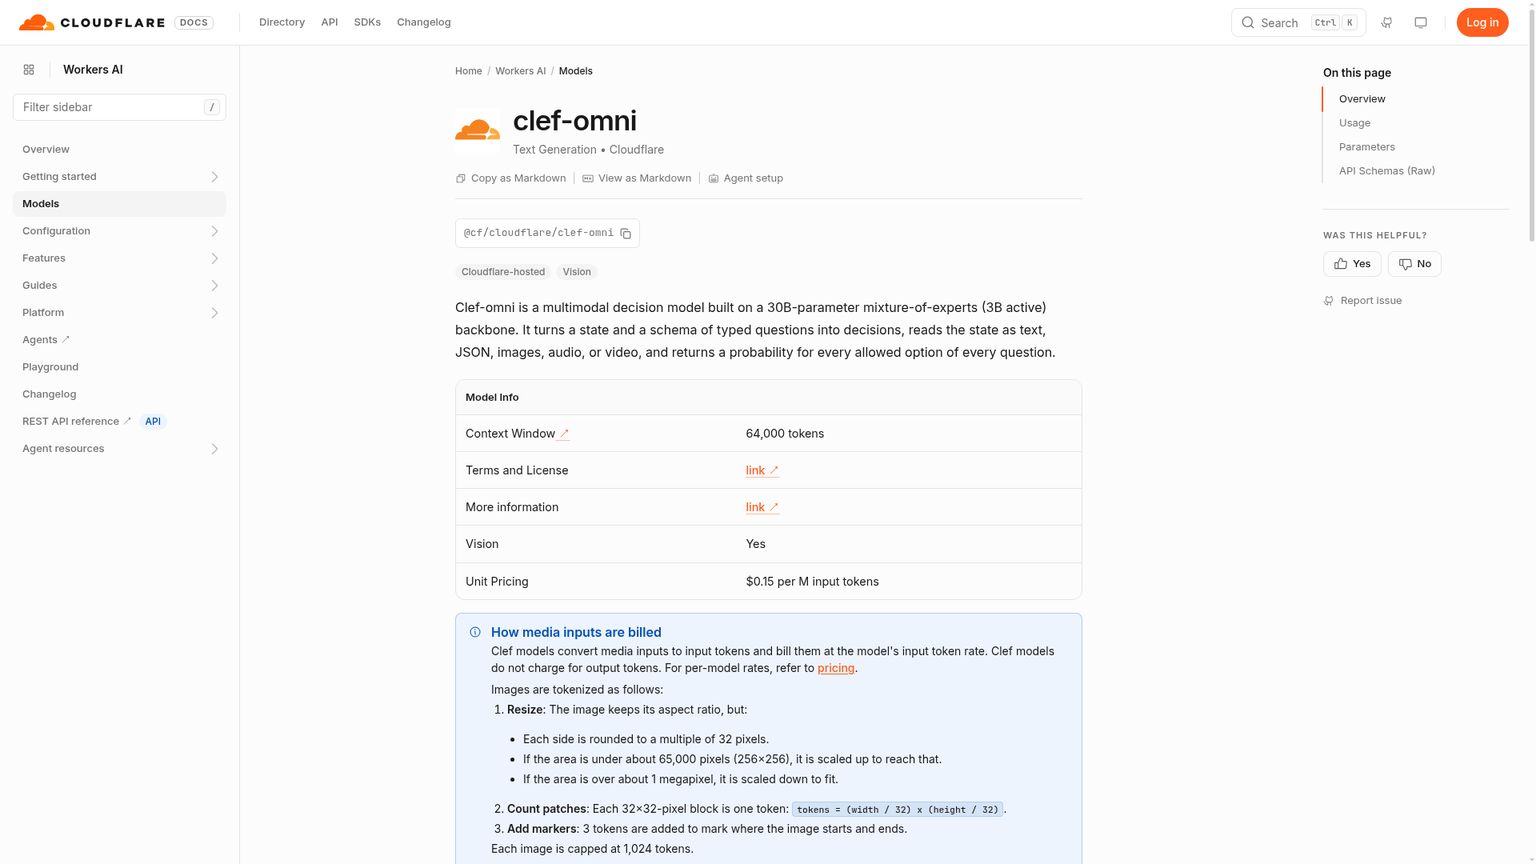
Des poids ouverts ne rendent pas pour autant le modèle omni déployable sur téléphone. La configuration de référence de Cloudflare décrit environ 64 GB de mémoire GPU pour son modèle de base en bfloat16. C’est une exigence d’infrastructure à budgéter, pas un tarif hébergé par token. Fiche du modèle Clef-omni
Le quota gratuit de Cloudflare, 10,000 Neurons par jour, correspond à une capacité Workers AI partagée ; les Neurons sont son unité de facturation du calcul. Au-delà du quota, l’offre Workers Paid est nécessaire. Considérez les tarifs par token comme les frais du modèle et ajoutez au budget le reste de l’abonnement Workers et de l’usage applicatif. Quotas et règles de facturation
- L’intégration native à Workers évite d’ajouter une plateforme applicative distincte.
- Les poids Apache-2.0 préservent la possibilité d’un auto-hébergement.
- La famille couvre le routage de texte courant jusqu’aux décisions sur audio et vidéo.
- Le contexte hébergé de Clef-flash est plus court que ne le laissent penser les anciennes annonces de lancement.
- Tronquer un état long peut supprimer les éléments nécessaires à la décision.
- Dans la configuration documentée, l’auto-hébergement de Clef-omni exige beaucoup de mémoire.
3. Microsoft-Decision-1 : étiquetage et contrôle des agents dans Foundry
Microsoft-Decision-1 est un modèle hébergé de notation de décisions destiné aux équipes qui travaillent déjà dans Microsoft Foundry. Son tarif de $0.042 par million de tokens d’entrée est identique au tarif actuel publié de Jev : évaluez-le pour son adéquation à votre plateforme et la qualité sur votre tâche, plutôt que pour une économie directe sur les tokens. L’étiquetage de retours clients ou le choix « continuer, réessayer ou transférer » d’un agent constituent de bons points de départ. La requête documentée accepte du texte ou du JSON ; ne déduisez pas une prise en charge des images de la famille du modèle sous-jacent. Annonce Microsoft, guide Foundry
À privilégier pour : L’étiquetage, la priorisation et le contrôle des actions d’agents dans un déploiement Foundry.
Point fort : Un parcours de déploiement Foundry documenté, avec Entra ID ou une clé API.
Tarifs : $0.042 par 1M de tokens d’entrée ; sortie gratuite.
Essai gratuit : Non publié dans les pages citées sur le modèle de décision.
Entrées et exécution : Texte ou JSON ; Microsoft Foundry et OpenRouter.
Licence : Service hébergé ; aucune licence de poids téléchargeables n’est publiée sur ces pages de l’éditeur. Tarifs et accès Microsoft, prérequis de déploiement
L’article Microsoft du 9 octobre 2026 indique que le modèle repose sur Qwen3.5-9B. Le passage évoquant d’autres modèles de base décrit un projet futur, pas l’architecture achetée aujourd’hui. De même, un modèle de base ouvert n’implique pas le droit de télécharger la version post-entraînée de Microsoft. Il s’agit d’un candidat hébergé tant que Microsoft ne publie pas ses poids séparément. Source sur l’architecture
L’intérêt opérationnel est de pouvoir mener l’évaluation dans la plateforme déjà utilisée par votre application. Imaginons que les retours clients soient aujourd’hui étiquetés par un modèle généraliste avant d’alimenter le rapport hebdomadaire d’un responsable produit. Définissez les thèmes et une issue « non classé », comparez les deux systèmes sur les mêmes retours, puis vérifiez si des commentaires vagues reçoivent des étiquettes trop précises. Une étiquette parfaitement structurée peut tout de même fausser le rapport.
Microsoft annonce la meilleure précision moyenne dans son comparatif de 36 benchmarks. Ce résultat est communiqué par le fournisseur, et sa comparaison de latence mesure Microsoft-Decision-1 via Foundry dans la même région. Ces conditions comptent : elles ne permettent de conclure ni au temps de réponse depuis votre application ni à la précision sur votre taxonomie interne. Description de l’évaluation Microsoft
La contrainte de déploiement est concrète. Il faut un projet Foundry, les autorisations de déploiement du modèle et un mécanisme d’authentification ; changer le nom du modèle dans un SDK sans rapport ne suffit pas. Le guide documente des décisions numériques, pas une explication rédigée. Si votre workflow doit justifier une étiquette auprès d’un réviseur, conservez les éléments qui l’étayent et produisez l’explication dans une autre étape. Configuration Foundry et contrat de sortie
- S’intègre aux workflows d’identité et de déploiement Foundry existants.
- Prend en charge les décisions binaires, les choix et la notation ordonnée.
- L’annonce de Microsoft indique clairement le tarif d’entrée.
- Aucune économie sur le tarif de base des entrées par rapport à Jev.
- Les pages de l’éditeur n’établissent aucune possibilité de déploiement avec des poids ouverts.
- L’entrée documentée est du texte/JSON ; ce n’est pas un remplacement multimodal promis.
4. OpenAI Decisions API : pour une application déjà intégrée à OpenAI
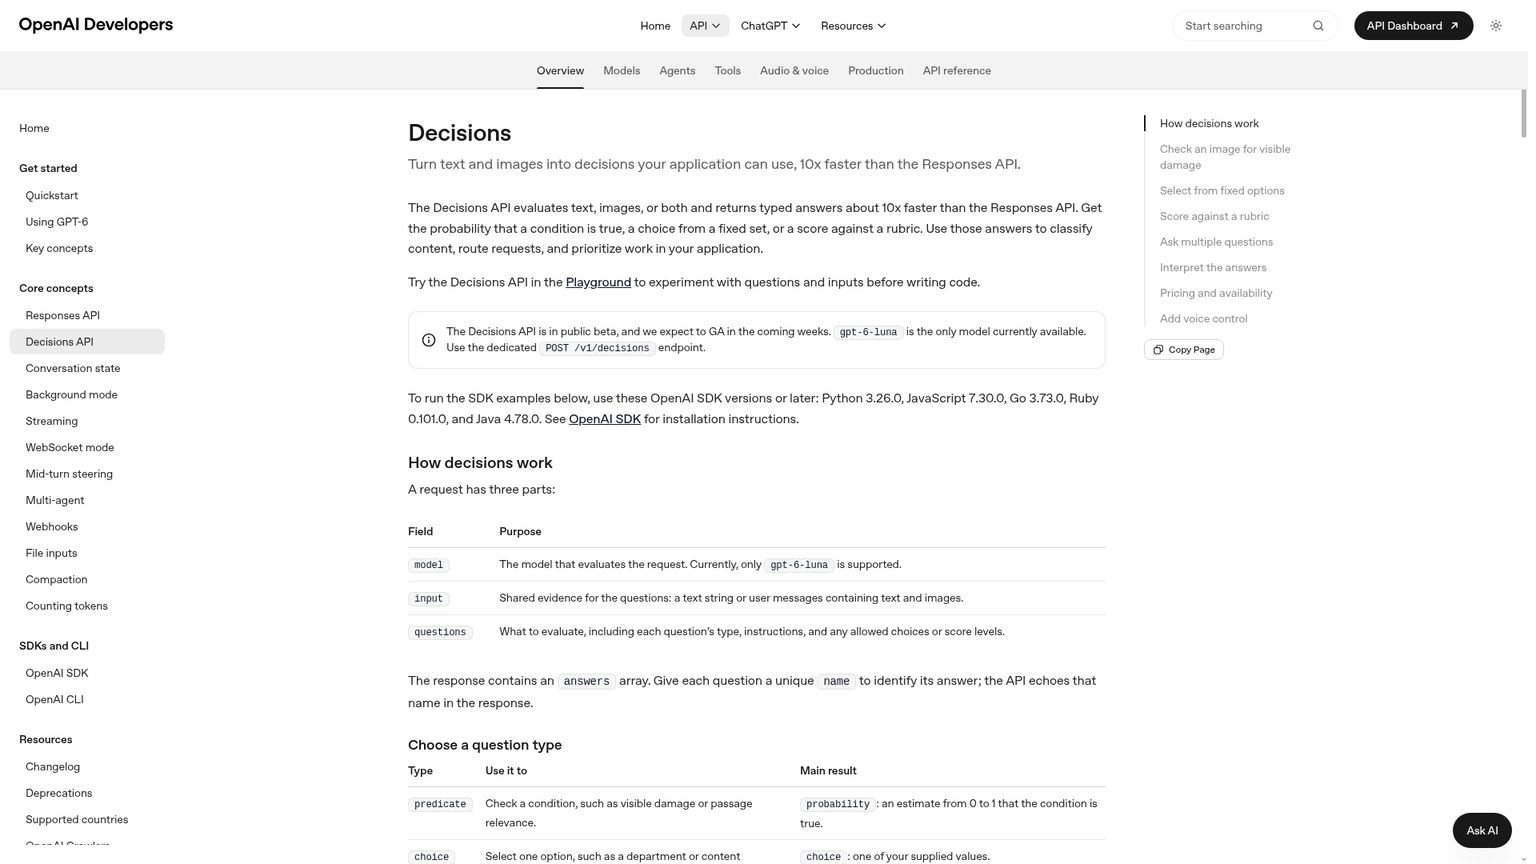
OpenAI Decisions API transforme du texte et des images en réponses typées avec gpt-6-luna. C’est un candidat pertinent si votre application utilise déjà OpenAI et que vous souhaitez y ajouter de la classification, un choix parmi des options définies ou une notation selon une grille. À $0.10 par million de tokens d’entrée, cette couche de décision coûte plus cher que Jev au tarif de base. Retenez-la si l’intégration ou la qualité mesurée sur la tâche justifie l’écart. Guide OpenAI Decisions
À privilégier pour : L’étiquetage de texte et d’images et les contrôles de décision dans une application OpenAI existante.
Point fort : Les réponses predicate, choice et score d’un endpoint dédié.
Tarifs : $0.10 par 1M de tokens d’entrée au tarif de base ; aucun frais de sortie, de lecture ou d’écriture du cache. Des majorations régionales et des multiplicateurs pour les entrées à contexte long s’appliquent.
Essai gratuit : Non publié dans le guide Decisions.
Entrées et exécution : Texte et images intégrées via l’endpoint hébergé POST /v1/decisions.
Licence : Accès à une API hébergée ; le guide ne fournit aucune licence de distribution de poids ouverts. Guide et tarifs actuels
L’API est entrée en bêta publique le 6 octobre 2026. Tenez compte de ce statut dans votre décision de déploiement. Une nouvelle API peut mériter une évaluation, mais avant d’en faire votre solution de secours, validez son intégration au parseur de réponses, à la gestion des exceptions et aux accès de votre compte. Journal des mises à jour OpenAI
Le principal obstacle à la migration est le contrat de requête et de réponse. OpenAI utilise input et un tableau de questions nommées ; son type oui/non est predicate. Un objet de questions au format Jev ne peut pas être transmis tel quel. La réponse peut aussi contenir un refus, à traiter séparément d’une probabilité. Formats des requêtes et des réponses
Un workflow de retours produits peut, par exemple, demander si une photo montre un dommage visible et choisir la file d’examen correspondante. Cela ne détermine ni l’origine du dommage, ni l’application d’une garantie, ni l’autorisation de rembourser. Ce sont des décisions distinctes, qui nécessitent d’autres éléments ou des règles métier fixes.
- Texte et images peuvent être évalués ensemble.
- Les réponses typées évitent d’avoir à analyser une étiquette rédigée.
- Le guide dédié distingue la facturation des décisions de celle des autres endpoints de modèles.
- Le tarif d’entrée de base dépasse celui de Jev et des alternatives hébergées les moins chères.
- Le statut de bêta publique compte dans la planification du déploiement.
- Les formats natifs de requête et la gestion des refus nécessitent un adaptateur.
5. Liquid AI d1-3B : le point de départ pour le texte et les images en local
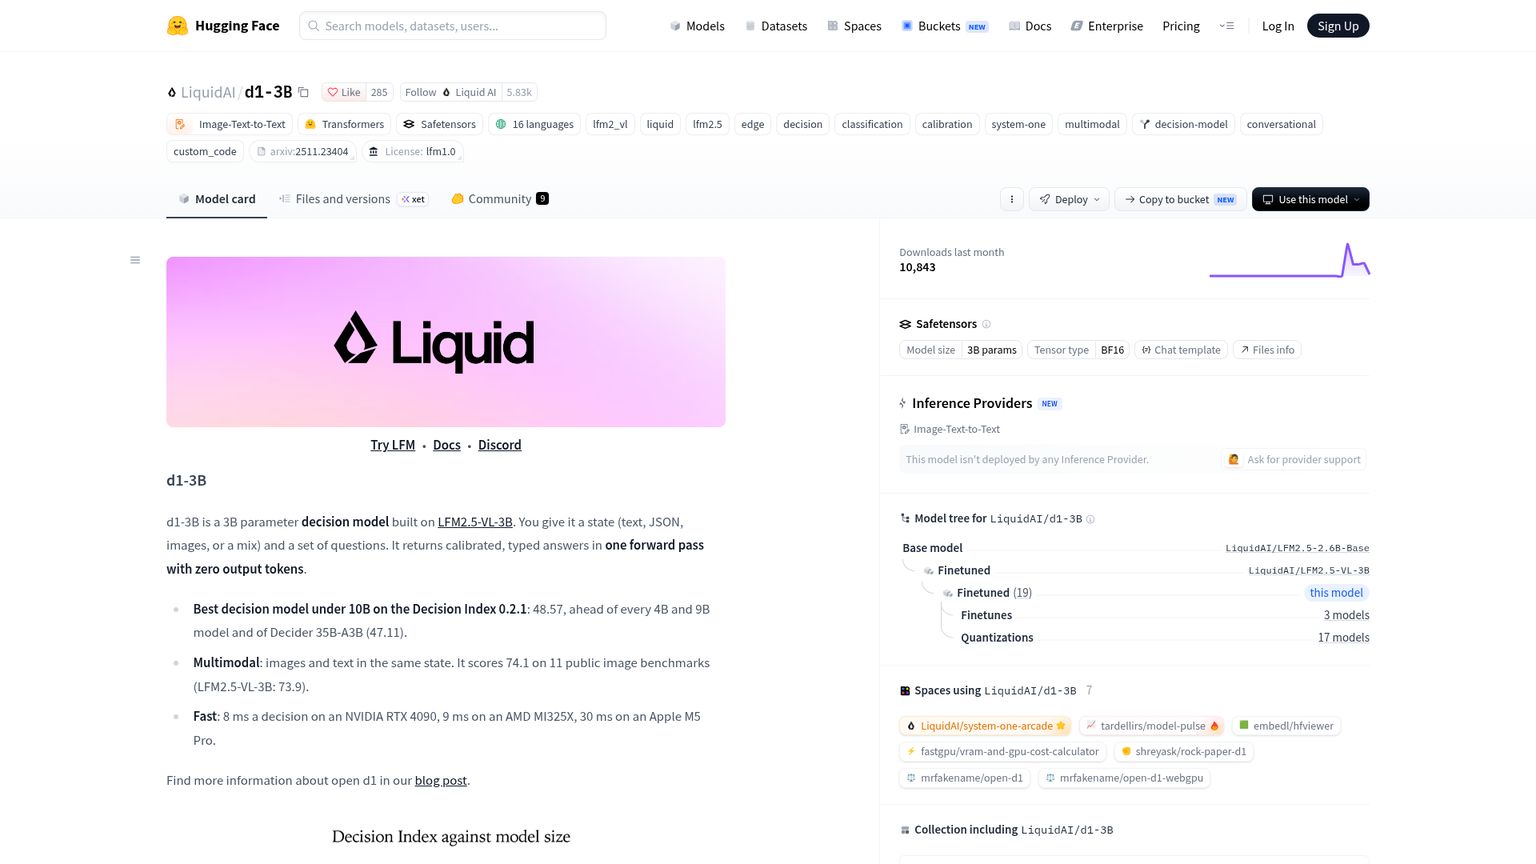
Liquid AI d1-3B est un modèle de décision à poids ouverts pour les entrées texte et images, publié le 7 octobre 2026. C’est le premier candidat local que j’évaluerais ici pour une application de bureau ou en périphérie devant classifier à la fois une description et une image. Son intérêt est de maîtriser le lieu d’exécution de l’inférence. Cela ne promet pas qu’exploiter un GPU coûtera moins cher qu’une API hébergée très bon marché. Annonce Liquid AI
À privilégier pour : La classification locale d’images, les contrôles visuels et le routage de texte.
Point fort : Un modèle téléchargeable accompagné de mesures documentées sur du matériel local.
Tarifs : Par 1M de tokens d’entrée : non publié pour ce checkpoint ouvert. Budgétez votre propre calcul.
Essai gratuit : Poids téléchargeables sous réserve de la licence ; le calcul reste à votre charge.
Entrées et exécution : Texte, JSON et images ; les exemples de l’éditeur prennent en charge CUDA, Apple MPS et le CPU via du code Transformers personnalisé.
Licence : LFM Open License v1.0. Fiche du modèle, licence des poids
Le modèle repose sur LFM2.5-VL-3B et documente un contexte de 32,768 tokens. Prenons un outil de contrôle qualité sur ordinateur : l’opérateur fournit l’image d’un produit et sélectionne une question d’inspection connue. L’exécution locale permet à l’application de fonctionner sans appel à un service de décision hébergé, à condition que le reste du workflow soit lui aussi local. Elle ne dispense pas de valider les conditions de prise de vue, le redimensionnement des images ou la définition d’un défaut. Architecture et contexte
Liquid annonce, pour une seule question, 16 ms sur Jetson AGX Thor, 26 ms sur AGX Orin et 50 ms sur Orin Nano. Ce sont des mesures matérielles communiquées par le fournisseur, pas une promesse pour la taille de vos entrées ni une comparaison avec une requête API complète sur Internet. Servez-vous-en pour identifier le matériel à évaluer, puis mesurez l’application complète. Tableau des temps de Liquid
La licence est une contrainte d’achat. Les deux checkpoints Liquid utilisent la LFM Open License v1.0, dont la condition d’usage commercial fait référence à un seuil de chiffre d’affaires annuel de $10 millions. Lisez la définition de l’entité juridique et la section 5 avant de supposer que votre déploiement remplit les critères ; confirmez les conditions auprès de Liquid si elles vous concernent. Ne classez pas ce modèle sous Apache-2.0 dans une fiche d’achat. Texte de la licence
Le nom appelle aussi une précision. Liquid répertorie le service hébergé d1 séparément de d1-3B et d1-omni-600M. Sa documentation et son annonce expliquent une facturation limitée aux entrées, mais les pages consultées pour ce comparatif ne publient pas de tarif en dollars par million. Le tarif et les limites du modèle hébergé ne doivent pas être attribués aux modèles téléchargeables. Catalogue Liquid, guide du service d1 hébergé
Pour un produit hors ligne, la bascule dépend de la qualité et de la latence obtenues sur l’appareil réellement visé. Testez avec les autres logiciels en fonctionnement, des images réalistes et un usage prolongé. Une inférence isolée réussie n’est que le début de l’évaluation de capacité.
- L’inférence de décision reste sur du matériel que vous exploitez.
- Le texte et les images sont pris en charge.
- Les mesures de l’éditeur désignent du matériel embarqué concret à évaluer.
- Les conditions d’usage commercial de la licence LFM demandent de l’attention.
- L’exécution, la capacité et la maintenance de l’environnement sont à votre charge.
- Le téléchargement ne garantit ni une facture d’inférence fixe ni un coût nul.
6. Liquid AI d1-omni-600M : de petites tâches vocales, avec les limites d’un modèle expérimental
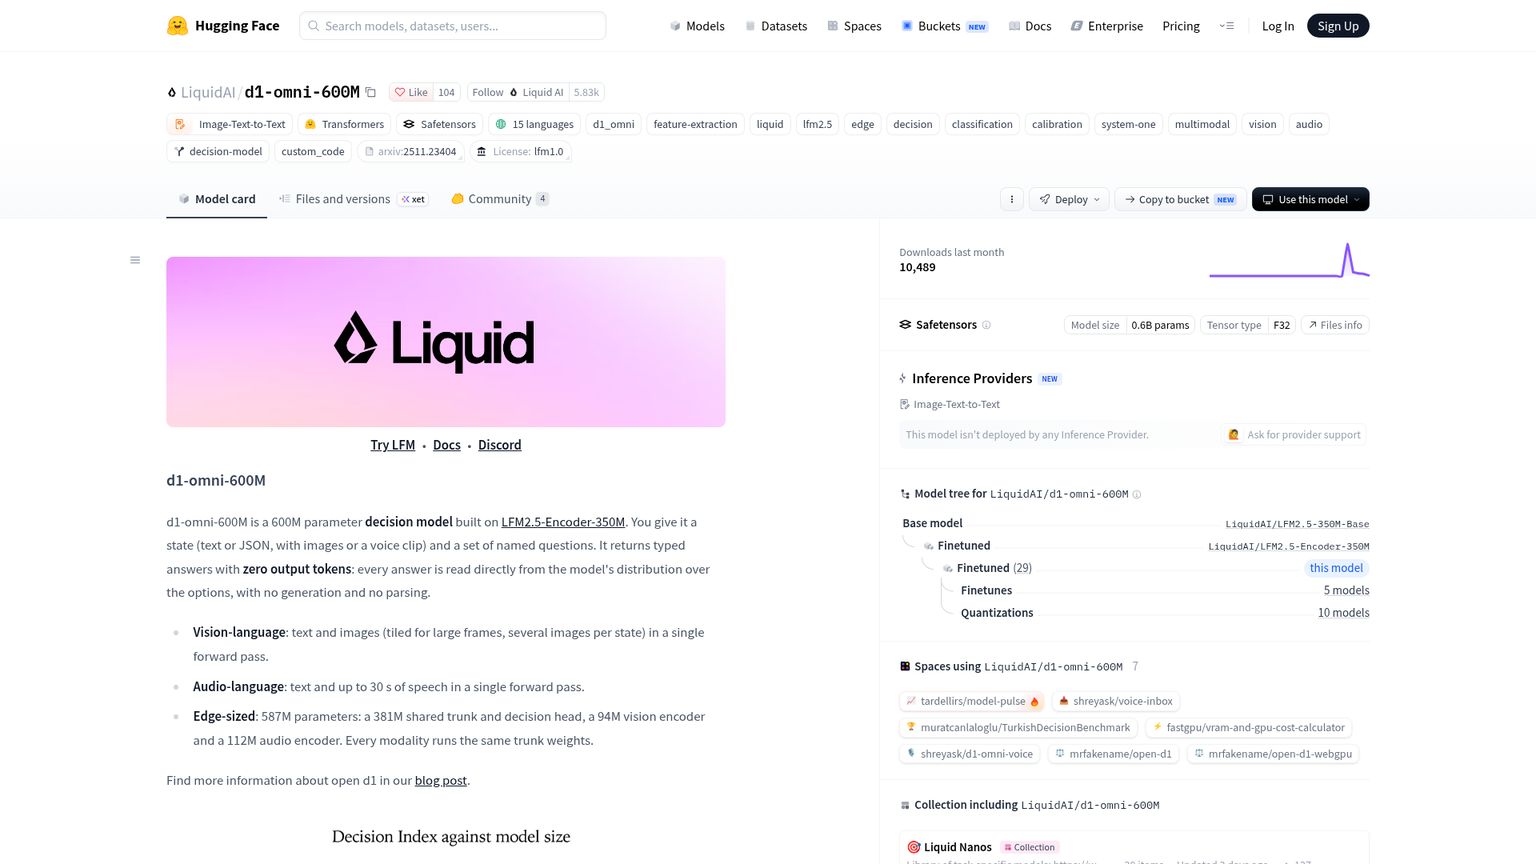
Liquid AI d1-omni-600M est la variante compacte et expérimentale pour le texte accompagné d’images ou d’audio. Elle mérite une place dans la sélection pour un appareil devant distinguer un petit ensemble d’intentions vocales, mais ne remplace pas d’emblée tous les services multimodaux hébergés. Sa taille rend l’exécution locale intéressante ; ses limites d’entrée et d’entraînement restent déterminantes. Un pilote de commandes vocales a un périmètre plus restreint que l’analyse d’enregistrements sans contrainte. Statut de la version, fiche du modèle
À privilégier pour : Les expérimentations d’intentions vocales ou de décisions sur images sur de petits appareils.
Point fort : Un checkpoint ouvert compact avec une entrée audio.
Tarifs : Par 1M de tokens d’entrée : non publié pour ce checkpoint ouvert.
Essai gratuit : Poids téléchargeables sous réserve de la licence ; les coûts de calcul restent à votre charge.
Entrées et exécution : Texte/JSON avec images ou audio ; exemples locaux sur CUDA, MPS ou CPU.
Licence : LFM Open License v1.0, avec la même condition d’usage commercial. Fiche du modèle, licence
La fiche documente 587 millions de paramètres, avec un entraînement audio fondé sur des requêtes entre une personne anglophone et un assistant. Les clips audio sont coupés à 30 secondes. Une commande comme « mettre l’inspection en pause » constitue donc une cible d’évaluation plus appropriée qu’un long appel client multilingue. Accepter de l’audio en entrée ne démontre pas une bonne performance sur tous les types de sons. Périmètre audio
Une limite passe facilement inaperçue : le modèle dispose de 16,384 positions de contexte au total, mais avec des images, le texte de l’état et des questions est tronqué à 896 tokens. Un long manuel d’utilisation joint à une image peut dépasser cette limite textuelle bien avant que la taille globale du contexte ne laisse prévoir un problème. Détails du contexte
Pour une borne, gardez une liste de commandes et des règles locales concises, avec une issue pour les demandes non reconnues. Évaluez les voix en arrière-plan et les contextes incomplets aussi méthodiquement que les commandes nettes. Le résultat utile est un système qui s’abstient quand l’instruction manque de clarté, plutôt qu’un système qui fournit toujours une option d’apparence valide.
L’annonce de Liquid ne publie aucune mesure de vitesse pour ce modèle expérimental. Ne lui attribuez pas les temps du modèle d1-3B, plus grand, et ne déduisez pas de garantie de latence de son plus petit nombre de paramètres. L’application doit toujours traiter les médias, charger le modèle et faire tenir son exécution dans les ressources de l’appareil. Périmètre des mesures au lancement
- Son faible encombrement convient à l’évaluation sur des appareils locaux aux ressources limitées.
- Il offre une voie de décision audio en plus de celle sur images.
- Les poids ouverts permettent d’examiner et d’exploiter le déploiement.
- Version expérimentale, avec un périmètre d’entraînement audio documenté restreint.
- Avec des images, le texte autorisé est bien plus court que le contexte total.
- L’annonce ne fournit aucun résultat de vitesse propre à ce modèle.
7. Amazon Strands Decider 2B : un contrôle local des agents dont on peut examiner le fonctionnement
Amazon Strands Decider 2B est un modèle de décision ouvert de Strands Labs, accompagné du code d’inférence, de ressources d’entraînement et d’évaluations publiées. Il convient particulièrement si vous quittez les appels hébergés à Jev pour maîtriser un petit composant de décision dans votre propre environnement d’agents. Commencez par une tâche délimitée, comme vérifier une action proposée au regard d’un ensemble de règles court. Ne considérez pas le serveur local fourni comme un produit hébergé complet. Dépôt de l’éditeur
À privilégier pour : Le contrôle local des actions d’agents, le routage et les expérimentations sur la méthode d’entraînement.
Point fort : Les poids, le code et les détails d’évaluation disponibles ensemble.
Tarifs : Tarif hébergé par 1M de tokens d’entrée : non publié ; vous fournissez l’environnement d’exécution.
Essai gratuit : Modèle et code téléchargeables sous Apache-2.0 ; le calcul est à votre charge.
Entrées et exécution : Texte et images facultatives avec le traitement visuel ; options CUDA, Apple Silicon et CPU.
Licence : Apache-2.0 pour le checkpoint nommé fondé sur Qwen et pour le projet. Fiche du modèle actuel
Fixez précisément le checkpoint : strands-decider-2B-qwen3.5-v1-2610 est la référence actuelle décrite par le dépôt. Il utilise une base Qwen3.5-2B-Base avec un adaptateur entraîné et une tête de décision, la partie qui attribue un score aux réponses autorisées. Les anciens noms hobson-v19 et hobson-v21 restent visibles ; toute affirmation de performance doit donc être associée à sa version. Version et architecture
Cette distinction concerne notamment le temps de 115 ms souvent cité. Le tableau détaillé du dépôt attribue cette médiane sur RTX 3090 à v19, tandis que les colonnes plus récentes indiquent partager l’architecture et la taille. Il s’agit d’un temps historique communiqué par le fournisseur, pas d’une nouvelle mesure du checkpoint actuel. Utilisez la mesure associée au checkpoint que vous comptez déployer. Tableau des performances par version
Le serveur fourni écoute sur localhost et ne comporte pas d’authentification. C’est utile pour une expérimentation locale, mais un service réseau exige aussi un contrôle d’accès, une gestion des accès concurrents, un responsable de déploiement et de la supervision. Pour un agent interne, ce responsable doit prévoir ce qui se passe lorsque le processus du modèle n’est pas encore chargé, est occupé ou indisponible. « Exécuter en local » est une option de déploiement, pas une stratégie de disponibilité. Instructions d’exécution
Un premier contrôle concret peut distinguer « l’action proposée lit seulement un enregistrement » de « l’action proposée modifie un enregistrement ». Des règles applicatives fixes doivent toujours vérifier les autorisations de l’utilisateur et les opérations permises. Si le modèle juge une opération sûre mais que l’utilisateur authentifié n’a pas le droit de l’effectuer, elle reste bloquée.
- Le modèle et le code sous Apache-2.0 permettent d’exploiter le composant localement.
- Les ressources d’entraînement et d’évaluation publiées rendent les hypothèses examinables.
- Les possibilités CPU et Apple Silicon de ce petit modèle élargissent les options d’évaluation.
- Aucun tarif d’entrée hébergé par l’éditeur ni endpoint géré n’est établi ici.
- Un serveur local d’exemple n’est pas un service de production abouti.
- Les latences historiques doivent rester associées au checkpoint mesuré.
Ce que la facture mensuelle change dans le choix
Une économie élevée en pourcentage peut représenter peu de dollars. Supposons un million de décisions par mois, chacune consommant 1,000 tokens d’entrée facturés. Cela représente un milliard de tokens d’entrée. Aux tarifs de base vérifiés, la facture du modèle, limitée aux entrées, s’élève à $20 pour Perplexity, $38 pour Clef-flash, $42 pour Jev ou Microsoft-Decision-1, $100 pour OpenAI Decisions, $150 pour Clef-omni et $240 pour Clef. Perplexity, Cloudflare, TypeSafe, Microsoft, OpenAI
Ce scénario repose volontairement sur un nombre identique de tokens facturables. Des tokenizers, des structures de questions et des traitements de médias différents peuvent aboutir à des totaux facturés différents pour une même entrée métier. Ces chiffres excluent les quotas gratuits, les abonnements aux plateformes, les majorations régionales ou de contexte long, les nouvelles tentatives, la génération en aval et la révision humaine.
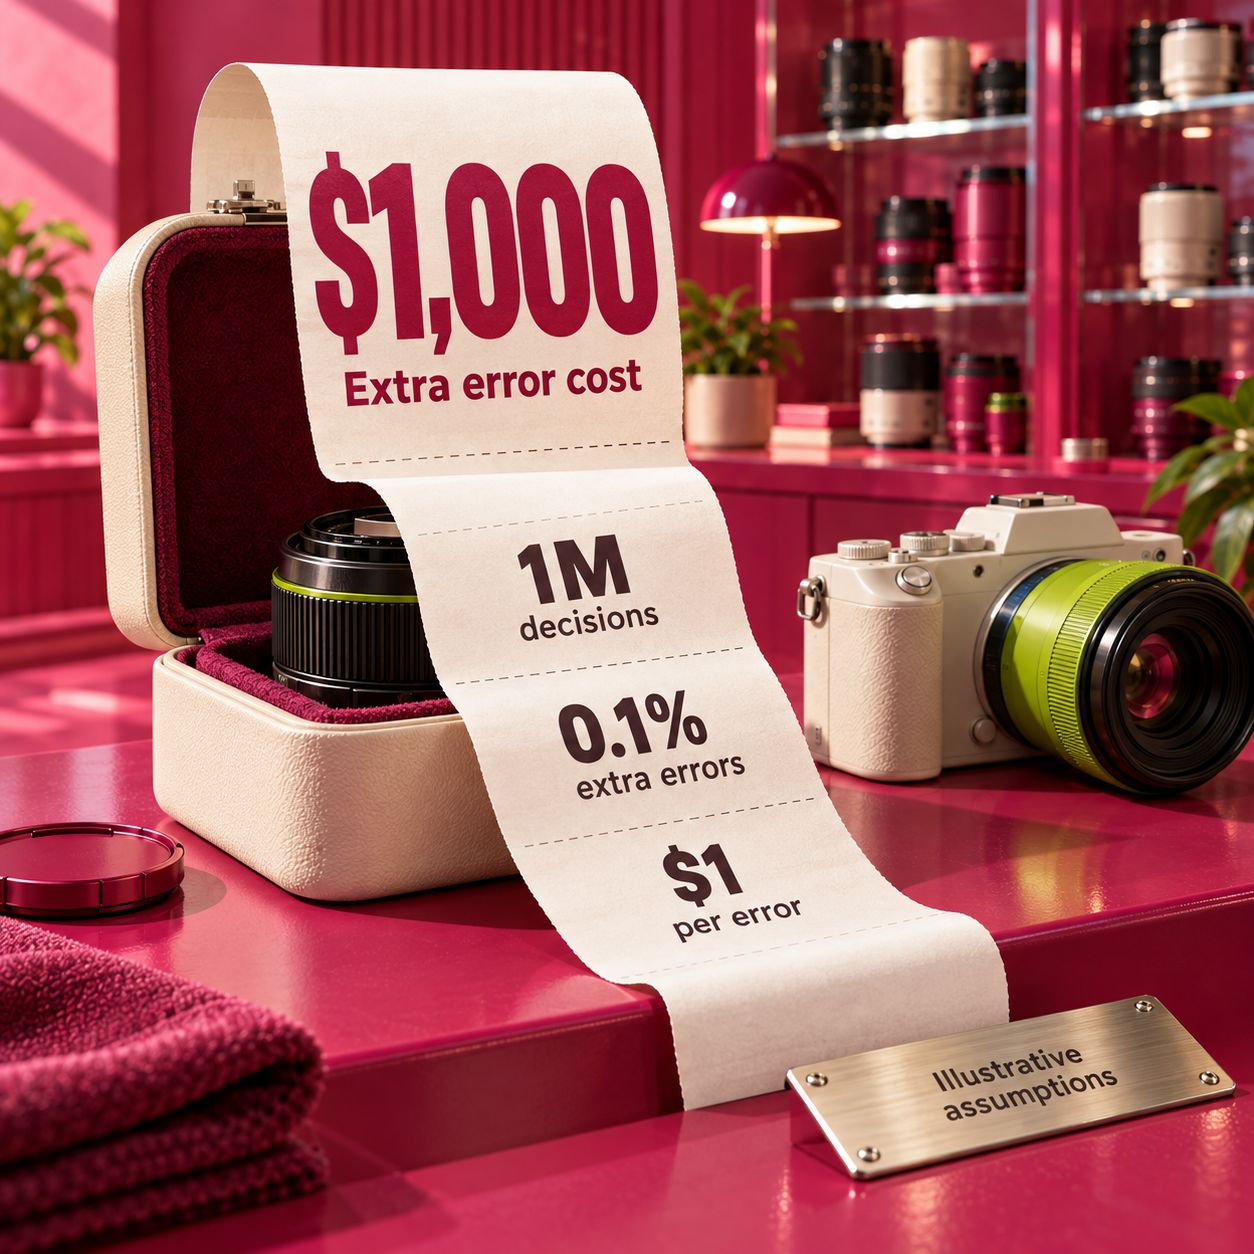
Supposons maintenant qu’un candidat entraîne 0.1 point de pourcentage d’erreurs supplémentaires, et que chaque erreur de plus coûte $1 à traiter. Sur un million de décisions, cela représente 1,000 erreurs supplémentaires et $1,000 de coût en plus. Ce sont des hypothèses illustratives, pas des taux d’échec mesurés ni un prix de marché du temps de travail. Elles montrent pourquoi il faut optimiser les décisions acceptées, plutôt que le seul prix des tokens.
L’auto-hébergement appelle le même raisonnement. Avec un budget d’infrastructure supplémentaire de $100 par mois, égaler le tarif de base de Perplexity à $0.02 par million demanderait cinq milliards de tokens d’entrée par mois, avant de compter l’exploitation ou les écarts de qualité. Les $100 sont une hypothèse, pas un devis GPU. Du matériel déjà disponible peut changer le calcul ; conserver les données en local ou faire fonctionner un produit hors ligne peut aussi le justifier sans économie sur les tokens.
Mesurez la facturation sur la charge réelle avant d’extrapoler. Le service d1 hébergé distinct de Liquid, par exemple, recompte le texte de chaque question et les images fournies. Envoyer plusieurs questions dans un seul appel HTTP n’implique donc pas de ne payer les éléments d’entrée qu’une fois. Cette règle de facturation ne fixe aucun tarif en dollars pour les checkpoints ouverts. Explication de la facturation Liquid
Quelle solution passer en production ?
Pour le routage courant, évaluez d’abord Perplexity si l’objectif est de réduire le coût hébergé. Commencez par Clef-flash si rester dans Workers simplifie l’application. Le choix dépend ensuite du débit de requêtes, de la longueur des entrées et des limites de mauvais routage et de révision mesurées que le candidat peut respecter. Ni un tarif inférieur ni une plateforme familière ne compensent la perte des éléments qui déterminent la bonne file.
Pour l’étiquetage, privilégiez le candidat qui respecte votre taxonomie sur les exemples ambigus. Microsoft-Decision-1 est un choix naturel dans Foundry ; Perplexity est le candidat hébergé à examiner pour son prix. Vérifiez si un commentaire peut relever de plusieurs thèmes. Une question à choix unique impose un seul gagnant : un problème à étiquettes multiples doit donc être décomposé en contrôles séparés ou représenté explicitement d’une autre manière.
Pour contrôler les actions d’agents, choisissez un environnement que vous pouvez exploiter de façon fiable et gardez l’autorité dans le code. Strands mérite une évaluation comme composant local ; Microsoft ou OpenAI peuvent convenir à une intégration hébergée existante. Le modèle peut fournir une estimation sur l’action proposée. L’application doit faire appliquer séparément les autorisations, les règles de dépense et les opérations permises.
Pour l’exécution sur l’appareil, commencez par d1-3B pour le texte et les images, et par d1-omni-600M pour une expérimentation vocale ciblée. Strands est une autre option locale si sa licence et sa méthode consultable correspondent mieux au projet. L’appareil, le prétraitement des entrées et l’usage commercial autorisé déterminent cette branche du choix avant toute comparaison de prix hébergés.
Pour des décisions sur audio et vidéo dans une application hébergée, évaluez Clef-omni. Sa prise en charge des médias constitue une différence réelle. Un modèle texte moins cher n’est une alternative que si vous ajoutez délibérément une étape de prétraitement et validez les informations qu’elle fait perdre.
Pour un second fournisseur, définissez la panne que vous voulez couvrir. Deux identifiants de modèle derrière la même passerelle dépendent toujours de cette passerelle. Un secours local échoue lui aussi s’il dépend du même service amont indisponible pour récupérer ses entrées. Dessinez le parcours complet de la requête et isolez la dépendance dont vous cherchez à supporter la panne.
Migrez une décision avant de migrer tout le workflow
Un remplacement réussit lorsqu’il préserve le contrat de décision de l’application, pas simplement lorsqu’il renvoie du JSON valide. Gardez les noms des files, le sens des grilles de notation et le comportement de repli stables pendant l’adaptation des champs propres au fournisseur. Vous pourrez ainsi examiner les désaccords sans mêler changement de modèle et changement de règles.
Figez la décision et les éléments à analyser
Choisissez un appel existant, par exemple l’affectation d’un nouveau ticket de support à une file. Consignez les étiquettes autorisées, la version des règles, les champs d’entrée et ce qui constitue une information insuffisante. Incluez dans le jeu étiqueté des cas ambigus et hors périmètre, pas seulement des exemples évidents.
Adaptez l’interface avec le fournisseur
Définissez explicitement la correspondance des éléments d’entrée, des questions et de la lecture des réponses. OpenAI utilise un champ d’entrée et un tableau de questions nommées ; les exemples documentés de Perplexity et Microsoft utilisent un état et des questions indexées par clé. Le format des images diffère aussi. Vérifiez le guide natif de l’éditeur, sans supposer que des primitives aux noms proches ont un format d’échange identique.
Exécutez le candidat en parallèle de la décision actuelle
Laissez le workflow actuel aux commandes pendant que le candidat enregistre seulement sa réponse. Comparez les décisions erronées acceptées, les transferts, les requêtes échouées, l’usage facturé et les temps de réponse les plus longs. Fournissez les mêmes éléments aux deux modèles pour qu’un changement de prétraitement ne passe pas pour un progrès du modèle.
Réglez les seuils pour ce modèle et cette tâche
Un seuil Jev n’est pas transférable au seul motif qu’une autre API renvoie une probabilité ou un champ appelé confidence. Vérifiez à nouveau le lien entre les scores et la justesse observée sur des exemples étiquetés. Prévoyez une voie de révision distincte pour les informations manquantes, les défaillances du fournisseur et les refus.
Basculez progressivement et facilitez le retour en arrière
Ne modifiez que le workflow retenu. Conservez la configuration précédente du modèle et un moyen d’y revenir. Réévaluez à chaque changement de checkpoint, d’alias de modèle, de formulation des questions ou de prétraitement : chacun peut modifier les décisions acceptées par vos seuils.
Si vous partez de Jev Router plutôt que d’un appel direct de décision à Jev, commencez par délimiter ce qui est facturé. Le service de routage et le modèle qu’il sélectionne en aval sont deux postes distincts. Le guide des tarifs de Jev Router explique cette différence ; un modèle de décision bon marché ne rend pas la réponse générée gratuite.
Les choix à éviter selon votre usage
Évitez Microsoft-Decision-1 pour économiser sur les tokens si votre seul reproche à Jev concerne son tarif de base actuel. Les tarifs publiés sont identiques. La plateforme ou la qualité peuvent justifier ce choix, mais c’est une autre raison.
Évitez Clef-flash hébergé pour une archive sans limite de taille si vous ne maîtrisez pas son budget d’entrée. Une réponse valide après troncature peut masquer l’absence d’un élément déterminant dans la décision. Choisissez une charge qui tient dans la limite ou évaluez une option dotée d’un contexte adapté.
Évitez d1-omni-600M pour analyser de longs enregistrements sans restriction sur la seule foi du mot omni. Le périmètre vocal documenté, la coupure des clips et le statut expérimental comptent. Dans cette sélection, Clef-omni est le candidat hébergé pour des médias plus riches, sous réserve de ses propres limites.
Évitez d’assimiler poids ouverts et service de production gratuit. Liquid impose une licence conditionnelle, la configuration de référence Perplexity demande beaucoup de mémoire et Strands vous laisse gérer l’hébergement. Télécharger un modèle marque le début d’un engagement d’exploitation.
Évitez un clone non vérifié comme solution de secours d’urgence. Un nom de produit proche ou un endpoint d’apparence compatible ne garantit ni un éditeur identifié, ni une licence exploitable, ni un environnement maintenu, ni une indépendance face aux pannes. Cette exclusion tient au manque d’éléments vérifiés, pas à l’idée que tous les projets communautaires seraient peu performants.
Questions fréquentes
Existe-t-il des alternatives à Jev gratuites ?
Cloudflare propose un quota gratuit quotidien partagé dans Workers AI. Plusieurs alternatives publient aussi des poids téléchargeables, mais le calcul reste à votre charge et la licence s’applique. La documentation du service hébergé de Liquid répertorie séparément un modèle texte seul d1:free, sans préciser de quota sur la page consultée ici. Un accès gratuit ne garantit pas un déploiement de production sans aucun coût. Guide du modèle hébergé Liquid
Quelles alternatives à Jev proposent des poids ouverts ?
Les éditeurs de la famille Clef, du checkpoint Perplexity cité, des deux checkpoints d1 de Liquid et de Strands Decider proposent un accès aux poids. Clef, Perplexity et le checkpoint Strands nommé utilisent Apache-2.0 ; Liquid utilise LFM Open License v1.0 avec une condition d’usage commercial. OpenAI Decisions et Microsoft-Decision-1 sont des options hébergées dans ce comparatif : les pages citées de leurs éditeurs ne fournissent pas de licence de poids ouverts.
Quelle alternative à Jev évaluer en premier ?
Évaluez d’abord Perplexity pour un tarif d’entrée hébergé inférieur, Clef-flash pour une application Workers existante, Microsoft-Decision-1 pour Foundry et OpenAI Decisions pour une intégration OpenAI. En local, commencez par d1-3B pour le texte et les images, d1-omni-600M pour une expérimentation vocale ciblée, ou Strands pour un composant d’agent dont le fonctionnement peut être examiné. L’évaluation sur votre charge réelle tranche le choix final.
Par où commencer lundi ?
Choisissez un appel de décision dont le responsable sait décrire ce qu’est une erreur coûteuse. Retenez un candidat pour la raison qui compte pour vous : prix, plateforme, médias en entrée ou exécution locale. Comparez-le à Jev avec les mêmes éléments, puis ne basculez que si ses erreurs acceptées, sa charge de révision et ses délais de réponse vous conviennent. Gardez la configuration d’origine prête à reprendre la main tant que la nouvelle solution n’a pas fait ses preuves sur le travail courant.
Utilisez la checklist d’audit des workflows métier avec l’IA pour identifier la décision à changer en premier.
- Publié
- Catégorie
- Build
- Langue

Classification de texte : faut-il adopter OpenAI Decisions API ?
OpenAI Decisions API pour classer les textes et orienter les tickets : trois requêtes, gestion des refus, tarifs et limites pour décider quand migrer.11 oct. 2026Build
Claude Code Remote Control : piloter ses sessions à distance
Configurez Claude Code Remote Control, reprenez vos sessions depuis un téléphone ou un navigateur et résolvez les erreurs de connexion, de compte et d’accès.9 oct. 2026Build
Coder sur iPhone avec Cursor : piloter son agent à distance
Pilotez votre agent Cursor depuis un iPhone : association des appareils, maintien du portable en éveil, tarifs et différences avec les agents cloud.9 oct. 2026Build
Prix Firecrawl en 2026 : calculez votre budget réel
Prix Firecrawl, crédits et recharges : calculez le coût de vos scrapes JSON, crawls hebdomadaires et pages en erreur pour choisir le bon forfait en USD.9 oct. 2026Build
Prix Claude Code : que choisir face à GitHub Copilot en 2026 ?
Claude Code ou GitHub Copilot : comparez les prix, les limites, les modèles et les coûts en équipe pour choisir votre assistant de code, ou combiner les deux.8 oct. 2026Build
LangGraph ou CrewAI : lequel choisir pour vos agents IA ?
LangGraph ou CrewAI pour vos agents IA ? Comparez état, mémoire, validation humaine, MCP et coûts d’hébergement sur un même workflow de prospection.7 oct. 2026Build
MCP server : créer, tester et déployer son serveur Python
Créez un serveur MCP en Python pour Claude Code et Cursor : outil en lecture seule, tests avec Inspector, authentification et déploiement HTTP partagé.7 oct. 2026Build