Classification de texte : faut-il adopter OpenAI Decisions API ?
OpenAI Decisions API pour classer les textes et orienter les tickets : trois requêtes, gestion des refus, tarifs et limites pour décider quand migrer.
Publié le
 Par Omid Saffari




Pour vos tâches de classification de texte, OpenAI Decisions API permet d’orienter les tickets, d’étiqueter les données et d’évaluer les actions proposées par un agent, avec des réponses directement exploitables par votre code. Si votre appel à un LLM sert uniquement à renvoyer une catégorie ou une note, un essai se justifie. Ne le remplacez toutefois que si Decisions atteint la même qualité de routage et améliore suffisamment le workflow pour justifier la migration.
Classification de texte : partir de la décision attendue
Voyez Decisions comme un répartiteur disposant d’une liste de destinations définie à l’avance. Vous lui fournissez les éléments à examiner et la question ; votre application décide de la suite à donner à la réponse.
Au 11 octobre 2026, l’API est en bêta publique, avec une disponibilité générale attendue « dans les prochaines semaines ». C’est la perspective annoncée par OpenAI, pas une date de sortie. gpt-6-luna est le seul modèle pris en charge, et le point d’accès est POST /v1/decisions. OpenAI présente l’API comme « environ 10x plus rapide que Responses API ». Il s’agit d’une affirmation d’OpenAI, pas d’un résultat mesuré dans votre application. Guide Decisions d’OpenAI
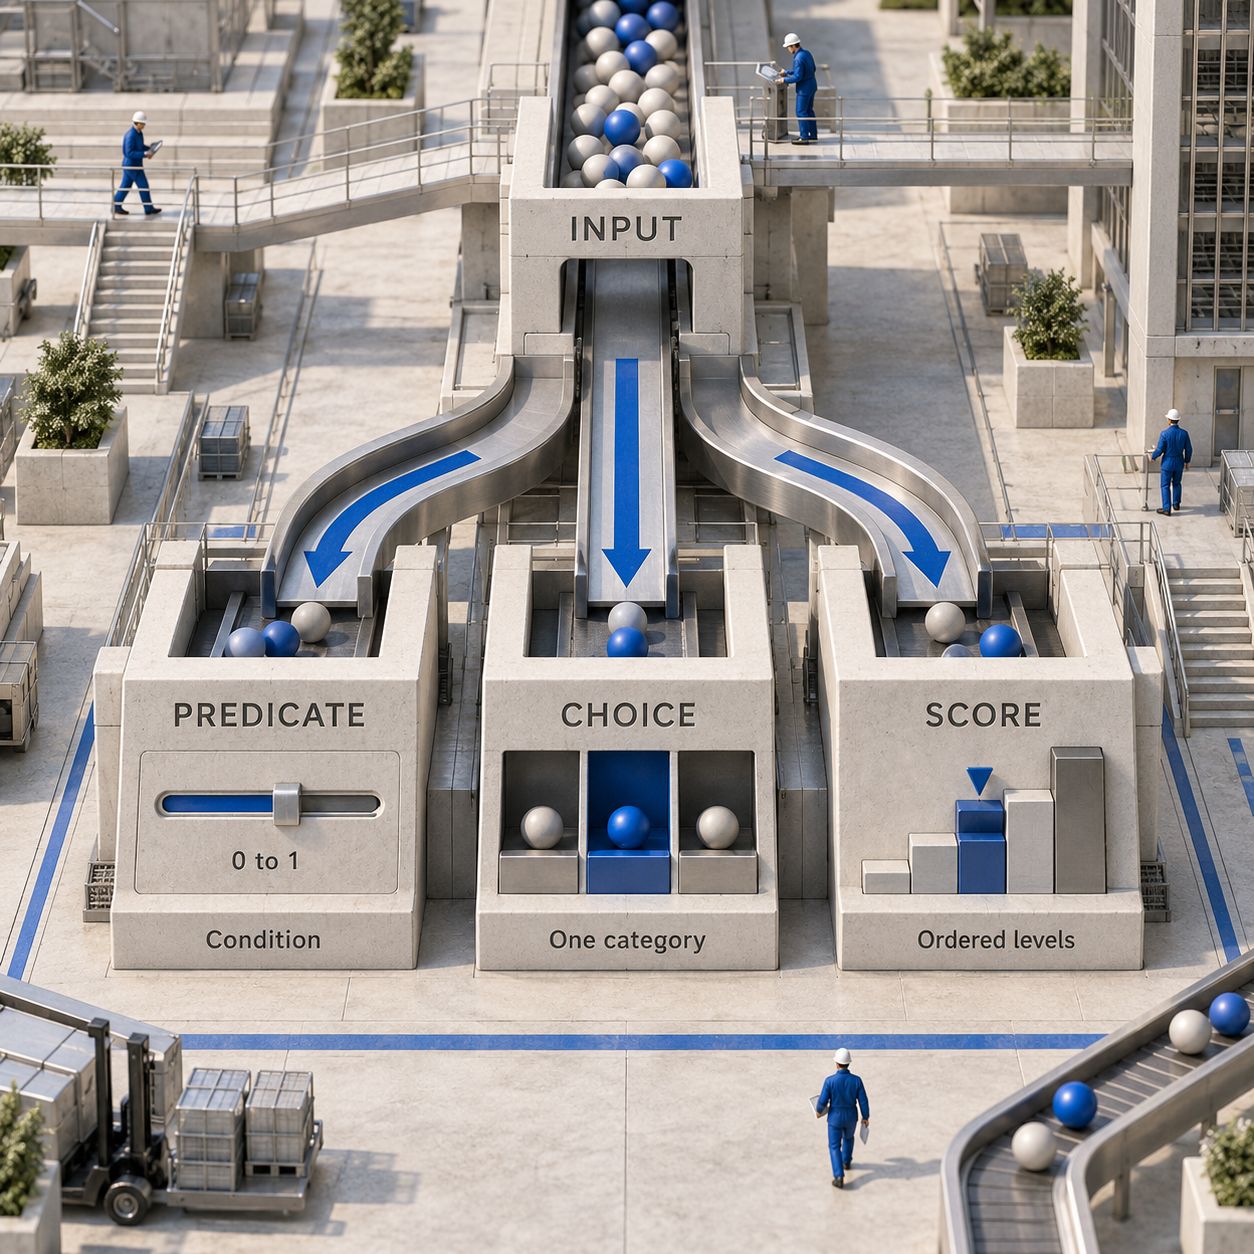
Choisissez le format de réponse avant de rédiger le prompt :
Pour un score, les niveaux sont indexés à partir de 0. Le résultat peut se situer entre deux niveaux : il résume l’incertitude entre ceux-ci. Utilisez un choix lorsque votre code attend une seule catégorie. Types de questions
Essayer les trois types de requêtes
Voici les trois exemples de requêtes cURL du guide, reproduits avec une mise en forme harmonisée et des commentaires ajoutés pour les distinguer. Définissez OPENAI_API_KEY dans l’environnement de votre shell ; l’exemple de prédicat nécessite aussi un fichier local product.png. Chaque commande envoie sa propre requête. Ces exemples ont été vérifiés dans le guide public, mais n’ont pas été exécutés avec un compte connecté. Exemples de requêtes d’origine
Les éléments communs sont input, qui contient les données à examiner, et questions, qui décrit les décisions à prendre à leur sujet. Le champ name d’une question identifie sa réponse dans le tableau answers renvoyé. Référence des requêtes et des réponses
# Predicate: inspect product.png for visible damage
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"

curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @- <<JSON
{
  "model": "gpt-6-luna",
  "input": [{
    "role": "user",
    "content": [
      {"type": "input_text", "text": "Inspect the product in this photo."},
      {"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
    ]
  }],
  "questions": [{
    "type": "predicate",
    "name": "visible_damage",
    "instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
  }]
}
JSON

# Choice: route a customer complaint
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice",
      "name": "department",
      "instructions": "Which department should handle this complaint?",
      "choices": [
        {"value": "billing", "description": "Payments, invoices, and refunds."},
        {"value": "technical", "description": "Problems using the product."},
        {"value": "shipping", "description": "Delivery and tracking."},
        {"value": "other", "description": "Requests outside these categories."}
      ]
    }]
  }'

# Score: assess issue severity
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Export fails in Safari but works in Chrome.",
    "questions": [{
      "type": "score",
      "name": "severity",
      "instructions": "How severe is this issue?",
      "levels": [
        {"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
        {"label": "Workaround available", "description": "A task fails, but another way works."},
        {"label": "Fully blocked", "description": "A task fails with no workaround."}
      ]
    }]
  }'
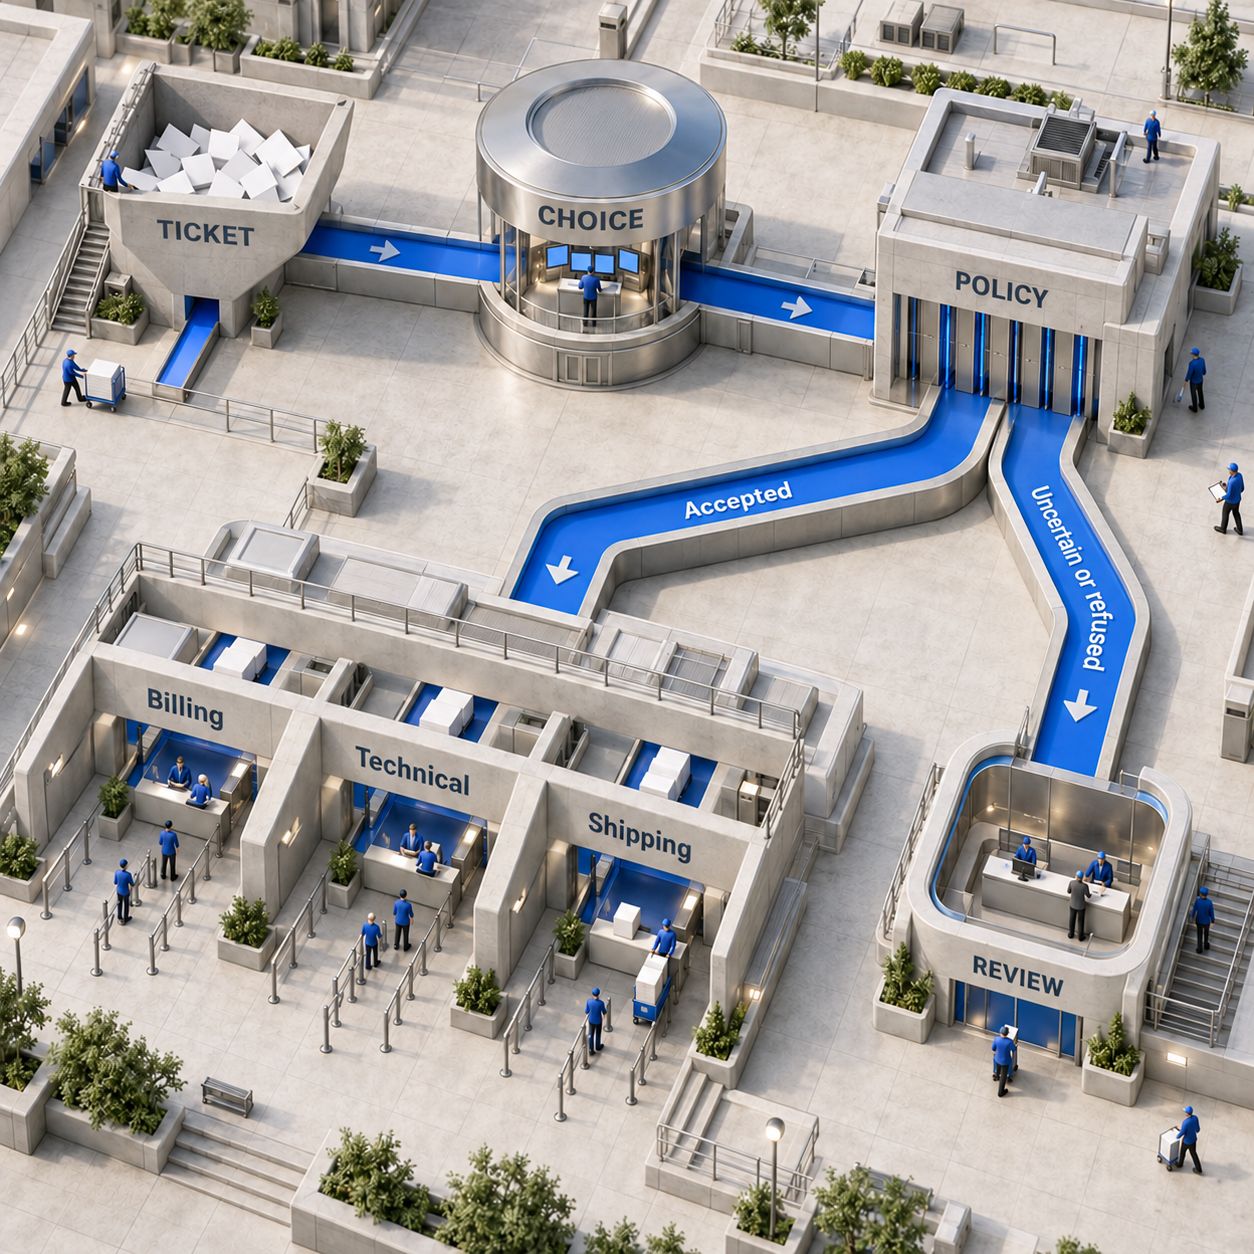
L’exemple de choix constitue déjà un point de départ concret : une réclamation pour double facturation doit rejoindre l’une des files prédéfinies. L’exemple de score répond à une autre question : à quel point un dysfonctionnement est-il gênant si un autre navigateur permet encore de travailler ? Distinguez l’équipe responsable du ticket de sa gravité : un problème de facturation peut être urgent sans devenir un ticket technique.
Traitez le refus avant de lire la valeur. Les exemples SDK du guide vérifient answer.type == "refusal" avant d’accéder à probability, choice ou score. Un refus est un résultat à part entière, pas une réponse à faible niveau de confiance ni votre catégorie other. Gestion des refus
Mettre le choix au service du routage des tickets
Pour une première version, concentrez-vous sur l’affectation aux files. Une équipe support pourrait transmettre l’objet du ticket et le passage pertinent du message client, obtenir le choix d’un service, puis laisser le code de l’application appliquer ses règles de routage.
Partez des définitions de files du guide et adaptez-les au périmètre réel de vos équipes. Conservez une option other pour les demandes qui ne relèvent d’aucun des services nommés. Une demande de remboursement relève de la facturation ; ce classement n’autorise pas pour autant le remboursement.
Cette petite fonction d’intégration illustre les règles à appliquer après avoir analysé une réponse JSON réussie et sélectionné la réponse department. Le dictionnaire thresholds doit contenir les seuils établis à partir de tickets étiquetés ; en l’absence de seuil, le ticket reste à examiner.
QUEUES = {
    "billing": "billing",
    "technical": "technical",
    "shipping": "shipping",
}

def queue_for(answer, thresholds):
    if answer.get("type") == "refusal":
        return "manual_review"
    if answer.get("type") != "choice":
        return "manual_review"
    department = answer.get("choice")
    if department not in QUEUES:  # Includes the guide's "other" choice.
        return "manual_review"
    cutoff = thresholds.get(department)
    confidence = answer.get("confidence")
    if cutoff is None or confidence is None or confidence < cutoff:
        return "manual_review"
    return QUEUES[department]
Dans ce workflow proposé, les erreurs d’API, les dépassements de délai et les réponses manquantes maintiennent eux aussi les tickets en attente d’un examen manuel. Consignez la version de la question, la file proposée, le niveau de confiance, la file finale et les éventuelles corrections de l’équipe. La mise à jour de la file doit pouvoir être répétée sans risque : une nouvelle tentative de requête ne doit pas créer d’affectations en double.
Vous pouvez regrouper dans une même requête des questions indépendantes portant sur le même ticket. Si le sens d’une question dépend d’une réponse précédente, posez-la dans une requête ultérieure. Conseils pour les requêtes à plusieurs questions
Fixer les seuils à partir de données étiquetées
Choisissez vos seuils en mesurant les erreurs que votre activité peut tolérer. OpenAI ne publie pas de chiffres de calibration dans le guide et renvoie les développeurs aux données étiquetées de leur propre application. Un niveau de confiance ne garantit pas que la réponse sera correcte à cette fréquence sur vos tickets. Interpréter les réponses
Partez d’anciens tickets dont un responsable support a vérifié la bonne destination. Incluez des demandes courtes, des problèmes mêlés, des messages qui manquent de contexte et des réclamations contenant des instructions destinées au modèle. Séparez les exemples utilisés pour ajuster les questions et les seuils d’un jeu de données réservé à la comparaison finale.
Mesurez les erreurs d’affectation, la part des tickets envoyés en examen manuel et le temps passé par l’équipe à corriger les affectations. Évaluez chaque file séparément. Confondre expédition et facturation n’a pas nécessairement le même coût opérationnel que manquer un signalement de compte compromis.
Commencez par faire fonctionner le candidat en parallèle du classificateur existant, sans modifier les affectations réelles. Ne le mettez en service que lorsque les résultats satisfont un critère d’acceptation écrit. Gardez l’ancien circuit disponible pour pouvoir revenir en arrière. Ce sont des étapes de déploiement proposées, pas les résultats d’un test de cette API.
Six cas d’usage à tester, par ordre de priorité
Pour démarrer, privilégiez des catégories stables, des erreurs observables et des exceptions dont une personne est déjà responsable. Ce classement exprime un choix de mise en œuvre, pas un palmarès de précision.
Pour l’étiquetage, décidez si une même donnée peut relever de plusieurs thèmes. Un choix unique sélectionne une catégorie ; des questions séparées peuvent mieux convenir à des étiquettes qui se recoupent. Pour la gravité des incidents, définissez l’impact en termes opérationnels, par exemple la perte de fonctionnalités et les solutions de contournement disponibles. Des mots comme « grave » laissent trop de place à l’interprétation du modèle.
Ce que les tarifs changent concrètement
Le tarif indiqué dans le guide est de $0.10 pour 1M de tokens d’entrée sur gpt-6-luna, sans frais de sortie, de lecture du cache ni d’écriture dans le cache. Des majorations pour le traitement régional et des multiplicateurs sur les entrées à contexte long peuvent s’appliquer. Ce sont les tarifs de Decisions ; n’appliquez pas cette règle de facturation aux appels ordinaires utilisant le même modèle. Tarifs de Decisions
Voici un calcul sur un lot hypothétique, pas une mesure de consommation ni un prix forfaitaire par décision. Supposons 100,000 appels de classification, chacun avec 1,000 tokens d’entrée non mis en cache, instructions et options comprises. Pour l’appel Responses existant, supposons aussi un total de 50 tokens de sortie facturés par appel. Le calcul utilise les tarifs de base standard pour les contextes courts, sans écriture dans le cache, majoration régionale, nouvelle tentative ni autres frais.
Les tarifs ordinaires du modèle proviennent de la grille tarifaire standard d’OpenAI. Dans cet exemple, supprimer la facturation des sorties fait économiser $2.50 sur l’ensemble du lot. Ce seul gain justifie difficilement de réécrire une intégration qui fonctionne.
L’argument le plus solide est opérationnel : moins d’attente dans un workflow séquentiel, moins de code pour traiter les réponses ou moins de tri manuel à taux d’erreur égal. Comparez ces gains à votre facture réelle et à votre charge de vérification. Un modèle existant plus cher ou des réponses générées plus longues changent le calcul ; les remises de cache déjà obtenues aussi. Le temps de développement et les tickets mal orientés font toujours partie du budget de migration.
Deux produits qui méritent d’être développés
Premier choix : un routeur de support avec examen manuel et historique des corrections
Un responsable des opérations support pourrait payer pour un connecteur qui suggère des files prédéfinies, met de côté les cas incertains et transforme les corrections de l’équipe en données d’évaluation. Le produit utile, c’est le workflow de routage complet, maintenance comprise.
DataForSEO estime à 170 le nombre de recherches mensuelles sur Google aux États-Unis pour « ticket triage », vérification effectuée le 11 octobre 2026. C’est un signal de demande informationnelle sur un sujet précis, pas un nombre d’acheteurs. Les outils de support existants répondent eux aussi à ce besoin : Zendesk propose des classifications de triage intelligent, dont l’utilisation dans les workflows nécessite son module complémentaire Copilot. Guide du triage de Zendesk
La plus petite version utile pourrait prendre en charge un outil de support, importer l’historique des tickets, prévisualiser les affectations et proposer une boîte de réception pour examiner et corriger les choix. Sa meilleure preuve commerciale serait la diminution des transferts évitables chez le client. La difficulté vient des fonctions déjà disponibles : si l’outil de support gère bien les files, ajouter un routeur augmente la maintenance. Démarquez-vous sur un problème précis de répartition des responsabilités ou de transfert entre systèmes.
Deuxième choix : un atelier de vérification pour des étiquettes prédéfinies
Une équipe de recherche ou de données pourrait payer pour un outil qui suggère des étiquettes, recueille les corrections et révèle les catégories qui suscitent des désaccords récurrents. DataForSEO estime à 90 le nombre de recherches mensuelles sur Google aux États-Unis pour « automated data labeling », lors de la même vérification. Cela signale un intérêt pour la tâche, pas une volonté démontrée d’acheter cette solution.
Une première version pourrait importer un CSV, appliquer un jeu d’étiquettes versionné, présenter les lignes incertaines à vérifier et exporter les résultats corrigés. Conservez un jeu d’évaluation à part pour comparer équitablement les changements d’étiquettes. Le piège : un modèle peut reproduire à faible coût une taxonomie mal définie. Le produit doit offrir de bons outils de vérification et de gestion des catégories ; une simple surcouche d’appel API se copie facilement.
Le routeur de support est le meilleur premier projet. La responsabilité des files donne une erreur visible, un opérateur capable de la corriger et un workflow récurrent dans lequel démontrer la valeur du produit. Interrogez cet opérateur avant de construire une plateforme de décision généraliste.
Quand conserver votre solution actuelle
Gardez Responses API lorsque vous avez besoin de champs extraits selon votre propre schéma JSON, d’une explication rédigée ou d’un appel d’outil demandé par le modèle, avec ses arguments. Decisions répond aux types de réponses plus restreints présentés ci-dessus. Conseils d’OpenAI pour choisir l’interface
Conservez des règles déterministes lorsque la réponse figure déjà dans un champ du compte ou dans une règle explicite. Un modèle apporte peu à « orienter les clients de cette région vers cette équipe ». Pour les actions lourdes de conséquences, maintenez l’autorisation humaine et les contrôles de permissions de l’application. Une décision de routage peut guider un workflow de remboursement ; elle n’établit ni le droit du client à être remboursé ni l’habilitation de l’opérateur.
Vérifiez ces contraintes d’intégration avant de planifier une migration :
- Images : le guide n’autorise que les URL de données en base64 intégrées à la requête : les octets de l’image sont donc encodés dans celle-ci. Les URL d’images hébergées en HTTP ou HTTPS et
file_id, qui désigne un fichier déjà téléversé, ne sont pas pris en charge selon les instructions du guide. Exigences pour les images en entrée - Contrôle des données : le guide indique la prise en charge de Zero Data Retention, ou ZDR, et d’usages relevant de HIPAA pour les clients éligibles. La résidence des données et le traitement régional sont pris en charge aux États-Unis et en Europe, précisément dans l’EEE + la Suisse. Des critères d’éligibilité, des accords, une configuration et des limites s’appliquent ; ce ne sont pas des réglages activés automatiquement sur les comptes. Disponibilité de Decisions, Contrôle des données chez OpenAI
- Maturité du service : la bêta publique justifie de conserver une possibilité de retour en arrière. Si votre classificateur actuel atteint ses objectifs et qu’un changement n’apporte aucun bénéfice mesurable, gardez-le.
Les alternatives : Jev, Clef et Microsoft-Decision-1
Avant de changer de fournisseur, comparez les candidats sur le même jeu de données étiquetées. Jev, de TypeSafe, accepte un état et des questions typées via son System One API. Cloudflare Clef propose des décisions typées dans Workers AI. Microsoft-Decision-1 est disponible dans Microsoft Foundry pour des tâches telles que la classification, le routage et la priorisation. Guide de démarrage de TypeSafe, documentation de Cloudflare Clef, annonce de Microsoft
Les intégrations existantes, les exigences d’hébergement, les résultats d’évaluation et la gestion des exceptions doivent guider la présélection. Notre guide du routage des tickets de support avec Jev décrit ce mode de routage ; l’article Jev Router est-il gratuit ? explique la distinction entre le logiciel de routage et l’inférence hébergée. Examinez séparément le format des requêtes et le comportement des niveaux de confiance de chaque fournisseur.
Faut-il remplacer mon appel de classification actuel par Decisions ?
Testez-le lorsque la sortie attendue est une catégorie prédéfinie, une estimation de condition ou une note selon une grille. Comparez les erreurs de routage, la charge d’examen manuel, le coût et les délais sur les mêmes exemples étiquetés. Conservez l’appel actuel si l’amélioration ne justifie pas la migration.
Que doit faire mon application lorsqu’une décision est refusée ?
Vérifiez le type de réponse avant de lire sa valeur. Dans un routeur de support, envoyez les refus en examen manuel et conservez assez de contexte pour que l’équipe puisse les traiter. Un refus n’autorise pas à choisir une action par défaut.
Quel seuil de confiance choisir ?
Fixez-le à partir de données étiquetées issues de votre propre workflow. Pour chaque seuil envisagé, mesurez les erreurs et le volume d’examens manuels, de préférence file par file. Cet article ne fournit aucun seuil universel et le guide d’OpenAI ne contient pas de tableau de calibration.
Puis-je transmettre l’URL d’une image hébergée ou l’identifiant d’un fichier téléversé ?
Suivez le format d’URL de données en base64 intégrée décrit dans le guide. Celui-ci exclut explicitement les URL d’images hébergées et les entrées file_id pour ce point d’accès. La requête de prédicat ci-dessus illustre le format pris en charge par le guide.
Par quoi commencer lundi
Choisissez l’appel de classification automatique qui oriente les tickets vers un ensemble de files déjà établi. Demandez à son responsable de vérifier un échantillon étiqueté représentatif, consignez les taux d’erreur et d’examen manuel acceptables, puis comparez Decisions à l’appel actuel en parallèle, sans changer les affectations. Ne basculez que lorsque ses résultats justifient sa place dans le workflow.
Pour un workflow de routage adapté à vos outils existants, nous développons des systèmes d’IA en production.
- Publié
- Catégorie
- Build
- Langue

Alternatives à Jev : quel modèle de décision IA choisir ?
Comparez les alternatives à Jev selon leurs tarifs en USD, leurs licences, leurs limites et leur déploiement : API hébergée ou modèles exécutés en local.11 oct. 2026Build
Claude Code Remote Control : piloter ses sessions à distance
Configurez Claude Code Remote Control, reprenez vos sessions depuis un téléphone ou un navigateur et résolvez les erreurs de connexion, de compte et d’accès.9 oct. 2026Build
Coder sur iPhone avec Cursor : piloter son agent à distance
Pilotez votre agent Cursor depuis un iPhone : association des appareils, maintien du portable en éveil, tarifs et différences avec les agents cloud.9 oct. 2026Build
Prix Firecrawl en 2026 : calculez votre budget réel
Prix Firecrawl, crédits et recharges : calculez le coût de vos scrapes JSON, crawls hebdomadaires et pages en erreur pour choisir le bon forfait en USD.9 oct. 2026Build
Prix Claude Code : que choisir face à GitHub Copilot en 2026 ?
Claude Code ou GitHub Copilot : comparez les prix, les limites, les modèles et les coûts en équipe pour choisir votre assistant de code, ou combiner les deux.8 oct. 2026Build
LangGraph ou CrewAI : lequel choisir pour vos agents IA ?
LangGraph ou CrewAI pour vos agents IA ? Comparez état, mémoire, validation humaine, MCP et coûts d’hébergement sur un même workflow de prospection.7 oct. 2026Build
MCP server : créer, tester et déployer son serveur Python
Créez un serveur MCP en Python pour Claude Code et Cursor : outil en lecture seule, tests avec Inspector, authentification et déploiement HTTP partagé.7 oct. 2026Build