OpenAI Decisions API: классификация обращений на практике
Как использовать OpenAI Decisions API для классификации обращений: три типа запросов, обработка отказов, цены, ограничения и проверка качества перед переходом.
Опубликовано
 Автор Omid Saffari




OpenAI Decisions API помогает распределять обращения по отделам, размечать записи и оценивать действия, которые предлагает ИИ-агент. Ответы можно сразу использовать в коде. Если сейчас вы вызываете LLM только ради категории или оценки, этот API стоит попробовать. Заменять существующий вызов имеет смысл лишь тогда, когда качество маршрутизации не уступает текущему, а выигрыш в работе оправдывает затраты на переход.
OpenAI Decisions API: какой ответ нужен вашему коду?
Представьте Decisions как диспетчера, у которого есть заранее заданный список направлений. Вы передаёте исходные данные и вопрос, а что делать с полученным ответом, решает ваше приложение.
По состоянию на 11 октября 2026 года API находится в открытом бета-тестировании. Выход в общий доступ ожидается «в ближайшие недели» — это ожидание OpenAI, а не дата релиза. Единственная поддерживаемая модель — gpt-6-luna, эндпоинт — POST /v1/decisions. По заявлению OpenAI, API работает «примерно в 10 раз быстрее Responses API». Это утверждение компании, а не результат замеров в вашем приложении. Руководство OpenAI по Decisions
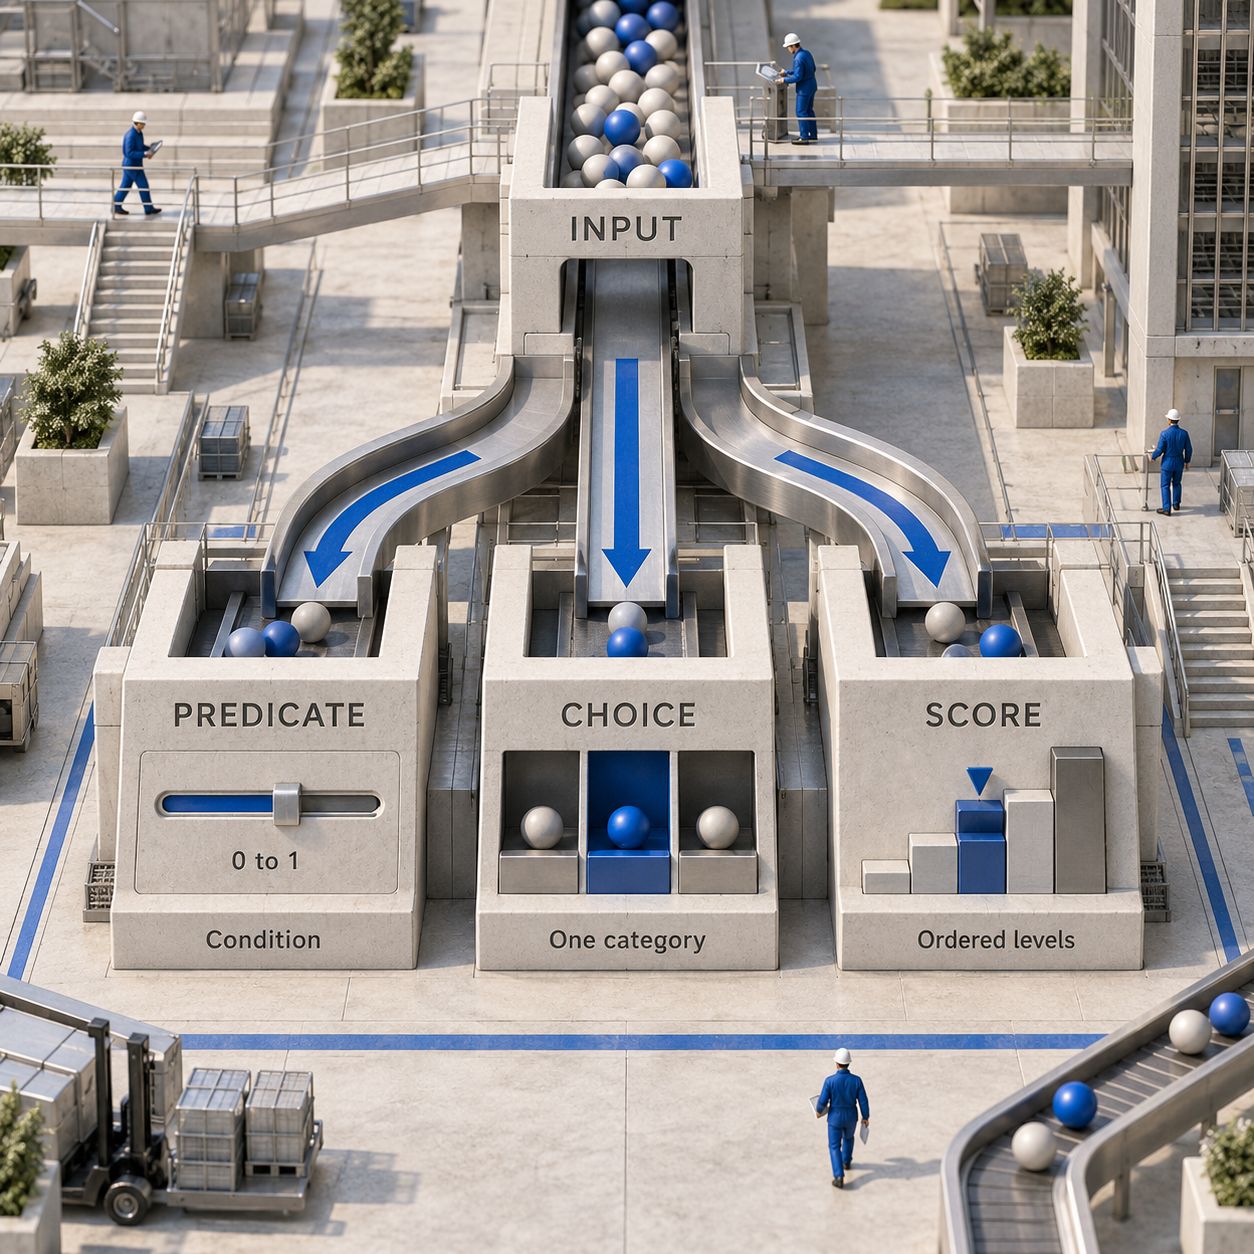
Прежде чем писать промпт, выберите формат ответа:
При оценке по шкале нумерация уровней начинается с индекса 0. Результат может оказаться между уровнями: он обобщает неопределённость между ними. Если коду нужна одна категория, используйте вопрос с выбором варианта. Типы вопросов
Как отправить запросы всех трёх типов
Ниже приведены три примера запросов cURL из руководства. Форматирование унифицировано, для разделения примеров добавлены комментарии. Задайте OPENAI_API_KEY в переменных окружения оболочки; для примера с предикатом также понадобится локальный файл product.png. Каждая команда отправляет отдельный запрос. Примеры сверены с общедоступным руководством, но не запускались с авторизацией в аккаунте. Исходные примеры запросов
Общие поля — input с исходными данными и questions с вопросами, на которые нужно ответить. Поле name у вопроса позволяет найти его ответ в возвращаемом массиве answers. Справочник по запросам и ответам
# Predicate: inspect product.png for visible damage
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"

curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @- <<JSON
{
  "model": "gpt-6-luna",
  "input": [{
    "role": "user",
    "content": [
      {"type": "input_text", "text": "Inspect the product in this photo."},
      {"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
    ]
  }],
  "questions": [{
    "type": "predicate",
    "name": "visible_damage",
    "instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
  }]
}
JSON

# Choice: route a customer complaint
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice",
      "name": "department",
      "instructions": "Which department should handle this complaint?",
      "choices": [
        {"value": "billing", "description": "Payments, invoices, and refunds."},
        {"value": "technical", "description": "Problems using the product."},
        {"value": "shipping", "description": "Delivery and tracking."},
        {"value": "other", "description": "Requests outside these categories."}
      ]
    }]
  }'

# Score: assess issue severity
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Export fails in Safari but works in Chrome.",
    "questions": [{
      "type": "score",
      "name": "severity",
      "instructions": "How severe is this issue?",
      "levels": [
        {"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
        {"label": "Workaround available", "description": "A task fails, but another way works."},
        {"label": "Fully blocked", "description": "A task fails with no workaround."}
      ]
    }]
  }'
Пример с выбором категории уже подходит для первого бизнес-сценария: жалобу на двойное списание нужно направить в одну из заданных очередей. Пример с оценкой решает другую задачу: насколько сильно сбой мешает работе, если в другом браузере всё работает? Не смешивайте ответственный отдел и серьёзность проблемы. Обращение по оплате может быть срочным, но от этого оно не становится техническим.
Прежде чем читать значение, обработайте отказ. В примерах с SDK из руководства сначала проверяется answer.type == "refusal", и только затем читаются probability, choice или score. Отказ — отдельный результат. Это не ответ с низкой уверенностью и не ваша категория other. Как обрабатываются отказы
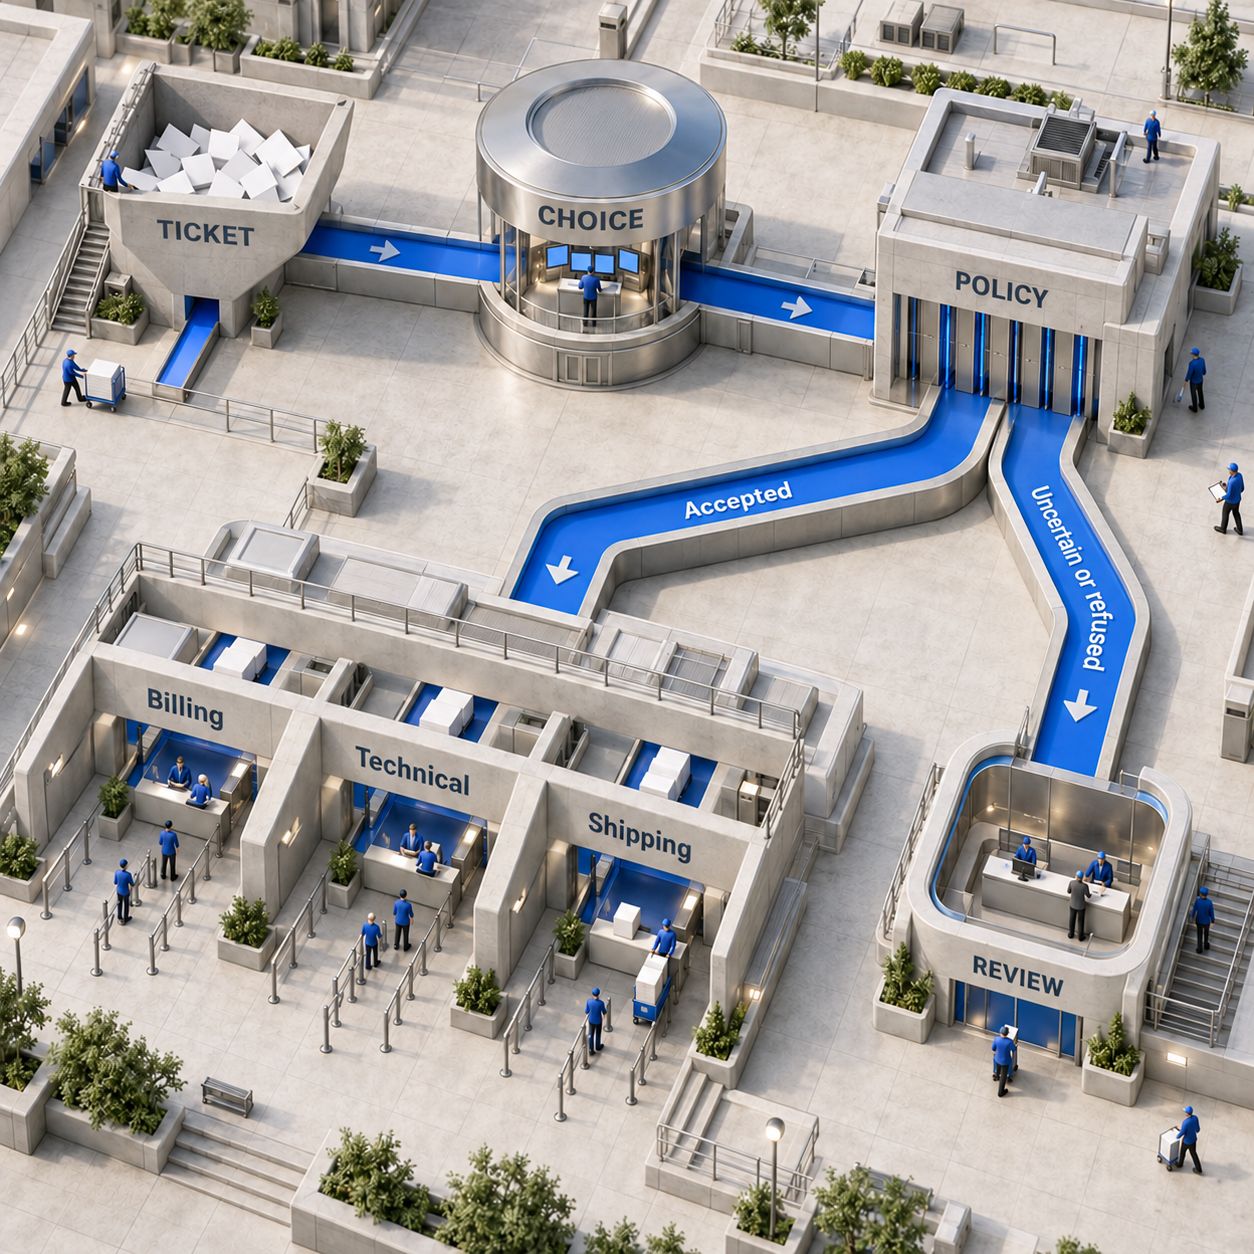
Маршрутизация заявок: от выбора категории к работе поддержки
Первую версию стройте вокруг назначения очереди. Команда поддержки может передавать тему обращения и относящееся к делу сообщение клиента, получать выбранный отдел, а затем применять правила маршрутизации обычным кодом приложения.
Возьмите определения очередей из руководства за основу и адаптируйте их к реальным зонам ответственности вашей команды. Сохраните вариант other для обращений, которые не относятся ни к одному из перечисленных отделов. Запрос на возврат денег относится к отделу расчётов, но сам по себе не даёт разрешения на возврат.
Этот небольшой адаптер показывает, как применить правила после разбора успешного JSON-ответа и выбора ответа department. В thresholds должны быть пороги, которые вы определили по размеченным обращениям. Если порога нет, заявка остаётся на ручной проверке.
QUEUES = {
    "billing": "billing",
    "technical": "technical",
    "shipping": "shipping",
}

def queue_for(answer, thresholds):
    if answer.get("type") == "refusal":
        return "manual_review"
    if answer.get("type") != "choice":
        return "manual_review"
    department = answer.get("choice")
    if department not in QUEUES:  # Includes the guide's "other" choice.
        return "manual_review"
    cutoff = thresholds.get(department)
    confidence = answer.get("confidence")
    if cutoff is None or confidence is None or confidence < cutoff:
        return "manual_review"
    return QUEUES[department]
В предлагаемой схеме ошибки API, тайм-ауты и отсутствие ответа также оставляют обращения на ручной проверке. Сохраняйте версию вопроса, предложенную очередь, уверенность, итоговую очередь и все исправления сотрудников. Обновление очереди должно допускать безопасный повтор: повторная попытка запроса не должна создавать дублирующие назначения.
Независимые вопросы об одном обращении можно объединить в один запрос. Если смысл следующего вопроса зависит от предыдущего ответа, его нужно отправить отдельным последующим запросом. Рекомендации для нескольких вопросов
Как подобрать пороги на размеченных данных
Выбирайте пороги по результатам замеров с учётом того, какие ошибки допустимы для вашего бизнеса. В руководстве OpenAI нет числовых данных о калибровке: разработчикам предлагают использовать размеченные данные своего приложения. Значение уверенности не гарантирует, что именно такая доля ответов на ваших обращениях окажется верной. Как интерпретировать ответы
Начните с прошлых обращений, для которых руководитель поддержки проверил правильную очередь. Включите короткие запросы, обращения сразу по нескольким вопросам, случаи с недостаточным контекстом и жалобы с инструкциями, адресованными модели. Примеры для настройки вопросов и порогов отделите от отложенной выборки для итогового сравнения.
Измеряйте число ошибочных назначений, долю обращений на ручной проверке и время сотрудников на исправления. Каждую очередь проверяйте отдельно. Если обращение по доставке попадёт в отдел расчётов, последствия могут отличаться от последствий пропущенного сообщения о взломе аккаунта.
Сначала запустите новый вариант параллельно с действующим классификатором, не меняя назначения в рабочей системе. Включайте его только после того, как результаты удовлетворят письменно зафиксированным критериям приёмки. Сохраните прежнюю схему для отката. Это предлагаемый порядок внедрения, а не результаты тестирования API.
Шесть задач, с которых стоит начать
Для первых внедрений лучше подходят задачи со стабильными категориями, заметными ошибками и сотрудником, который уже отвечает за нестандартные случаи. Ниже — приоритеты с точки зрения внедрения, а не рейтинг точности.
Для разметки заранее определите, может ли одна запись относиться к нескольким темам. Один вопрос с выбором даёт одну категорию; для пересекающихся меток могут подойти отдельные вопросы. Серьёзность инцидентов описывайте через последствия для работы: потерю функциональности и наличие обходных решений. Слова вроде «серьёзный» оставляют модели слишком большой простор для интерпретации.
Цены Decisions API: что меняется в расходах
В руководстве указана цена $0.10 за 1M входных токенов для gpt-6-luna. Платы за выходные токены, чтение из кэша и запись в кэш нет. Возможны надбавки за обработку в определённом регионе и повышающие коэффициенты для входных токенов при длинном контексте. Это тарифы Decisions; не переносите эти правила расчёта на обычные вызовы той же модели. Цены Decisions
Рассмотрим расчётный пример для серии запросов. Это не замер реального использования и не фиксированная цена одного решения. Допустим, мы выполняем 100,000 вызовов классификации, каждый с 1,000 некэшированных входных токенов, включая инструкции и варианты ответа. Для существующего вызова Responses также предположим 50 оплачиваемых выходных токенов на вызов. Используем стандартные базовые тарифы для короткого контекста, без записи в кэш, региональных надбавок, повторных попыток и других начислений.
Тарифы обычных вызовов модели взяты из таблицы стандартных цен OpenAI. В этом примере отсутствие платы за выходные токены экономит $2.50 на всей серии запросов. Одного этого мало, чтобы оправдать переделку работающей интеграции.
Более весомый аргумент — изменения в работе: меньше ожидания в последовательном процессе, меньше кода для обработки ответов или меньше ручной сортировки при той же частоте ошибок. Сравнивайте с реальными счетами и нагрузкой на проверяющих. Если текущая модель дороже или генерирует более длинные ответы, расчёт изменится; существующие скидки за кэширование тоже влияют на итог. Время разработчиков и ошибочно направленные обращения по-прежнему нужно учитывать в бюджете перехода.
Две идеи для продукта
Первый выбор: маршрутизатор обращений с проверкой и историей исправлений
Руководитель операционной работы поддержки может платить за коннектор, который предлагает очередь из фиксированного списка, оставляет сомнительные случаи на проверке и превращает исправления сотрудников в данные для оценки качества. Полезный продукт здесь — весь процесс маршрутизации вместе с его поддержкой.
По оценке DataForSEO, запрос «ticket triage» ищут в Google в США 170 раз в месяц; данные проверены 11 октября 2026 года. Это сигнал узкого информационного спроса, а не число покупателей. Действующие системы поддержки тоже решают эту задачу: Zendesk предлагает классификацию intelligent triage, а для её использования в рабочих процессах требуется дополнение Copilot. Руководство Zendesk по классификации обращений
Минимальная полезная версия могла бы работать с одной системой поддержки: загружать историю обращений, показывать предлагаемые назначения до их применения и предоставлять очередь ручной проверки с возможностью исправить решение. Самым убедительным аргументом для продажи стало бы сокращение лишних передач между отделами у конкретного клиента. Сложность в том, что существующая система уже может всё это делать: если она хорошо распределяет обращения, ещё один маршрутизатор лишь добавит работы по сопровождению. Стоит решать конкретную проблему разграничения ответственности или передачи обращений между системами.
Второй выбор: рабочее место для проверки разметки по заданным категориям
Исследовательская команда или команда по работе с данными может платить за инструмент, который предлагает метки, собирает исправления и показывает категории с постоянными разногласиями. В ходе той же проверки DataForSEO оценил частотность запроса «automated data labeling» в Google в США в 90 поисков в месяц. Это говорит об интересе к задаче, но не доказывает готовность платить за такую реализацию.
Первая версия могла бы принимать CSV, применять набор меток с учётом его версии, показывать сомнительные строки на проверку и экспортировать исправленные результаты. Сохраняйте отложенную выборку для оценки, чтобы честно сравнивать результаты при изменении меток. Проблема в том, что модель может дёшево воспроизводить путаную систему категорий. Продукту нужны хорошие инструменты проверки и управления категориями; оболочку над вызовом API легко скопировать.
Маршрутизатор обращений — более убедительный выбор для первого продукта. Распределение ответственности между очередями даёт заметную ошибку, сотрудника, который может её исправить, и регулярный процесс, на котором можно показать пользу. Прежде чем строить универсальную платформу принятия решений, поговорите с этим сотрудником.
Когда лучше сохранить текущий подход
Оставьте Responses API, если вам нужно извлекать поля в собственную JSON-схему, получать текстовое объяснение или инициированный моделью вызов инструмента с аргументами. Decisions предназначен для более узкого набора типов ответа, описанных выше. Рекомендации OpenAI по выбору интерфейса
Сохраните детерминированные правила там, где ответ уже содержится в поле аккаунта или явно задан в политике. Модель мало что добавит к правилу «клиентов из этого региона направлять этой команде». Для действий с существенными последствиями сохраните одобрение человеком и проверку полномочий в приложении. Решение о маршрутизации может помочь в процессе возврата денег, но не устанавливает ни право клиента на возврат, ни полномочия сотрудника.
Прежде чем планировать переход, проверьте ограничения интеграции:
- Изображения: руководство допускает только встроенные data URL с base64, то есть байты изображения должны быть закодированы внутри запроса. Ссылки HTTP или HTTPS на размещённые изображения и
file_id— идентификатор ранее загруженного файла — согласно руководству не поддерживаются. Требования к изображениям на входе - Управление данными: в руководстве заявлена поддержка Zero Data Retention, или ZDR, а также использования в соответствии с HIPAA для клиентов, отвечающих условиям. Хранение данных в выбранном регионе и региональная обработка поддерживаются в США и Европе, а именно в ЕЭЗ + Швейцарии. Действуют требования к клиентам, соглашениям и настройке, а также ограничения; эти возможности не включены автоматически для всех аккаунтов. Доступность Decisions, Управление данными в OpenAI
- Зрелость релиза: открытая бета-версия — повод сохранить возможность отката. Если действующий классификатор достигает целевых показателей, а замена не даёт измеримой пользы, оставьте его.
Альтернативы: Jev, Clef и Microsoft-Decision-1
Прежде чем менять провайдера, сравните кандидатов на одних и тех же размеченных данных. Jev от TypeSafe принимает состояние и типизированные вопросы через System One API. Cloudflare Clef предлагает типизированные решения в Workers AI. Microsoft-Decision-1 доступна в Microsoft Foundry для задач, включая классификацию, маршрутизацию и приоритизацию. Быстрый старт TypeSafe, документация Cloudflare Clef, анонс Microsoft
При отборе учитывайте существующие интеграции, требования к размещению, результаты оценки и обработку исключений. Наше руководство по маршрутизации обращений с Jev разбирает схему распределения, а статья «Бесплатен ли Jev Router?» объясняет разницу между программой-маршрутизатором и облачным инференсом. Формат запросов и поведение показателей уверенности у каждого провайдера нужно рассматривать отдельно.
Стоит ли заменять текущий вызов классификации на Decisions?
Попробуйте его, если на выходе нужна категория из фиксированного списка, оценка вероятности условия или оценка по заданной шкале. На одних и тех же размеченных примерах сравните ошибки маршрутизации, нагрузку на ручную проверку, стоимость и время выполнения. Если улучшения не оправдывают переход, сохраните текущий вызов.
Что должно делать приложение, если API отказался отвечать?
Проверяйте тип ответа до чтения его значения. В маршрутизаторе поддержки отправляйте такие обращения на ручную проверку и сохраняйте достаточно контекста для сотрудников. Отказ не даёт разрешения выполнить действие по умолчанию.
Какой порог уверенности выбрать?
Подберите его на размеченных данных своего рабочего процесса. Для каждого возможного порога измерьте ошибки и объём ручной проверки, желательно отдельно по очередям. Универсального порога в этой статье нет, как нет и таблицы калибровки в руководстве OpenAI.
Можно ли передать ссылку на изображение или ID загруженного файла?
Используйте встроенный data URL с base64, как описано в руководстве. Для этого эндпоинта оно прямо исключает ссылки на размещённые изображения и входные данные file_id. Запрос с предикатом выше показывает поддерживаемый формат из руководства.
С чего начать в понедельник
Выберите вызов классификации, который распределяет обращения по устоявшемуся набору очередей. Пусть ответственный за этот процесс проверит репрезентативную размеченную выборку, зафиксирует допустимую частоту ошибок и долю ручной проверки, а затем сравнит Decisions с текущим вызовом параллельно, не меняя назначений. Переходите только тогда, когда результаты подтвердят пользу для рабочего процесса.
Если вам нужен процесс маршрутизации на базе ваших текущих инструментов, мы разрабатываем ИИ-системы для промышленной эксплуатации.
- Опубликовано
- Категория
- Build
- Язык

Аналоги Jev в 2026 году: что выбрать для API и локального запуска
Сравниваем аналоги Jev: Perplexity, OpenAI, Microsoft, Clef, Liquid d1 и Strands. Цены в USD, лицензии, ограничения API и выбор модели для локального запуска.11 окт. 2026 г.Build
Claude Code Remote Control: настройка доступа с телефона
Как настроить Claude Code Remote Control в терминале, VS Code и Desktop, подключиться с телефона или из браузера и устранить ошибки входа и соединения.9 окт. 2026 г.Build
Cursor на iPhone: настройка и управление локальными агентами
Как настроить Cursor на iPhone, подключить ноутбук и управлять локальными агентами. Условия работы, тарифы и отличия от Cloud Agents, Claude Code и Codex.9 окт. 2026 г.Build
Тарифы Firecrawl: сколько стоит сбор данных в 2026 году
Тарифы Firecrawl за октябрь 2026: кредиты, доплаты и расчёты для JSON, обычных страниц и еженедельного обхода. Сравните планы и расходы на сбор данных.9 окт. 2026 г.Build
Claude Code или GitHub Copilot: что выбрать в 2026 году
Сравниваем Claude Code и GitHub Copilot: цены, лимиты, модели и управление командой. Что выбрать для редактора и терминала и сколько стоит использовать оба.8 окт. 2026 г.Build
LangGraph vs CrewAI: как выбрать фреймворк ИИ-агентов
Сравнение LangGraph и CrewAI на одном процессе согласования: состояние, память, MCP, трассировка и цены облачных платформ. Что выбрать для ИИ-агентов.7 окт. 2026 г.Build
MCP-сервер на Python: от первого инструмента до HTTP
Создайте MCP-сервер на Python для проверки заказов: протестируйте его в Inspector, подключите Claude Code и Cursor, добавьте авторизацию и разместите в облаке.7 окт. 2026 г.Build