OpenAI Decisions APIの使い方:問い合わせの自動振り分けと料金
OpenAI Decisions APIの使い方を、問い合わせチケットの自動振り分けを軸に解説します。三つのリクエスト例、回答拒否への対応、信頼度のしきい値、料金と制約を整理。既存のLLM呼び出しやルール処理を残すべき場面も含め、移行の手間に見合うかを実データで判断するための手順を紹介します。
公開日
 著者 Omid Saffari




OpenAI Decisions APIは、問い合わせチケットの振り分け、レコードへのラベル付け、エージェントが提案したアクションの評価を、コードでそのまま扱える回答として返すAPIです。今使っているLLMへの呼び出しがカテゴリや評価値を返すためだけのものであれば、試す価値があります。ただし、置き換えるのは、現在と同等の振り分け品質を確保でき、移行の手間に見合うだけ業務を改善できると確認してからです。
OpenAI Decisions APIで何を判断させるかを先に決める
Decisionsは、行き先があらかじめ決まっている振り分け係だと考えるとわかりやすくなります。判断材料と質問を渡し、回答を受け取った後の処理はアプリケーション側で決めます。
2026年10月11日時点で、このAPIはパブリックベータです。一般提供は**「今後数週間以内」とされていますが、これはOpenAIの見通しであり、リリース日の確約ではありません。対応モデルはgpt-6-lunaのみで、エンドポイントはPOST /v1/decisionsです。OpenAIは「Responses APIより約10倍高速」**と説明しています。これはOpenAIによる主張であり、自分のアプリケーションで測定した結果とは区別してください。OpenAIのDecisionsガイド
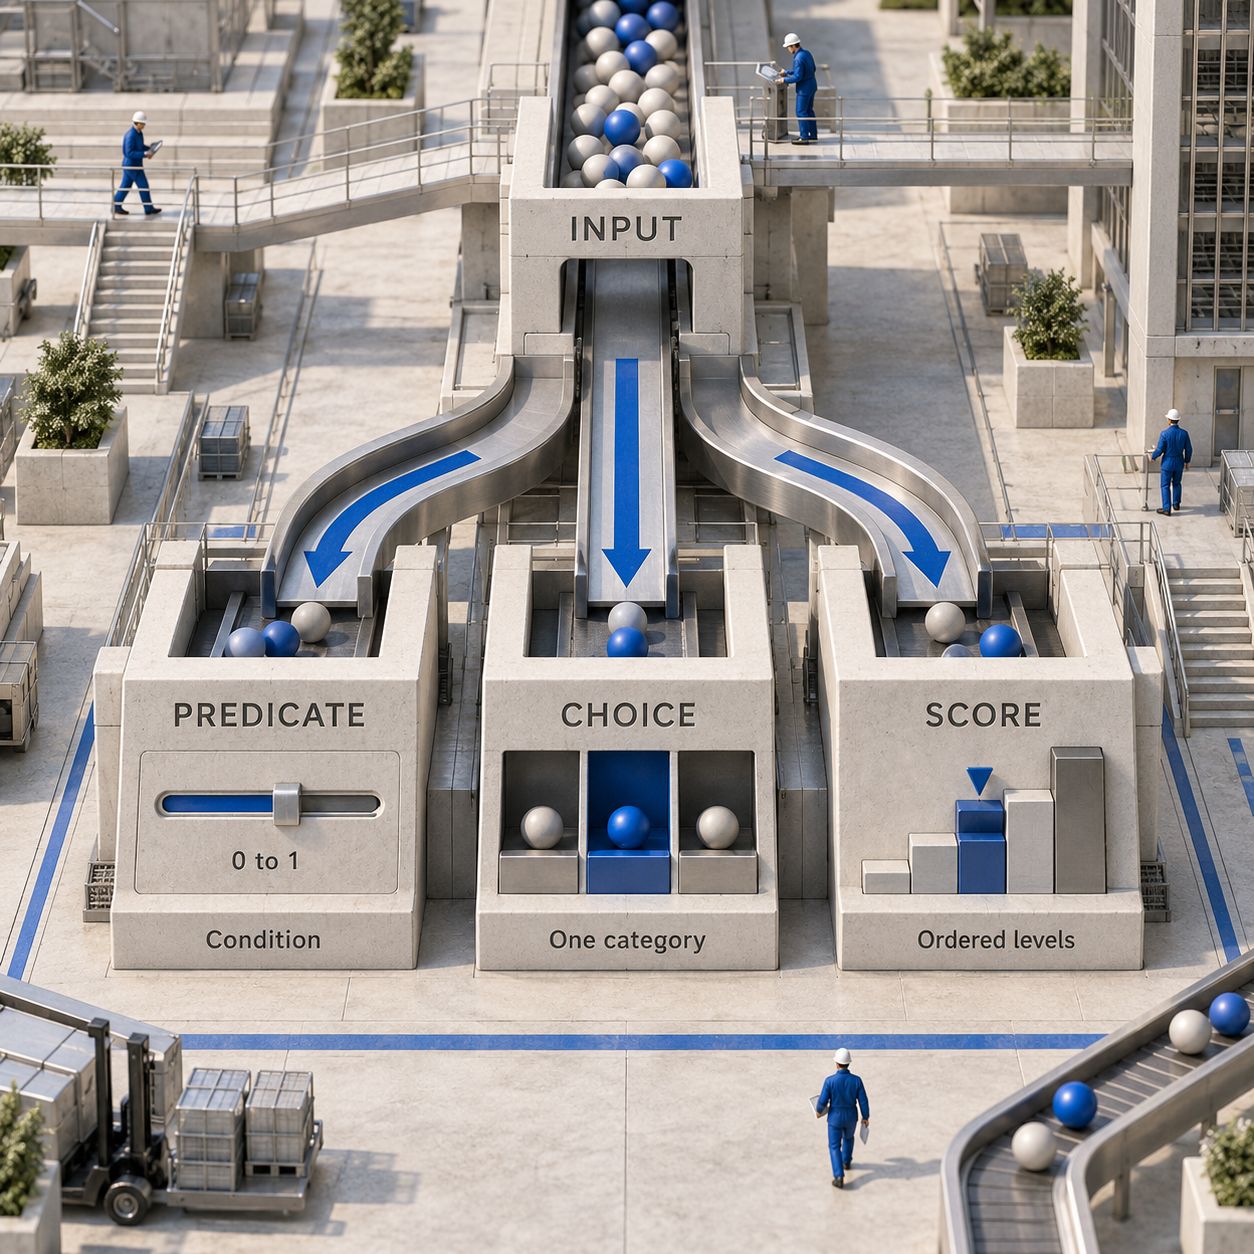
プロンプトを書く前に、必要な回答の型を選びます。
スコアの各レベルのインデックスは0から始まります。結果はレベル間の値になることもあります。各レベルにまたがる不確実性を集約して表すためです。コード側でカテゴリを一つに確定する必要がある場合は、choiceを使います。質問の型
三つのリクエスト例を使ってみる
以下は、ガイドに掲載された三つのcURLリクエスト例です。書式を統一し、各例を区別するコメントを加えています。シェルの環境変数にOPENAI_API_KEYを設定してください。predicateの例には、ローカルのproduct.pngも必要です。各コマンドは個別にリクエストを送信します。これらの例は公開ガイドと照合したもので、認証済みアカウントでの実行確認はしていません。元のリクエスト例
共通する要素は、判断材料を渡すinputと、それに対して行う判断を指定するquestionsです。質問のnameは、返されるanswers配列の中で回答を識別するために使います。リクエストとレスポンスのリファレンス
# Predicate: inspect product.png for visible damage
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"

curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @- <<JSON
{
  "model": "gpt-6-luna",
  "input": [{
    "role": "user",
    "content": [
      {"type": "input_text", "text": "Inspect the product in this photo."},
      {"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
    ]
  }],
  "questions": [{
    "type": "predicate",
    "name": "visible_damage",
    "instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
  }]
}
JSON

# Choice: route a customer complaint
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice",
      "name": "department",
      "instructions": "Which department should handle this complaint?",
      "choices": [
        {"value": "billing", "description": "Payments, invoices, and refunds."},
        {"value": "technical", "description": "Problems using the product."},
        {"value": "shipping", "description": "Delivery and tracking."},
        {"value": "other", "description": "Requests outside these categories."}
      ]
    }]
  }'

# Score: assess issue severity
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Export fails in Safari but works in Chrome.",
    "questions": [{
      "type": "score",
      "name": "severity",
      "instructions": "How severe is this issue?",
      "levels": [
        {"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
        {"label": "Workaround available", "description": "A task fails, but another way works."},
        {"label": "Fully blocked", "description": "A task fails with no workaround."}
      ]
    }]
  }'
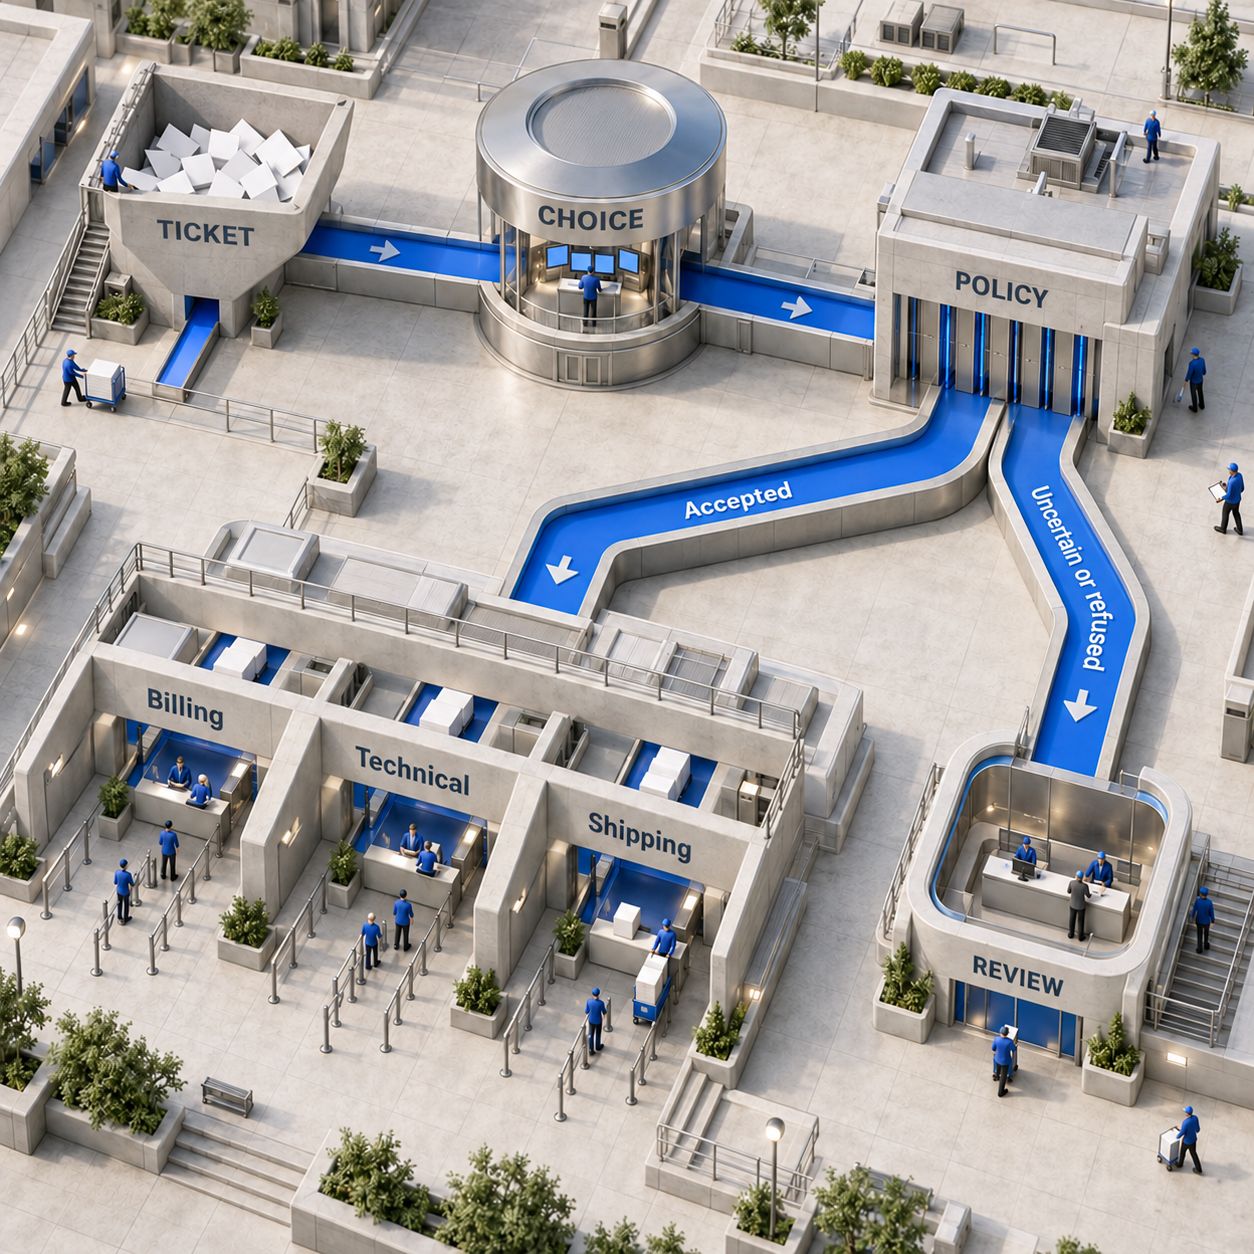
choiceの例は、そのまま業務への導入を考える出発点になります。二重請求の苦情を、決められた担当キューのいずれかに振り分ける処理です。一方、scoreの例が問うのは、別のブラウザなら動作する不具合が、業務をどれだけ妨げるかです。担当キューと重大度は分けて扱いましょう。そうすれば、請求に関する問題を技術担当のチケットに変えてしまうことなく、緊急の問題として扱えます。
回答の値を読む前に、回答拒否を処理してください。 ガイドのSDK例では、probability、choice、scoreにアクセスする前にanswer.type == "refusal"を確認しています。回答拒否は独立した結果です。信頼度の低い回答でも、otherカテゴリでもありません。回答拒否の挙動
choiceで問い合わせの自動振り分けを実装する
最初の実装は、担当キューの割り当てに絞ります。たとえばサポートチームなら、チケットの件名と必要な顧客メッセージを送り、担当部門の選択結果を受け取り、通常のアプリケーションコードで振り分けルールを適用する流れです。
ガイドのキュー定義をたたき台にして、自社チームの実際の担当範囲に置き換えます。指定した部門では扱えない問い合わせのために、otherの選択肢は残してください。返金依頼の担当は請求部門でも、その振り分け結果が返金の実行を許可するわけではありません。
以下の小さなアダプターは、成功したJSONレスポンスを解析し、departmentの回答を選んだ後に適用するルールの例です。thresholdsには、ラベル付きチケットで検証して決めたしきい値を格納しておく必要があります。しきい値がない場合は、人による確認に回します。
QUEUES = {
    "billing": "billing",
    "technical": "technical",
    "shipping": "shipping",
}

def queue_for(answer, thresholds):
    if answer.get("type") == "refusal":
        return "manual_review"
    if answer.get("type") != "choice":
        return "manual_review"
    department = answer.get("choice")
    if department not in QUEUES:  # Includes the guide's "other" choice.
        return "manual_review"
    cutoff = thresholds.get(department)
    confidence = answer.get("confidence")
    if cutoff is None or confidence is None or confidence < cutoff:
        return "manual_review"
    return QUEUES[department]
このワークフロー案では、APIエラー、タイムアウト、回答の欠落も人による確認に回します。質問のバージョン、提案されたキュー、信頼度、最終的なキュー、担当者による修正を記録してください。また、リクエストを再試行しても割り当てが重複しないよう、キューの更新処理を再試行可能な設計にします。
同じチケットに対する独立した質問は、一つのリクエストにまとめられます。前の回答によって意味が変わる後続の質問は、別のリクエストで送ります。複数の質問を扱う際のガイド
しきい値はラベル付きの実データで決める
しきい値は、業務上どこまで誤りを許容できるかを測って決めます。OpenAIはガイドでキャリブレーションの数値を公開しておらず、実際の用途に即したラベル付きデータを使うよう案内しています。信頼度の値は、自社のチケットでもその割合で正解することを保証するものではありません。回答の解釈
まず、サポート責任者が正しい振り分け先を確認した過去のチケットを用意します。短い依頼、複数の問題を含むもの、文脈が不足しているもの、モデルに指示を与えようとする文面を含む苦情も入れてください。質問やしきい値の調整に使うデータと、最終比較のために取り分けておく評価用データは分離します。
誤ったキューへの割り当て、人による確認に回る割合、担当者が割り当ての修正に費やす時間を測定します。キューごとに確認してください。配送の問い合わせを請求部門に送る誤りと、アカウント侵害の報告を見落とす誤りでは、業務上の損失が異なる可能性があります。
まずは本番の割り当てを変えずに、候補となる仕組みを既存の分類器と並行して動かします。あらかじめ文書にした合格基準を満たしてから、本番に適用してください。切り戻せるよう、従来の経路も残します。ここで示したのは導入手順の提案であり、このAPIをテストして得た結果ではありません。
試す価値のある六つの用途と優先順位
最初に試す用途として適しているのは、カテゴリが安定していて、誤りを把握でき、例外対応の担当者がすでに決まっている業務です。以下の順位は実装の観点からの判断であり、精度のランキングではありません。
ラベル付けでは、一つのレコードに複数のテーマが付く可能性があるかを先に決めます。choiceはカテゴリを一つ選ぶためのものです。ラベルが重なる場合は、質問を分ける方法が適していることもあります。インシデントの重大度は、使えなくなった機能や利用可能な回避策など、業務上の具体的な影響で定義してください。「深刻」といった言葉だけでは、モデルの解釈に委ねる部分が大きすぎます。
料金の違いは実務にどれだけ効くのか
ガイドに記載されたgpt-6-lunaの料金は、入力1Mトークンあたり$0.10です。出力、キャッシュの読み取り、キャッシュの書き込みには課金されません。リージョン別処理の追加料金や、長いコンテキストに対する入力料金の倍率が適用される場合があります。 これはDecisionsの料金体系です。同じモデルを使う通常の呼び出しに、この課金ルールを当てはめないでください。Decisionsの料金
以下は、まとめて処理した場合の計算例です。実測値でも、判断一件あたりの固定料金でもありません。分類の呼び出しを100,000回行い、各回で指示や選択肢を含むキャッシュなしの入力を1,000トークン使うと仮定します。既存のResponses呼び出しについては、課金対象となる出力トークンの合計を一回あたり50と仮定します。標準の短いコンテキスト向け基本料金で計算し、キャッシュへの書き込み、リージョンの追加料金、再試行、その他の費用は含めません。
通常のモデル料金は、OpenAIの標準料金表を参照しています。この例では、出力への課金がなくなることで節約できるのは処理全体で$2.50です。それだけでは、動いている連携処理を書き直す理由としては弱いでしょう。
導入を後押しするのは、むしろ運用面の改善です。たとえば、順番に進むワークフローの待ち時間が減る、レスポンスを処理するコードが減る、同じ誤り率で手動の仕分けが減る、といった効果です。実際の請求額と確認作業の負担に照らして比較してください。現在使っているモデルの料金が高い場合や、生成される回答が長い場合は、計算結果も変わります。既存のキャッシュ割引も影響します。開発工数と誤った振り分けへの対応コストも、移行予算に含める必要があります。
開発するなら、この二つ
第一候補:確認と手動修正の履歴を残せるサポート振り分けツール
サポート運用の責任者なら、決められたキューを提案し、不確実なケースを保留し、担当者の修正を評価データに変えられるコネクターに対価を払う可能性があります。価値を持つのは、保守も含めた振り分けワークフロー全体です。
2026年10月11日の確認時点で、DataForSEOは**「ticket triage」の米国Google検索数を月間170件**と推定しています。これは限定的な情報収集需要を示すもので、購入者数ではありません。既存のヘルプデスク製品もこの業務に対応しています。Zendeskはintelligent triageによる分類機能を提供しており、ワークフローでその分類を使うにはCopilotアドオンが必要です。Zendeskのトリアージガイド
最小限でも実用になる構成としては、一つのヘルプデスクに対応し、過去のチケットを取り込み、割り当て先をプレビューし、手動で修正できる確認用受信トレイを用意する形が考えられます。営業で最も説得力を持つのは、顧客が不要な引き継ぎをどれだけ減らせたかという実績です。難点は、既存製品ですでに対応できる場合があることです。ヘルプデスクが適切に振り分けているなら、別のツールを追加しても保守負担が増えます。特定の担当範囲の問題や、システムをまたぐ引き継ぎに絞って価値を出してください。
第二候補:定義済みラベルを確認・修正する作業ツール
リサーチチームやデータチームなら、ラベルを提案し、修正を集め、どのカテゴリで判断の食い違いが続いているかを示す作業ツールに対価を払う可能性があります。同じ確認時点で、DataForSEOは**「automated data labeling」の米国Google検索数を月間90件**と推定しています。これは業務への関心を示すもので、この実装への支払い意欲が実証されたわけではありません。
初期版では、CSVを読み込み、バージョン管理されたラベルセットを適用し、不確実な行を確認対象として提示し、修正後の結果を書き出す構成が考えられます。ラベルの変更を公平に比較できるよう、調整には使わない評価用データを確保してください。難しいのは、分類体系が曖昧なままでも、モデルはそれを低コストで再現できてしまうことです。製品には、使いやすい確認機能とカテゴリ管理機能が必要です。API呼び出しを包むだけの仕組みは簡単に模倣されます。
最初に開発するなら、サポートの振り分けツールが有力です。 キューの担当範囲が決まっていれば、誤りを目で確認でき、それを修正できる運用担当者もいます。繰り返し発生する業務の中で価値を示せる点も強みです。汎用的な意思決定プラットフォームを作る前に、まずその担当者に話を聞いてください。
既存の方法を使い続けたほうがよい場面
独自のJSONスキーマに沿ったフィールド抽出、文章による説明、引数付きのツール呼び出しをモデルに求める場合は、Responses APIを使い続けてください。Decisionsが扱うのは、ここまでに紹介した、より限定的な回答の型です。インターフェースの選び方に関するOpenAIのガイド
アカウントのフィールドや明文化されたルールですでに答えが決まる場合は、結果が一意に決まるルール処理を維持します。「この地域の顧客はこのチームに振り分ける」という処理に、モデルを加える価値はほとんどありません。重要な結果を伴うアクションでは、人による承認とアプリケーションの権限チェックを残してください。振り分けの判断は返金ワークフローの参考にはなりますが、顧客に返金を受ける権利があるか、担当者に実行権限があるかを確定するものではありません。
移行の予定を組む前に、次の制約を確認してください。
- 画像: ガイドで認められているのは、インラインのbase64データURLだけです。画像のバイト列をエンコードして、リクエスト内に含める形式を指します。ガイドの記載では、HTTPまたはHTTPSでホストされた画像URLと、アップロード済みファイルを参照する
file_idはサポートされていません。画像入力の要件 - データ管理: ガイドには、Zero Data Retention(ZDR)と、適格な顧客によるHIPAA対象用途への対応が記載されています。データレジデンシーとリージョン内処理は、米国と欧州、具体的にはEEA + スイスでサポートされています。適格性、契約、設定、各種制限の条件があり、アカウントの初期設定で自動的に適用されるわけではありません。Decisionsの提供範囲、OpenAIのデータ管理
- 提供段階: パブリックベータである以上、切り戻しの経路を確保しておくべきです。既存の分類器が目標を満たしていて、変更による効果を測定できないなら、そのまま使い続けてください。
代替候補のJev、Clef、Microsoft-Decision-1と比較する
プロバイダーを切り替える前に、同じラベル付きデータと処理内容で候補を比較してください。TypeSafeのJevは、System One APIを通じて状態と型付きの質問を受け取ります。Cloudflare Clefは、Workers AIで型付きの判断結果を提供します。Microsoft-Decision-1はMicrosoft Foundryで利用でき、分類、振り分け、優先順位付けなどの用途に対応しています。TypeSafeクイックスタート、Cloudflare Clefのドキュメント、Microsoftの発表
候補の絞り込みでは、既存の連携、ホスティングの要件、評価結果、例外処理を重視します。Jevによる問い合わせチケット振り分けガイドでは振り分けの実装パターンを、Jev Routerは無料で使えるのかではルーターソフトウェアとホスト型の推論サービスの違いを解説しています。リクエスト形式と信頼度の挙動は、プロバイダーごとに個別に確認してください。
今使っている分類処理をDecisionsに置き換えるべきですか?
出力が決められたカテゴリ、条件が成立する確率、評価基準に沿ったスコアのいずれかであれば、試す価値があります。同じラベル付きデータで、振り分けの誤り、人による確認の負担、費用、処理時間を比較してください。改善が移行の手間に見合わなければ、現在の処理を維持します。
回答が拒否された場合、アプリケーションはどう処理すべきですか?
値を読む前に、回答の型を確認してください。サポートの振り分け処理では、回答拒否を人による確認に回し、担当者が対応できるだけの文脈を残します。回答拒否を、既定のアクションを選んでよいという許可として扱わないでください。
信頼度のしきい値はいくつに設定すればよいですか?
自社のワークフローから得たラベル付きデータで決めます。候補となるしきい値ごとに、誤りと確認件数を測定してください。できればキュー別に確認します。本記事では万能のしきい値を提示しておらず、OpenAIのガイドにもキャリブレーション表はありません。
ホストされた画像URLやアップロード済みファイルのIDを渡せますか?
ガイドにあるインラインのbase64データURL形式に従ってください。このエンドポイントでは、ホストされた画像URLとfile_idの入力が明示的に除外されています。上のpredicateリクエストが、ガイドでサポートされている形式の例です。
まず取り組むこと
決められた担当キューにチケットを送る分類処理を一つ選びます。その担当者に、実際の問い合わせ傾向を反映したラベル付きサンプルを確認してもらい、許容できる誤り率と確認に回す割合を明文化してください。そのうえで、本番の割り当てを変えずに、Decisionsを現在の処理と並行して比較します。ワークフローに採用するだけの価値を確認できてから切り替えましょう。
既存のツールに合わせた振り分けワークフローの構築をご希望なら、本番運用向けAIシステムの開発をお任せください。
- 公開日
- カテゴリー
- Build
- 言語

decision model比較2026:Jevの代替7選を料金と導入条件で選ぶ
Jevの代替となるdecision modelを、料金・入力形式・ライセンス・実行環境で比較。Perplexity、Cloudflare Clef、Microsoft、OpenAI、Liquid d1、Strandsの向き不向きを整理し、月額費用の試算と移行時の確認点から、自社の判断業務に合う候補を選べます。2026年10月11日Build
Claude Code Remote Controlの使い方:スマホ接続とエラー対処
Claude Code Remote Controlで、パソコンの作業をスマホやブラウザから続ける方法を解説します。CLI・VS Code・Desktopの設定、対応プラン、通知、ログインや接続エラーの対処まで整理。ローカルで実行される処理と、Anthropicに保存されるセッション記録の違いも確認できます。2026年10月9日Build
Cursorのスマホ操作ガイド:iPhoneでRemote Controlを設定する
Cursorをスマホから操作したい開発者向けに、iPhoneとPCのペアリング手順、スリープを防ぐ設定、Enterpriseの利用条件を解説します。ローカルとクラウドの実行環境、料金の考え方、Claude CodeやCodexとの違いも整理し、離席中の進捗確認や短い指示に役立つ活用例を紹介します。2026年10月9日Build
Firecrawl 料金ガイド2026:プラン別の実費とクレジットの計算方法
Firecrawlの料金プランを、クレジット消費と実際の処理量から比較します。通常ページの取得、JSON抽出、毎週のクロールはいくらかかるのか。月払い・年払い、追加クレジット、失敗ページの課金、無料枠、セルフホストや代替サービスまで整理し、パイプラインに合うプランと支出上限の決め方を解説します。2026年10月9日Build
Claude Code 料金比較:GitHub Copilotとの違いと2026年の選び方
Claude CodeとGitHub Copilotの料金・利用制限・対応モデルを比較。個人開発者と10人チームの費用、ターミナルとエディターでの使い勝手、チーム管理やデータの扱いまで整理します。追加利用料や上位プランへの切り替え、併用時の月額費用を押さえ、自分の開発環境に合う選び方を解説します。2026年10月8日Build
LangGraphとCrewAIを比較:承認フロー・状態管理・料金で選ぶ
LangGraphとCrewAIを、企業調査から営業メールの下書き、人による承認までの同じ業務で比較します。状態管理とメモリ、MCP連携、可観測性、ホスティング料金の違いをコード例と費用試算で解説。個人開発、スタートアップ、大企業それぞれの選び方と、本番運用で必要になる復旧・移行の判断材料が分かります。2026年10月7日Build
MCPサーバーをPythonで自作する:注文照会から認証・公開まで
PythonでMCPサーバーを自作し、読み取り専用の注文照会をMCP Inspectorで検証。Claude CodeとCursorへの接続から、OAuth認証付きHTTPサービスの構築、RenderやCloudflare Workersへの公開までを、コードと料金例で解説します。権限設計とログ管理も確認できます。2026年10月7日Build