KI-Klassifizierung mit der OpenAI Decisions API
Tickets zuweisen und Daten klassifizieren mit der OpenAI Decisions API: drei Anfragetypen, Preise, Grenzen und der Umgang mit verweigerten Antworten.
Veröffentlicht am
 Von Omid Saffari




Die OpenAI Decisions API liefert für die KI-Klassifizierung Antworten, die sich direkt im Code weiterverarbeiten lassen: Tickets zuweisen, Datensätze mit Labels versehen oder vorgeschlagene Agentenaktionen bewerten. Gibt ein bestehender LLM-Aufruf lediglich eine Kategorie oder Bewertung zurück, lohnt sich ein Test. Ein Wechsel ist aber erst sinnvoll, wenn die Qualität der Ticketzuweisung mindestens gleich bleibt und der Ablauf sich so weit verbessert, dass sich die Umstellung lohnt.
KI-Klassifizierung: Welche Antwort braucht der Code?
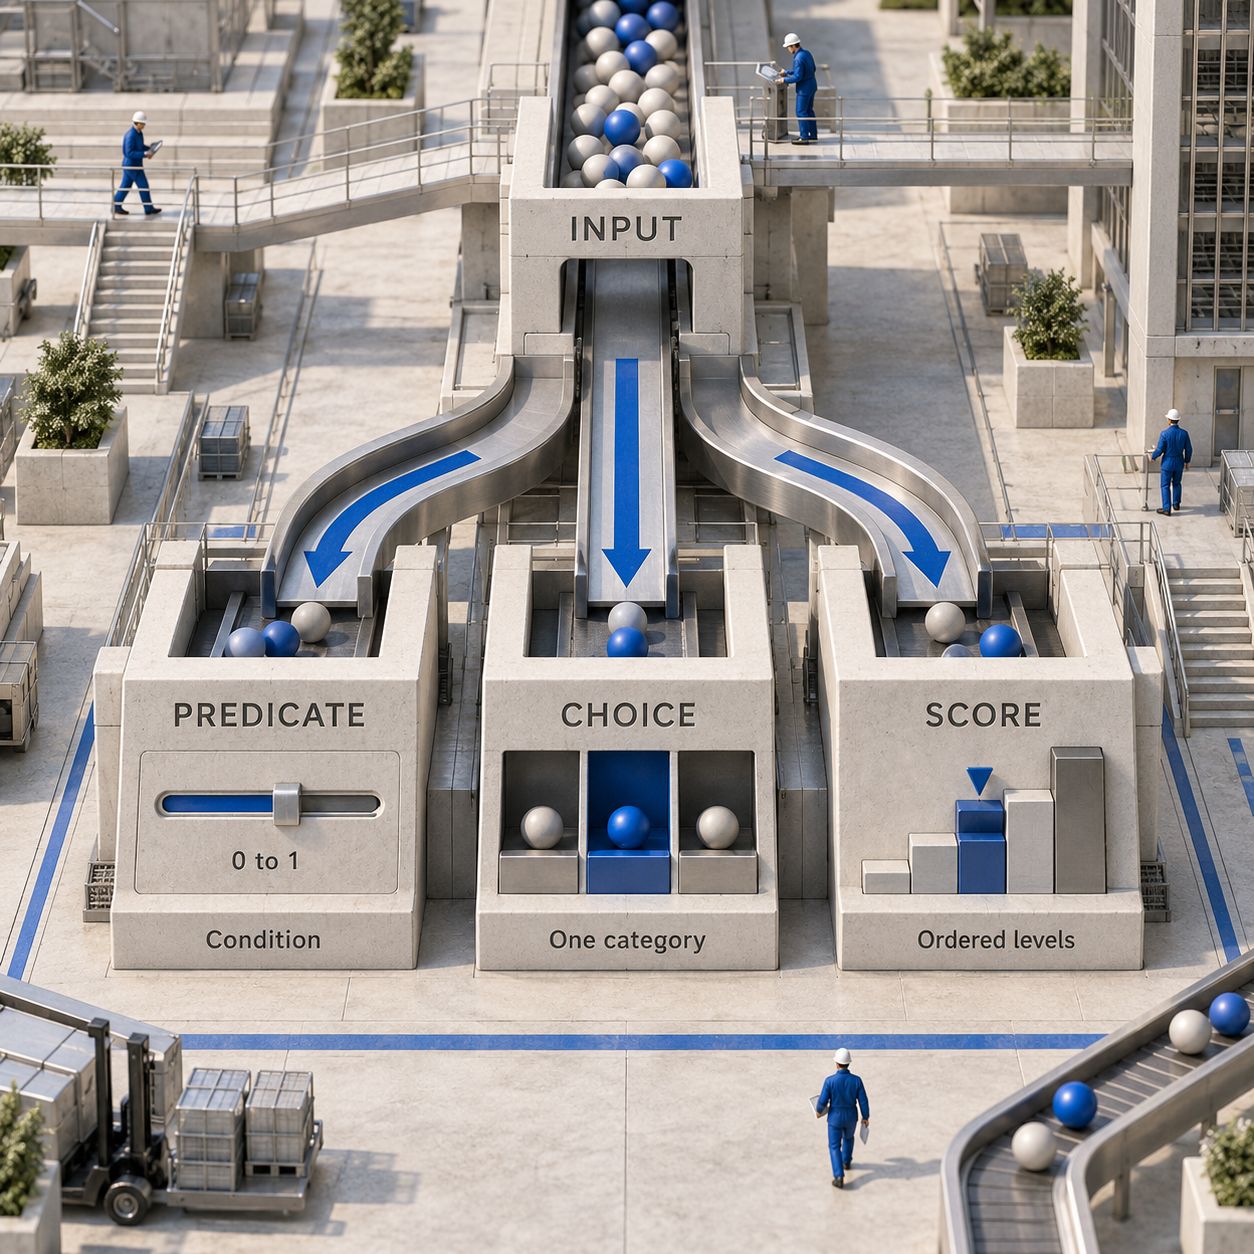
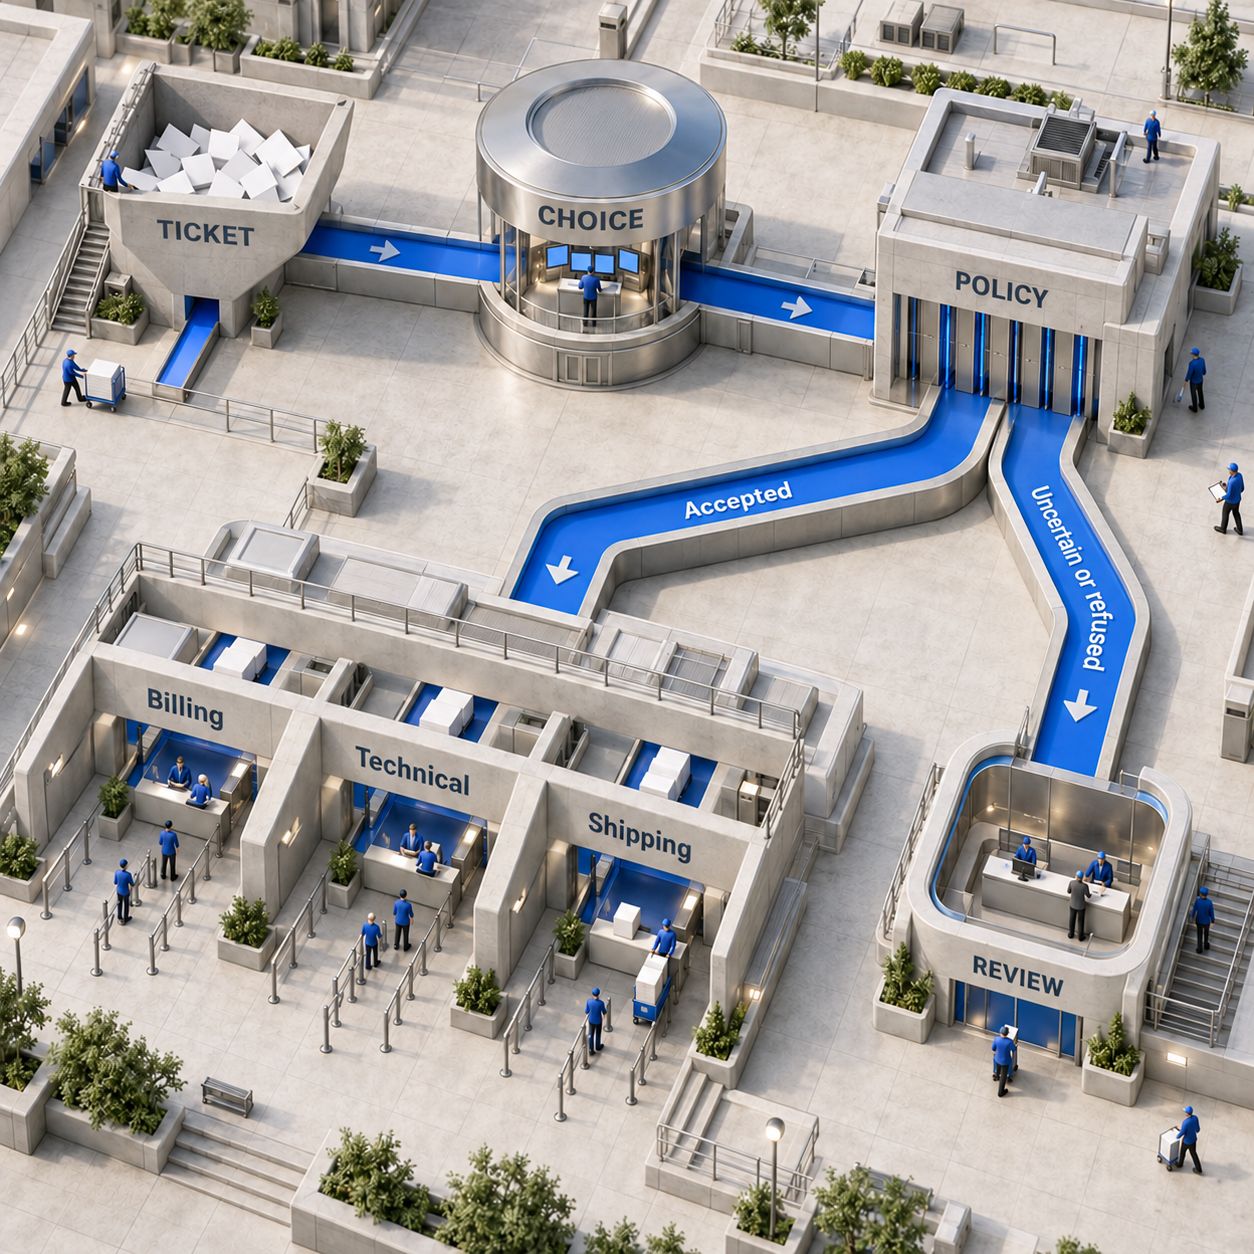
Decisions lässt sich als Verteilstelle mit festgelegten Zielen verstehen. Die Anfrage liefert die Informationen und die dazugehörige Frage. Was nach der Antwort geschieht, entscheidet die Anwendung.
Stand 11. Oktober 2026 befindet sich die API in der öffentlichen Beta. Die allgemeine Verfügbarkeit wird „in den kommenden Wochen“ erwartet. Das ist eine Erwartung von OpenAI, kein Veröffentlichungstermin. gpt-6-luna ist das einzige unterstützte Modell, der Endpunkt lautet POST /v1/decisions. OpenAI beschreibt die API als „etwa 10x schneller als die Responses API“. Das ist eine Herstellerangabe, kein Messergebnis für die eigene Anwendung. OpenAIs Leitfaden zur Decisions API
Vor dem Prompt steht die Wahl des Antwortformats:
Bei einem Score beginnen die Stufen mit Index 0. Das Ergebnis kann zwischen den Stufen liegen, weil es die Unsicherheit über mehrere Stufen zusammenfasst. Braucht der Code genau eine Kategorie, ist eine Choice-Frage der passende Typ. Fragetypen
Die drei Anfragetypen in der Praxis
Die folgenden drei cURL-Beispiele stammen aus dem Leitfaden. Ihre Formatierung wurde vereinheitlicht; ergänzte Kommentare trennen die Beispiele voneinander. In der Shell muss OPENAI_API_KEY gesetzt sein. Das Predicate-Beispiel benötigt außerdem eine lokale Datei namens product.png. Jeder Befehl stellt eine eigene Anfrage. Die Beispiele wurden mit dem öffentlichen Leitfaden abgeglichen, aber nicht mit einem angemeldeten Konto ausgeführt. Ursprüngliche Anfragebeispiele
Alle Anfragen enthalten input für die zugrunde liegenden Informationen und questions für die darauf bezogenen Entscheidungen. Über name lässt sich die Antwort auf eine Frage im zurückgegebenen Array answers zuordnen. Referenz zu Anfrage und Antwort
# Predicate: inspect product.png for visible damage
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"

curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @- <<JSON
{
  "model": "gpt-6-luna",
  "input": [{
    "role": "user",
    "content": [
      {"type": "input_text", "text": "Inspect the product in this photo."},
      {"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
    ]
  }],
  "questions": [{
    "type": "predicate",
    "name": "visible_damage",
    "instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
  }]
}
JSON

# Choice: route a customer complaint
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice",
      "name": "department",
      "instructions": "Which department should handle this complaint?",
      "choices": [
        {"value": "billing", "description": "Payments, invoices, and refunds."},
        {"value": "technical", "description": "Problems using the product."},
        {"value": "shipping", "description": "Delivery and tracking."},
        {"value": "other", "description": "Requests outside these categories."}
      ]
    }]
  }'

# Score: assess issue severity
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Export fails in Safari but works in Chrome.",
    "questions": [{
      "type": "score",
      "name": "severity",
      "instructions": "How severe is this issue?",
      "levels": [
        {"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
        {"label": "Workaround available", "description": "A task fails, but another way works."},
        {"label": "Fully blocked", "description": "A task fails with no workaround."}
      ]
    }]
  }'
Das Choice-Beispiel bietet bereits einen sinnvollen geschäftlichen Ausgangspunkt: Eine Beschwerde über eine doppelte Abbuchung muss einer der festgelegten Warteschlangen zugewiesen werden. Das Score-Beispiel beantwortet eine andere Frage: Wie stark beeinträchtigt ein Fehler die Nutzung, wenn ein anderer Browser weiterhin funktioniert? Zuständigkeit und Schweregrad sollten getrennt bleiben. So kann ein Abrechnungsproblem dringend sein, ohne dadurch zu einem technischen Ticket zu werden.
Zuerst eine verweigerte Antwort abfangen, dann den Wert auslesen. Die SDK-Beispiele im Leitfaden prüfen answer.type == "refusal", bevor sie auf probability, choice oder score zugreifen. Eine Verweigerung ist ein eigenständiges Ergebnis: weder eine Antwort mit geringer Konfidenz noch die Kategorie other. Verhalten bei verweigerten Antworten
Textklassifizierung für das Ticket-Routing im Support
Die erste Version sollte sich auf die Zuweisung zu Warteschlangen konzentrieren. Ein Supportteam könnte den Ticketbetreff und die relevante Kundennachricht übermitteln, eine Abteilung als Antwort erhalten und anschließend seine Zuweisungsregeln mit gewöhnlichem Anwendungscode durchsetzen.
Die Warteschlangendefinitionen aus dem Leitfaden dienen als Ausgangspunkt. An ihre Stelle gehören die tatsächlichen Zuständigkeiten des Teams. Für Anliegen, die keine der genannten Abteilungen abdeckt, bleibt die Option other bestehen. Ein Erstattungswunsch gehört zur Abrechnung; damit ist die Erstattung noch nicht genehmigt.
Der folgende kleine Anwendungsadapter veranschaulicht die Regeln, nachdem eine erfolgreiche JSON-Antwort eingelesen und die Antwort department ausgewählt wurde. In thresholds müssen Schwellenwerte stehen, die anhand bereits zugeordneter Tickets ermittelt wurden. Fehlt ein Schwellenwert, bleibt das Ticket zur manuellen Prüfung liegen.
QUEUES = {
    "billing": "billing",
    "technical": "technical",
    "shipping": "shipping",
}

def queue_for(answer, thresholds):
    if answer.get("type") == "refusal":
        return "manual_review"
    if answer.get("type") != "choice":
        return "manual_review"
    department = answer.get("choice")
    if department not in QUEUES:  # Includes the guide's "other" choice.
        return "manual_review"
    cutoff = thresholds.get(department)
    confidence = answer.get("confidence")
    if cutoff is None or confidence is None or confidence < cutoff:
        return "manual_review"
    return QUEUES[department]
In diesem vorgeschlagenen Ablauf führen auch API-Fehler, Zeitüberschreitungen und fehlende Antworten zur manuellen Prüfung. Protokolliert werden die Version der Frage, die vorgeschlagene Warteschlange, die Konfidenz, die endgültige Warteschlange und etwaige Korrekturen durch Mitarbeitende. Die Aktualisierung der Zuweisung muss sich gefahrlos wiederholen lassen, damit ein erneuter Aufruf keine doppelten Zuweisungen erzeugt.
Unabhängige Fragen zum selben Ticket lassen sich in einer Anfrage bündeln. Hängt die Bedeutung einer Folgefrage von einer früheren Antwort ab, gehört sie in eine spätere Anfrage. Hinweise zu mehreren Fragen
Schwellenwerte anhand zugeordneter Tickets festlegen
Entscheidend für die Schwellenwerte ist, welche Fehler das Unternehmen verkraften kann. OpenAI veröffentlicht im Leitfaden keine Kalibrierungswerte und verweist auf bereits klassifizierte Daten aus der jeweiligen Anwendung. Ein Konfidenzwert verspricht nicht, dass die Antwort bei den eigenen Tickets entsprechend häufig richtig liegt. Antworten einordnen
Als Ausgangspunkt eignen sich frühere Tickets, deren korrekte Zuständigkeit eine Supportleitung geprüft hat. Dazu gehören auch knappe Anfragen, gemischte Anliegen, Fälle mit fehlendem Kontext und Beschwerden mit Anweisungen an das Modell. Die Beispiele zur Abstimmung der Fragen und Schwellenwerte müssen von einem separaten Datensatz für den abschließenden Vergleich getrennt bleiben.
Gemessen werden Fehlzuweisungen, der Anteil der Tickets zur manuellen Prüfung und die Zeit, die Mitarbeitende für Korrekturen benötigen. Jede Warteschlange wird einzeln ausgewertet. Eine Verwechslung von Versand und Abrechnung kann andere betriebliche Folgen haben als eine übersehene Meldung über ein kompromittiertes Konto.
Zunächst läuft der Kandidat parallel zum bestehenden Klassifikator, ohne die tatsächlichen Zuweisungen zu verändern. Er wird erst übernommen, wenn die Ergebnisse ein schriftlich festgehaltenes Abnahmekriterium erfüllen. Der bisherige Weg bleibt für eine Rückkehr verfügbar. Das sind vorgeschlagene Einführungsschritte, keine Ergebnisse eines Tests dieser API.
Sechs Einsatzfelder nach ihrem Potenzial geordnet
Für den Einstieg eignen sich Aufgaben mit stabilen Kategorien, erkennbaren Fehlern und einer Person, die bereits für Ausnahmen zuständig ist. Die Reihenfolge beruht auf einer Einschätzung der Umsetzung, nicht auf einem Genauigkeitsvergleich.
Beim Labeling muss feststehen, ob ein Datensatz mehreren Themen zugeordnet werden darf. Eine einzelne Choice-Frage wählt genau eine Kategorie aus; für überlappende Labels können getrennte Fragen sinnvoll sein. Für den Schweregrad einer Störung werden die Auswirkungen betrieblich konkret beschrieben, etwa anhand ausgefallener Funktionen und verfügbarer Umgehungslösungen. Begriffe wie „schwerwiegend“ lassen dem Modell zu viel Interpretationsspielraum.
Was die Preise im Alltag ausmachen
Der Leitfaden nennt für gpt-6-luna einen Eingabepreis von $0.10 je 1M Tokens. Für die Ausgabe sowie das Lesen und Schreiben des Caches fallen keine Gebühren an. Zuschläge für regionale Verarbeitung und Multiplikatoren für Eingaben mit langem Kontext können hinzukommen. Diese Tarife gelten für Decisions. Die Abrechnungsregel lässt sich nicht auf gewöhnliche Aufrufe desselben Modells übertragen. Preise der Decisions API
Das folgende Beispiel ist eine Berechnung für einen Stapel von Anfragen, keine Nutzungsmessung und kein Pauschalpreis pro Entscheidung. Angenommen werden 100,000 Klassifizierungsaufrufe mit jeweils 1,000 nicht zwischengespeicherten Eingabetokens einschließlich Anweisungen und Auswahloptionen. Für den bisherigen Responses-Aufruf kommen insgesamt 50 abgerechnete Ausgabetokens je Aufruf hinzu. Grundlage sind die regulären Basistarife für kurzen Kontext, ohne Cache-Schreibvorgänge, regionale Zuschläge, Wiederholungsversuche oder weitere Gebühren.
Die regulären Modellpreise stammen aus OpenAIs Standardpreistabelle. In diesem Beispiel spart der Wegfall der Ausgabekosten $2.50 über den gesamten Stapel. Für sich genommen ist das ein schwacher Grund, eine funktionierende Integration umzubauen.
Überzeugender ist ein betrieblicher Vorteil: kürzere Wartezeiten in einem sequenziellen Ablauf, weniger Code zur Antwortverarbeitung oder weniger manuelle Sortierung bei gleicher Fehlerquote. Maßstab sind die tatsächliche Rechnung und der Prüfaufwand. Ein teureres bisheriges Modell oder längere generierte Antworten verändern die Rechnung ebenso wie bereits genutzte Cache-Rabatte. Entwicklungszeit und falsch zugewiesene Tickets gehören weiterhin ins Budget für die Umstellung.
Zwei Produktideen, die sich lohnen könnten
Erste Wahl: Ticket-Routing mit Prüfung und Korrekturverlauf
Eine Supportleitung könnte für einen Konnektor bezahlen, der festgelegte Warteschlangen vorschlägt, unsichere Fälle zurückhält und Korrekturen der Mitarbeitenden in Evaluationsdaten überführt. Das nützliche Produkt ist der vollständige Zuweisungsprozess einschließlich seiner laufenden Pflege.
DataForSEO schätzt für „ticket triage“ monatlich 170 Google-Suchanfragen in den USA, geprüft am 11. Oktober 2026. Das ist ein begrenztes Signal für Informationsbedarf, keine Zahl potenzieller Käufer. Auch bestehende Helpdesk-Produkte decken diese Aufgabe ab: Zendesk bietet Klassifizierungen für die intelligente Triage; für ihre Nutzung in Workflows ist das Copilot-Add-on erforderlich. Zendesk-Leitfaden zur Triage
Die kleinste nützliche Version könnte einen Helpdesk unterstützen, historische Tickets importieren, Zuweisungen als Vorschau anzeigen und einen Posteingang zur Prüfung mit manuellen Korrekturmöglichkeiten anbieten. Das stärkste Verkaufsargument wäre, wie deutlich beim Kunden vermeidbare Übergaben zurückgehen. Der Haken ist der Funktionsumfang des vorhandenen Systems: Verteilt der Helpdesk die Tickets bereits gut, verursacht ein zusätzlicher Router mehr Wartungsaufwand. Ein konkretes Zuständigkeitsproblem oder eine Übergabe zwischen Systemen muss den Unterschied machen.
Zweite Wahl: Eine Prüfoberfläche für feste Labels
Ein Forschungs- oder Datenteam könnte für eine Arbeitsoberfläche bezahlen, die Labels vorschlägt, Korrekturen erfasst und zeigt, bei welchen Kategorien immer wieder Uneinigkeit entsteht. Bei derselben Abfrage schätzt DataForSEO 90 Google-Suchanfragen pro Monat in den USA für „automated data labeling“. Das zeigt Interesse an der Aufgabe, belegt aber keine Zahlungsbereitschaft für diese Umsetzung.
Eine erste Version könnte eine CSV-Datei einlesen, einen versionierten Satz von Labels anwenden, unsichere Zeilen zur Prüfung vorlegen und korrigierte Ergebnisse exportieren. Ein separater Evaluationsdatensatz ermöglicht faire Vergleiche bei Änderungen an den Labels. Der Haken: Ein Modell kann eine unklare Taxonomie kostengünstig reproduzieren. Das Produkt braucht deshalb gute Werkzeuge zur Prüfung und Kategorienverwaltung; eine Oberfläche um einen API-Aufruf lässt sich leicht nachbauen.
Das Ticket-Routing ist die überzeugendere erste Produktidee. Feste Zuständigkeiten machen Fehler sichtbar. Es gibt jemanden im Betrieb, der sie korrigieren kann, und einen wiederkehrenden Ablauf, an dem sich der Nutzen zeigen lässt. Mit dieser Person sollte das Gespräch beginnen, bevor eine allgemeine Entscheidungsplattform entsteht.
Wann der bisherige Ansatz die bessere Wahl bleibt
Die Responses API bleibt die richtige Wahl, wenn Felder in einem eigenen JSON-Schema extrahiert werden sollen, eine schriftliche Erklärung gebraucht wird oder das Modell einen Tool-Aufruf samt Argumenten anfordern soll. Decisions bedient die enger gefassten Antworttypen von oben. OpenAIs Hinweise zur Wahl der Schnittstelle
Deterministische Regeln bleiben sinnvoll, wenn die Antwort bereits in einem Kontofeld oder einer eindeutigen Vorgabe steckt. Für „Kunden aus dieser Region an dieses Team weiterleiten“ bietet ein Modell kaum Mehrwert. Bei folgenreichen Aktionen bleiben menschliche Freigaben und Berechtigungsprüfungen in der Anwendung nötig. Eine Einschätzung zur Zuweisung kann einen Erstattungsprozess unterstützen; sie belegt weder den Anspruch des Kunden noch die Befugnis der handelnden Person.
Vor der Planung einer Umstellung sind diese Integrationsgrenzen zu prüfen:
- Bilder: Der Leitfaden erlaubt ausschließlich eingebettete Base64-Daten-URLs. Die Bilddaten werden also codiert direkt in der Anfrage übermittelt. Gehostete HTTP- oder HTTPS-Bild-URLs sowie
file_id, der Verweis auf eine zuvor hochgeladene Datei, werden laut Leitfaden nicht unterstützt. Anforderungen an Bildeingaben - Datenkontrollen: Laut Leitfaden werden Zero Data Retention, kurz ZDR, sowie die Nutzung unter HIPAA für berechtigte Kunden unterstützt. Datenresidenz und regionale Verarbeitung sind in den USA und Europa, konkret im EWR + der Schweiz, möglich. Dabei gelten Voraussetzungen, Vereinbarungen, Konfigurationsanforderungen und Einschränkungen; es handelt sich nicht um automatische Standardeinstellungen des Kontos. Verfügbarkeit der Decisions API, OpenAIs Datenkontrollen
- Produktreife: Die öffentliche Beta spricht dafür, einen Weg zurück zur bisherigen Lösung offenzuhalten. Erfüllt der vorhandene Klassifikator seine Ziele und bringt ein Wechsel keinen messbaren Vorteil, bleibt er im Einsatz.
Alternativen: Jev, Clef und Microsoft-Decision-1
Vor einem Anbieterwechsel sollten alle Kandidaten anhand derselben bereits klassifizierten Daten verglichen werden. Jev von TypeSafe nimmt über seine System One API einen Zustand und typisierte Fragen entgegen. Cloudflare Clef bietet typisierte Entscheidungen in Workers AI. Microsoft-Decision-1 ist in Microsoft Foundry unter anderem für Klassifizierung, Zuweisung und Priorisierung verfügbar. TypeSafe-Schnellstart, Dokumentation zu Cloudflare Clef, Microsofts Ankündigung
Die engere Auswahl sollte sich nach bestehenden Integrationen, Hosting-Anforderungen, Evaluationsergebnissen und dem Umgang mit Ausnahmefällen richten. Unser Leitfaden zum Support-Ticket-Routing mit Jev beschreibt das Zuweisungsmuster; Ist Jev Router kostenlos? erklärt den Unterschied zwischen Routersoftware und gehosteter Inferenz. Anfrageformate und das Verhalten der Konfidenzwerte müssen für jeden Anbieter gesondert betrachtet werden.
Soll Decisions meinen bisherigen Klassifizierungsaufruf ersetzen?
Ein Test lohnt sich, wenn als Ausgabe eine feste Kategorie, eine Einschätzung zu einer Bedingung oder eine Bewertung anhand eines Rasters gebraucht wird. Zuweisungsfehler, manueller Prüfaufwand, Kosten und Laufzeit werden an denselben bereits klassifizierten Beispielen verglichen. Rechtfertigt die Verbesserung keine Umstellung, bleibt der bisherige Aufruf bestehen.
Was soll die Anwendung tun, wenn eine Entscheidung verweigert wird?
Vor dem Auslesen des Werts wird der Antworttyp geprüft. Beim Support-Routing führt eine Verweigerung zur manuellen Prüfung; dabei muss genügend Kontext für die Bearbeitung durch Mitarbeitende erhalten bleiben. Eine Verweigerung erlaubt nicht, stattdessen eine Standardaktion auszuführen.
Welcher Konfidenzschwellenwert ist sinnvoll?
Der Schwellenwert wird anhand bereits klassifizierter Daten aus dem eigenen Arbeitsablauf bestimmt. Für jeden möglichen Wert werden Fehler und Prüfvolumen gemessen, möglichst getrennt nach Warteschlange. Dieser Artikel liefert keinen allgemeingültigen Schwellenwert; auch OpenAIs Leitfaden enthält keine Kalibrierungstabelle.
Kann ich eine gehostete Bild-URL oder die ID einer hochgeladenen Datei übergeben?
Es gilt das Format für eingebettete Base64-Daten-URLs aus dem Leitfaden. Dieser schließt gehostete Bild-URLs und file_id-Eingaben für den Endpunkt ausdrücklich aus. Die Predicate-Anfrage oben zeigt das im Leitfaden unterstützte Muster.
Der nächste Schritt für Montag
Als Kandidat eignet sich der Klassifizierungsaufruf, der Tickets auf eine festgelegte Auswahl von Warteschlangen verteilt. Die verantwortliche Person prüft eine repräsentative, bereits klassifizierte Stichprobe und hält akzeptable Fehlerquoten sowie Anteile für die manuelle Prüfung fest. Anschließend wird Decisions parallel zum bisherigen Aufruf verglichen, ohne Zuweisungen zu verändern. Der Wechsel erfolgt erst, wenn sich die API ihren Platz im Ablauf verdient hat.
Für einen Zuweisungsprozess, der auf die vorhandenen Tools abgestimmt ist: Wir entwickeln produktionsreife KI-Systeme.
- Veröffentlicht
- Kategorie
- Build
- Sprache

Decision Models 2026: Welche Jev-Alternative passt?
Decision Models als Jev-Alternativen: Perplexity, Clef, OpenAI, Microsoft, Liquid und Strands nach Preisen, Lizenzen und Einsatzmöglichkeiten vergleichen.11. Okt. 2026Build
Claude Code Remote Control: Einrichtung und Fernzugriff
Claude Code Remote Control einrichten, per Smartphone oder Browser weiterarbeiten und typische Anmelde- und Verbindungsfehler gezielt beheben.9. Okt. 2026Build
Cursor App fürs iPhone: Lokale Agenten fernsteuern
Mit der Cursor App lokale Agenten vom iPhone aus steuern: So funktionieren Kopplung und Fernzugriff, so bleibt der Laptop erreichbar. Preise und Praxistipps.9. Okt. 2026Build
Firecrawl Pricing 2026: Welcher Tarif sich wirklich lohnt
Firecrawl Pricing im Überblick: Tarife, Credits und Zusatzkosten. Beispielrechnungen für JSON-Extraktion, Fehlerseiten und wöchentliche Crawls im Vergleich.9. Okt. 2026Build
Claude Code Kosten 2026: GitHub Copilot im Vergleich
Claude Code und GitHub Copilot im Vergleich: Kosten, Nutzungslimits, Modelle und Teamverwaltung. Welcher Tarif passt zu Editor, Terminal und Team?8. Okt. 2026Build
LangGraph oder CrewAI? KI-Agenten im Vergleich
LangGraph oder CrewAI für KI-Agenten? Der Vergleich zeigt Unterschiede bei Workflows, Freigaben, Speicher, MCP und den Kosten der gehosteten Plattformen.7. Okt. 2026Build
MCP Server erstellen: Mit Python vom lokalen Tool zum Teamdienst
MCP Server mit Python erstellen, in Inspector testen und an Claude Code oder Cursor anbinden. Dazu HTTP-Authentifizierung, Hosting und klare Zugriffsrechte.7. Okt. 2026Build