Kundenservice-Automatisierung mit Jev: Ticket-Routing in der Praxis
Jev routet Support-Tickets, bewertet Schweregrad und Dringlichkeit und zeigt anhand seiner Konfidenzwerte, wann ein Mensch die Entscheidung übernehmen sollte.

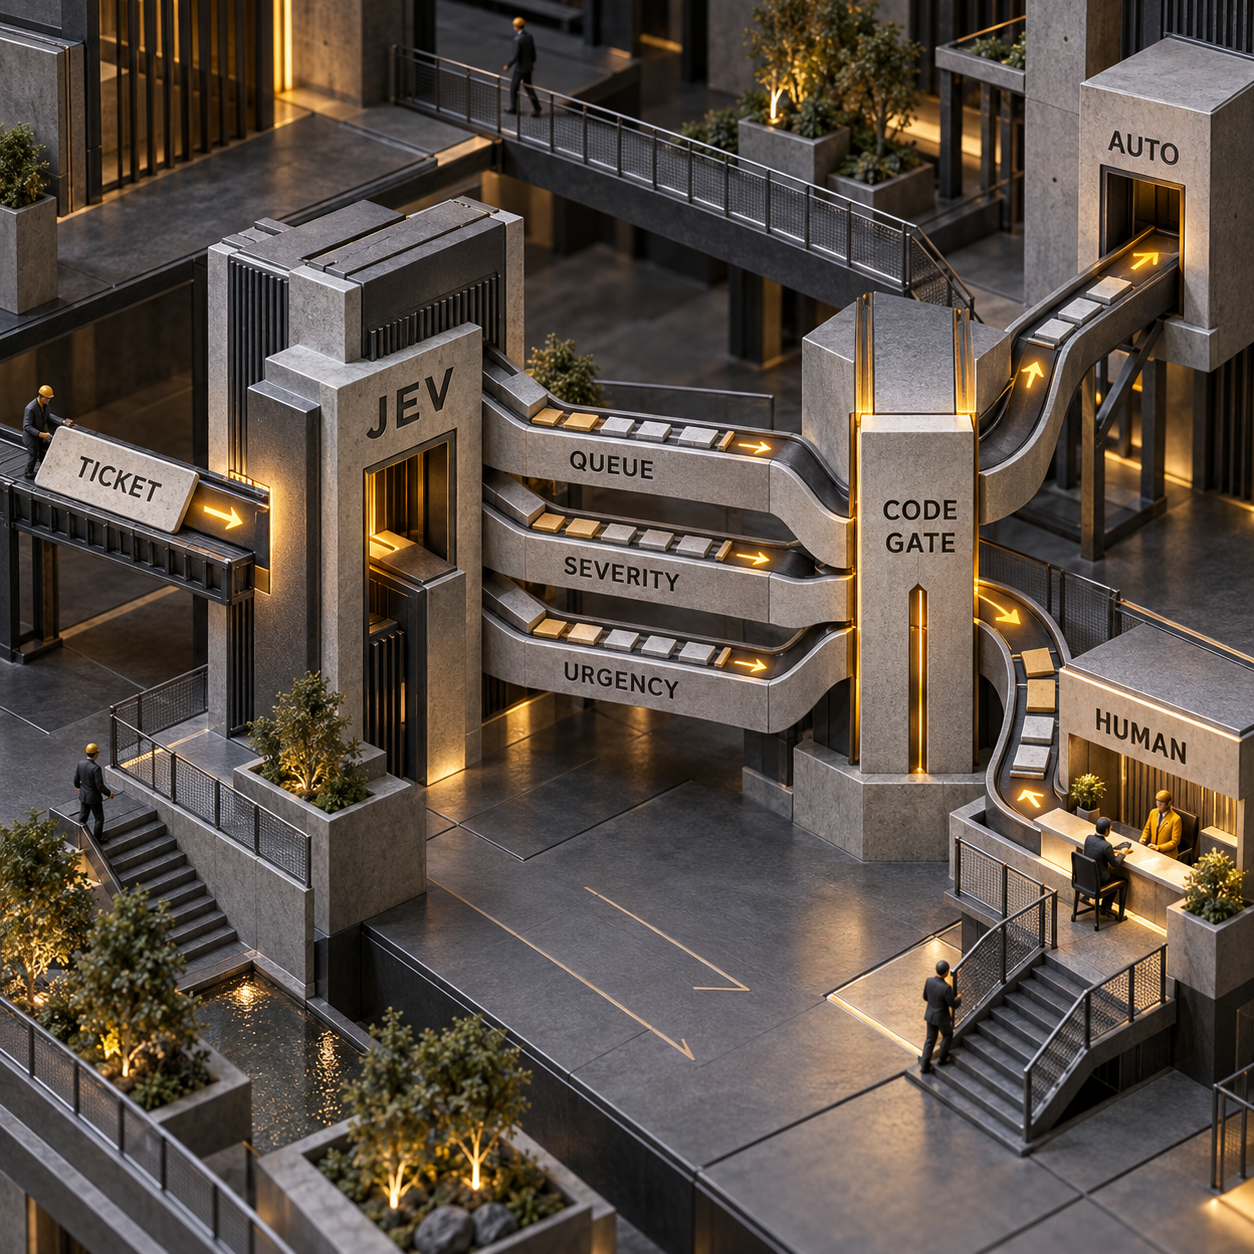
Für die Kundenservice-Automatisierung macht Jev aus einer einzigen unübersichtlichen Supportnachricht drei Signale, die Software sofort verarbeiten kann: eine Warteschlange, einen Schweregrad und die Wahrscheinlichkeit, dass das Ticket dringend ist. Entscheidend ist nicht nur, dass diese Antworten typisiert sind. Der eigene Code kann sie prüfen, protokollieren und festlegen, wann ihnen nicht zu trauen ist.
Am Anfang sollte eine einzige reversible Aufgabe stehen: ein Ticket weiterleiten, im Code aber eine Warteschlange für die menschliche Prüfung vorsehen. Jev garantiert die Form seiner Antwort, nicht, dass billing tatsächlich die richtige Antwort ist. Genau dieser Unterschied trennt eine Demo von einem belastbaren Arbeitsablauf.
Kundenservice-Automatisierung beginnt mit einer Entscheidung, nicht mit einem autonomen Support-Agenten
Jev ist ein Entscheidungsmodell, kein Chatbot. Es erhält Text oder strukturiertes JSON als sogenannten state und beantwortet anschließend Fragen, deren mögliche Antwortformen vorab feststehen. Statt eines ausformulierten Textes liefert es Werte und Wahrscheinlichkeiten. TypeSafe bezeichnet Jev als System-One-Modell: Es ist für schnelle, eng umrissene Entscheidungen innerhalb gewöhnlicher Software konzipiert.
Jev lässt sich als semantische Weiche verstehen. Eine gewöhnliche if-Anweisung prüft eine exakte Tatsache, etwa ob eine Rechnung überfällig ist. Jev übernimmt den unscharfen Teil, zum Beispiel die Einschätzung, ob eine Kundennachricht dringend klingt, und gibt die Kontrolle danach an normalen Code zurück.
Für den ersten Support-Workflow genügt ein Ticket mit drei Fragen:
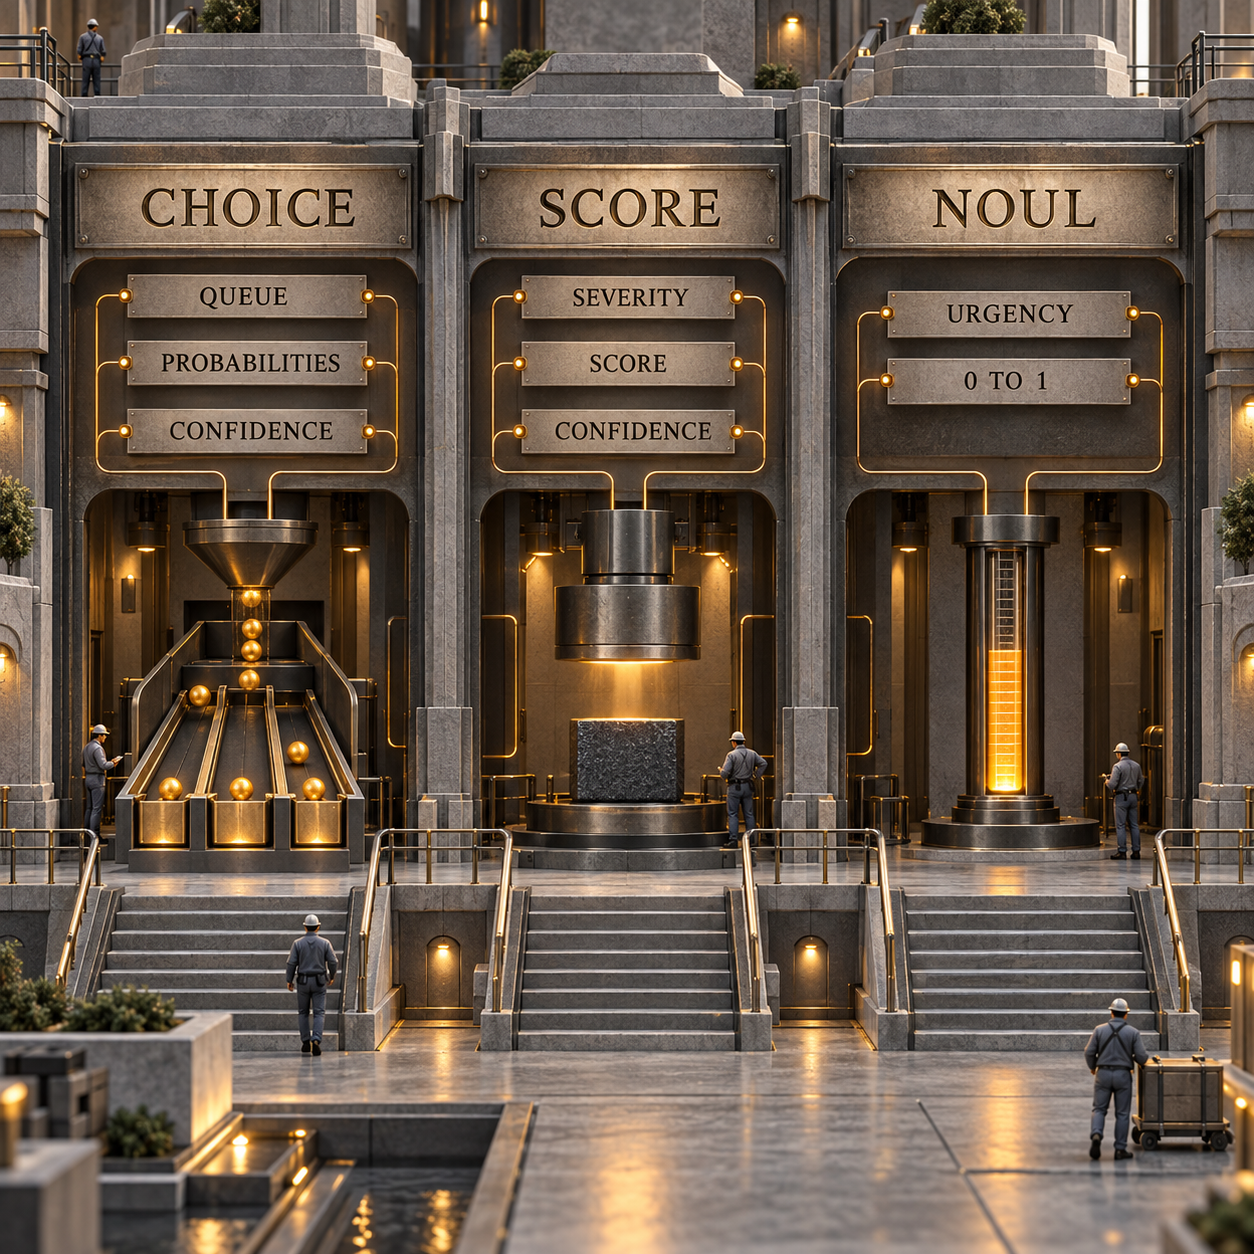
- Choice: In welche fest definierte Warteschlange gehört dieses Ticket?
- Score: Auf welcher Stufe einer geordneten Skala liegt der Schweregrad?
- Noul: Wie wahrscheinlich ist es, dass der Kunde Dringlichkeit ausdrückt?
Alle drei Fragen können in einer Anfrage übertragen werden und werden unabhängig voneinander anhand desselben Zustands ausgewertet. Jev akzeptiert derzeit ausschließlich Text, darunter Strings und aus Text aufgebaute JSON-Strukturen. Anhänge, Bilder, Audio- oder Videodateien werden nicht unterstützt.
Choice, Score und Noul beantworten unterschiedliche Fragen
Jeder Grundtyp ist für eine andere Art von Frage gedacht. Die passende Auswahl ist wichtiger als eine besonders ausgefeilte Formulierung.
Die Warteschlange ist eine Choice, weil billing, technical, sales und other Alternativen darstellen. Der Schweregrad ist ein Score, weil seine Stufen eine geordnete Skala bilden. Dringlichkeit ist ein Noul, sofern lediglich gefragt wird, ob die Nachricht Zeitdruck ausdrückt.
Wichtig sind die vollständigen Verteilungen. Weist eine Choice den Kategorien billing und technical ähnlich hohe Wahrscheinlichkeiten zu, ist die Grenze zwischen den Warteschlangen unscharf. Bei Choice und Score fasst das einzelne Feld confidence diese Verteilung zusammen. Bei einem Noul markiert ein Wert nahe 0.5 den mehrdeutigen Bereich, denn der zurückgegebene Wert ist bereits die Ja-Wahrscheinlichkeit.
Das erste Ticket-Routing aufbauen
Zuerst ist der Zugang zu prüfen. TypeSafe hat Jev am 15. September 2026 als Early Access veröffentlicht; in dieser Veröffentlichungsumgebung stand kein TypeSafe-Schlüssel zur Verfügung. Eine Anfrage ohne Schlüssel an den Modell-Endpunkt wurde mit HTTP 403 und einem Authentifizierungsfehler beantwortet. Mit autorisiertem Zugang ist der folgende Workflow ausführbar, doch kein Ergebnis in diesem Artikel wird als Ausführung dieses Laufs dargestellt.
Vorausgesetzt werden Python 3.10 oder neuer, das Paket typesafe-sdk und die Umgebungsvariable TYPESAFE_API_KEY. Das SDK liest diese Variable und verwendet standardmäßig jev-latest. Im Beispiel wird das Modell ausdrücklich genannt, damit die Anfrage leicht nachvollziehbar bleibt.
from time import perf_counter

from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = {
    "id": "T-001",
    "message": (
        "Our SSO connection stopped working after renewal. "
        "The invoice is paid, but the whole team is locked out."
    ),
}

started = perf_counter()
with TypeSafeClient() as client:
    response = client.system_one(
        model="jev-latest",
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which support queue should handle `message`?",
                criteria={
                    "billing": "Invoices, payments, refunds, or subscriptions",
                    "technical": "Bugs, outages, access, or integrations",
                    "sales": "Plans, pricing, upgrades, or a new account",
                    "other": "Anything that does not clearly fit the other queues",
                },
            ),
            "severity": Score(
                instructions="How severe is the customer impact in `message`?",
                criteria=[
                    "Minor inconvenience",
                    "One person is blocked",
                    "Several users are blocked",
                    "Security risk or data loss",
                ],
            ),
            "urgent": Noul(
                instructions="Does `message` express urgency or time pressure?",
            ),
        },
    )
latency_ms = round((perf_counter() - started) * 1000, 1)

queue = response.answers["queue"]
severity = response.answers["severity"]
urgent = response.answers["urgent"]

# These are conservative test gates for this reversible workflow,
# not universal thresholds. Tune them on labelled tickets.
needs_human = (
    queue.choice == "other"
    or queue.confidence < 0.75
    or severity.confidence < 0.70
    or 0.35 < urgent.noul < 0.65
)

record = {
    "ticket_id": ticket["id"],
    "model": response.model,
    "input_tokens": response.usage.input_tokens,
    "latency_ms": latency_ms,
    "queue": queue.choice,
    "queue_probabilities": queue.probabilities,
    "queue_confidence": queue.confidence,
    "severity": severity.score,
    "severity_confidence": severity.confidence,
    "urgency_probability": urgent.noul,
    "handoff": needs_human,
}
print(record)
Die Schwellenwerte im Beispiel sind bewusst auf diesen Einzelfall zugeschnitten. Eine falsche Support-Warteschlange lässt sich meist korrigieren, doch selbst diese Kosten unterscheiden sich. Ein Start-up mit zwei Personen kann eine Fehlleitung hinnehmen, die für den Helpdesk eines Krankenhauses nicht akzeptabel wäre. Auch TypeSafe empfiehlt in seinen Hinweisen zur Konfidenz, die Grenzen an den Folgen auszurichten und mit den eigenen Daten abzustimmen.
Ein weiteres Detail gehört ins Protokoll: jev-latest ist ein Alias. Zum Zeitpunkt der Veröffentlichung verweist er auf jev-1.13.0; im Feld model der Antwort steht, welche Version die Anfrage tatsächlich beantwortet hat. Verändert eine spätere Version die Ergebnisse, lässt sich das ohne die konkrete Modell-ID im Protokoll nicht erklären.
Der sichtbare Fehlerfall: formal gültig, inhaltlich falsch
Das Beispiel-Ticket enthält absichtlich zwei deutliche Signale. „Renewal“ und „invoice“ sprechen für billing, „SSO“ und „locked out“ dagegen für den technischen Support. Für die im Code definierte Skala könnte ein gelabelter Testsatz technical als korrekte Warteschlange festlegen, weil der fehlende Zugang das akute Problem ist.
Trotzdem könnte Jev eine vollständig gültige Choice mit dem Wert billing liefern. Das JSON wäre lesbar, das Feld vorhanden und der Wert eine der erlaubten Optionen. Gemessen am festgelegten Referenzlabel wäre die Antwort dennoch falsch.
Dieser Fehler macht zwei voneinander getrennte Kontrollen sichtbar:
- Laufzeit-Fallback: Fälle mit niedriger Konfidenz,
otheroder mehrdeutigem Noul gehen an einen Menschen. - Evaluations-Fallback: Jede Testentscheidung wird mit einem menschlich vergebenen Label verglichen, auch bei hoher Konfidenz. Ein Schwellenwert erkennt keine Fehlklassifikation mit hoher Konfidenz.
„Typsicher“ darf nicht mit „konstruktionsbedingt korrekt“ verwechselt werden. Typsicherheit schützt die Schnittstelle zwischen Modell und Code. Genauigkeit muss für genau die verwendeten Tickets, Labels, Kriterien, Modellversionen und Sprachen gemessen werden.
Ein unabhängiger früher Test zur E-Mail-Weiterleitung unterstreicht das. Bei 1,565 deutsch- und englischsprachigen geschäftlichen E-Mails meldete der Praktiker für Jev eine Gesamtgenauigkeit von 96.4%, hinter zwei Gemini-Modellen. Im selben Test häuften sich die Jev-Fehler bei niedrigerer Konfidenz, wodurch eine gezielte menschliche Prüfung nützlich wurde. Das ist der Datensatz eines einzelnen Praktikers, kein allgemeingültiges Produktionsergebnis.
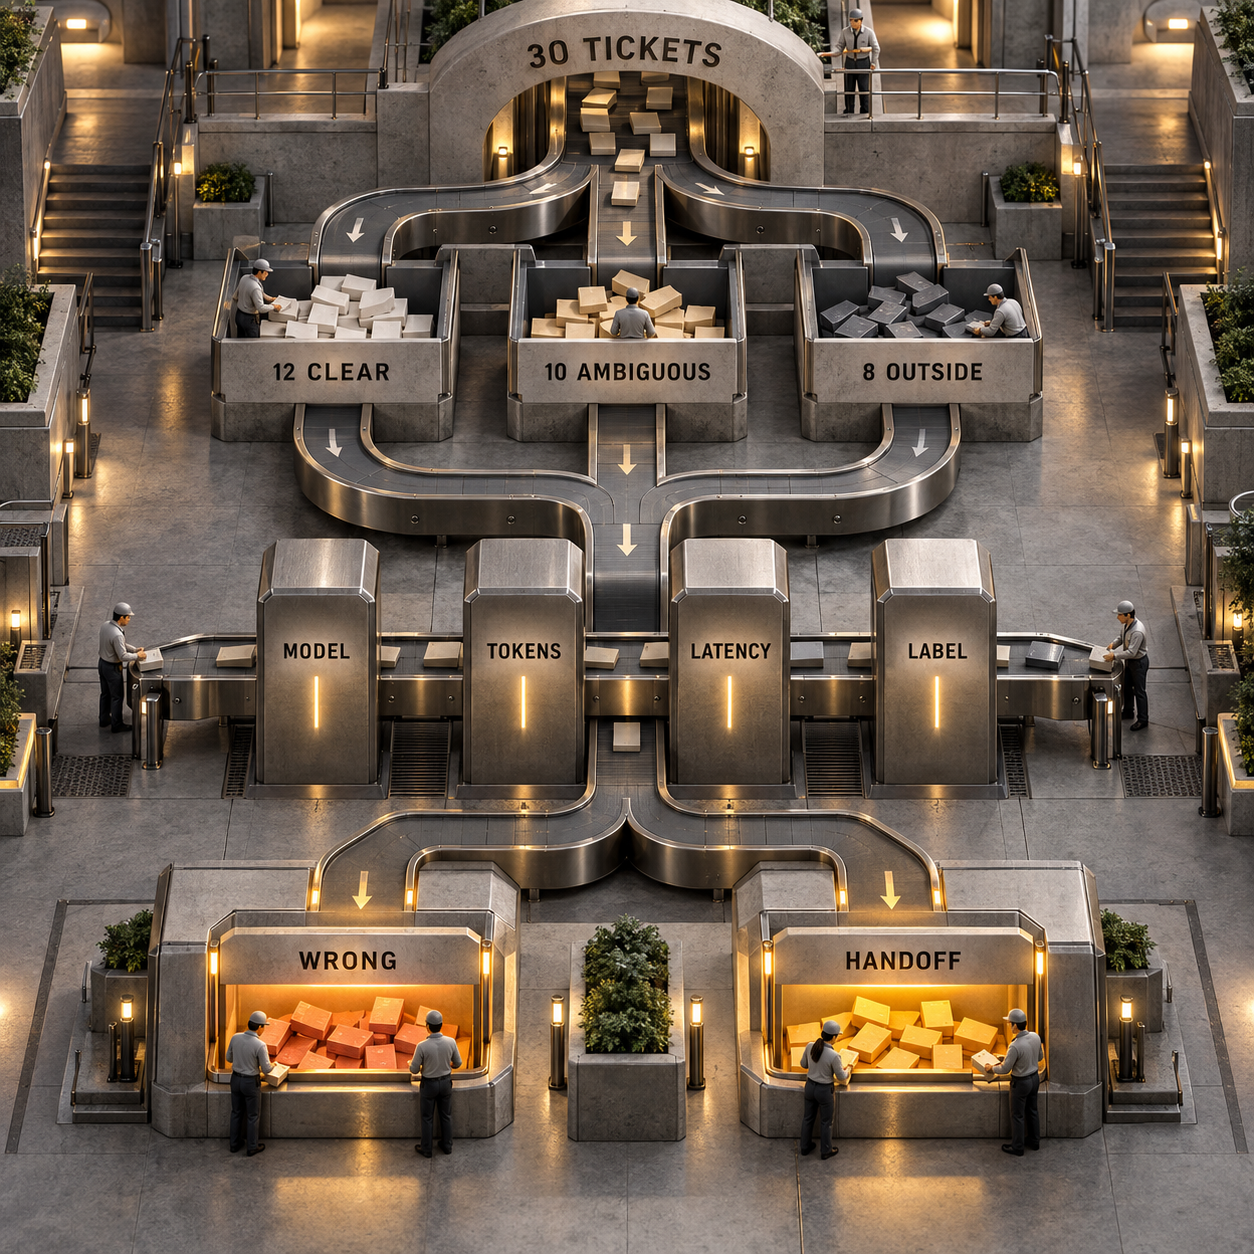
Vor dem Ticket-Routing: ein Workflow-Test mit 30 Tickets
Dreißig Tickets können keine Produktionsgenauigkeit belegen. Sie können aber ein ungeeignetes Label-Set, einen fehlenden other-Pfad, missverständliche Anweisungen, ein falsch verwendetes Antwortfeld oder einen Fallback sichtbar machen, der nie auslöst. Das ist ein kleiner Workflow-Test, kein Benchmark.
Der Testsatz sollte feststehen, bevor die Antworten von Jev betrachtet werden:
Jede Zeile erhält eine beständige Ticket-ID, die erwartete Warteschlange, eine kurze Begründung für dieses Referenzlabel und die Angabe, ob sie an einen Menschen gehen soll. Danach werden die konkrete Modellversion, Eingabe-Token, die clientseitig gemessene Latenz, zurückgegebene Warteschlange und Wahrscheinlichkeiten, der Schweregrad samt Konfidenz, die Dringlichkeitswahrscheinlichkeit, ein Kennzeichen für Fehlklassifikationen und die tatsächliche Übergabe protokolliert.
Mindestens vier Ausschnitte sind getrennt auszuwerten:
- Fehlklassifikationen unter den Fällen, die der Code automatisch weiterleiten würde
- Fehlklassifikationen mit hoher Konfidenz, weil die Laufzeitschranke sie übersieht
- Übergabequote bei eindeutigen Fällen, weil übermäßige Vorsicht manuelle Arbeit erzeugt
- Nicht abgedeckte Fälle, die nicht in
othergelandet sind
Solange der Zugang auf einer Warteliste steht, bleiben Testsatz und Skript einsatzbereit. Die Ergebnisspalten dürfen nicht mit Werten aus der Dokumentation oder fremden Tests gefüllt werden. Das ehrliche Artefakt ist ein wegen fehlenden Zugangs blockiertes Testblatt mit ausführbarem Code.
Die Kostenrechnung verändert den Posten für Klassifizierung, nicht den gesamten Support-Stack
Jev 1.13 kostet $0.042 pro Million Eingabe-Token; die Ausgabe wird nicht berechnet. Bei diesem Tarif kostet ein hypothetisches Ticket mit 500 Eingabe-Token $0.000021 an Modelleingabe. Einhunderttausend Tickets dieser Größe würden $2.10 kosten.
Diese Zahl fällt auf, ist aber kein Ersatzpreis für Kundenservice-Software. Zendesk beginnt bei $19 pro Agent und Monat bei jährlicher Zahlung. Intercom startet bei $29 pro Arbeitsplatz und Monat und berechnet ab $0.99 pro Fin-Ergebnis. Zu diesen Produkten gehören Posteingänge, Ticketspeicherung, Oberflächen für Mitarbeitende, Berichte und weitere betriebliche Infrastruktur. Jev liefert lediglich das Entscheidungssignal.
Die veränderte Budgetannahme ist enger gefasst: Wiederkehrende semantische Klassifizierung muss nicht jedes Mal einen teuren Aufruf eines generativen Modells verbrauchen. Geld und Aufwand verlagern sich auf Integration, gelabelte Beispiele, Überwachung, Ausnahmebehandlung und die Menschen, die Übergaben übernehmen. Bei gewöhnlichem Posteingangsvolumen kann die reine Ersparnis bei der Inferenz weniger wertvoll sein als das Wissen, bei welchen Tickets das Modell selbst Unsicherheit signalisiert.
Hier bietet sich eine klare Arbeitsteilung an. Jev wählt eine Route; ein generatives Modell formuliert Sprache. Für die Antwortseite dieses Workflows zeigt der Artikel, wie ChatGPT anhand des Ticketverlaufs Zendesk-Antworten vorbereiten kann. Richtlinien, Berechtigungen und Aktionen sollten weiterhin durch den Anwendungscode durchgesetzt werden.
Sieben Workflows, geordnet nach dem größten Nutzen
Das sind mögliche Anwendungen eines klar begrenzten Entscheidungsmodells, keine gemeldeten Ergebnisse.
Jev spielt seine Stärke aus, wenn die möglichen Antworten bekannt sind, die Entscheidung häufig wiederkehrt und sich eine falsche Verzweigung eindämmen lässt. Schlecht geeignet ist das Modell, wenn eine Antwort, Erklärung, Berechnung, ein präziser Datumsvergleich oder eine lange Argumentationskette benötigt wird.
Zwei Produkte, deren Entwicklung sich lohnt
1. Nach Konfidenz gesteuertes Support-Routing zum Nachrüsten
Das ist die stärkste Chance: eine schlanke Routing-Schicht für Teams, die bereits einen Helpdesk einsetzen, ihre Tickets aber noch manuell sortieren oder mit brüchigen Schlüsselwortregeln arbeiten. Sie liest ein Ticket, wendet die eigene Warteschlangen-Skala des Teams an, schreibt die gewählte Warteschlange und die Wahrscheinlichkeiten zurück in den Helpdesk und übergibt unsichere oder nicht passende Fälle an einen Menschen.
Die Nachfrage ist konkret genug, um relevant zu sein: customer service automation erzielt in den USA etwa 880 Suchanfragen pro Monat, help desk automation und customer support automation jeweils etwa 260. Bestehende Supportplattformen beginnen bei rund $19 bis $29 pro Arbeitsplatz und Monat. Das Verkaufsversprechen lautet deshalb nicht „den Helpdesk ersetzen“, sondern „eine Routing-Entscheidung in dem bereits bezahlten Helpdesk messbar machen“.
Die kleinste verkaufsfähige Version benötigt einen Konnektor, vier bearbeitbare Warteschlangendefinitionen, eine other-Route, Konfidenzbereiche, einen Prüf-Posteingang und einen wöchentlichen Bericht über Fehlklassifikationen. Der Haken liegt beim Onboarding. Jeder Kunde zieht seine Warteschlangengrenzen anders; ein allgemeines Schema wird zur Fehlerquelle des Produkts. Der Wettbewerbsvorteil steckt in Evaluation und Rückkopplung, nicht im API-Aufruf.
2. Eine Routing-QA-Konsole für den Schattenbetrieb
Zuerst lässt sich die Sicherheitsschicht verkaufen, erst danach die Automatisierung. Eine Supportleitung lädt gelabelte Tickets hoch, führt ein mögliches Frageschema aus, ohne Live-Zuweisungen zu verändern, und erhält Verwechslungsstatistiken, Fehler mit hoher Konfidenz, Übergabequoten, Versionsvergleiche sowie eine Liste der Fälle, deren Kriterien verbessert werden müssen.
Dieselben 260 monatlichen Suchanfragen für help desk automation zeigen Interesse an dieser Aufgabe. Ein CPC von $129.46 für customer support automation signalisiert zudem, dass Anbieter diesen Traffic als wirtschaftlich wertvoll einstufen. Das MVP kann aus einem CSV-Import, einem direkten Jev-Aufruf, einer Gegenüberstellung zur Labelprüfung und einem exportierbaren Entscheidungsprotokoll bestehen. Zunächst sollte es den Test mit 30 Tickets unterstützen, danach größere private Datensätze.
Allerdings könnten Teams von einem professionell gestalteten Dashboard statistische Sicherheit erwarten. Das Produkt muss klar benennen, was eine kleine Stichprobe belegen kann und was nicht, Ticketdaten schützen und Konfidenz nicht als tatsächliche Genauigkeit darstellen. Als Ergänzung zum Routing-Produkt ist das überzeugend, als eigenständiges Geschäft hingegen schwächer, weil Evaluation nur gelegentlich anfällt.
Grenzen, bei denen Jev nicht eingesetzt werden sollte
Jev ist ungeeignet, wenn Fließtext, eine Kundenantwort, Code oder eine Erklärung der Argumentation gefragt sind. Ebenso wenig gehört es in Aufgaben mit Arithmetik, Zählen, Datumsvergleichen oder deterministischen Zulassungsregeln, die gewöhnlicher Code exakt abbilden kann.
Laut Dokumentation zeigt Jev 1.13 Schwächen bei Fallen durch wörtliche Auslegung, indirekten Bezügen, irrelevantem Kontext, adversarialen Inhalten, widersprüchlichen Anweisungen und numerischer Genauigkeit. Die primäre Trainingssprache ist Englisch; für andere Sprachen ist eine geringere Genauigkeit dokumentiert. Anhänge müssen von einem anderen System in Text umgewandelt werden, bevor Jev sie verarbeiten kann.
Für die gesamte Anfrage gilt ein Kontextlimit von 64,000 Token. Ein zweites Limit von 32,000 Token umfasst den Zustand plus die längste Frage. Diese Werte sind Obergrenzen, keine Zielgrößen. Die offizielle Anleitung warnt davor, dass irrelevanter Zustand die Genauigkeit mindern kann. Deshalb sollten nur die Richtlinien und Ticketdetails abgerufen werden, die für die aktuellen Fragen nötig sind.
Die harte Grenze bilden die Folgen. Eine Support-Kategorie lässt sich rückgängig machen. Eine Rückerstattung, Kontosperrung, Einstellungsentscheidung, medizinische Priorisierung oder Geldüberweisung ist nicht bloß ein Label. Folgenreiche Aktionen gehören hinter deterministische Prüfungen, eine Bestätigung, eine qualifizierte Person oder ein eigens für diese Domäne entwickeltes und validiertes System.
Der konkrete Plan für Montag
Wer den Supportbetrieb verantwortet, exportiert am Montagmorgen 30 aktuelle Tickets. Noch bevor jemand eine Modellausgabe sieht, werden 12 eindeutige, 10 mehrdeutige und 8 nicht abgedeckte Beispiele gelabelt. Danach wird Early Access beantragt, das Skript nach Erhalt eines Schlüssels im Schattenbetrieb ausgeführt und die Fehlklassifikationen mit hoher Konfidenz werden geprüft, bevor ein Schwellenwert angepasst wird. Eine Verbindung zum Live-Routing sollte erst erfolgen, wenn menschliches Referenzlabel, Modellversion und Fallback-Ergebnis gemeinsam im selben Protokoll stehen.
Was ist Jev?
Jev ist das Entscheidungsmodell von TypeSafe AI für strukturierte Software-Workflows. Es liest Text oder einen strukturierten Textzustand und liefert klar begrenzte Antworten der Typen Choice, Score und Noul samt Wahrscheinlichkeiten, statt Fließtext zu erzeugen.
Wofür steht der Name Jev?
Laut TypeSafe verweist der Name auf William Stanley Jevons. Die übergeordnete Bezeichnung „System One“ bezieht sich auf die schnelle, intuitive Seite der Unterscheidung zwischen System 1 und System 2.
Gibt es ein Video zur Nutzung von Jev?
Videos können einen ersten Überblick vermitteln. Für die Implementierung sollte jedoch die aktuelle Dokumentation zur TypeSafe API und zum SDK maßgeblich sein, weil sich Anfragefelder, Modell-Aliasse, Zugang und Limits ändern können. Der direkte Ablauf lautet: einen autorisierten Schlüssel beschaffen, den Zustand zusammen mit typisierten Fragen senden, die zurückgegebenen Verteilungen prüfen und den Fallback im Code belassen.
Wenn ein nach Konfidenz gesteuerter Support-Workflow auf Grundlage der tatsächlichen Warteschlangenregeln und Tickets entstehen soll, ist die Entwicklung von KI-Kundenservice der passende Ausgangspunkt.
- Zuletzt aktualisiert
- 21. Sept. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
Claude Code Anleitung: So lädt Claude Code AGENTS.md
Diese Claude Code Anleitung zeigt, wann AGENTS.md ab v2.1.277 direkt geladen wird, welche Dateien Vorrang haben und wie sich das Setup sicher testen lässt.19. Sept. 2026Build
Claude Code MCP Timeout richtig einstellen
Claude Code MCP Timeout gezielt setzen: Startwartezeit, Verbindungs- und Tool-Timeouts sauber trennen und benötigte Server vor Jobs sicher prüfen.17. Sept. 2026Build
KI-Crawler blockieren, ohne die Suche zu verlieren
Cloudflare trennt Suche und KI-Training. So lassen sich KI-Crawler blockieren, migrierte Regeln prüfen und Googlebot für die Indexierung offenhalten.16. Sept. 2026Build
Diktierprogramm kostenlos und offline: Murmure im Praxistest
Murmure im Praxistest: Wie gut das kostenlose Offline-Diktierprogramm Fachbegriffe erkennt, welche Hardware genügt und was lokale oder Remote-LLMs ändern.14. Sept. 2026Build
Video API mit FFmpeg: Was RenderIO wirklich kostet
Was kostet die RenderIO Video API? Der Vergleich zeigt Credits, Aufpreise und exakte Wechselpunkte für Starter, Growth und Business im Praxiseinsatz.14. Sept. 2026Build
Diktierprogramm kostenlos: Was Dictare tatsächlich kostet
Diktierprogramm kostenlos: Dictare läuft lokal für $0. Der Preisvergleich zeigt, welche Kosten für Coding-Agent, Hardware, Einrichtung und Strom bleiben.13. Sept. 2026Build
Claude Code Plugin testen: Native Evals als Release-Gate
So messen native Evals, ob ein Claude Code Plugin das Verhalten von Claude verbessert – mit A/B-Vergleich, deterministischen Gradern und einem CI-Gate.12. Sept. 2026Build