Automação de atendimento ao cliente com Jev: roteamento seguro de tickets
Aprenda a aplicar automação de atendimento ao cliente com Jev para rotear tickets, medir severidade e urgência e manter a revisão humana no fluxo.

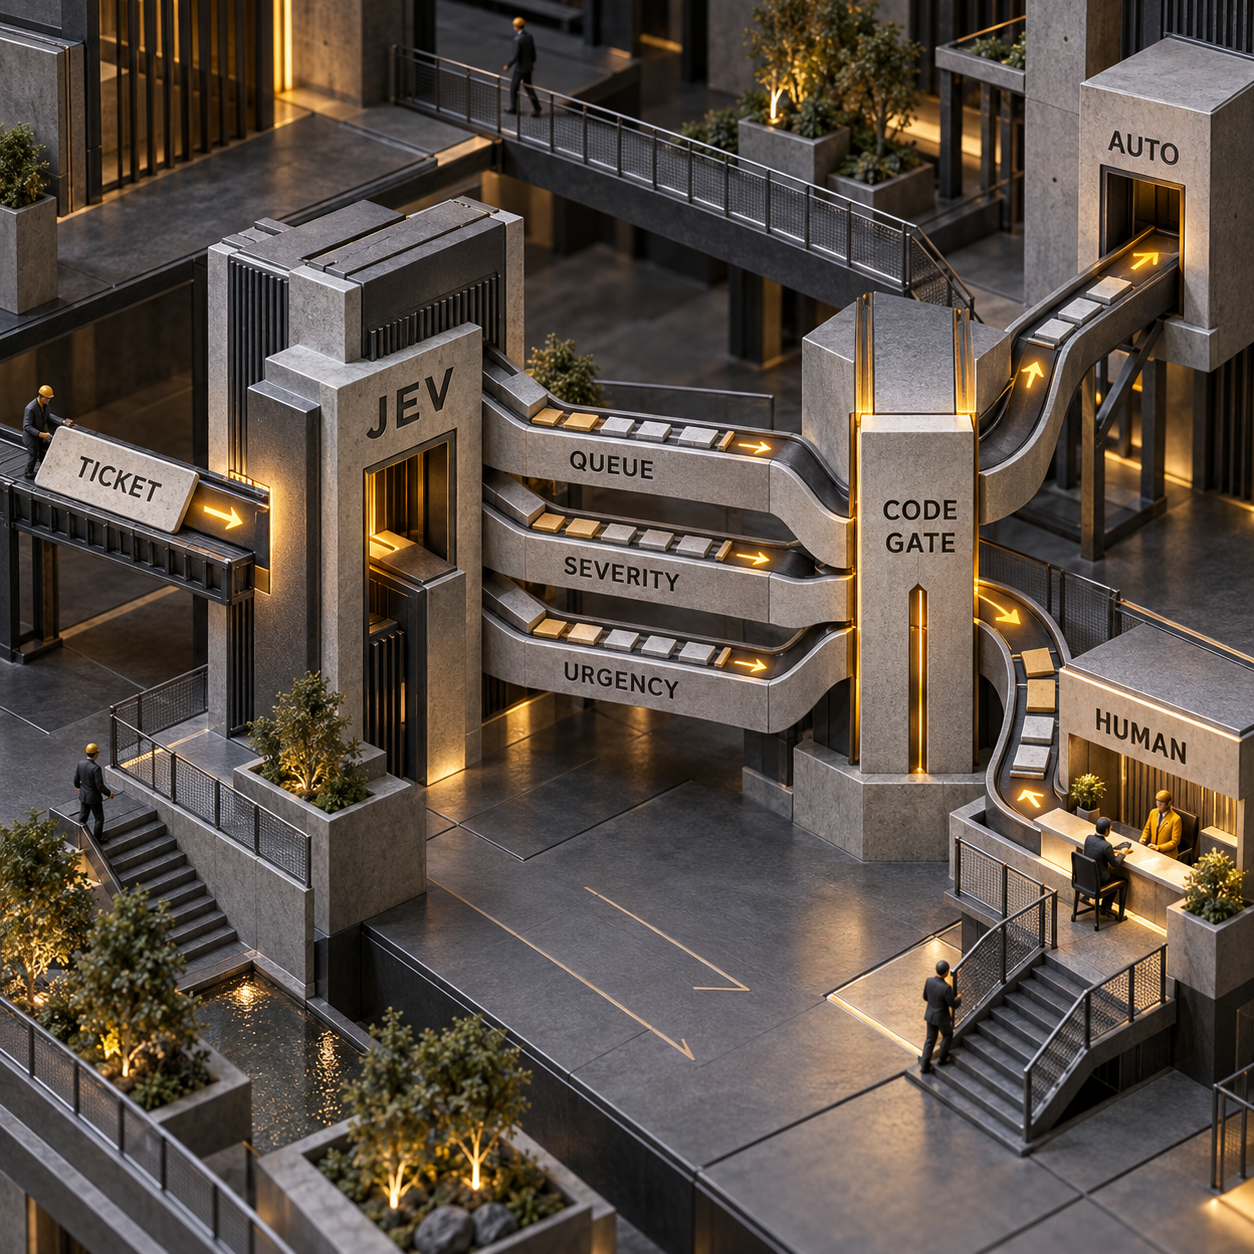
Na automação de atendimento ao cliente, o Jev consegue transformar uma única mensagem confusa de suporte em três sinais que seu software pode usar na hora: uma fila, uma pontuação de severidade e a probabilidade de o ticket ser urgente. O valor não está apenas no fato de essas respostas serem tipadas. Está na possibilidade de o código inspecioná-las, registrá-las e decidir quando não confiar nelas.
Comece com uma tarefa reversível: encaminhar um ticket, mantendo no código uma fila para revisão humana. O Jev garante o formato da resposta, não que billing seja a resposta correta. Essa diferença separa uma demonstração de um fluxo de trabalho em produção.
A automação de atendimento ao cliente começa por uma única decisão
O Jev é um modelo de decisão, não um chatbot. Você envia um texto ou JSON estruturado chamado state e faz perguntas cujos formatos possíveis de resposta são definidos antecipadamente. Em vez de redigir uma resposta, ele devolve valores e probabilidades. A TypeSafe o classifica como um modelo System One, criado para fazer julgamentos rápidos e específicos dentro de softwares convencionais.
Pense nele como uma central semântica. Um if comum verifica um fato exato, como uma fatura vencida. O Jev cuida da parte ambígua — por exemplo, avaliar se a mensagem do cliente parece urgente — e então devolve o controle ao código tradicional.
No primeiro fluxo de triagem de tickets, forneça um ticket e pergunte:
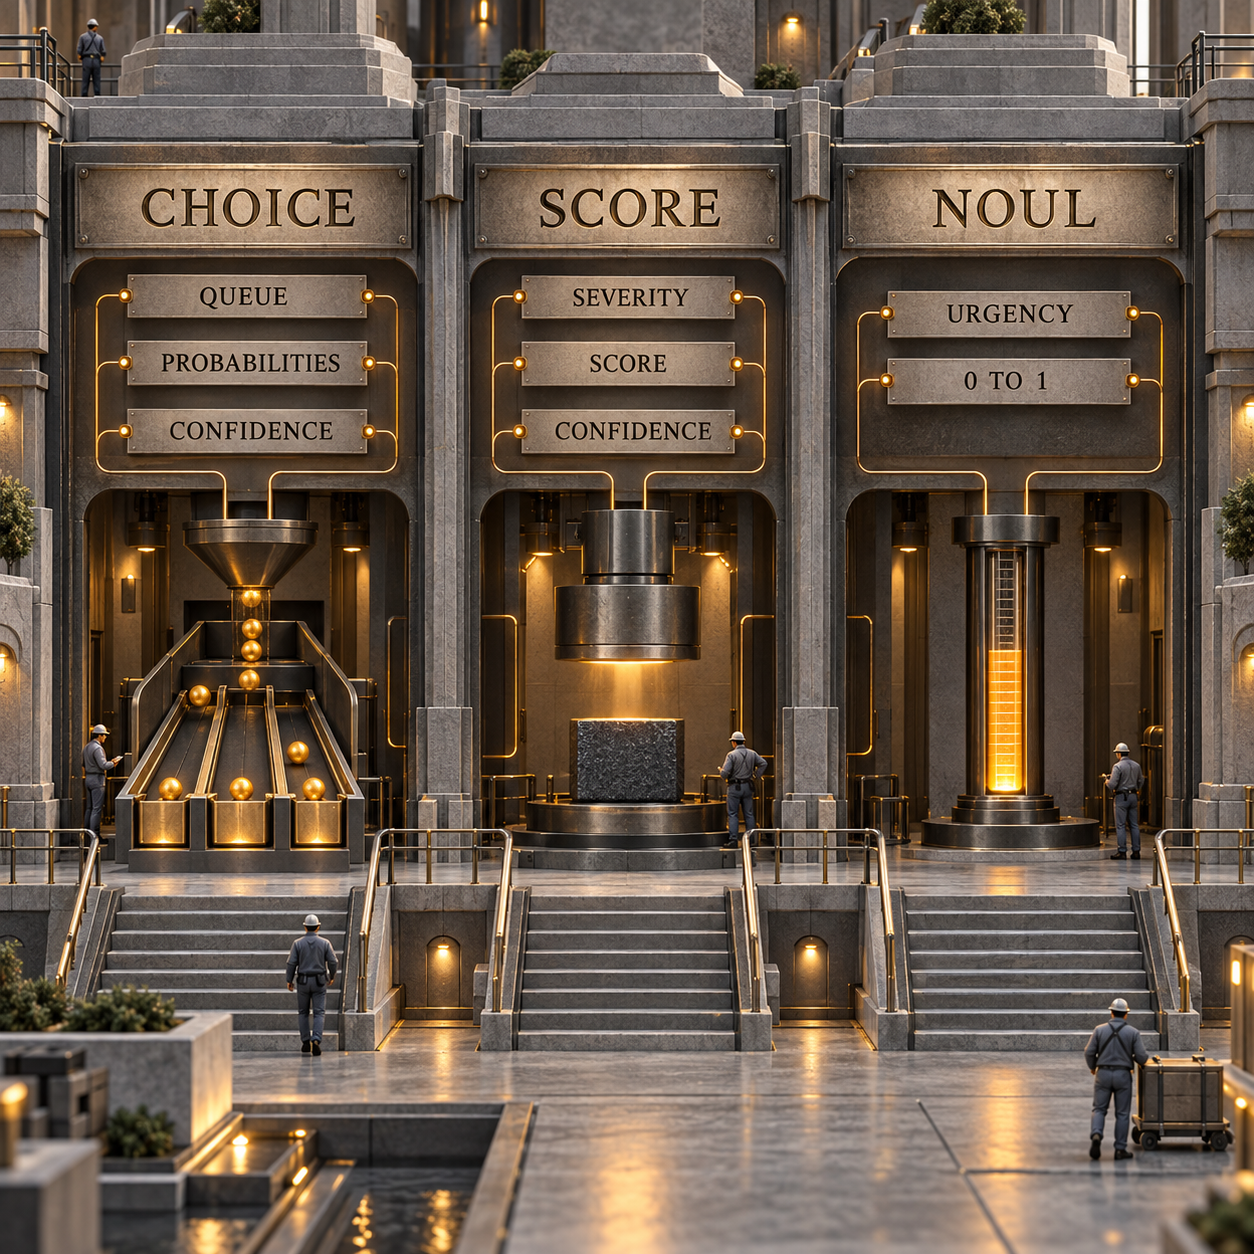
- Choice: Para qual fila predefinida este ticket deve ir?
- Score: Em que nível de uma escala ordenada está a severidade do caso?
- Noul: Qual é a probabilidade de o cliente estar demonstrando urgência?
As três perguntas podem seguir na mesma requisição e são avaliadas de forma independente com base no mesmo estado. No momento, o Jev aceita somente texto, inclusive strings e estruturas JSON formadas por texto. Ele não recebe anexos, imagens, clipes de áudio nem vídeos.
Choice, Score e Noul não são três nomes para a mesma resposta
Cada primitiva resolve um tipo diferente de pergunta. Escolher a correta importa mais do que elaborar uma instrução engenhosa.
A fila é uma Choice porque billing, technical, sales e other são alternativas. A severidade é um Score porque seus níveis formam uma escala ordenada. Já a urgência é um Noul quando a pergunta se resume a saber se a mensagem expressa pressão de tempo.
As distribuições completas são importantes. Se uma Choice atribui probabilidades parecidas a billing e technical, ela está sinalizando que a fronteira entre as filas é imprecisa. Em Choice e Score, o campo único confidence resume essa dispersão. Em um Noul, um valor próximo de 0.5 representa a zona ambígua, pois o número retornado já é a probabilidade de “sim”.
Monte o primeiro roteamento de tickets de suporte
Antes de tudo, verifique o acesso. A TypeSafe lançou o Jev em acesso antecipado em 15 de setembro de 2026, e este ambiente de publicação não tinha uma chave da TypeSafe. Uma requisição ao endpoint de modelos sem chave retornou HTTP 403 com erro de autenticação. O fluxo abaixo pode ser executado por quem tem acesso autorizado, mas nenhum resultado deste artigo é apresentado como se tivesse sido gerado nesta execução.
Use Python 3.10 ou mais recente, instale typesafe-sdk e defina TYPESAFE_API_KEY no ambiente. O SDK lê essa variável e adota jev-latest por padrão. No exemplo, o modelo aparece explicitamente para facilitar a auditoria da requisição.
from time import perf_counter

from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = {
    "id": "T-001",
    "message": (
        "Our SSO connection stopped working after renewal. "
        "The invoice is paid, but the whole team is locked out."
    ),
}

started = perf_counter()
with TypeSafeClient() as client:
    response = client.system_one(
        model="jev-latest",
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which support queue should handle `message`?",
                criteria={
                    "billing": "Invoices, payments, refunds, or subscriptions",
                    "technical": "Bugs, outages, access, or integrations",
                    "sales": "Plans, pricing, upgrades, or a new account",
                    "other": "Anything that does not clearly fit the other queues",
                },
            ),
            "severity": Score(
                instructions="How severe is the customer impact in `message`?",
                criteria=[
                    "Minor inconvenience",
                    "One person is blocked",
                    "Several users are blocked",
                    "Security risk or data loss",
                ],
            ),
            "urgent": Noul(
                instructions="Does `message` express urgency or time pressure?",
            ),
        },
    )
latency_ms = round((perf_counter() - started) * 1000, 1)

queue = response.answers["queue"]
severity = response.answers["severity"]
urgent = response.answers["urgent"]

# These are conservative test gates for this reversible workflow,
# not universal thresholds. Tune them on labelled tickets.
needs_human = (
    queue.choice == "other"
    or queue.confidence < 0.75
    or severity.confidence < 0.70
    or 0.35 < urgent.noul < 0.65
)

record = {
    "ticket_id": ticket["id"],
    "model": response.model,
    "input_tokens": response.usage.input_tokens,
    "latency_ms": latency_ms,
    "queue": queue.choice,
    "queue_probabilities": queue.probabilities,
    "queue_confidence": queue.confidence,
    "severity": severity.score,
    "severity_confidence": severity.confidence,
    "urgency_probability": urgent.noul,
    "handoff": needs_human,
}
print(record)
Os limites escolhidos acima são deliberadamente locais. Encaminhar um ticket para a fila errada costuma ser reversível, mas o custo do erro varia. Uma startup de duas pessoas pode tolerar um roteamento incorreto que seria inaceitável para a central de suporte de um hospital. A própria orientação da TypeSafe sobre confiança recomenda definir as fronteiras conforme o risco e ajustá-las com seus dados.
Há outro detalhe que merece entrar no log: jev-latest é um alias. Na data de publicação, ele aponta para jev-1.13.0, e o campo model da resposta informa qual versão realmente respondeu. Se uma versão futura alterar os resultados, um registro sem o ID resolvido do modelo não permitirá explicar a mudança.
A falha visível é uma resposta válida com o significado errado
O ticket do exemplo reúne de propósito dois sinais fortes. “Renovação” e “fatura” apontam para billing, enquanto “SSO” e “equipe sem acesso” indicam suporte técnico. Pelos critérios definidos no código, um conjunto de teste rotulado poderia considerar technical a fila correta, já que a falha de acesso é o bloqueio imediato.
Ainda assim, o Jev poderia devolver uma resposta Choice perfeitamente válida com billing. O JSON seria interpretado sem erro. O campo existiria. O valor estaria entre as opções permitidas. Mesmo assim, a resposta estaria errada em relação ao rótulo esperado.
Essa falha evidencia dois controles distintos:
- Fallback em tempo de execução: Encaminhe a uma pessoa os casos de baixa confiança, os classificados como
othere os Nouls ambíguos. - Fallback de avaliação: Compare cada decisão de teste com um rótulo humano, inclusive as decisões de alta confiança. Um limite não detecta um rótulo errado emitido com convicção.
Não confunda “saída tipada” com “acerto garantido por construção”. A segurança de tipos protege a interface entre o modelo e seu código. A precisão precisa ser medida para os tickets, rótulos, critérios, versão do modelo e idioma realmente usados.
Um teste independente e inicial de roteamento de emails reforça esse ponto. Em 1,565 emails corporativos em alemão e inglês, o profissional responsável relatou 96.4% de precisão geral para o Jev, atrás de dois modelos Gemini. No mesmo teste, os erros do Jev se concentraram nos casos de menor confiança, o que tornou útil a revisão humana seletiva. É o conjunto de dados de um único profissional, não um resultado universal de produção.
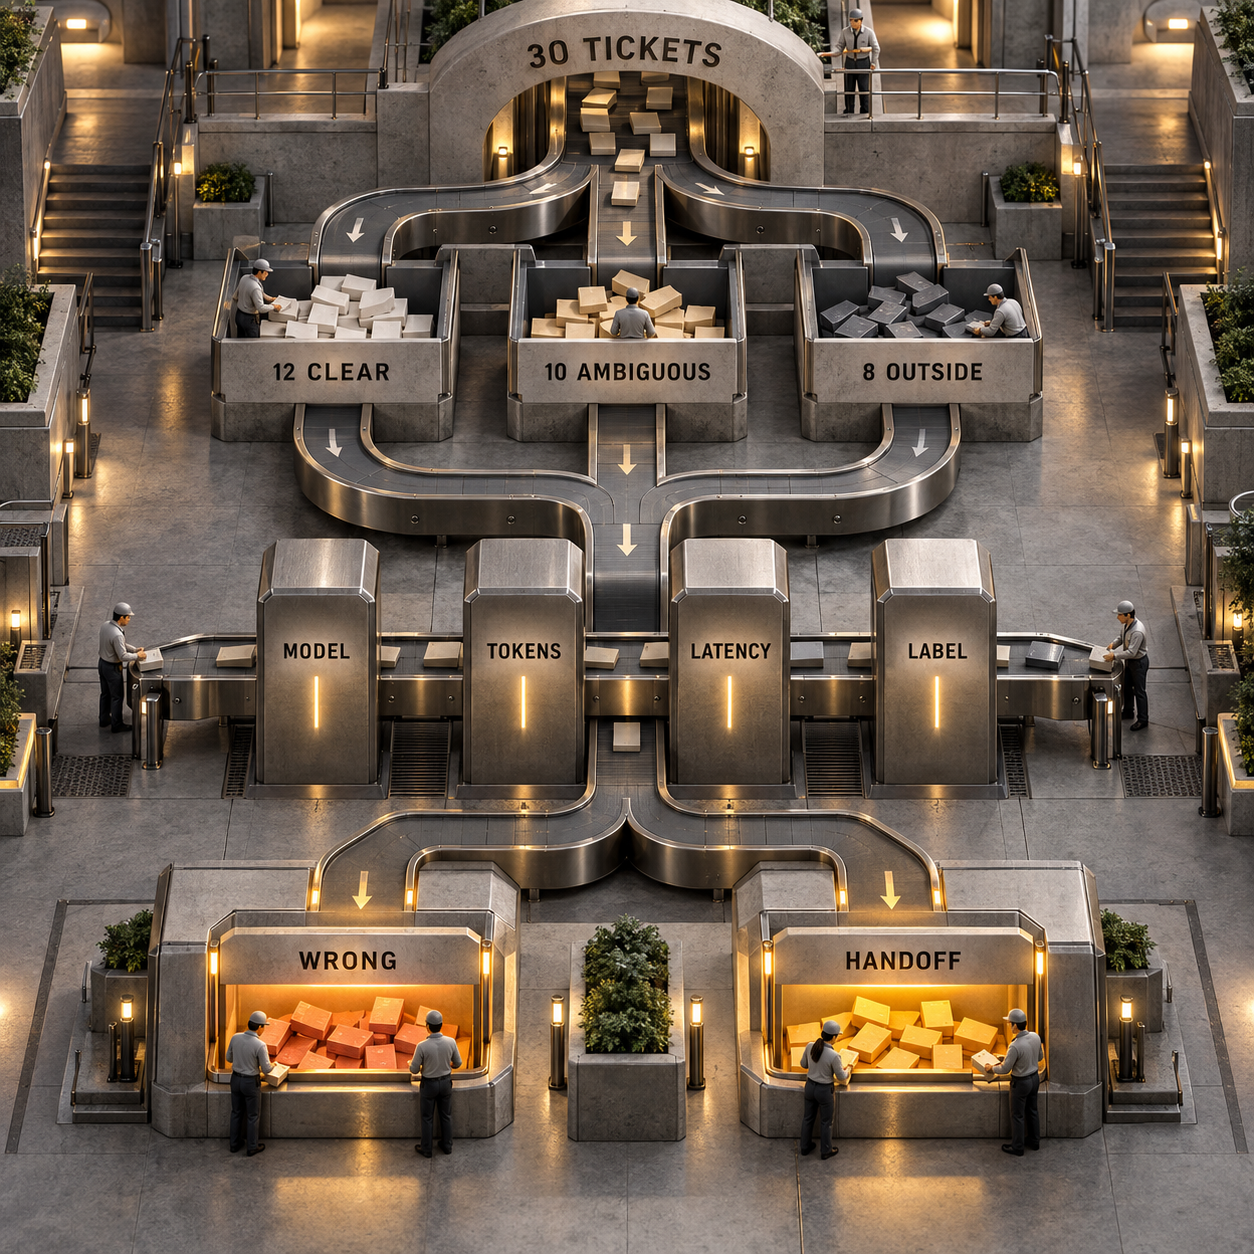
Faça um teste de fluxo com 30 tickets antes de rotear qualquer caso
Trinta tickets não comprovam a precisão em produção. Eles servem para revelar um conjunto ruim de rótulos, a ausência da rota other, uma instrução enganosa, um erro no uso dos campos da resposta ou um fallback que nunca é acionado. Encare esse exercício como uma pequena validação do fluxo, não como benchmark.
Prepare a amostra antes de consultar as respostas do Jev:
Dê a cada linha um ID de ticket estável, a fila esperada, uma justificativa curta para o rótulo e a indicação de que uma pessoa deve ou não recebê-lo. Depois, registre a versão resolvida do modelo, os tokens de entrada, a latência medida pelo cliente, a fila e as probabilidades retornadas, a severidade e sua confiança, a probabilidade de urgência, a marcação de rótulo errado e o encaminhamento efetivo.
Analise pelo menos quatro recortes separadamente:
- Rótulos errados entre os casos que o código encaminharia automaticamente
- Rótulos errados com alta confiança, pois o filtro de execução não os detectará
- Taxa de encaminhamento para revisão nos casos claros, já que cautela excessiva gera trabalho manual
- Casos fora do escopo que não foram direcionados para
other
Se o acesso ainda estiver sujeito a lista de espera, deixe a amostra e o script prontos. Não preencha as colunas de resultado com valores retirados da documentação ou do teste de outra pessoa. O artefato honesto é uma planilha de execução bloqueada por acesso, acompanhada de código executável.
O cálculo de custo muda a classificação, não toda a operação de suporte
O Jev 1.13 custa $0.042 por milhão de tokens de entrada, sem cobrança pela saída. Nessa tarifa, um ticket hipotético com 500 tokens de entrada custa $0.000021 em processamento do modelo. Cem mil tickets desse tamanho custariam $2.10.
O número chama atenção, mas não equivale ao preço de substituir um software de atendimento. O Zendesk começa em $19 por agente ao mês no plano anual, enquanto o Intercom parte de $29 por assento ao mês e cobra a partir de $0.99 por resultado do Fin. Esses produtos incluem caixas de entrada, armazenamento de tickets, interfaces para agentes, relatórios e outras estruturas operacionais. O Jev fornece apenas o sinal de decisão.
A premissa de orçamento que muda é mais restrita: a classificação semântica repetitiva deixa de exigir uma chamada cara a um modelo generativo em todos os casos. O dinheiro e o esforço migram para integração, exemplos rotulados, monitoramento, tratamento de exceções e as pessoas que recebem os encaminhamentos. Em volumes comuns de atendimento, a economia bruta de inferência pode valer menos do que saber quais tickets o próprio modelo considera incertos.
Há uma divisão de trabalho útil aqui. O Jev pode escolher uma rota; um modelo generativo pode preparar o texto. Para o lado da resposta nesse fluxo, veja como o ChatGPT pode preparar respostas do Zendesk com base no histórico do ticket. Ainda cabe ao código da aplicação impor políticas, permissões e ações.
Sete fluxos, classificados por quem mais se beneficia
Estas são aplicações possíveis de um modelo de decisão restrito, não resultados observados.
O Jev funciona melhor quando as respostas possíveis são conhecidas, a decisão se repete com frequência e os efeitos de uma ramificação errada podem ser contidos. Ele é uma escolha ruim quando a saída precisa ser uma resposta, explicação, cálculo, comparação exata de datas ou uma longa cadeia de raciocínio.
Dois produtos que vale a pena construir
1. Uma camada de roteamento de suporte controlada por confiança
Esta é a oportunidade mais promissora. Venda uma camada fina de roteamento para equipes que já usam uma central de atendimento, mas ainda classificam tickets manualmente ou mantêm regras frágeis baseadas em palavras-chave. A solução leria o ticket, aplicaria a escala de filas da própria equipe, gravaria a fila selecionada e as probabilidades de volta na central e enviaria casos incertos ou sem correspondência para uma pessoa.
A demanda é específica o bastante para ser relevante: customer service automation recebe cerca de 880 buscas mensais nos EUA, enquanto help desk automation e customer support automation recebem cerca de 260 cada. As plataformas de suporte existentes começam na faixa de $19 a $29 por assento ao mês, então a proposta não é “substitua sua central de atendimento”. É “torne mensurável uma decisão de roteamento dentro da central pela qual você já paga”.
A menor versão comercializável precisa de um conector, quatro definições editáveis de fila, uma rota other, faixas de confiança, uma caixa de revisão e um relatório semanal de rótulos errados. O desafio está na implantação. Cada cliente define as fronteiras entre filas de um jeito, e um esquema genérico se torna a causa das falhas do próprio produto. A vantagem competitiva está no ciclo de avaliação e feedback, não na chamada à API.
2. Um console de QA para roteamento em modo sombra
Venda a camada de segurança antes da automação. O líder de suporte envia tickets rotulados, executa um esquema candidato de perguntas sem alterar as atribuições em produção e recebe contagens da matriz de confusão, erros de alta confiança, taxas de encaminhamento, comparações entre versões e uma lista dos casos que precisam de critérios melhores.
As mesmas 260 buscas mensais por help desk automation mostram interesse nessa tarefa, enquanto um CPC de $129.46 para customer support automation sinaliza que os fornecedores atribuem valor comercial a esse tráfego. O MVP pode reunir importação de CSV, chamada direta ao Jev, revisão lado a lado dos rótulos e exportação do registro de decisões. Primeiro, ele deve dar suporte ao teste com 30 tickets; depois, a conjuntos privados maiores.
O risco é a equipe interpretar um painel bem-acabado como garantia estatística. O produto precisa deixar claro o que uma amostra pequena consegue ou não demonstrar, proteger os dados dos tickets e evitar apresentar confiança como se fosse precisão comprovada. É um bom produto complementar à camada de roteamento, mas uma opção mais fraca como negócio independente porque a avaliação acontece de forma esporádica.
Limites que devem interromper o projeto
Não use o Jev quando precisar de texto em prosa, uma resposta ao cliente, código ou uma explicação do raciocínio. Ele também não é o lugar certo para aritmética, contagem, comparação de datas ou regras determinísticas de elegibilidade que o código comum consegue executar com exatidão.
A documentação aponta que o Jev 1.13 é mais fraco diante de armadilhas de interpretação literal, referências indiretas, contexto irrelevante, conteúdo adversarial, instruções contraditórias e precisão numérica. Seu principal idioma de treinamento é o inglês, e a precisão documentada é menor em outros idiomas. Antes que o Jev possa receber um anexo, outro sistema precisa convertê-lo em texto.
O limite de contexto é de 64,000 tokens para a requisição inteira, com um segundo limite de 32,000 tokens para o estado somado à pergunta mais longa. Trate esses valores como tetos, não como metas. A orientação oficial alerta que estados com informações irrelevantes podem reduzir a precisão; recupere apenas a política e os dados do ticket necessários para as perguntas atuais.
O limite inegociável é a consequência. Um rótulo de suporte pode ser revertido. Um reembolso, uma suspensão de conta, uma decisão de contratação, uma prioridade médica ou uma transferência de dinheiro não é apenas um rótulo. Mantenha ações de alto impacto atrás de verificações determinísticas, confirmação, uma pessoa qualificada ou um sistema projetado e validado para aquele domínio.
O que fazer na segunda-feira
Se você lidera operações de suporte, exporte 30 tickets recentes na segunda-feira de manhã. Antes que alguém veja a saída do modelo, rotule 12 exemplos claros, 10 ambíguos e 8 fora do escopo. Solicite o acesso antecipado, execute o script em modo sombra quando receber uma chave e analise os casos errados de alta confiança antes de ajustar qualquer limite. Não conecte o resultado ao roteamento em produção enquanto o rótulo humano, a versão do modelo e o desfecho do fallback não estiverem no mesmo registro.
O que é a IA Jev?
Jev é o modelo de decisão da TypeSafe AI para fluxos de software estruturados. Ele lê texto ou um estado estruturado em texto e, em vez de gerar prosa, retorna respostas restritas de Choice, Score e Noul com probabilidades.
De onde vem o nome Jev?
Segundo a TypeSafe, o nome faz referência a William Stanley Jevons. Já a designação mais ampla “System One” remete ao lado rápido e intuitivo da distinção entre Sistema 1 e Sistema 2.
Como usar o Jev em vídeo?
Vídeos podem ajudar na orientação inicial, mas a implementação deve partir da documentação atual da API e do SDK da TypeSafe, pois campos da requisição, aliases de modelo, acesso e limites podem mudar. O fluxo direto é: obter uma chave autorizada, enviar o estado com perguntas tipadas, inspecionar as distribuições retornadas e manter o fallback no código.
Se você quer criar um fluxo de suporte controlado por confiança com base nas regras de fila e nos tickets da sua operação, o caminho certo é o serviço de desenvolvimento de IA para atendimento ao cliente.
- Última atualização
- 21 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.
Claude Code + AGENTS.md: como ativar a leitura nativa
Aprenda a fazer o Claude Code ler AGENTS.md nativamente, escolher o modo certo, evitar conflitos com CLAUDE.md e validar tudo em uma sessão nova.19 de set. de 2026Build
Claude Code MCP: como ajustar o timeout de inicialização
Aprenda a definir o tempo de espera inicial do Claude Code MCP, separar os quatro limites e impedir que automações prossigam sem servidores essenciais.17 de set. de 2026Build
Cloudflare: como bloquear treinamento de IA sem prejudicar a busca
Configure o Cloudflare para bloquear treinamento de IA sem perder indexação. Veja o ajuste correto, valide o robots.txt e evite bloquear Googlebot e Bingbot.16 de set. de 2026Build
Digitação por voz com Murmure: análise do app offline
Testei o Murmure para digitação por voz offline, com dicionário, regras e LLM opcional. Veja onde ele acerta, quais limites pesam e para quem serve.14 de set. de 2026Build
FFmpeg API da RenderIO: preços, créditos e limites
FFmpeg API da RenderIO: veja preços, cobrança por créditos, limites técnicos e quando compensa migrar entre os planos Starter, Growth e Business.14 de set. de 2026Build
Transcrição de voz com Dictare: preço e custo real
Veja quanto custa o Dictare, o que a transcrição de voz local inclui e quais despesas com agente, máquina e manutenção entram no custo real.13 de set. de 2026Build
Como testar plugins do Claude Code e medir sua contribuição
Veja como testar plugins do Claude Code com evals nativos, comparar resultados com um controle sem plugin e limitar custos antes de levar o teste ao CI.12 de set. de 2026Build