客服工单自动分配:Jev AI 置信度门控实战
想把客服工单自动分配接入现有系统?本文用一个可运行的 Jev AI 路由方案,讲清 Choice、Score 与 Noul 的返回结构、置信度门控、人工兜底和 30 条工单的影子测试,并拆解成本、适用边界与两个可落地的产品方向,同时说明如何记录模型版本、概率、延迟和错误标签,让团队在不交出最终控制权的前提下安全上线。

客服工单自动分配,不必从复杂的自主 Agent 做起。Jev 能把一条杂乱的求助消息变成软件可以立即使用的三类信号:该进哪个队列、严重程度有多高,以及工单是否紧急的概率。关键不只是答案以类型化字段返回,而是代码可以检查和记录这些字段,并在结果不值得信任时主动停下来。
第一步只做一个可撤销的任务:分配工单,同时在代码里保留人工审核队列。Jev 保证返回结果符合预定结构,却不保证 billing 一定判断正确。能否分清这两件事,决定了你做出来的是演示,还是能真正运行的工作流。
客服工单自动分配先从一个决策开始,别急着造自主客服 Agent
Jev 是决策模型,不是聊天机器人。你向它发送一段文本,或一份名为 state 的结构化 JSON,再提出答案形态已预先限定的问题。它返回的是值和概率,而不是一段回复。TypeSafe 将其称为 System One 模型:它的定位是在常规软件中快速完成范围明确的判断。
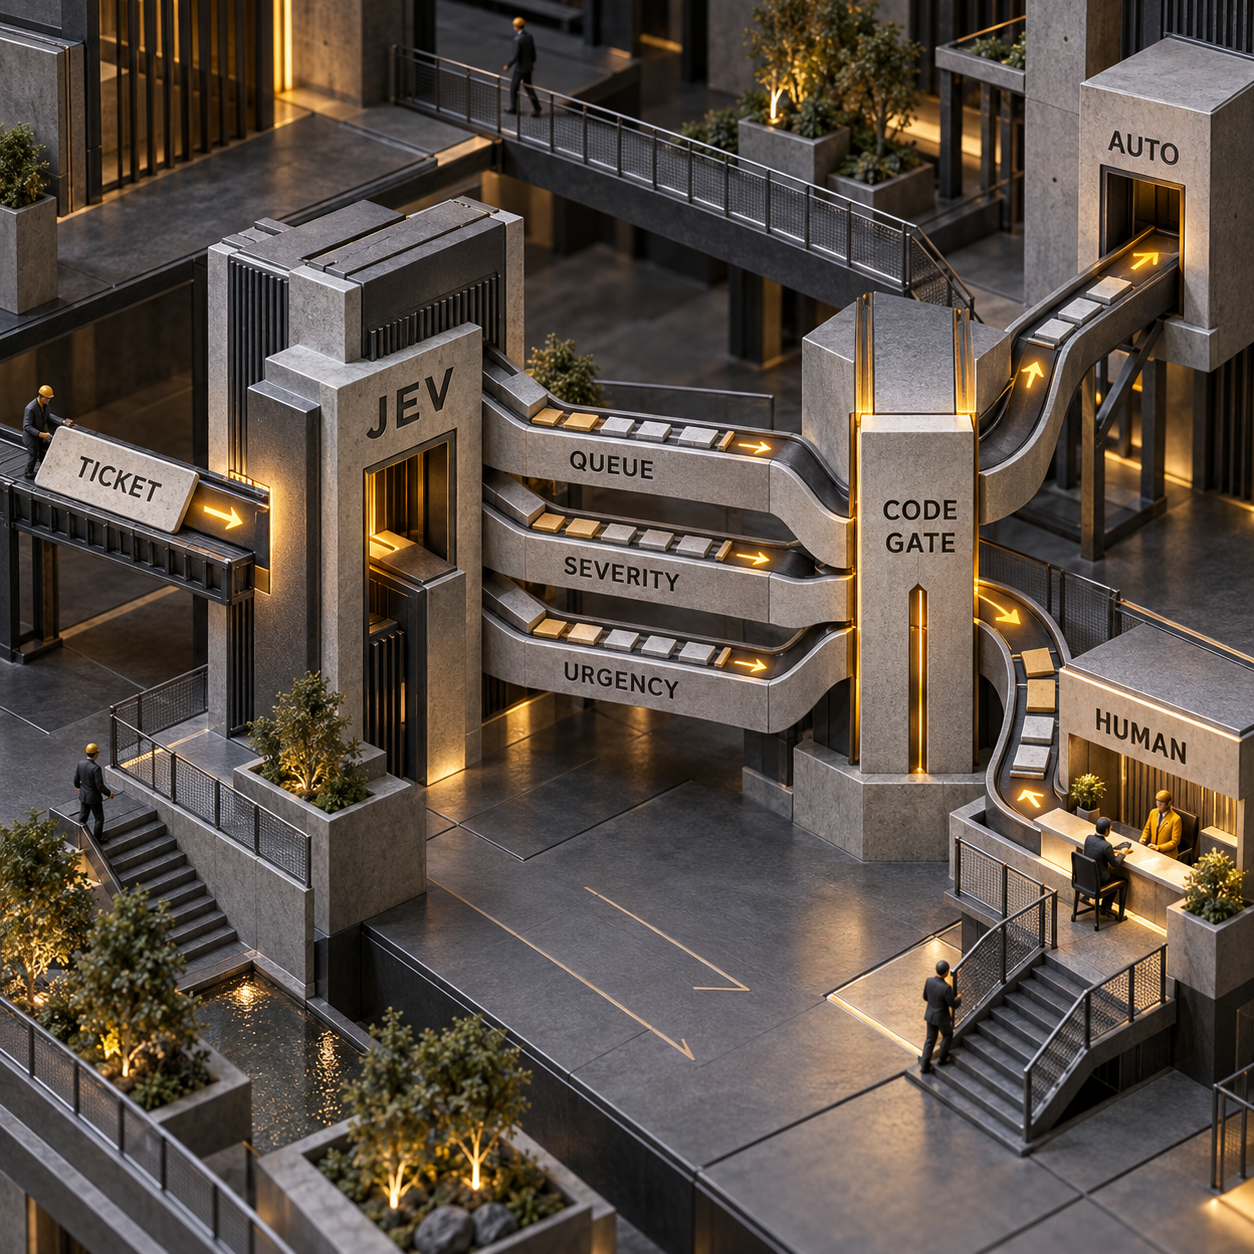
可以把它理解成一个语义交换机。普通 if 语句适合检查精确事实,例如发票是否逾期;Jev 负责处理模糊部分,例如客户的措辞是否显得紧迫,之后再把控制权交还给普通代码。
搭建第一条客服工作流时,先给它一张工单,并提出三个问题:
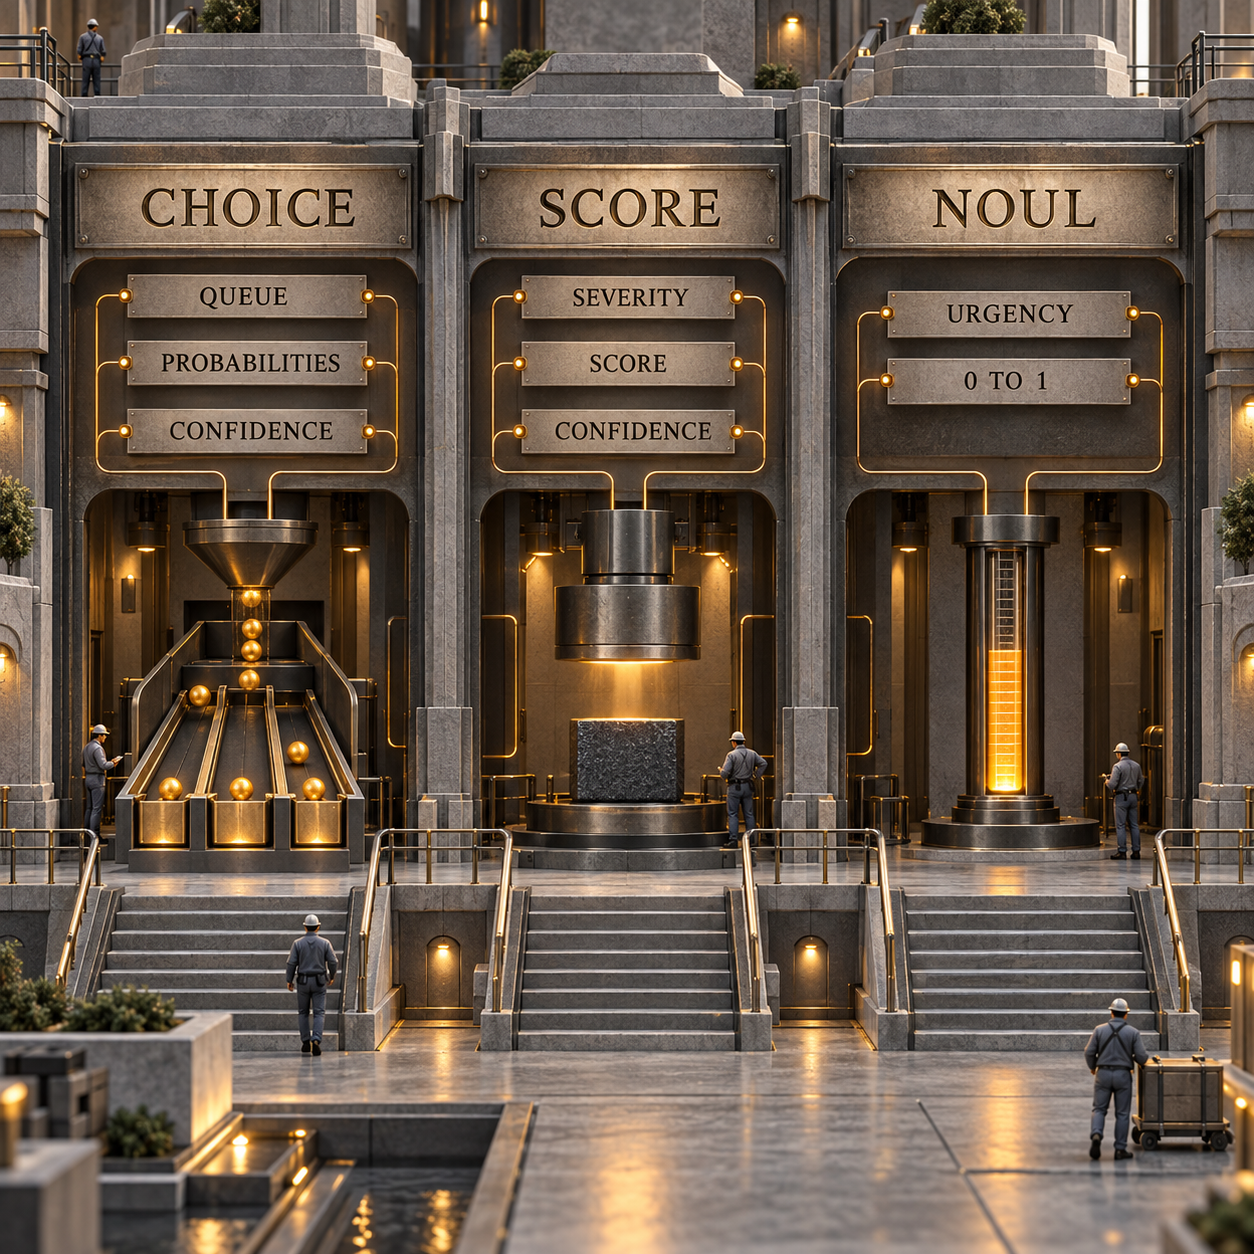
- **Choice:**这张工单应该进入哪个固定队列?
- **Score:**按一套有顺序的标准,它的严重程度位于哪一级?
- **Noul:**客户正在表达紧迫感的概率有多高?
三个问题可以放进同一个请求,并基于同一份 state 独立评估。目前 Jev 只接受文本,包括字符串和由文本组成的 JSON 结构;附件、图片、音频和视频都不能直接作为输入。
Choice、Score 和 Noul 解决的不是同一个问题
每种原语对应一种不同的提问方式。选对原语,比琢磨花哨的措辞更重要。
队列适合用 Choice,因为 billing、technical、sales 和 other 是互斥选项;严重程度适合用 Score,因为各级别构成有序标准;如果只需要判断消息是否在表达时间压力,紧急性就适合用 Noul。
不要只看最终答案,完整的概率分布同样重要。如果 Choice 给 billing 和 technical 分配了相近的概率,说明队列边界并不清晰。对于 Choice 和 Score,单独的 confidence 字段会概括这种分布;对于 Noul,返回值本身就是“是”的概率,因此接近 0.5 的区域代表判断模糊。
搭建第一条工单路由
先确认是否有访问权限。TypeSafe 于 2026 年 9 月 15 日以 early access 形式发布 Jev,而本文发布环境没有 TypeSafe 密钥。未携带密钥请求 models 端点时,服务器返回了 HTTP 403 和认证错误。下面的工作流在获得授权后即可运行,但本文不会把任何结果说成是本次写作过程中实际执行所得。
请使用 Python 3.10 或更高版本,安装 typesafe-sdk,并在环境变量中设置 TYPESAFE_API_KEY。SDK 会读取该变量,默认使用 jev-latest。下面显式指定模型,便于审计每次请求。
from time import perf_counter

from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = {
    "id": "T-001",
    "message": (
        "Our SSO connection stopped working after renewal. "
        "The invoice is paid, but the whole team is locked out."
    ),
}

started = perf_counter()
with TypeSafeClient() as client:
    response = client.system_one(
        model="jev-latest",
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which support queue should handle `message`?",
                criteria={
                    "billing": "Invoices, payments, refunds, or subscriptions",
                    "technical": "Bugs, outages, access, or integrations",
                    "sales": "Plans, pricing, upgrades, or a new account",
                    "other": "Anything that does not clearly fit the other queues",
                },
            ),
            "severity": Score(
                instructions="How severe is the customer impact in `message`?",
                criteria=[
                    "Minor inconvenience",
                    "One person is blocked",
                    "Several users are blocked",
                    "Security risk or data loss",
                ],
            ),
            "urgent": Noul(
                instructions="Does `message` express urgency or time pressure?",
            ),
        },
    )
latency_ms = round((perf_counter() - started) * 1000, 1)

queue = response.answers["queue"]
severity = response.answers["severity"]
urgent = response.answers["urgent"]

# These are conservative test gates for this reversible workflow,
# not universal thresholds. Tune them on labelled tickets.
needs_human = (
    queue.choice == "other"
    or queue.confidence < 0.75
    or severity.confidence < 0.70
    or 0.35 < urgent.noul < 0.65
)

record = {
    "ticket_id": ticket["id"],
    "model": response.model,
    "input_tokens": response.usage.input_tokens,
    "latency_ms": latency_ms,
    "queue": queue.choice,
    "queue_probabilities": queue.probabilities,
    "queue_confidence": queue.confidence,
    "severity": severity.score,
    "severity_confidence": severity.confidence,
    "urgency_probability": urgent.noul,
    "handoff": needs_human,
}
print(record)
上面的阈值是针对这个具体场景有意设置得较保守,并不适用于所有项目。分错客服队列通常可以挽回,但实际代价仍因业务而异。两人规模的创业团队或许能接受一次误分,医院服务台却未必可以。TypeSafe 自己的置信度指南也明确指出,边界应由风险决定,并用自己的数据调优。
还有一个字段值得记录:jev-latest 是别名。本文发布时,它指向 jev-1.13.0;响应中的 model 字段会告诉你真正作答的是哪个版本。如果后续版本让结果发生变化,一份没有记录解析后模型 ID 的日志将无法解释原因。
最危险的失败:格式完全正确,语义却判断错了
示例工单故意放入了两组强信号。“Renewal”和“invoice”指向 billing,而“SSO”和“locked out”指向 technical support。按照代码中的分类标准,一套带人工标签的测试集可能会把 technical 定为正确队列,因为眼下真正阻塞客户的是无法访问系统。
即便如此,Jev 仍可能返回一个格式完全有效的 billing Choice。JSON 可以正常解析,字段确实存在,值也属于允许的选项,但对照人工标签,它依然是错的。
这个失败暴露出两道必须分别设置的控制:
- **运行时兜底:**把低置信度、
other和 Noul 模糊区间的案例交给人工处理。 - **评估时兜底:**让每个测试决策都与人工标签对照,包括高置信度结果。阈值拦不住“非常自信但标签错误”的判断。
不要把“类型安全”误解成“准确性由结构自动保证”。类型安全保护的是模型与代码之间的接口;准确率则必须针对你实际使用的工单、标签、标准、模型版本和语言逐一测量。
一项独立的早期邮件路由测试说明了这一点。在 1,565 封德语和英语商务邮件上,该实践者报告 Jev 的整体准确率为 96.4%,落后于两个 Gemini 模型。同一测试还发现,Jev 的错误更多集中在较低置信度区间,因此选择性人工审核确有价值。不过,这只是一位实践者的数据集,不能当作普遍的生产环境结论。
自动分配前,先用 30 条工单检查工作流
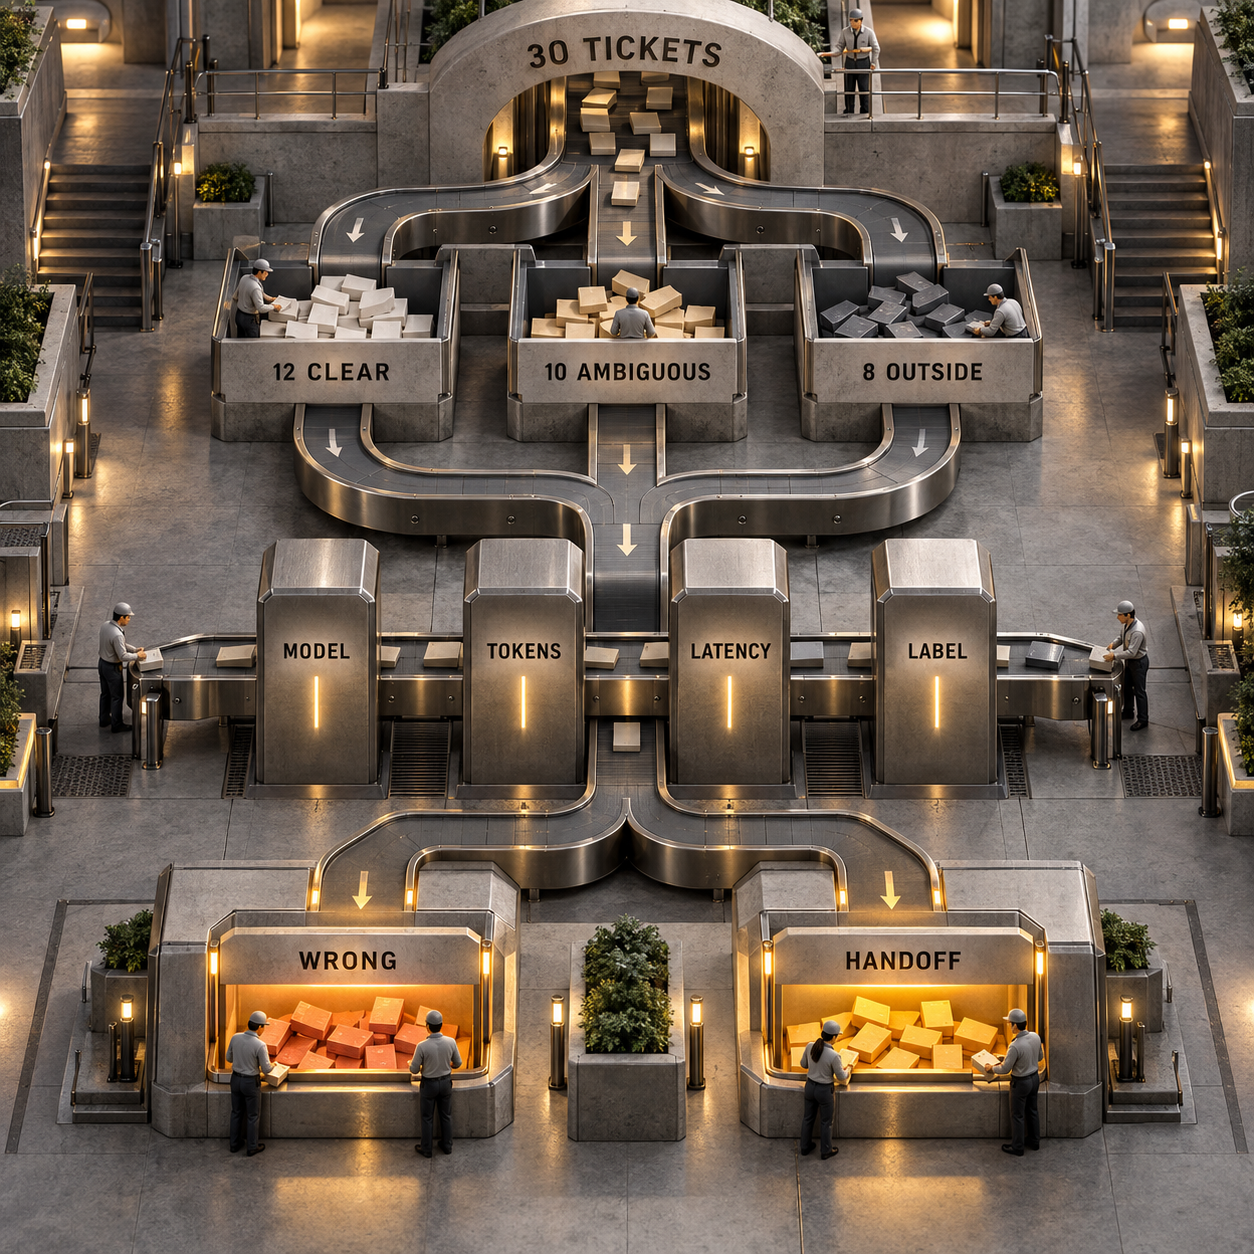
30 条工单不足以证明生产准确率,却足以暴露标签集合设计不佳、缺少 other 路径、指令误导、响应字段用错,或者兜底逻辑从不触发等问题。把它当成一次小型工作流检查,而不是基准测试。
在查看 Jev 输出前,先准备好测试样本:
为每一行分配稳定的工单 ID、预期队列、该标签的简短理由,以及是否应转交人工。随后记录解析后的模型版本、输入 token 数、客户端测得的延迟、返回的队列与概率、严重程度及其置信度、紧急概率、标签是否错误,以及是否真的触发人工交接。
至少分别检查以下四个切片:
- 被代码自动分配、但标签错误的案例
- 高置信度错标案例,因为运行时门控无法拦住它们
- 清晰案例的人工交接率,因为过度谨慎会制造额外人工工作
- 没有落入
other的超范围案例
如果访问权限仍在候补名单中,就先把样本和脚本准备好。不要用文档或他人测试里的数值填充结果列。诚实的交付物应该是一份注明“因访问权限受阻”的运行表,以及可以执行的代码。
成本变化的是分类环节,不是整套客服系统
Jev 1.13 的价格是每百万输入 token $0.042,输出不计费。按这个单价,一张假设含 500 个输入 token 的工单,模型输入成本为 $0.000021;同等大小的 100,000 张工单合计为 $2.10。
这个数字很抢眼,但它不是客服软件的替代价格。Zendesk 按年付费的起价为每位 Agent 每月 $19;Intercom 的起价为每个席位每月 $29,此外每次 Fin outcome 从 $0.99 起。这些产品包含收件箱、工单存储、Agent 操作界面、报告及其他运营基础设施,而 Jev 只提供决策信号。
真正变化的预算假设更窄:重复性的语义分类,不再需要每次都调用昂贵的生成式模型。费用和精力会转向集成、带标签样本、监控、异常处理,以及接手人工交接的人员。在普通收件箱规模下,单纯节省推理费的价值,可能还不如明确知道模型对哪些工单没有把握。
这里可以形成清晰的分工:Jev 负责选择路线,生成式模型负责组织语言。如果要搭建工作流的回复环节,可以参考用 ChatGPT 根据工单历史生成 Zendesk 回复。策略、权限和实际动作仍应由应用代码强制执行。
7 类工作流:按受益程度排序
以下是受约束决策模型可能适用的场景,并非已经报告的成效。
当候选答案已知、决策需要高频重复,而且错误分支可被控制时,Jev 最能发挥作用。如果输出必须是一段回复、解释、计算结果、精确日期比较或很长的推理链,它就不适合。
两个值得做成产品的方向
1. 带置信度门控的客服路由改造层
这是最值得优先验证的机会。面向已经使用 help desk、却仍靠人工分拣工单或脆弱关键词规则的团队,销售一层轻量路由能力。它读取工单,应用团队自己的队列标准,把选中的队列和概率写回 help desk,并将不确定或无法匹配的案例交给人工。
搜索需求足够具体:customer service automation 在美国每月约有 880 次搜索,help desk automation 和 customer support automation 则分别约有 260 次。现有客服平台的每席位月费起点约为 $19 至 $29,因此销售话术不该是“替换你的 help desk”,而应该是“在你已经付费使用的 help desk 内,让一个路由决策变得可测量”。
最小可售版本需要一个连接器、四个可编辑的队列定义、一条 other 路径、置信度区间、审核收件箱和每周错标报告。真正的难点在上手配置:每个客户划分队列的边界都不同,通用结构反而会成为产品的失败点。护城河是评估与反馈闭环,而不是一次 API 调用。
2. 影子模式的路由质检控制台
先卖安全层,再卖自动化。客服负责人上传带标签工单,在不改变线上分配的前提下运行候选问题结构,得到混淆统计、高置信度错误、人工交接率、版本对比,以及需要改进判断标准的案例清单。
help desk automation 同样每月约 260 次的搜索量,说明市场对这项工作有兴趣;而 customer support automation 的 CPC 高达 $129.46,则表明厂商高度重视这类商业流量。MVP 可以由 CSV 导入、直接调用 Jev、并排审核标签和可导出的决策日志组成。先支持 30 条工单的检查,再扩展到更大的私有数据集。
风险在于,团队可能会从一个做得很精致的仪表盘中期待统计保证。产品必须明确小样本能证明什么、不能证明什么,保护工单数据,并避免把置信度包装成真实准确率。它很适合作为路由改造层的配套产品;但评估工作并非持续发生,因此单独成业务时吸引力较弱。
哪些限制意味着应该立刻停手
如果需要的是文案、客户回复、代码或推理说明,就不要使用 Jev。算术、计数、日期比较,以及普通代码可以精确处理的确定性资格规则,也不该交给它。
文档显示,Jev 1.13 在应对字面陷阱、间接表达、无关上下文、对抗性内容、相互矛盾的指令和数值精度时较弱。其主要训练语言是英语,其他语言的文档准确率更低。附件必须先由另一个系统转成文本,Jev 才能读取。
整个请求的上下文上限是 64,000 token;此外,state 与最长问题合计还有 32,000-token 的限制。它们应该被视为天花板,而不是目标。官方指南警告,无关 state 可能降低准确率,因此只应检索当前问题需要的策略和工单信息。
真正的硬性边界在于后果。客服标签可以撤销;退款、账号停用、招聘决定、医疗优先级或资金转移则不只是“贴个标签”。高后果动作必须置于确定性检查、确认流程、具备资质的人员,或为相应领域设计并完成验证的系统之后。
周一应该怎么开始
如果你负责客服运营,周一早上先导出最近的 30 条工单。在任何人查看模型输出前,标注 12 条清晰案例、10 条模糊案例和 8 条超范围案例。申请 early access,拿到密钥后以影子模式运行脚本;先检查那些高置信度错标,再调整阈值。在人工标签、模型版本和兜底结果没有同时写入同一份日志之前,不要把结果接入线上路由。
Jev AI 是什么?
Jev 是 TypeSafe AI 面向结构化软件工作流推出的决策模型。它读取文本或结构化文本 state,返回受约束的 Choice、Score 和 Noul 答案及其概率,而不是生成一段文案。
Jev 这个名字是什么意思?
TypeSafe 表示,这个名字来自 William Stanley Jevons。更宽泛的“System One”名称,则指 System 1 与 System 2 区分中快速、直觉的一侧。
Jev 怎么用:有没有视频教程?
视频可以帮助快速了解产品,但实现时应从 TypeSafe 最新的 API 和 SDK 文档入手,因为请求字段、模型别名、访问权限和限制都可能变化。最直接的流程是:获取授权密钥,发送 state 与类型化问题,检查返回的概率分布,并把兜底逻辑留在代码里。
如果你希望按照真实的队列规则和工单搭建一套置信度门控客服工作流,可以从 AI 客服开发开始。
- 最近更新
- 2026年9月21日
- 分类
- Build
在 Google 中优先显示本站


把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。
Claude Code 读取 AGENTS.md:原生支持的正确配置方式
Claude Code 读取 AGENTS.md 已有原生方案,但版本、项目指令优先级、配置模式和服务提供商都会影响结果。本指南梳理 v2.1.277 的加载规则,讲清 CLAUDE.md 与 AGENTS.md 如何取舍、怎样启用双文件模式、何时保留导入桥接,并用无害探针验证新会话到底加载了哪份项目指令。2026年9月19日Build
Claude Code MCP 启动超时:四类超时怎么配
Claude Code 2.1.274 新增 CLAUDE_CODE_MCP_STARTUP_WAIT_MS,用于限制首轮非交互执行等待 MCP 服务器的时间。本文讲清它与 MCP_TIMEOUT、工具调用超时和任务截止时间的区别,并提供可复现测试、CI 就绪门禁及自动化场景配置建议,让定时任务在依赖未就绪时快速失败。2026年9月17日Build
Cloudflare 屏蔽 AI 爬虫:保留搜索,拒绝训练
Cloudflare 已重新定义 Training 下的 Block:它可能连 Googlebot、Applebot 和 Bingbot 的搜索抓取一并拦截。本文说明如何允许 Search、选择 Disallow AI Training,核对迁移设置、robots.txt 与爬虫活动,在拒绝模型训练的同时保留搜索收录。2026年9月16日Build
Murmure 语音转文字实测:离线听写值不值得用?
实测 Murmure 1.11.3:免费、离线的桌面语音转文字工具如何用 Parakeet、词典和格式化规则处理技术术语与文件路径。本文还对比 Windows、macOS、Linux 的安装限制,本地与远程 LLM 的隐私边界、速度表现、API 能力和 $0 定价,帮你判断它是否适合日常听写与开发工作流。2026年9月14日Build
RenderIO FFmpeg API 定价拆解:套餐、积分与升级临界点
RenderIO FFmpeg API 每月 $12 起。本文完整拆解 Starter、Growth 与 Business 的命令积分、链式任务、视频下载计费、运行时、存储及 webhook 限制,并算清 838、2,201 等关键升级临界点,帮助你判断何时继续支付超额费、何时换档更省钱。2026年9月14日Build
Dictare 价格拆解:这款语音转文字软件真的零成本吗?
Dictare 是面向编程智能体的免费本地语音转文字软件。本文拆解其 $0 定价、安装与硬件隐性成本,并与 Spokenly 和 Wispr Flow 的免费及付费方案逐项比较,还提供一套可直接套用的成本公式,帮你判断本地运行的所有权成本与托管订阅的跨平台便利,哪一个更适合你的开发工作流。2026年9月13日Build
Claude Code 插件评测实战:用原生 Evals 验证行为变化
Claude Code 2.1.269 已原生支持插件评测。本文从创建行为用例、配置确定性 grader、读取 WITH/W/OUT/Δ 报告,到故意制造回归、控制成本并接入 CI,完整演示如何证明插件确实改变了 Claude 的行为,而不只是通过文件校验,并给出最值得优先测试的场景和两类产品机会。2026年9月12日Build