Automatisation service client : router les tickets avec Jev
Automatisation service client avec Jev : routez les tickets, interprétez la confiance du modèle et basculez les cas ambigus vers un agent humain.

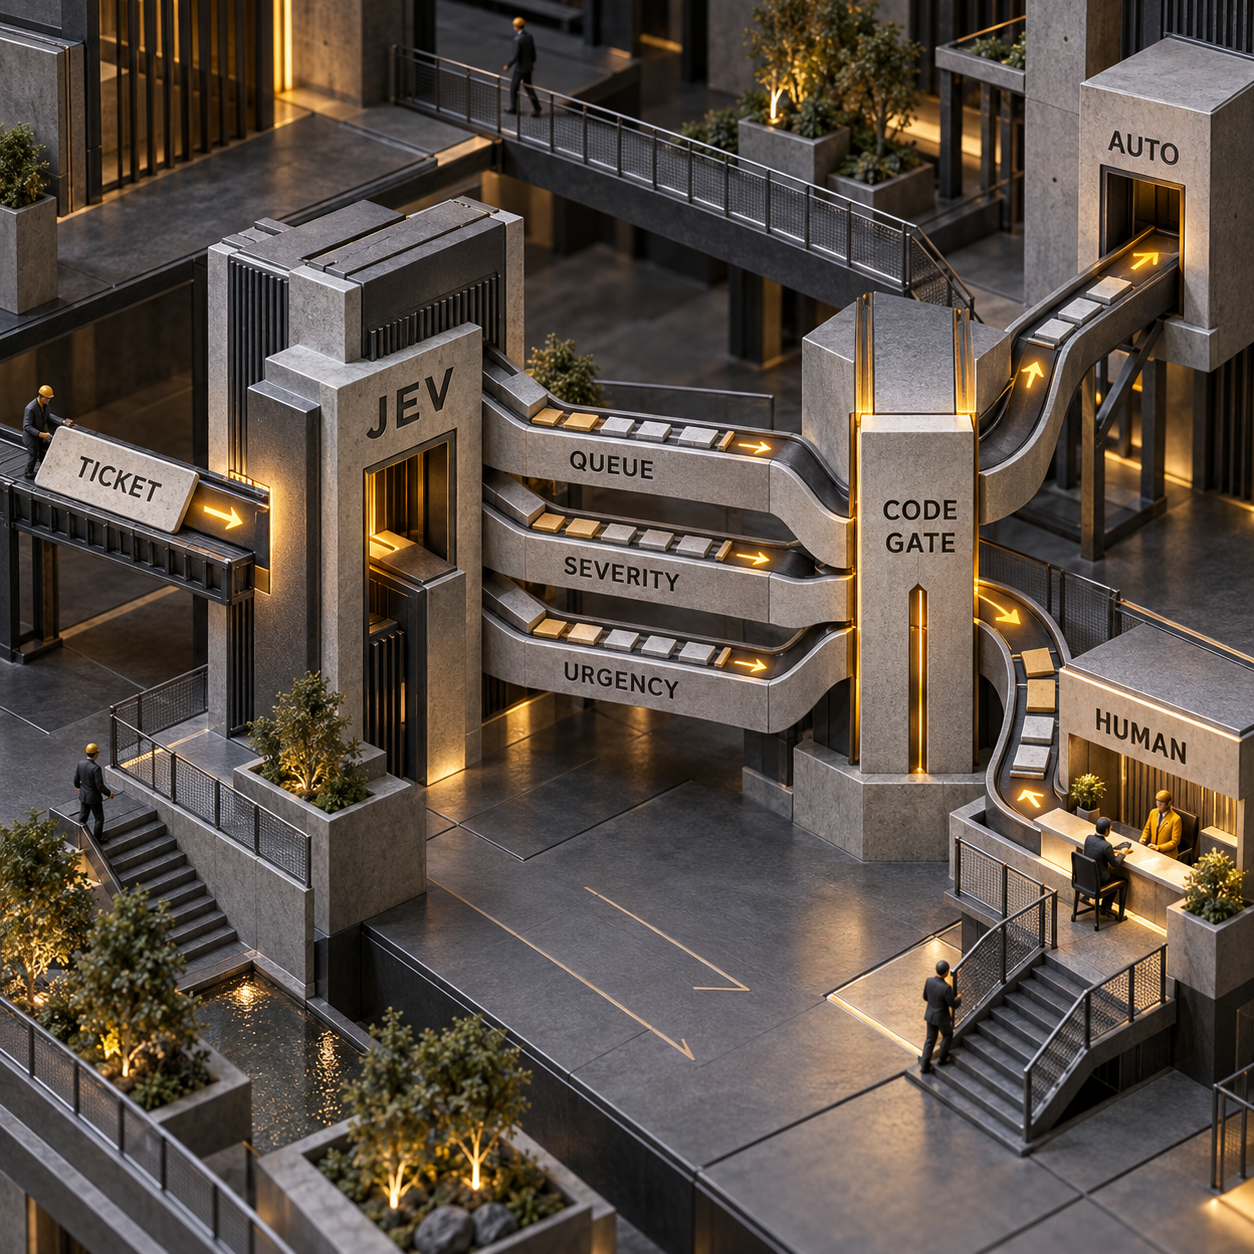
Dans un workflow d’automatisation service client, Jev peut transformer un message confus en trois signaux immédiatement exploitables par votre logiciel : une file d’attente, un score de gravité et la probabilité que le ticket soit urgent. L’intérêt ne tient pas seulement au fait que ces réponses sont typées. Votre code peut aussi les examiner, les journaliser et décider quand ne pas leur faire confiance.
Commencez par une tâche réversible : routez un ticket, tout en conservant dans le code une file de validation humaine. Jev garantit la forme de sa réponse, pas la pertinence de la catégorie billing. C’est cette nuance qui sépare une démo d’un workflow réellement opérationnel.
Automatisation service client : commencez par une décision, pas par un agent autonome
Jev est un modèle de décision, pas un chatbot. Vous lui transmettez du texte ou un JSON structuré appelé state, puis vous posez des questions dont les formats de réponse possibles sont définis à l’avance. Le modèle renvoie des valeurs et des probabilités, et non une réponse rédigée. TypeSafe parle de modèle System One : il est conçu pour rendre des jugements rapides et ciblés au sein d’un logiciel classique.
Voyez-le comme un aiguillage sémantique. Une instruction if ordinaire sait vérifier un fait exact, par exemple si une facture est en retard. Jev traite la partie floue — déterminer si le message d’un client semble urgent — puis rend la main au code traditionnel.
Pour un premier workflow de support, fournissez-lui un ticket et posez trois questions :
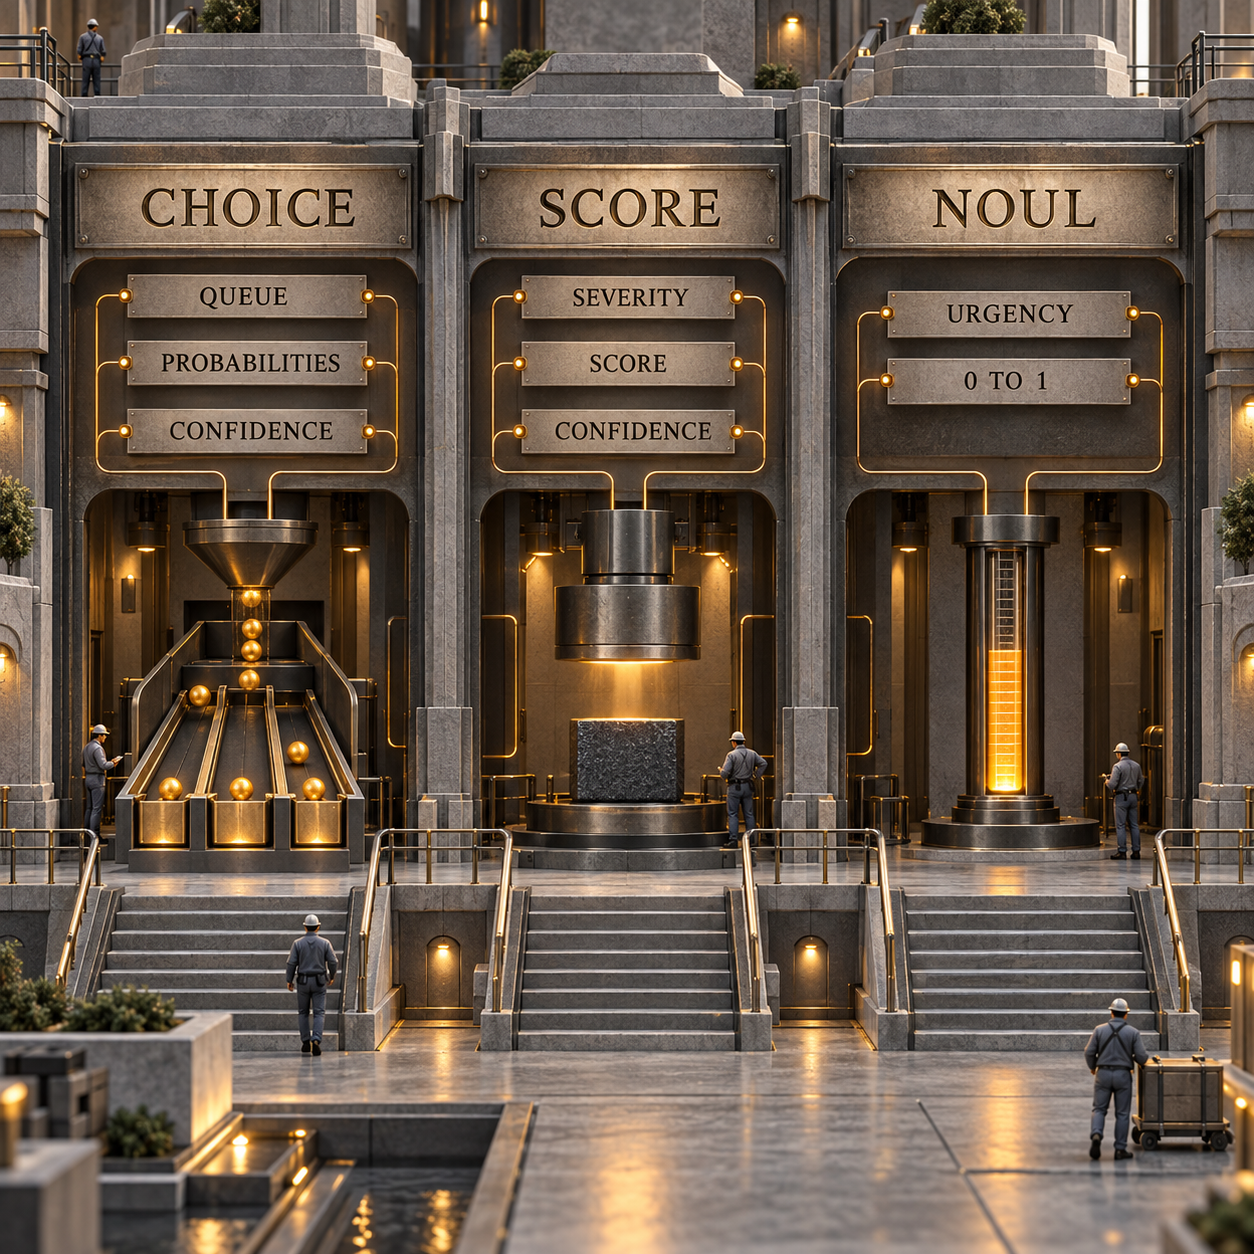
- Choice : vers quelle file prédéfinie faut-il router ce ticket ?
- Score : où situer sa gravité sur une grille ordonnée ?
- Noul : quelle est la probabilité que le client exprime un caractère urgent ?
Ces trois questions peuvent être réunies dans une même requête et sont évaluées indépendamment à partir du même état. À l’heure actuelle, Jev n’accepte que du texte, y compris des chaînes et des structures JSON composées de texte. Il ne prend en charge ni pièce jointe, ni image, ni fichier audio, ni vidéo.
Choice, Score et Noul ne désignent pas trois fois la même réponse
Chaque primitive répond à un type de question différent. Choisir la bonne compte davantage que de chercher une formulation brillante.
Une file d’attente relève de Choice, car billing, technical, sales et other sont des options concurrentes. La gravité relève de Score, puisque ses niveaux forment une grille ordonnée. L’urgence relève de Noul lorsque la question consiste simplement à savoir si le message exprime une contrainte de temps.
Les distributions complètes sont importantes. Si un Choice attribue des probabilités proches à billing et technical, il signale que la frontière entre les deux files est floue. Pour Choice et Score, le champ unique confidence résume cette dispersion. Avec Noul, une valeur proche de 0.5 correspond à la zone d’ambiguïté, puisque la valeur renvoyée représente déjà la probabilité d’un « oui ».
Mettre en place le premier routage de ticket
Il faut d’abord vérifier l’accès. TypeSafe a lancé Jev en accès anticipé le 15 septembre 2026, et cet environnement de publication ne disposait pas de clé TypeSafe. Une requête sans clé vers l’endpoint des modèles a renvoyé une erreur d’authentification HTTP 403. Le workflow ci-dessous est exécutable avec un accès autorisé, mais aucun résultat présenté dans cet article ne prétend provenir d’une exécution effectuée ici.
Utilisez Python 3.10 ou une version ultérieure, installez typesafe-sdk et définissez TYPESAFE_API_KEY dans votre environnement. Le SDK lit cette variable et utilise jev-latest par défaut. Dans cet exemple, le modèle est indiqué explicitement pour faciliter l’audit de la requête.
from time import perf_counter

from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = {
    "id": "T-001",
    "message": (
        "Our SSO connection stopped working after renewal. "
        "The invoice is paid, but the whole team is locked out."
    ),
}

started = perf_counter()
with TypeSafeClient() as client:
    response = client.system_one(
        model="jev-latest",
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which support queue should handle `message`?",
                criteria={
                    "billing": "Invoices, payments, refunds, or subscriptions",
                    "technical": "Bugs, outages, access, or integrations",
                    "sales": "Plans, pricing, upgrades, or a new account",
                    "other": "Anything that does not clearly fit the other queues",
                },
            ),
            "severity": Score(
                instructions="How severe is the customer impact in `message`?",
                criteria=[
                    "Minor inconvenience",
                    "One person is blocked",
                    "Several users are blocked",
                    "Security risk or data loss",
                ],
            ),
            "urgent": Noul(
                instructions="Does `message` express urgency or time pressure?",
            ),
        },
    )
latency_ms = round((perf_counter() - started) * 1000, 1)

queue = response.answers["queue"]
severity = response.answers["severity"]
urgent = response.answers["urgent"]

# These are conservative test gates for this reversible workflow,
# not universal thresholds. Tune them on labelled tickets.
needs_human = (
    queue.choice == "other"
    or queue.confidence < 0.75
    or severity.confidence < 0.70
    or 0.35 < urgent.noul < 0.65
)

record = {
    "ticket_id": ticket["id"],
    "model": response.model,
    "input_tokens": response.usage.input_tokens,
    "latency_ms": latency_ms,
    "queue": queue.choice,
    "queue_probabilities": queue.probabilities,
    "queue_confidence": queue.confidence,
    "severity": severity.score,
    "severity_confidence": severity.confidence,
    "urgency_probability": urgent.noul,
    "handoff": needs_human,
}
print(record)
Les seuils ci-dessus sont volontairement propres à ce cas d’usage. Router un ticket vers la mauvaise équipe est généralement réversible, mais le coût de l’erreur varie malgré tout. Une startup de deux personnes peut accepter une erreur d’aiguillage qu’un service d’assistance hospitalier ne saurait tolérer. Les recommandations de TypeSafe sur la confiance précisent que les limites doivent refléter les enjeux et être ajustées sur vos propres données.
Autre élément à journaliser : jev-latest est un alias. Au moment de la publication, il pointe vers jev-1.13.0, et le champ model de la réponse indique la version qui a réellement répondu. Si une version ultérieure modifie les résultats, un journal dépourvu de cet identifiant résolu ne permettra pas de comprendre pourquoi.
Un échec peut être parfaitement valide sur la forme, mais faux sur le fond
Le ticket d’exemple contient volontairement deux signaux forts. Les termes « renewal » et « invoice » orientent vers la facturation, tandis que « SSO » et « locked out » suggèrent le support technique. Avec la grille définie dans le code, un jeu de test étiqueté pourrait considérer technical comme la bonne file, car l’impossibilité d’accéder au service constitue le blocage immédiat.
Jev pourrait pourtant renvoyer un Choice billing tout à fait valide. Le JSON serait analysable. Le champ serait présent. La valeur ferait bien partie des options autorisées. Elle resterait néanmoins incorrecte au regard de l’étiquette attendue.
Cet échec met en évidence deux contrôles distincts :
- Repli à l’exécution : confier à une personne les cas à faible confiance, classés
otherou associés à un Noul ambigu. - Repli lors de l’évaluation : comparer chaque décision de test à une étiquette humaine, y compris lorsque la confiance est élevée. Un seuil ne détectera jamais une étiquette fausse donnée avec assurance.
Ne confondez pas « type safe » et « exact par construction ». Le typage sécurise l’interface entre le modèle et votre code. L’exactitude doit, elle, être mesurée sur les tickets, les étiquettes, les critères, la version du modèle et la langue réellement utilisés.
Un premier test indépendant de routage d’e-mails illustre bien le problème. Sur 1,565 e-mails professionnels en allemand et en anglais, son auteur a mesuré pour Jev une exactitude globale de 96.4%, derrière deux modèles Gemini. Dans ce même test, les erreurs de Jev se concentraient sur les niveaux de confiance les plus faibles, ce qui rendait utile une validation humaine sélective. Il s’agit des données d’un seul praticien, pas d’un résultat généralisable à la production.
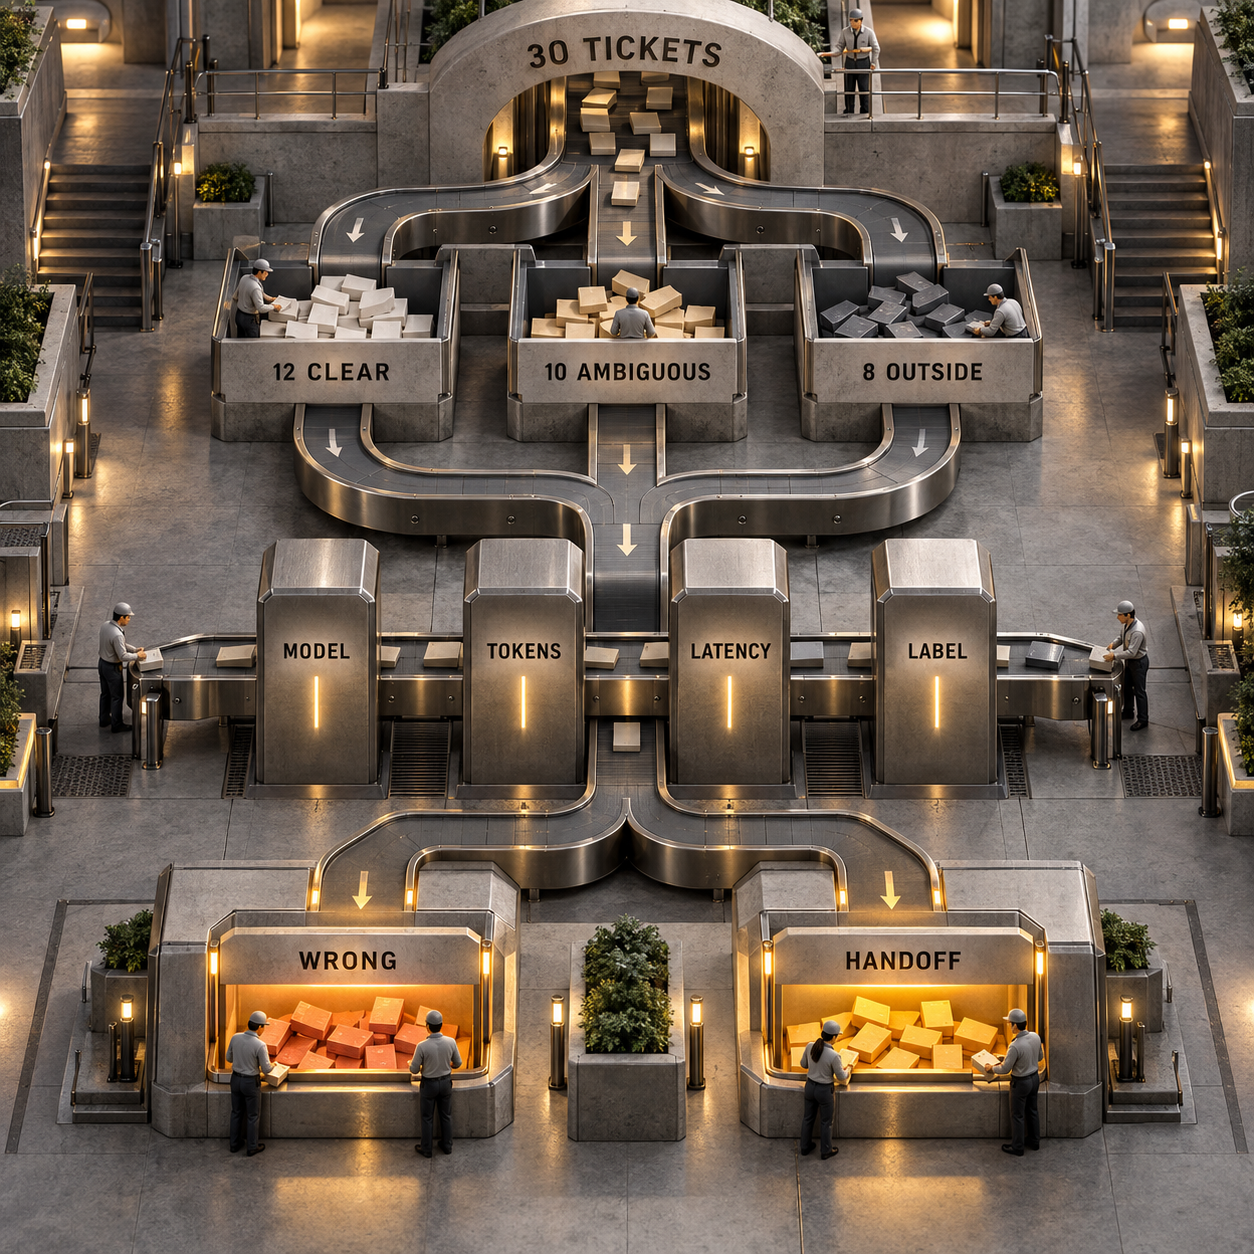
Tester le workflow sur 30 tickets avant d’en router un seul
Trente tickets ne suffisent pas à établir la précision en production. Ils peuvent toutefois révéler un mauvais jeu d’étiquettes, l’absence d’un chemin other, une consigne trompeuse, une erreur de champ dans la réponse ou un mécanisme de repli qui ne se déclenche jamais. Considérez l’exercice comme une vérification limitée du workflow, pas comme un benchmark.
Constituez le jeu de test avant de consulter les réponses de Jev :
Pour chaque ligne, renseignez un identifiant de ticket stable, la file attendue, une courte justification de l’étiquette et la nécessité éventuelle d’une intervention humaine. Enregistrez ensuite la version résolue du modèle, les tokens d’entrée, la latence mesurée côté client, la file et ses probabilités, la gravité et son niveau de confiance, la probabilité d’urgence, l’indicateur d’étiquette erronée et la décision réelle de transfert à un humain.
Analysez séparément au moins quatre segments :
- Les mauvaises étiquettes parmi les cas que le code aurait routés automatiquement
- Les erreurs assorties d’une confiance élevée, puisque la règle d’exécution ne les interceptera pas
- Le taux de transfert des cas clairs, car une prudence excessive crée du travail manuel
- Les cas hors périmètre qui n’ont pas abouti dans
other
Si l’accès reste soumis à une liste d’attente, gardez le jeu de test et le script prêts. Ne remplissez pas les colonnes de résultats avec des valeurs tirées de la documentation ou du test d’un tiers. Le livrable honnête est une feuille d’exécution bloquée faute d’accès, accompagnée de code exécutable.
Le coût change pour la classification, pas pour toute la plateforme de support
Jev 1.13 coûte $0.042 par million de tokens d’entrée, sans facturation de la sortie. À ce tarif, un ticket hypothétique de 500 tokens d’entrée coûte $0.000021 en entrée du modèle. Cent mille tickets de cette taille reviendraient à $2.10.
Ce chiffre est spectaculaire, mais il ne correspond pas au prix de remplacement d’un logiciel de support client. Zendesk débute à $19 par agent et par mois avec un paiement annuel, tandis qu’Intercom démarre à $29 par poste et par mois et facture à partir de $0.99 par résolution Fin. Ces produits comprennent notamment des boîtes de réception, le stockage des tickets, les interfaces pour agents et le reporting. Jev ne fournit que le signal de décision.
L’hypothèse budgétaire qui évolue est plus limitée : la classification sémantique répétitive n’a plus besoin de mobiliser à chaque fois un appel coûteux à un modèle génératif. Les dépenses et les efforts se déplacent vers l’intégration, les exemples étiquetés, le suivi, la gestion des exceptions et les personnes qui prennent le relais. Avec un volume de boîte de réception courant, l’économie brute sur l’inférence peut compter moins que la capacité à repérer les tickets pour lesquels le modèle signale lui-même son incertitude.
Une répartition des rôles se dessine. Jev peut sélectionner une destination ; un modèle génératif peut préparer le texte. Pour le volet réponse de ce workflow, consultez comment ChatGPT peut préparer des réponses Zendesk à partir de l’historique d’un ticket. Le code de votre application doit toujours faire respecter les règles, les autorisations et les actions.
Sept workflows classés selon leurs principaux bénéficiaires
Il s’agit d’applications possibles d’un modèle de décision contraint, et non de résultats observés.
Jev donne le meilleur de lui-même lorsque les réponses possibles sont connues, que la décision se répète souvent et que les conséquences d’un mauvais embranchement peuvent être contenues. Il convient mal lorsque la sortie attendue est une réponse, une explication, un calcul, une comparaison précise de dates ou une longue chaîne de raisonnement.
Deux produits qui méritent d’être construits
1. Une couche de routage du support pilotée par la confiance
C’est l’opportunité la plus solide. L’idée consiste à vendre une fine couche de routage aux équipes qui utilisent déjà un help desk, mais continuent de trier les tickets à la main ou d’entretenir des règles par mots-clés fragiles. Cette couche lirait le ticket, appliquerait la grille de files propre à l’équipe, réinjecterait dans le help desk la file choisie et ses probabilités, puis confierait les cas incertains ou sans correspondance à une personne.
La demande est assez précise pour être significative : customer service automation totalise environ 880 recherches mensuelles aux États-Unis, tandis que help desk automation et customer support automation en enregistrent chacune environ 260. Les plateformes de support existantes démarrent autour de $19 à $29 par poste et par mois. La promesse ne doit donc pas être « remplacez votre help desk », mais « rendez mesurable une décision de routage au sein du help desk que vous payez déjà ».
La plus petite version commercialisable doit proposer un connecteur, quatre définitions de file modifiables, une route other, des tranches de confiance, une boîte de validation et un rapport hebdomadaire sur les mauvaises étiquettes. Le point difficile sera l’onboarding : chaque client trace des frontières différentes entre ses files, et un schéma générique deviendrait le principal facteur d’échec du produit. L’avantage défendable réside dans la boucle d’évaluation et de feedback, pas dans l’appel API.
2. Une console d’assurance qualité du routage en mode fantôme
Vendez la couche de sécurité avant l’automatisation. Un responsable du support importe des tickets étiquetés, teste un schéma de questions candidat sans modifier les affectations en production, puis obtient les matrices de confusion, les erreurs à forte confiance, les taux de transfert, les comparaisons de versions et la liste des cas dont les critères doivent être améliorés.
Les mêmes 260 recherches mensuelles pour help desk automation témoignent de l’intérêt pour cette tâche, tandis qu’un CPC de $129.46 sur customer support automation indique la valeur commerciale que les éditeurs accordent à ce trafic. Le MVP peut se limiter à un import CSV, un appel direct à Jev, une validation côte à côte des étiquettes et un journal de décisions exportable. Il doit commencer par prendre en charge le test sur 30 tickets, avant de passer à des jeux de données privés plus vastes.
Le risque tient aux attentes : face à un tableau de bord soigné, les équipes peuvent supposer qu’elles disposent d’une assurance statistique. Le produit doit expliquer ce qu’un petit échantillon permet ou non de prouver, protéger les données des tickets et ne jamais présenter la confiance comme une mesure de l’exactitude réelle. Cette console compléterait bien la couche de routage, mais son potentiel autonome est plus faible, car l’évaluation reste ponctuelle.
Les limites qui doivent vous arrêter
N’utilisez pas Jev si vous attendez du texte rédigé, une réponse à un client, du code ou l’explication d’un raisonnement. Ce n’est pas non plus le bon outil pour l’arithmétique, le comptage, la comparaison de dates ou les règles d’éligibilité déterministes qu’un code ordinaire peut appliquer exactement.
D’après sa documentation, Jev 1.13 est moins performant face aux pièges littéraux, à l’indirection, au contexte superflu, au contenu adversarial, aux consignes contradictoires et aux exigences de précision numérique. Sa principale langue d’entraînement est l’anglais et la précision documentée est plus faible dans les autres langues. Un autre système doit convertir les pièces jointes en texte avant que Jev puisse les lire.
La fenêtre de contexte est limitée à 64,000 tokens pour l’ensemble de la requête. Une seconde limite de 32,000 tokens s’applique à l’état et à la question la plus longue. Considérez ces valeurs comme des plafonds, pas comme des objectifs. La documentation officielle prévient qu’un état non pertinent peut dégrader la précision : ne récupérez donc que les règles et les informations du ticket nécessaires aux questions du moment.
La vraie ligne rouge concerne les conséquences. Une étiquette de support est réversible. Un remboursement, la suspension d’un compte, une décision d’embauche, une priorité médicale ou un transfert d’argent ne sont pas de simples étiquettes. Toute action lourde de conséquences doit rester subordonnée à des contrôles déterministes, une confirmation, une personne qualifiée ou un système conçu et validé pour ce domaine.
Ce qu’il faut faire lundi
Si vous dirigez des opérations de support, exportez 30 tickets récents lundi matin. Étiquetez 12 cas clairs, 10 cas ambigus et 8 cas hors périmètre avant que quiconque ne voie les sorties du modèle. Demandez l’accès anticipé, exécutez le script en mode fantôme dès que vous recevez une clé et examinez les erreurs données avec assurance avant d’ajuster un seuil. Ne branchez pas les résultats sur le routage en production tant que l’étiquette humaine, la version du modèle et l’issue du mécanisme de repli ne figurent pas dans le même journal.
Qu’est-ce que Jev AI ?
Jev est le modèle de décision de TypeSafe AI pour les workflows logiciels structurés. Il lit du texte ou un état textuel structuré, puis renvoie des réponses contraintes de type Choice, Score et Noul, accompagnées de probabilités, au lieu de générer du texte.
Que signifie le nom Jev ?
Selon TypeSafe, le nom fait référence à William Stanley Jevons. L’appellation plus large « System One » renvoie au versant rapide et intuitif de la distinction entre System 1 et System 2.
Existe-t-il une vidéo pour apprendre à utiliser Jev ?
Une vidéo peut aider à découvrir le produit, mais l’implémentation doit partir de la documentation actuelle de l’API et du SDK TypeSafe, car les champs de requête, les alias de modèle, les modalités d’accès et les limites peuvent évoluer. Le workflow direct est le suivant : obtenir une clé autorisée, envoyer un état et des questions typées, examiner les distributions renvoyées et conserver le mécanisme de repli dans le code.
Pour construire un workflow de support piloté par la confiance à partir de vos véritables règles de file et de vos tickets, commencez par notre offre de développement IA pour le service client.
- Dernière mise à jour
- 21 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
Claude Code AGENTS.md : activer la lecture native
Claude Code peut désormais lire AGENTS.md sans fichier passerelle. Découvrez les versions, réglages et limites à vérifier pour activer ce mode.19 sept. 2026Build
Serveur MCP : régler l’attente au démarrage de Claude Code
Réglez le délai d’attente d’un serveur MCP dans Claude Code 2.1.274, distinguez les quatre timeouts et fiabilisez vos tâches automatisées en CI.17 sept. 2026Build
Cloudflare : bloquer l’entraînement de l’IA sans sacrifier le SEO
Sur Cloudflare, réglez Search sur Allow et Training sur Disallow AI Training, puis vérifiez robots.txt pour préserver le SEO sans autoriser l’entraînement.16 sept. 2026Build
Dictée vocale hors ligne : faut-il installer Murmure ?
Murmure propose une dictée vocale gratuite et hors ligne. Notre test évalue sa précision, ses règles de correction, sa confidentialité et ses limites.14 sept. 2026Build
Tarifs RenderIO : le vrai coût de cette API FFmpeg
Découvrez les tarifs RenderIO, le coût réel des crédits FFmpeg et les seuils à partir desquels Starter, Growth ou Business devient le choix le plus rentable.14 sept. 2026Build
Logiciel de dictée vocale Dictare : le vrai coût du gratuit
Dictare est un logiciel de dictée vocale gratuit et local. Voici son prix réel, les coûts à prévoir et son intérêt face à Spokenly et Wispr Flow.13 sept. 2026Build
Plugins Claude Code : mesurer leur impact avec les evals natives
Apprenez à tester les plugins Claude Code avec les evals natives, mesurer leur impact réel et bloquer les régressions grâce à un garde-fou CI.12 sept. 2026Build