Jev로 티켓 라우팅을 안전하게 설계하는 법
Jev로 고객 지원 티켓을 분류하고 큐·심각도·긴급도 신호를 코드에서 다루는 방법을 설명합니다. 라벨링한 티켓 30건, 신뢰도 임계값, 사람 검토 큐를 활용해 자동 티켓 라우팅의 오분류를 드러내고 안전한 운영 경계를 세우는 과정을 단계별로 정리한 실무 가이드입니다.

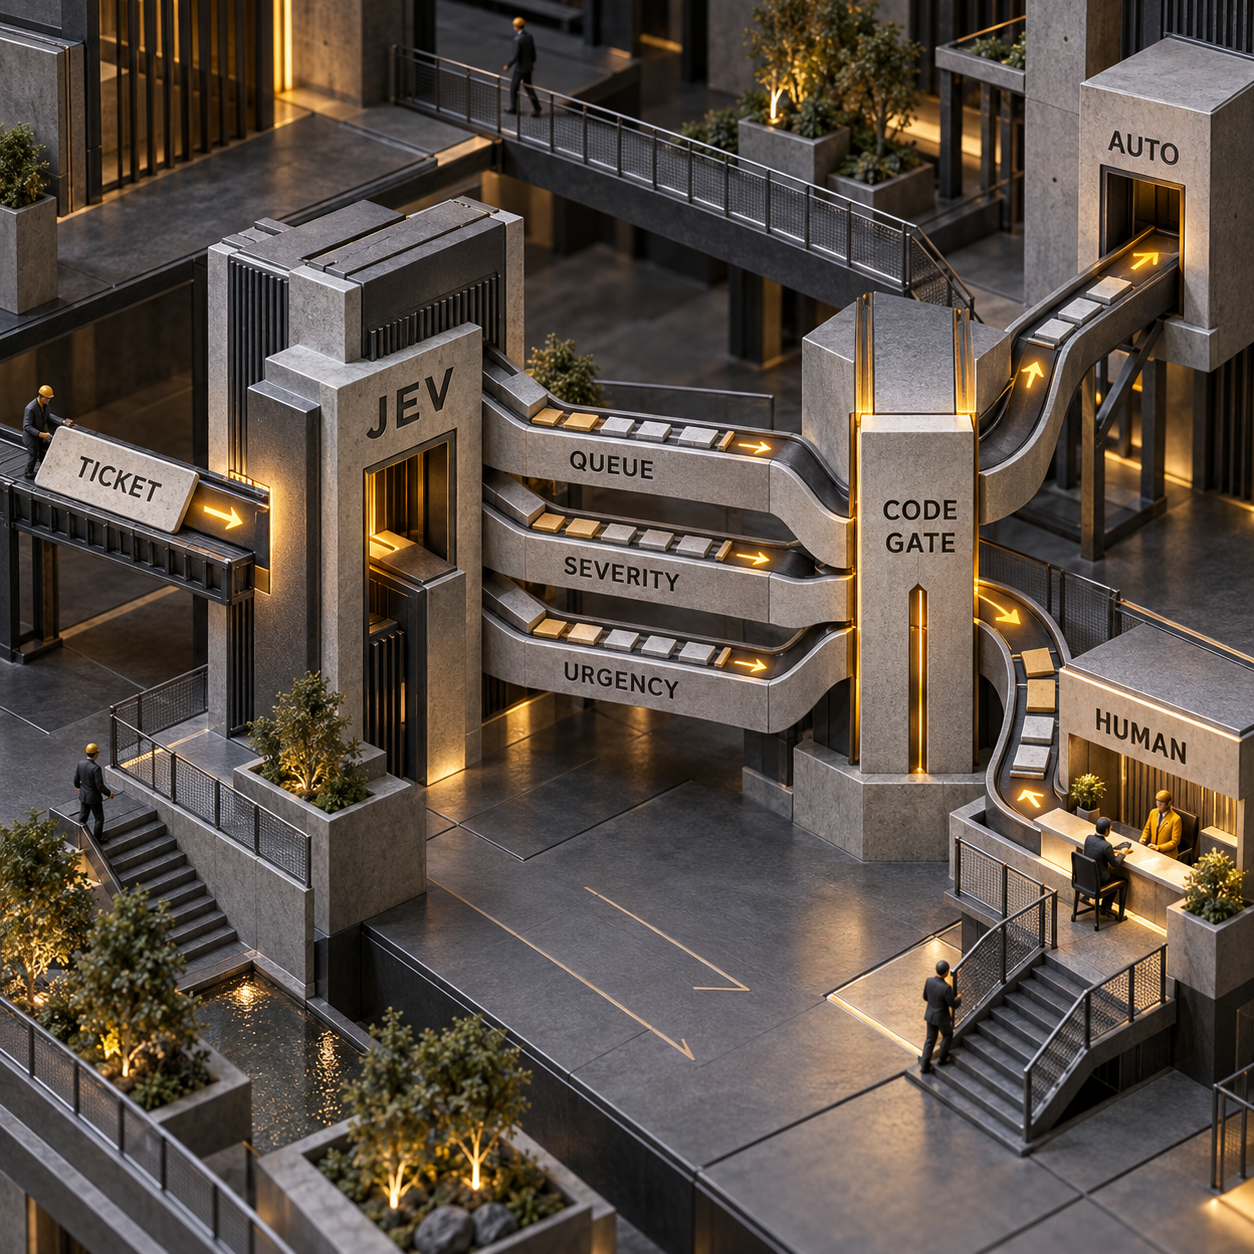
Jev는 뒤섞인 고객 지원 메시지 하나를 소프트웨어가 즉시 활용할 수 있는 세 가지 신호, 즉 큐, 심각도 점수, 티켓의 긴급 확률로 바꿀 수 있습니다. 티켓 라우팅에서 중요한 것은 답이 단순히 정해진 타입으로 반환된다는 점이 아닙니다. 코드가 그 값을 확인하고 로그로 남기며, 언제 신뢰하지 말아야 할지 판단할 수 있다는 점입니다.
첫 작업은 되돌릴 수 있는 범위로 제한합니다. 티켓을 분류하되 코드에 사람 검토 큐를 남겨 두십시오. Jev가 보장하는 것은 응답의 형태이지 billing이 정답이라는 사실이 아닙니다. 이 차이가 데모와 실제 운영 워크플로를 가릅니다.
자율형 고객 지원 에이전트보다 티켓 라우팅 결정 하나로 시작합니다
Jev는 챗봇이 아니라 의사결정 모델입니다. 텍스트나 state라고 부르는 구조화 JSON을 보내고, 가능한 응답 형태를 미리 고정한 질문을 던집니다. 그러면 문장형 답변 대신 값과 확률을 돌려줍니다. TypeSafe는 이를 System One 모델이라고 부릅니다. 일반 소프트웨어 안에서 빠르고 범위가 좁은 판단을 처리하도록 설계됐다는 뜻입니다.
의미를 읽는 교환기라고 생각하면 쉽습니다. 일반적인 if 문은 청구서의 결제 기한이 지났는지처럼 정확한 사실을 확인할 수 있습니다. Jev는 고객 메시지가 다급하게 들리는지 같은 모호한 부분을 처리한 뒤, 다시 일반 코드에 제어권을 넘깁니다.
첫 고객 지원 워크플로에서는 티켓 하나를 주고 다음과 같이 묻습니다.
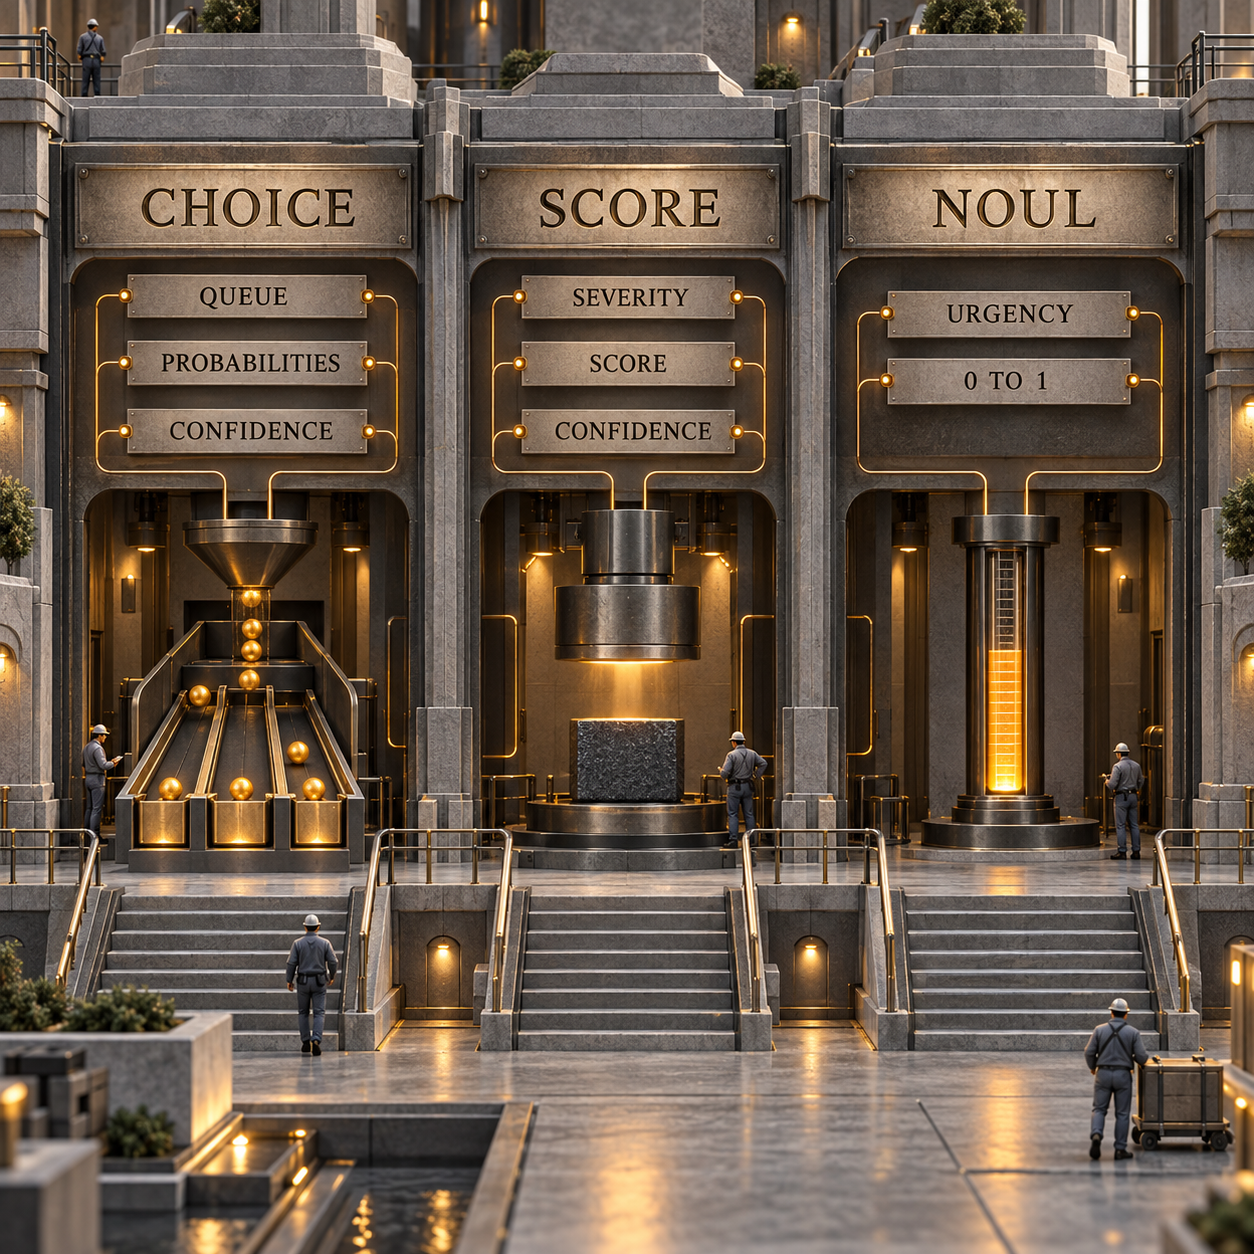
- Choice: 미리 정한 큐 중 어느 곳으로 이 티켓을 보내야 하는가?
- Score: 순서가 있는 평가 기준에서 심각도는 어느 수준인가?
- Noul: 고객이 긴급함을 표현할 가능성은 얼마나 높은가?
세 질문을 요청 하나에 함께 담을 수 있으며, 모두 같은 state를 바탕으로 독립적으로 평가됩니다. 현재 Jev가 받는 입력은 텍스트뿐입니다. 문자열과 텍스트로 구성된 JSON 구조는 가능하지만 첨부 파일, 이미지, 오디오 클립, 동영상은 받을 수 없습니다.
Choice, Score, Noul은 같은 답을 부르는 세 가지 이름이 아닙니다
각 프리미티브는 서로 다른 종류의 질문에 답합니다. 영리한 문구를 만드는 것보다 목적에 맞는 프리미티브를 고르는 일이 더 중요합니다.
큐에는 billing, technical, sales, other라는 대안이 있으므로 Choice를 사용합니다. 심각도는 순서가 있는 평가 기준이므로 Score가 맞습니다. 메시지에 시간 압박이 드러나는지만 묻는 긴급도에는 Noul을 사용합니다.
전체 확률 분포를 봐야 합니다. billing과 technical에 비슷한 확률을 배정한 Choice는 큐의 경계가 모호하다는 신호를 보내는 셈입니다. Choice와 Score에서는 단일 confidence 필드가 그 분포를 요약합니다. Noul은 반환값 자체가 ‘예’일 확률이므로 0.5에 가까운 구간이 모호한 영역입니다.
첫 티켓 라우팅 구축하기
먼저 접근 권한부터 확인해야 합니다. TypeSafe는 2026년 9월 15일 Jev를 얼리 액세스로 공개했으며, 이 글의 게시 환경에는 TypeSafe 키가 없었습니다. 키 없이 모델 엔드포인트에 요청하자 인증 오류와 함께 HTTP 403이 반환됐습니다. 아래 워크플로는 권한이 있으면 실행할 수 있지만, 이 글의 어떤 결과도 이번 작성 과정에서 직접 실행한 값으로 제시하지 않습니다.
Python 3.10 이상을 사용하고 typesafe-sdk를 설치한 뒤 환경 변수에 TYPESAFE_API_KEY를 설정합니다. SDK는 이 변수를 읽으며 기본적으로 jev-latest를 사용합니다. 아래 예제는 요청을 쉽게 감사할 수 있도록 모델을 명시했습니다.
from time import perf_counter

from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = {
    "id": "T-001",
    "message": (
        "Our SSO connection stopped working after renewal. "
        "The invoice is paid, but the whole team is locked out."
    ),
}

started = perf_counter()
with TypeSafeClient() as client:
    response = client.system_one(
        model="jev-latest",
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which support queue should handle `message`?",
                criteria={
                    "billing": "Invoices, payments, refunds, or subscriptions",
                    "technical": "Bugs, outages, access, or integrations",
                    "sales": "Plans, pricing, upgrades, or a new account",
                    "other": "Anything that does not clearly fit the other queues",
                },
            ),
            "severity": Score(
                instructions="How severe is the customer impact in `message`?",
                criteria=[
                    "Minor inconvenience",
                    "One person is blocked",
                    "Several users are blocked",
                    "Security risk or data loss",
                ],
            ),
            "urgent": Noul(
                instructions="Does `message` express urgency or time pressure?",
            ),
        },
    )
latency_ms = round((perf_counter() - started) * 1000, 1)

queue = response.answers["queue"]
severity = response.answers["severity"]
urgent = response.answers["urgent"]

# These are conservative test gates for this reversible workflow,
# not universal thresholds. Tune them on labelled tickets.
needs_human = (
    queue.choice == "other"
    or queue.confidence < 0.75
    or severity.confidence < 0.70
    or 0.35 < urgent.noul < 0.65
)

record = {
    "ticket_id": ticket["id"],
    "model": response.model,
    "input_tokens": response.usage.input_tokens,
    "latency_ms": latency_ms,
    "queue": queue.choice,
    "queue_probabilities": queue.probabilities,
    "queue_confidence": queue.confidence,
    "severity": severity.score,
    "severity_confidence": severity.confidence,
    "urgency_probability": urgent.noul,
    "handoff": needs_human,
}
print(record)
위 임계값은 이 워크플로에 맞춰 의도적으로 보수적으로 잡은 값입니다. 잘못된 고객 지원 큐로 보내는 일은 대개 되돌릴 수 있지만, 그 비용도 상황마다 다릅니다. 구성원이 둘뿐인 스타트업에서 감수할 수 있는 오분류를 병원 헬프데스크에서는 허용하기 어려울 수 있습니다. TypeSafe의 신뢰도 가이드도 위험의 크기에 따라 경계를 정하고 자체 데이터로 조정하라고 안내합니다.
로그에 남겨야 할 세부 사항이 하나 더 있습니다. jev-latest는 별칭입니다. 게시 시점에는 jev-1.13.0을 가리키며, 응답의 model 필드에서 실제로 답한 버전을 확인할 수 있습니다. 이후 버전에서 결과가 달라졌을 때 확정된 모델 ID가 로그에 없으면 원인을 설명할 수 없습니다.
눈에 보이는 실패는 형식은 맞지만 의미가 틀린 답입니다
샘플 티켓에는 두 가지 강한 신호를 의도적으로 넣었습니다. “Renewal”과 “invoice”는 billing을, “SSO”와 “locked out”은 technical 지원을 가리킵니다. 코드의 평가 기준을 적용한 라벨링 테스트 세트에서는 접근 장애가 당장 해결해야 할 문제이므로 technical을 정답 큐로 정할 수 있습니다.
그런데도 Jev는 형식상 완벽하게 유효한 billing Choice를 반환할 수 있습니다. JSON 파싱은 성공하고 필드도 존재하며, 값도 허용된 옵션 중 하나일 것입니다. 그래도 그 라벨을 기준으로 보면 답은 틀렸습니다.
이 실패는 서로 다른 두 가지 통제 장치가 필요하다는 사실을 보여줍니다.
- 런타임 대체 경로: 신뢰도가 낮거나
other로 분류됐거나 Noul 값이 모호한 사례는 사람에게 보냅니다. - 평가 대체 경로: 신뢰도가 높은 결정을 포함해 모든 테스트 결정을 사람의 라벨과 비교합니다. 임계값만으로는 자신 있게 내놓은 오답을 잡을 수 없습니다.
‘타입 안전’을 ‘처음부터 정확함’으로 오해해서는 안 됩니다. 타입 안전성은 모델과 코드 사이의 인터페이스를 보호합니다. 정확도는 실제로 사용하는 티켓, 라벨, 평가 기준, 모델 버전, 언어를 기준으로 직접 측정해야 하는 속성입니다.
독립적으로 진행된 초기 이메일 라우팅 테스트도 같은 점을 보여줍니다. 독일어와 영어 비즈니스 이메일 1,565건을 대상으로 한 테스트에서 Jev의 전체 정확도는 96.4%로 보고됐으며, 두 Gemini 모델보다 낮았습니다. 같은 테스트에서는 Jev의 오류가 낮은 신뢰도 구간에 몰려 있어 선택적으로 사람에게 검토를 맡기는 방식이 유용했습니다. 이는 보편적인 운영 결과가 아니라 한 실무자의 데이터 세트에서 나온 결과입니다.
자동 라우팅 전에 30건으로 워크플로를 점검합니다
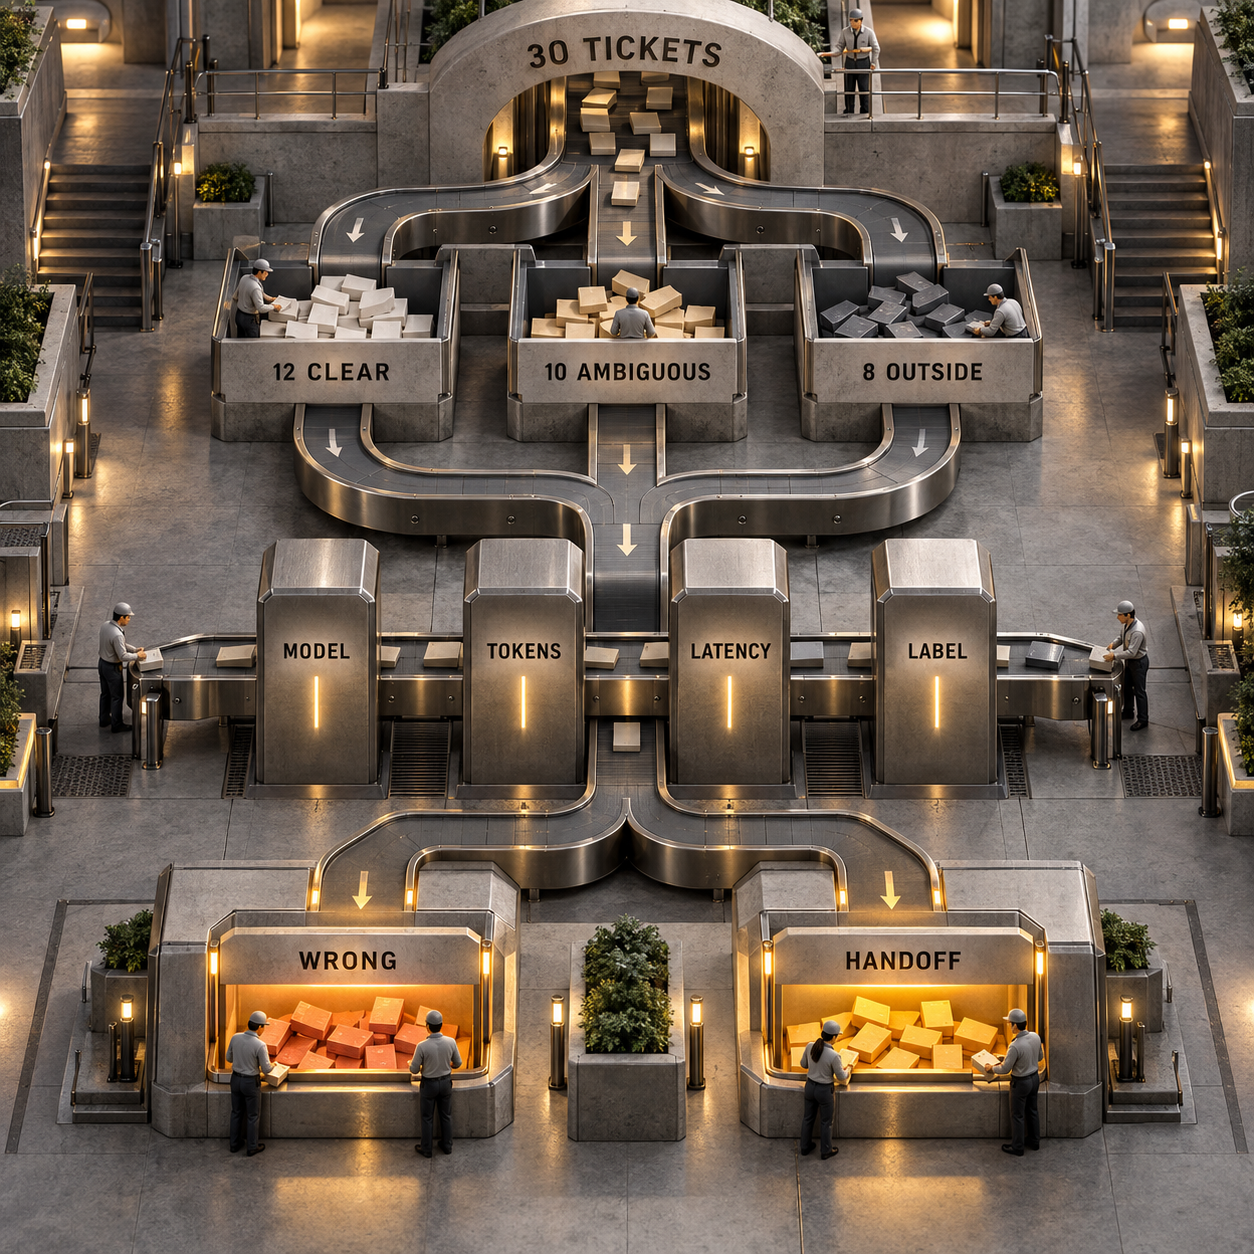
티켓 30건만으로 운영 환경의 정확도를 입증할 수는 없습니다. 하지만 잘못 설계한 라벨 묶음, 빠진 other 경로, 오해를 부르는 지시문, 잘못 참조한 응답 필드, 한 번도 작동하지 않는 대체 경로는 찾아낼 수 있습니다. 벤치마크가 아니라 작은 규모의 워크플로 점검으로 다뤄야 합니다.
Jev의 답을 보기 전에 먼저 테스트 자료를 만듭니다.
각 행에 변하지 않는 티켓 ID, 예상 큐, 해당 라벨을 붙인 짧은 이유, 사람에게 보내야 하는지를 기록합니다. 그다음 확정된 모델 버전, 입력 토큰, 클라이언트에서 측정한 지연 시간, 반환된 큐와 확률, 심각도와 신뢰도, 긴급 확률, 오답 라벨 여부, 실제 사람 전달 여부를 남깁니다.
최소한 다음 네 가지 구간은 따로 검토합니다.
- 코드가 자동으로 라우팅했을 사례 중 라벨이 틀린 건
- 런타임 게이트가 놓치는 고신뢰도 오답
- 지나친 신중함이 수작업을 늘리는지 확인할 수 있는 명확한 사례의 사람 전달 비율
other에 들어가지 못한 범위 밖 사례
아직도 접근 권한을 기다리는 중이라면 테스트 자료와 스크립트를 준비해 두십시오. 문서나 다른 사람의 테스트에서 가져온 값으로 결과 열을 채우면 안 됩니다. 실행 가능한 코드가 함께 있는 ‘접근 권한 대기’ 실행표가 정직한 결과물입니다.
비용 계산이 바꾸는 것은 분류 항목이지 고객 지원 전체 스택이 아닙니다
Jev 1.13의 가격은 입력 토큰 백만 개당 $0.042이며 출력에는 요금이 부과되지 않습니다. 이 요율에서 입력 토큰이 500개인 가상의 티켓 하나에 드는 모델 입력 비용은 $0.000021입니다. 같은 크기의 티켓 십만 건은 $2.10입니다.
눈길을 끄는 금액이지만 고객 지원 소프트웨어를 대체하는 가격은 아닙니다. Zendesk는 연간 결제 기준 상담원 한 명당 월 $19부터 시작하고, Intercom은 좌석당 월 $29부터 시작하며 Fin 결과 한 건당 $0.99부터 부과합니다. 이런 제품에는 받은편지함, 티켓 저장소, 상담원 인터페이스, 보고 기능을 비롯한 운영 도구가 포함됩니다. Jev가 제공하는 것은 의사결정 신호뿐입니다.
달라지는 예산 가정은 그보다 좁습니다. 반복적인 의미 분류를 할 때마다 비싼 생성형 모델을 호출할 필요가 없어진다는 점입니다. 비용과 노력은 통합, 라벨링된 예시, 모니터링, 예외 처리, 전달받은 건을 맡을 사람에게 옮겨갑니다. 일반적인 받은편지함 규모에서는 순수 추론 비용 절감보다 모델이 어떤 티켓을 확신하지 못한다고 말하는지 아는 것이 더 중요할 수 있습니다.
여기에는 유용한 역할 분담이 있습니다. Jev는 경로를 고르고 생성형 모델은 문장을 준비할 수 있습니다. 답변 작성 단계의 워크플로는 ChatGPT가 티켓 기록을 바탕으로 Zendesk 답변을 준비하는 방법을 참고하십시오. 정책, 권한, 실제 작업은 여전히 애플리케이션 코드가 강제해야 합니다.
혜택이 큰 주체부터 정리한 일곱 가지 워크플로
아래 내용은 제약형 의사결정 모델을 적용할 수 있는 사례이지, 보고된 성과가 아닙니다.
Jev는 가능한 답이 이미 정해져 있고, 같은 결정이 자주 반복되며, 잘못된 분기의 영향을 제한할 수 있을 때 가장 강합니다. 답변 문구, 설명, 계산, 정확한 날짜 비교, 긴 추론 과정이 필요한 작업에는 적합하지 않습니다.
구축해 볼 만한 제품 두 가지
1. 신뢰도 게이트를 둔 고객 지원 라우팅 보강 도구
가장 유망한 기회입니다. 이미 헬프데스크를 쓰면서도 티켓을 수동 분류하거나 쉽게 깨지는 키워드 규칙을 유지하는 팀에 가벼운 라우팅 계층을 판매할 수 있습니다. 티켓을 읽고 팀 고유의 큐 평가 기준을 적용한 뒤, 선택된 큐와 확률을 헬프데스크에 다시 기록하고 불확실하거나 어느 항목에도 맞지 않는 사례는 사람에게 보냅니다.
수요는 충분히 구체적입니다. customer service automation의 미국 월간 검색량은 약 880회이며, help desk automation과 customer support automation은 각각 약 260회입니다. 기존 고객 지원 플랫폼의 가격은 좌석당 월 $19~$29부터 시작합니다. 따라서 판매 문구는 “헬프데스크를 대체합니다”가 아니라 “이미 비용을 내고 있는 헬프데스크 안에서 라우팅 결정 하나를 측정 가능하게 만듭니다”여야 합니다.
판매 가능한 최소 버전에는 커넥터 하나, 편집 가능한 큐 정의 네 개, other 경로, 신뢰도 구간, 검토용 받은편지함, 주간 오답 라벨 보고서가 필요합니다. 문제는 온보딩입니다. 고객마다 큐의 경계가 다르며, 일반화한 스키마 자체가 제품의 실패 원인이 될 수 있습니다. 경쟁력은 API 호출이 아니라 평가와 피드백 루프에 있습니다.
2. 섀도 모드 라우팅 QA 콘솔
자동화보다 안전 계층을 먼저 판매하는 제품입니다. 고객 지원 책임자가 라벨링된 티켓을 업로드하고 실제 배정을 바꾸지 않은 채 후보 질문 스키마를 실행하면, 혼동 건수, 고신뢰도 오류, 사람 전달 비율, 버전 비교 결과, 평가 기준을 개선해야 할 사례 목록을 받습니다.
help desk automation의 월간 검색량이 260회라는 사실은 이 작업에 대한 관심을 보여주고, customer support automation의 CPC가 $129.46이라는 점은 공급업체가 이 트래픽을 상업적으로 높이 평가한다는 신호입니다. MVP는 CSV 가져오기, Jev 직접 호출, 라벨 나란히 검토하기, 의사결정 로그 내보내기로 구성할 수 있습니다. 먼저 티켓 30건 점검을 지원하고 이후 더 큰 비공개 데이터 세트로 확장해야 합니다.
문제는 팀이 잘 다듬어진 대시보드에서 통계적 확실성까지 기대할 수 있다는 점입니다. 이 제품은 작은 표본이 입증할 수 있는 것과 없는 것을 분명히 밝히고, 티켓 데이터를 보호하며, 신뢰도를 실제 정답의 정확도처럼 보여주지 않아야 합니다. 라우팅 보강 도구의 보완 제품으로는 좋지만 평가는 간헐적으로 이뤄지므로 독립 사업으로서는 매력이 더 약합니다.
사용을 중단해야 하는 한계선
문장, 고객 답변, 코드, 추론 설명이 필요할 때는 Jev를 사용하지 마십시오. 일반 코드가 정확히 처리할 수 있는 산술, 개수 세기, 날짜 비교, 결정론적 자격 규칙에도 적합하지 않습니다.
문서에 따르면 Jev 1.13은 문자 그대로의 함정, 간접 표현, 무관한 맥락, 적대적 콘텐츠, 서로 충돌하는 지시, 수치 정밀도에 취약합니다. 주된 학습 언어는 영어이며 다른 언어에서는 문서상 정확도가 더 낮습니다. Jev가 첨부 파일을 보려면 다른 시스템에서 먼저 텍스트로 변환해야 합니다.
전체 요청의 컨텍스트 한도는 64,000토큰이며, state와 가장 긴 질문을 합친 부분에는 별도로 32,000토큰 한도가 적용됩니다. 이 수치는 목표가 아니라 상한선으로 봐야 합니다. 공식 가이드는 무관한 state가 정확도를 낮출 수 있다고 경고하므로, 현재 질문에 필요한 정책과 티켓 세부 정보만 가져오십시오.
결정적인 중단 기준은 결과의 파급력입니다. 고객 지원 라벨은 되돌릴 수 있습니다. 환불, 계정 정지, 채용 결정, 의료 우선순위, 자금 이체는 단순한 라벨이 아닙니다. 파급력이 큰 조치는 결정론적 검사, 확인 절차, 자격을 갖춘 사람, 또는 해당 분야에 맞춰 설계하고 검증한 시스템 뒤에 두어야 합니다.
월요일에 할 일
고객 지원 운영을 맡고 있다면 월요일 아침 최근 티켓 30건을 내보냅니다. 누구도 모델 출력을 보기 전에 명확한 사례 12건, 모호한 사례 10건, 범위 밖 사례 8건에 라벨을 붙입니다. 얼리 액세스를 신청하고 키가 도착하면 섀도 모드에서 스크립트를 실행한 뒤, 임계값을 조정하기 전에 자신 있게 틀린 사례부터 검토합니다. 사람 라벨, 모델 버전, 대체 경로의 결과가 모두 같은 로그에 담기기 전에는 실제 라우팅에 연결하지 마십시오.
Jev AI란 무엇인가요?
Jev는 구조화된 소프트웨어 워크플로를 위한 TypeSafe AI의 의사결정 모델입니다. 텍스트나 구조화된 텍스트 state를 읽고 문장을 생성하는 대신, 확률이 포함된 제약형 Choice, Score, Noul 답을 반환합니다.
Jev는 무엇의 약자인가요?
TypeSafe에 따르면 Jev라는 이름은 William Stanley Jevons를 가리킵니다. 더 넓은 개념인 “System One”이라는 이름은 System 1과 System 2를 구분할 때 빠르고 직관적인 쪽을 뜻합니다.
Jev 사용법 영상으로 시작해도 되나요?
영상 검색 결과는 개념을 익히는 데 도움이 될 수 있습니다. 다만 요청 필드, 모델 별칭, 접근 방식, 한도는 바뀔 수 있으므로 구현은 최신 TypeSafe API와 SDK 문서에서 시작해야 합니다. 직접 구현하는 흐름은 권한이 있는 키를 받고, state와 타입이 지정된 질문을 보내고, 반환된 분포를 살핀 뒤, 대체 경로를 코드에 유지하는 순서입니다.
실제 큐 규칙과 티켓에 맞춘 신뢰도 게이트 기반 고객 지원 워크플로가 필요하다면 AI 고객 서비스 개발에서 시작할 수 있습니다.
- 마지막 업데이트
- 2026년 9월 21일
- 카테고리
- Build
Google에서 이 사이트를 우선하기


omidsaffari.com을 선호 소스로 지정하면 Google이 Top Stories, AI Overviews, AI Mode에서 우선적으로 보여 줍니다.
Claude Code 사용법: AGENTS.md를 프로젝트 지침으로 불러오기
Claude Code v2.1.277에서 AGENTS.md를 프로젝트 지침으로 직접 불러오는 조건과 설정법을 정리합니다. CLAUDE.md 우선순위, 제공업체와 기능 플래그 제한, /config 모드 선택, 새 세션에서 실제 로드 여부를 검증하는 방법까지 단계별로 확인하세요.2026년 9월 19일Build
Claude Code MCP 시작 대기 시간, 제대로 설정하는 법
Claude Code 2.1.274에 추가된 MCP 시작 대기 환경 변수의 범위와 0의 의미를 설명합니다. 서버 시작, 툴 실행, 전체 작업의 제한을 구분하고 CI와 예약 작업에서 필수 서버의 연결 상태를 검증해 불완전한 결과를 막는 실전 설정 기준까지 한 번에 정리했습니다.2026년 9월 17일Build
검색 노출을 지키는 Cloudflare AI 크롤러 차단 설정법
Cloudflare에서 검색 노출은 유지하면서 AI 학습 크롤러만 막는 안전한 설정법을 정리했습니다. 2026년 9월 15일 달라진 Block 정책부터 마이그레이션 점검, robots.txt 검증, Bing 예외와 운영상 한계까지 실무 순서대로 확인하세요.2026년 9월 16일Build
음성 텍스트 변환 앱 Murmure 리뷰: 오프라인 받아쓰기 실전 검증
무료 오프라인 받아쓰기 앱 Murmure를 직접 테스트했습니다. 맞춤 사전과 서식 규칙이 기술 용어와 파일 경로를 얼마나 정확히 고치는지, 하드웨어 요구 사항과 로컬·원격 LLM 연결에서 달라지는 개인정보 보호 경계를 살펴보고 누구에게 맞는지도 정리했습니다.2026년 9월 14일Build
RenderIO FFmpeg API 가격 가이드: 크레딧 비용과 업그레이드 기준
RenderIO FFmpeg API의 Starter·Growth·Business 요금과 명령 크레딧 구조를 분석합니다. 체인 실행, yt-dlp 다운로드, 런타임·스토리지 제한과 플랜별 손익분기점을 비교해 워크로드에 맞는 비용 기준과 업그레이드 시점을 명확히 제시합니다.2026년 9월 14일Build
Dictare 가격 분석: 무료 로컬 음성 텍스트 변환의 실제 비용
Dictare는 코딩 에이전트용 무료 로컬 음성 텍스트 변환 도구입니다. 소프트웨어 가격은 $0이지만, 음성 모델 설치와 하드웨어, 전력, 운영 시간, 별도 코딩 에이전트 요금까지 나눠 실제 비용을 계산하고 Spokenly·Wispr Flow와 비교합니다.2026년 9월 13일Build
Claude Code 플러그인 테스트: 네이티브 eval로 회귀 잡기
Claude Code 플러그인 테스트를 네이티브 eval로 실행하는 방법을 알아봅니다. 플러그인 적용 전후의 델타를 비교하고, 보고서를 해석하며, 반복 세션과 judge 비용을 계산해 신뢰할 수 있는 CI 회귀 방지 게이트로 연결하는 실전 절차를 정리했습니다.2026년 9월 12일Build