데이터 라벨링과 고객 문의 분류, OpenAI Decisions API로 어디까지 할까
OpenAI Decisions API로 데이터 라벨링과 고객 문의 자동 분류를 구현하는 방법을 살펴봅니다. 세 가지 요청 예제부터 응답 거부 처리, 신뢰도 임곗값, 요금 계산과 연동 제약까지 짚고, 기존 LLM 호출을 유지할지 전환할지 판단할 기준을 정리합니다.
게시일
 작성자 Omid Saffari




OpenAI Decisions API는 고객 문의 티켓 라우팅, 데이터 라벨링, 에이전트가 제안한 행동의 평가 결과를 코드에서 바로 사용할 수 있는 형태로 반환합니다. 지금 쓰는 LLM 호출이 범주 하나나 평점만 반환하는 용도라면 시험해 볼 만합니다. 다만 기존 방식과 같은 수준의 라우팅 품질을 확보하고, 이전에 드는 수고를 감수할 만큼 업무 흐름이 개선될 때 교체해야 합니다.
코드에 필요한 판단부터 정합니다
Decisions는 정해진 목적지 중 하나를 고르는 배차 담당자와 비슷합니다. 근거와 질문을 전달하면 답을 돌려주고, 그다음 무엇을 할지는 애플리케이션이 결정합니다.
2026년 10월 11일 기준으로 이 API는 공개 베타이며, 정식 출시는 “앞으로 몇 주 안에” 이뤄질 예정입니다. 이는 OpenAI의 예상이지 확정된 출시일은 아닙니다. 지원 모델은 gpt-6-luna뿐이며, 엔드포인트는 **POST /v1/decisions**입니다. OpenAI는 **“Responses API보다 약 10배 빠르다”**고 설명합니다. 이는 OpenAI의 주장으로, 여러분의 애플리케이션에서 측정한 결과와는 구분해야 합니다. OpenAI Decisions 가이드
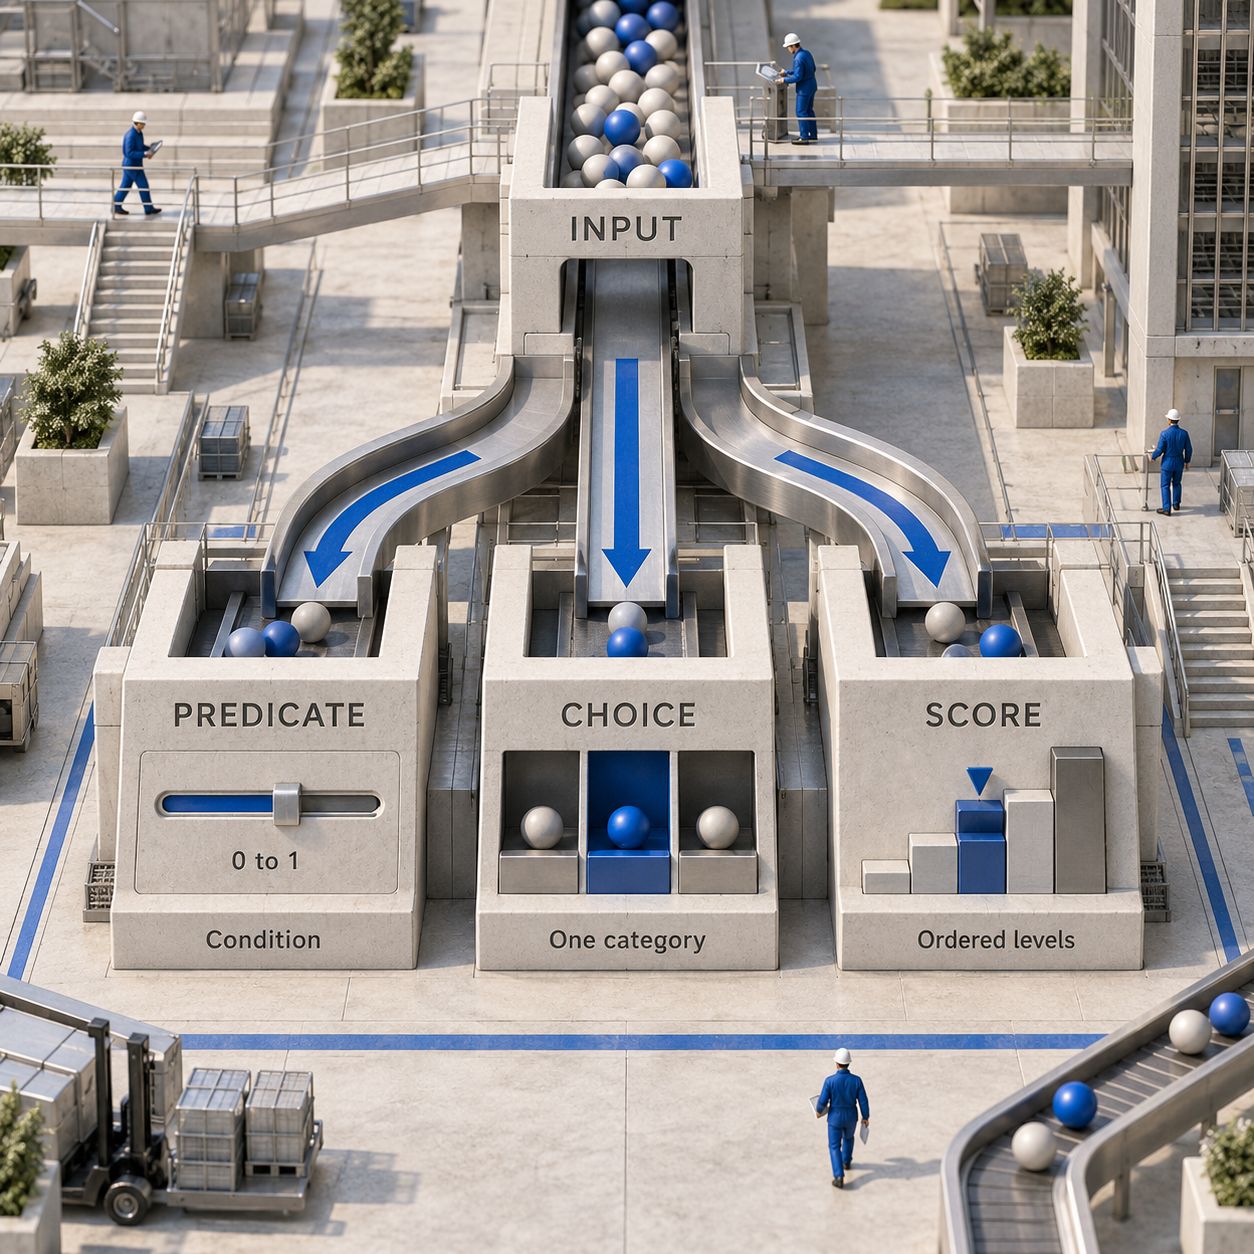
프롬프트를 작성하기 전에 필요한 응답 형태부터 고릅니다.
점수의 단계 인덱스는 0부터 시작합니다. 결과는 단계 사이의 값이 될 수 있으며, 여러 단계에 걸친 불확실성을 요약합니다. 코드에서 범주 하나만 필요하다면 choice를 사용합니다. 질문 유형 안내
세 가지 요청을 각각 실행합니다
다음은 가이드에 실린 cURL 요청 예제 세 가지입니다. 서식을 통일하고 각 예제를 구분하는 주석을 추가했습니다. 셸 환경에 OPENAI_API_KEY를 설정해야 하며, predicate 예제에는 로컬 파일 product.png도 필요합니다. 각 명령은 별도의 요청을 보냅니다. 예제는 공개 가이드와 대조했으며, 로그인한 계정으로 실행해 검증한 것은 아닙니다. 원본 요청 예제
공통 구성 요소는 판단 근거를 담는 input과 그 근거에 대해 내릴 판단을 정의하는 questions입니다. 질문의 name으로 반환된 answers 배열에서 해당 답을 찾습니다. 요청 및 응답 레퍼런스
# Predicate: inspect product.png for visible damage
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"

curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @- <<JSON
{
  "model": "gpt-6-luna",
  "input": [{
    "role": "user",
    "content": [
      {"type": "input_text", "text": "Inspect the product in this photo."},
      {"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
    ]
  }],
  "questions": [{
    "type": "predicate",
    "name": "visible_damage",
    "instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
  }]
}
JSON

# Choice: route a customer complaint
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice",
      "name": "department",
      "instructions": "Which department should handle this complaint?",
      "choices": [
        {"value": "billing", "description": "Payments, invoices, and refunds."},
        {"value": "technical", "description": "Problems using the product."},
        {"value": "shipping", "description": "Delivery and tracking."},
        {"value": "other", "description": "Requests outside these categories."}
      ]
    }]
  }'

# Score: assess issue severity
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Export fails in Safari but works in Chrome.",
    "questions": [{
      "type": "score",
      "name": "severity",
      "instructions": "How severe is this issue?",
      "levels": [
        {"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
        {"label": "Workaround available", "description": "A task fails, but another way works."},
        {"label": "Fully blocked", "description": "A task fails with no workaround."}
      ]
    }]
  }'
choice 예제는 실무에 바로 응용하기 좋은 출발점입니다. 중복 결제 민원을 정해진 큐 중 하나로 보내는 작업입니다. score 예제는 다른 문제를 다룹니다. 다른 브라우저에서는 정상 작동할 때, 해당 오류가 업무에 얼마나 큰 지장을 주는지 묻습니다. 담당 큐와 심각도는 따로 판단해야 합니다. 그래야 긴급한 결제 문제를 기술 지원 티켓으로 잘못 분류하지 않습니다.
값을 읽기 전에 응답 거부부터 처리합니다. 가이드의 SDK 예제는 probability, choice, score에 접근하기 전에 answer.type == "refusal"을 확인합니다. 응답 거부는 별도의 결과입니다. 신뢰도가 낮은 답도, 직접 정의한 other 범주도 아닙니다. 응답 거부 동작
choice를 고객 문의 티켓 분류에 적용합니다
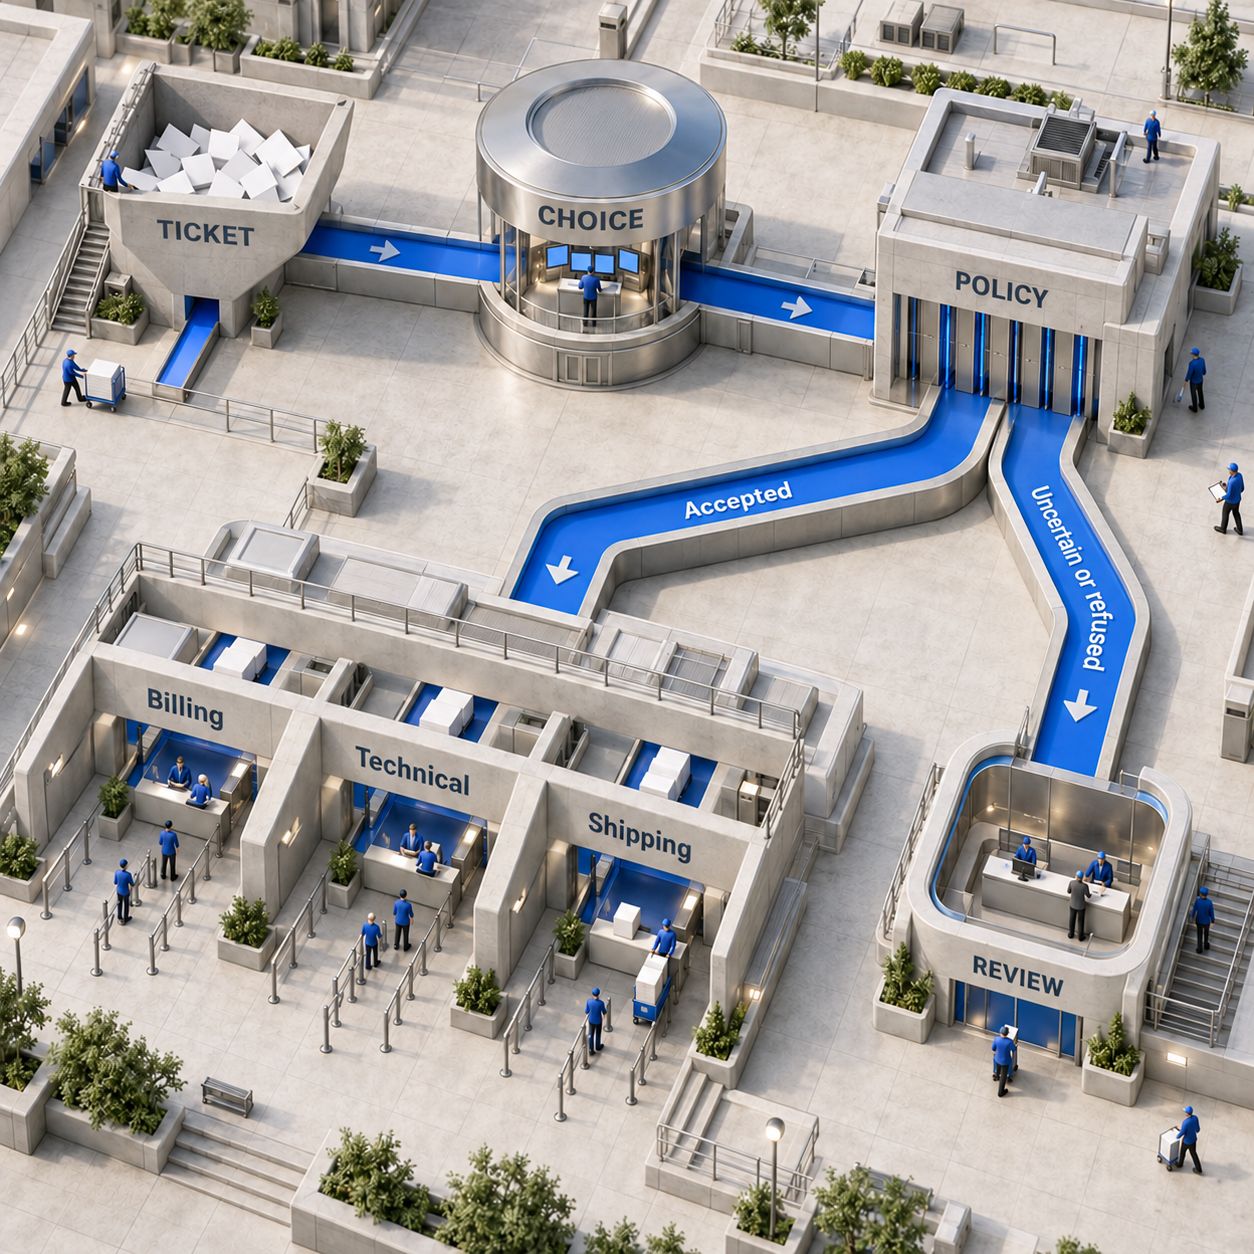
첫 버전은 담당 큐 배정에 집중합니다. 고객 지원팀이 티켓 제목과 관련 고객 메시지를 전달하면 모델이 담당 부서를 선택하고, 일반 애플리케이션 코드가 라우팅 정책을 적용하는 방식입니다.
가이드의 큐 정의를 출발점으로 삼되, 실제 팀의 담당 업무 범위에 맞게 바꿉니다. 지정한 부서가 처리하지 않는 요청을 위해 other 선택지는 남겨 둡니다. 환불 요청을 결제 담당 부서에 배정하는 것과 환불을 승인하는 것은 별개입니다.
아래의 간단한 애플리케이션 어댑터는 성공한 JSON 응답을 파싱하고 department 답을 선택한 뒤 적용할 정책을 보여줍니다. thresholds에는 정답 라벨이 있는 티켓으로 검증한 임곗값을 넣어야 합니다. 해당 임곗값이 없으면 티켓을 수동 검토 대상으로 남깁니다.
QUEUES = {
    "billing": "billing",
    "technical": "technical",
    "shipping": "shipping",
}

def queue_for(answer, thresholds):
    if answer.get("type") == "refusal":
        return "manual_review"
    if answer.get("type") != "choice":
        return "manual_review"
    department = answer.get("choice")
    if department not in QUEUES:  # Includes the guide's "other" choice.
        return "manual_review"
    cutoff = thresholds.get(department)
    confidence = answer.get("confidence")
    if cutoff is None or confidence is None or confidence < cutoff:
        return "manual_review"
    return QUEUES[department]
여기서 제안하는 워크플로에서는 API 오류, 타임아웃, 답 누락도 수동 검토로 보냅니다. 질문 버전, 제안된 큐, 신뢰도, 최종 큐, 담당자의 수정 내용을 기록합니다. 큐 업데이트는 재시도해도 안전하게 설계해야 합니다. 요청을 재시도했다고 중복 배정이 생겨서는 안 됩니다.
같은 티켓에 대한 서로 독립적인 질문은 하나의 요청에 담을 수 있습니다. 앞선 답에 따라 의미가 달라지는 후속 질문은 다음 요청으로 보내야 합니다. 여러 질문을 처리하는 방법
정답 라벨이 있는 데이터로 임곗값을 정합니다
업무에서 어느 정도의 오류를 감당할 수 있는지 측정해 임곗값을 정합니다. OpenAI는 가이드에 신뢰도 보정 수치를 공개하지 않으며, 애플리케이션의 라벨링된 데이터를 사용하도록 안내합니다. 신뢰도 값이 높다고 해서 실제 티켓에서도 그 비율만큼 정답을 보장하는 것은 아닙니다. 응답 해석 방법
지원팀 책임자가 올바른 배정 대상을 확인한 과거 티켓부터 사용합니다. 짧은 요청, 여러 문제가 섞인 문의, 맥락이 부족한 건, 모델을 겨냥한 지시문이 포함된 민원도 넣습니다. 질문과 임곗값을 조정하는 데 쓸 예제와 최종 비교를 위해 따로 보관할 평가 데이터는 분리합니다.
잘못된 큐로 배정한 비율, 검토로 보낸 비율, 담당자가 배정을 수정하는 데 쓴 시간을 측정합니다. 큐별로도 나눠 확인합니다. 배송 문의를 결제 문의로 잘못 분류하는 것과 계정 탈취 신고를 놓치는 것은 운영상 비용이 다를 수 있습니다.
먼저 실제 배정은 바꾸지 않은 채 새 후보를 기존 분류기와 함께 실행합니다. 문서로 정한 도입 기준을 충족했을 때만 전환합니다. 되돌릴 수 있도록 기존 처리 경로도 유지합니다. 이는 권장 도입 절차이며, 이 API를 직접 시험해 얻은 결과는 아닙니다.
데이터 라벨링 등 먼저 시도할 활용처 6가지
초기 도입에 적합한 작업은 범주가 안정적이고, 오류를 확인할 수 있으며, 예외를 처리할 담당자가 이미 정해져 있는 일입니다. 아래 순위는 구현 관점의 판단이며 정확도 순위표는 아닙니다.
라벨링에서는 레코드 하나에 여러 주제를 허용할지 먼저 정합니다. 단일 choice는 범주 하나만 고릅니다. 라벨이 겹칠 수 있다면 질문을 따로 두는 편이 적합할 수 있습니다. 장애 심각도는 기능 상실이나 우회 방법 유무처럼 운영상 확인할 수 있는 기준으로 정의합니다. “심각함” 같은 표현은 모델이 자의적으로 해석할 여지를 너무 많이 남깁니다.
요금 차이가 실제 비용에 미치는 영향
가이드에 제시된 gpt-6-luna 요금은 입력 토큰 1M당 $0.10이며, 출력·캐시 읽기·캐시 쓰기 요금은 없습니다. 리전별 처리 할증과 장문 컨텍스트 입력 배수가 적용될 수 있습니다. 이는 Decisions 요금입니다. 같은 모델을 쓰더라도 일반 호출에 이 과금 방식을 적용해서는 안 됩니다. Decisions 요금 안내
다음은 가정한 일괄 처리 작업의 비용 계산 예시입니다. 실제 사용량 측정치나 판단 건당 정액 요금이 아닙니다. 분류 호출 100,000건에 호출당 지시문과 선택지를 포함한 캐시 미적용 입력 토큰 1,000개가 있다고 가정합니다. 기존 Responses 호출에는 호출당 과금 대상 출력 토큰이 총 50개라고 추가로 가정합니다. 짧은 컨텍스트의 표준 기본 요금을 적용하며, 캐시 쓰기, 리전 할증, 재시도, 기타 비용은 제외합니다.
일반 모델 요금은 OpenAI 표준 요금표를 기준으로 합니다. 이 예시에서 출력 과금이 사라져 절약하는 금액은 전체 일괄 처리 작업을 합쳐 $2.50입니다. 이것만으로 잘 작동하는 연동을 다시 작성할 이유는 부족합니다.
더 설득력 있는 도입 근거는 운영에 있습니다. 순차 처리 워크플로의 대기 시간을 줄이거나, 응답 처리 코드를 간소화하거나, 같은 오류율에서 수동 분류를 줄일 수 있어야 합니다. 실제 청구액과 검토 작업량을 기준으로 비교합니다. 기존 모델이 더 비싸거나 생성하는 답이 길면 계산 결과가 달라집니다. 이미 받는 캐시 할인도 영향을 줍니다. 개발 시간과 잘못 배정된 티켓의 비용 역시 이전 예산에 포함해야 합니다.
만들어 볼 만한 제품 두 가지
첫 번째 후보: 검토와 수동 변경 이력을 갖춘 고객 문의 라우터
지원 운영 책임자라면 정해진 큐를 제안하고, 불확실한 건은 보류하며, 담당자의 수정 내용을 평가 데이터로 바꾸는 커넥터에 비용을 지불할 수 있습니다. 제품의 가치는 유지 관리까지 포함한 전체 라우팅 워크플로에 있습니다.
2026년 10월 11일 확인한 DataForSEO 추정치에서 “ticket triage”의 미국 Google 월간 검색량은 170회입니다. 이는 좁은 범위의 정보 탐색 수요를 보여주는 신호이지 구매자 수가 아닙니다. 기존 헬프데스크 제품도 이 업무를 다룹니다. Zendesk는 지능형 분류 기능을 제공하며, 이를 워크플로에 활용하려면 Copilot 추가 기능이 필요합니다. Zendesk 분류 가이드
최소한의 실용적인 버전은 헬프데스크 하나를 지원하고, 과거 티켓을 가져오며, 큐 배정을 미리 보여주고, 수동 변경이 가능한 검토함을 제공하는 형태가 될 수 있습니다. 가장 강력한 판매 근거는 고객사의 불필요한 이관이 얼마나 줄었는지입니다. 걸림돌은 기존 제품이 이미 처리하는 범위입니다. 헬프데스크가 큐 배정을 잘하고 있다면 라우터 하나가 유지 관리 부담만 늘릴 수 있습니다. 특정 담당 범위의 문제나 시스템 간 이관 문제를 해결하는 데 집중해야 합니다.
두 번째 후보: 고정 라벨을 위한 검토 작업 도구
리서치팀이나 데이터팀이라면 라벨을 제안하고, 수정 사항을 수집하며, 어느 범주에서 의견이 계속 갈리는지 보여주는 작업 도구에 비용을 지불할 수 있습니다. 같은 시점에 확인한 DataForSEO 추정치에서 “automated data labeling”의 미국 Google 월간 검색량은 90회입니다. 이는 해당 업무에 대한 관심을 나타낼 뿐, 이런 구현물에 돈을 낼 의향까지 입증하지는 않습니다.
첫 버전은 CSV를 받아 버전이 지정된 라벨 세트를 적용하고, 불확실한 행을 검토 대상으로 보여준 뒤, 수정된 결과를 내보내는 형태가 될 수 있습니다. 라벨 변경의 효과를 공정하게 비교하도록 별도의 평가 데이터를 유지합니다. 주의할 점은 모델이 불명확한 분류 체계도 저렴하게 그대로 재현할 수 있다는 것입니다. 제품에는 좋은 검토 기능과 범주 관리 툴이 필요합니다. API 호출을 감싼 기능만으로는 쉽게 복제됩니다.
먼저 만들 제품으로는 고객 문의 라우터가 더 유망합니다. 큐별 담당 범위가 정해져 있으면 오류가 드러나고, 이를 고칠 운영자가 있으며, 가치를 반복해서 입증할 업무도 있습니다. 범용 의사결정 플랫폼을 만들기 전에 그 운영자부터 인터뷰합니다.
기존 방식을 유지하는 편이 나은 경우
직접 정한 JSON 스키마로 필드를 추출하거나, 글로 된 설명을 받거나, 모델이 인자를 포함해 툴 호출을 요청해야 한다면 Responses API를 유지합니다. Decisions가 제공하는 응답 유형은 위에서 설명한 범위로 한정됩니다. 인터페이스 선택에 관한 OpenAI 안내
계정 필드나 명시적인 정책에 이미 답이 있다면 결정론적 규칙을 유지합니다. “이 지역의 고객은 이 팀으로 배정한다”는 규칙에 모델을 추가해도 얻는 것이 거의 없습니다. 중요한 결과를 초래하는 행동에는 사람의 승인과 애플리케이션의 권한 검사를 유지해야 합니다. 라우팅 판단은 환불 워크플로에 참고할 수 있지만, 고객의 환불 자격이나 담당자의 처리 권한을 확정해 주지는 못합니다.
이전 일정을 잡기 전에 다음 연동 제약을 확인합니다.
- 이미지: 가이드는 인라인 base64 데이터 URL만 허용합니다. 이미지 바이트를 인코딩해 요청 안에 넣는 방식입니다. 가이드에 따르면 HTTP 또는 HTTPS로 호스팅되는 이미지 URL과, 이전에 업로드한 파일을 가리키는
file_id는 지원하지 않습니다. 이미지 입력 요건 - 데이터 제어: 가이드는 Zero Data Retention(ZDR)과 자격 요건을 갖춘 고객이 HIPAA 관련 용도로 사용하는 것을 지원한다고 명시합니다. 데이터 레지던시와 리전별 처리는 미국과 유럽, 구체적으로 EEA + 스위스에서 지원합니다. 자격 요건, 계약, 설정, 제한 사항이 적용되며 계정에 자동으로 적용되는 기본 설정은 아닙니다. Decisions 제공 범위, OpenAI 데이터 제어
- 출시 단계: 공개 베타인 만큼 되돌릴 경로를 남겨야 합니다. 기존 분류기가 목표를 충족하고 변경해도 측정 가능한 이점이 없다면 그대로 유지합니다.
대안으로 비교할 Jev, Clef, Microsoft-Decision-1
제공업체를 바꾸기 전에 같은 라벨링 데이터로 후보를 비교합니다. TypeSafe의 Jev는 System One API를 통해 상태와 타입이 지정된 질문을 받습니다. Cloudflare Clef는 Workers AI에서 타입이 지정된 판단 결과를 제공합니다. Microsoft-Decision-1은 Microsoft Foundry에서 사용할 수 있으며 분류, 라우팅, 우선순위 결정 등을 처리합니다. TypeSafe 빠른 시작, Cloudflare Clef 문서, Microsoft 발표
기존 연동, 호스팅 요건, 평가 결과, 예외 처리 방식을 기준으로 후보를 추립니다. Jev 고객 문의 티켓 라우팅 가이드에서는 라우팅 패턴을 다루며, Jev Router는 무료인가요?에서는 라우터 소프트웨어와 호스팅 추론의 차이를 설명합니다. 제공업체마다 요청 형식과 신뢰도 동작을 별도로 확인해야 합니다.
기존 분류 호출을 Decisions로 바꿔야 하나요?
출력이 고정 범주, 조건 충족 가능성, 평가 기준에 따른 점수라면 시험해 볼 만합니다. 같은 라벨링 예제로 라우팅 오류, 수동 검토 작업량, 비용, 처리 시간을 비교합니다. 개선 폭이 이전 비용을 정당화하지 못한다면 기존 호출을 유지합니다.
응답이 거부되면 애플리케이션은 어떻게 처리해야 하나요?
값을 읽기 전에 응답 유형을 확인합니다. 고객 문의 라우터에서는 응답 거부를 수동 검토로 보내고 담당자가 처리할 수 있을 만큼 맥락을 남깁니다. 응답이 거부됐다고 기본 행동을 실행할 권한이 생기는 것은 아닙니다.
신뢰도 임곗값은 얼마로 설정해야 하나요?
직접 운영하는 워크플로의 라벨링 데이터로 정합니다. 후보 임곗값마다 오류와 검토 물량을 측정하고, 가능하면 큐별로도 나눠 봅니다. 이 글에서 제시하는 범용 임곗값은 없으며 OpenAI 가이드에도 신뢰도 보정 표가 없습니다.
호스팅된 이미지 URL이나 업로드한 파일 ID를 전달할 수 있나요?
가이드의 인라인 base64 데이터 URL 형식을 따릅니다. 가이드는 이 엔드포인트에서 호스팅된 이미지 URL과 file_id 입력을 명시적으로 제외합니다. 위의 predicate 요청이 가이드에서 지원하는 형식을 보여줍니다.
이번 주에 시작할 일
정해진 큐 집합으로 티켓을 보내는 분류 호출 하나를 고릅니다. 담당자가 대표성 있는 라벨링 표본을 확인하고, 허용할 오류율과 검토 비율을 문서로 정하게 합니다. 실제 배정은 바꾸지 않은 채 Decisions와 현재 호출을 나란히 비교합니다. 업무 흐름에서 쓸 만한 가치가 입증된 뒤에만 전환합니다.
기존 툴에 맞춘 라우팅 워크플로가 필요하다면, 실제 운영에 쓰이는 AI 시스템을 구축해 드립니다.
- 게시일
- 카테고리
- Build
- 언어

Claude Code 사용법: Remote Control로 모바일에서 작업 이어가기
Claude Code 사용법 중 Remote Control 설정을 정리합니다. CLI·VS Code·Desktop에서 세션을 시작하고 스마트폰이나 브라우저로 연결하는 방법, 로그인·연결 오류의 원인과 해결법, 로컬 실행과 대화 기록 저장의 차이까지 확인합니다.2026년 10월 9일Build
모바일 코딩: iPhone에서 Cursor 로컬 에이전트 원격 제어하기
iPhone에서 Cursor 로컬 에이전트의 작업을 확인하고 다음 지시를 보내는 모바일 코딩 방법을 정리합니다. 기기 페어링, 노트북 전원·절전 설정, Enterprise 관리자 설정부터 요금과 클라우드 에이전트·Claude Code·Codex의 연결 방식 차이까지 살펴봅니다.2026년 10월 9일Build
Firecrawl 가격 2026: 요금제와 실제 수집 비용 계산법
Firecrawl 가격과 요금제를 크레딧 기준으로 비교합니다. 일반 스크래핑과 JSON 추출, 매주 크롤링의 비용 계산을 확인하고 연 결제 청구액, 오류 페이지 과금, 자동 충전 한도와 셀프 호스팅·대안 툴의 운영비까지 검토해 다음 수집 작업의 예산을 정해 보세요.2026년 10월 9일Build
AI 코딩, 무엇을 쓸까? Claude Code와 GitHub Copilot 2026 비교
AI 코딩 툴 선택을 위해 Claude Code와 GitHub Copilot의 요금제, 사용량 한도, 지원 모델·팀 관리 기능을 비교합니다. 개인 개발자와 10인 팀의 비용, 터미널·에디터 작업의 차이, 두 툴을 함께 쓸 때의 구성을 살펴보고 업무 방식에 맞는 구독을 고를 수 있습니다.2026년 10월 8일Build
LangGraph vs CrewAI 비교: 승인 흐름·메모리·비용으로 고르는 법
LangGraph와 CrewAI를 같은 기업 조사·이메일 초안·승인 워크플로로 비교합니다. 상태 복구, 메모리, 사람 검토, MCP, 관측 가능성과 호스팅 비용을 살펴보고, 개인 개발자부터 스타트업·기업 팀까지 어떤 실행 구조와 운영 부담이 맞는지 판단할 기준을 제시합니다.2026년 10월 7일Build
MCP 서버 만들기: Python 주문 조회부터 인증·배포까지
Python으로 MCP 서버를 직접 만들고 주문 조회 툴을 구현합니다. Inspector 검증부터 Claude Code·Cursor 연결, 로컬 stdio와 원격 HTTP 선택, OAuth 인증, Render·Cloudflare Workers 배포 및 운영 비용까지 살펴봅니다.2026년 10월 7일Build
AI 에이전트 툴 Gumloop vs n8n: 가격·구축·운영 비교 (2026년 10월 검증)
AI 에이전트 툴 Gumloop와 n8n을 가격, 과금 단위, 구축 담당자, 호스팅 방식으로 비교합니다. 같은 리드 업무의 비용 교차점과 Community 협업 제약, 트리거 동작까지 살펴보고 팀에 맞는 자동화 툴을 고르세요. 2026년 10월 검증한 가격과 요금제 정보를 담았습니다.2026년 10월 7일Build