OpenAI Decisions API: come smistare ticket e valutare azioni
Come usare OpenAI Decisions API per smistare ticket e valutare azioni: esempi di richieste, gestione dei rifiuti, prezzi, limiti e criteri per migrare.
Pubblicato il
 Di Omid Saffari




Con OpenAI Decisions API puoi smistare ticket, assegnare etichette ai record e valutare le azioni proposte dagli agenti, ottenendo risposte direttamente utilizzabili dal codice. Se oggi chiami un LLM solo per ricevere una categoria o una valutazione, vale la pena provarla. Sostituisci la chiamata esistente soltanto quando la qualità dello smistamento è almeno equivalente e il miglioramento del flusso di lavoro giustifica la migrazione.
OpenAI Decisions API: parti dalla decisione che serve al codice
Pensa a Decisions come a un addetto allo smistamento con un elenco preciso di destinazioni. Tu fornisci gli elementi da valutare e la domanda; l’applicazione stabilisce cosa fare quando arriva la risposta.
All’11 ottobre 2026, l’API è in beta pubblica, con disponibilità generale prevista «nelle prossime settimane». È una previsione di OpenAI, non una data di rilascio. gpt-6-luna è l’unico modello supportato e l’endpoint è POST /v1/decisions. OpenAI la descrive come «circa 10x più veloce della Responses API». Considerala una dichiarazione del fornitore, non un risultato misurato sulla tua applicazione. Guida di OpenAI a Decisions
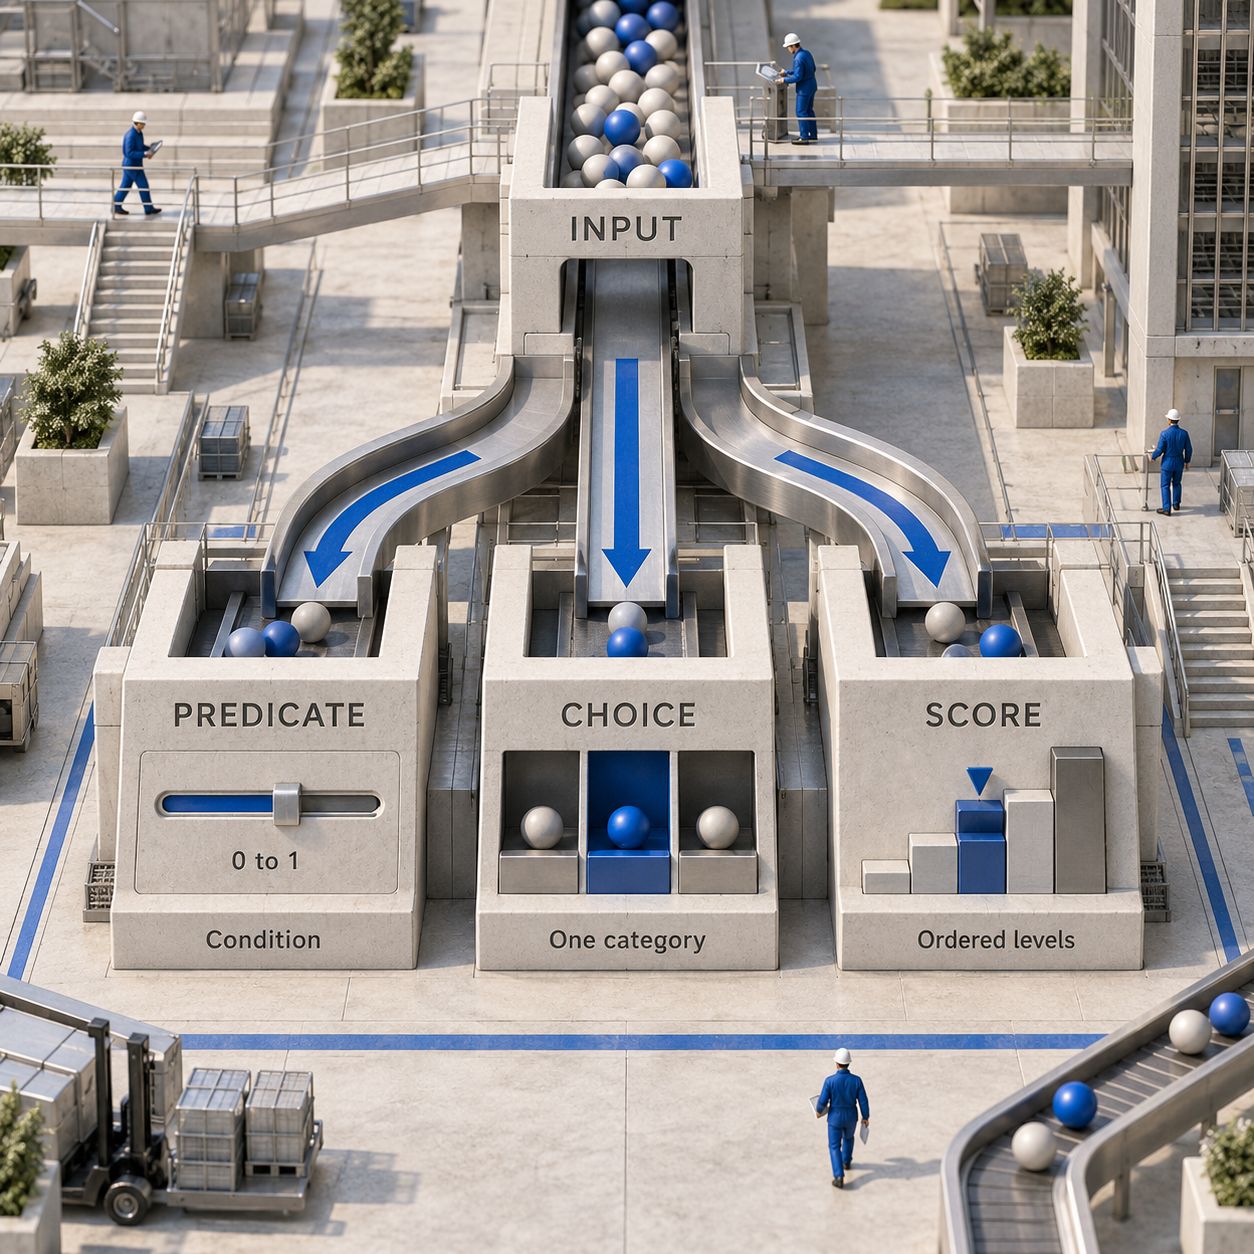
Scegli la forma della risposta prima di scrivere il prompt:
Nel caso di un punteggio, i livelli partono dall’indice 0. Il risultato può cadere tra due livelli, perché sintetizza l’incertezza distribuita tra questi. Usa una scelta quando al codice serve una sola categoria. Tipi di domanda
Come inviare le tre richieste
Questi sono i tre esempi di richiesta cURL della guida, riprodotti uniformando la formattazione e aggiungendo commenti per distinguerli. Imposta OPENAI_API_KEY nell’ambiente della shell; per l’esempio predicate serve anche un file locale product.png. Ogni comando invia una richiesta distinta. Gli esempi sono stati confrontati con la guida pubblica, ma non eseguiti con un account autenticato. Esempi di richiesta originali
Gli elementi comuni sono input, cioè il materiale da valutare, e questions, le decisioni da prendere su quel materiale. Il campo name di una domanda ne identifica la risposta nell’array answers restituito. Riferimento per richieste e risposte
# Predicate: inspect product.png for visible damage
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"

curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @- <<JSON
{
  "model": "gpt-6-luna",
  "input": [{
    "role": "user",
    "content": [
      {"type": "input_text", "text": "Inspect the product in this photo."},
      {"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
    ]
  }],
  "questions": [{
    "type": "predicate",
    "name": "visible_damage",
    "instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
  }]
}
JSON

# Choice: route a customer complaint
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice",
      "name": "department",
      "instructions": "Which department should handle this complaint?",
      "choices": [
        {"value": "billing", "description": "Payments, invoices, and refunds."},
        {"value": "technical", "description": "Problems using the product."},
        {"value": "shipping", "description": "Delivery and tracking."},
        {"value": "other", "description": "Requests outside these categories."}
      ]
    }]
  }'

# Score: assess issue severity
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Export fails in Safari but works in Chrome.",
    "questions": [{
      "type": "score",
      "name": "severity",
      "instructions": "How severe is this issue?",
      "levels": [
        {"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
        {"label": "Workaround available", "description": "A task fails, but another way works."},
        {"label": "Fully blocked", "description": "A task fails with no workaround."}
      ]
    }]
  }'
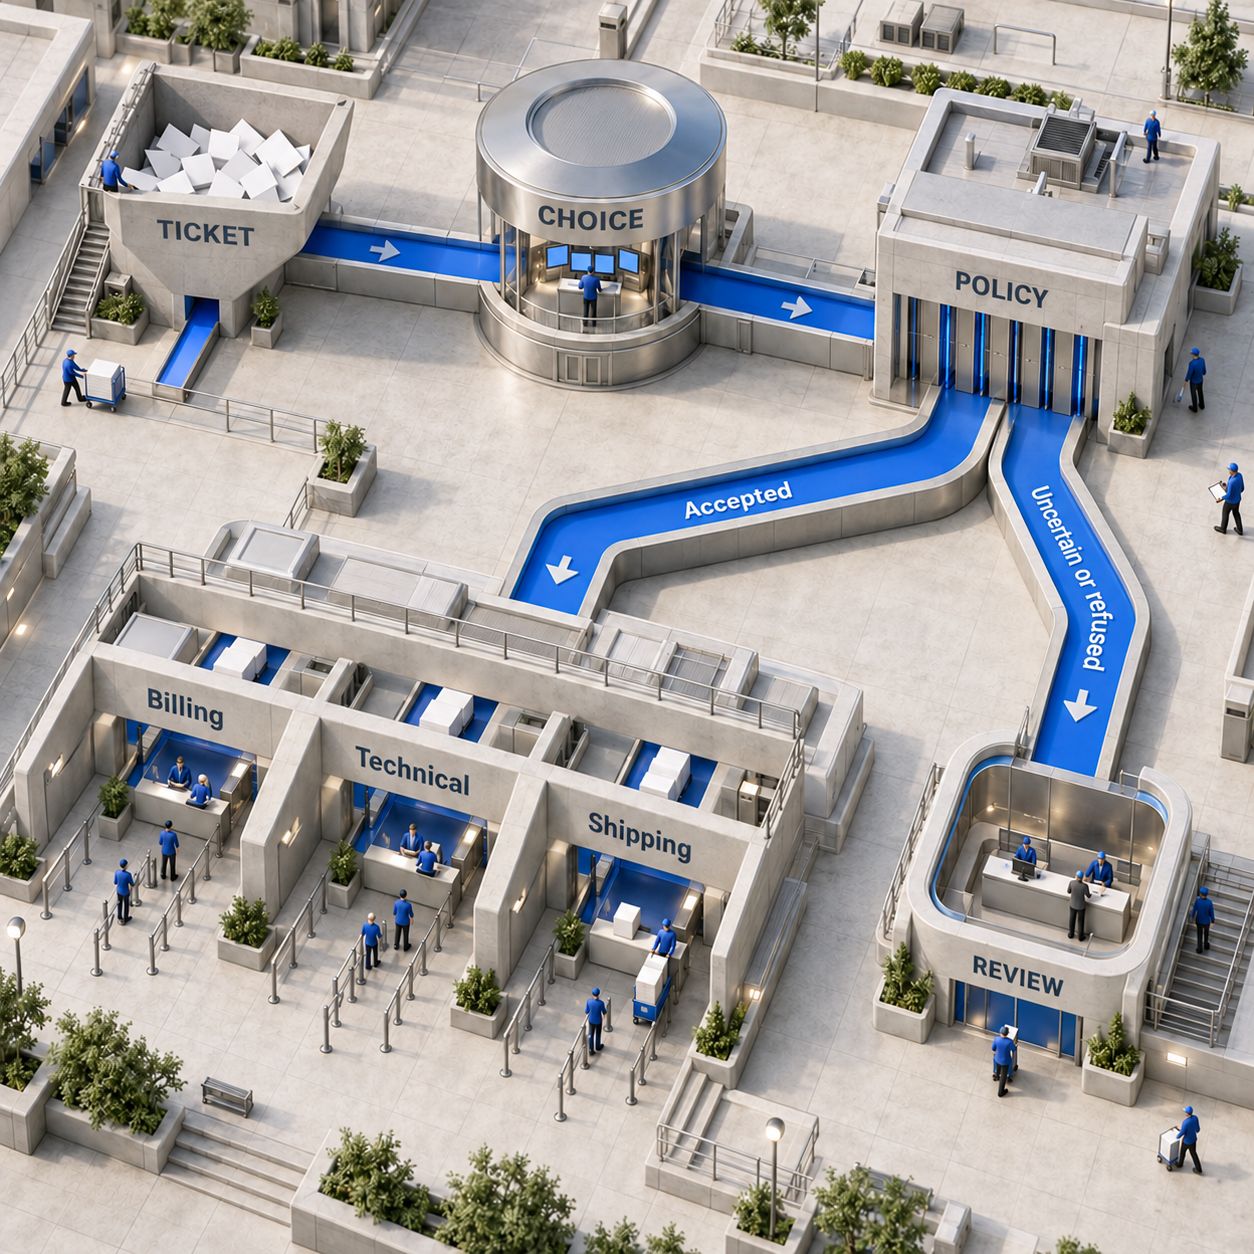
L’esempio choice offre già un punto di partenza concreto: il reclamo per un doppio addebito deve finire in una delle code previste. L’esempio score risponde a una domanda diversa: quanto incide un malfunzionamento se con un altro browser tutto funziona? Tieni separati il reparto competente e la gravità del problema: una questione di fatturazione può essere urgente senza diventare un ticket tecnico.
Gestisci il rifiuto prima di leggere il valore. Gli esempi SDK della guida verificano answer.type == "refusal" prima di accedere a probability, choice o score. Un rifiuto è un esito distinto: non equivale a una risposta con bassa confidenza né alla categoria other. Gestione dei rifiuti
Dalla scelta al triage dei ticket di assistenza
Costruisci la prima versione attorno all’assegnazione alle code. Il team di assistenza potrebbe inviare l’oggetto del ticket e il messaggio pertinente del cliente, ricevere la scelta del reparto e lasciare al normale codice applicativo il compito di applicare le regole di smistamento.
Parti dalle definizioni delle code nella guida e adattale alle competenze effettive dei tuoi reparti. Mantieni un’opzione other per le richieste che non rientrano in nessuno di essi. Una richiesta di rimborso spetta alla fatturazione; questo non autorizza il rimborso.
Questo piccolo adattatore applicativo mostra come applicare le regole dopo aver elaborato una risposta JSON ricevuta correttamente e selezionato la risposta department. thresholds deve contenere soglie stabilite su ticket etichettati; se manca una soglia, il ticket resta in attesa di revisione.
QUEUES = {
    "billing": "billing",
    "technical": "technical",
    "shipping": "shipping",
}

def queue_for(answer, thresholds):
    if answer.get("type") == "refusal":
        return "manual_review"
    if answer.get("type") != "choice":
        return "manual_review"
    department = answer.get("choice")
    if department not in QUEUES:  # Includes the guide's "other" choice.
        return "manual_review"
    cutoff = thresholds.get(department)
    confidence = answer.get("confidence")
    if cutoff is None or confidence is None or confidence < cutoff:
        return "manual_review"
    return QUEUES[department]
Nel flusso proposto, anche errori dell’API, timeout e risposte mancanti lasciano i ticket alla revisione manuale. Registra la versione della domanda, la coda proposta, la confidenza, la coda finale e le eventuali correzioni degli operatori. Fai in modo che l’aggiornamento della coda possa essere ripetuto senza effetti indesiderati: un nuovo tentativo della stessa richiesta non deve creare assegnazioni duplicate.
Puoi riunire nella stessa richiesta domande indipendenti sul medesimo ticket. Se invece il significato di una domanda successiva dipende da una risposta precedente, inviala in una richiesta separata, dopo aver ricevuto quella risposta. Indicazioni per le richieste con più domande
Come definire le soglie sui ticket etichettati
Scegli le soglie misurando gli errori che l’attività può tollerare. Nella guida OpenAI non pubblica dati di calibrazione e invita gli sviluppatori a usare dati etichettati della propria applicazione. Un valore di confidenza non garantisce che, sui tuoi ticket, la risposta sarà corretta con quella frequenza. Come interpretare le risposte
Parti da ticket passati la cui destinazione corretta sia stata verificata da un responsabile dell’assistenza. Includi richieste brevi, problemi di natura diversa nello stesso messaggio, contesto mancante e reclami che contengono istruzioni rivolte al modello. Tieni separati gli esempi usati per perfezionare domande e soglie da un insieme riservato al confronto finale.
Misura le assegnazioni alla coda sbagliata, la quota di ticket inviata alla revisione e il tempo che gli operatori dedicano a correggere le assegnazioni. Analizza ogni coda separatamente. Confondere una spedizione con un problema di fatturazione può avere un costo operativo diverso dal non riconoscere una segnalazione di account compromesso.
Inizialmente affianca il nuovo sistema al classificatore esistente senza modificare le assegnazioni effettive. Mettilo in produzione solo quando i risultati soddisfano un criterio di accettazione scritto. Mantieni disponibile il percorso precedente per poter tornare indietro. Questi sono passaggi di messa in produzione proposti, non risultati di un test di questa API.
Sei casi d’uso da provare, in ordine di priorità
Per iniziare, cerca attività con categorie stabili, errori osservabili e una persona già responsabile delle eccezioni. L’ordine riflette una valutazione pratica di implementazione, non una classifica di accuratezza.
Per l’etichettatura, stabilisci se ogni record può appartenere a più temi. Una singola scelta seleziona una sola categoria; per etichette sovrapposte possono essere più adatte domande separate. Per la gravità degli incidenti, definisci l’impatto in termini operativi, come la perdita di funzionalità e la disponibilità di soluzioni alternative. Parole come «grave» lasciano troppo spazio all’interpretazione del modello.
Quanto incide davvero il prezzo
La guida indica un prezzo di input di $0.10 per 1M di token su gpt-6-luna, senza addebiti per output, lettura o scrittura della cache. Possono applicarsi maggiorazioni per l’elaborazione regionale e moltiplicatori sull’input per contesti lunghi. Sono le tariffe di Decisions: non estendere queste regole di fatturazione alle normali chiamate allo stesso modello. Prezzi di Decisions
Quello che segue è un calcolo su un lotto ipotetico, non una misurazione dei consumi né un prezzo fisso per decisione. Supponiamo di effettuare 100,000 chiamate di classificazione, ciascuna con 1,000 token di input non presenti in cache, comprese istruzioni e opzioni. Per la chiamata Responses esistente, ipotizziamo anche 50 token di output fatturati complessivamente per chiamata. Usiamo le tariffe base standard per contesti brevi, senza scritture in cache, maggiorazioni regionali, nuovi tentativi o altri addebiti.
Le tariffe ordinarie del modello provengono dal listino standard di OpenAI. In questo esempio, eliminare l’addebito dell’output fa risparmiare $2.50 sull’intero lotto. Da solo, è un motivo debole per riscrivere un’integrazione funzionante.
L’argomento più solido è operativo: meno attese in un flusso sequenziale, meno codice per gestire le risposte o meno smistamento manuale a parità di errori. Fai il confronto con la fattura effettiva e il carico di revisione. I conti cambiano se il modello già in uso è più costoso o genera risposte più lunghe; lo stesso vale per eventuali sconti sulla cache già applicati. Nel budget della migrazione vanno inclusi anche il tempo di sviluppo e i ticket indirizzati al reparto sbagliato.
Due prodotti che vale la pena sviluppare
Prima scelta: smistamento ticket con revisione e storico delle correzioni
Un responsabile delle operazioni di assistenza potrebbe pagare per un connettore che suggerisce code predefinite, trattiene i casi incerti e trasforma le correzioni degli operatori in dati di valutazione. Il prodotto utile è l’intero flusso di smistamento, manutenzione compresa.
DataForSEO stima 170 ricerche mensili su Google negli Stati Uniti per «ticket triage», dato verificato l’11 ottobre 2026. È un segnale circoscritto di domanda informativa, non un conteggio di potenziali acquirenti. Anche i prodotti helpdesk esistenti coprono questa esigenza: Zendesk offre classificazioni di triage intelligente e richiede il componente aggiuntivo Copilot per usarle nei flussi di lavoro. Guida al triage di Zendesk
La versione minima utile potrebbe supportare un helpdesk, importare ticket storici, mostrare un’anteprima delle assegnazioni e offrire una casella di revisione con possibilità di correggerle. La prova commerciale più convincente sarebbe la riduzione dei passaggi evitabili tra reparti del cliente. L’ostacolo è la copertura già offerta dagli strumenti in uso: se l’helpdesk gestisce bene le code, un altro sistema di smistamento aggiunge manutenzione. Punta su un problema specifico di attribuzione delle responsabilità o di passaggio tra sistemi.
Seconda scelta: un ambiente di revisione per etichette predefinite
Un team di ricerca o dati potrebbe pagare per un ambiente che suggerisce etichette, raccoglie correzioni e mostra quali categorie continuano a generare disaccordo. Nella stessa verifica, DataForSEO stima 90 ricerche mensili su Google negli Stati Uniti per «automated data labeling». Il dato indica interesse per l’attività, non dimostra la disponibilità a pagare per questa implementazione.
Una prima versione potrebbe acquisire un CSV, applicare un insieme di etichette con controllo delle versioni, presentare le righe incerte per la revisione ed esportare i risultati corretti. Conserva un insieme di valutazione separato, così da confrontare in modo equo le modifiche alle etichette. Il limite è che un modello può riprodurre a basso costo anche una tassonomia poco chiara. Il prodotto deve offrire validi strumenti di revisione e gestione delle categorie; un’interfaccia attorno a una chiamata API è facile da copiare.
Il sistema di smistamento dei ticket è il prodotto più solido da cui iniziare. L’attribuzione dei ticket ai reparti rende visibili gli errori, individua un operatore che può correggerli e offre un flusso ricorrente su cui dimostrare il valore del prodotto. Intervista quell’operatore prima di costruire una piattaforma decisionale generica.
Quando conviene mantenere la soluzione attuale
Mantieni la Responses API quando ti servono campi estratti secondo uno schema JSON definito da te, una spiegazione scritta o una chiamata a uno strumento richiesta dal modello, completa di argomenti. Decisions si limita ai tipi di risposta descritti sopra. Indicazioni di OpenAI sulla scelta dell’interfaccia
Mantieni le regole deterministiche quando la risposta è già in un campo dell’account o in una regola esplicita. Un modello aggiunge poco a «assegna i clienti di questa regione a questo team». Per le azioni con conseguenze rilevanti, conserva l’autorizzazione umana e i controlli dei permessi applicativi. Una valutazione di smistamento può contribuire a un flusso di rimborso; non può stabilire se il cliente ne abbia diritto o se l’operatore sia autorizzato a concederlo.
Verifica questi vincoli di integrazione prima di pianificare una migrazione:
- Immagini: la guida ammette soltanto URL data inline in base64, cioè con i byte dell’immagine codificati all’interno della richiesta. Secondo le indicazioni della guida, non sono supportati URL di immagini ospitate via HTTP o HTTPS né
file_id, il riferimento a un file già caricato. Requisiti per le immagini in input - Controlli sui dati: la guida dichiara il supporto a Zero Data Retention, o ZDR, e all’utilizzo in ambito HIPAA per i clienti idonei. La residenza dei dati e l’elaborazione regionale sono supportate negli Stati Uniti e in Europa, nello specifico SEE + Svizzera. Si applicano requisiti di idoneità, accordi, configurazioni e limitazioni: non sono impostazioni attive automaticamente per tutti gli account. Disponibilità di Decisions, Controlli sui dati di OpenAI
- Maturità del rilascio: la beta pubblica è un motivo per mantenere la possibilità di tornare alla soluzione precedente. Se il classificatore attuale raggiunge gli obiettivi e sostituirlo non porta vantaggi misurabili, mantienilo.
Le alternative: Jev, Clef e Microsoft-Decision-1
Prima di cambiare fornitore, confronta le soluzioni sullo stesso insieme di dati etichettati. Jev, di TypeSafe, accetta uno stato e domande tipizzate attraverso la sua System One API. Cloudflare Clef offre decisioni tipizzate in Workers AI. Microsoft-Decision-1 è disponibile in Microsoft Foundry per attività tra cui classificazione, smistamento e assegnazione delle priorità. Guida rapida di TypeSafe, Documentazione di Cloudflare Clef, Annuncio di Microsoft
Integrazioni esistenti, requisiti di hosting, risultati delle valutazioni e gestione delle eccezioni devono guidare la selezione. La nostra guida allo smistamento dei ticket con Jev descrive il modello di smistamento; Jev Router è gratuito? chiarisce la differenza tra il software di routing e l’inferenza ospitata. Valuta separatamente il formato delle richieste e il comportamento dei valori di confidenza di ciascun fornitore.
Conviene sostituire la mia chiamata di classificazione con Decisions?
Provala quando l’output è una categoria predefinita, la stima di una condizione o un punteggio basato su una griglia di valutazione. Confronta errori di smistamento, carico di revisione manuale, costi e tempi sugli stessi esempi etichettati. Mantieni la chiamata attuale se il miglioramento non giustifica la migrazione.
Cosa deve fare l’applicazione se Decisions rifiuta di rispondere?
Controlla il tipo di risposta prima di leggerne il valore. In un sistema di smistamento dei ticket, invia il caso alla revisione manuale e conserva abbastanza contesto perché gli operatori possano gestirlo. Un rifiuto non autorizza a scegliere un’azione predefinita.
Quale soglia di confidenza dovrei usare?
Definiscila sui dati etichettati del tuo flusso di lavoro. Per ogni soglia candidata, misura gli errori e il volume di revisioni, preferibilmente distinguendo le code. Questo articolo non fornisce una soglia universale e la guida di OpenAI non contiene una tabella di calibrazione.
Posso passare l’URL di un’immagine online o l’ID di un file caricato?
Segui il formato con URL data inline in base64 indicato nella guida. Per questo endpoint la guida esclude esplicitamente gli URL di immagini ospitate e gli input file_id. La richiesta predicate riportata sopra mostra il formato supportato.
Da cosa partire lunedì
Scegli la chiamata di classificazione che assegna i ticket a un insieme consolidato di code. Chiedi al responsabile di controllare un campione rappresentativo già etichettato, metti per iscritto i tassi accettabili di errore e revisione e confronta Decisions con la chiamata attuale senza modificare le assegnazioni. Sostituiscila solo quando i risultati ne giustificano l’ingresso nel flusso di lavoro.
Se cerchi un flusso di smistamento costruito attorno agli strumenti che già usi, sviluppiamo sistemi AI pronti per l’uso in produzione.
- Pubblicato
- Categoria
- Build
- Lingua

Alternative a Jev nel 2026: quale modello scegliere
Alternative a Jev a confronto: prezzi in USD, licenze e limiti di OpenAI, Microsoft, Clef, Liquid d1, Perplexity e Strands per scegliere il modello adatto.11 ott 2026Build
Claude Code mobile: guida a Remote Control
Usa Claude Code dal telefono con Remote Control: configurazione da CLI, VS Code o Desktop, requisiti, notifiche e soluzioni agli errori di accesso.9 ott 2026Build
Cursor app: come controllare gli agenti da iPhone
Configura Cursor su iPhone per guidare gli agenti del portatile: abbinamento, requisiti, costi e differenze rispetto agli agenti cloud, Claude Code e Codex.9 ott 2026Build
Firecrawl pricing 2026: costi reali di pagine, JSON e crawl
Quanto costa Firecrawl? Confronta piani, crediti e fatture per scraping JSON e crawl settimanali, inclusi errori, ricariche e alternative a pari volume.9 ott 2026Build
Claude Code vs Copilot: prezzi, limiti e scelta nel 2026
Claude Code vs Copilot: confronta prezzi, limiti, modelli e controlli per i team. Scopri quale scegliere per l’editor, il terminale o per usarli insieme.8 ott 2026Build
Agenti AI in produzione: quando scegliere LangGraph o CrewAI
Confronta LangGraph e CrewAI per creare agenti AI: stato, memoria, approvazioni, MCP e costi di hosting sullo stesso workflow di ricerca e scrittura.7 ott 2026Build
Server MCP in Python: guida pratica dal test all'hosting
Crea un server MCP in Python per consultare gli ordini, testalo con Inspector e collegalo a Claude Code e Cursor. Poi passa a HTTP con autenticazione.7 ott 2026Build