Firecrawl pricing 2026: costi reali di pagine, JSON e crawl
Quanto costa Firecrawl? Confronta piani, crediti e fatture per scraping JSON e crawl settimanali, inclusi errori, ricariche e alternative a pari volume.
Pubblicato il
 Di Omid Saffari



Firecrawl pricing: si parte da $19/mese per 5,000 crediti, ma 10,000 operazioni di scraping in formato JSON richiedono 50,000 crediti e rientrano nel piano Standard da $99/mese. Per un agente AI o una pipeline di retrieval-augmented generation (RAG), che recupera documenti su cui basare le risposte dell'AI, il budget deve tenere conto delle pagine restituite, dei formati di output e delle visite ripetute.
Verificato il 9 ottobre 2026 sulla pagina dei prezzi di Firecrawl. La pagina indica che questi prezzi sono in vigore dal 4 settembre 2026. La versione Markdown dei prezzi, a cui rimanda la pagina, riporta esplicitamente gli importi con fatturazione mensile e i totali delle fatture annuali indicati qui sotto. Tutti i prezzi di Firecrawl sono in USD; i calcoli escludono le imposte e le funzionalità opzionali, salvo dove specificato.
Firecrawl è un'API per acquisire dati dal web e trasformare URL in contenuti utilizzabili da un agente. Il credito è un'unità di fatturazione: non garantisce che una pagina contenga informazioni utili. Una pagina di errore restituita può consumare lo stesso credito di base del documento che si cercava.
Firecrawl pricing: piani e crediti a confronto
Hobby va bene per piccoli lavori ricorrenti; Standard diventa più conveniente quando l'estrazione o le ricariche portano i consumi oltre la fascia in cui Hobby conviene. Passare a un piano con più crediti inclusi non è l'unica strada. Tutti i piani a pagamento acquistabili in autonomia permettono anche di comprare crediti aggiuntivi in incrementi da $5.
Fonti: prezzi di Firecrawl e relativa versione Markdown, consultate il 9 ottobre 2026. Le richieste simultanee indicano quante pagine possono essere renderizzate contemporaneamente; il lavoro in eccesso resta in coda.
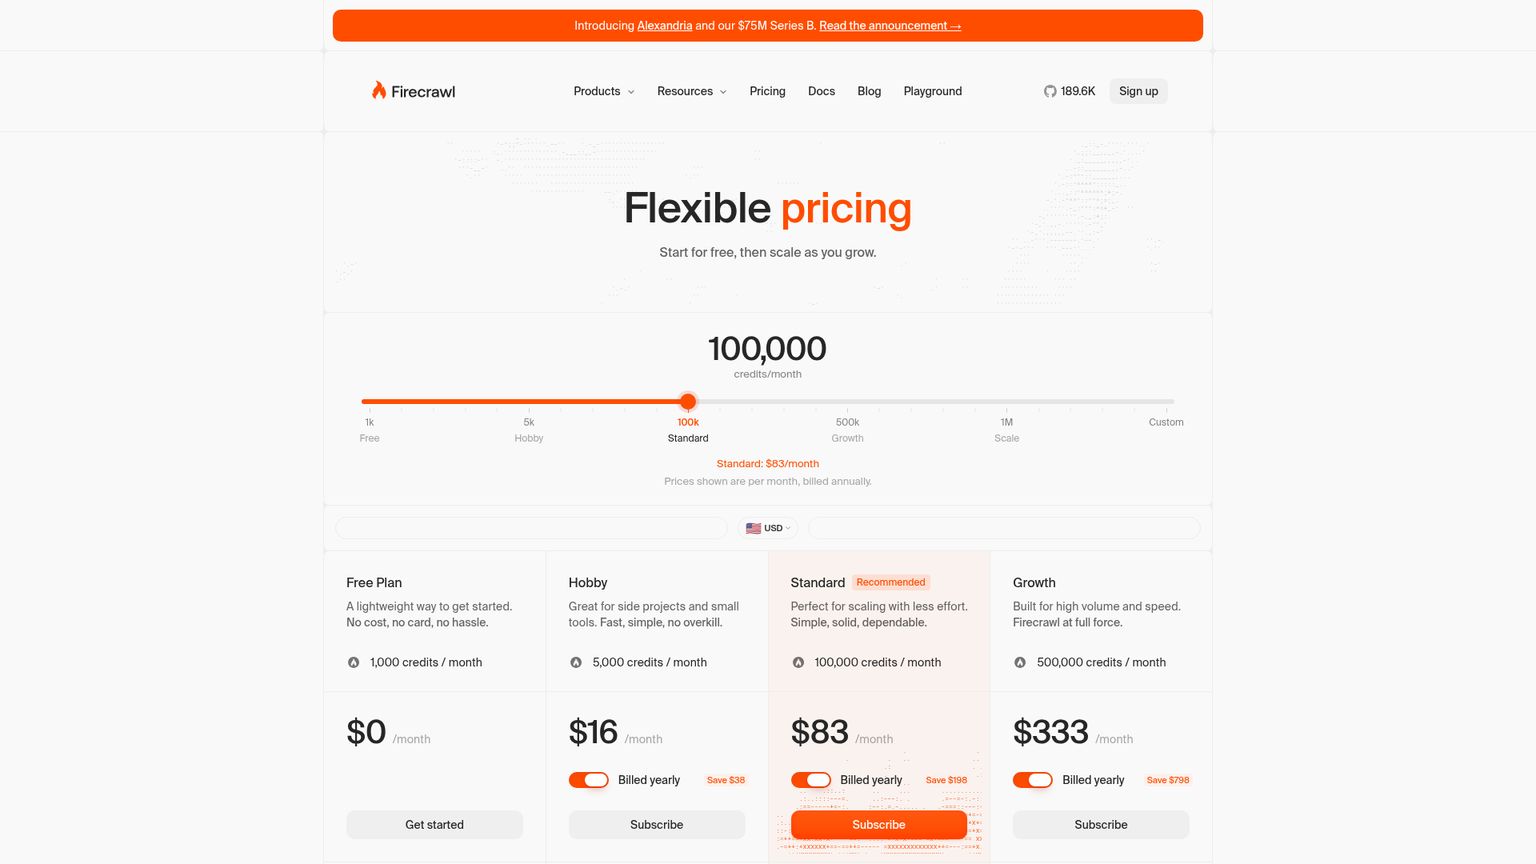
Le schede dei piani annuali mostrano equivalenti mensili arrotondati. Le fatture annuali pubblicate ammontano a Hobby $190, Standard $990, Growth $3,990 e Scale $7,190. Per pianificare la liquidità, usare questi totali anziché moltiplicare per dodici l'importo arrotondato della scheda. La fatturazione annuale dà diritto al rinnovo mensile dei crediti: non rende subito disponibili tutti quelli dell'anno.
Il limite di Free è il saldo ricorrente ridotto, insieme alla bassa frequenza delle richieste. Consente due richieste simultanee e 10 richieste al minuto per scrape, map e search. Non offre pacchetti di crediti aggiuntivi. Un prototipo che concentra molte operazioni in poco tempo può raggiungere il limite di frequenza prima di esaurire i crediti.
Il punto debole di Hobby è il costo dell'uso aggiuntivo. Le cinque richieste simultanee e le 100 richieste al minuto per scrape, map e search bastano per un'attività in background di dimensioni contenute. Ogni 1,000 crediti extra costa $5: con estrazioni JSON ripetute, l'abbonamento di partenza può diventare una parte marginale della spesa.
Standard offre il salto a 100,000 crediti e ricariche meno costose. Include 25 richieste simultanee e un limite di 500 richieste al minuto sugli stessi endpoint. È il primo piano da valutare per chi avvia un'impresa e deve raccogliere campi strutturati da migliaia di pagine.
Growth aumenta insieme capacità e velocità. Include 50 richieste simultanee e un limite di 5,000 richieste al minuto per scrape/map/search. I suoi 500,000 crediti sono adatti ad aggiornamenti su larga scala, ma i crediti dell'abbonamento non utilizzati non passano al mese successivo.
Scale consente di riportare i crediti per un mese. Ai 1,000,000 crediti mensili si aggiungono 100 richieste simultanee e un limite di 10,000 richieste al minuto per scrape/map/search. Enterprise offre crediti, richieste simultanee e riporto su misura, oltre ad assistenza dedicata, un accordo sul livello di servizio, single sign-on e conservazione dei dati pari a zero. Prima di confrontarlo con un piano acquistabile in autonomia, chiedere un preventivo personalizzato.
Quanto costano le API Firecrawl per ciascun endpoint?
Una pagina costa un credito solo con l'operazione di base. La pagina dei prezzi elenca queste tariffe di base, uguali per tutti i piani:
- Scrape: 1 credito per pagina. Recupera il contenuto di un URL.
- Crawl: 1 credito per pagina. Segue i link e recupera le pagine di un sito; una singola attività di crawl può fatturare molte pagine.
- Map: 1 credito per pagina nella tabella dei prezzi. Serve a individuare URL, ma c'è una discrepanza nel conteggio, spiegata più avanti.
- Search: 2 crediti ogni 10 risultati. I risultati e i contenuti acquisiti tramite scraping attingono allo stesso saldo dell'account.
- Interact: 2 crediti per minuto di browser. Il tempo trascorso in un browser interattivo si misura separatamente dal numero di pagine.
- Monitor: 1 credito per pagina a ogni controllo. Ogni esecuzione di un controllo ricorrente consuma nuovamente crediti.
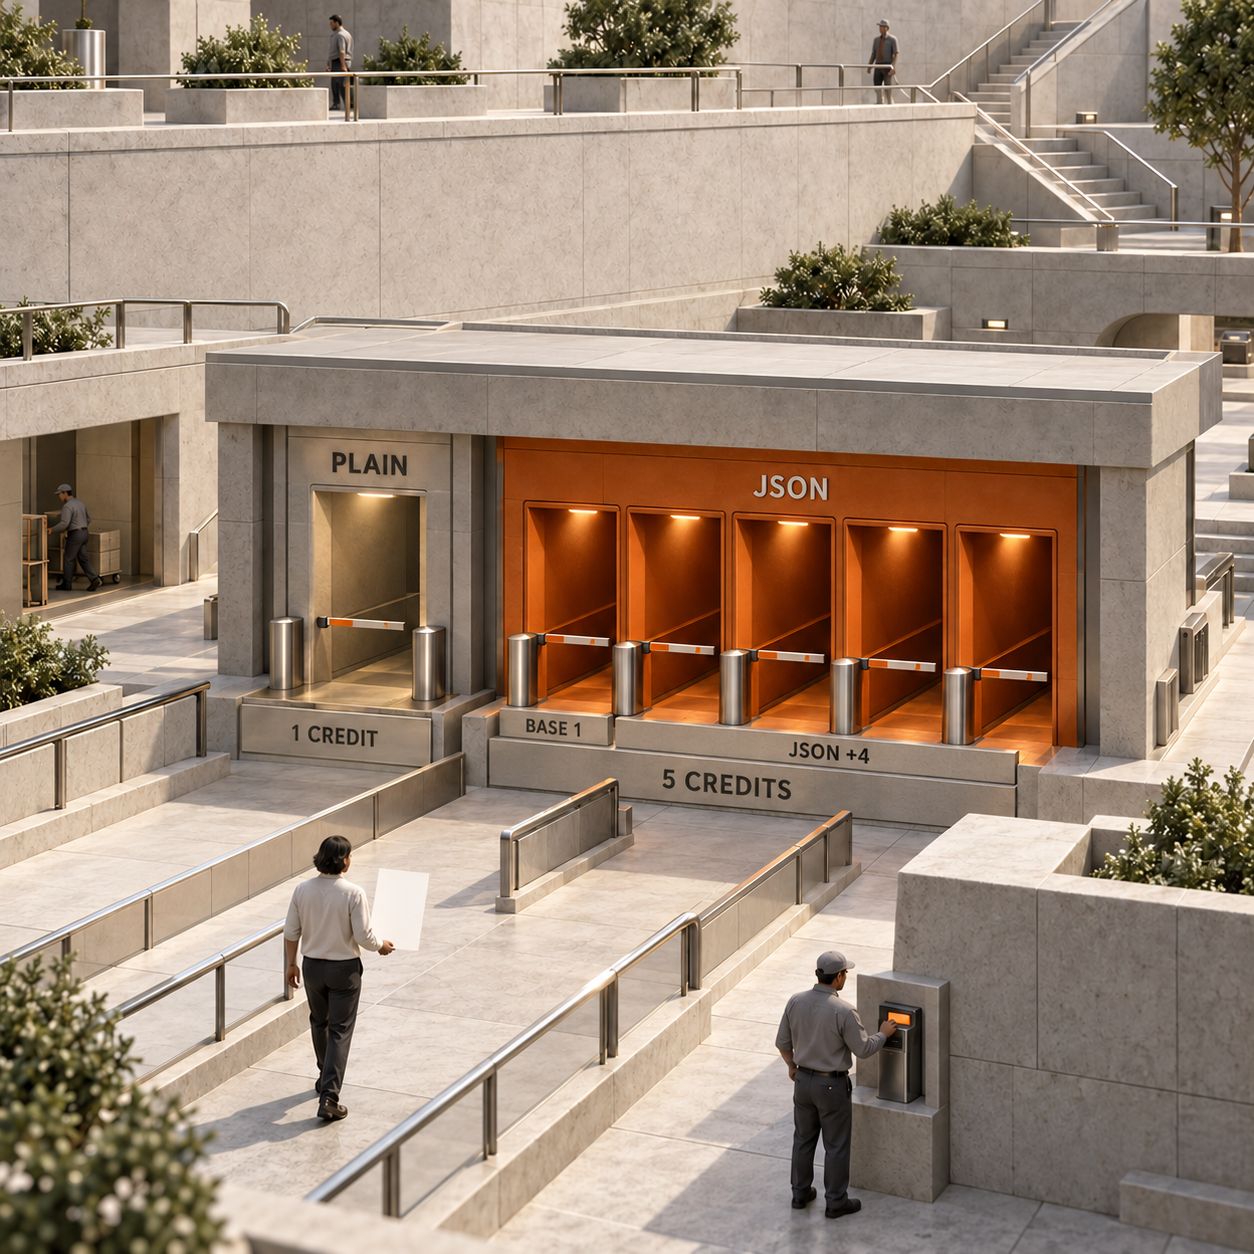
I formati JSON, Question e Highlight aggiungono quattro crediti per pagina su Scrape e Crawl. JSON restituisce campi strutturati, Question produce una risposta a partire dalla pagina e Highlight seleziona i passaggi pertinenti. Con uno di questi formati, il costo della pagina più quello del formato è 1 + 4 = 5 crediti. Diecimila pagine consumano quindi 50,000 crediti, anziché 10,000.
La documentazione sulla fatturazione precisa alcune distinzioni che incidono sul budget di un agente. Search arrotonda per eccesso a blocchi di dieci: 11 risultati costano quattro crediti di ricerca. Se si acquisiscono anche i contenuti dei risultati tramite scraping, i costi delle pagine si aggiungono. Un agente che cerca e legge compie due operazioni fatturabili.
La tariffa di due crediti di Interact vale per le sessioni basate solo su codice. Le sessioni guidate da prompt costano sette crediti per minuto di browser, con un minimo di un minuto. Anche l'estrazione deterministica di Monitor è una modalità distinta: il riepilogo dei prezzi la indica a sette crediti per pagina a ogni controllo, anziché ai cinque crediti del calcolo per Scrape in formato JSON.
Map merita attenzione. La pagina dei prezzi indica un credito per pagina, mentre la documentazione sulla fatturazione parla di un credito per chiamata Map e descrive la scoperta degli URL senza acquisirne i contenuti. Verificare come viene conteggiato il proprio flusso di individuazione degli URL, anziché moltiplicare ogni URL restituito da Map per la tariffa di Scrape. Nessuno degli esempi di spesa qui sotto usa Map.
Firecrawl Extract: quale operazione si sta acquistando?
L'esempio da cinque crediti si riferisce a Scrape o Crawl con formato JSON. Non è una tariffa valida per tutto ciò che Firecrawl chiama estrazione. La documentazione separata di /extract descrive una fatturazione in crediti basata sui token e indica Agent come suo successore. Agent offre cinque esecuzioni gratuite al giorno in anteprima e ha prezzi dinamici.
Per rendere prevedibile il budget di acquisizione dei dati, indicare nel foglio di calcolo il percorso API e il formato effettivi. «Estrarre 10,000 pagine» è troppo ambiguo; «10,000 chiamate Scrape di base con formato JSON» identifica un carico calcolabile da 50,000 crediti. Le opzioni aggiuntive possono comunque comportare altri addebiti.
Tre esempi di spesa mensile
Per calcolare il mese, sommare l'abbonamento e i pacchetti interi di crediti. Sono scenari calcolati, non fatture osservate. Si assumono normali pagine restituite, nessun saldo di crediti acquistati in precedenza, nessun credito promozionale e nessuna opzione aggiuntiva. La dotazione di Free non si somma a quella di un piano a pagamento.
Per qualsiasi piano, il calcolo è:
Spesa mensile = abbonamento + $5 × arrotondamento per eccesso(max(0, crediti fatturati − crediti inclusi) ÷ crediti per pacchetto).
Arrotondare per eccesso significa acquistare il numero intero di pacchetti immediatamente superiore. Anche un piccolo disavanzo richiede un intero incremento da $5. I dati di partenza provengono dai piani e pacchetti pubblicati da Firecrawl.
10,000 pagine con scraping di base: $44 con Hobby mensile
Per questo lavoro, Hobby con cinque ricariche costa meno di Standard. Chi acquisisce 10,000 pagine ordinarie per un indice di documenti ha bisogno di 10,000 crediti. Hobby ne include 5,000: ne mancano quindi 5,000.
Cinque pacchetti da 1,000 costano $25. Aggiungendo l'abbonamento mensile da $19 si ottiene $19 + $25 = $44. Standard costerebbe $99, lasciando parte della capacità inutilizzata. La spesa con Hobby equivale a $4.40 ogni 1,000 pagine consegnate.
Con Hobby annuale, la fattura di base è di $190/anno e il mese dell'esempio richiede comunque $25 di crediti aggiuntivi. Il costo mensile ripartito è quindi di circa $40.83. Usando l'importo arrotondato della scheda, il calcolo è $16 + $25 = $41: la piccola differenza deriva dall'equivalente annuale mostrato, non da una diversa tariffa dei pacchetti.
10,000 estrazioni JSON: $99 con Standard mensile
Standard conviene più di Hobby quando ogni pagina deve restituire campi strutturati. Gli stessi 10,000 URL consumano ora 10,000 × 5 = 50,000 crediti. Una pipeline per un catalogo prodotti che richiede nome, prezzo e disponibilità è un esempio di lavoro che necessita di questo formato.
Hobby richiederebbe 45 pacchetti aggiuntivi: $19 + 45 × $5 = $244. Standard copre l'intero carico a $99/mese, lasciando 50,000 crediti disponibili per altre attività. A questo volume effettivo, la spesa dell'abbonamento è di $9.90 ogni 1,000 pagine JSON.
Standard annuale costa $990/anno, pari a $82.50 al mese, mostrati come $83/mese. La scelta resta la stessa: per un uso continuativo di Scrape JSON su 10,000 pagine, scegliere Standard. La scheda iniziale più economica di Hobby non giustifica il suo costo marginale molto più alto.
Un crawl di 50,000 pagine ogni settimana: $349 o $399, a seconda del mese
Con fatturazione mensile, quattro esecuzioni favoriscono Standard con pacchetti aggiuntivi; cinque favoriscono Growth. Contare le esecuzioni previste nel ciclo di fatturazione: «settimanale» non significa sempre quattro volte.
Quattro esecuzioni complete richiedono 50,000 × 4 = 200,000 crediti. Standard ne include 100,000. Per i restanti 100,000 servono 50 pacchetti da 2,000: $99 + 50 × $5 = $349. L'abbonamento mensile Growth da $399 costerebbe $50 in più per lo stesso carico di crawl di base.
Cinque esecuzioni richiedono 250,000 crediti. Standard ha allora bisogno di 75 pacchetti: $99 + 75 × $5 = $474. Growth copre il carico a $399, risultando più economico di $75 in quel mese.
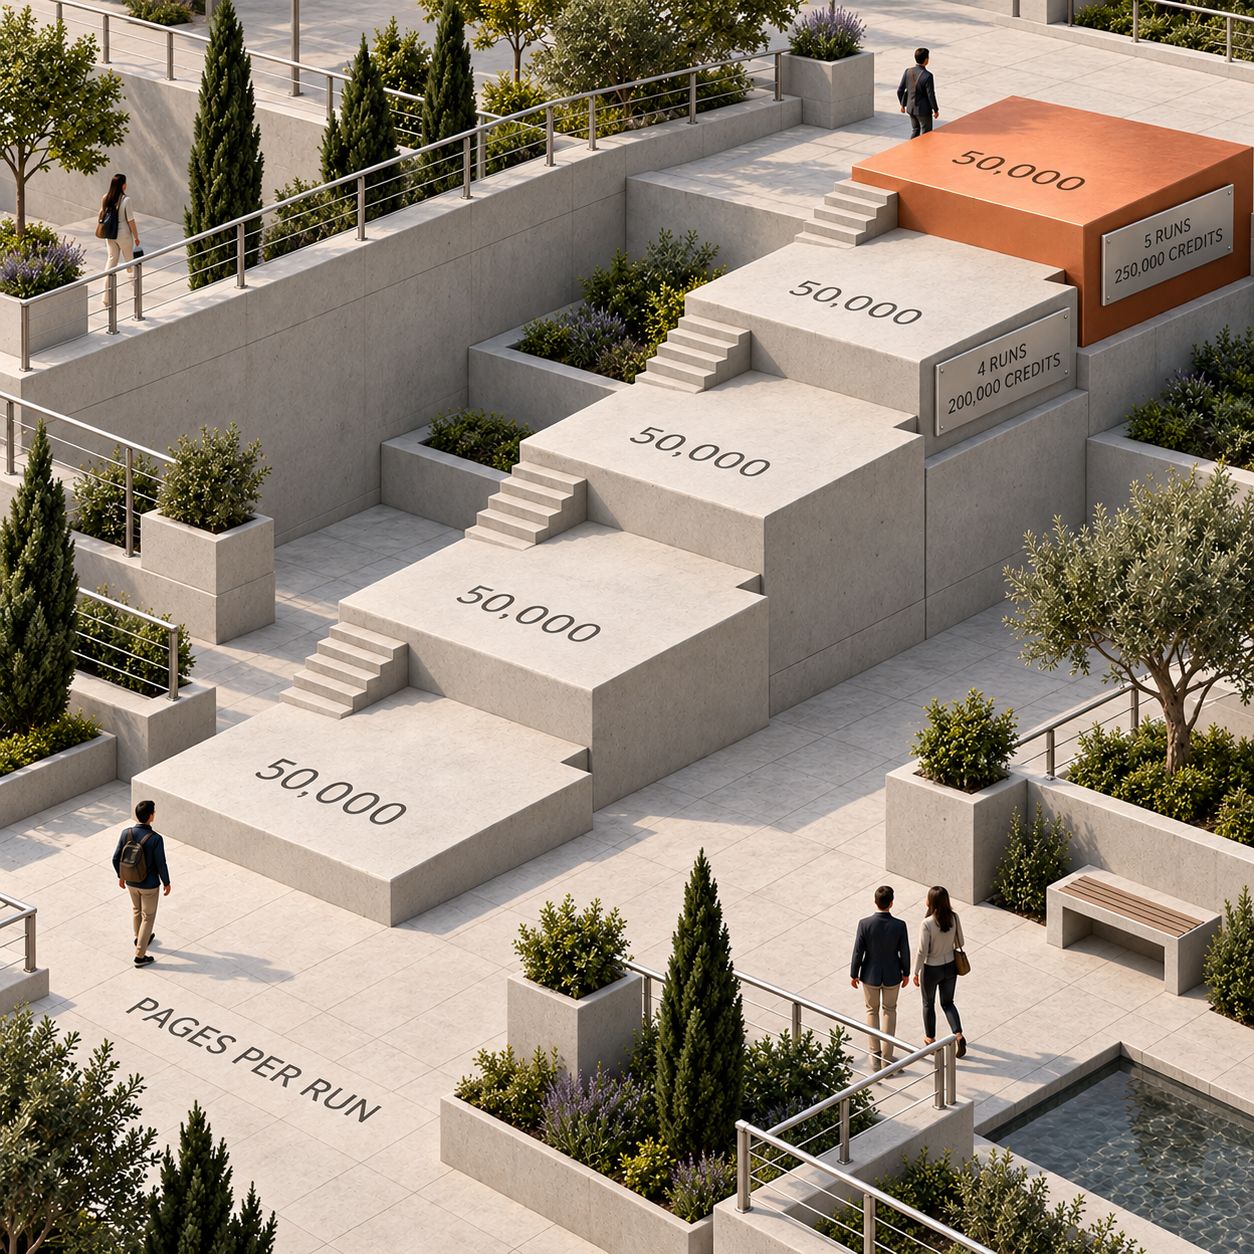
La fatturazione annuale sposta la soglia. A 200,000 crediti, la quota mensile ripartita di Standard annuale da $82.50 più $250 di pacchetti dà $332.50, lo stesso costo base mensile ripartito di Growth annuale. Le schede arrotondano entrambe le opzioni dell'esempio a $333. A 250,000 crediti, Growth annuale resta a $332.50 al mese ripartiti, mentre Standard annuale con pacchetti arriva a $457.50. Assumere l'impegno annuale solo quando calendario e consumi sono stabili.
Aggiungere JSON a ogni pagina del crawl cambia di nuovo la scala. Quattro esecuzioni consumano 1,000,000 crediti, coperti da Scale mensile a $749. Cinque esecuzioni consumano 1,250,000 crediti: Scale con 50 pacchetti costa $749 + $250 = $999. Il formato di output può incidere più del prezzo di partenza dell'abbonamento.
Quando conviene passare al piano superiore?
Passare di piano quando quello più grande costa meno del piano attuale con ricariche, oppure quando le richieste simultanee limitano il lavoro. Il punto in cui finiscono i crediti inclusi non coincide, da solo, con la soglia di convenienza del passaggio.
Con fatturazione mensile, Hobby raggiunge $99 a 21,000 crediti, alla pari con Standard. Oltre 21,000, il pacchetto successivo porta Hobby a $104, mentre Standard resta a $99. La fatturazione annuale anticipa il punto di sorpasso: Standard diventa più conveniente oltre 18,000 crediti.
Standard mensile raggiunge $399 a 220,000 crediti, alla pari con Growth. Oltre 220,000, Growth diventa più conveniente. Con fatturazione annuale, la soglia corrispondente è di 200,000 crediti. Ecco perché il crawl settimanale con quattro esecuzioni e quello con cinque portano a scelte diverse.
Growth mensile raggiunge $749 a 675,000 crediti, alla pari con Scale. Oltre quella soglia, Scale costa meno e offre una dotazione più ampia, crediti aggiuntivi più economici e il riporto. Queste soglie sono calcolate dalle tariffe pubblicate per abbonamenti e pacchetti, assumendo un saldo nullo di crediti acquistati in precedenza.
Usando tutta la dotazione mensile di ciascun piano, il costo base ogni 1,000 pagine semplici è di $3.80 con Hobby, $0.99 con Standard, $0.798 con Growth e $0.749 con Scale. Questi importi descrivono piani utilizzati integralmente, non la spesa per un piccolo lavoro che lascia crediti inutilizzati. Standard usato per tutte le 20,000 pagine JSON consentite equivale a $4.95 ogni 1,000 pagine JSON; nell'esempio da 10,000 pagine, il costo è $9.90.
Le richieste simultanee possono giustificare un passaggio anticipato. Un'attività settimanale con una finestra di completamento stretta può richiedere i 50 rendering simultanei di Growth anche quando Standard con pacchetti costa meno. Il calcolo dei crediti definisce il budget; una prova con un carico rappresentativo stabilisce se il piano più lento termina in tempo. Qui non si dichiara alcun test di velocità di elaborazione.
Pagine fallite e dettagli di fatturazione che incidono sul budget
Una pagina addebitata non è necessariamente un documento accettato. Le FAQ sui prezzi di Firecrawl precisano che uno scrape senza risultati non viene addebitato, ma una pagina restituita con 403 o 404 costa un credito. La documentazione sulla fatturazione spiega che l'addebito di base dipende dal documento restituito.
Si immagini un lavoro di scraping di base da 10,000 richieste che restituisce 2,000 pagine bloccate o mancanti e 8,000 documenti utilizzabili. Può comunque consumare 10,000 crediti e costare $44 con Hobby mensile. Il costo dell'output utile diventa $44 ÷ 8,000 × 1,000 = $5.50 ogni 1,000 documenti accettati, anziché $4.40.
Riprovare una volta quei 2,000 URL può aggiungere altri 2,000 crediti di base, se restituiscono nuovamente documenti. Con Hobby significa due pacchetti extra da $5, cioè $10. Registrare lo stato della pagina in metadata.statusCode e decidere quali errori meritano un altro tentativo. Una pagina mancante non dovrebbe restare indefinitamente nell'elenco degli aggiornamenti automatici.
La regola che esclude l'addebito in assenza di un documento ha delle eccezioni. Se un controllo contro la prompt injection abilitato è già stato eseguito, la documentazione indica che uno scrape successivamente fallito può comunque costare cinque crediti. Le sessioni del browser vengono fatturate in base al tempo anche quando non producono il risultato desiderato. Gli esempi precedenti escludono queste opzioni; anche una pagina 403 restituita va distinta da un fallimento completo senza addebito.
I crediti acquistati e quelli dell'abbonamento hanno scadenze diverse. I crediti inclusi in Free, Hobby, Standard e Growth non passano al mese successivo. Scale riporta per un mese i crediti dell'abbonamento non utilizzati; Enterprise prevede condizioni personalizzate. I crediti aggiuntivi acquistati restano disponibili fino all'uso finché l'abbonamento è attivo, ma scadono quando termina. La fatturazione annuale non elimina il rinnovo mensile del saldo sui piani inferiori.
Il limite delle ricariche automatiche non limita tutta la spesa possibile. I piani a pagamento aggiungono crediti in incrementi da $5 fino al limite mensile impostato. Lasciarlo vuoto consente ricariche automatiche illimitate; impostarlo a zero le disattiva. Gli acquisti manuali di crediti non rientrano nel limite. Nel budget, distinguere abbonamento, aggiunte automatiche e acquisti manuali.
Il passaggio a un piano superiore può comportare un nuovo addebito completo dell'abbonamento. La documentazione sulla fatturazione indica che il passaggio è immediato, addebita l'intero prezzo del nuovo piano senza riproporzionamento e fa ripartire il ciclo. I crediti precedenti non utilizzati vengono conservati, ma cambiare piano non significa semplicemente pagare la differenza tra due schede. I passaggi a piani inferiori hanno effetto al rinnovo. Se un mese con cinque esecuzioni richiede più crediti, confrontare i pacchetti con l'addebito effettivo del passaggio prima di modificare un abbonamento già attivo.
La sezione 6.e dei termini di Firecrawl stabilisce che non sono previsti rimborsi ordinari; la disdetta interrompe le fatturazioni successive al periodo in corso. È descritta un'eccezione con rimborso proporzionale se Firecrawl non può più fornire il servizio. Considerare l'impegno annuale come denaro già impegnato e verificare le imposte separatamente dagli esempi di consumo.
Firecrawl gratis: il piano Free basta per la propria pipeline?
Si può restare sul piano gratuito senza limiti di tempo se tutto il lavoro ricorrente rientra nei 1,000 crediti mensili e nei limiti ridotti. Non serve una carta di credito e la dotazione si rinnova ogni mese. È un piano gratuito ricorrente, anziché una prova utilizzabile una sola volta.
Se dedicati esclusivamente a una singola attività di base, 1,000 crediti coprono 1,000 pagine semplici, 200 pagine JSON oppure 5,000 risultati di ricerca richiesti in gruppi di dieci. Search e Scrape attingono allo stesso saldo. La quantità di ricerche pubblicizzata non è una seconda dotazione da usare dopo aver esaurito i crediti di Scrape.
Un agente personale che legge 150 pagine JSON al mese usa 750 crediti. Un piccolo aggiornamento della documentazione da 200 pagine semplici a settimana usa 800 crediti in un ciclo con quattro esecuzioni, oppure tutti i 1,000 in un ciclo con cinque. Questi utenti potrebbero non dover mai pagare, purché le altre operazioni rientrino nel saldo residuo.
La documentazione del piano Free indica che le richieste restituiscono HTTP 402 quando la dotazione si esaurisce; Free non prevede consumo extra a pagamento. Usarlo per definire il formato e l'insieme delle fonti prima di impegnarsi con la fatturazione annuale.
Gli studenti verificati possono accedere a un programma studenti Firecrawl separato, che offre 10,000 crediti gratuiti per progetti didattici o personali. Tra i requisiti ci sono un indirizzo email accademico e l'iscrizione a un college, un'università o un programma accreditato. La pagina non stabilisce una dotazione commerciale ricorrente: chi avvia un'impresa non dovrebbe impostare il budget della startup su questa ipotesi.
Quando conviene ospitare Firecrawl sui propri server?
Il self-hosting conviene quando il costo operativo completo è inferiore alla spesa del servizio gestito per lo stesso output accettato. Eliminare l'abbonamento a Firecrawl significa sostituirlo con infrastruttura e responsabilità; restano i costi per renderizzare le pagine ed eseguire i modelli di estrazione.
Usare questo confronto:
Costo mensile del self-hosting = infrastruttura + archiviazione e traffico in uscita + proxy + uso dei modelli + tempo di gestione + quota ammortizzata della migrazione.
Negli esempi di questo articolo, confrontare il totale con $44 per 10,000 operazioni mensili di scraping di base, $99 per 10,000 operazioni di scraping JSON oppure $349 per il crawl settimanale con quattro esecuzioni. La propria macchina deve completare davvero lo stesso carico e superare gli stessi controlli di accettazione. Non dividere la fattura di un server economico per una capacità di pagine mai verificata.
Il self-hosting è più plausibile se si gestiscono già i servizi di supporto, le fonti sono accessibili e un volume continuativo distribuisce quel lavoro fisso su molte pagine utili. È più difficile giustificarlo per un piccolo agente la cui intera spesa di scraping gestito è di $44, soprattutto quando nessuno è responsabile dei problemi del browser e degli aggiornamenti.
Il confronto ufficiale con la versione open source include nello stack predefinito le operazioni di base scrape, crawl, map e search. I formati basati su LLM richiedono un fornitore di modelli configurato oppure Ollama. Agent, Browser, Interact, la dashboard gestita e i controlli enterprise non fanno parte di quello stack predefinito. Un workflow cloud che dipende da queste funzionalità non si può valutare come una semplice sostituzione del server.
La nostra guida al self-hosting di Firecrawl spiega il deployment e la scelta operativa. Usarla quando il controllo o un utilizzo continuativo giustificano il lavoro; mantenere Firecrawl gestito quando l'output e l'assistenza fanno risparmiare più del costo dei crediti.
Alternative a Firecrawl: confronto a parità di volume
Confrontare lo stesso numero di output utili e precisare il lavoro incluso in ogni prezzo. Una pagina acquisita, righe estratte e campi JSON arbitrari sono acquisti diversi. Firecrawl, Bright Data e Browse AI sono partner. I confronti utilizzano i prezzi pubblicati sulle pagine attuali dei fornitori.
Bright Data: acquisizione meno costosa se si gestisce l'elaborazione successiva
Web Unlocker di Bright Data è un'API di accesso con un prezzo per richiesta riuscita. La sua pagina dei prezzi indica una tariffa a consumo di $1.50 ogni 1,000 richieste, fatturazione sulle richieste riuscite, limiti di spesa e richieste simultanee illimitate.
Con quella tariffa a pagamento, 10,000 richieste di pagina riuscite costano $15; 200,000 costano $300; 250,000 costano $375. Sono moltiplicazioni della tariffa, non preventivi per un servizio equivalente all'estrazione di campi JSON arbitrari di Firecrawl o a una pipeline RAG completa di documenti. Escludono il lavoro aggiuntivo nell'applicazione e non assumono che la dotazione gratuita si sommi all'uso a pagamento.
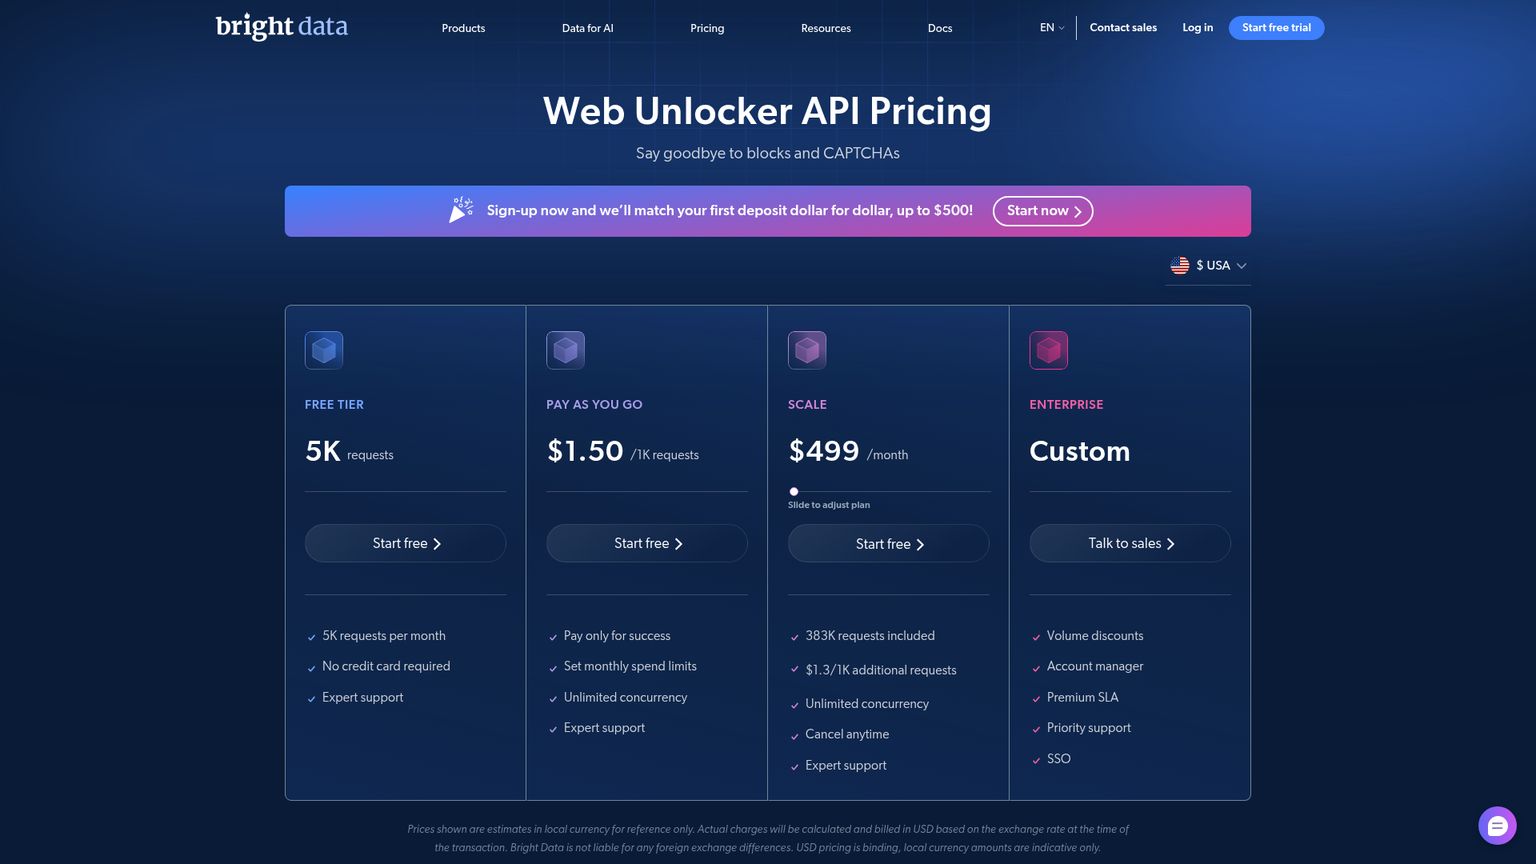
Rispetto ai $44 del mese di scraping di base o ai $349 del crawl con quattro esecuzioni di Firecrawl, Bright Data lascia margine per finanziare l'elaborazione restante. Sceglierlo quando l'accesso è il collo di bottiglia e quell'elaborazione è già gestita in proprio. Mantenere Firecrawl quando il suo output documentale e il workflow di crawl svolgono il lavoro che altrimenti bisognerebbe sviluppare. Una richiesta meno costosa riduce il costo totale solo se il lavoro mancante costa meno della differenza.
Browse AI: calcolare righe e domini del robot
Browse AI è un servizio di estrazione visuale basato su robot riutilizzabili, configurati selezionando gli elementi da estrarre. La sua pagina dei prezzi addebita un credito per una visita a una pagina standard oppure un credito ogni dieci righe, applicando il valore più alto. I siti premium possono richiedere da due a dieci crediti per esecuzione.
Per un volume continuativo di 10,000 visite a pagine standard al mese, ipotizzare un credito per visita e nessuna fonte premium. Servono quindi 120,000 crediti all'anno. Il piano Professional annuale offre 60,000 crediti a $69/mese con fatturazione annuale, cioè $69 × 12 = $828/anno. Altri 60,000 crediti, usando per prudenza la tariffa di ricarica pubblicata di $0.017, costano $1,020: $1,848/anno, pari a $154/mese. La pagina pubblica una fascia di ricarica da $0.017 a $0.013; usare una tariffa inferiore solo se confermata dal preventivo.
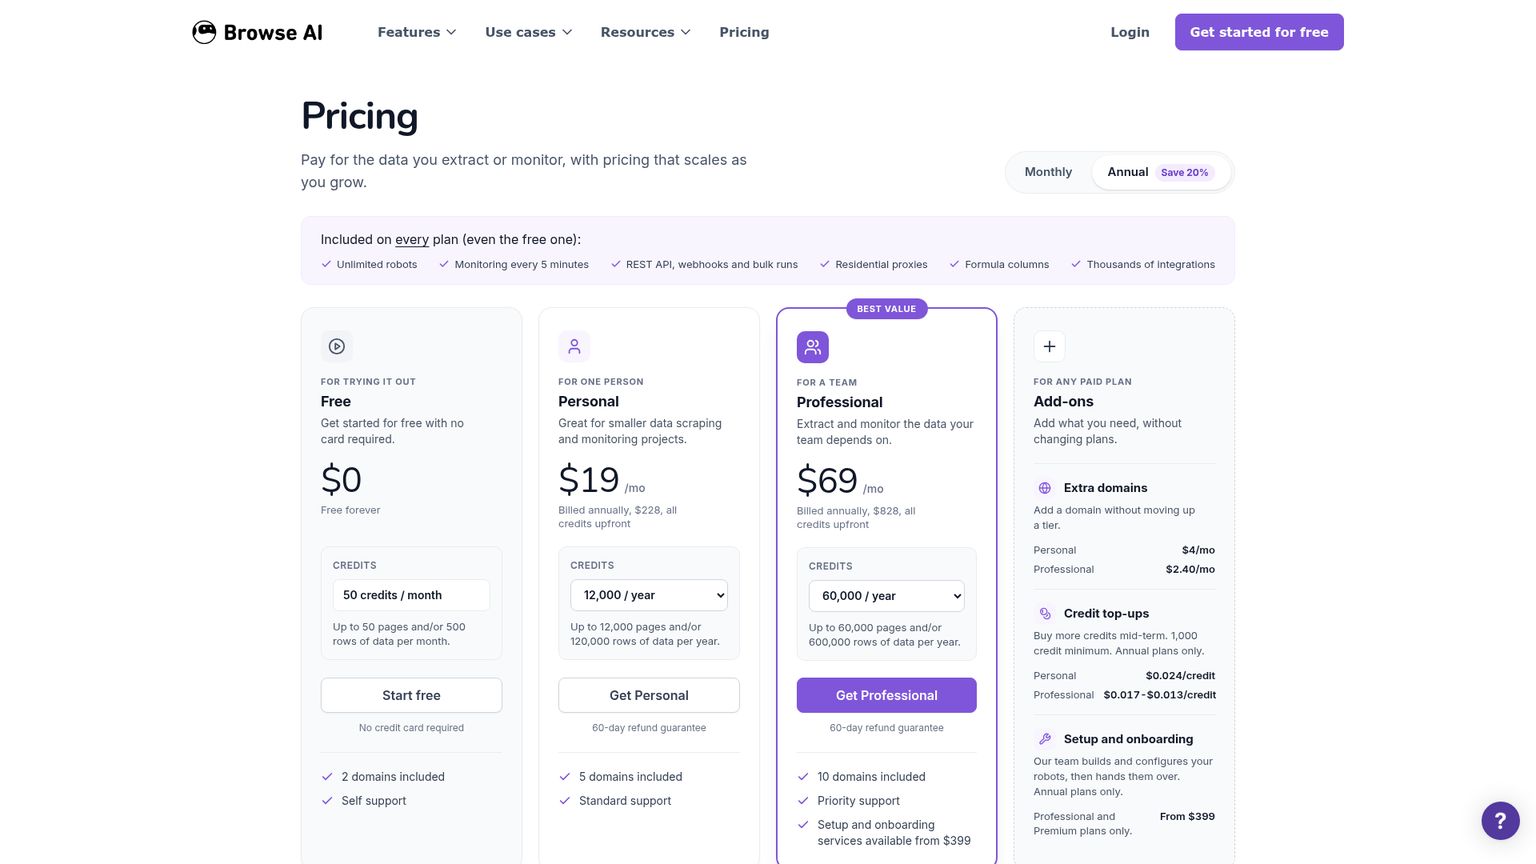
Questo modello costa più dell'esempio Firecrawl da $99 per scraping JSON, ma offre un'interfaccia operativa diversa. Può essere adatto a chi avvia un'impresa e vuole che l'operatore mantenga il robot di estrazione senza scrivere lo scraper. Il piano Professional include dieci domini; un corpus web ampio o una pagina con molte righe può far saltare rapidamente le ipotesi di partenza.
Un carico mensile da 200,000 pagine corrisponde a 2,400,000 crediti standard all'anno, prima dei moltiplicatori. Chiedere un preventivo per volume anziché presumere che la scheda di partenza da $69 copra quel crawl. Browse AI va considerato per fonti ricorrenti selezionate, non automaticamente per l'acquisizione estesa a tutto un sito senza restrizioni.
Apify: serve una stima per l'Actor scelto
Apify esegue Actors, programmi di scraping e automazione pronti all'uso. Il suo modello di prezzo comprende l'uso della piattaforma e il modello di addebito dell'Actor scelto. Il solo numero di pagine non definisce calcolo, proxy, archiviazione o tariffe proprie del programma.
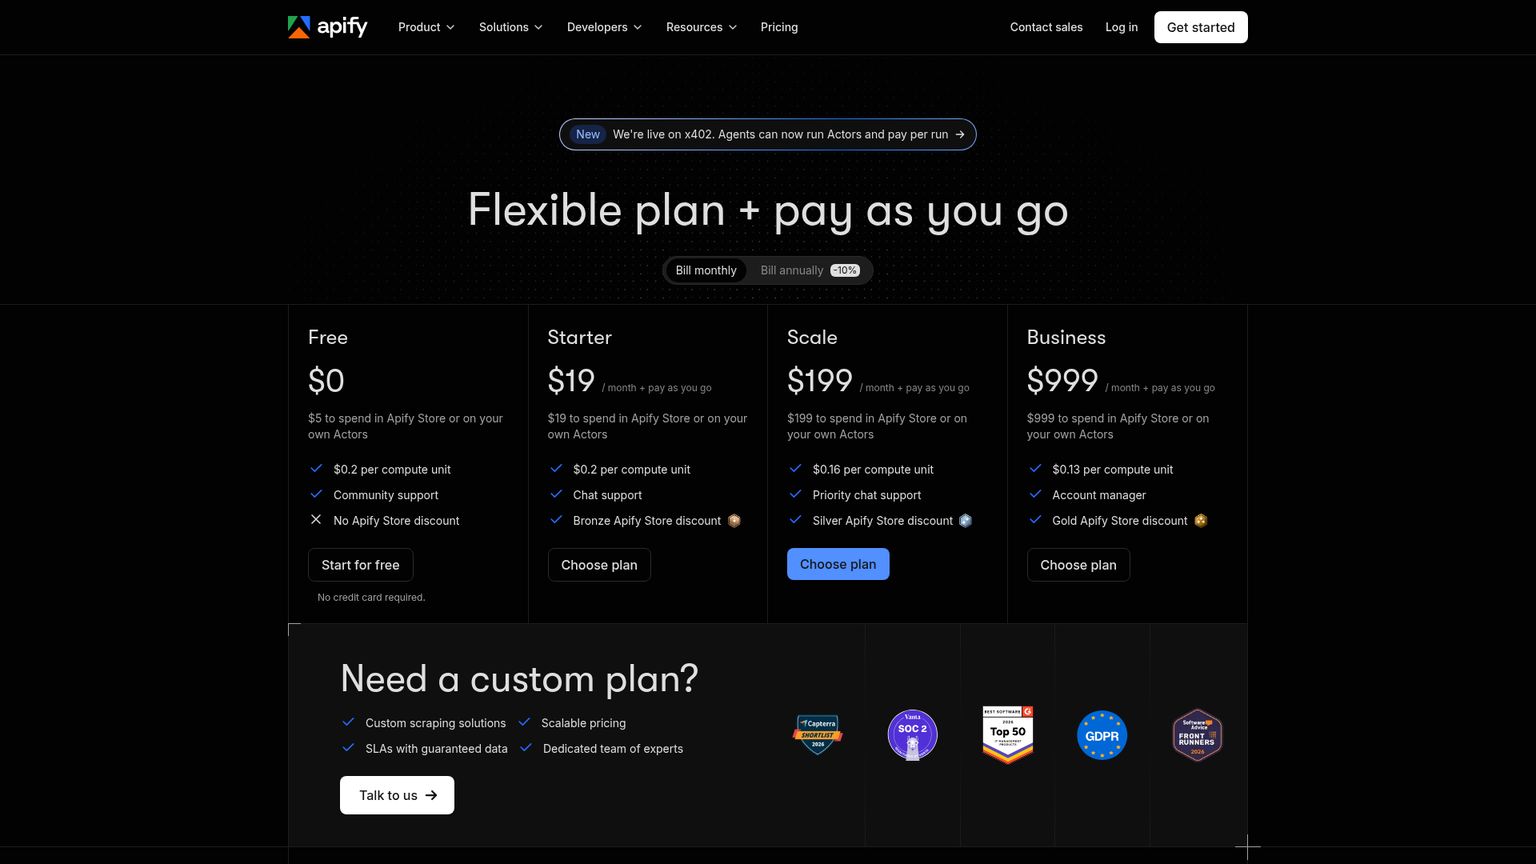
Per le stesse 10,000 o 200,000 pagine, ottenere una stima basata sull'Actor effettivo e sull'insieme delle fonti prima di preferirlo a Firecrawl. È adatto a chi trova un programma esistente per la fonte esatta. Evitare un confronto che usa il prezzo d'ingresso dell'abbonamento Apify al posto del costo del lavoro completato.
Consultare le alternative a Firecrawl per le possibili sostituzioni e i migliori strumenti di web scraping per un confronto più ampio su output e responsabilità operative.
Definire il budget prima del prossimo crawl
Stabilire percorso API, calendario e regola di accettazione prima di scegliere il piano. Un indice di documenti che richiede testo semplice non dovrebbe chiedere JSON su ogni pagina solo perché l'opzione è disponibile. Un catalogo strutturato deve mettere esplicitamente a budget il formato aggiuntivo.
Definire l'unità di lavoro
Annotare endpoint, formato richiesto, URL di destinazione ed esecuzioni nel ciclo di fatturazione. Per l'esempio settimanale, scrivere 50,000 pagine per esecuzione e verificare se il ciclo successivo ne comprende quattro o cinque. Impostare un limite esplicito alle pagine del crawl: inviare un'attività non equivale a ottenere un prezzo fisso.
Calcolare la spesa con pacchetti interi
Moltiplicare le pagine per il costo in crediti della modalità scelta. Sottrarre la dotazione del piano e arrotondare il disavanzo per eccesso a pacchetti da $5. Confrontare il piano attuale con pacchetti e quello superiore, poi verificare l'addebito per il passaggio se si ha già un abbonamento.
Impostare un limite alle ricariche automatiche
Nelle impostazioni Billing, inserire un limite mensile di spesa a consumo in multipli interi di $5. Per il crawl di base con quattro esecuzioni su Standard, $250 finanziano le ricariche dell'esempio. Zero disattiva le aggiunte automatiche; lasciare il campo vuoto elimina il limite di spesa automatica. Gli acquisti manuali restano fuori da quel tetto.
Misurare i documenti accettati
Registrare crediti fatturati, stato restituito dalla pagina, campi richiesti e output accettato. Interrompere i tentativi ripetuti sulle pagine che continuano a risultare mancanti. Confrontare il costo per documento accettato del lavoro completato con il budget prima di aumentarne la frequenza o abilitare un altro formato.
Chi deve aggiornare un indice RAG la prossima settimana dovrebbe iniziare distinguendo gli URL che richiedono documenti semplici da quelli che richiedono campi strutturati. Poi stimare il prossimo ciclo di fatturazione e impostare il tetto dei crediti. Questa decisione di solito incide sul budget più della ricerca del prezzo annuale di copertina più basso.
Domande frequenti
Posso usare Firecrawl gratis?
Sì. Il piano Free rinnova 1,000 crediti ogni mese senza richiedere una carta. Possono coprire 1,000 pagine di base o 200 pagine Scrape JSON, se l'intero saldo viene dedicato a quell'operazione.
Firecrawl è gratuito?
Firecrawl offre un piano gratuito ricorrente e piani gestiti a pagamento. È disponibile anche la versione open source, ma infrastruttura, fornitori opzionali e costi operativi restano a proprio carico. I crediti gratuiti del servizio gestito non passano al mese successivo e non consentono ricariche a pagamento.
Quanto costa Firecrawl?
Con fatturazione mensile, Hobby costa $19, Standard $99, Growth $399 e Scale $749; Enterprise è su misura. Le schede annuali mostrano rispettivamente $16, $83, $333 e $599 al mese. Questi prezzi mensili sono pubblicati esplicitamente nella versione Markdown dei prezzi collegata da Firecrawl; i consumi oltre il saldo incluso richiedono pacchetti da $5.
I crediti non usati passano al mese successivo?
La pagina dei prezzi prevede un mese di riporto per Scale e un riporto personalizzato per Enterprise. I crediti dell'abbonamento Free, Hobby, Standard e Growth non vengono riportati. I crediti acquistati restano disponibili finché l'abbonamento è attivo, ma scadono quando termina.
Come si ottengono i crediti per studenti?
Il programma studenti offre 10,000 crediti agli studenti verificati che soddisfano i requisiti. Registrarsi con un'email accademica e riscattare STUDENTEDU in Settings, Billing. Gli usi indicati sono progetti didattici o personali; qui non viene promessa una dotazione commerciale ricorrente.
Qual è la politica di rimborso di Firecrawl?
La sezione 6.e dei termini di Firecrawl stabilisce che non sono previsti rimborsi ordinari. La disdetta interrompe le fatturazioni future dopo il periodo in corso; l'eccezione indicata è un rimborso proporzionale se Firecrawl non può più offrire il servizio. Verificare questa politica prima di pagare l'anno.
Che differenza c'è tra Firecrawl e Apify?
Firecrawl misura in crediti le operazioni sulle pagine e le opzioni del servizio gestito. Apify esegue Actors con addebiti specifici del programma più l'uso della piattaforma. Confrontare l'output esatto richiesto e l'insieme delle fonti: lo stesso numero di pagine non basta, da solo, a determinare una spesa Apify.
Qual è l'API di web scraping più economica?
Non esiste una scelta universalmente più economica per documenti semplici, fonti premium e campi strutturati. Alla tariffa a pagamento indicata, Bright Data Web Unlocker costa $15 per 10,000 richieste riuscite, mentre Firecrawl Hobby costa $44 per 10,000 operazioni di scraping di base. Calcolare l'elaborazione restante prima di considerarli output finali equivalenti.
Quali sono le alternative a Firecrawl?
Bright Data è adatto ai lavori incentrati sull'accesso, Browse AI ai robot di estrazione mantenuti tramite un'interfaccia visuale e Apify ai workflow per cui esiste già un Actor appropriato. Scegliere in base all'output richiesto, al costo per pagina accettata e a chi si occuperà della gestione.
Come si esegue Firecrawl in locale?
Seguire la guida di Firecrawl al self-hosting con Docker Compose, verificare uno scrape reale e configurare i fornitori necessari ai propri formati. Lo stack predefinito non include tutte le funzionalità Cloud e il fornitore non pubblica una configurazione minima dell'host verificata.
Firecrawl può fare scraping di LinkedIn?
La sua documentazione attuale sulla fatturazione indica che gli URL dei profili e delle aziende LinkedIn vengono instradati verso fornitori di dati terzi e usano i prezzi di quei fornitori. Non applicare a questi URL il costo di base di un credito per scrape, né assumere che un piano standard garantisca la disponibilità della fonte desiderata. Verificare prima il workflow esatto instradato verso il fornitore.
ChatGPT può fare web scraping?
Firecrawl documenta un connettore nativo per ChatGPT per gli strumenti di acquisizione di dati dal web. L'accesso all'account e l'operazione richiesta continuano a determinare l'uso di Firecrawl; l'interfaccia di chat non rende gratuite le chiamate di scraping a pagamento sottostanti.
Il web scraping è illegale negli Stati Uniti?
La risposta dipende dall'accesso e dall'uso. La politica del Dipartimento di Giustizia degli Stati Uniti sull'esercizio dell'azione penale ai sensi del CFAA indica che una violazione delle sole condizioni d'uso nell'accesso a un sito pubblico non costituisce, di per sé, una base per procedere penalmente per accesso eccedente l'autorizzazione. È una politica circoscritta sull'azione penale, non un'autorizzazione generale a fare scraping o riutilizzare dati. Chiarire i diritti per il workflow effettivo prima di metterlo in produzione.
Ricevi la AI Business Workflow Audit Checklist tramite la newsletter per definire fonti, output, calendario e responsabile del tuo prossimo workflow di acquisizione di dati dal web.
- Pubblicato
- Categoria
- Build
- Lingua

Claude Code vs Copilot: prezzi, limiti e scelta nel 2026
Claude Code vs Copilot: confronta prezzi, limiti, modelli e controlli per i team. Scopri quale scegliere per l’editor, il terminale o per usarli insieme.8 ott 2026Build
Agenti AI in produzione: quando scegliere LangGraph o CrewAI
Confronta LangGraph e CrewAI per creare agenti AI: stato, memoria, approvazioni, MCP e costi di hosting sullo stesso workflow di ricerca e scrittura.7 ott 2026Build
Server MCP in Python: guida pratica dal test all'hosting
Crea un server MCP in Python per consultare gli ordini, testalo con Inspector e collegalo a Claude Code e Cursor. Poi passa a HTTP con autenticazione.7 ott 2026Build
n8n self hosting o Gumloop? Prezzi e workflow a confronto
n8n self hosting o Gumloop? Confronta prezzi in USD, crediti ed esecuzioni, agenti AI e limiti dei piani per scegliere chi gestirà il tuo workflow.7 ott 2026Build
LangGraph e framework per agenti AI: quale scegliere nel 2026
Confronta otto framework per agenti AI, da LangGraph a CrewAI: linguaggi, stato, MCP, approvazioni e prezzi per scegliere il runtime adatto alla produzione.7 ott 2026Build
Codex ChatGPT: configura il cloud e lavora a PC spento
Configura un ambiente riutilizzabile per Codex Cloud, avvia attività a PC spento, segui il lavoro dal telefono e scegli tra cloud e CLI locale.7 ott 2026Build
GitHub Copilot: prezzo dei piani e spesa reale nel 2026
GitHub Copilot: prezzo dei piani, crediti AI e tre esempi di fattura. Scopri quando convengono Pro, Pro+, Max e i piani per team, con limiti di spesa.6 ott 2026Build