Alternative a Jev nel 2026: quale modello scegliere
Alternative a Jev a confronto: prezzi in USD, licenze e limiti di OpenAI, Microsoft, Clef, Liquid d1, Perplexity e Strands per scegliere il modello adatto.
Pubblicato il
 Di Omid Saffari






Tra le alternative a Jev, l'API di Perplexity, a $0.02 per milione di token di input, è la prima da valutare per ridurre la spesa per un servizio gestito. Clef-flash è più indicato se l'applicazione gira già su Cloudflare, mentre Liquid AI d1-3B è il punto di partenza per prendere decisioni su immagini in locale. Con un milione di decisioni al mese e 1,000 token di input fatturati per ciascuna, passare da Jev a Perplexity fa risparmiare appena $22 sul costo base dell'input. Conviene scegliere l'alternativa che mantiene entro la soglia accettabile il tasso di decisioni errate accettate dall'applicazione e funziona nell'ambiente richiesto dall'applicazione.
Prezzi, licenze e documentazione sul deployment verificati l'11 ottobre 2026. I prezzi riportati provengono dai rispettivi produttori. Le cifre mensili sono calcoli basati su ipotesi esplicite, non fatture ottenute da una prova in produzione. Nessun modello è stato eseguito per questo confronto.
Alternative a Jev: quale scegliere per ogni esigenza?
Partite dai vincoli di deployment, poi confrontate la qualità sulle decisioni che dovete prendere. Con un'API gestita, è il fornitore a far funzionare il modello. Un modello a pesi aperti permette di ottenere i file ed eseguire l'inferenza in proprio, nei limiti della licenza; non significa che qualcuno offra gratuitamente la potenza di calcolo.
Le tariffe dei servizi gestiti non indicano il costo dell'inferenza su infrastruttura propria. Per i modelli scaricabili di Liquid e Strands, non pubblicato significa che le pagine del produttore non indicano una tariffa fissa per token di input. Hardware, energia, hosting e gestione restano a vostro carico. I dettagli su licenze e checkpoint sono nelle singole sezioni.
Il riferimento attuale di TypeSafe è Jev 1.13, con ID modello jev-1.13.0, a $0.042 per milione di token di input e output gratuito. Accetta testo e testo strutturato, come JSON, ma non immagini, audio o video. Microsoft ha quindi la stessa tariffa di input pubblicata per Jev; OpenAI costa di più alla tariffa base; Perplexity e Clef-flash costano meno. Catalogo dei modelli TypeSafe
Un'integrazione Jev esistente possiede già qualcosa di prezioso: una definizione delle decisioni necessarie all'applicazione. Va conservata. Se i ticket di fatturazione devono andare all'amministrazione e i problemi di accesso all'assistenza, il sostituto deve dimostrare di funzionare su quei casi prima che un risultato di benchmark orienti la scelta.
Come abbiamo selezionato i modelli decisionali AI
La selezione privilegia i modelli con un'API, una scheda o un repository mantenuti dal produttore e documentazione sufficiente a decidere come distribuirli. I cloni della community privi di una pagina verificata del produttore restano fuori dal confronto. La lista comprende sei produttori e sette opzioni di scelta: la famiglia Cloudflare condivide una sezione, mentre i due modelli Liquid richiedono raccomandazioni distinte.
I criteri sono pratici: tipi di input necessari, esecuzione gestita o locale, licenza dei pesi, limiti documentati che possono compromettere il carico di lavoro e costo di una decisione utilizzabile. È utilizzabile una decisione che l'applicazione può accettare senza una correzione costosa o un passaggio superfluo a un livello superiore di assistenza.
L'ordine parte dal candidato più interessante per ridurre il prezzo di un servizio gestito, poi passa alle integrazioni con le piattaforme e alle opzioni locali. Non è una classifica di accuratezza. I test dei fornitori usano dataset, hardware, lunghezze di input e percorsi di rete diversi. Tutti i dati sulle prestazioni citati sono dichiarati dal fornitore e nessuno dimostra che un modello supererà Jev sui vostri ticket.
Va chiarito anche il perimetro del compito. Questi modelli scelgono fra esiti predefiniti o assegnano loro un punteggio. Se serve una risposta scritta al cliente o una spiegazione, occorre mantenere una fase di generazione. Il nostro confronto tra Jev e GLM-5.3-Flash approfondisce questa scelta più ampia.
Le sette opzioni a confronto
1. Perplexity pplx-decider-v1.1-27b: da dove partire per spendere meno con un'API gestita
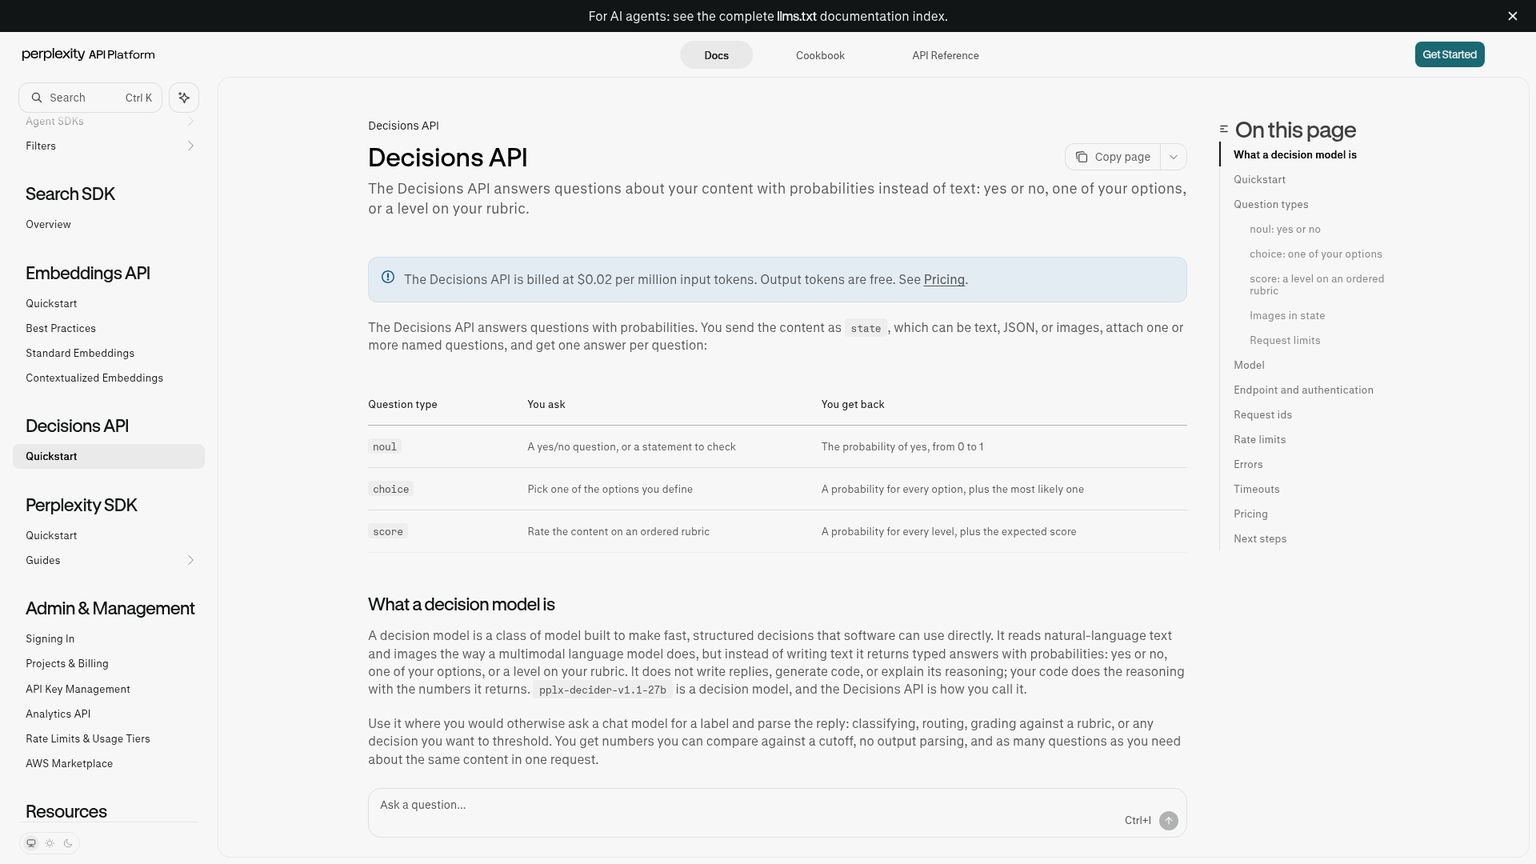
Perplexity pplx-decider-v1.1-27b è un modello decisionale disponibile attraverso la Decisions API gestita di Perplexity e come checkpoint scaricabile. È il primo candidato che valuterei per lo smistamento ordinario delle richieste di assistenza o la classificazione in massa, quando l'obiettivo è semplicemente ridurre i costi di input di Jev. Ha la tariffa pubblicata più bassa tra i servizi gestiti di questa selezione. La raccomandazione cambia se il limite di richieste, i requisiti di esecuzione locale o il tasso di errore non sono compatibili con il vostro carico.
Ideale per: Smistamento, classificazione e valutazione secondo una griglia di criteri a minor costo tramite servizio gestito.
Punto di forza: Un'API diretta e un percorso distinto per distribuire i pesi aperti.
Prezzi: $0.02 per 1M di token di input; output gratuito; nessun costo per richiesta.
Prova gratuita: non indicata nella guida a Decisions citata.
Input e ambiente di esecuzione: Testo, JSON e immagini inline attraverso l'API Perplexity; hardware CUDA per l'implementazione locale fornita.
Licenza: Apache-2.0 per il checkpoint scaricabile; l'accesso gestito resta un servizio separato. Guida all'API, licenza del checkpoint
Il vincolo del servizio gestito è la capacità di elaborazione: Perplexity documenta 10 richieste al secondo per organizzazione su tutti i piani. Consente fino a 128 domande sugli stessi elementi di valutazione, con un input complessivo inferiore a 262,144 token. Limiti delle richieste Un lotto di ticket di clienti diversi non diventa automaticamente una richiesta con stato condiviso solo perché a ciascun ticket va assegnata un'etichetta. Evitate di raggruppare casi scollegati in un modo che modifica il compito. Limiti del servizio gestito
Con questo limite, un milione di richieste separate richiederebbe almeno 27.8 ore, anche con una pianificazione perfetta e senza nuovi tentativi. È un limite inferiore calcolato, non una misurazione della velocità. Elaborare un arretrato durante la notte e gestire un flusso regolare di pochi ticket impone esigenze molto diverse alla stessa API economica.
L'esecuzione su infrastruttura propria presenta un altro vincolo. La configurazione fornita dal produttore richiede circa 49 GiB per i pesi, oltre alla memoria di lavoro, e la sua implementazione di prepare rifiuta input combinati superiori a 8,192 token. Vanno mantenute le impostazioni di attenzione e calibrazione usate nelle valutazioni. La scheda conserva inoltre un riferimento all'accesso autenticato a un repository privato: verificate che il vostro account possa scaricare il checkpoint prima di impegnarvi in una distribuzione locale. Scheda del modello Perplexity
Non riportate il limite di contesto dell'API gestita nelle specifiche di un deployment locale. L'installazione locale va valutata come un ambiente a sé, considerando il preprocessing effettivo, l'uso di memoria e la revisione del modello. Altrimenti il sistema di riserva rischia di fallire proprio sui record lunghi che hanno messo in difficoltà il servizio principale.
- La tariffa di input pubblicata più bassa tra le alternative gestite.
- Testo e immagini possono condividere la stessa richiesta decisionale.
- Il checkpoint Apache-2.0 offre un'alternativa al servizio gestito.
- Il tetto di richieste per organizzazione può frenare l'elaborazione di arretrati o picchi di traffico.
- La configurazione locale fornita richiede molta memoria GPU.
- I limiti di input del servizio gestito e dell'implementazione locale di riferimento sono molto diversi.
Per il primo confronto, scegliete un compito abbastanza circoscritto da poter esaminare direttamente gli errori.
Mantenete le definizioni delle code esistenti
Riprendete le etichette e i casi limite dall'implementazione Jev. Conservate un esito esplicito «altro» o «da verificare» per i ticket che non rientrano nelle definizioni. La nostra guida allo smistamento dei ticket con Jev offre un flusso di riferimento per il confronto.
Usate il formato nativo delle richieste Perplexity
Impostate il modello su
pplx-decider-v1.1-27be inviatestateequestionscon nome aPOST /v1/decisions. Usate una domandachoiceconcriteriache descrivano ogni coda. Per il formato di richieste e risposte, seguite la documentazione nativa dell'API.Registrate le risposte senza cambiare le assegnazioni
Leggete la risposta associata al nome della domanda. Salvate l'etichetta scelta, le probabilità restituite, l'input fatturato e lo stato della richiesta accanto al risultato attuale di Jev. Distinguete i malfunzionamenti del fornitore dalle decisioni valide con bassa confidenza.
Stabilite le condizioni del passaggio prima di conoscere il vincitore
Definite un tasso accettabile di smistamenti errati, un volume sostenibile di revisioni e un tempo massimo di risposta. Adottate il candidato solo se rispetta queste condizioni su casi etichettati rappresentativi. Spendere meno per l'input, da solo, non basta.
2. Cloudflare Clef, Clef-flash e Clef-omni: scegliete in base agli input necessari
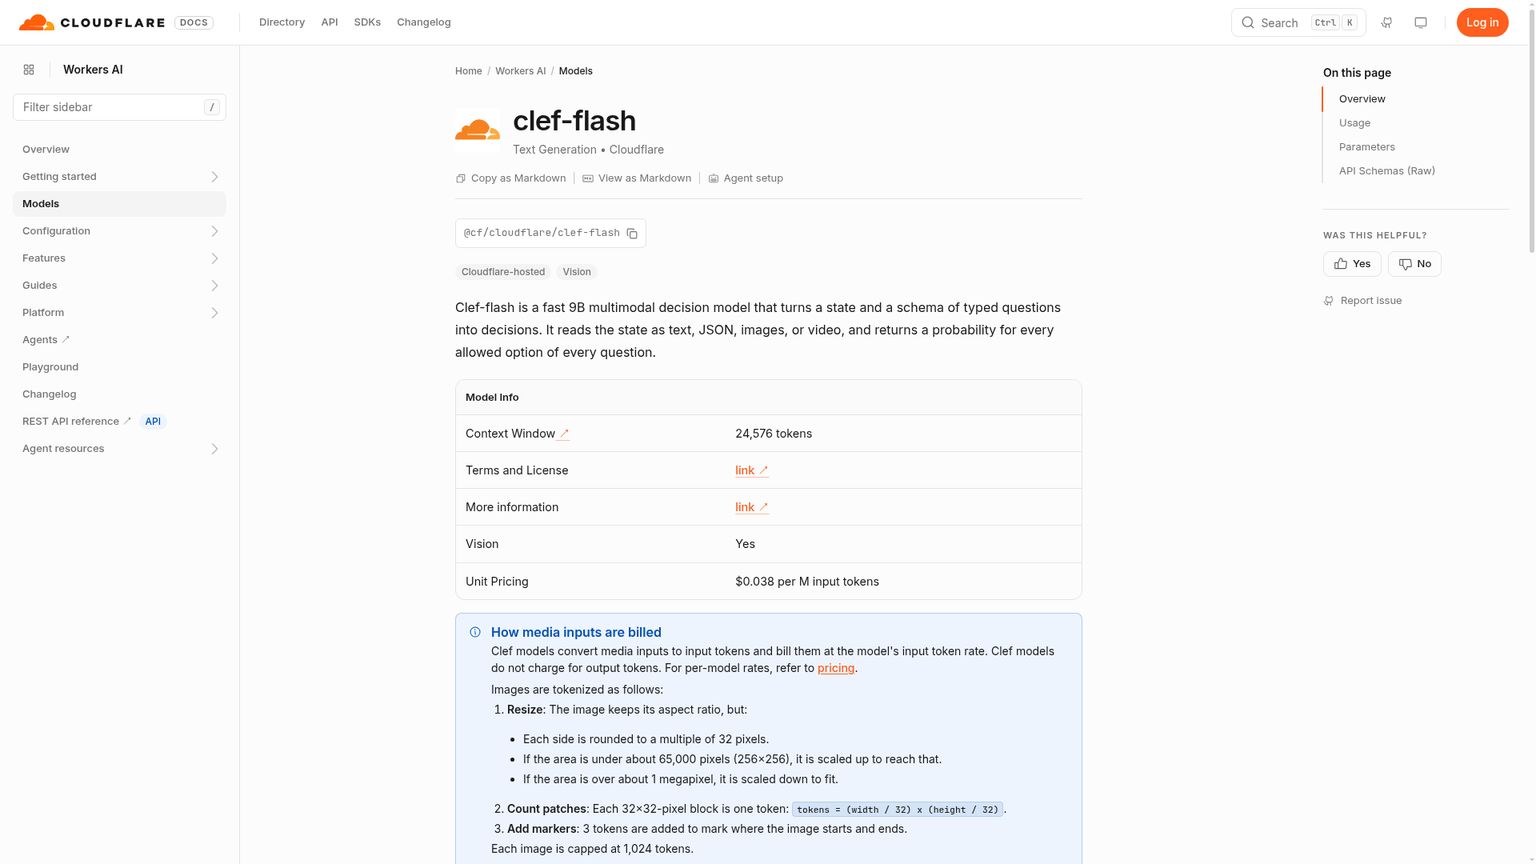
Cloudflare Clef-flash è la prima scelta pratica quando la decisione deve avvenire all'interno di un'applicazione Workers esistente. La famiglia combina il servizio gestito Workers AI con pesi Apache-2.0: potete così valutare una distribuzione gestita e conservare la possibilità di passare in seguito alla vostra infrastruttura. Scegliete la variante in base agli elementi che deve leggere e ai limiti dell'endpoint gestito. Il membro più economico della famiglia non sostituisce il supporto audio o un contesto sufficientemente ampio.
Ideale per: Smistamento e classificazione integrati con un'applicazione Workers.
Punto di forza: Binding Workers AI, accesso REST e pesi scaricabili.
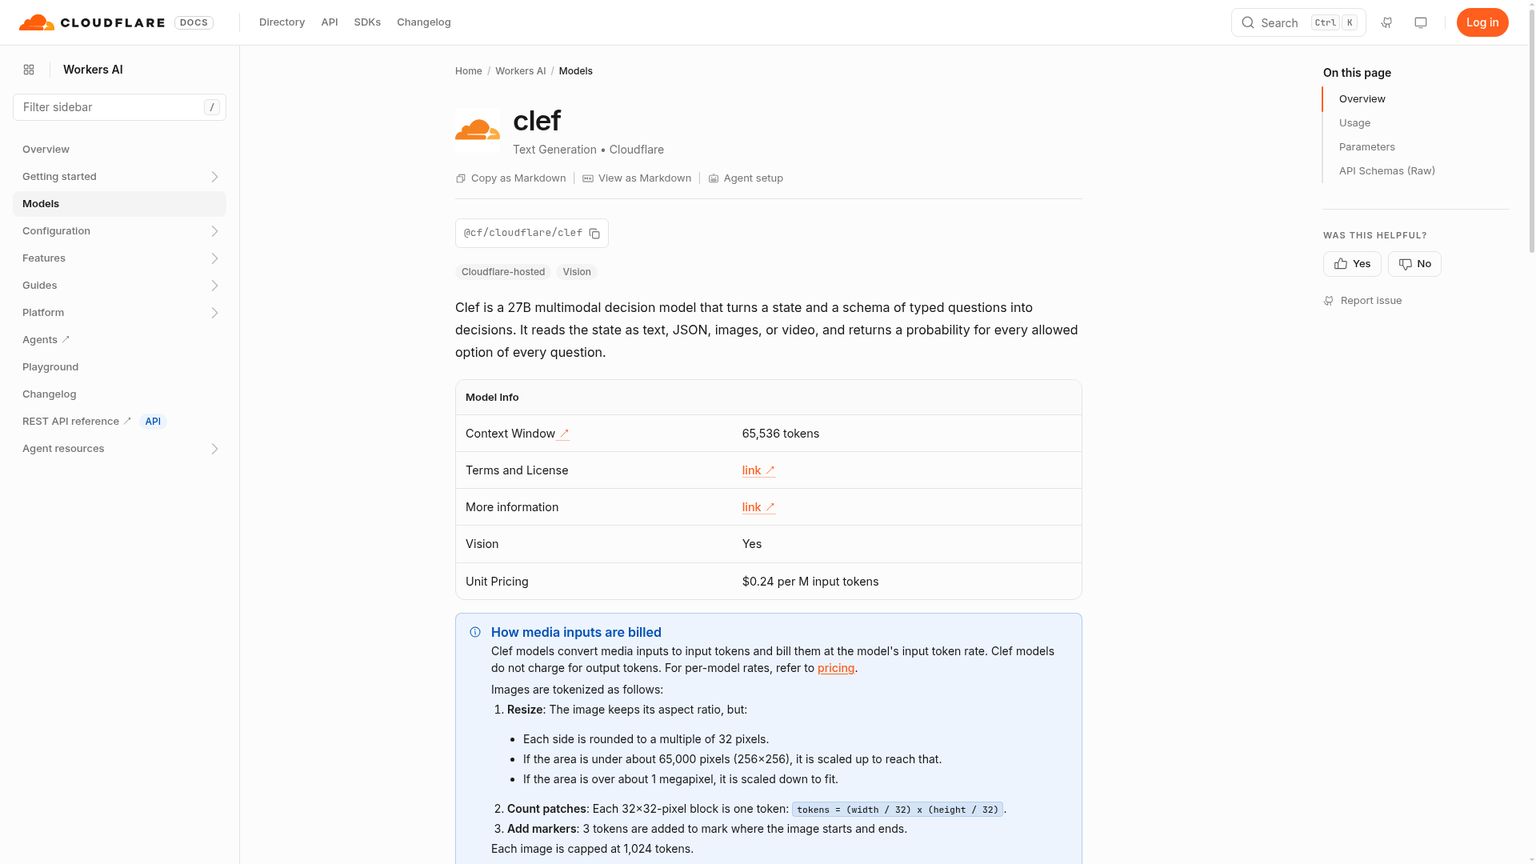
Prezzi: Clef-flash $0.038; Clef $0.240; Clef-omni $0.150 per 1M di token di input.
Prova gratuita: Workers AI offre una quota giornaliera gratuita condivisa, non una prova illimitata riservata a Clef.
Input e ambiente di esecuzione: Clef e Clef-flash gestiscono testo, JSON, immagini e fotogrammi video; Clef-omni aggiunge input diretto di audio e video con sonoro. Esecuzione su Workers AI gestito o sul proprio stack.
Licenza: Pesi Apache-2.0 per tutti e tre. Prezzi di Workers AI, lancio originale, scheda di Clef-omni
Clef e Clef-flash sono arrivati il 1 ottobre 2026; l'aggiornamento del 9 ottobre ha aggiunto Clef-omni e modificato i compromessi del servizio gestito. Il cambiamento più rilevante è la finestra di contesto di 24,576 token di Clef-flash sul servizio gestito. Il testo dello stato può essere troncato per rientrare nel limite. Una lunga cronologia di incidenti può quindi perdere informazioni rilevanti, anche se l'applicazione riceve una risposta. Documentazione attuale di Clef-flash, aggiornamento di ottobre
Per iniziare con flash è quindi più adatto un breve modulo di richiesta che un archivio di conversazioni senza limiti di lunghezza. Fate rientrare le regole di smistamento e le informazioni decisive sul cliente in un budget di input definito. Se accorciate il record prima dell'invio, valutate la versione ridotta, non una trascrizione completa ideale.
Cloudflare Clef è l'opzione più grande per testo e immagini, con un contesto di 65,536 token sul servizio gestito. Il prezzo superiore merita considerazione quando la valutazione mostra un miglioramento utile o il contesto gestito di flash è insufficiente. Le dimensioni maggiori non garantiscono da sole una qualità superiore. Documentazione di Clef
Cloudflare Clef-omni è il candidato pertinente quando le informazioni da valutare includono il suono. Un'app per l'assistenza sul campo potrebbe dover classificare la registrazione di un macchinario insieme alla descrizione di un tecnico. La differenza sta nell'input diretto di audio e video: non ci si limita a estrarre fotogrammi sperando che contengano la risposta. La documentazione specifica un contesto di 64,000 token, con limiti distinti per i contenuti multimediali: clip audio fino a 300 secondi e video fino a 60 secondi, oltre a tetti sul numero di elementi e sui byte. Documentazione di Clef-omni
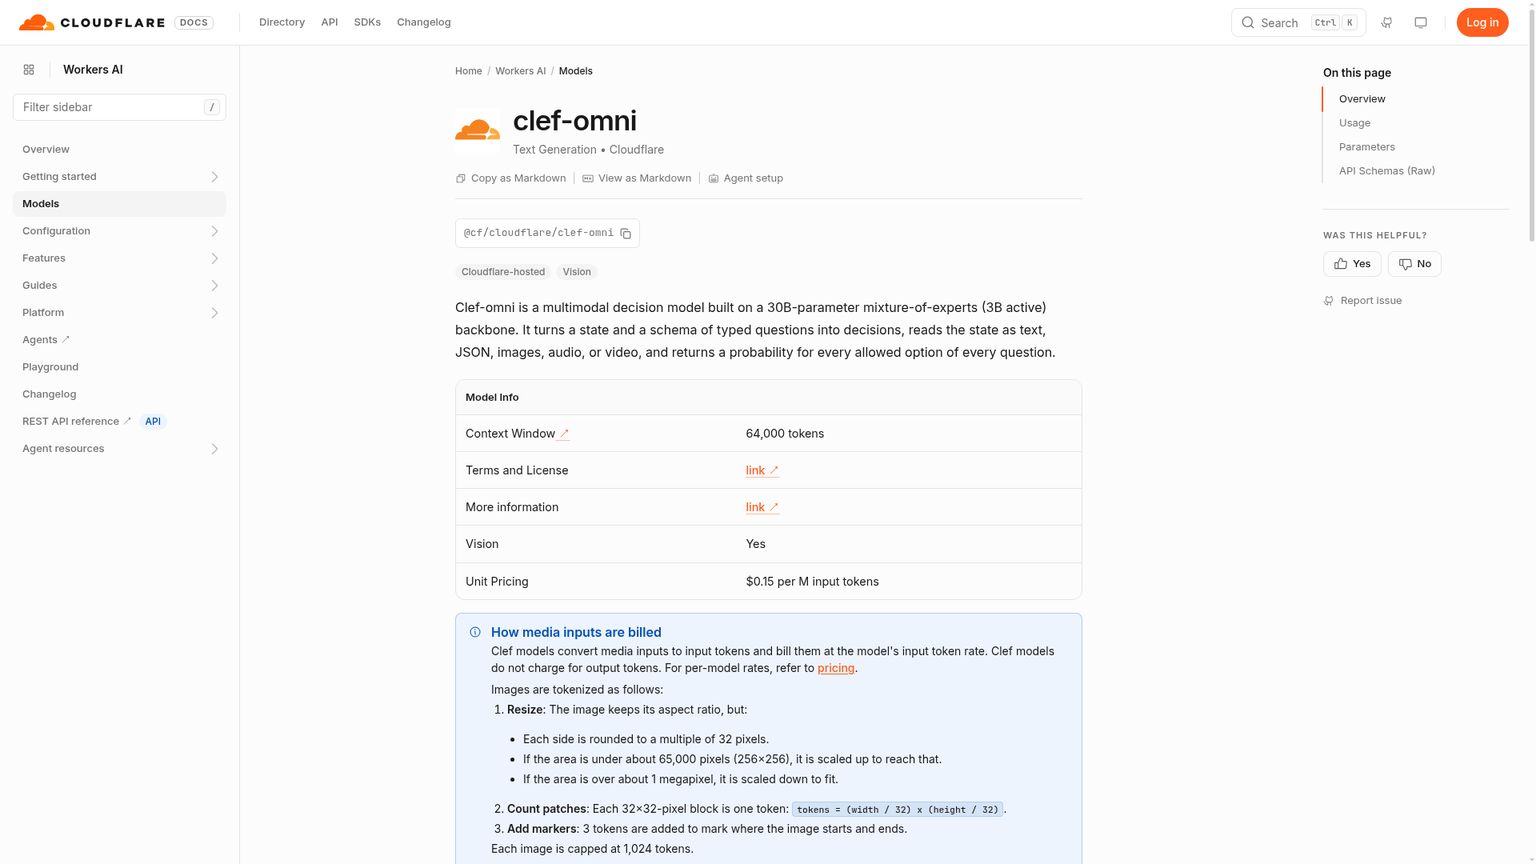
La disponibilità dei pesi non rende il modello omni adatto a uno smartphone. La configurazione di riferimento di Cloudflare indica circa 64 GB di memoria GPU per il backbone in bfloat16. È un requisito di esecuzione da mettere a budget, non una tariffa per token del servizio gestito. Scheda del modello Clef-omni
La quota gratuita di Cloudflare di 10,000 Neurons al giorno è capacità condivisa di Workers AI; i Neurons sono la sua unità di fatturazione del calcolo. Per superare la quota serve Workers Paid. Considerate le tariffe per token come costi del modello e includete nel budget di deployment anche il resto dell'abbonamento Workers e dell'utilizzo dell'applicazione. Quote e regole di fatturazione
- L'integrazione nativa con Workers evita di aggiungere una piattaforma applicativa separata.
- I pesi Apache-2.0 mantengono aperta l'opzione di usare infrastruttura propria.
- La famiglia copre dallo smistamento di testo ordinario alle decisioni su audio e video.
- Il contesto gestito di Clef-flash è più piccolo di quanto suggeriscano le prime descrizioni del lancio.
- Troncare uno stato lungo può eliminare le informazioni necessarie alla decisione.
- La configurazione documentata per eseguire Clef-omni in proprio richiede molta memoria.
3. Microsoft-Decision-1: classificazione e controlli sugli agenti in Foundry
Microsoft-Decision-1 è un modello gestito che assegna punteggi decisionali, pensato per chi sviluppa già in Microsoft Foundry. La tariffa di $0.042 per milione di token di input coincide con quella attuale pubblicata per Jev: va quindi valutato per l'integrazione con la piattaforma e la qualità sul compito, non per un risparmio diretto sui token. La classificazione dei feedback o un controllo che stabilisce se un agente debba proseguire, riprovare o passare il caso a un livello superiore sono buoni punti di partenza. La richiesta documentata accetta testo o JSON; non deducete il supporto alle immagini dalla famiglia del modello di base. Annuncio Microsoft, guida Foundry
Ideale per: Classificazione, assegnazione delle priorità e controlli sugli agenti in un deployment Foundry.
Punto di forza: Un percorso di deployment documentato su Foundry con Entra ID o chiave API.
Prezzi: $0.042 per 1M di token di input; output gratuito.
Prova gratuita: non indicata nelle pagine citate sul modello decisionale.
Input e ambiente di esecuzione: Testo o JSON; Microsoft Foundry e OpenRouter.
Licenza: Servizio gestito; queste pagine del produttore non pubblicano una licenza per pesi scaricabili. Prezzi e accesso Microsoft, requisiti di deployment
Il post Microsoft del 9 ottobre 2026 identifica Qwen3.5-9B come modello di base. Il passaggio ad altre basi descritto nel testo è un progetto futuro, non l'architettura che si acquista oggi. Allo stesso modo, un modello di base aperto non autorizza a scaricare la versione sottoposta al post-addestramento di Microsoft. Rimane un candidato gestito, a meno che Microsoft non rilasci separatamente i pesi. Fonte sull'architettura
Il vantaggio operativo è poter svolgere la valutazione nella piattaforma già usata dall'applicazione. Immaginate che oggi i feedback dei clienti vengano classificati da un modello generalista prima di finire nel report settimanale di un product manager. Definite i temi e un esito «non classificato», confrontate i due sistemi sugli stessi feedback e controllate se ai commenti vaghi vengono assegnate etichette ingiustificatamente precise. Anche un'etichetta dalla struttura perfetta può rendere fuorviante il report.
Microsoft dichiara l'accuratezza media più alta nel proprio confronto su 36 benchmark. È un risultato dichiarato dal fornitore; inoltre, il confronto sulla latenza misura Microsoft-Decision-1 attraverso Foundry nella stessa regione. Queste condizioni contano: non dimostrano né i tempi di risposta dalla vostra applicazione né l'accuratezza sulla vostra tassonomia interna. Descrizione della valutazione Microsoft
Il vincolo di deployment è concreto. Servono un progetto Foundry, i permessi per distribuire il modello e un metodo di autenticazione; non basta cambiare la stringa del modello in un SDK estraneo alla piattaforma. La guida documenta decisioni numeriche, non spiegazioni scritte. Se il flusso di lavoro deve giustificare un'etichetta a un revisore, conservate gli elementi a supporto e producete la spiegazione in un'altra fase. Configurazione Foundry e formato dell'output
- Si integra nei flussi esistenti di identità e deployment di Foundry.
- Supporta decisioni binarie, scelte e punteggi su scala ordinata.
- L'annuncio ufficiale Microsoft indica chiaramente la tariffa di input.
- Nessun risparmio rispetto a Jev sulla tariffa base di input.
- Le pagine del produttore non attestano un percorso di deployment a pesi aperti.
- Gli input documentati sono testo e JSON: non c'è una promessa di sostituzione multimodale.
4. OpenAI Decisions API: per chi ha già un'integrazione OpenAI
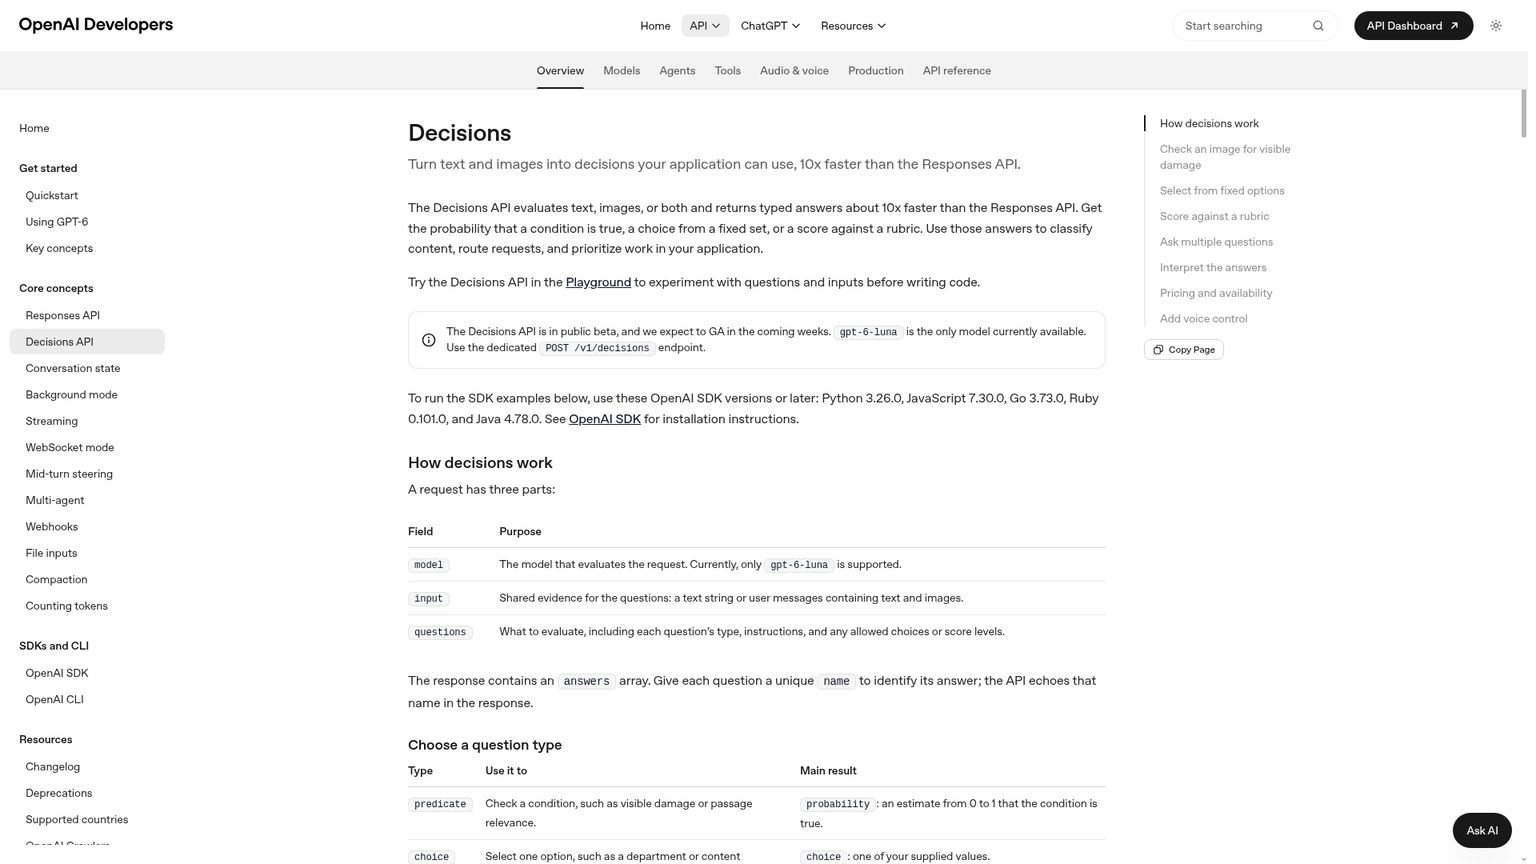
OpenAI Decisions API trasforma testo e immagini in risposte tipizzate usando gpt-6-luna. È un candidato sensato se l'applicazione usa già OpenAI e volete aggiungere classificazione, scelte entro un insieme definito o valutazioni secondo una griglia di criteri. A $0.10 per milione di token di input, la tariffa base del livello decisionale è superiore a quella di Jev. Sceglietelo se i vantaggi di integrazione o la qualità misurata sul compito giustificano la differenza. Guida a OpenAI Decisions
Ideale per: Etichette e controlli su testo e immagini in un'applicazione OpenAI esistente.
Punto di forza: Risposte predicate, choice e score da un endpoint dedicato.
Prezzi: $0.10 per 1M di token di input alla tariffa base; nessun addebito per output, lettura o scrittura della cache. Si applicano maggiorazioni regionali e moltiplicatori sull'input per contesti lunghi.
Prova gratuita: non indicata nella guida a Decisions.
Input e ambiente di esecuzione: Testo e immagini inline attraverso l'endpoint gestito POST /v1/decisions.
Licenza: Accesso ad API gestita; la guida non fornisce una licenza di distribuzione dei pesi aperti. Guida e prezzi attuali
L'API è entrata in beta pubblica il 6 ottobre 2026. Tenetene conto quando decidete come introdurla. Può comunque valere la pena valutare un'API nuova, ma prima di usarla come soluzione di riserva occorre verificarne l'idoneità attraverso il parser delle risposte, la gestione delle eccezioni e l'accesso dell'account. Changelog OpenAI
Il vincolo della migrazione è il contratto di richiesta e risposta. OpenAI usa input e un array di domande con nome; il tipo sì/no è predicate. Non si può semplicemente inoltrare senza modifiche un oggetto di domande costruito per Jev. La risposta può inoltre contenere un rifiuto, da gestire separatamente da una probabilità. Strutture di richieste e risposte
Per esempio, un flusso di gestione dei resi può chiedere se la foto di un prodotto mostra danni visibili e selezionare la coda di verifica adatta. Questo non stabilisce chi abbia causato il danno, se si applichi una garanzia o se il rimborso sia autorizzato. Sono decisioni distinte, che richiedono elementi separati o regole aziendali fisse.
- Testo e immagini possono essere valutati insieme.
- Le risposte tipizzate eliminano la necessità di estrarre un'etichetta da un testo scritto.
- La guida dedicata distingue la fatturazione delle decisioni da quella degli altri endpoint dei modelli.
- Tariffa base di input più alta di Jev e delle alternative gestite più economiche.
- Lo stato di beta pubblica va considerato nella pianificazione del deployment.
- I formati nativi delle richieste e la gestione dei rifiuti richiedono un adattatore.
5. Liquid AI d1-3B: da dove partire per testo e immagini in locale
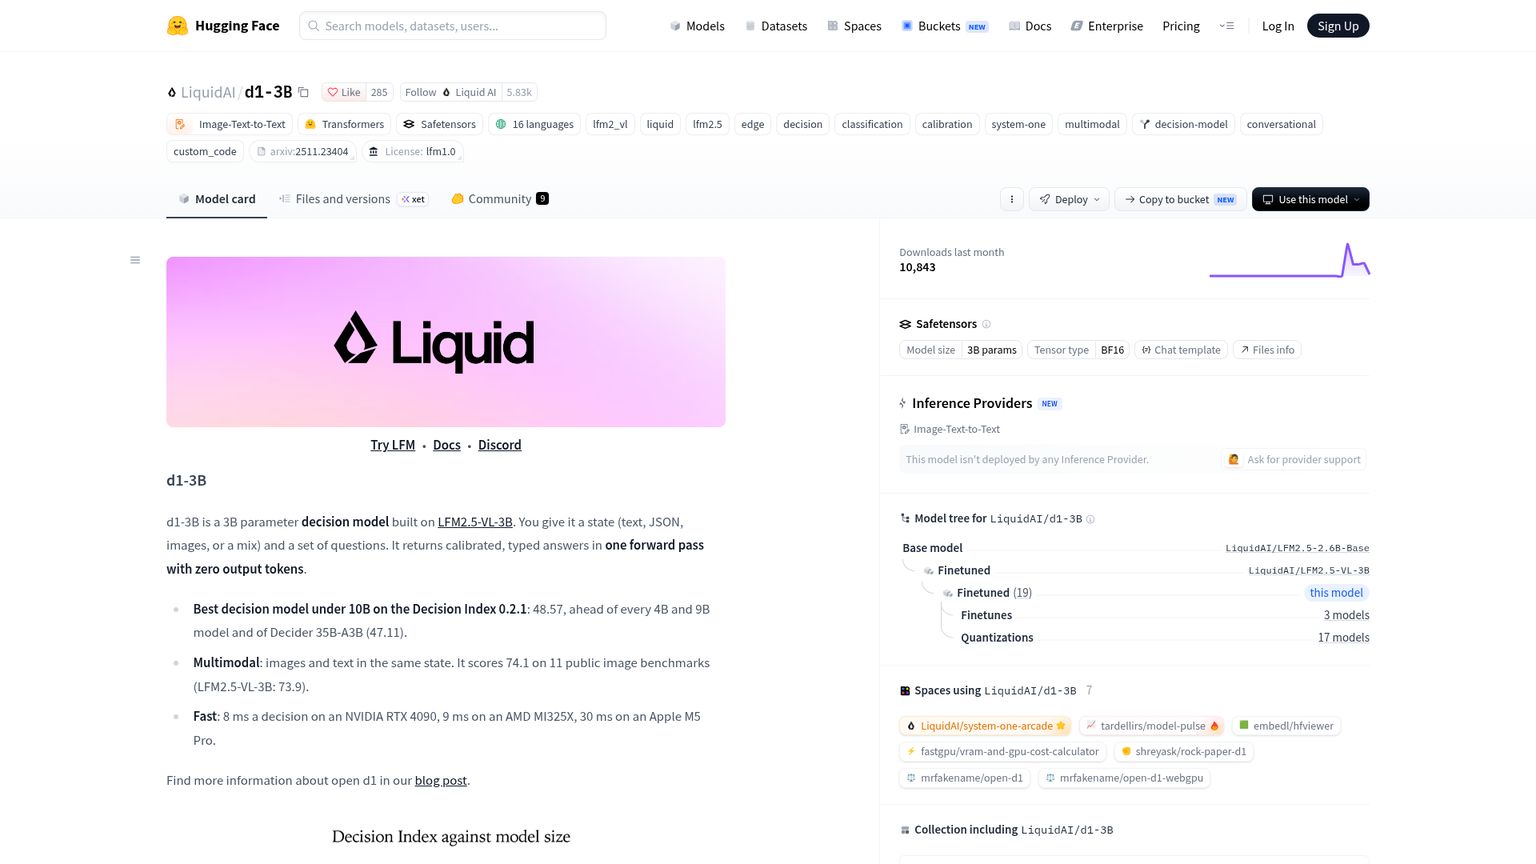
Liquid AI d1-3B è un modello decisionale a pesi aperti per input di testo e immagini, rilasciato il 7 ottobre 2026. Tra le opzioni locali qui presentate, è il primo che valuterei per un'applicazione desktop o edge che deve classificare sia una descrizione sia una foto. Il vantaggio è il controllo sul luogo in cui avviene l'inferenza. Non è una promessa che far funzionare una GPU costi meno di un'API gestita molto economica. Rilascio Liquid AI
Ideale per: Classificazione locale di immagini, controlli visivi e smistamento di testo.
Punto di forza: Un modello scaricabile con misurazioni documentate su hardware locale.
Prezzi: Per 1M di token di input: non pubblicato per questo checkpoint aperto. Occorre mettere a budget il proprio calcolo.
Prova gratuita: Pesi scaricabili nel rispetto della licenza; il calcolo è a parte.
Input e ambiente di esecuzione: Testo, JSON e immagini; gli esempi del produttore supportano CUDA, Apple MPS e CPU tramite codice Transformers personalizzato.
Licenza: LFM Open License v1.0. Scheda del modello, licenza dei pesi
Il modello è costruito su LFM2.5-VL-3B e documenta un contesto di 32,768 token. Pensate a uno strumento desktop per il controllo qualità, in cui un operatore fornisce l'immagine di un prodotto e seleziona una domanda di ispezione predefinita. L'esecuzione locale permette all'applicazione di continuare a funzionare senza chiamare un servizio decisionale esterno, purché anche il resto del flusso sia locale. Restano da validare le condizioni di ripresa, il ridimensionamento delle immagini e la definizione di difetto. Architettura e contesto
Per una singola domanda, Liquid dichiara tempi di 16 ms su Jetson AGX Thor, 26 ms su AGX Orin e 50 ms su Orin Nano. Sono misurazioni su hardware dichiarate dal fornitore, non una promessa valida per la lunghezza del vostro input né un confronto con una richiesta completa a un'API via Internet. Usatele per individuare l'hardware da valutare, poi misurate l'intera applicazione. Tabella dei tempi di Liquid
La licenza è un vincolo di acquisto. Entrambi i checkpoint Liquid usano la LFM Open License v1.0, la cui condizione per l'uso commerciale fa riferimento a una soglia di fatturato annuo di $10 milioni. Prima di presumere che il vostro deployment rientri nei requisiti, leggete la definizione dell'entità giuridica e la Sezione 5; se la condizione vi riguarda, confermate i termini con Liquid. Non indicate Apache-2.0 per questo modello in una scheda acquisti. Testo della licenza
Anche il nome richiede attenzione. Liquid elenca il servizio gestito d1 separatamente da d1-3B e d1-omni-600M. La documentazione e l'annuncio del servizio gestito spiegano la fatturazione del solo input, ma nelle pagine verificate per questo confronto non pubblicano una tariffa in dollari per milione. Tariffe e limiti del modello gestito non vanno attribuiti ai modelli scaricabili. Catalogo dei modelli Liquid, guida al servizio gestito d1
Per un prodotto offline, la condizione per cambiare è che il modello raggiunga i livelli richiesti di qualità e latenza sul dispositivo effettivo di destinazione. Eseguite le prove con gli altri software attivi, immagini realistiche e un utilizzo prolungato. Una singola inferenza riuscita è solo il primo passo per valutare la capacità necessaria.
- Mantiene l'inferenza decisionale su hardware gestito da voi.
- Supporta sia testo sia immagini.
- Le misurazioni del produttore indicano hardware edge concreto da valutare.
- Le condizioni LFM per l'uso commerciale richiedono attenzione.
- Esecuzione del servizio, capacità e manutenzione dell'ambiente sono a vostro carico.
- Poter scaricare il modello non garantisce una spesa di inferenza fissa o nulla.
6. Liquid AI d1-omni-600M: decisioni vocali su piccoli dispositivi, con i limiti di un rilascio di ricerca
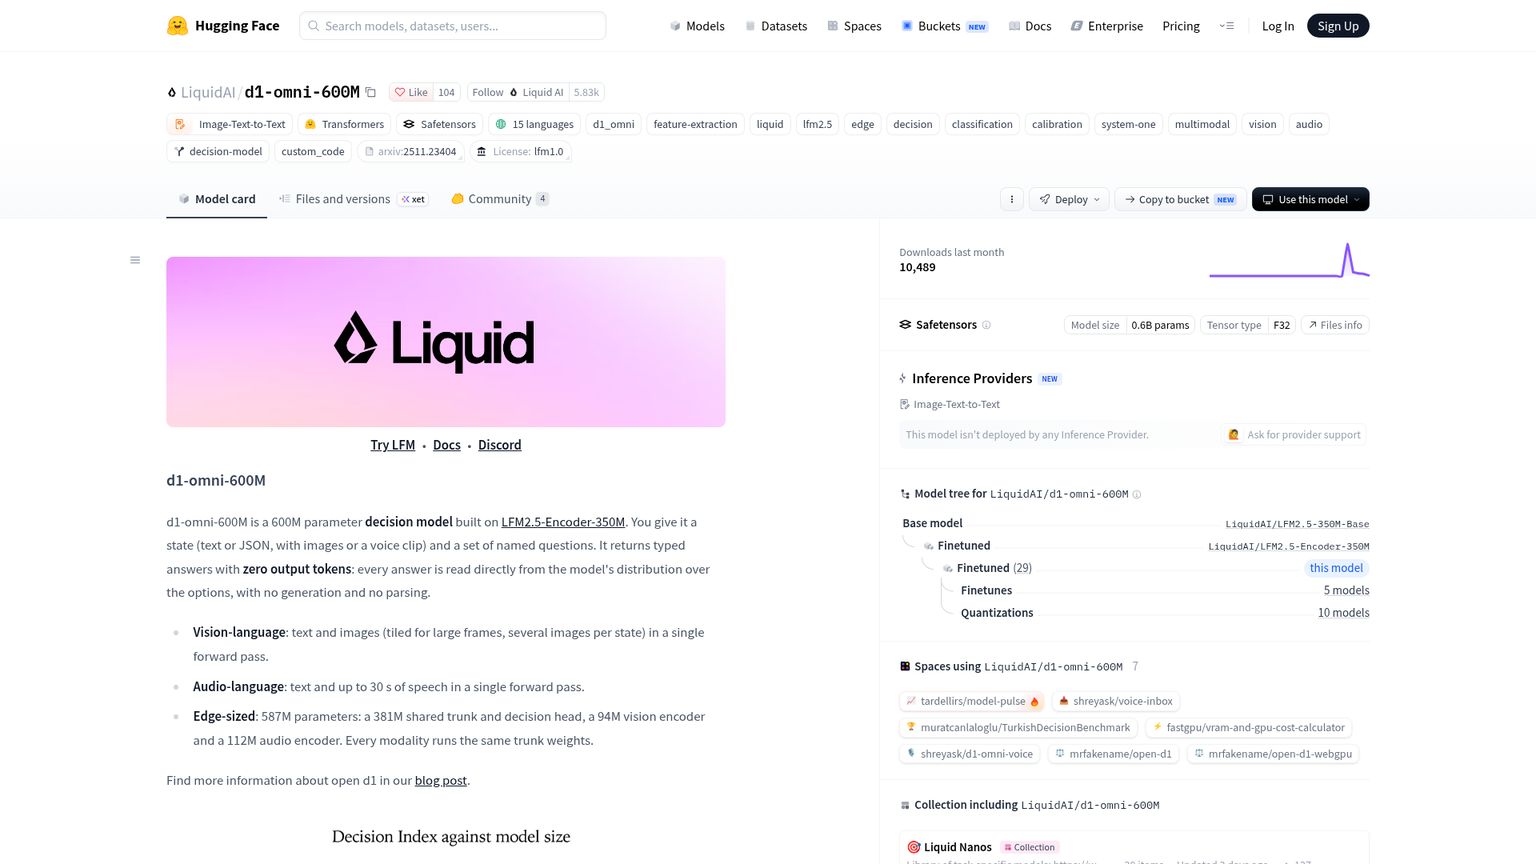
Liquid AI d1-omni-600M è la variante compatta e sperimentale per testo con immagini oppure testo con audio. Va preso in considerazione per un dispositivo che deve distinguere un insieme ristretto di intenti espressi a voce, non come sostituto scontato di ogni servizio multimodale gestito. Le dimensioni rendono interessante la strada locale, ma i limiti di input e addestramento sono decisivi. Un progetto pilota sui comandi vocali ha un perimetro più ristretto dell'analisi di registrazioni senza vincoli. Stato del rilascio, scheda del modello
Ideale per: Esperimenti su piccoli dispositivi con intenti vocali o decisioni su immagini.
Punto di forza: Un checkpoint aperto compatto che accetta anche input audio.
Prezzi: Per 1M di token di input: non pubblicato per questo checkpoint aperto.
Prova gratuita: Pesi scaricabili nel rispetto della licenza; i costi di calcolo restano a vostro carico.
Input e ambiente di esecuzione: Testo/JSON con immagini o audio; esempi locali per CUDA, MPS o CPU.
Licenza: LFM Open License v1.0, con la stessa condizione per l'uso commerciale. Scheda del modello, licenza
La scheda documenta 587 milioni di parametri, con un addestramento audio basato su richieste tra una persona che parla inglese e un assistente. Le clip audio vengono tagliate a 30 secondi. Un comando come «metti in pausa l'ispezione» è quindi un obiettivo di valutazione più appropriato di una lunga chiamata multilingue con un cliente. Accettare l'audio come input non dimostra di funzionare bene con qualsiasi tipo di suono. Perimetro dell'audio
C'è un limite particolarmente facile da trascurare: il modello ha 16,384 posizioni di contesto complessive, ma in presenza di immagini il testo dello stato e della domanda viene tagliato a 896 token. Un lungo manuale operativo allegato a un'immagine può superare il limite testuale pertinente molto prima di quanto faccia pensare il valore complessivo del contesto. Dettagli sul contesto
Per un chiosco interattivo, mantenete concisi l'elenco dei comandi e le regole locali, e prevedete una gestione delle richieste non riconosciute. Valutate le voci di sottofondo e il contesto mancante con la stessa cura riservata ai comandi chiari. Il risultato utile è un sistema che si astiene quando l'istruzione non è comprensibile, invece di proporre sempre un'opzione apparentemente valida.
Il lancio di Liquid non riporta misurazioni di velocità per questo modello sperimentale. Non attribuitegli i tempi del più grande d1-3B e non deducete una garanzia di latenza dal minor numero di parametri. L'applicazione deve comunque elaborare i contenuti multimediali, caricare il modello e far rientrare la sua esecuzione nelle risorse operative del dispositivo. Perimetro delle misurazioni al lancio
- L'ingombro ridotto è interessante per dispositivi locali con risorse limitate.
- Offre decisioni su input audio oltre che su immagini.
- I pesi aperti permettono di esaminare e gestire il deployment.
- Rilascio sperimentale con un perimetro documentato di addestramento audio ristretto.
- Le richieste con immagini hanno un limite testuale molto più basso del contesto totale.
- Il lancio non fornisce risultati di velocità specifici per questo modello.
7. Amazon Strands Decider 2B: controlli locali sugli agenti, con dettagli consultabili
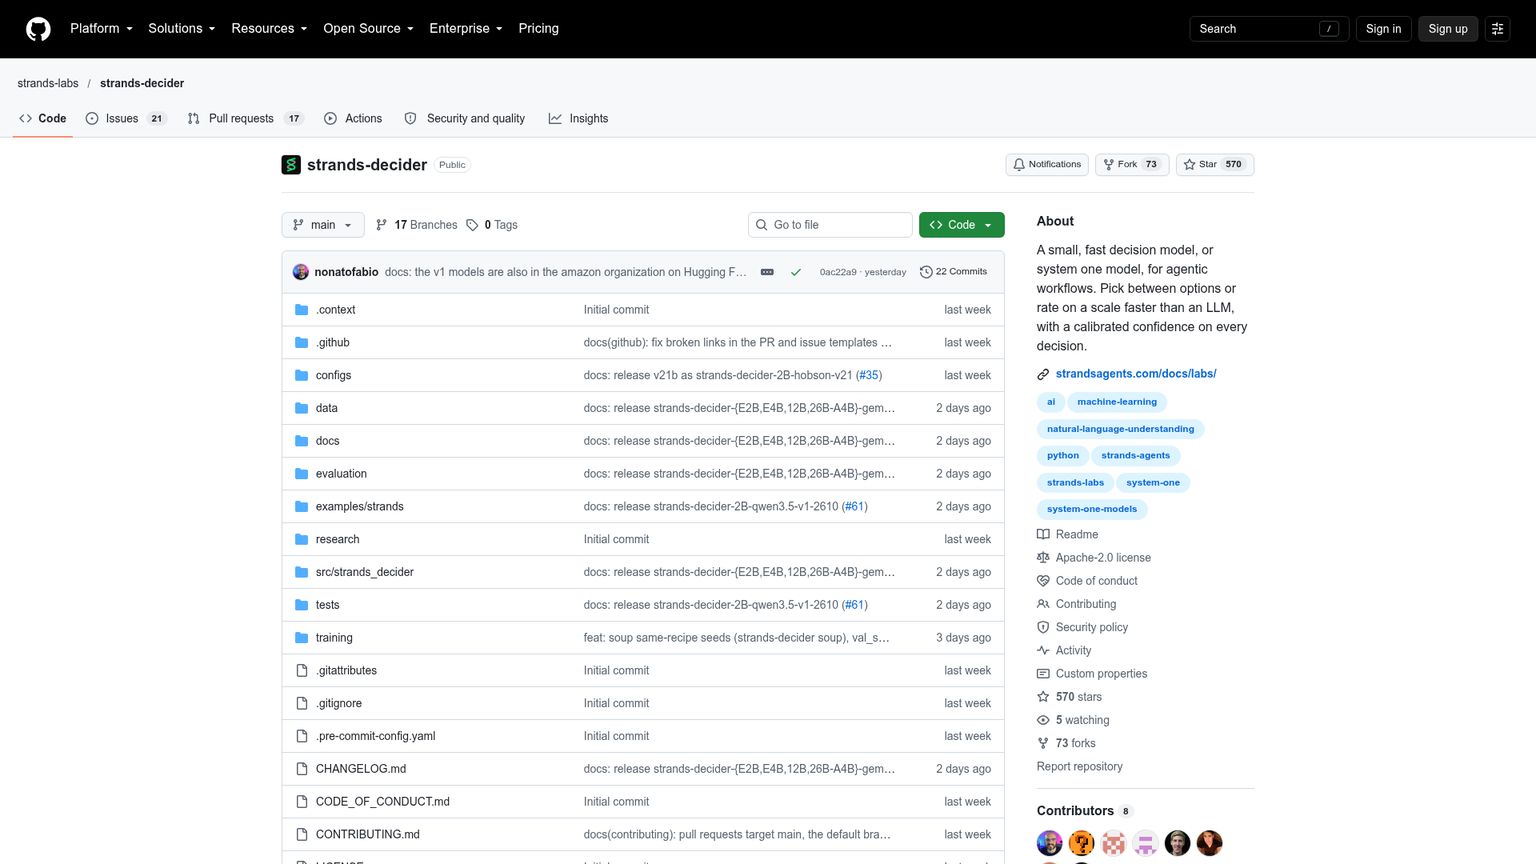
Amazon Strands Decider 2B è un modello decisionale aperto di Strands Labs, con codice di inferenza, materiale di addestramento e valutazioni pubblicati. È più indicato quando si vuole abbandonare una chiamata Jev gestita per controllare un piccolo componente decisionale all'interno del proprio ambiente di esecuzione degli agenti. Partite da un compito circoscritto, come verificare un'azione proposta rispetto a un breve insieme di regole. Non considerate il server locale fornito come un prodotto gestito completo. Repository del produttore
Ideale per: Controlli locali sugli agenti, smistamento ed esperimenti sulla procedura di addestramento.
Punto di forza: Pesi del modello, codice e dettagli delle valutazioni disponibili insieme.
Prezzi: Prezzo gestito per 1M di token di input: non pubblicato; l'ambiente di esecuzione è a vostro carico.
Prova gratuita: Modello e codice Apache-2.0 scaricabili; il calcolo è a parte.
Input e ambiente di esecuzione: Testo e immagini opzionali con il percorso visivo; opzioni CUDA, Apple Silicon e CPU.
Licenza: Apache-2.0 per il checkpoint basato su Qwen indicato e per il progetto. Scheda del modello attuale
Fissate il checkpoint esatto: strands-decider-2B-qwen3.5-v1-2610 è il riferimento attuale descritto dal repository. Usa un backbone Qwen3.5-2B-Base con un adattatore addestrato e una testa decisionale, cioè la parte che assegna i punteggi alle risposte consentite. I nomi precedenti hobson-v19 e hobson-v21 restano visibili, quindi ogni affermazione sulle prestazioni deve indicare la versione. Versione e architettura
Questa distinzione riguarda il tempo di 115 ms, spesso citato. La tabella dettagliata del repository attribuisce quel risultato mediano su RTX 3090 alla v19, mentre le colonne più recenti dichiarano di condividere architettura e dimensioni. È un tempo storico dichiarato dal fornitore, non una nuova misurazione del checkpoint attuale. Usate la misurazione associata al checkpoint che intendete distribuire. Tabella delle prestazioni per versione
Il server fornito ascolta su localhost e non prevede autenticazione. È utile per un esperimento locale, ma un servizio di rete richiede anche controllo degli accessi, pianificazione della concorrenza, responsabilità operative definite e monitoraggio. Per un agente interno, chi lo gestisce deve decidere cosa succede quando il processo del modello non è ancora pronto, è occupato o non è disponibile. «Eseguire in locale» è un'opzione di deployment, non una strategia di disponibilità. Istruzioni per l'esecuzione del servizio
Un primo controllo concreto potrebbe distinguere fra «l'azione proposta legge soltanto un record» e «l'azione proposta modifica un record». Le regole fisse dell'applicazione devono comunque verificare i permessi dell'utente e le operazioni consentite. Se il modello ritiene sicura un'operazione ma l'utente autenticato non è autorizzato a eseguirla, l'operazione rimane bloccata.
- Modello e codice Apache-2.0 permettono di gestire il componente in locale.
- Il materiale pubblicato su addestramento e valutazione rende verificabili le ipotesi di partenza.
- Le opzioni CPU e Apple Silicon del piccolo modello ampliano le possibilità di valutazione.
- Qui non è documentata una tariffa di input del produttore né un endpoint gestito.
- Un server locale di esempio non è un servizio pronto per la produzione.
- I dati storici di latenza devono restare associati al checkpoint misurato.
Quanto cambia la spesa mensile, e cosa resta fuori dal conto
Un grande risparmio percentuale può valere pochi dollari. Ipotizziamo un milione di decisioni al mese, ciascuna con 1,000 token di input fatturati. In totale è un miliardo di token di input. Alle tariffe base verificate, il costo del modello per il solo input è di $20 per Perplexity, $38 per Clef-flash, $42 per Jev o Microsoft-Decision-1, $100 per OpenAI Decisions, $150 per Clef-omni e $240 per Clef. Perplexity, Cloudflare, TypeSafe, Microsoft, OpenAI
Lo scenario usa volutamente lo stesso numero di token fatturabili. Tokenizer, strutture delle domande ed elaborazioni multimediali differenti possono produrre totali fatturati diversi a parità di input aziendale. Le cifre escludono quote gratuite, abbonamenti alle piattaforme, maggiorazioni regionali o per contesti lunghi, nuovi tentativi, generazione successiva e revisione da parte del personale.
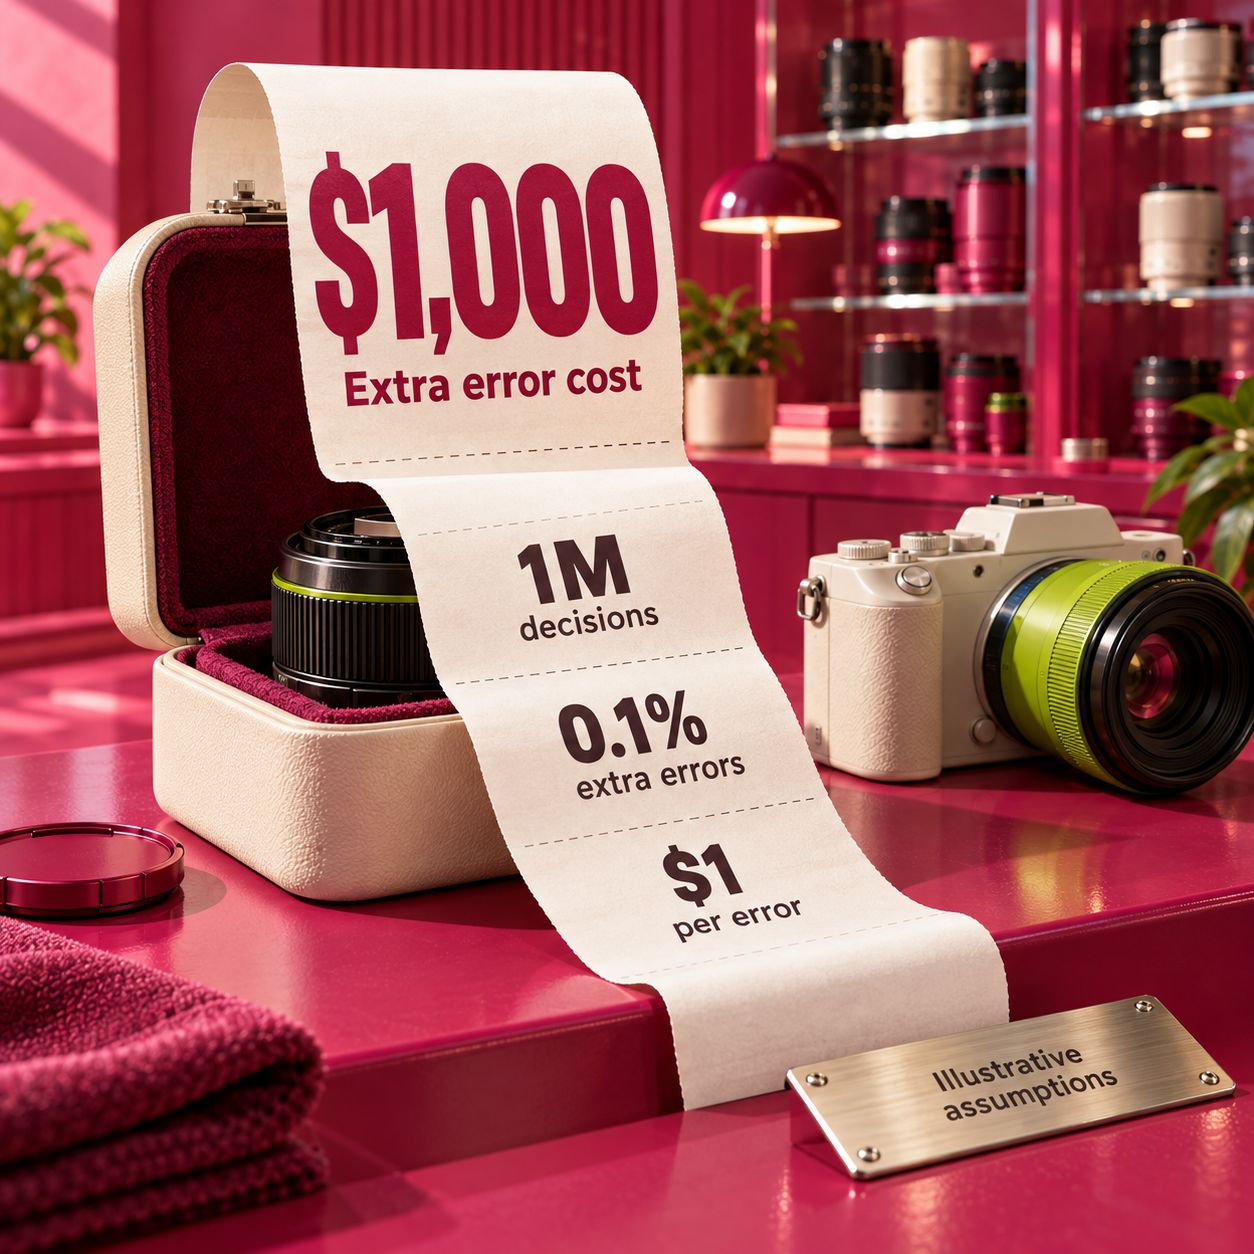
Ipotizziamo ora che un candidato produca 0.1 punti percentuali di errori in più, e che gestire ogni errore aggiuntivo costi $1. Su un milione di decisioni, significa 1,000 errori in più e $1,000 di costi aggiuntivi. Sono ipotesi illustrative, non tassi di errore misurati né un prezzo di mercato del tempo del personale. Mostrano perché conviene ottimizzare le decisioni accettate, non soltanto il prezzo dei token.
Un ragionamento simile vale per l'esecuzione su infrastruttura propria. Con un budget aggiuntivo di $100 al mese per l'infrastruttura, per pareggiare la tariffa base di Perplexity di $0.02 per milione servirebbero cinque miliardi di token di input al mese, prima di considerare la gestione o le differenze di qualità. I $100 sono un'ipotesi, non un preventivo per una GPU. Disporre già di hardware inutilizzato può cambiare il calcolo; mantenere i dati in locale o supportare un prodotto offline può giustificare la scelta anche senza risparmiare sui token.
Misurate la fatturazione sul carico reale prima di fare proiezioni. Per esempio, il servizio gestito d1, distinto dagli altri prodotti Liquid, conteggia nuovamente per ogni domanda il relativo testo e le immagini fornite. Inviare più domande in un'unica chiamata HTTP non significa quindi pagare una sola volta per gli elementi da valutare. Questa regola di fatturazione non attribuisce una tariffa in dollari ai checkpoint aperti. Spiegazione della fatturazione Liquid
Quale modello conviene portare in produzione?
Per lo smistamento ordinario, valutate prima Perplexity se l'obiettivo è ridurre il costo di un servizio gestito. Partite da Clef-flash quando rimanere in Workers semplifica l'applicazione. A far cambiare la scelta è la compatibilità del candidato con il ritmo delle richieste, la lunghezza degli input e i limiti misurati di smistamenti errati e revisioni. Né una tariffa inferiore né una piattaforma familiare compensano la perdita delle informazioni che determinano la coda corretta.
Per la classificazione, privilegiate il candidato che rispetta la vostra tassonomia anche negli esempi ambigui. Microsoft-Decision-1 è una scelta naturale da valutare per Foundry; Perplexity è il candidato gestito orientato al prezzo. Verificate se un commento possa appartenere a più temi. Una domanda a scelta singola impone un solo vincitore: un problema con più etichette va quindi scomposto in verifiche separate o rappresentato in altro modo con una scelta esplicita.
Per i controlli sugli agenti, scegliete un ambiente che sapete gestire in modo affidabile e mantenete nel codice l'autorità sulle azioni. Strands merita una valutazione per un componente locale; Microsoft o OpenAI possono adattarsi a un'integrazione gestita già consolidata. Il modello può fornire una stima sull'azione proposta. L'applicazione deve far rispettare separatamente i permessi, le regole di spesa e le operazioni consentite.
Per l'esecuzione sul dispositivo, partite da d1-3B per testo e immagini e da d1-omni-600M per un esperimento vocale circoscritto. Strands è un'altra opzione locale quando la licenza e la procedura di addestramento consultabile sono più adatte al progetto. In questo caso, dispositivo, preprocessing dell'input e uso commerciale consentito determinano la scelta prima del confronto fra prezzi dei servizi gestiti.
Per decisioni su audio e video in un'applicazione gestita, valutate Clef-omni. Il modo in cui tratta i contenuti multimediali è una differenza sostanziale. Un modello testuale più economico diventa un'alternativa solo aggiungendo consapevolmente una fase di preprocessing e verificando quali informazioni vadano perse in quel passaggio.
Se cercate un secondo fornitore, decidete da quale guasto deve proteggervi. Due ID modello dietro lo stesso gateway dipendono comunque da quel gateway. Anche una soluzione locale di riserva fallisce se, per recuperare l'input, dipende dallo stesso servizio a monte non disponibile. Disegnate l'intero percorso della richiesta e isolate la dipendenza alla cui interruzione volete resistere.
Migrare una decisione prima dell'intero flusso di lavoro
La sostituzione riesce quando conserva il contratto decisionale dell'applicazione, non quando restituisce JSON valido. Mantenete stabili i nomi delle code, il significato dei criteri di valutazione e il comportamento di ripiego mentre adattate i campi specifici del fornitore. Così le divergenze si possono esaminare senza confondere un cambio di modello con un cambio di regole.
Fissate la decisione e gli elementi da valutare
Scegliete una chiamata esistente, per esempio l'assegnazione della coda a un nuovo ticket di assistenza. Registrate le etichette consentite, la versione delle regole, i campi di input e le condizioni che rendono insufficienti le informazioni. Nel set etichettato includete casi ambigui e fuori ambito, non soltanto esempi ovvi.
Adattate l'interfaccia con il fornitore
Mappate esplicitamente gli elementi da valutare, le definizioni delle domande e il codice che legge le risposte. OpenAI usa un campo di input e un array di domande con nome; gli esempi documentati di Perplexity e Microsoft usano stato e domande identificate da chiavi. Anche il confezionamento delle immagini cambia. Verificate tutto nella guida nativa del produttore, senza presumere che nomi simili delle primitive implichino formati di trasmissione identici.
Affiancate il candidato al sistema attuale
Lasciate il controllo al flusso esistente mentre il candidato si limita a registrare una risposta. Confrontate decisioni errate accettate, passaggi ad altri operatori o sistemi, richieste fallite, utilizzo fatturato e tempi delle risposte più lente. Fornite gli stessi elementi a entrambi i modelli, così un cambiamento nel preprocessing non sembrerà un miglioramento del modello.
Definite soglie per questo modello e questo compito
Una soglia di Jev non è trasferibile solo perché un'altra API restituisce una probabilità o un campo chiamato confidence. Verificate di nuovo, su esempi etichettati, il rapporto fra punteggi e correttezza osservata. Prevedete un percorso di revisione separato per informazioni mancanti, guasti del fornitore e rifiuti.
Procedete gradualmente e rendete semplice il ritorno indietro
Modificate soltanto il flusso scelto. Conservate la configurazione del modello precedente e un modo per ripristinarla. Ripetete la valutazione quando cambiano il checkpoint, l'alias del modello, la formulazione delle domande o il preprocessing: ciascuno di questi elementi può modificare le decisioni accettate dalle soglie.
Se partite da Jev Router invece che da una chiamata decisionale diretta a Jev, chiarite prima quali componenti vengono fatturati. Il servizio di routing e il modello a valle che seleziona sono voci di spesa diverse. La guida ai prezzi di Jev Router spiega la distinzione: un modello decisionale economico non rende gratuita la risposta generata.
Le scelte da evitare
Evitate di migrare a Microsoft-Decision-1 per risparmiare sui token se l'unico problema è l'attuale tariffa base di Jev. Le tariffe pubblicate coincidono. Può comunque essere una buona scelta per la piattaforma o la qualità, ma la motivazione è diversa.
Evitate Clef-flash gestito per un archivio di informazioni senza limiti di lunghezza, a meno di controllare il budget di input. Una risposta valida dopo il troncamento può nascondere il fatto che un'informazione decisiva non sia mai arrivata al modello. Usate un carico che rientri nei limiti oppure valutate un percorso con un contesto adeguato.
Evitate d1-omni-600M per analizzare registrazioni lunghe senza vincoli sulla sola forza della parola omni. Il perimetro documentato del parlato, il taglio delle clip e lo stato sperimentale sono elementi sostanziali. In questa selezione, Clef-omni è il candidato gestito quando servono contenuti multimediali più ricchi, entro i suoi limiti.
Evitate di usare pesi aperti come sinonimo di servizio di produzione gratuito. Liquid ha una licenza condizionata, la configurazione di riferimento Perplexity richiede molta memoria e Strands lascia a voi l'hosting. Scaricare un modello è l'inizio di un impegno operativo.
Evitate un clone non verificato come soluzione di emergenza. Un nome simile o un endpoint apparentemente compatibile non dimostrano l'esistenza di un produttore identificabile, una licenza utilizzabile, un ambiente di esecuzione mantenuto o un percorso indipendente in caso di guasto. L'esclusione dipende dalla mancanza di riscontri, non dall'idea che tutti i progetti della community funzionino male.
Domande frequenti
Esistono alternative a Jev gratuite?
Cloudflare offre una quota giornaliera gratuita condivisa di Workers AI. Diverse alternative pubblicano anche pesi scaricabili, ma il calcolo resta a vostro carico e occorre rispettare la licenza. La documentazione del servizio gestito Liquid elenca separatamente il modello solo testo d1:free, senza indicare una quota nella pagina verificata per questo articolo. Un accesso gratuito non garantisce un deployment in produzione a costo zero. Guida al modello gestito Liquid
Quali alternative a Jev hanno pesi aperti?
Per la famiglia Clef, il checkpoint Perplexity indicato, i due checkpoint d1 di Liquid e Strands Decider, i produttori pubblicano modalità di accesso ai pesi. Clef, Perplexity e il checkpoint Strands indicato usano Apache-2.0; Liquid usa LFM Open License v1.0 con una condizione per l'uso commerciale. In questo confronto, OpenAI Decisions e Microsoft-Decision-1 sono opzioni gestite, senza una licenza dei pesi aperti fornita dalle pagine dei produttori citate.
Quale alternativa a Jev conviene provare per prima?
Valutate prima Perplexity per una tariffa di input gestito più bassa, Clef-flash per un'applicazione Workers esistente, Microsoft-Decision-1 per Foundry e OpenAI Decisions per un'integrazione OpenAI. Per l'esecuzione locale, partite da d1-3B per testo e immagini, d1-omni-600M per un esperimento vocale circoscritto o Strands per un componente dell'agente di cui poter esaminare i dettagli. La scelta finale dipende dalla valutazione sul vostro carico di lavoro.
Da cosa partire lunedì
Scegliete la chiamata decisionale il cui responsabile sa spiegare che cosa rende costoso un errore. Individuate un candidato in base al motivo che vi interessa: prezzo, piattaforma, input multimediali o esecuzione locale. Affiancatelo a Jev usando gli stessi elementi di valutazione, poi passate al nuovo modello solo se gli errori accettati, il carico di revisione e i tempi massimi di risposta sono soddisfacenti. Tenete pronta la configurazione originale finché il nuovo percorso non avrà dimostrato la propria affidabilità sul lavoro ordinario.
Usate la checklist di audit dei flussi di lavoro aziendali con l'AI per individuare la prima decisione da cambiare.
- Pubblicato
- Categoria
- Build
- Lingua

OpenAI Decisions API: come smistare ticket e valutare azioni
Come usare OpenAI Decisions API per smistare ticket e valutare azioni: esempi di richieste, gestione dei rifiuti, prezzi, limiti e criteri per migrare.11 ott 2026Build
Claude Code mobile: guida a Remote Control
Usa Claude Code dal telefono con Remote Control: configurazione da CLI, VS Code o Desktop, requisiti, notifiche e soluzioni agli errori di accesso.9 ott 2026Build
Cursor app: come controllare gli agenti da iPhone
Configura Cursor su iPhone per guidare gli agenti del portatile: abbinamento, requisiti, costi e differenze rispetto agli agenti cloud, Claude Code e Codex.9 ott 2026Build
Firecrawl pricing 2026: costi reali di pagine, JSON e crawl
Quanto costa Firecrawl? Confronta piani, crediti e fatture per scraping JSON e crawl settimanali, inclusi errori, ricariche e alternative a pari volume.9 ott 2026Build
Claude Code vs Copilot: prezzi, limiti e scelta nel 2026
Claude Code vs Copilot: confronta prezzi, limiti, modelli e controlli per i team. Scopri quale scegliere per l’editor, il terminale o per usarli insieme.8 ott 2026Build
Agenti AI in produzione: quando scegliere LangGraph o CrewAI
Confronta LangGraph e CrewAI per creare agenti AI: stato, memoria, approvazioni, MCP e costi di hosting sullo stesso workflow di ricerca e scrittura.7 ott 2026Build
Server MCP in Python: guida pratica dal test all'hosting
Crea un server MCP in Python per consultare gli ordini, testalo con Inspector e collegalo a Claude Code e Cursor. Poi passa a HTTP con autenticazione.7 ott 2026Build