Аналоги Jev в 2026 году: что выбрать для API и локального запуска
Сравниваем аналоги Jev: Perplexity, OpenAI, Microsoft, Clef, Liquid d1 и Strands. Цены в USD, лицензии, ограничения API и выбор модели для локального запуска.
Опубликовано
 Автор Omid Saffari






Если вы ищете аналоги Jev, чтобы сократить расходы на облачный API, первым стоит проверить Perplexity с тарифом $0.02 за миллион входных токенов. Clef-flash лучше впишется в приложение, которое уже работает на Cloudflare, а Liquid AI d1-3B — отправная точка для локального принятия решений по изображениям. При миллионе решений в месяц и 1,000 оплачиваемых входных токенов на каждое переход с Jev на Perplexity сэкономит всего $22 по базовому тарифу на входные токены. Выбирайте модель, которая сохраняет долю ошибочных решений, принятых приложением, на допустимом уровне и работает там, где нужно вашему приложению.
Цены, лицензии и документация по развёртыванию проверены 11 октября 2026 года. Все приведённые тарифы взяты у разработчиков. Месячные суммы рассчитаны на оговорённых допущениях: это не счета по итогам испытания в рабочей системе. Для этого сравнения модели не запускались.
Аналоги Jev: какую модель выбрать под свою задачу?
Сначала определите ограничения по развёртыванию, затем сравнивайте качество на собственных задачах. Облачный API означает, что за работу модели отвечает провайдер. Открытые веса позволяют получить файлы модели и самостоятельно выполнять инференс на условиях её лицензии. Бесплатные вычислительные ресурсы к ним не прилагаются.
Облачные тарифы не отражают стоимость инференса на собственной инфраструктуре. Для скачиваемых моделей Liquid и Strands пометка «не опубликован» означает, что на страницах разработчиков нет фиксированного тарифа за входные токены. Оборудование, электричество, хостинг и эксплуатацию всё равно придётся оплачивать. Подробности о лицензиях и версиях весов приведены в разделах о моделях.
Текущая точка отсчёта у TypeSafe — Jev 1.13, идентификатор модели jev-1.13.0, по цене $0.042 за миллион входных токенов; выходные токены бесплатны. Модель принимает текст и структурированный текст, например JSON, но не изображения, аудио или видео. Поэтому опубликованный входной тариф Microsoft совпадает с Jev; базовый тариф OpenAI выше, а Perplexity и Clef-flash дешевле. Каталог моделей TypeSafe
В существующей интеграции с Jev уже есть ценная основа: определение решений, которые должно принимать приложение. Сохраните его. Если обращения по оплате должны попадать в финансовый отдел, а проблемы с доступом к аккаунту — в поддержку, сначала проверьте замену на этих случаях. Громкий результат бенчмарка не должен определять выбор раньше такой проверки.
Как отбирались модели
В подборку вошли модели с API, карточкой или репозиторием, которые поддерживает сам разработчик, и с документацией, достаточной для выбора способа развёртывания. Клоны от сообщества без подтверждённой страницы разработчика в сравнение не включены. Здесь представлены шесть разработчиков и семь вариантов выбора: семейство Cloudflare собрано в одном разделе, а двум моделям Liquid нужны отдельные рекомендации.
Критерии практические: нужные типы входных данных, облачный или локальный запуск, лицензия на веса, документированное ограничение, способное сорвать вашу задачу, и стоимость пригодного решения. Пригодным считается решение, которое приложение может принять без дорогого исправления или лишней эскалации.
Первым идёт наиболее перспективный кандидат для снижения облачного тарифа, затем — варианты под конкретные платформы и локальный запуск. Это не рейтинг точности. Разработчики тестируют модели на разных наборах данных, оборудовании, длинах входа и сетевых маршрутах. Все приведённые показатели производительности — данные разработчиков. Ни один из них не доказывает, что модель обойдёт Jev на ваших обращениях.
Важно учитывать и границы задачи. Эти модели выбирают из заданных исходов или оценивают их. Если нужен текст ответа клиенту или объяснение, этап генерации следует сохранить. Этот более широкий выбор разобран в нашем сравнении Jev и GLM-5.3-Flash.
Семь вариантов для выбора
1. Perplexity pplx-decider-v1.1-27b: первый кандидат на снижение облачного тарифа
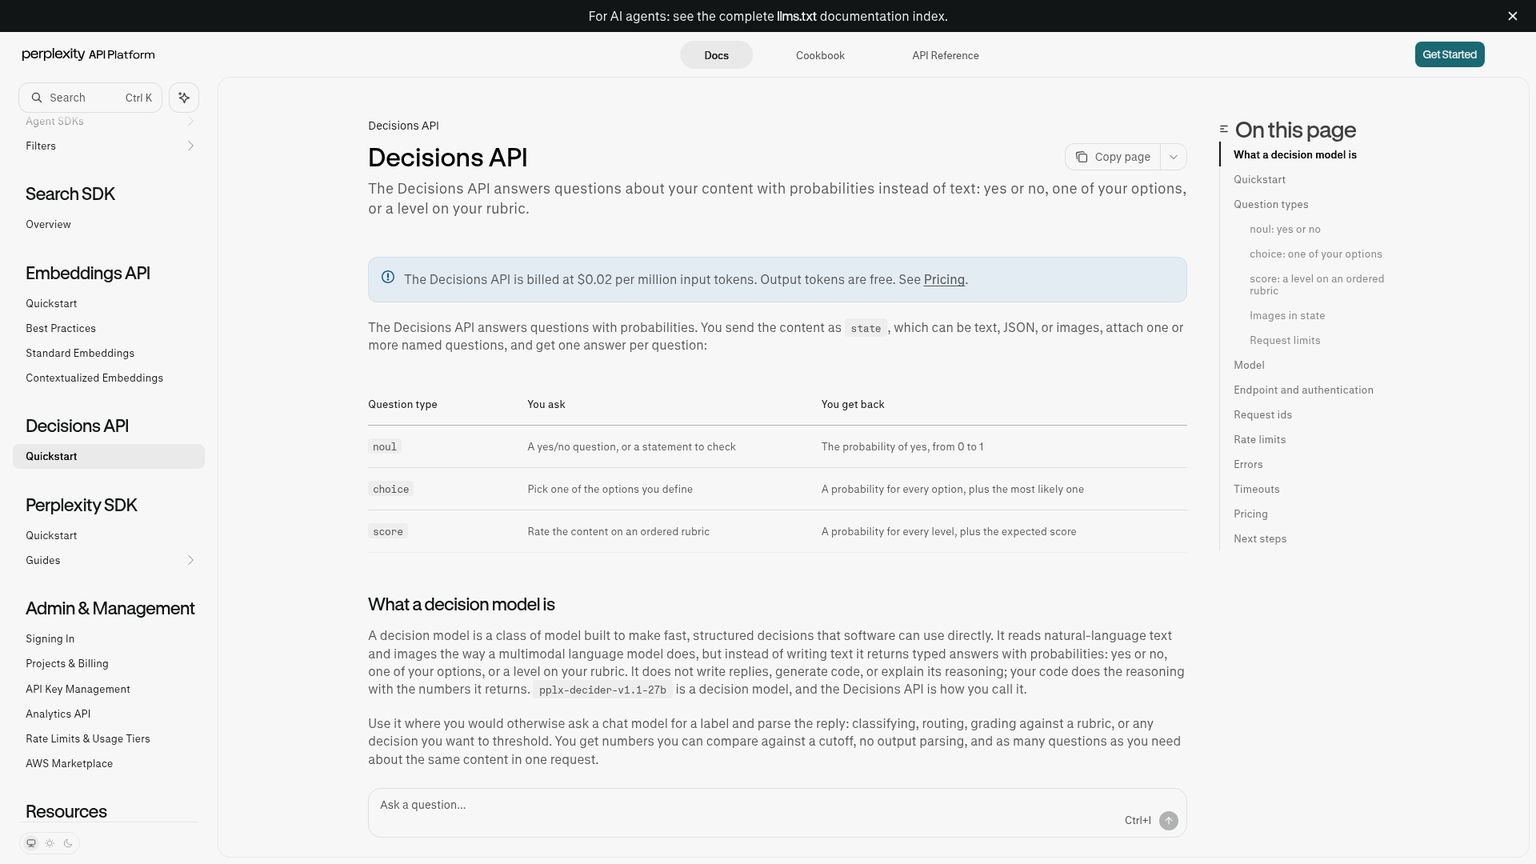
Perplexity pplx-decider-v1.1-27b — модель для принятия решений, доступная через облачный Decisions API Perplexity и в виде скачиваемых весов. Именно её я проверил бы первой для обычной маршрутизации обращений или массовой разметки, если задача — просто сократить расходы на входные токены Jev. В этой подборке у неё самый низкий опубликованный облачный тариф. Рекомендация меняется, если ограничения по запросам, требования к локальному запуску или доля ошибок не подходят вашей нагрузке.
Для каких задач: Более дешёвые облачные маршрутизация, разметка и оценка по заданным критериям.
Главное отличие: Прямой API и отдельный вариант развёртывания с открытыми весами.
Цена: $0.02 за 1 млн входных токенов; выход бесплатен; платы за отдельный запрос нет.
Бесплатный пробный доступ: В указанном руководстве Decisions не описан.
Входные данные и среда: Текст, JSON и встроенные в запрос изображения через API Perplexity; оборудование с CUDA для предоставленной локальной реализации.
Лицензия: Apache-2.0 для скачиваемых весов; облачный доступ остаётся отдельной услугой. Руководство по API, лицензия на веса
Главное ограничение облачного варианта — пропускная способность: Perplexity указывает 10 запросов в секунду на организацию на всех тарифах. По общим исходным данным можно задать до 128 вопросов, а суммарный вход должен быть меньше 262,144 токенов. Ограничения запросов Набор отдельных обращений клиентов не становится запросом с общими данными лишь потому, что каждому обращению нужна метка. Не объединяйте несвязанные случаи так, чтобы менялся смысл задачи. Ограничения облачного сервиса
При таком лимите миллион отдельных запросов займёт не менее 27.8 часа, даже при идеальном планировании и без повторных попыток. Это расчётная нижняя граница, а не замер скорости. Ночная обработка накопленных записей и небольшой равномерный поток обращений предъявляют совсем разные требования к одному и тому же дешёвому API.
У самостоятельного развёртывания есть другое ограничение. Конфигурация разработчика требует примерно 49 GiB для весов плюс рабочую память, а реализация prepare отклоняет совокупный вход длиннее 8,192 токенов. Необходимо сохранить настройки механизма внимания и калибровки, с которыми проводилась оценка. В карточке также остаётся упоминание доступа к закрытому репозиторию после аутентификации. Прежде чем планировать локальное внедрение, убедитесь, что ваш аккаунт позволяет скачать веса. Карточка модели Perplexity
Не переносите лимит облачного контекста в требования к локальному развёртыванию. Локальную сборку нужно оценивать отдельно: с её фактической предобработкой, расходом памяти и версией модели. Иначе резервный вариант может отказать именно на тех длинных записях, которые вызвали проблемы у основного сервиса.
- Самый низкий опубликованный облачный тариф на входные токены среди этих альтернатив.
- Текст и изображения можно передавать в одном запросе на принятие решения.
- Веса под Apache-2.0 позволяют выйти за пределы облачного сервиса.
- Лимит запросов на организацию может мешать обработке накопленных данных или всплесков трафика.
- Предоставленная локальная конфигурация требует большого объёма памяти GPU.
- Лимиты входных данных в облаке и в эталонной локальной реализации сильно различаются.
Для первого сравнения выберите достаточно узкую задачу, чтобы ошибки можно было разобрать вручную.
Сохраните существующие правила распределения по очередям
Возьмите метки и пограничные случаи из своей реализации на Jev. Для обращений, которые не укладываются в эти определения, оставьте явный исход «другое» или «на проверку». В нашем руководстве по маршрутизации обращений с Jev описан базовый процесс для сравнения.
Используйте собственный формат запросов Perplexity
Укажите модель
pplx-decider-v1.1-27bи отправьтеstateвместе с именованнымиquestionsвPOST /v1/decisions. Используйте вопрос типаchoice, а вcriteriaопишите каждую очередь. Форматы запросов и ответов сверяйте с официальным справочником API.Записывайте ответы, не меняя назначения обращений
Извлеките ответ по имени вопроса. Рядом с текущим результатом Jev сохраняйте выбранную метку, возвращённые вероятности, оплачиваемый объём входных данных и статус запроса. Отделяйте сбои провайдера от корректных решений с низкой уверенностью.
Задайте условия перехода до того, как увидите победителя
Определите допустимую долю неверных назначений, объём ручной проверки и предельное время ответа. Переводите кандидата в рабочий режим, только если он выполняет эти условия на репрезентативном наборе размеченных задач. Одного снижения расходов на входные токены недостаточно.
2. Cloudflare Clef, Clef-flash и Clef-omni: выбирайте по входным данным
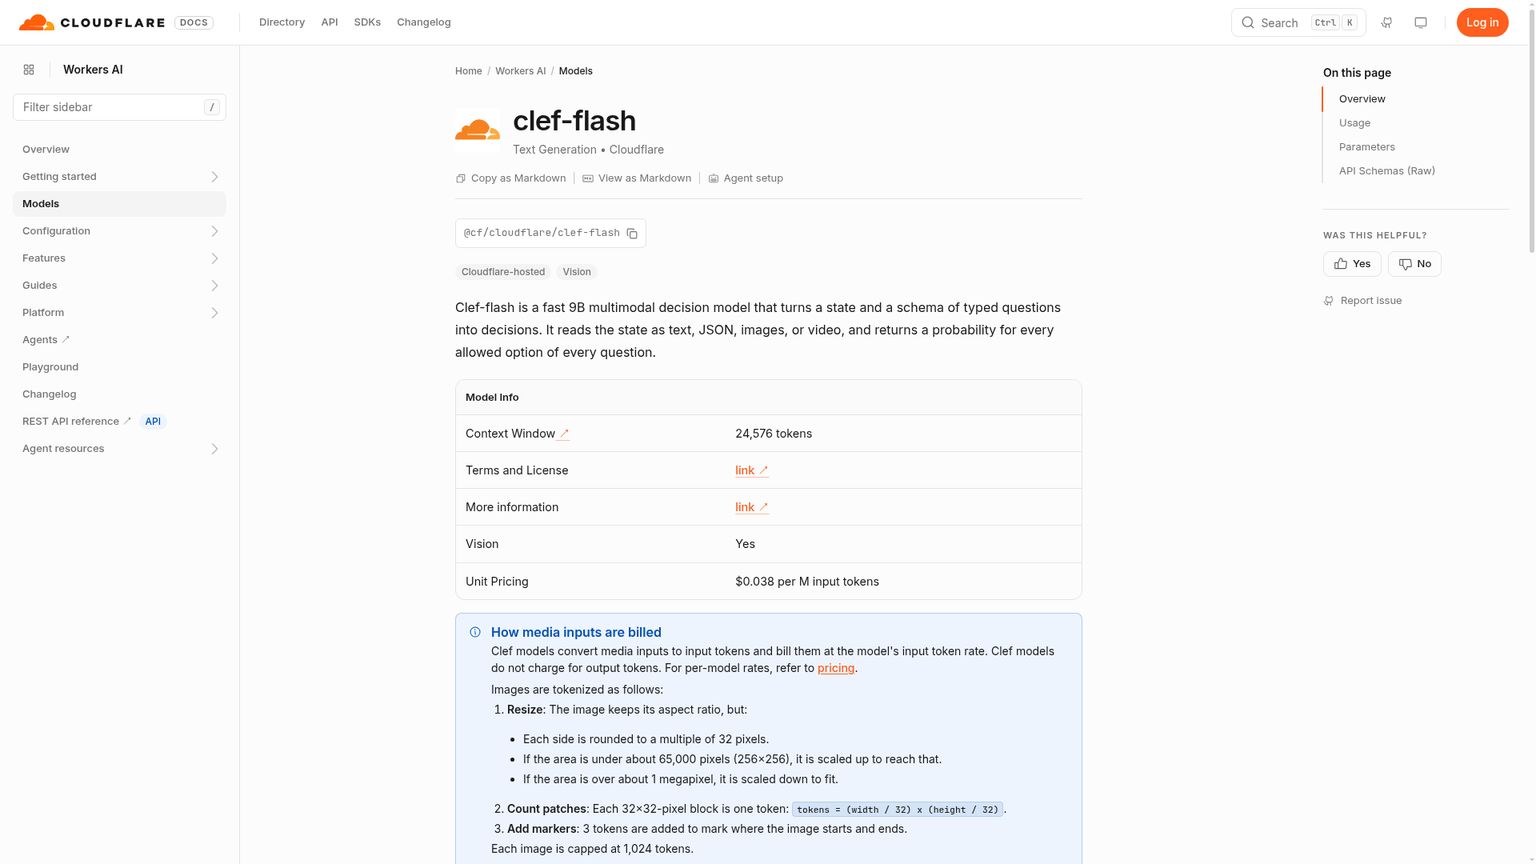
Cloudflare Clef-flash — практичный первый кандидат, если решение должно приниматься внутри уже работающего приложения Workers. Семейство сочетает облачный запуск в Workers AI и веса под Apache-2.0: можно проверить управляемый сервис и сохранить возможность позже перенести модель на свою инфраструктуру. Выбирайте вариант по данным, которые ему предстоит анализировать, и ограничениям облачного эндпоинта. Самая дешёвая модель семейства не заменит поддержку аудио или достаточный объём контекста.
Для каких задач: Маршрутизация и классификация рядом с приложением Workers.
Главное отличие: Привязки Workers AI и доступ через REST, а также скачиваемые веса.
Цена: Clef-flash — $0.038; Clef — $0.240; Clef-omni — $0.150 за 1 млн входных токенов.
Бесплатный пробный доступ: У Workers AI есть общая ежедневная бесплатная квота, а не отдельный безлимитный пробный доступ к Clef.
Входные данные и среда: Clef и Clef-flash обрабатывают текст, JSON, изображения и кадры видео; Clef-omni также принимает непосредственно аудио и видео со звуком. Запуск в облаке Workers AI или в собственном стеке инференса.
Лицензия: Веса всех трёх моделей распространяются под Apache-2.0. Тарифы Workers AI, первоначальный релиз, карточка Clef-omni
Clef и Clef-flash вышли 1 октября 2026 года; обновление от 9 октября добавило Clef-omni и изменило условия выбора облачных моделей. Самое существенное изменение: у Clef-flash теперь контекстное окно на 24,576 токенов в облаке. Текст исходных данных может обрезаться, чтобы уложиться в этот предел. Поэтому из длинной истории инцидента могут исчезнуть значимые сведения, хотя приложение получит ответ. Актуальная документация Clef-flash, октябрьское обновление
Поэтому для первой проверки flash лучше подходит короткая форма обращения, чем архив переписки без ограничения длины. Заранее отведите место во входных данных и для правил распределения по очередям, и для решающих сведений от клиента. Если вы сокращаете запись перед отправкой, оценивайте именно сокращённую версию, а не идеальную полную расшифровку.
Cloudflare Clef — более крупный вариант для текста и изображений с облачным контекстом на 65,536 токенов. Более высокая цена оправдывает рассмотрение модели, если ваша оценка показывает полезное улучшение или облачного контекста flash недостаточно. Сам по себе размер модели не гарантирует выигрыша в качестве. Документация Clef
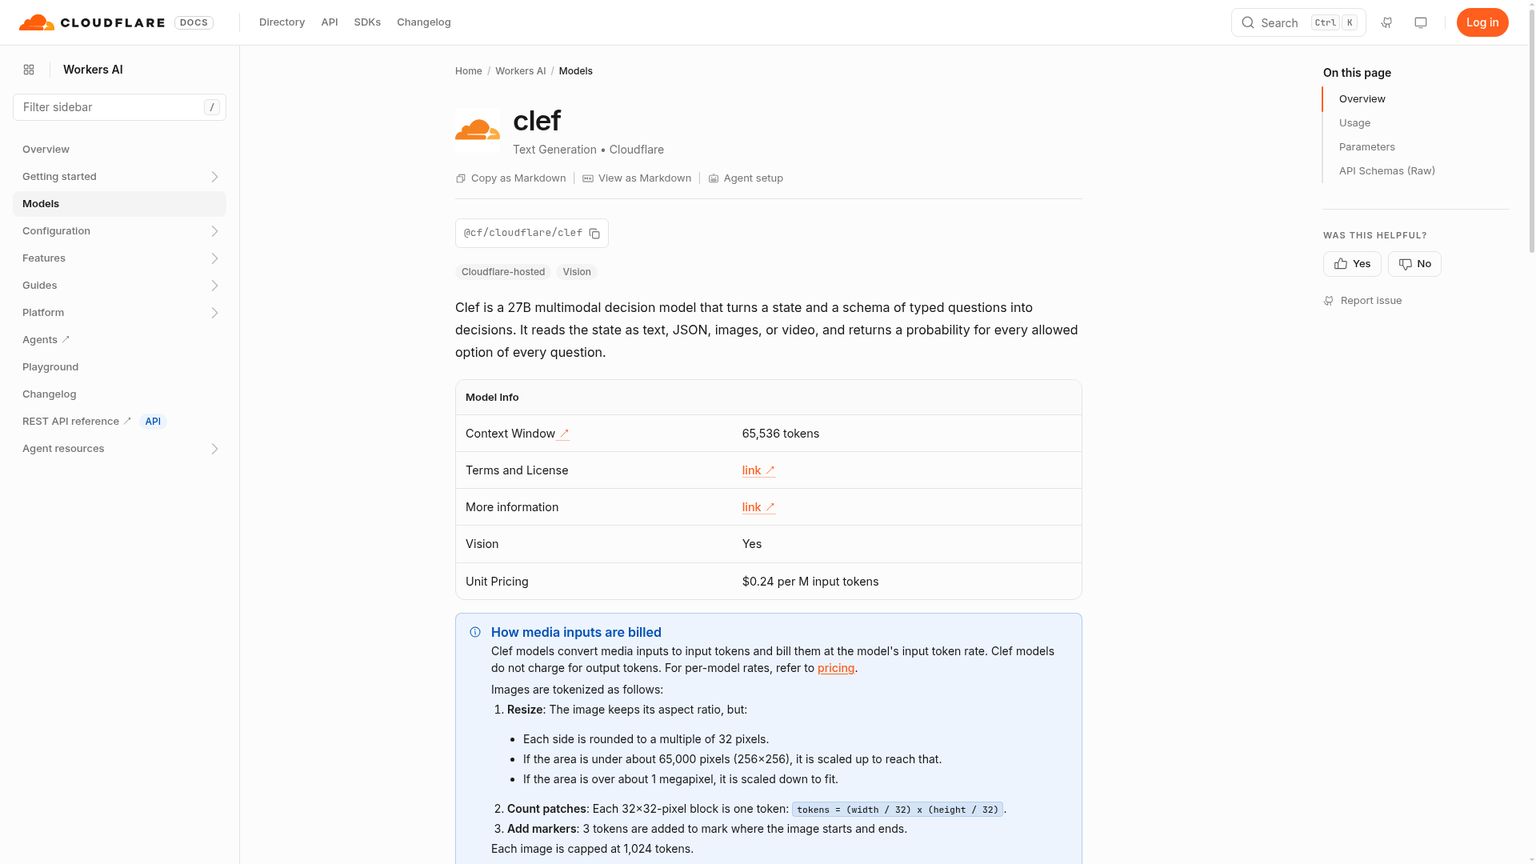
Cloudflare Clef-omni стоит рассматривать, когда среди исходных данных есть звук. Например, приложению для выездного обслуживания может понадобиться классифицировать запись работы оборудования вместе с описанием техника. Здесь принципиален прямой приём аудио и видео: одного извлечения неподвижных кадров может не хватить для ответа. В документации указан контекст на 64,000 токенов, а также отдельные ограничения на медиа: аудиозаписи до 300 секунд, видео до 60 секунд, плюс лимиты по количеству и объёму в байтах. Документация Clef-omni
Открытые веса не означают, что omni можно развернуть на телефоне. В эталонной конфигурации Cloudflare указано около 64 GB памяти GPU для базовой части модели в bfloat16. Это требование к ресурсам для запуска, которое нужно заложить в бюджет, а не облачная плата за токены. Карточка модели Clef-omni
Бесплатная квота Cloudflare в 10,000 Neurons в день относится к общим ресурсам Workers AI; Neurons — единица тарификации вычислений на этой платформе. Для расхода сверх квоты требуется Workers Paid. Считайте токенные тарифы платой за модель, а в бюджет развёртывания включайте также остальные расходы на подписку Workers и работу приложения. Правила квот и оплаты
- Встроенная интеграция с Workers избавляет от необходимости добавлять отдельную платформу для приложения.
- Веса под Apache-2.0 сохраняют возможность самостоятельного развёртывания.
- Семейство покрывает задачи от обычной маршрутизации текста до решений по аудио и видео.
- Облачный контекст Clef-flash меньше, чем можно заключить из ранних описаний релиза.
- Обрезка длинных исходных данных может удалить сведения, от которых зависит решение.
- В документированной конфигурации самостоятельный запуск Clef-omni требует большого объёма памяти.
3. Microsoft-Decision-1: разметка и контроль действий агентов в Foundry
Microsoft-Decision-1 — облачная модель оценки решений для разработчиков, уже работающих в Microsoft Foundry. Её тариф $0.042 за миллион входных токенов совпадает с текущим опубликованным тарифом Jev. Оценивать её стоит по удобству работы в вашей платформе и качеству на задаче, а не ради прямой экономии на токенах. Разумная первая задача — разметка обратной связи или выбор следующего шага агента: продолжить, повторить попытку либо передать вопрос дальше. Документированный запрос принимает текст или JSON; по базовому семейству модели нельзя делать вывод о поддержке изображений. Анонс Microsoft, руководство Foundry
Для каких задач: Разметка, расстановка приоритетов и контроль действий агентов в Foundry.
Главное отличие: Документированный путь развёртывания в Foundry с Entra ID или ключом API.
Цена: $0.042 за 1 млн входных токенов; выход бесплатен.
Бесплатный пробный доступ: На указанных страницах модели не описан.
Входные данные и среда: Текст или JSON; Microsoft Foundry и OpenRouter.
Лицензия: Облачный сервис; на этих страницах разработчика лицензия на скачиваемые веса не опубликована. Цена и доступ у Microsoft, требования к развёртыванию
В публикации Microsoft от 9 октября 2026 года базовой моделью названа Qwen3.5-9B. Переход на другие базовые модели обсуждается как план на будущее, а не как доступная сегодня архитектура. Открытость базовой модели также не даёт права скачивать дообученную модель Microsoft. Пока Microsoft не выпустит веса отдельно, это кандидат для облачного использования. Источник об архитектуре
Практическое преимущество в том, что оценку можно провести внутри платформы, которую приложение уже использует. Допустим, сейчас универсальная модель размечает отзывы клиентов, а менеджер продукта читает еженедельный отчёт. Определите темы и исход «без категории», сравните обе системы на одних отзывах и проверьте, не получают ли расплывчатые комментарии неоправданно точные метки. Даже идеально оформленная метка может исказить отчёт.
Microsoft заявляет о самой высокой средней точности в своём сравнении по 36 бенчмаркам. Это данные разработчика; в сравнении задержек Microsoft-Decision-1 измерялась через Foundry в том же регионе. Условия существенны: они не определяют ни время ответа из вашего приложения, ни точность на вашей собственной системе категорий. Описание оценки Microsoft
Требования к внедрению вполне конкретны. Нужны проект Foundry, права на развёртывание модели и способ аутентификации: одной замены строки с именем модели в постороннем SDK недостаточно. Руководство описывает числовые решения, а не текстовые объяснения. Если проверяющему нужно обосновать метку, сохраняйте подтверждающие сведения и формируйте объяснение отдельным шагом. Настройка Foundry и формат ответа
- Вписывается в существующие процессы управления доступом и развёртыванием Foundry.
- Поддерживает бинарные решения, выбор вариантов и оценку по упорядоченной шкале.
- В собственном анонсе Microsoft прямо указан тариф на входные токены.
- Экономии относительно базового входного тарифа Jev нет.
- Страницы разработчика не подтверждают возможность развёртывания с открытыми весами.
- Документированный вход — текст и JSON; обещания мультимодальной замены нет.
4. OpenAI Decisions API: для приложений с готовой интеграцией OpenAI
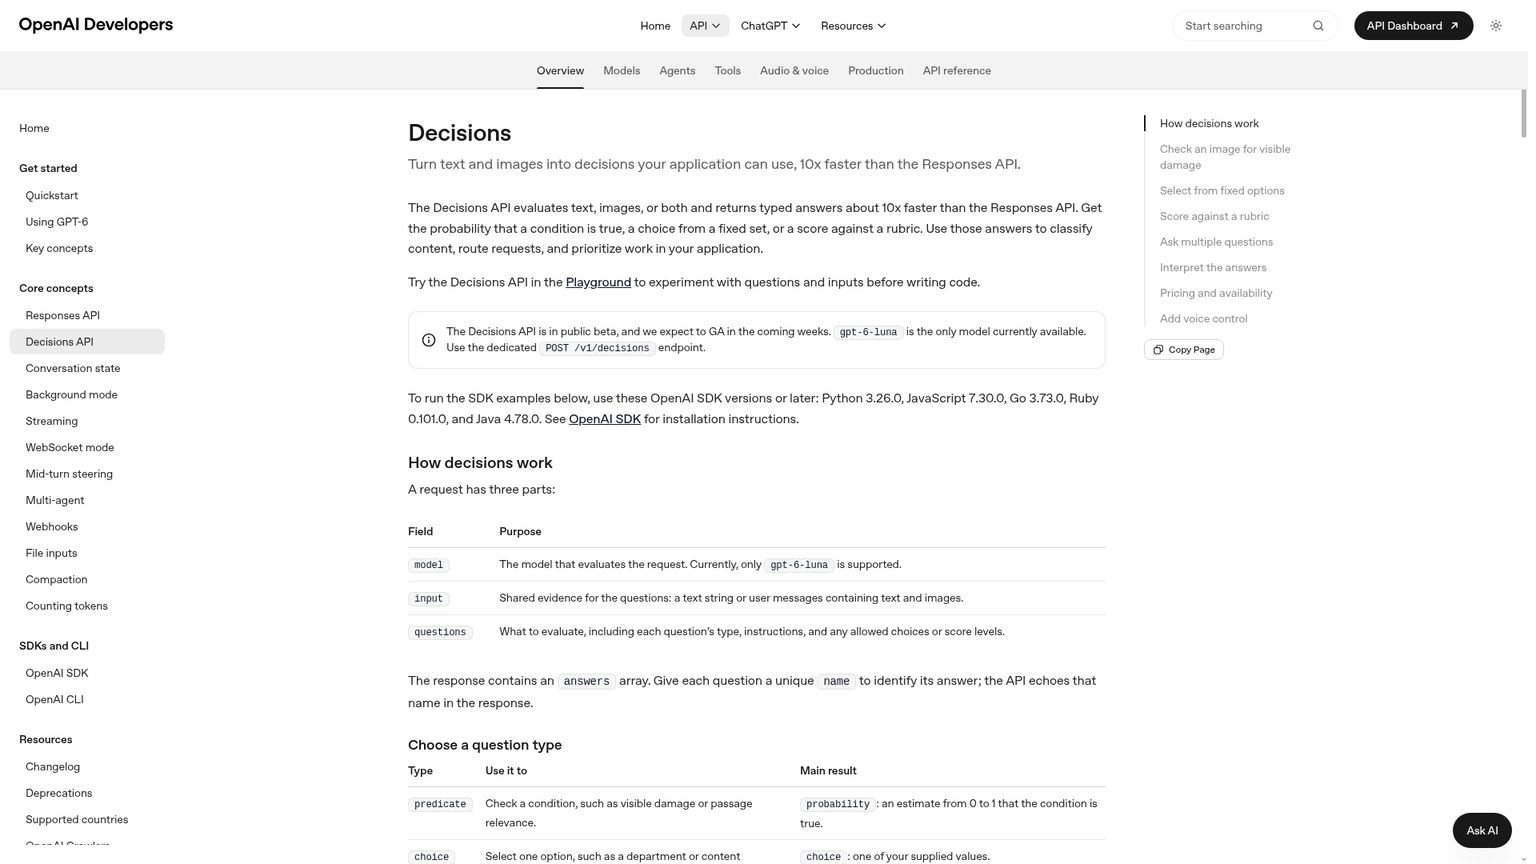
OpenAI Decisions API превращает текст и изображения в типизированные ответы с помощью gpt-6-luna. Это разумный кандидат, если приложение уже использует OpenAI и в той же интеграции нужны классификация, выбор из ограниченного набора вариантов или оценка по критериям. Базовый тариф $0.10 за миллион входных токенов делает этот компонент принятия решений дороже Jev. Выбирайте его, если разницу оправдывают удобство интеграции или измеренное качество на вашей задаче. Руководство OpenAI Decisions
Для каких задач: Метки по тексту и изображениям и проверки перед действиями в существующем приложении на OpenAI.
Главное отличие: Ответы predicate, choice и score через выделенный эндпоинт.
Цена: Базовый тариф $0.10 за 1 млн входных токенов; платы за выход, чтение и запись кэша нет. Действуют региональные надбавки и повышающие коэффициенты для входных данных с длинным контекстом.
Бесплатный пробный доступ: В руководстве Decisions не описан.
Входные данные и среда: Текст и встроенные в запрос изображения через облачный эндпоинт POST /v1/decisions.
Лицензия: Доступ к облачному API; руководство не содержит лицензии на распространение открытых весов. Актуальное руководство и тарифы
API перешёл в публичную бету 6 октября 2026 года. Учитывайте этот статус при внедрении. Новый API вполне может заслуживать проверки, но прежде чем делать его резервным вариантом, нужно убедиться, что он работает с вашим разбором ответов, обработкой исключений и доступом через аккаунт. Журнал изменений OpenAI
Главное препятствие при миграции — формат запросов и ответов. OpenAI использует input и массив именованных вопросов; тип для ответа «да/нет» называется predicate. Существующий объект вопросов в формате Jev нельзя просто переслать без изменений. Ответ также может содержать отказ, который нужно обрабатывать отдельно от вероятности. Форматы запросов и ответов
Например, в процессе возврата товара можно спросить, видны ли на фотографии повреждения, и выбрать подходящую очередь проверки. Это не устанавливает, кто вызвал повреждение, действует ли гарантия и разрешён ли возврат денег. Для таких отдельных решений нужны другие сведения или фиксированные бизнес-правила.
- Текст и изображения можно оценивать вместе.
- Типизированные ответы избавляют от необходимости извлекать метку из свободного текста.
- Отдельное руководство разграничивает оплату решений и других эндпоинтов моделей.
- Базовый входной тариф выше, чем у Jev и самых дешёвых облачных альтернатив.
- Статус публичной беты нужно учитывать при планировании внедрения.
- Для собственного формата запросов и обработки отказов нужен адаптер.
5. Liquid AI d1-3B: с чего начать локальную обработку текста и изображений
Liquid AI d1-3B — модель принятия решений с открытыми весами для текстовых и графических входных данных, выпущенная 7 октября 2026 года. Среди локальных кандидатов я проверил бы её первой для настольного или периферийного приложения, которому нужно классифицировать и описание, и картинку. Её преимущество — контроль над тем, где выполняется инференс. Это не обещание, что работа собственного GPU обойдётся дешевле очень недорогого облачного API. Релиз Liquid AI
Для каких задач: Локальная классификация изображений, визуальные проверки и маршрутизация текста.
Главное отличие: Скачиваемая модель с опубликованными замерами на локальном оборудовании.
Цена: Тариф за 1 млн входных токенов для этих открытых весов не опубликован. Вычислительные ресурсы нужно закладывать в собственный бюджет.
Бесплатный пробный доступ: Веса можно скачать на условиях лицензии; вычисления оплачиваются отдельно.
Входные данные и среда: Текст, JSON и изображения; примеры разработчика поддерживают CUDA, Apple MPS и CPU через специализированный код Transformers.
Лицензия: LFM Open License v1.0. Карточка модели, лицензия на веса
Модель построена на LFM2.5-VL-3B; в документации указан контекст на 32,768 токенов. Представьте настольный инструмент контроля качества: оператор загружает изображение товара и выбирает заранее заданный вопрос проверки. Локальный запуск позволяет приложению работать без обращения к облачной модели принятия решений, если остальные этапы процесса тоже выполняются локально. При этом всё равно нужно проверять условия съёмки, изменение размера изображения и само определение дефекта. Архитектура и контекст
Liquid сообщает время обработки одного вопроса: 16 мс на Jetson AGX Thor, 26 мс на AGX Orin и 50 мс на Orin Nano. Это замеры разработчика на конкретном оборудовании, а не обещание для вашего объёма входных данных и не сравнение с полным запросом к API через интернет. По ним можно выбрать оборудование для проверки, а затем измерить работу приложения целиком. Таблица замеров Liquid
Лицензия влияет на решение о внедрении. Обе модели Liquid используют LFM Open License v1.0, где условие коммерческого использования ссылается на порог годовой выручки $10 млн. Прежде чем считать, что ваше развёртывание соответствует условиям, прочтите определение юридического лица и раздел 5. Если это условие вас затрагивает, уточните его у Liquid. Не указывайте Apache-2.0 для этой модели в закупочной документации. Текст лицензии
В названиях тоже важно не запутаться. Liquid указывает облачный d1 отдельно от d1-3B и d1-omni-600M. Документация и анонс облачной модели описывают оплату только входных данных, но на проверенных для этого сравнения страницах нет тарифа в долларах за миллион токенов. Тариф и ограничения облачной модели нельзя переносить на скачиваемые версии. Каталог моделей Liquid, руководство по облачному d1
Для продукта, работающего без сети, условие перехода — достаточные качество и скорость модели на реальном целевом устройстве. Тестируйте её с запущенным остальным ПО, реалистичными изображениями и длительной нагрузкой. Успешный одиночный инференс — лишь начало оценки необходимой мощности.
- Решения обрабатываются на оборудовании, которым управляете вы.
- Поддерживаются и текст, и изображения.
- Замеры разработчика указывают конкретное оборудование для проверки на периферии.
- Условия коммерческого использования LFM требуют внимания.
- Запуск сервиса, достаточная мощность и сопровождение среды — ваша ответственность.
- Возможность скачать модель не означает фиксированных или нулевых расходов на инференс.
6. Liquid AI d1-omni-600M: короткие голосовые команды с ограничениями экспериментального релиза
Liquid AI d1-omni-600M — компактная экспериментальная модель того же семейства для текста с изображениями или текста с аудио. Её стоит включить в список кандидатов для устройства, которому нужно различать небольшой набор голосовых намерений. Считать её заведомой заменой любому мультимодальному облачному сервису нельзя. Размер делает локальный запуск интересным, но решающее значение имеют ограничения входных данных и обучения. Пилот с голосовыми командами — гораздо более узкая задача, чем анализ произвольных записей. Статус релиза, карточка модели
Для каких задач: Эксперименты с распознаванием голосовых намерений или решениями по изображениям на маломощных устройствах.
Главное отличие: Компактная модель с открытыми весами и поддержкой аудиовхода.
Цена: Тариф за 1 млн входных токенов для этих открытых весов не опубликован.
Бесплатный пробный доступ: Веса можно скачать на условиях лицензии; расходы на вычисления остаются за вами.
Входные данные и среда: Текст или JSON с изображениями либо аудио; примеры локального запуска на CUDA, MPS и CPU.
Лицензия: LFM Open License v1.0 с тем же условием коммерческого использования. Карточка модели, лицензия
В карточке указаны 587 млн параметров; обучение на аудио основано на обращениях англоговорящего пользователя к ассистенту. Аудиозаписи обрезаются на 30 секундах. Поэтому команда вроде «приостанови проверку» — более подходящая задача для оценки, чем длинный многоязычный разговор с клиентом. Поддержка аудиовхода сама по себе не доказывает качество работы с любыми звуками. Область применения аудио
Есть ограничение, которое особенно легко упустить: у модели 16,384 позиции контекста в общей сложности, но при работе с изображениями текст исходных данных и вопроса обрезается до 896 токенов. Длинная инструкция по эксплуатации, приложенная к изображению, может превысить доступный текстовый объём задолго до того, как общий размер контекста заставит заподозрить проблему. Подробности о контексте
Для киоска оставьте список команд и локальные правила короткими и предусмотрите обработку нераспознанных запросов. Фоновую речь и нехватку контекста проверяйте так же тщательно, как чисто произнесённые команды. Нужна система, которая воздерживается от решения при неясной инструкции, а не всегда выдаёт внешне допустимый вариант.
В анонсе Liquid нет замеров скорости этой экспериментальной модели. Не переносите на неё время работы более крупной d1-3B и не выводите гарантию задержки из меньшего числа параметров. Приложению всё равно предстоит обрабатывать медиа, загружать модель и укладывать её работу в ресурсный бюджет устройства. Какие замеры вошли в анонс
- Небольшой размер полезен для локальных устройств с ограниченными ресурсами.
- Наряду с изображениями поддерживается принятие решений по аудио.
- Открытые веса позволяют изучать модель и самостоятельно управлять её развёртыванием.
- Экспериментальный релиз с узкой документированной областью обучения на аудио.
- В запросах с изображениями доступный объём текста намного меньше общего контекста.
- В анонсе нет отдельного результата замера скорости этой модели.
7. Amazon Strands Decider 2B: прозрачный локальный контроль действий агентов
Amazon Strands Decider 2B — открытая модель принятия решений от Strands Labs с опубликованными кодом инференса, материалами обучения и оценками. Она лучше подходит, когда причина отказа от облачного вызова Jev — желание контролировать небольшой компонент принятия решений в собственной среде выполнения агентов. Начните с ограниченной задачи, например проверки предлагаемого действия по короткому набору правил. Предоставленный локальный сервер не следует считать законченным облачным продуктом. Репозиторий разработчика
Для каких задач: Локальный контроль действий агентов, маршрутизация и эксперименты с методикой обучения.
Главное отличие: Веса, код и подробности оценки доступны вместе.
Цена: Облачный тариф за 1 млн входных токенов не опубликован; среду выполнения предоставляете вы.
Бесплатный пробный доступ: Модель и код можно скачать под Apache-2.0; вычисления оплачиваются отдельно.
Входные данные и среда: Текст и, при подключении обработки изображений, изображения; варианты для CUDA, Apple Silicon и CPU.
Лицензия: Apache-2.0 для указанной версии весов на базе Qwen и самого проекта. Текущая карточка модели
Зафиксируйте точную версию весов: strands-decider-2B-qwen3.5-v1-2610 — текущий эталонный вариант, описанный в репозитории. Он использует базовую модель Qwen3.5-2B-Base с обученным адаптером и модулем принятия решений, который оценивает допустимые ответы. Старые названия hobson-v19 и hobson-v21 по-прежнему встречаются, поэтому рядом с утверждением о производительности обязательно должна стоять версия. Версия и архитектура
Это различие касается и часто цитируемого времени 115 мс. Подробная таблица в репозитории относит этот медианный результат на RTX 3090 к v19, а в колонках новых версий указаны общие с ней архитектура и размер. Это исторический замер разработчика, а не новое измерение текущей версии весов. Используйте замер, относящийся к той версии, которую собираетесь разворачивать. Таблица производительности по версиям
Предоставленный сервер слушает localhost и не имеет аутентификации. Для локального эксперимента это полезно, но сетевому сервису также нужны контроль доступа, планирование одновременных запросов, ответственный за эксплуатацию и мониторинг. В случае внутреннего агента ответственный должен определить поведение системы, когда процесс модели ещё не прогрет, занят или недоступен. Локальный запуск — вариант развёртывания, а не стратегия обеспечения доступности. Инструкции по запуску сервиса
Первая конкретная проверка может различать два случая: «предложенное действие только читает запись» и «предложенное действие меняет запись». При этом права пользователя и допустимые операции всё равно должны проверяться фиксированными правилами приложения. Если модель считает операцию безопасной, но у аутентифицированного пользователя нет права её выполнить, операция остаётся заблокированной.
- Модель и код под Apache-2.0 позволяют самостоятельно эксплуатировать локальный компонент.
- Опубликованные материалы обучения и оценки позволяют проверить исходные допущения.
- Варианты запуска небольшой модели на CPU и Apple Silicon расширяют возможности проверки.
- Здесь не подтверждены ни облачный тариф разработчика на входные токены, ни управляемый эндпоинт.
- Пример локального сервера не является готовым сервисом для рабочей эксплуатации.
- Исторические показатели задержки нужно связывать именно с той версией весов, на которой их измерили.
Как меняется месячный счёт и что остаётся за его пределами
Большая экономия в процентах может оказаться небольшой суммой в долларах. Допустим, нужно принимать миллион решений в месяц, расходуя на каждое 1,000 оплачиваемых входных токенов. Это миллиард входных токенов. При проверенных базовых тарифах счёт только за входные токены модели составит $20 для Perplexity, $38 для Clef-flash, $42 для Jev или Microsoft-Decision-1, $100 для OpenAI Decisions, $150 для Clef-omni и $240 для Clef. Perplexity, Cloudflare, TypeSafe, Microsoft, OpenAI
В этом сценарии число оплачиваемых токенов намеренно приведено к одной величине. Разные токенизаторы, структура вопросов и обработка медиа могут дать разные оплачиваемые объёмы для одних и тех же исходных бизнес-данных. Расчёт не учитывает бесплатные квоты, подписки на платформы, региональные надбавки и наценки за длинный контекст, повторные запросы, последующую генерацию и проверку сотрудниками.
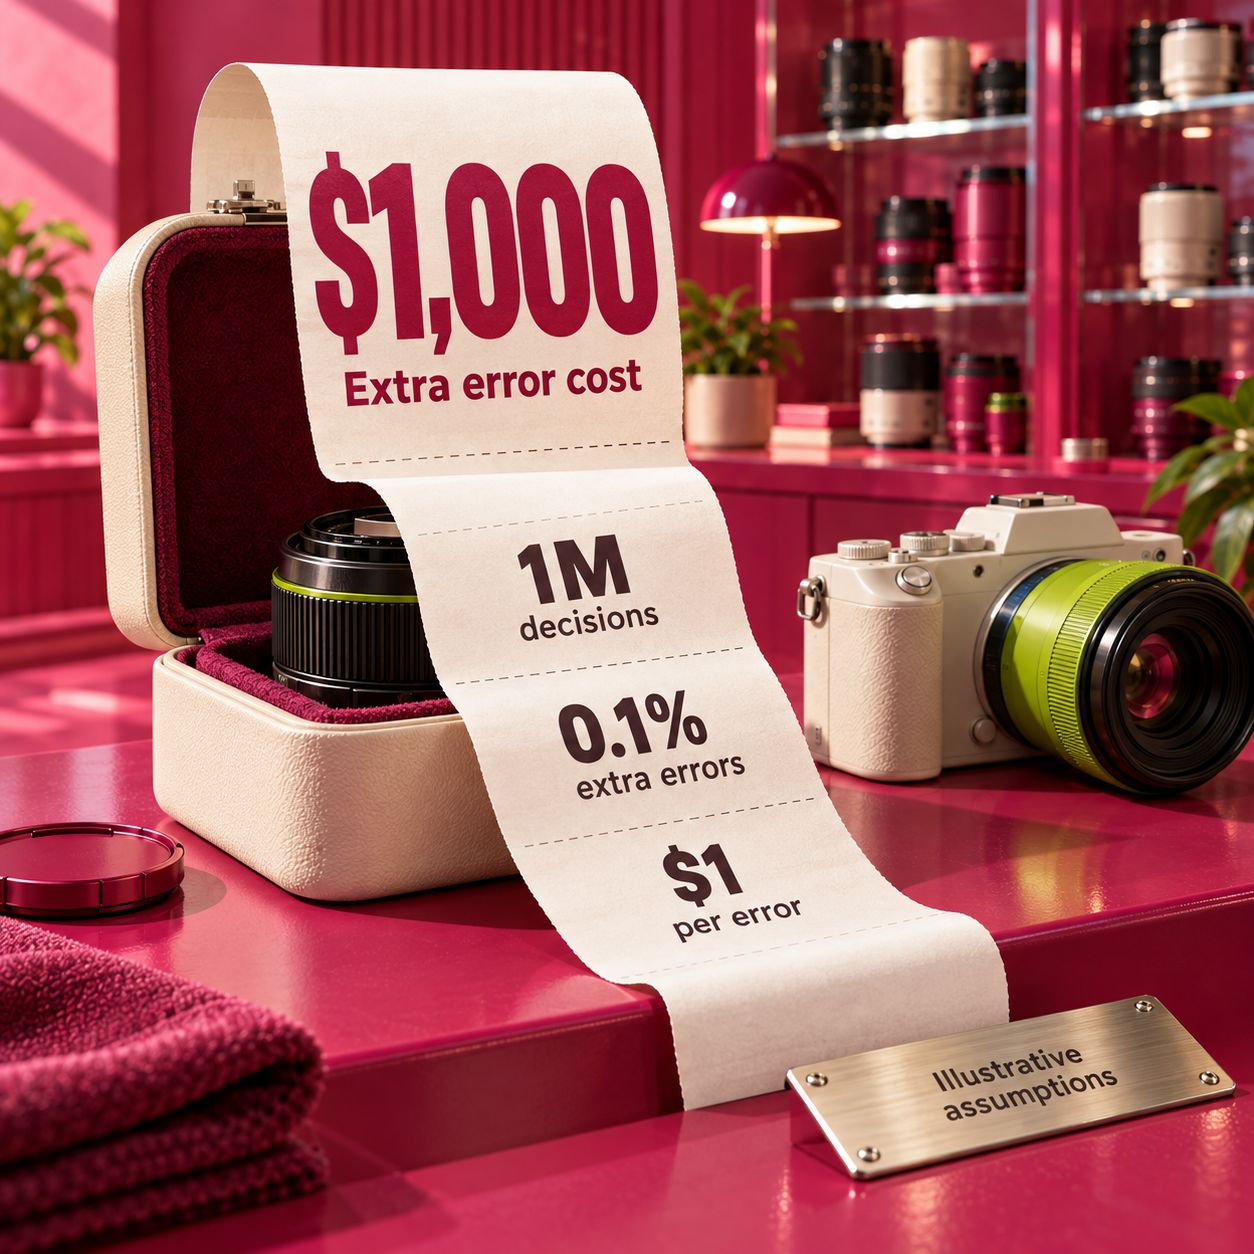
Теперь предположим, что у кандидата доля ошибок выше на 0.1 процентного пункта, а исправление каждой дополнительной ошибки обходится в $1. На миллионе решений это даст 1,000 лишних ошибок и $1,000 дополнительных расходов. Это иллюстративные допущения, а не измеренные показатели ошибок или рыночная стоимость рабочего времени. Они показывают, почему нужно оптимизировать стоимость приемлемых решений, а не только цену токенов.
Самостоятельное развёртывание требует похожего расчёта. Если дополнительный бюджет на инфраструктуру составит $100 в месяц, для выхода на уровень базового тарифа Perplexity в $0.02 за миллион потребуется пять миллиардов входных токенов в месяц — ещё до учёта эксплуатации и различий в качестве. Сумма $100 взята для примера, это не цена аренды GPU. Уже имеющееся свободное оборудование может изменить расчёт. А локальное хранение данных или работа продукта без сети могут оправдать такой выбор даже без экономии на токенах.
Прежде чем экстраполировать расходы, измерьте оплату на реальной нагрузке. Например, отдельный облачный сервис d1 от Liquid заново учитывает текст и переданные изображения для каждого вопроса. Поэтому несколько вопросов в одном HTTP-запросе не означают, что исходные данные будут оплачены только один раз. Это правило тарификации не задаёт цену в долларах для открытых весов модели. Пояснение Liquid о тарификации
Какую модель запускать в рабочей системе?
Для обычной маршрутизации сначала проверьте Perplexity, если цель — снизить облачные расходы. Начните с Clef-flash, если работа внутри Workers упрощает приложение. Решение меняется в зависимости от того, укладывается ли кандидат в ваши требования по частоте запросов, длине входа и измеренному допустимому объёму неверных назначений и ручных проверок. Ни более низкий тариф, ни знакомая платформа не компенсируют потерю сведений, от которых зависит правильный выбор очереди.
Для разметки предпочтительна модель, которая сохраняет вашу систему категорий на неоднозначных примерах. Microsoft-Decision-1 — естественный кандидат для Foundry, Perplexity — облачный вариант с акцентом на цену. Проверьте, может ли комментарий относиться сразу к нескольким темам. Вопрос с единственным выбором заставляет назначить одного победителя. Поэтому задачу с несколькими метками нужно разбить на отдельные проверки или явно представить другим подходящим способом.
Для контроля действий агентов выбирайте среду, которую можете надёжно эксплуатировать, а управление полномочиями оставляйте в коде. Strands стоит проверить как локальный компонент; Microsoft или OpenAI могут подойти для уже существующей облачной интеграции. Модель может дать оценку предлагаемому действию. Приложение должно отдельно обеспечивать соблюдение прав доступа, правил расходов и ограничений на операции.
Для работы на устройстве начните с d1-3B для текста и изображений, а для узкого голосового эксперимента — с d1-omni-600M. Strands — ещё один локальный вариант, если его лицензия и доступная для изучения методика лучше соответствуют проекту. В этой ветке выбора устройство, предобработка входных данных и допустимое коммерческое использование важнее сравнения облачных цен.
Для решений по аудио и видео в облачном приложении проверьте Clef-omni. Способность напрямую обрабатывать такие данные — существенное отличие. Более дешёвая текстовая модель станет альтернативой, только если вы сознательно добавите этап предобработки и проверите, какая информация на нём теряется.
Для резервного провайдера сначала определите, от какого сбоя он должен защитить. Два идентификатора моделей за одним шлюзом всё равно зависят от этого шлюза. Локальный резерв тоже откажет, если получает входные данные из того же недоступного вышестоящего сервиса. Нарисуйте весь путь запроса и изолируйте зависимость, отказ которой система должна пережить.
Сначала перенесите одно решение, затем весь процесс
Замена успешна, когда сохраняет согласованные правила принятия решений в приложении, а не просто возвращает корректный JSON. Адаптируя поля под провайдера, оставляйте неизменными названия очередей, смысл критериев оценки и поведение при сбоях. Тогда расхождения можно будет разбирать, не смешивая смену модели с изменением правил.
Зафиксируйте задачу и исходные данные
Выберите один существующий вызов, например назначение очереди новому обращению в поддержку. Запишите допустимые метки, версию правил, входные поля и критерии нехватки информации. Включите в размеченный набор неоднозначные и выходящие за рамки задачи случаи, а не только очевидные примеры.
Адаптируйте интерфейс взаимодействия с провайдером
Явно сопоставьте исходные данные, определения вопросов и способ чтения ответов. OpenAI использует поле input и массив именованных вопросов; в документированных примерах Perplexity и Microsoft применяются state и вопросы с ключами. Упаковка изображений тоже различается. Сверяйтесь с собственным руководством разработчика: похожие названия примитивов не означают одинакового формата передачи данных.
Запустите кандидата параллельно с текущей моделью
Пусть текущий процесс по-прежнему управляет действиями, а кандидат только записывает ответ. Сравнивайте ошибочно принятые решения, передачи на проверку, сбои запросов, оплачиваемый расход и самые долгие ответы. Передавайте обеим моделям одни и те же сведения, чтобы изменение предобработки не выглядело улучшением модели.
Настройте пороги для этой модели и задачи
Порог Jev нельзя переносить только потому, что другой API тоже возвращает вероятность или поле confidence. Заново проверьте связь оценок с фактической правильностью на размеченных примерах. Предусмотрите отдельный путь проверки для нехватки данных, сбоев провайдера и отказов модели.
Переключайтесь постепенно и упростите откат
Меняйте только выбранный процесс. Сохраните прежнюю конфигурацию модели и способ вернуться к ней. Повторяйте оценку при изменении версии весов, псевдонима модели, формулировок вопросов или предобработки: любое из этих изменений может повлиять на решения, проходящие ваши пороги.
Если вы начинаете с Jev Router, а не с прямого вызова Jev для принятия решения, сначала разберитесь, за что выставляется счёт. Сервис маршрутизации и выбранная им последующая модель — разные статьи расходов. Это различие объясняет руководство по тарифам Jev Router: дешёвая модель принятия решений не делает генерацию ответа бесплатной.
Когда эти варианты не подходят
Не выбирайте Microsoft-Decision-1 ради экономии на токенах, если единственная претензия к Jev — текущий базовый тариф. Опубликованные цены совпадают. По платформе или качеству это всё ещё может быть удачный выбор, но обоснование будет другим.
Не используйте облачный Clef-flash для архива исходных данных без ограничения размера, если не контролируете объём входа. Корректный ответ после обрезки может скрывать тот факт, что решающие сведения вообще не дошли до модели. Подберите нагрузку, которая укладывается в лимит, или проверьте вариант с подходящим контекстом.
Не выбирайте d1-omni-600M для неограниченного анализа длинных записей только из-за слова omni. Документированная область работы с речью, обрезка записи и экспериментальный статус имеют значение. Если требуются более разнообразные медиа, облачный кандидат в этой подборке — Clef-omni, с учётом его собственных ограничений.
Не считайте открытые веса синонимом бесплатного рабочего сервиса. У Liquid есть условие в лицензии, эталонная конфигурация Perplexity требует большого объёма памяти, а Strands оставляет хостинг вам. Скачивание модели — начало обязательств по её эксплуатации.
Не используйте непроверенный клон как аварийный резерв. Похожее название продукта или внешне совместимый эндпоинт не подтверждают ни разработчика, ни подходящую лицензию, ни поддерживаемую среду выполнения, ни независимость от отказа основной системы. Причина исключения — отсутствие подтверждений, а не утверждение, что все проекты сообщества работают плохо.
Частые вопросы
Есть ли бесплатные аналоги Jev?
Cloudflare предоставляет общую ежедневную бесплатную квоту Workers AI. У нескольких альтернатив также можно скачать веса, но вычислительные ресурсы предоставляете вы и условия лицензии обязательны. В документации облачного сервиса Liquid отдельно указана текстовая модель d1:free, однако на проверенной здесь странице размер квоты не опубликован. Бесплатный способ доступа не гарантирует нулевых расходов при рабочем развёртывании. Руководство по облачным моделям Liquid
У каких альтернатив Jev открытые веса?
Разработчики опубликовали способы получения весов семейства Clef, указанной версии Perplexity, двух моделей d1 от Liquid и Strands Decider. Clef, Perplexity и указанная версия Strands используют Apache-2.0; Liquid — LFM Open License v1.0 с условием коммерческого использования. OpenAI Decisions и Microsoft-Decision-1 в этом сравнении представлены как облачные варианты: на приведённых страницах разработчиков лицензии на открытые веса не предоставлены.
Какой аналог Jev проверить первым?
Для более низкого облачного тарифа на входные токены сначала проверьте Perplexity; для существующего приложения Workers — Clef-flash, для Foundry — Microsoft-Decision-1, для интеграции с OpenAI — OpenAI Decisions. При локальном запуске начните с d1-3B для текста и изображений, d1-omni-600M для узкого голосового эксперимента или Strands для компонента агента, устройство которого можно изучить. Окончательный выбор определяет проверка на вашей нагрузке.
С чего начать на практике
Выберите вызов модели, за который отвечает человек, способный объяснить, как выглядит дорогостоящая ошибка. Подберите одного кандидата под свою причину перехода: цену, платформу, медиа на входе или локальную работу. Сравните его с Jev на одних и тех же исходных данных. Переходите, только если вас устраивают ошибочно принятые решения, нагрузка на ручную проверку и время ответа. Держите исходную конфигурацию наготове, пока новый вариант не докажет надёжность в обычной работе.
Используйте чек-лист аудита бизнес-процессов с ИИ, чтобы определить, какое решение стоит изменить первым.
- Опубликовано
- Категория
- Build
- Язык

OpenAI Decisions API: классификация обращений на практике
Как использовать OpenAI Decisions API для классификации обращений: три типа запросов, обработка отказов, цены, ограничения и проверка качества перед переходом.11 окт. 2026 г.Build
Claude Code Remote Control: настройка доступа с телефона
Как настроить Claude Code Remote Control в терминале, VS Code и Desktop, подключиться с телефона или из браузера и устранить ошибки входа и соединения.9 окт. 2026 г.Build
Cursor на iPhone: настройка и управление локальными агентами
Как настроить Cursor на iPhone, подключить ноутбук и управлять локальными агентами. Условия работы, тарифы и отличия от Cloud Agents, Claude Code и Codex.9 окт. 2026 г.Build
Тарифы Firecrawl: сколько стоит сбор данных в 2026 году
Тарифы Firecrawl за октябрь 2026: кредиты, доплаты и расчёты для JSON, обычных страниц и еженедельного обхода. Сравните планы и расходы на сбор данных.9 окт. 2026 г.Build
Claude Code или GitHub Copilot: что выбрать в 2026 году
Сравниваем Claude Code и GitHub Copilot: цены, лимиты, модели и управление командой. Что выбрать для редактора и терминала и сколько стоит использовать оба.8 окт. 2026 г.Build
LangGraph vs CrewAI: как выбрать фреймворк ИИ-агентов
Сравнение LangGraph и CrewAI на одном процессе согласования: состояние, память, MCP, трассировка и цены облачных платформ. Что выбрать для ИИ-агентов.7 окт. 2026 г.Build
MCP-сервер на Python: от первого инструмента до HTTP
Создайте MCP-сервер на Python для проверки заказов: протестируйте его в Inspector, подключите Claude Code и Cursor, добавьте авторизацию и разместите в облаке.7 окт. 2026 г.Build