Jev и маршрутизация обращений в поддержку
Практическое руководство по Jev: как классифицировать обращения, оценивать критичность и срочность, сохраняя проверку человеком и безопасный откат.

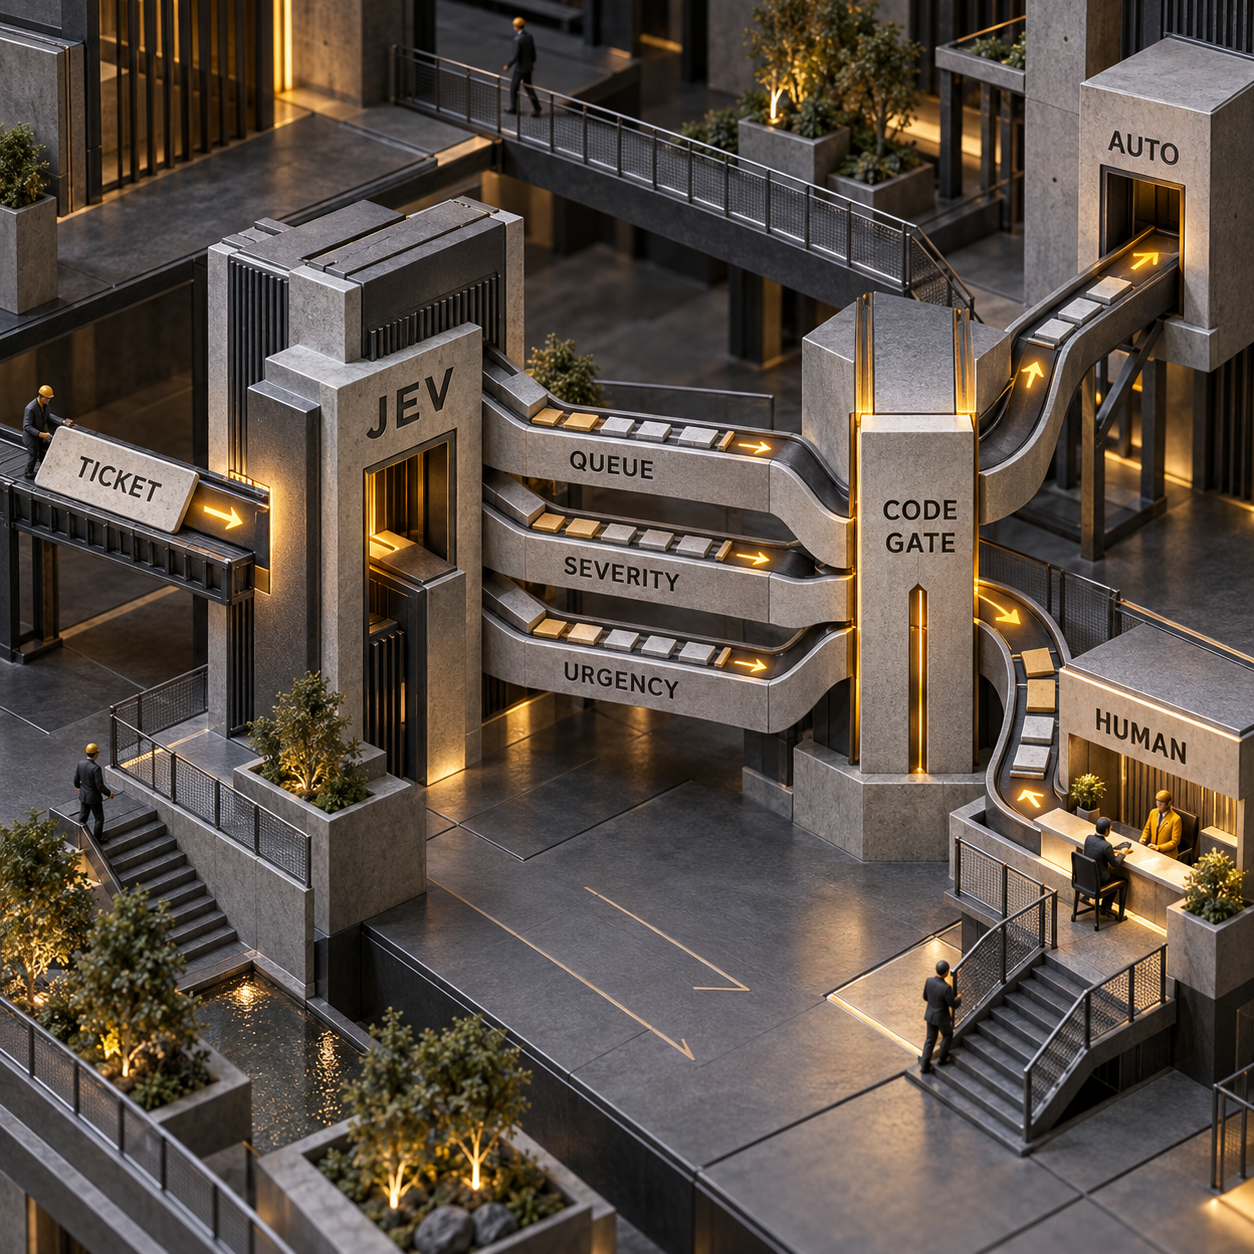
Jev превращает одно неструктурированное обращение в поддержку сразу в три сигнала, понятных вашему ПО: очередь, оценку критичности и вероятность того, что заявку нужно обработать срочно. Такая маршрутизация обращений полезна не только потому, что ответы имеют заданный тип. Код может проверить их, записать в журнал и решить, когда модели доверять не следует.
Начните с одной обратимой задачи: направьте заявку в нужную очередь, но предусмотрите в коде очередь для проверки человеком. Jev гарантирует формат ответа, а не то, что ответ billing окажется верным. Именно это отличает демонстрацию от рабочего процесса.
Маршрутизация обращений: начните с одного решения, а не с автономного агента
Jev — модель принятия решений, а не чат-бот. Вы передаёте ей текст или структурированный JSON под названием state, а затем задаёте вопросы, заранее определив допустимые форматы ответов. В ответ приходят значения и вероятности, а не текстовое сообщение. TypeSafe называет Jev моделью System One: она предназначена для быстрых узких решений внутри обычного ПО.
Представьте Jev как семантический коммутатор. Обычный оператор if проверит точный факт — например, просрочен ли счёт. Jev берёт на себя нечёткую часть задачи: скажем, определяет, звучит ли сообщение клиента срочно, — а затем возвращает управление обычному коду.
В первом сценарии для службы поддержки передайте одну заявку и задайте три вопроса:
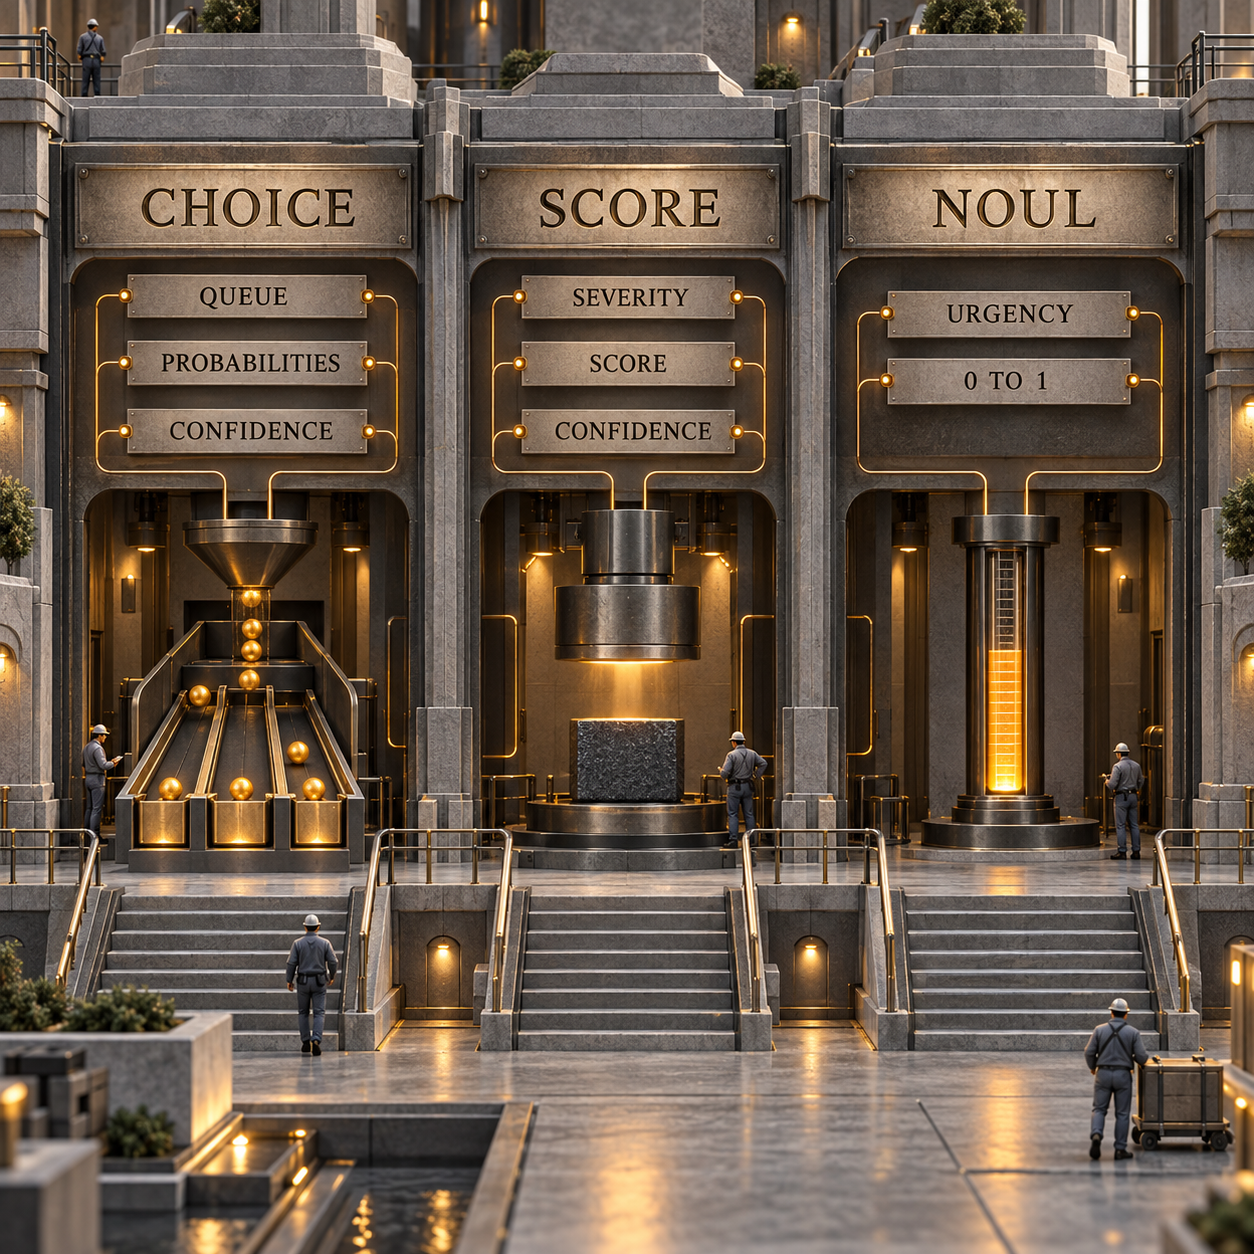
- Choice: В какую из заданных очередей направить заявку?
- Score: Какому уровню упорядоченной шкалы соответствует её критичность?
- Noul: Какова вероятность, что клиент сообщает о срочной проблеме?
Все три вопроса можно отправить одним запросом: они будут независимо оценены на основе одного и того же состояния. Сейчас Jev принимает только текст, в том числе строки и JSON-структуры, составленные из текста. Вложения, изображения, аудио и видео модель не принимает.
Choice, Score и Noul решают разные задачи
Каждый примитив отвечает на свой тип вопроса. Правильный выбор здесь важнее изобретательной формулировки.
Очередь определяется через Choice, поскольку billing, technical, sales и other — взаимоисключающие варианты. Критичность подходит для Score, потому что её уровни образуют упорядоченную шкалу. Noul уместен для срочности, если вопрос сводится к тому, выражено ли в сообщении ограничение по времени.
Смотрите на распределение вероятностей целиком. Если Choice присваивает близкие вероятности вариантам billing и technical, граница между очередями для этой заявки размыта. Для Choice и Score поле confidence кратко характеризует определённость распределения. У Noul зона неоднозначности находится около 0.5, поскольку возвращаемое значение уже является вероятностью ответа «да».
Собираем первую схему распределения заявок
Сначала проверьте доступ. TypeSafe открыла ранний доступ к Jev 15 сентября 2026 года, но в среде, где готовилась эта публикация, ключа TypeSafe не было. Запрос к эндпоинту моделей без ключа вернул HTTP 403 с ошибкой аутентификации. Приведённый ниже сценарий можно запустить при наличии доступа, однако ни один результат в этой статье не выдаётся за результат выполнения в рамках этой публикации.
Используйте Python 3.10 или новее, установите typesafe-sdk и задайте переменную окружения TYPESAFE_API_KEY. SDK читает эту переменную и по умолчанию использует jev-latest. В примере модель указана явно, чтобы запрос было проще проверять.
from time import perf_counter

from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = {
    "id": "T-001",
    "message": (
        "Our SSO connection stopped working after renewal. "
        "The invoice is paid, but the whole team is locked out."
    ),
}

started = perf_counter()
with TypeSafeClient() as client:
    response = client.system_one(
        model="jev-latest",
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which support queue should handle `message`?",
                criteria={
                    "billing": "Invoices, payments, refunds, or subscriptions",
                    "technical": "Bugs, outages, access, or integrations",
                    "sales": "Plans, pricing, upgrades, or a new account",
                    "other": "Anything that does not clearly fit the other queues",
                },
            ),
            "severity": Score(
                instructions="How severe is the customer impact in `message`?",
                criteria=[
                    "Minor inconvenience",
                    "One person is blocked",
                    "Several users are blocked",
                    "Security risk or data loss",
                ],
            ),
            "urgent": Noul(
                instructions="Does `message` express urgency or time pressure?",
            ),
        },
    )
latency_ms = round((perf_counter() - started) * 1000, 1)

queue = response.answers["queue"]
severity = response.answers["severity"]
urgent = response.answers["urgent"]

# These are conservative test gates for this reversible workflow,
# not universal thresholds. Tune them on labelled tickets.
needs_human = (
    queue.choice == "other"
    or queue.confidence < 0.75
    or severity.confidence < 0.70
    or 0.35 < urgent.noul < 0.65
)

record = {
    "ticket_id": ticket["id"],
    "model": response.model,
    "input_tokens": response.usage.input_tokens,
    "latency_ms": latency_ms,
    "queue": queue.choice,
    "queue_probabilities": queue.probabilities,
    "queue_confidence": queue.confidence,
    "severity": severity.score,
    "severity_confidence": severity.confidence,
    "urgency_probability": urgent.noul,
    "handoff": needs_human,
}
print(record)
Пороговые значения в примере намеренно привязаны к этому сценарию. Ошибочное распределение заявки обычно обратимо, но цена такой ошибки бывает разной. Стартап из двух человек может спокойно отнестись к промаху, недопустимому для службы поддержки больницы. В собственных рекомендациях TypeSafe по confidence сказано, что границы должны соответствовать риску и настраиваться на ваших данных.
Есть ещё одна деталь, которую стоит журналировать: jev-latest — это псевдоним. На момент публикации он указывает на jev-1.13.0, а поле model в ответе показывает, какая версия фактически обработала запрос. Если после обновления результаты изменятся, журнал без точного идентификатора модели не поможет объяснить причину.
Самый наглядный сбой: формат верный, смысл ошибочный
В тестовой заявке намеренно совмещены два сильных сигнала. Слова “Renewal” и “invoice” указывают на биллинг, а “SSO” и “locked out” — на техническую поддержку. При правилах из примера в размеченной выборке правильной очередью может считаться technical, поскольку непосредственная проблема — потеря доступа.
Но Jev вполне может вернуть формально корректный Choice billing. JSON будет успешно разобран. Поле окажется на месте. Значение войдёт в список допустимых вариантов. И всё же относительно эталонной метки ответ будет неправильным.
Такой сбой показывает, что нужны два независимых механизма контроля:
- Резервный сценарий в рабочем процессе: передавайте человеку случаи с низким confidence, значением
otherи неоднозначным Noul. - Резервный сценарий при оценке: сравнивайте каждое тестовое решение с меткой человека, включая ответы с высоким confidence. Порог не выявит уверенно выбранную неправильную метку.
Не путайте «типобезопасный» с «точный по определению». Типобезопасность защищает интерфейс между моделью и кодом. Точность же необходимо измерять именно на тех заявках, метках, критериях, версиях модели и языках, которые вы используете.
Это подтверждает независимый ранний тест маршрутизации электронной почты. На 1,565 деловых письмах на немецком и английском языках автор получил для Jev общую точность 96.4% — ниже, чем у двух моделей Gemini. Ошибки Jev в том же тесте чаще встречались при более низкой уверенности, поэтому выборочная проверка человеком оказалась полезной. Это результат одного специалиста на собственной выборке, а не универсальный производственный показатель.
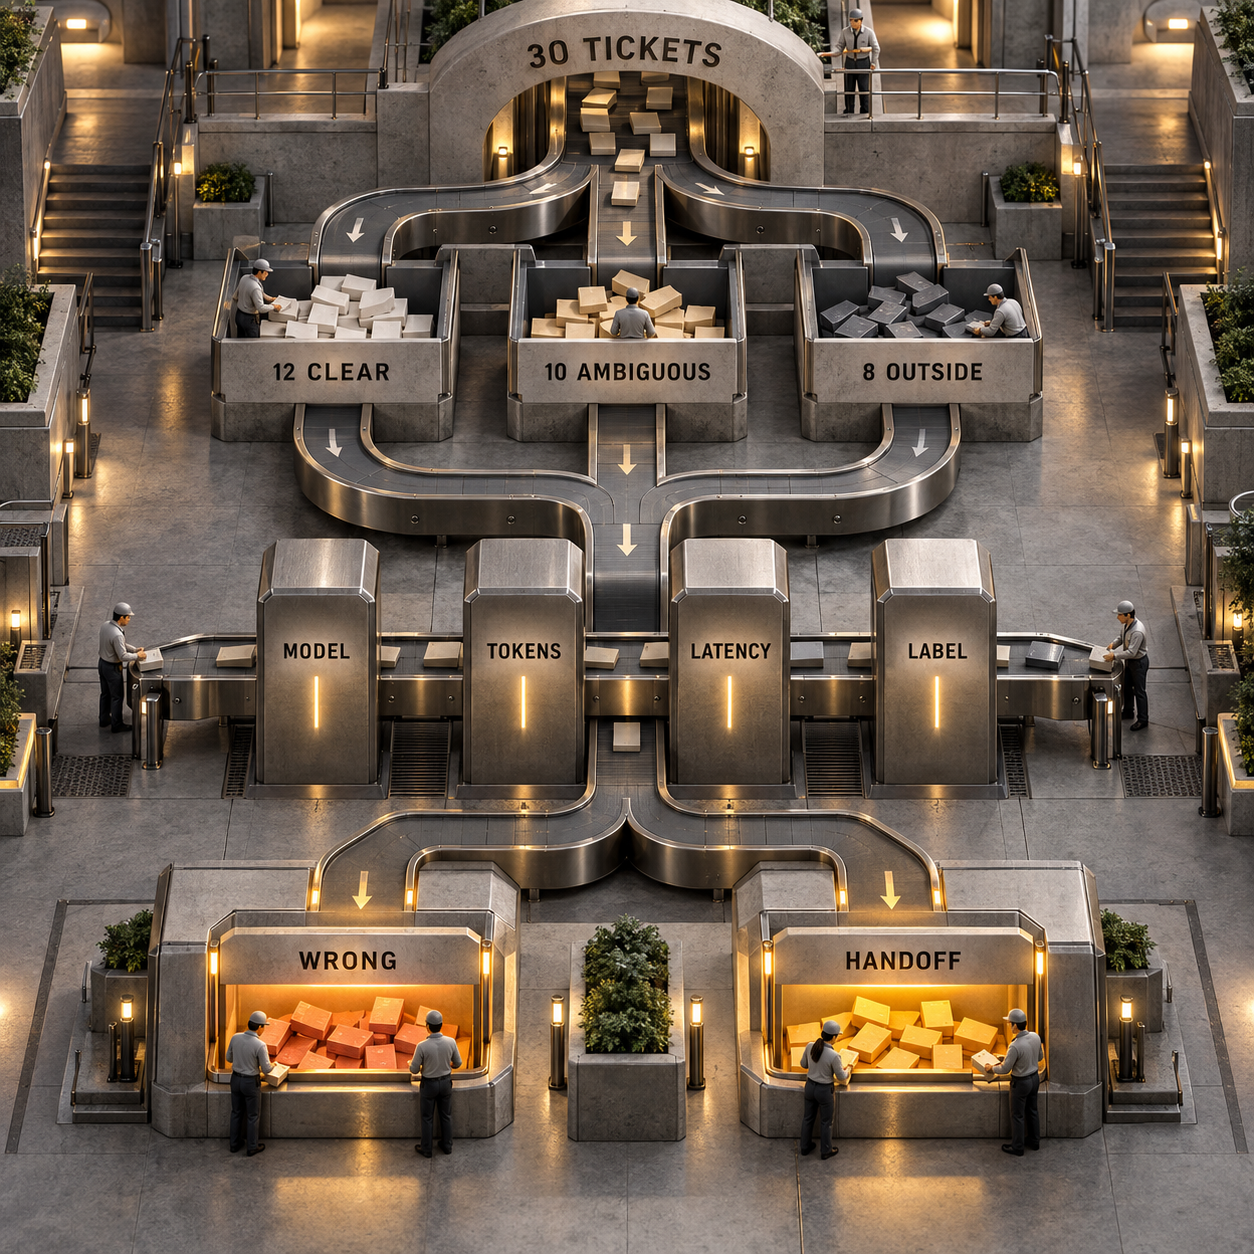
До автоматической маршрутизации проверьте процесс на 30 заявках
Тридцати заявок недостаточно, чтобы подтвердить производственную точность. Зато они способны обнаружить неудачный набор меток, отсутствие пути other, вводящую в заблуждение инструкцию, ошибку в полях ответа или резервный сценарий, который никогда не срабатывает. Это небольшая проверка процесса, а не бенчмарк.
Подготовьте тестовый набор до того, как увидите ответы Jev:
Для каждой строки задайте постоянный идентификатор заявки, ожидаемую очередь, краткое обоснование метки и признак передачи человеку. Затем запишите точную версию модели, входные токены, измеренную клиентом задержку, выбранную очередь и вероятности, критичность и её confidence, вероятность срочности, признак ошибочной метки и фактическую передачу человеку.
Отдельно проверьте как минимум четыре среза:
- Ошибочные метки среди заявок, которые код направил бы автоматически
- Уверенные ошибочные метки, поскольку рабочий шлюз их не перехватит
- Долю передач человеку среди однозначных случаев: избыточная осторожность создаёт ручную работу
- Случаи вне охвата, которые не попали в
other
Если доступ всё ещё выдаётся по списку ожидания, сохраните тестовый набор и готовый скрипт. Не заполняйте колонки результатов значениями из документации или чужого теста. Честный артефакт в этом случае — таблица заблокированного из-за отсутствия доступа запуска и исполняемый код.
Стоимость меняет статью расходов на классификацию, а не весь стек поддержки
Для Jev 1.13 установлена цена $0.042 за миллион входных токенов, выходные токены не тарифицируются. При таком тарифе гипотетическая заявка объёмом 500 входных токенов стоит $0.000021. Стоимость обработки ста тысяч заявок такого размера составит $2.10.
Цифра впечатляет, но это не цена замены платформы поддержки. Zendesk стоит от $19 за оператора в месяц при годовой оплате, Intercom — от $29 за место в месяц плюс от $0.99 за результат Fin. В эти продукты входят интерфейс работы с обращениями, хранение заявок, рабочее место оператора, отчётность и другая операционная инфраструктура. Jev предоставляет только сигнал для принятия решения.
Меняется более узкое бюджетное допущение: повторяющаяся семантическая классификация больше не требует каждый раз обращаться к дорогой генеративной модели. Деньги и усилия смещаются в сторону интеграции, размеченных примеров, мониторинга, обработки исключений и сотрудников, принимающих переданные заявки. При обычном объёме входящих обращений экономия на инференсе может оказаться менее ценной, чем понимание того, в каких случаях модель сама сообщает о своей неуверенности.
Здесь полезно разделить роли. Jev выбирает маршрут. Генеративная модель готовит текст. О второй части такого процесса читайте в материале о том, как ChatGPT может готовить ответы Zendesk на основе истории заявки. Политики, разрешения и действия по-прежнему должны контролироваться кодом приложения.
Семь сценариев: кому они принесут больше пользы
Ниже перечислены возможные применения модели принятия решений с ограниченным форматом ответа, а не зафиксированные результаты.
Jev лучше всего работает там, где возможные ответы известны заранее, решение регулярно повторяется, а последствия неверной ветки можно сдержать. Модель плохо подходит для задач, где результатом должен быть ответ клиенту, объяснение, вычисление, точное сравнение дат или длинная цепочка рассуждений.
Два продукта, которые стоит создать
1. Дополнение для маршрутизации с порогом уверенности
Это самая перспективная возможность. Предложите компактный слой маршрутизации командам, которые уже работают в help desk, но всё ещё сортируют обращения вручную или используют хрупкие правила на ключевых словах. Система будет читать заявку, применять собственные правила очередей команды, записывать выбранную очередь и вероятности обратно в help desk, а сомнительные и нераспознанные случаи передавать человеку.
Спрос достаточно конкретен: customer service automation получает около 880 поисковых запросов в месяц в США, а help desk automation и customer support automation — примерно по 260. Существующие платформы поддержки стоят от $19 до $29 за место в месяц, поэтому предложение должно звучать не как «замените свой help desk», а как «сделайте измеримым одно решение о маршрутизации внутри help desk, за который уже платите».
Минимальная продаваемая версия требует одного коннектора, четырёх редактируемых определений очередей, маршрута other, диапазонов уверенности, очереди проверки и еженедельного отчёта по ошибочным меткам. Слабое место — онбординг. Границы очередей у каждого клиента свои, а универсальная схема становится главным источником ошибок продукта. Защитное преимущество создаёт цикл оценки и обратной связи, а не сам вызов API.
2. QA-консоль для маршрутизации в теневом режиме
Сначала продавайте защитный слой, а уже затем автоматизацию. Руководитель поддержки загружает размеченные заявки, запускает тестовую схему вопросов без изменения реальных назначений и получает матрицу ошибок, уверенные промахи, доли передачи человеку, сравнение версий и список случаев, для которых нужны более точные критерии.
Те же 260 ежемесячных запросов по фразе help desk automation показывают интерес к задаче, а CPC $129.46 для customer support automation указывает на коммерческую ценность такого трафика для поставщиков. MVP может состоять из импорта CSV, прямого вызова Jev, параллельной проверки меток и экспортируемого журнала решений. Сначала он должен поддерживать проверку на 30 заявках, а затем — более крупные закрытые наборы данных.
Риск в том, что от аккуратного дашборда команды могут ожидать статистических гарантий. Продукт обязан прямо объяснять, что небольшая выборка может подтвердить, а что нет, защищать данные заявок и не выдавать уверенность модели за реальную точность. Это хорошее дополнение к слою маршрутизации, но более слабый самостоятельный бизнес, поскольку оценку проводят не постоянно.
Ограничения, при которых нужно остановиться
Не применяйте Jev, если нужны связный текст, ответ клиенту, код или объяснение хода рассуждений. Эта модель также не подходит для арифметики, подсчёта, сравнения дат и детерминированных правил допуска, которые обычный код выполнит точно.
Согласно документации, Jev 1.13 хуже справляется с ловушками, основанными на буквальном прочтении, косвенными формулировками, нерелевантным контекстом, состязательным содержимым, противоречивыми инструкциями и числовой точностью. Основной язык обучения — английский; для других языков заявлена более низкая точность. Прежде чем Jev сможет обработать вложение, другая система должна преобразовать его в текст.
Лимит контекста для всего запроса составляет 64,000 токенов, а для состояния вместе с самым длинным вопросом действует дополнительный предел 32,000 токенов. Это верхние границы, а не цели. В официальных рекомендациях сказано, что нерелевантное состояние может снизить точность, поэтому извлекайте только те правила и сведения из заявки, которые нужны для текущих вопросов.
Жёсткая граница — последствия решения. Метку обращения можно изменить. Возврат средств, блокировка аккаунта, решение о найме, медицинский приоритет или перевод денег — это уже не просто метки. Действия с серьёзными последствиями должны оставаться за детерминированными проверками, подтверждением, квалифицированным специалистом либо системой, разработанной и проверенной для соответствующей области.
Что сделать в понедельник
Если вы отвечаете за поддержку, утром в понедельник экспортируйте 30 недавних заявок. До просмотра ответов модели разметьте 12 однозначных, 10 неоднозначных и 8 выходящих за рамки задачи примеров. Запросите ранний доступ, после получения ключа запустите скрипт в теневом режиме и разберите уверенные ошибки до настройки порога. Не подключайте результат к реальной маршрутизации, пока метка человека, версия модели и итог резервного сценария не окажутся в одном журнале.
Что такое Jev AI?
Jev — модель принятия решений TypeSafe AI для структурированных программных процессов. Она читает текст или структурированное текстовое состояние и вместо генерации прозы возвращает ограниченные ответы Choice, Score и Noul с вероятностями.
Что означает название Jev?
По словам TypeSafe, название отсылает к William Stanley Jevons. Более широкое обозначение “System One” связано с быстрой, интуитивной стороной различия между System 1 и System 2.
Как использовать Jev: видео или документация?
Видео помогает получить общее представление, но реализацию стоит начинать с актуальной документации по API и SDK TypeSafe: поля запросов, псевдонимы моделей, доступ и ограничения могут меняться. Рабочая последовательность проста: получите авторизованный ключ, отправьте состояние и типизированные вопросы, изучите распределения в ответе и оставьте резервный сценарий в коде.
Если вам нужен процесс поддержки с порогом уверенности, построенный на ваших правилах очередей и реальных заявках, начните с услуги разработки ИИ для клиентской поддержки.
- Последнее обновление
- 21 сент. 2026 г.
- Категория
- Build
Сделать этот сайт предпочтительным в Google


Отметьте omidsaffari.com как предпочтительный источник — и Google будет поднимать его для вас в Top Stories, AI Overviews и AI Mode.
AGENTS.md в Claude Code: как включить и проверить
Настройте встроенную поддержку AGENTS.md в Claude Code, проверьте, какой файл инструкций загружается, и учтите ограничения провайдеров и CLAUDE.md.19 сент. 2026 г.Build
Таймаут MCP в Claude Code: как настроить ожидание запуска
Разбираем таймаут MCP в Claude Code 2.1.274: как задать ожидание первого хода, разделить четыре лимита и проверить готовность серверов перед работой.17 сент. 2026 г.Build
Запрет обучения ИИ в Cloudflare: как сохранить индексацию
Настройте запрет обучения ИИ в Cloudflare, не закрывая сайт от поисковых роботов. Проверьте перенесённые параметры, robots.txt и активность краулеров.16 сент. 2026 г.Build
Голосовой ввод в Murmure: кому подойдёт офлайн-диктовка
Обзор Murmure 1.11.3: как работает локальный голосовой ввод, словарь и правила форматирования, кому подойдёт приложение и где его ограничения.14 сент. 2026 г.Build
FFmpeg API RenderIO: тарифы, лимиты и реальная стоимость
Разбираем тарифы FFmpeg API RenderIO: цену одной команды, переплату сверх лимита, ограничения времени и цепочек и переход на Growth или Business.14 сент. 2026 г.Build
Dictare: бесплатный голосовой ввод для программирования
Dictare — бесплатный локальный голосовой ввод для программирования. Отделяем цену программы от настройки речевых моделей, компьютера и тарифа ИИ-агента.13 сент. 2026 г.Build
Тестирование плагинов Claude Code: evals без самописного раннера
Разбираем нативные eval-тесты Claude Code: как сравнить поведение с плагином и без него, оценить дельту, ограничить расходы и поставить проверку в CI.12 сент. 2026 г.Build