Automatización de atención al cliente con Jev: guía práctica
Aprende a usar Jev para clasificar tickets, medir su gravedad y detectar urgencia, con umbrales de confianza y revisión humana antes de automatizar.

Jev convierte un mensaje desordenado de soporte en tres señales que el software puede usar de inmediato para la automatización de atención al cliente: una cola, una puntuación de gravedad y la probabilidad de que el ticket sea urgente. El valor no está solo en recibir esas respuestas por escrito. Tu código puede examinarlas, registrarlas y decidir cuándo no confiar en ellas.
Empieza por una tarea reversible: enrutar un ticket, pero conserva en el código una cola de revisión humana. Jev garantiza la estructura de la respuesta, no que billing sea la respuesta correcta. Esa diferencia separa una demostración de un flujo de trabajo operativo.
Empieza la automatización de atención al cliente con una sola decisión
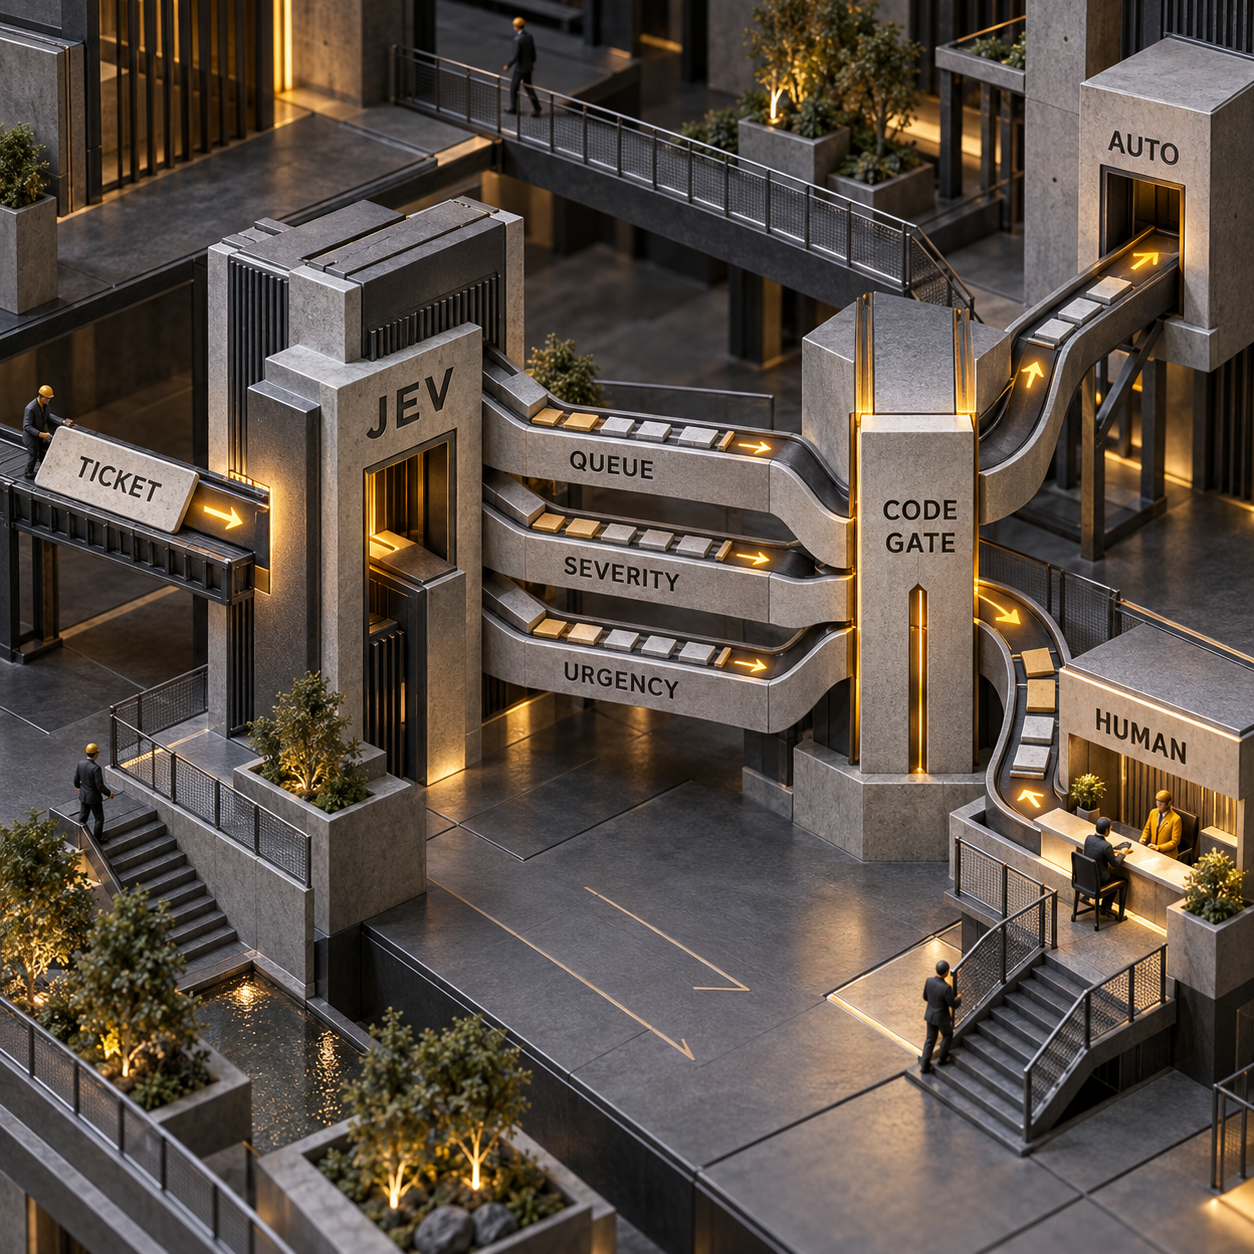
Jev es un modelo de decisión, no un chatbot. Le envías texto o JSON estructurado, denominado state, y después planteas preguntas cuyas posibles estructuras de respuesta están definidas de antemano. En lugar de redactar una contestación, devuelve valores y probabilidades. TypeSafe lo denomina modelo System One: está diseñado para emitir juicios rápidos y acotados dentro de software convencional.
Piensa en Jev como una central de distribución semántica. Una sentencia if común verifica un hecho exacto, como si una factura está vencida. Jev resuelve la parte difusa —por ejemplo, si el mensaje de un cliente parece urgente— y devuelve el control al código convencional.
Para un primer flujo de soporte, dale un ticket y pregunta:
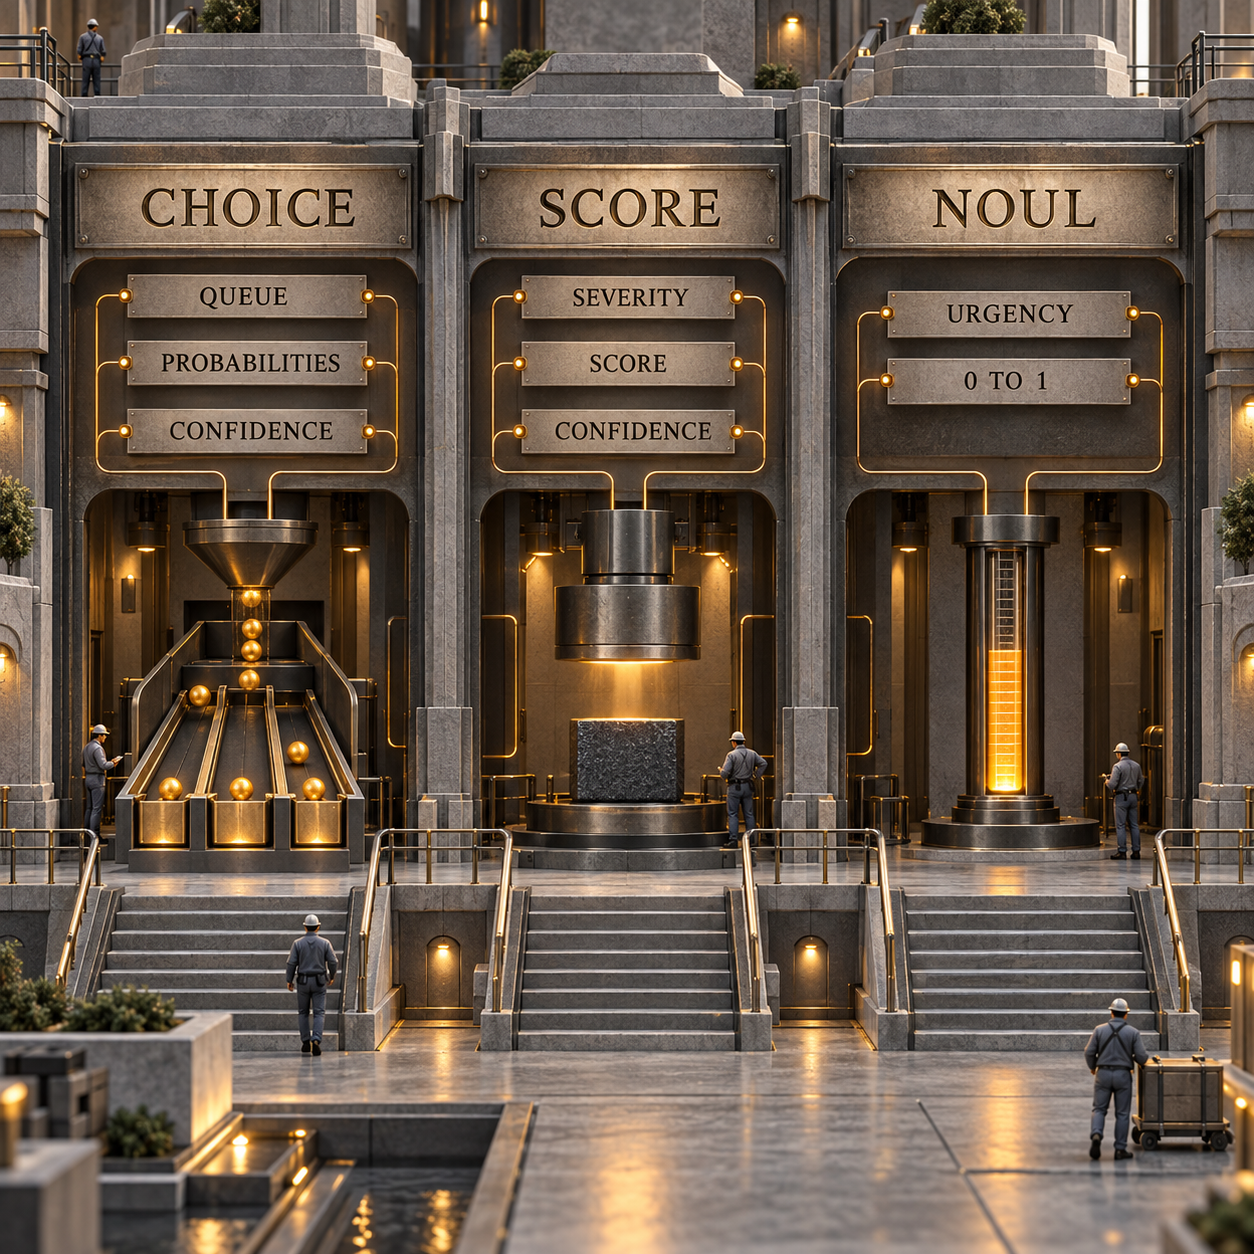
- Choice: ¿A cuál de las colas predefinidas debe enviarse el ticket?
- Score: ¿En qué nivel de una rúbrica ordenada se sitúa su gravedad?
- Noul: ¿Qué probabilidad hay de que el cliente esté expresando urgencia?
Las tres preguntas pueden viajar en una misma solicitud y se evalúan de forma independiente sobre el mismo estado. Por ahora, Jev solo acepta texto, incluidas cadenas y estructuras JSON compuestas por texto. No admite archivos adjuntos, imágenes, clips de audio ni videos.
Choice, Score y Noul no son tres nombres para la misma respuesta
Cada primitiva responde una clase distinta de pregunta. Elegir la adecuada importa más que redactar instrucciones ingeniosas.
Una cola requiere Choice porque billing, technical, sales y other son alternativas. La gravedad requiere Score porque sus niveles forman una rúbrica ordenada. La urgencia requiere Noul cuando la pregunta se limita a determinar si el mensaje expresa presión de tiempo.
Las distribuciones completas son importantes. Si una Choice asigna probabilidades parecidas a billing y technical, indica que la frontera entre ambas colas es difusa. En Choice y Score, el campo único confidence resume esa dispersión. En Noul, un valor cercano a 0.5 marca la zona ambigua, pues el valor devuelto ya representa la probabilidad de una respuesta afirmativa.
Construye el primer enrutamiento de tickets
Primero hay que comprobar el acceso. TypeSafe lanzó Jev en acceso anticipado el 15 de septiembre de 2026, y este entorno de publicación no disponía de una clave de TypeSafe. Una solicitud al endpoint de modelos sin clave devolvió HTTP 403 con un error de autenticación. El flujo que sigue puede ejecutarse con acceso autorizado, pero ningún resultado de este artículo se presenta como una ejecución realizada durante esta prueba.
Usa Python 3.10 o una versión posterior, instala typesafe-sdk y configura TYPESAFE_API_KEY en el entorno. El SDK lee esa variable y emplea jev-latest de forma predeterminada. En este ejemplo, el modelo se declara expresamente para que la solicitud sea fácil de auditar.
from time import perf_counter

from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = {
    "id": "T-001",
    "message": (
        "Our SSO connection stopped working after renewal. "
        "The invoice is paid, but the whole team is locked out."
    ),
}

started = perf_counter()
with TypeSafeClient() as client:
    response = client.system_one(
        model="jev-latest",
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which support queue should handle `message`?",
                criteria={
                    "billing": "Invoices, payments, refunds, or subscriptions",
                    "technical": "Bugs, outages, access, or integrations",
                    "sales": "Plans, pricing, upgrades, or a new account",
                    "other": "Anything that does not clearly fit the other queues",
                },
            ),
            "severity": Score(
                instructions="How severe is the customer impact in `message`?",
                criteria=[
                    "Minor inconvenience",
                    "One person is blocked",
                    "Several users are blocked",
                    "Security risk or data loss",
                ],
            ),
            "urgent": Noul(
                instructions="Does `message` express urgency or time pressure?",
            ),
        },
    )
latency_ms = round((perf_counter() - started) * 1000, 1)

queue = response.answers["queue"]
severity = response.answers["severity"]
urgent = response.answers["urgent"]

# These are conservative test gates for this reversible workflow,
# not universal thresholds. Tune them on labelled tickets.
needs_human = (
    queue.choice == "other"
    or queue.confidence < 0.75
    or severity.confidence < 0.70
    or 0.35 < urgent.noul < 0.65
)

record = {
    "ticket_id": ticket["id"],
    "model": response.model,
    "input_tokens": response.usage.input_tokens,
    "latency_ms": latency_ms,
    "queue": queue.choice,
    "queue_probabilities": queue.probabilities,
    "queue_confidence": queue.confidence,
    "severity": severity.score,
    "severity_confidence": severity.confidence,
    "urgency_probability": urgent.noul,
    "handoff": needs_human,
}
print(record)
Los umbrales anteriores son deliberadamente locales. Enviar un ticket de soporte a una cola equivocada suele ser reversible, pero incluso ese costo depende del contexto. Una startup de dos personas puede tolerar un error de enrutamiento que sería inaceptable para la mesa de ayuda de un hospital. La propia guía de TypeSafe sobre confianza indica que los límites deben responder al nivel de riesgo y ajustarse con datos propios.
Conviene registrar otro detalle: jev-latest es un alias. En la fecha de publicación apunta a jev-1.13.0, y el campo model de la respuesta indica qué versión respondió realmente. Si una versión posterior modifica los resultados, un registro sin el identificador resuelto del modelo no permitirá explicar el cambio.
El fallo visible: una respuesta válida con el significado equivocado
El ticket de ejemplo contiene deliberadamente dos señales fuertes. “Renewal” e “invoice” apuntan a facturación, mientras que “SSO” y “locked out” apuntan al soporte técnico. Según la rúbrica del código, un conjunto de prueba etiquetado podría definir technical como la cola correcta porque el bloqueo inmediato es la pérdida de acceso.
Aun así, Jev podría devolver una Choice billing perfectamente válida. El JSON se analizaría sin problemas. El campo existiría. El valor pertenecería a las opciones permitidas. Y, pese a todo, la respuesta sería incorrecta frente a esa etiqueta.
Ese fallo revela dos controles distintos:
- Respaldo en tiempo de ejecución: Envía a una persona los casos de baja confianza, los clasificados como
othery los Noul ambiguos. - Respaldo de evaluación: Compara cada decisión de prueba con una etiqueta humana, incluidas las decisiones de alta confianza. Ningún umbral detecta una etiqueta incorrecta emitida con seguridad.
No confundas “tipos seguros” con “precisión garantizada desde el diseño”. La seguridad de tipos protege la interfaz entre el modelo y tu código. La precisión debe medirse para los tickets, las etiquetas, los criterios, la versión del modelo y el idioma concretos que utilizas.
Una prueba independiente y temprana de enrutamiento de correo ilustra el problema. En 1,565 correos empresariales en alemán e inglés, quien realizó la prueba informó que Jev alcanzó una precisión general del 96.4%, por detrás de dos modelos Gemini. La misma prueba encontró que los errores de Jev se concentraban en niveles de confianza más bajos, lo que hacía útil una revisión humana selectiva. Es el conjunto de datos de un solo profesional, no un resultado universal de producción.
Prueba un flujo de 30 tickets antes de enrutar nada
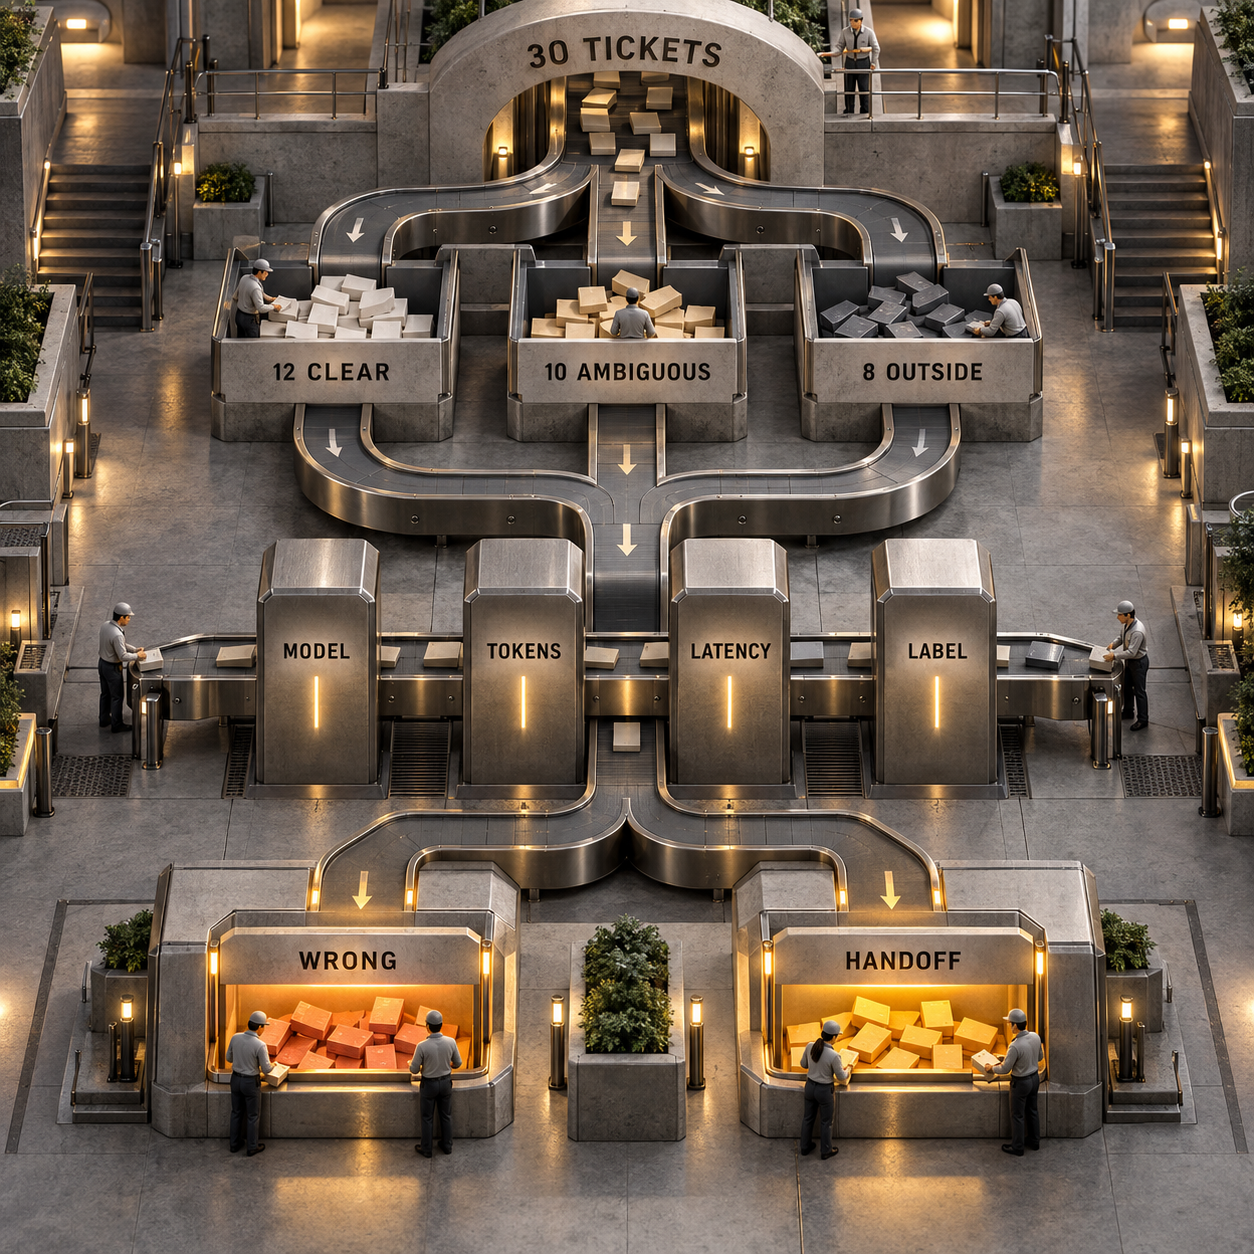
Treinta tickets no bastan para demostrar la precisión en producción. Sí pueden revelar un conjunto de etiquetas deficiente, la ausencia de una ruta other, una instrucción engañosa, un error en los campos de respuesta o un mecanismo de respaldo que nunca se activa. Trátalo como una pequeña comprobación del flujo, no como un benchmark.
Prepara el conjunto de prueba antes de consultar las respuestas de Jev:
Asigna a cada fila un identificador estable de ticket, la cola esperada, una breve justificación de la etiqueta y si el caso debe derivarse a una persona. Después registra la versión resuelta del modelo, los tokens de entrada, la latencia medida por el cliente, la cola y las probabilidades devueltas, la gravedad y su confianza, la probabilidad de urgencia, el indicador de etiqueta incorrecta y la derivación efectiva a revisión humana.
Revisa por separado al menos estas cuatro categorías:
- Etiquetas incorrectas entre los casos que el código enrutaría automáticamente
- Etiquetas incorrectas de alta confianza, porque la compuerta de ejecución no las detectará
- Tasa de derivación de los casos claros, porque un exceso de cautela crea trabajo manual
- Casos fuera de alcance que no terminaron en
other
Si el acceso sigue sujeto a lista de espera, deja preparados el conjunto de prueba y el script. No rellenes las columnas de resultados con valores copiados de la documentación o de la prueba de otra persona. El artefacto honesto es una hoja de ejecución bloqueada por falta de acceso, acompañada de código ejecutable.
El cálculo de costos cambia la partida de clasificación, no toda la plataforma de soporte
Jev 1.13 cuesta $0.042 por millón de tokens de entrada, sin cobro por la salida. Con esa tarifa, un ticket hipotético de 500 tokens de entrada cuesta $0.000021 en procesamiento del modelo. Cien mil tickets de ese tamaño costarían $2.10.
La cifra llama la atención, pero no equivale al precio de sustituir un software de atención al cliente. Zendesk parte de $19 por agente al mes con pago anual, mientras que Intercom parte de $29 por puesto al mes y cobra desde $0.99 por resultado de Fin. Esos productos incluyen bandejas de entrada, almacenamiento de tickets, interfaces para agentes, informes y otros componentes operativos. Jev solo aporta la señal de decisión.
El supuesto presupuestario que cambia es más acotado: la clasificación semántica repetida ya no tiene que consumir una costosa llamada a un modelo generativo cada vez. El dinero y el esfuerzo se desplazan hacia la integración, los ejemplos etiquetados, el monitoreo, la gestión de excepciones y las personas que atienden las derivaciones. Con un volumen habitual de bandeja de entrada, el ahorro bruto en inferencia puede ser menos valioso que saber en qué tickets el propio modelo declara tener dudas.
Aquí conviene dividir responsabilidades. Jev puede seleccionar una ruta. Un modelo generativo puede preparar el texto. Para la parte de respuesta de ese flujo, consulta cómo ChatGPT puede preparar respuestas de Zendesk a partir del historial del ticket. El código de la aplicación debe seguir aplicando políticas, permisos y acciones.
Siete flujos de trabajo, ordenados por quién obtiene más valor
Estas son aplicaciones posibles de un modelo de decisión restringido, no resultados observados.
Jev ofrece su mayor valor cuando se conocen las respuestas posibles, la decisión se repite con frecuencia y una bifurcación equivocada puede contenerse. Encaja mal cuando la salida debe ser una respuesta, una explicación, un cálculo, una comparación precisa de fechas o una larga cadena de razonamiento.
Dos productos que vale la pena construir
1. Una capa de enrutamiento de soporte con umbrales de confianza
Esta es la oportunidad más sólida. La propuesta consiste en vender una capa ligera de enrutamiento a equipos que ya usan una mesa de ayuda, pero todavía clasifican los tickets a mano o mantienen reglas frágiles basadas en palabras clave. La capa leería el ticket, aplicaría la rúbrica de colas del equipo, escribiría en la mesa de ayuda la cola seleccionada y sus probabilidades, y enviaría a una persona los casos dudosos o sin coincidencia.
La demanda es lo bastante específica como para resultar relevante: customer service automation recibe unas 880 búsquedas mensuales en Estados Unidos, mientras que help desk automation y customer support automation reciben unas 260 cada una. Las plataformas de soporte existentes parten de unos $19 a $29 por puesto al mes, así que el argumento no es “sustituye tu mesa de ayuda”, sino “haz medible una decisión de enrutamiento dentro de la mesa de ayuda que ya pagas”.
La versión mínima vendible necesita un conector, cuatro definiciones editables de cola, una ruta other, bandas de confianza, una bandeja de revisión y un informe semanal de etiquetas incorrectas. La dificultad está en la incorporación. Cada cliente traza de manera distinta las fronteras entre colas, y un esquema genérico se convierte en el punto de fallo del producto. La ventaja defendible está en el ciclo de evaluación y retroalimentación, no en la llamada a la API.
2. Una consola de QA para probar el enrutamiento en modo sombra
Vende la capa de seguridad antes que la automatización. Un responsable de soporte sube tickets etiquetados, ejecuta un esquema de preguntas candidato sin modificar las asignaciones activas y recibe recuentos de confusión, errores de alta confianza, tasas de derivación, comparaciones entre versiones y una lista de casos que necesitan criterios más claros.
Las mismas 260 búsquedas mensuales de help desk automation muestran interés por esta tarea, mientras que un CPC de $129.46 para customer support automation indica que los proveedores atribuyen valor comercial a ese tráfico. El MVP puede constar de un importador de CSV, una llamada directa a Jev, una revisión de etiquetas en paralelo y un registro de decisiones exportable. Primero debe admitir la prueba de 30 tickets y, más adelante, conjuntos de datos privados de mayor tamaño.
El riesgo es que los equipos interpreten un panel pulido como garantía estadística. El producto debe explicar qué puede y qué no puede demostrar una muestra pequeña, proteger los datos de los tickets y evitar presentar la confianza como precisión real. Es un buen complemento para la capa de enrutamiento, pero resulta más débil como negocio independiente porque la evaluación es esporádica.
Límites que deben detener el proyecto
No uses Jev si necesitas prosa, una respuesta para el cliente, código o una explicación del razonamiento. Tampoco es adecuado para aritmética, conteos, comparaciones de fechas ni reglas deterministas de elegibilidad que el código convencional puede ejecutar con exactitud.
La documentación indica que Jev 1.13 es más débil frente a trampas literales, referencias indirectas, contexto irrelevante, contenido adversarial, instrucciones contradictorias y precisión numérica. Su idioma principal de entrenamiento es el inglés, y se documenta una precisión inferior en otros idiomas. Antes de que Jev pueda procesar archivos adjuntos, otro sistema debe convertirlos en texto.
El límite de contexto es de 64,000 tokens para la solicitud completa, con un segundo límite de 32,000 tokens que cubre el estado más la pregunta más larga. Son techos, no objetivos. La guía oficial advierte que un estado irrelevante puede reducir la precisión, por lo que conviene recuperar solo la política y los datos del ticket necesarios para las preguntas actuales.
El límite definitivo lo marcan las consecuencias. Una etiqueta de soporte es reversible. Un reembolso, la suspensión de una cuenta, una decisión de contratación, una prioridad médica o una transferencia de dinero no son simples etiquetas. Somete las acciones de alto impacto a comprobaciones deterministas, una confirmación, una persona cualificada o un sistema diseñado y validado para ese ámbito.
Qué hacer el lunes
Si diriges operaciones de soporte, exporta 30 tickets recientes el lunes por la mañana. Etiqueta 12 casos claros, 10 ambiguos y 8 fuera de alcance antes de que nadie vea la salida del modelo. Solicita acceso anticipado, ejecuta el script en modo sombra cuando recibas una clave y revisa los casos incorrectos emitidos con alta confianza antes de ajustar un umbral. No conectes el resultado al enrutamiento activo hasta que la etiqueta humana, la versión del modelo y el resultado del mecanismo de respaldo aparezcan en el mismo registro.
¿Qué es Jev IA?
Jev es el modelo de decisión de TypeSafe AI para flujos de software estructurados. Lee texto o un estado estructurado con texto y devuelve respuestas restringidas de tipo Choice, Score y Noul con probabilidades, en lugar de generar prosa.
¿Qué significa el nombre Jev?
TypeSafe explica que el nombre alude a William Stanley Jevons. La denominación más amplia “System One” remite al lado rápido e intuitivo de la distinción entre System 1 y System 2.
¿Cómo aprender a usar Jev en video?
Los videos pueden servir como introducción, pero la implementación debe partir de la documentación vigente de la API y el SDK de TypeSafe, ya que los campos de las solicitudes, los alias de los modelos, el acceso y los límites pueden cambiar. El flujo directo es el siguiente: consigue una clave autorizada, envía el estado junto con preguntas tipadas, examina las distribuciones devueltas y conserva el mecanismo de respaldo en el código.
Si quieres construir un flujo de soporte con umbrales de confianza basado en tus reglas de colas y tickets reales, el punto de partida adecuado es el desarrollo de IA para atención al cliente.
- Última actualización
- 21 sept 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.
Claude Code y AGENTS.md: cómo activar las instrucciones compartidas
Configura Claude Code para que lea AGENTS.md, elige el modo correcto, comprueba qué archivo carga y evita fallos por proveedor, versión o configuración.19 sept 2026Build
Claude Code MCP: cómo ajustar la espera de inicio
Configura el tiempo de espera de Claude Code MCP al iniciar trabajos automáticos, separa los cuatro límites y evita resultados parciales o incompletos.17 sept 2026Build
Bloquear bots de IA en Cloudflare sin cerrar el paso a los buscadores
Configura Cloudflare para bloquear bots de IA dedicados al entrenamiento sin cerrar el acceso de los buscadores. Revisa la migración y el robots.txt.16 sept 2026Build
Voz a texto con Murmure: análisis a fondo
Probamos Murmure para convertir voz a texto sin conexión: precisión, diccionario, reglas, requisitos, límites y uso de LLM locales o remotos.14 sept 2026Build
API FFmpeg: cuánto cuesta RenderIO y qué plan conviene
Compara precios, créditos, límites y sobrecostos de RenderIO para saber cuándo convienen Starter, Growth o Business en una API FFmpeg de producción.14 sept 2026Build
Voz a texto con Dictare: precio real y costos ocultos
Dictare convierte voz a texto por $0 y sin suscripción. Comparamos sus costos reales, límites y alternativas para saber cuándo conviene usarlo.13 sept 2026Build
Evals de Claude Code: cómo medir el aporte real de un plugin
Guía práctica para ejecutar evals de Claude Code, comparar un plugin con una línea base sin plugin y controlar costos antes de llevar la prueba a CI.12 sept 2026Build