Modelos de IA locales y API: alternativas a Jev en 2026
Compara alternativas a Jev: modelos de IA locales y API de Perplexity, Clef, Microsoft, OpenAI, Liquid y Strands, con precios, licencias y límites.
Publicado el
 Por Omid Saffari






Al comparar modelos de IA locales y API como alternativas a Jev, la API de Perplexity, a $0.02 por millón de tokens de entrada, es la primera que conviene evaluar para reducir la factura de un servicio alojado. Clef-flash encaja mejor si la aplicación ya funciona en Cloudflare, mientras que Liquid AI d1-3B es el punto de partida para tomar decisiones con imágenes en local. Con un millón de decisiones mensuales y 1,000 tokens de entrada facturados por decisión, pasar de Jev a Perplexity ahorra apenas $22 en cargos base de entrada. Elige la alternativa que mantenga la tasa de error que puedes aceptar y funcione donde la aplicación lo necesita.
Precios, licencias y documentación de despliegue verificados el 11 de octubre de 2026. Los precios que siguen proceden de cada proveedor. Los importes mensuales son cálculos basados en los supuestos indicados, no facturas de una prueba en producción. No se ejecutó ningún modelo para esta comparativa.
Modelos de IA locales y API: ¿qué alternativa a Jev encaja con cada tarea?
Empieza por las restricciones de despliegue y después compara la calidad con las decisiones de tu propia aplicación. En una API alojada, el proveedor se encarga de operar el modelo. Que los pesos sean abiertos significa que puedes obtener los archivos del modelo y ejecutar la inferencia por tu cuenta, con las condiciones de su licencia; no significa que alguien aporte el cómputo gratis.
Los precios de los servicios alojados no indican el costo de ejecutar la inferencia en infraestructura propia. En los modelos descargables de Liquid y Strands, no publicado significa que las páginas del proveedor no ofrecen una tarifa fija por tokens de entrada. El hardware, la energía, el alojamiento y la operación siguen teniendo un costo. Los detalles de las licencias y los checkpoints aparecen en sus respectivos apartados.
La referencia actual de TypeSafe es Jev 1.13, con el identificador de modelo jev-1.13.0, a $0.042 por millón de tokens de entrada y salida gratuita. Acepta texto y texto estructurado, como JSON, pero no imágenes, audio ni video. Por tanto, Microsoft iguala la tarifa de entrada publicada de Jev; OpenAI cuesta más con su tarifa base, y Perplexity y Clef-flash cuestan menos. Catálogo de modelos de TypeSafe
Una integración existente con Jev ya tiene algo valioso: la definición de las decisiones que necesita la aplicación. Consérvala. Si los tickets de facturación deben ir a finanzas y los problemas de acceso a soporte, la alternativa tiene que demostrar que resuelve esos casos antes de que un resultado llamativo en un benchmark incline la elección.
Cómo se seleccionaron las alternativas
La selección prioriza modelos con una API, ficha o repositorio mantenidos por su creador, y con documentación suficiente para decidir cómo desplegarlos. Los clones comunitarios sin una página verificada de su creador quedan fuera de esta comparativa. La lista reúne seis proveedores en siete opciones de compra: la familia de Cloudflare comparte apartado, mientras que los dos modelos de Liquid necesitan recomendaciones separadas.
Los criterios son prácticos: tipos de entrada necesarios, ejecución alojada o local, licencia de los pesos, algún límite documentado que pueda impedir el trabajo y costo de una decisión útil. Una decisión útil es aquella que la aplicación puede aceptar sin una corrección costosa ni una derivación innecesaria.
El orden empieza por el candidato alojado más sólido para reducir el precio, continúa con las opciones que encajan en determinadas plataformas y termina con las alternativas locales. No es una clasificación por precisión. Las pruebas de los proveedores emplean distintos conjuntos de datos, hardware, longitudes de entrada y rutas de red. Todas las cifras de rendimiento citadas aquí son datos publicados por el proveedor; ninguna demuestra que un modelo vaya a superar a Jev con tus tickets.
También hay que delimitar la tarea. Estos modelos eligen o puntúan entre resultados definidos. Si necesitas redactar una respuesta de soporte o una explicación, conserva un paso de generación. La comparativa entre Jev y GLM-5.3-Flash analiza esa elección más amplia.
Las siete opciones que conviene evaluar
1. Perplexity pplx-decider-v1.1-27b: el punto de partida para pagar menos por una API alojada
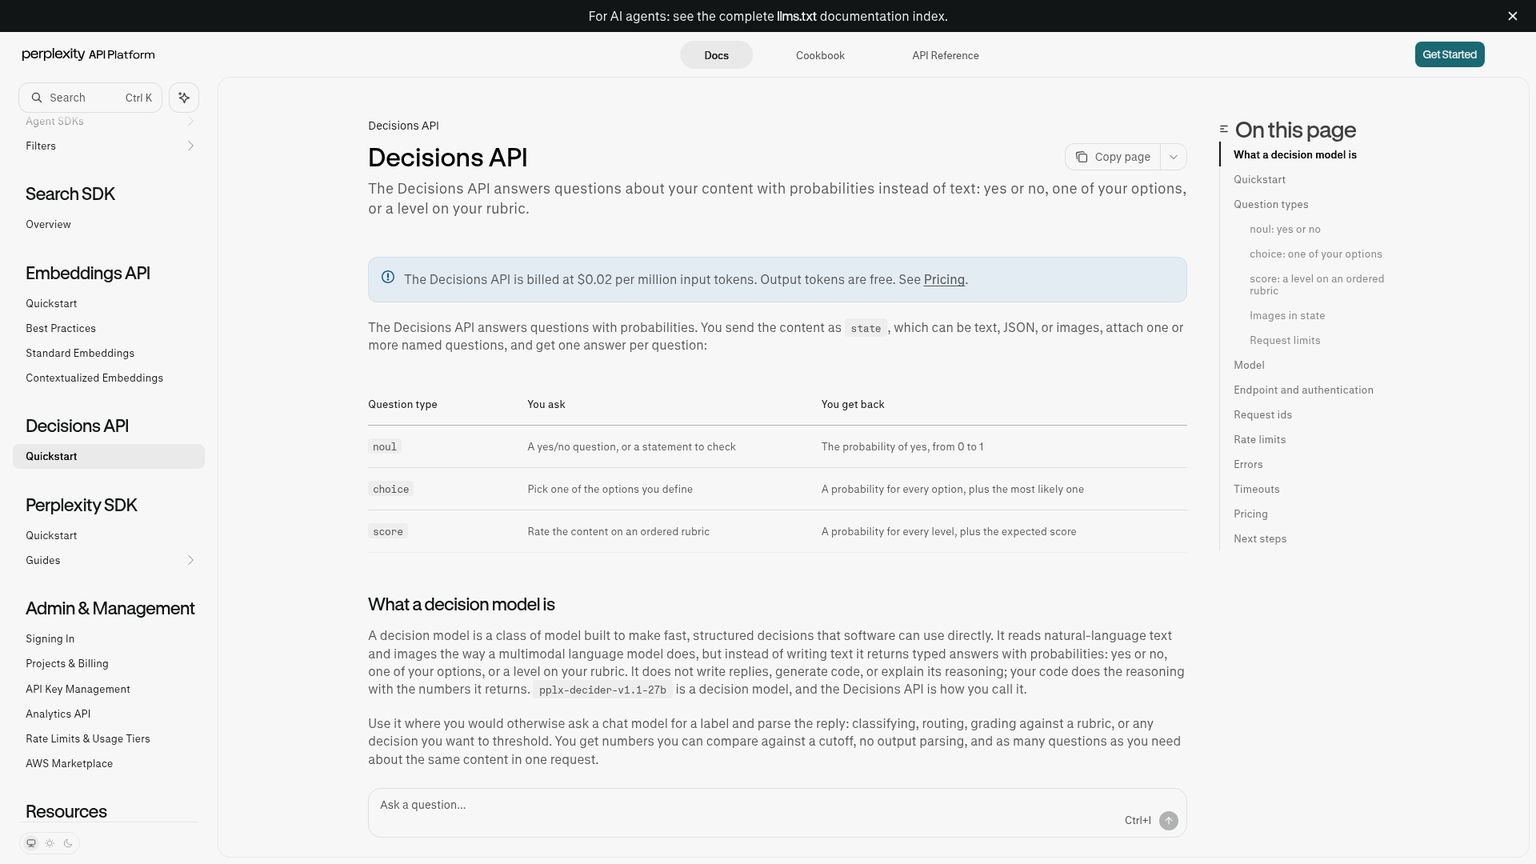
Perplexity pplx-decider-v1.1-27b es un modelo de decisiones disponible tanto mediante Decisions API, alojada por Perplexity, como en un checkpoint descargable. Es el primer candidato que evaluaría para asignar tickets de soporte habituales o etiquetar en volumen cuando el objetivo sea reducir el costo de entrada de Jev. Tiene la tarifa alojada publicada más baja de esta selección. La recomendación cambia si su límite de solicitudes, los requisitos para ejecutarlo en local o su tasa de error no sirven para tu carga de trabajo.
Ideal para: Enrutamiento, etiquetado y puntuación según una rúbrica a menor costo en un servicio alojado.
Lo más destacado: Una API directa y una vía independiente de despliegue con pesos abiertos.
Precio: $0.02 por 1M de tokens de entrada; salida gratuita y sin cargo por solicitud.
Prueba gratuita: No publicada en la guía de Decisions citada.
Entradas y ejecución: Texto, JSON e imágenes incluidas en la solicitud a la API de Perplexity; hardware CUDA para la implementación local suministrada.
Licencia: Apache-2.0 para el checkpoint descargable; el acceso alojado sigue siendo un servicio aparte. Guía de la API, licencia del checkpoint
El límite del servicio alojado está en el caudal de solicitudes: Perplexity documenta 10 solicitudes por segundo y por organización en todos los planes. Permite hasta 128 preguntas sobre información compartida, con una entrada total inferior a 262,144 tokens. Límites de las solicitudes Un lote de tickets de clientes distintos no se convierte automáticamente en una solicitud con estado compartido porque todos necesiten una etiqueta. Evita agrupar casos sin relación de una forma que cambie la tarea. Límites del servicio alojado
Con ese límite, un millón de solicitudes independientes tardaría como mínimo 27.8 horas, incluso con una programación perfecta y sin reintentos. Es un mínimo calculado, no una medición de velocidad. Procesar un histórico durante la noche y atender un flujo continuo de pocos tickets imponen exigencias muy distintas a la misma API económica.
La ejecución en infraestructura propia tiene otro límite. La configuración que proporciona el creador requiere aproximadamente 49 GiB para los pesos, más memoria de trabajo, y su implementación de prepare rechaza entradas combinadas de más de 8,192 tokens. Es necesario conservar los ajustes de atención y calibración utilizados en la evaluación. La ficha también mantiene una referencia al acceso autenticado a un repositorio privado: comprueba que tu cuenta puede descargar el checkpoint antes de comprometerte con un despliegue local. Ficha del modelo de Perplexity
No copies el límite de contexto del servicio alojado en una tarea de despliegue local. La implementación local debe evaluarse como un entorno de ejecución propio, incluidos su preprocesamiento real, consumo de memoria y revisión del modelo. De lo contrario, la alternativa de respaldo puede fallar precisamente con los registros largos que causaron problemas al servicio principal.
- La tarifa de entrada alojada publicada más baja de estas alternativas.
- Texto e imágenes pueden compartir una misma solicitud de decisión.
- El checkpoint Apache-2.0 ofrece una vía más allá del servicio alojado.
- El límite de solicitudes por organización puede frenar el procesamiento de históricos o los picos de tráfico.
- La configuración local suministrada requiere bastante memoria de GPU.
- Los límites de entrada del servicio alojado y de la implementación local de referencia difieren mucho.
Para la primera comparativa, delimita la tarea lo suficiente como para poder revisar los errores directamente.
Conserva las definiciones actuales de las colas
Parte de las etiquetas y los casos límite de tu implementación con Jev. Mantén una opción explícita de otro o revisión para los tickets que no encajen en esas definiciones. La guía de enrutamiento de tickets de soporte con Jev ofrece un flujo de referencia para comparar.
Usa el formato nativo de solicitud de Perplexity
Configura el modelo como
pplx-decider-v1.1-27by envíastatejunto conquestionsidentificadas por nombre aPOST /v1/decisions. Usa una preguntachoiceconcriteriaque describan cada cola. Sigue la referencia nativa de la API para respetar el contrato de solicitud y respuesta.Registra las respuestas sin cambiar las asignaciones
Lee la respuesta bajo el nombre de su pregunta. Guarda la etiqueta elegida, las probabilidades devueltas, el uso de entrada facturado y el estado de la solicitud junto al resultado actual de Jev. Distingue los fallos del proveedor de las decisiones válidas con poca confianza.
Define las condiciones del cambio antes de conocer al ganador
Fija una tasa aceptable de asignaciones incorrectas, un volumen de revisión y un plazo de respuesta. Pasa al candidato solo si cumple esas condiciones en trabajo representativo y etiquetado. Una factura de entrada menor no basta para aprobar el cambio.
2. Cloudflare Clef, Clef-flash y Clef-omni: elige según las entradas que necesitas
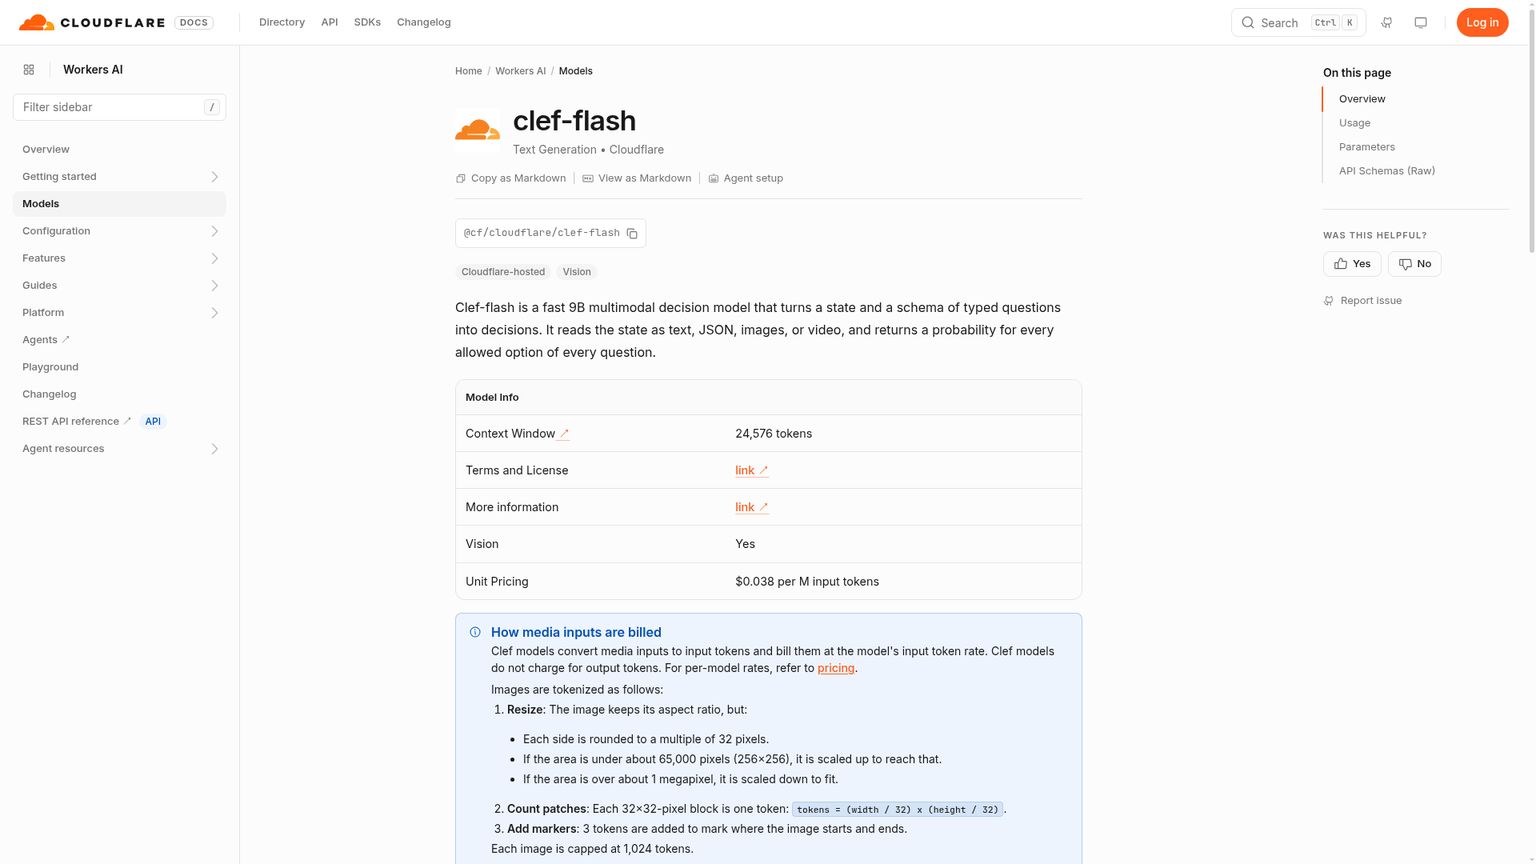
Cloudflare Clef-flash es la primera opción práctica cuando la decisión debe tomarse dentro de una aplicación que ya está en Workers. La familia combina alojamiento en Workers AI con pesos Apache-2.0, por lo que permite evaluar un despliegue gestionado y conservar la posibilidad de ejecutarlo después en infraestructura propia. Elige la variante según la información que deba leer y los límites del endpoint alojado. El miembro más barato de la familia no sustituye la compatibilidad con audio ni un contexto suficiente.
Ideal para: Enrutamiento y clasificación cerca de una aplicación de Workers.
Lo más destacado: Bindings de Workers AI y acceso REST, además de pesos descargables.
Precio: Clef-flash $0.038; Clef $0.240; Clef-omni $0.150 por 1M de tokens de entrada.
Prueba gratuita: Workers AI ofrece una asignación diaria gratuita compartida, no una prueba ilimitada e independiente de Clef.
Entradas y ejecución: Clef y Clef-flash procesan texto, JSON, imágenes y fotogramas de video; Clef-omni añade entrada directa de audio y video con sonido. Ejecución alojada en Workers AI o en tu propia infraestructura de inferencia.
Licencia: Pesos Apache-2.0 en los tres casos. Precios de Workers AI, lanzamiento original, ficha de Clef-omni
Clef y Clef-flash llegaron el 1 de octubre de 2026; la actualización del 9 de octubre incorporó Clef-omni y cambió las condiciones que hay que sopesar en el servicio alojado. El cambio más relevante es que Clef-flash tiene ahora una ventana de contexto alojada de 24,576 tokens. El texto del estado puede truncarse para ajustarse a ella. Por eso, un historial largo de incidentes puede perder información importante aunque la aplicación reciba una respuesta. Documentación actual de Clef-flash, actualización de octubre
Por eso, un formulario de entrada breve es una mejor primera tarea para flash que un archivo de conversaciones sin límite. Reserva un presupuesto de entrada explícito para la política de asignación y la información decisiva del cliente. Si acortas el registro antes de enviarlo, evalúa esa versión reducida, no una transcripción completa idealizada.
Cloudflare Clef es la opción de mayor tamaño para texto e imágenes, con un contexto alojado de 65,536 tokens. Su precio más alto merece consideración cuando la evaluación demuestra una mejora útil o el contexto alojado de flash se queda corto. El mayor tamaño no le otorga una ventaja automática de calidad. Documentación de Clef
Cloudflare Clef-omni es el candidato pertinente cuando la información incluye sonido. Una aplicación de servicio técnico en campo podría necesitar clasificar una grabación de una máquina junto con la descripción de un técnico. La diferencia está en la entrada directa de audio y video: no se limita a extraer fotogramas y esperar que contengan la respuesta. Su documentación especifica un contexto de 64,000 tokens, con límites independientes para medios, entre ellos clips de audio de hasta 300 segundos y videos de hasta 60 segundos, además de topes de cantidad y bytes. Documentación de Clef-omni
Que los pesos sean abiertos no convierte al modelo omni en una opción para ejecutar en un teléfono. La configuración de referencia de Cloudflare indica unos 64 GB de memoria de GPU para su modelo base en bfloat16. Es un requisito de ejecución que debes presupuestar, no un cargo por token del servicio alojado. Ficha de Clef-omni
La asignación gratuita de Cloudflare de 10,000 Neurons al día es capacidad compartida de Workers AI; Neurons es su unidad de facturación de cómputo. Superar esa asignación requiere Workers Paid. Trata las tarifas por token como cargos del modelo e incluye el resto de la suscripción a Workers y el uso de la aplicación en el presupuesto del despliegue. Asignación y reglas de facturación
- La integración nativa con Workers evita añadir otra plataforma de aplicaciones.
- Los pesos Apache-2.0 mantienen abierta la opción de usar infraestructura propia.
- La familia abarca desde el enrutamiento habitual de texto hasta decisiones con audio y video.
- El contexto alojado de Clef-flash es menor de lo que sugieren las descripciones iniciales del lanzamiento.
- Truncar un estado largo puede eliminar la información que necesita la decisión.
- Alojar Clef-omni por cuenta propia exige mucha memoria en la configuración documentada.
3. Microsoft-Decision-1: etiquetado y controles para agentes en Foundry
Microsoft-Decision-1 es un modelo alojado que puntúa decisiones, orientado a quienes ya desarrollan en Microsoft Foundry. Sus $0.042 por millón de tokens de entrada igualan la tarifa publicada actual de Jev, de modo que conviene evaluarlo por su encaje en la plataforma y la calidad en la tarea, más que por un ahorro directo en tokens. El etiquetado de comentarios o un control que permita a un agente continuar, reintentar o escalar son puntos de partida razonables. La solicitud documentada acepta texto o JSON; no deduzcas que admite imágenes por la familia del modelo base. Anuncio de Microsoft, guía de Foundry
Ideal para: Etiquetado, priorización y controles para agentes en un despliegue de Foundry.
Lo más destacado: Un proceso de despliegue documentado en Foundry con Entra ID o una clave de API.
Precio: $0.042 por 1M de tokens de entrada; salida gratuita.
Prueba gratuita: No publicada en las páginas citadas sobre el modelo de decisiones.
Entradas y ejecución: Texto o JSON; Microsoft Foundry y OpenRouter.
Licencia: Servicio alojado; estas páginas del proveedor no publican una licencia para descargar los pesos. Precios y acceso de Microsoft, requisitos de despliegue
La publicación de Microsoft del 9 de octubre de 2026 identifica Qwen3.5-9B como modelo base. La posibilidad de adoptar otros modelos base se presenta como un plan futuro, no como la arquitectura que se ofrece hoy. Del mismo modo, que el modelo base sea abierto no otorga permiso para descargar el modelo de Microsoft tras su entrenamiento posterior. Esta es una opción alojada mientras Microsoft no publique los pesos por separado. Fuente sobre la arquitectura
La ventaja operativa es poder evaluar dentro de la plataforma que ya usa la aplicación. Supongamos que un modelo general etiqueta los comentarios de los clientes antes de que un responsable de producto lea el informe semanal. Define los temas y una opción sin clasificar, compara ambos sistemas con los mismos comentarios y revisa si los más vagos reciben etiquetas demasiado específicas. Una etiqueta con una estructura perfecta también puede distorsionar el informe.
Microsoft declara la mayor precisión media en su comparativa de 36 benchmarks. Es un resultado publicado por el proveedor, y su comparativa de latencia mide Microsoft-Decision-1 a través de Foundry en la misma región. Esas condiciones importan: no establecen el tiempo de respuesta desde tu aplicación ni la precisión con tu taxonomía interna. Descripción de la evaluación de Microsoft
Los requisitos de despliegue son concretos. Necesitas un proyecto de Foundry, permisos para desplegar modelos y un método de autenticación; no basta con cambiar el nombre del modelo en un SDK ajeno. La guía documenta decisiones numéricas, no una explicación redactada. Si el flujo de trabajo debe justificar una etiqueta ante un revisor, conserva la información que la respalda y genera la explicación en otro paso. Configuración de Foundry y contrato de salida
- Encaja con los procesos existentes de identidad y despliegue de Foundry.
- Admite decisiones binarias, selección entre opciones y puntuación ordinal.
- El anuncio de Microsoft indica una tarifa de entrada clara.
- No ahorra frente a Jev en la tarifa base de entrada.
- Las páginas del proveedor no establecen una vía de despliegue con pesos abiertos.
- La entrada documentada es texto/JSON; no se promete un sustituto multimodal.
4. OpenAI Decisions API: para aplicaciones que ya integran OpenAI
OpenAI Decisions API convierte texto e imágenes en respuestas tipadas mediante gpt-6-luna. Es un candidato razonable si la aplicación ya usa OpenAI y quieres incorporar clasificación, selección entre opciones delimitadas o puntuación según una rúbrica dentro de esa integración. A $0.10 por millón de tokens de entrada, su capa de decisiones resulta más cara que Jev con la tarifa base. Elígela si la integración o la calidad medida en la tarea justifican la diferencia. Guía de OpenAI Decisions
Ideal para: Etiquetas y controles con texto e imágenes en una aplicación que ya usa OpenAI.
Lo más destacado: Respuestas predicate, choice y score desde un endpoint dedicado.
Precio: $0.10 por 1M de tokens de entrada con la tarifa base; sin cargos por salida, lectura de caché ni escritura en caché. Se aplican recargos regionales y multiplicadores de entrada para contextos largos.
Prueba gratuita: No publicada en la guía de Decisions.
Entradas y ejecución: Texto e imágenes incluidas en la solicitud a través del endpoint alojado POST /v1/decisions.
Licencia: Acceso a una API alojada; la guía no facilita una licencia de distribución de pesos abiertos. Guía y precios actuales
La API entró en beta pública el 6 de octubre de 2026. Ten en cuenta ese estado al decidir el despliegue. Una API nueva puede merecer una evaluación, pero antes de usarla como respaldo hay que demostrar que funciona con tu procesamiento de respuestas, manejo de excepciones y acceso de cuenta. Registro de cambios de OpenAI
El obstáculo de la migración es el contrato de solicitud y respuesta. OpenAI usa input y un array de preguntas con nombre; su tipo de respuesta sí/no es predicate. No puedes reenviar sin cambios un objeto de preguntas con el formato de Jev. La respuesta también puede incluir una negativa a responder, que debe tratarse por separado de una probabilidad. Patrones de solicitudes y respuestas
Por ejemplo, un flujo de devoluciones puede preguntar si una foto del producto muestra daños visibles y seleccionar la cola de revisión correspondiente. Eso no determina quién causó el daño, si se aplica la garantía o si el reembolso está autorizado. Son decisiones independientes que requieren otra información o reglas de negocio fijas.
- Permite evaluar texto e imágenes juntos.
- Las respuestas tipadas evitan tener que interpretar una etiqueta redactada.
- La guía específica distingue la facturación de decisiones de la de otros endpoints de modelos.
- La tarifa base de entrada supera la de Jev y las alternativas alojadas más baratas.
- El estado de beta pública influye en la planificación del despliegue.
- Los formatos nativos de solicitud y el tratamiento de las negativas requieren un adaptador.
5. Liquid AI d1-3B: por dónde empezar con texto e imágenes en local
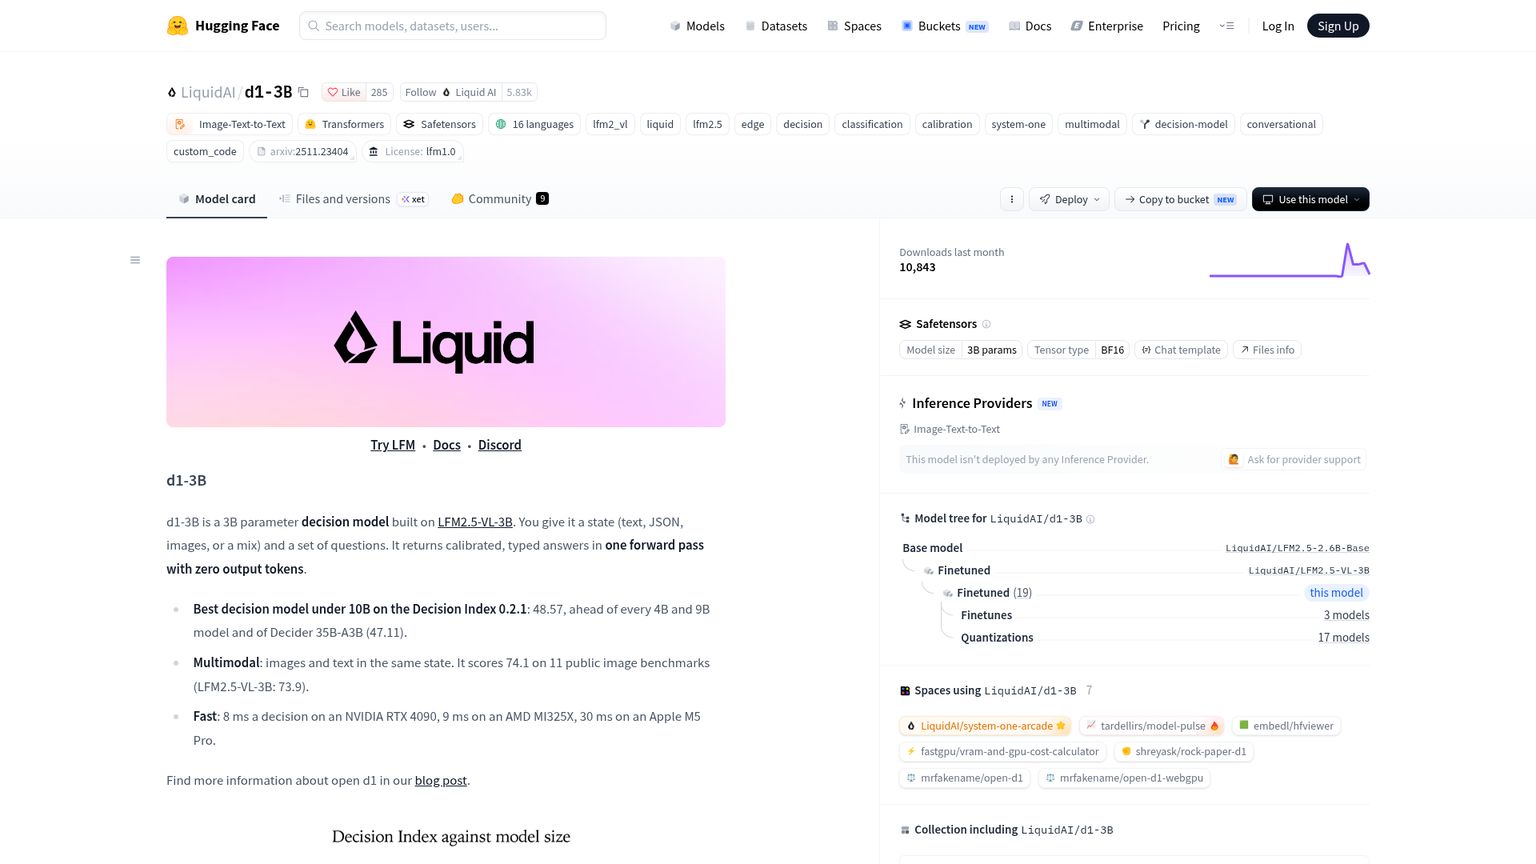
Liquid AI d1-3B es un modelo de decisiones con pesos abiertos para entradas de texto e imágenes, publicado el 7 de octubre de 2026. Es el primer candidato local de esta selección que evaluaría para una aplicación de escritorio o en el dispositivo que deba clasificar tanto una descripción como una imagen. Su atractivo está en controlar dónde se ejecuta la inferencia. No promete que operar una GPU salga más barato que una API alojada de precio muy bajo. Lanzamiento de Liquid AI
Ideal para: Clasificación local de imágenes, comprobaciones visuales y enrutamiento de texto.
Lo más destacado: Un modelo descargable con mediciones documentadas en hardware local.
Precio: Por 1M de tokens de entrada: no publicado para este checkpoint abierto. Debes presupuestar tu propio cómputo.
Prueba gratuita: Pesos descargables sujetos a la licencia; el cómputo se paga aparte.
Entradas y ejecución: Texto, JSON e imágenes; los ejemplos del creador admiten CUDA, Apple MPS y CPU mediante código personalizado de Transformers.
Licencia: LFM Open License v1.0. Ficha del modelo, licencia de los pesos
El modelo se basa en LFM2.5-VL-3B y documenta un contexto de 32,768 tokens. Piensa en una herramienta de escritorio para revisar la calidad: un operador aporta una imagen del producto y selecciona una pregunta de inspección conocida. La ejecución local permite que la aplicación siga funcionando sin llamar a un servicio alojado de decisiones, siempre que el resto del flujo también sea local. Sigue siendo necesario validar las condiciones de la cámara, el cambio de tamaño de las imágenes y la definición de defecto. Arquitectura y contexto
Liquid publica tiempos para una sola pregunta de 16 ms en Jetson AGX Thor, 26 ms en AGX Orin y 50 ms en Orin Nano. Son mediciones en hardware publicadas por el proveedor, no una promesa para el tamaño de tus entradas ni una comparativa con una solicitud completa a una API por internet. Úsalas para identificar hardware que merezca una evaluación y después mide la aplicación completa. Tabla de tiempos de Liquid
La licencia condiciona la compra. Ambos checkpoints de Liquid usan LFM Open License v1.0, cuya condición de uso comercial hace referencia a un umbral de ingresos anuales de $10 millones. Revisa la entidad jurídica definida y la Sección 5 antes de dar por hecho que tu despliegue cumple; confirma las condiciones con Liquid si te afectan. No marques este modelo como Apache-2.0 en una ficha de compras. Texto de la licencia
También conviene distinguir los nombres. Liquid presenta d1 alojado por separado de d1-3B y d1-omni-600M. La documentación y el anuncio del servicio alojado explican que solo se factura la entrada, pero las páginas revisadas para esta comparativa no publican una tarifa en dólares por millón. No traslades la tarifa ni los límites del modelo alojado a estas versiones descargables. Catálogo de modelos de Liquid, guía de d1 alojado
Para un producto sin conexión, la condición del cambio es que el modelo alcance la calidad y latencia exigidas en el dispositivo de destino real. Pruébalo con el resto del software en marcha, imágenes realistas y uso sostenido. Una inferencia aislada que sale bien es solo el comienzo de una decisión sobre capacidad.
- Mantiene la inferencia de decisiones en hardware que tú operas.
- Admite tanto texto como imágenes.
- Las mediciones del creador señalan hardware concreto para evaluar la ejecución en el dispositivo.
- Hay que revisar las condiciones de uso comercial de LFM.
- La infraestructura de inferencia, la capacidad y el mantenimiento del entorno de ejecución quedan a tu cargo.
- Poder descargarlo no implica una factura de inferencia fija ni nula.
6. Liquid AI d1-omni-600M: decisiones de voz acotadas, con los límites de un modelo experimental
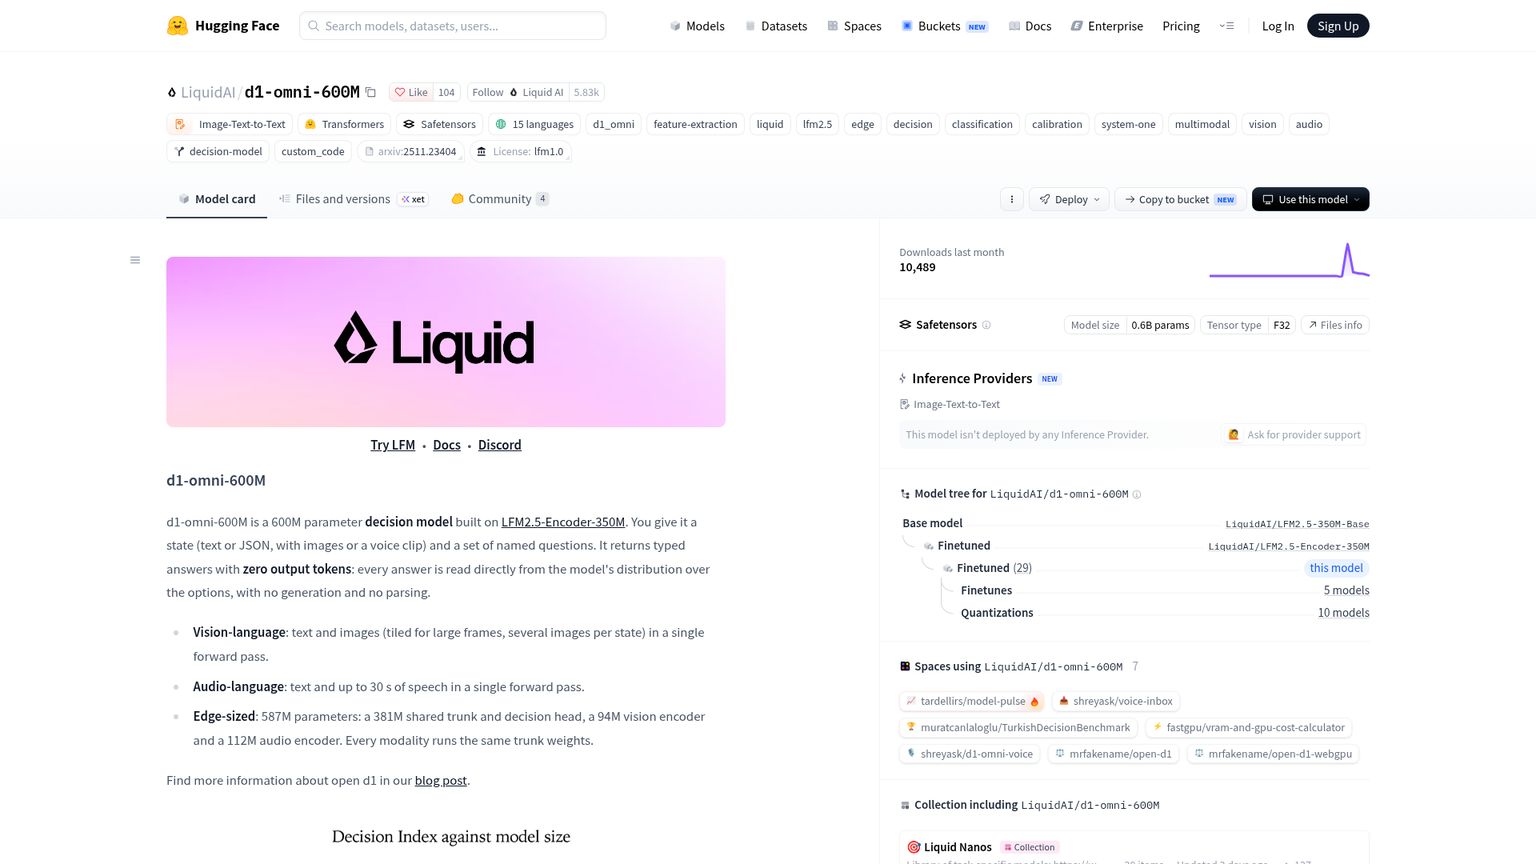
Liquid AI d1-omni-600M es el modelo hermano compacto y experimental para texto con imágenes o texto con audio. Merece entrar en la selección para un dispositivo que deba distinguir un pequeño conjunto de intenciones expresadas por voz; no hay que asumir que sustituye a cualquier servicio multimodal alojado. Su tamaño hace interesante la ejecución local, pero los límites de entrada y entrenamiento son decisivos. Un piloto de comandos de voz es una tarea más acotada que analizar grabaciones sin restricciones. Estado del lanzamiento, ficha del modelo
Ideal para: Experimentos de reconocimiento de intenciones por voz o decisiones con imágenes en dispositivos pequeños.
Lo más destacado: Un checkpoint abierto y compacto con entrada de audio.
Precio: Por 1M de tokens de entrada: no publicado para este checkpoint abierto.
Prueba gratuita: Pesos descargables sujetos a la licencia; los costos de cómputo siguen a tu cargo.
Entradas y ejecución: Texto/JSON con imágenes o audio; ejemplos locales para CUDA, MPS o CPU.
Licencia: LFM Open License v1.0, con la misma condición de uso comercial. Ficha del modelo, licencia
La ficha documenta 587 millones de parámetros, con entrenamiento de audio basado en solicitudes entre una persona que habla inglés y un asistente. Los clips de audio se recortan a los 30 segundos. Por tanto, un comando como «pausa la inspección» es un objetivo de evaluación más adecuado que una llamada larga y multilingüe de un cliente. Admitir audio como entrada no demuestra rendimiento con cualquier clase de sonido. Alcance del audio
Hay un límite especialmente fácil de pasar por alto: el modelo tiene 16,384 posiciones de contexto en total, pero, con imágenes, el texto del estado y de la pregunta se recorta a 896 tokens. Un manual de operación largo adjunto a una imagen puede superar el límite de texto correspondiente mucho antes de lo que hace pensar la cifra total de contexto. Detalles del contexto
Para un quiosco, mantén concisas la lista de comandos y la política local, e incluye una vía para solicitudes no reconocidas. Evalúa el habla de fondo y la falta de contexto con el mismo cuidado que los comandos claros. Lo útil es un sistema que se abstenga cuando la instrucción no esté clara, en vez de ofrecer siempre una opción con apariencia válida.
El lanzamiento de Liquid no publica mediciones de velocidad de este modelo experimental. No le atribuyas los tiempos del modelo mayor d1-3B ni deduzcas una garantía de latencia de su menor número de parámetros. La aplicación aún debe procesar los medios, cargar el modelo y acomodar su ejecución a los recursos operativos del dispositivo. Alcance de las mediciones del lanzamiento
- Su tamaño reducido es pertinente para dispositivos locales con recursos limitados.
- Ofrece una vía de decisión con audio además de otra con imágenes.
- Los pesos abiertos permiten examinar y operar el despliegue.
- Es una versión experimental con un alcance documentado de entrenamiento de audio limitado.
- Las solicitudes con imágenes admiten mucho menos texto de lo que sugiere el contexto total.
- El lanzamiento no aporta un resultado de velocidad específico del modelo.
7. Amazon Strands Decider 2B: controles locales para agentes que puedes examinar
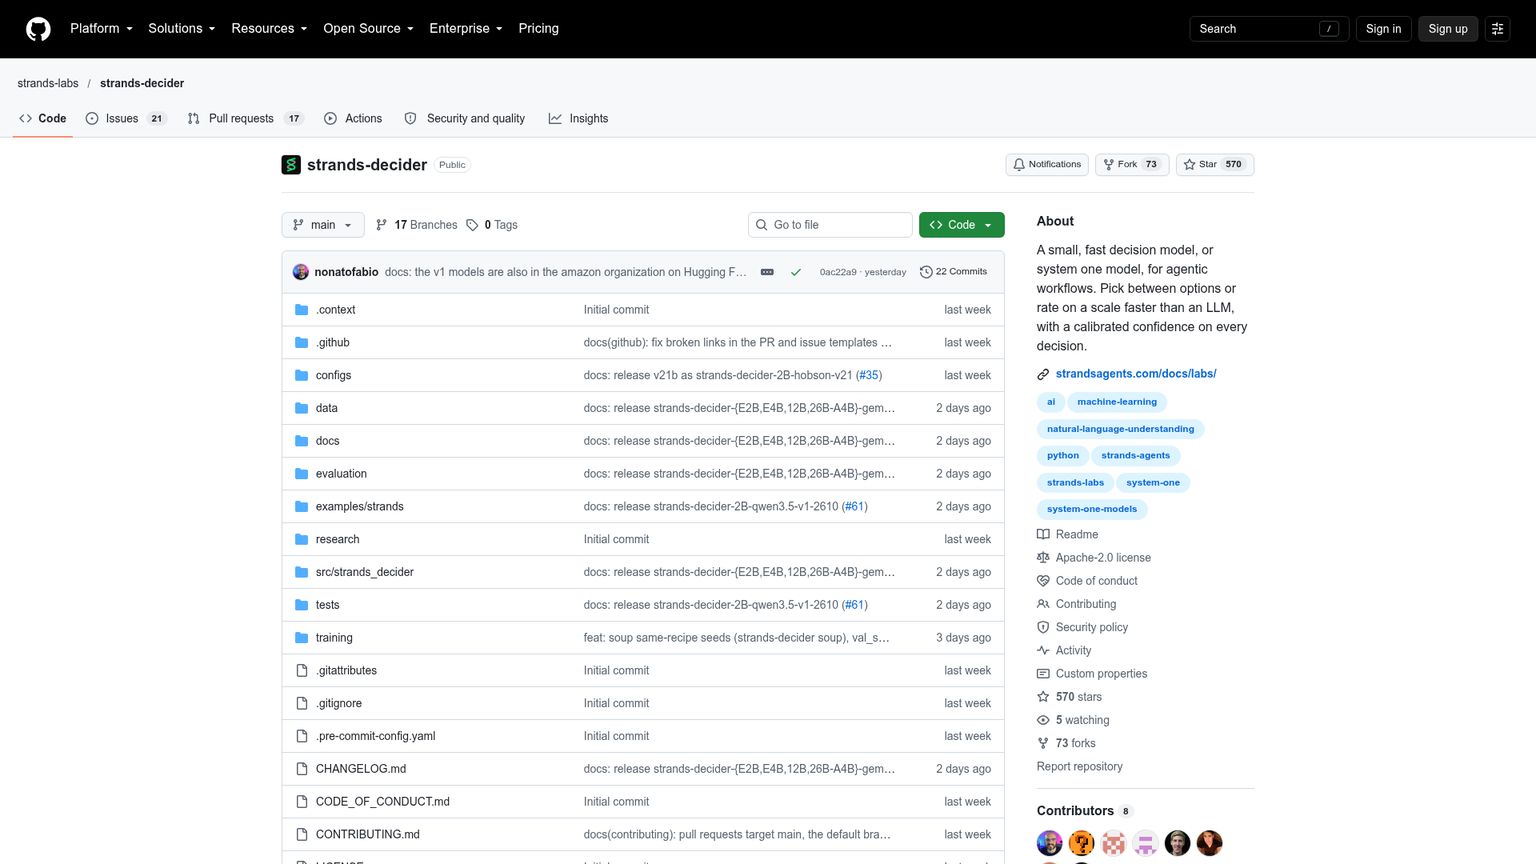
Amazon Strands Decider 2B es un modelo abierto de decisiones de Strands Labs, con código de inferencia, material de entrenamiento y evaluaciones publicados. Encaja mejor cuando el motivo para dejar una llamada alojada a Jev es controlar un pequeño componente de decisión dentro del entorno de ejecución de tu propio agente. Empieza por una tarea delimitada, como contrastar una acción propuesta con una política breve. No consideres el servidor local suministrado un producto alojado completo. Repositorio del creador
Ideal para: Controles locales para agentes, enrutamiento y experimentos con el método de entrenamiento.
Lo más destacado: Pesos, código y detalles de evaluación disponibles en un mismo proyecto.
Precio: Tarifa alojada por 1M de tokens de entrada: no publicada; tú aportas el entorno de ejecución.
Prueba gratuita: Modelo y código descargables con Apache-2.0; el cómputo va aparte.
Entradas y ejecución: Texto e imágenes opcionales mediante la vía de visión; opciones para CUDA, Apple Silicon y CPU.
Licencia: Apache-2.0 para el checkpoint basado en Qwen citado y para el proyecto. Ficha actual del modelo
Fija el checkpoint exacto: strands-decider-2B-qwen3.5-v1-2610 es la referencia actual descrita por el repositorio. Usa una base Qwen3.5-2B-Base con un adaptador entrenado y una cabeza de decisión, el componente que puntúa las respuestas permitidas. Los nombres anteriores hobson-v19 y hobson-v21 siguen visibles, así que toda afirmación de rendimiento debe ir acompañada de su versión. Versión y arquitectura
Esa distinción afecta al tiempo de 115 ms que suele citarse. La tabla detallada del repositorio atribuye esa mediana en RTX 3090 a v19, mientras que las columnas más recientes indican que comparten arquitectura y tamaño. Es una medición histórica publicada por el proveedor, no una medición nueva del checkpoint actual. Usa el dato vinculado al checkpoint que piensas desplegar. Tabla de rendimiento por versión
El servidor suministrado escucha en localhost y no tiene autenticación. Sirve para experimentar en local, pero un servicio de red también necesita control de acceso, planificación de concurrencia, responsables del despliegue y monitoreo. En un agente interno, su responsable debe decidir qué ocurre cuando el proceso del modelo aún no está listo, está ocupado o no está disponible. «Ejecutar en local» es una opción de despliegue, no una estrategia de disponibilidad. Instrucciones de ejecución del servicio
Un primer control concreto podría distinguir entre «la acción propuesta solo lee un registro» y «la acción propuesta modifica un registro». Las reglas fijas de la aplicación deben seguir comprobando los permisos del usuario y las operaciones permitidas. Si el modelo considera segura una operación pero el usuario autenticado no puede realizarla, la operación sigue bloqueada.
- El modelo y el código Apache-2.0 permiten operar el componente en local.
- El material de entrenamiento y evaluación publicado permite examinar los supuestos.
- Las opciones de CPU y Apple Silicon para un modelo pequeño amplían las posibilidades de evaluación.
- Aquí no se acredita una tarifa de entrada alojada ni un endpoint gestionado por el creador.
- Un servidor local de ejemplo no es un servicio de producción terminado.
- Las cifras históricas de latencia deben permanecer vinculadas al checkpoint medido.
Qué cambia en la factura mensual y qué queda fuera
Un gran ahorro porcentual puede representar pocos dólares. Supongamos un millón de decisiones al mes, cada una con 1,000 tokens de entrada facturados. Son mil millones de tokens de entrada. Con las tarifas base verificadas, la factura del modelo, contando solo la entrada, sería de $20 para Perplexity, $38 para Clef-flash, $42 para Jev o Microsoft-Decision-1, $100 para OpenAI Decisions, $150 para Clef-omni y $240 para Clef. Perplexity, Cloudflare, TypeSafe, Microsoft, OpenAI
El escenario iguala deliberadamente la cantidad de tokens facturables. Distintos tokenizadores, formas de organizar las preguntas y procesos de tratamiento de medios pueden generar diferentes totales facturados para la misma entrada de negocio. Las cifras excluyen asignaciones gratuitas, suscripciones a plataformas, recargos regionales o por contexto largo, reintentos, generación posterior y revisión por parte del personal.
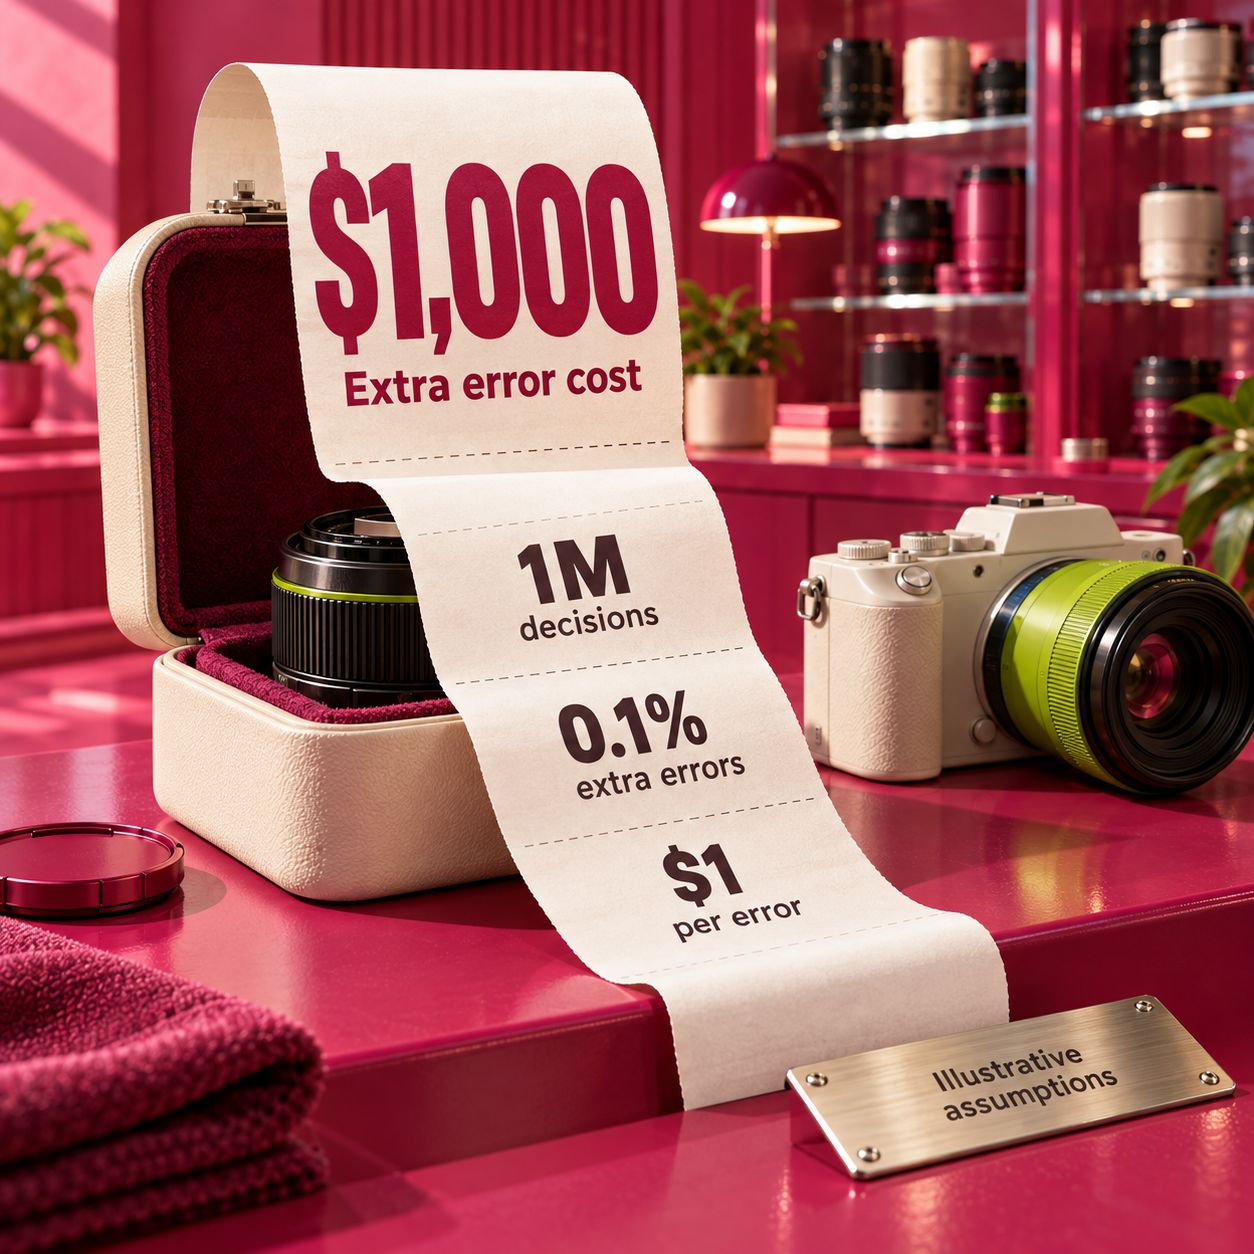
Supongamos ahora que un candidato genera 0.1 puntos porcentuales más de errores y que resolver cada error adicional cuesta $1. En un millón de decisiones, eso supone 1,000 errores adicionales y $1,000 de costo extra. Son supuestos ilustrativos, no tasas de fallo medidas ni un precio de mercado para el tiempo del personal. Muestran por qué conviene optimizar las decisiones aceptadas, en lugar de fijarse solo en el precio por token.
La infraestructura propia exige una comprobación parecida. Si tu presupuesto adicional de infraestructura fuera de $100 al mes, igualar la tarifa base de Perplexity de $0.02 por millón exigiría cinco mil millones de tokens de entrada al mes, sin contar todavía la operación ni las diferencias de calidad. Los $100 son un supuesto, no una cotización de GPU. Tener hardware disponible puede cambiar el cálculo; mantener los datos en local o sostener un producto sin conexión puede justificarlo incluso sin ahorro en tokens.
Mide la facturación con la carga de trabajo real antes de extrapolar. Por ejemplo, el servicio alojado d1 de Liquid, que es independiente, vuelve a contabilizar el texto y las imágenes aportadas para cada pregunta. Enviar varias preguntas en una misma llamada HTTP no implica, por tanto, pagar por esa información una sola vez. Esa regla de facturación no asigna una tarifa en dólares a sus checkpoints abiertos. Explicación de facturación de Liquid
¿Qué alternativa conviene llevar a producción?
Para el enrutamiento habitual, evalúa primero Perplexity si buscas reducir el costo del servicio alojado. Empieza por Clef-flash cuando seguir dentro de Workers simplifique la aplicación. La elección cambia según el candidato encaje con la frecuencia de solicitudes, la longitud de entrada y los límites medidos de asignaciones incorrectas y revisión. Ni una tarifa menor ni una plataforma conocida compensan perder la información que determina la cola correcta.
Para el etiquetado, prioriza el candidato que conserve tu taxonomía en ejemplos ambiguos. Microsoft-Decision-1 es un candidato natural para Foundry; Perplexity es la opción alojada guiada por el precio. Comprueba si un comentario puede pertenecer a más de un tema. Una pregunta de elección única impone un solo ganador: un problema de múltiples etiquetas debe descomponerse en comprobaciones separadas o representarse de otra forma deliberada.
Para los controles de agentes, elige un entorno de ejecución que puedas operar con fiabilidad y mantén la autoridad en el código. Conviene evaluar Strands para un componente local; Microsoft u OpenAI pueden encajar en una integración alojada ya establecida. El modelo puede aportar una estimación sobre la acción propuesta. La aplicación debe hacer cumplir por separado los permisos, las reglas de gasto y las operaciones autorizadas.
Para trabajar en el dispositivo, empieza con d1-3B para texto e imágenes y con d1-omni-600M para un experimento de voz acotado. Strands es otra opción local cuando su licencia y su método de entrenamiento documentado encajan mejor en el proyecto. El dispositivo, el preprocesamiento de entrada y el uso comercial permitido determinan esta elección antes que una comparativa de precios alojados.
Para decisiones con audio o video en una aplicación alojada, evalúa Clef-omni. Su forma de procesar medios marca una diferencia sustancial. Un modelo de texto más barato solo es una alternativa si añades deliberadamente un paso de preprocesamiento y validas qué información pierde ese paso.
Si necesitas un segundo proveedor, decide qué fallo quieres cubrir. Dos identificadores de modelo detrás de la misma pasarela siguen dependiendo de ella. Un respaldo local también falla si necesita el mismo servicio externo no disponible para recuperar su entrada. Dibuja la ruta completa de la solicitud y aísla la dependencia cuya caída quieres poder soportar.
Migra una decisión antes de cambiar todo el flujo
Un reemplazo funciona cuando conserva el contrato de decisiones de la aplicación, no solo cuando devuelve JSON válido. Mantén estables los nombres de las colas, el significado de las rúbricas y el comportamiento de respaldo mientras adaptas los campos propios de cada proveedor. Así podrás revisar los desacuerdos sin mezclar un cambio de modelo con uno de política.
Fija la decisión y la información que utilizará
Elige una llamada existente, como la asignación de cola de un nuevo ticket de soporte. Registra las etiquetas permitidas, la versión de la política, los campos de entrada y qué se considera información insuficiente. Incluye trabajo ambiguo y fuera de alcance en el conjunto etiquetado, no solo ejemplos evidentes.
Adapta la interfaz con el proveedor
Mapea de forma explícita la información, las definiciones de preguntas y la lectura de respuestas. OpenAI usa un campo de entrada y un array de preguntas con nombre; los ejemplos documentados de Perplexity y Microsoft usan un estado y preguntas organizadas por clave. El formato de envío de imágenes también difiere. Compruébalo en la guía nativa del creador, sin asumir que nombres parecidos de tipos básicos implican formatos de intercambio idénticos.
Ejecuta el candidato en paralelo con la decisión actual
Deja que el flujo actual mantenga el control mientras el candidato se limita a registrar su respuesta. Compara las decisiones incorrectas que se aceptan, las derivaciones, las solicitudes fallidas, el uso facturado y los tiempos de respuesta más lentos. Usa la misma información en ambos modelos para que un cambio de preprocesamiento no parezca una mejora del modelo.
Define umbrales para este modelo y esta tarea
Un umbral de Jev no es transferible solo porque otra API devuelva una probabilidad o un campo llamado confianza. Vuelve a comprobar la relación entre las puntuaciones y el acierto observado en ejemplos etiquetados. Establece una vía de revisión separada para la falta de información, los fallos del proveedor y las negativas a responder.
Pasa a producción gradualmente y facilita la vuelta atrás
Cambia solo el flujo seleccionado. Conserva la configuración del modelo anterior y una forma de volver a ella. Reevalúa cuando cambien el checkpoint, el alias del modelo, la redacción de las preguntas o el preprocesamiento, porque cualquiera de esos cambios puede alterar las decisiones que aceptan tus umbrales.
Si partes de Jev Router y no de una llamada directa de decisiones a Jev, identifica primero dónde se separan los cargos. El servicio de enrutamiento y el modelo posterior que selecciona son partes distintas de la factura. La guía de precios de Jev Router explica la diferencia: un modelo de decisiones barato no hace gratuita la respuesta generada.
Qué opciones conviene evitar y en qué casos
Evita migrar a Microsoft-Decision-1 para ahorrar en tokens si tu única queja es la tarifa base actual de Jev. Las tarifas publicadas coinciden. Puede seguir siendo una buena elección por plataforma o calidad, pero esa es otra justificación.
Evita Clef-flash alojado para un archivo de información sin límites salvo que controles el presupuesto de entrada. Una respuesta válida después de un truncamiento puede ocultar que un dato crítico nunca llegó al modelo. Usa una carga de trabajo que quepa o evalúa una vía con un contexto adecuado.
Evita d1-omni-600M para analizar grabaciones largas sin restricciones por la sola presencia de la palabra omni. El alcance documentado del habla, el recorte de clips y su estado experimental importan. Clef-omni es el candidato alojado de esta selección cuando se necesita mayor variedad de medios, con sus propios límites.
Evita usar pesos abiertos como sinónimo de servicio de producción gratuito. Liquid tiene una licencia condicionada, la configuración de referencia de Perplexity necesita mucha memoria y Strands deja el alojamiento a tu cargo. Descargar un modelo es el comienzo de un compromiso operativo.
Evita un clon sin verificar como respaldo de emergencia. Un nombre de producto parecido o un endpoint que parece compatible no acreditan un creador, una licencia utilizable, un entorno de ejecución mantenido ni una vía de fallo independiente. La exclusión se debe a la falta de información verificable, no a que todos los proyectos comunitarios rindan mal.
Preguntas frecuentes
¿Hay alternativas a Jev gratis?
Cloudflare ofrece una asignación diaria gratuita compartida de Workers AI. Varias alternativas también publican pesos descargables, pero el cómputo corre por tu cuenta y debes cumplir la licencia. Por separado, la documentación alojada de Liquid enumera un modelo d1:free solo de texto, sin publicar una asignación en la página revisada aquí. Una vía de acceso gratuita no garantiza un despliegue de producción sin costo. Guía del modelo alojado de Liquid
¿Qué alternativas a Jev tienen pesos abiertos?
La familia Clef, el checkpoint citado de Perplexity, los dos checkpoints d1 de Liquid y Strands Decider tienen vías de acceso a los pesos publicadas por sus creadores. Clef, Perplexity y el checkpoint citado de Strands usan Apache-2.0; Liquid usa LFM Open License v1.0 con una condición de uso comercial. OpenAI Decisions y Microsoft-Decision-1 son opciones alojadas en esta comparativa, sin una licencia de pesos abiertos facilitada por las páginas citadas de sus proveedores.
¿Qué alternativa a Jev debería probar primero?
Evalúa primero Perplexity para reducir la tarifa de entrada alojada, Clef-flash para una aplicación existente de Workers, Microsoft-Decision-1 para Foundry y OpenAI Decisions para una integración con OpenAI. Para la ejecución local, empieza por d1-3B para texto e imágenes, d1-omni-600M para un experimento de voz acotado o Strands para un componente de agente que puedas examinar. La evaluación con tu carga de trabajo determina la elección final.
El primer paso para el lunes
Elige la llamada de decisión cuyo responsable sepa explicar cómo sería un error costoso. Selecciona un candidato por el motivo que necesitas: precio, plataforma, entrada de medios o ejecución local. Compáralo junto a Jev con la misma información y cambia solo si los errores aceptados, la carga de revisión y los plazos de respuesta son satisfactorios. Mantén preparada la configuración original hasta que la nueva vía se haya ganado tu confianza con el trabajo habitual.
Usa la lista de verificación para auditar flujos de trabajo empresariales con IA e identificar qué decisión conviene cambiar primero.
- Publicado
- Categoría
- Build
- Idioma

API de decisiones de OpenAI: usos, costos y límites
Conoce la API de decisiones de OpenAI para clasificar tickets y evaluar acciones: ejemplos, precios, límites y criterios para decidir si conviene migrar.11 oct 2026Build
Claude Code Remote Control: sigue programando desde el móvil
Configura Claude Code Remote Control desde la terminal, VS Code o Desktop, conecta tu móvil o navegador y resuelve errores de acceso y conexión paso a paso.9 oct 2026Build
Programar desde el móvil: cómo usar Cursor desde el iPhone
Aprende a programar desde el móvil con Cursor: vincula tu iPhone, mantén accesible tu computadora y conoce las diferencias con los agentes en la nube.9 oct 2026Build
Firecrawl pricing: guía de precios, planes y créditos
Compara los precios de Firecrawl, el consumo de créditos y las recargas. Calcula cuánto pagarías por extraer páginas, generar JSON o rastrear cada semana.9 oct 2026Build
Mejor IA para programar en 2026: Claude Code o GitHub Copilot
Compara Claude Code y GitHub Copilot: precios, límites, modelos y controles de equipo. Elige la mejor IA para programar o calcula cuánto cuesta usar ambos.8 oct 2026Build
LangGraph vs CrewAI: cómo elegir para un agente en producción
LangGraph vs CrewAI: compara control del estado, memoria, MCP, revisión humana y precios con el mismo flujo para elegir tu framework de agentes de IA.7 oct 2026Build
Qué es MCP: crea un servidor en Python para tu equipo
Descubre qué es MCP y crea un servidor en Python para consultar pedidos. Pruébalo con Inspector, conecta Claude Code y Cursor y añade HTTP con autenticación.7 oct 2026Build