Decision Models 2026: Welche Jev-Alternative passt?
Decision Models als Jev-Alternativen: Perplexity, Clef, OpenAI, Microsoft, Liquid und Strands nach Preisen, Lizenzen und Einsatzmöglichkeiten vergleichen.
Veröffentlicht am
 Von Omid Saffari






Unter diesen Jev-Alternativen ist die API von Perplexity mit $0.02 pro Million Eingabetokens der erste Kandidat, wenn Decision Models die Kosten eines gehosteten Dienstes senken sollen. Clef-flash passt besser, wenn die Anwendung bereits auf Cloudflare läuft; für lokale Bildentscheidungen bietet sich Liquid AI d1-3B als Einstieg an. Bei einer Million Entscheidungen im Monat mit jeweils 1,000 abgerechneten Eingabetokens spart der Wechsel von Jev zu Perplexity allerdings nur $22 an Basiskosten für die Eingabe. Entscheidend ist eine Alternative, die am benötigten Einsatzort läuft und den Anteil akzeptierter Fehlentscheidungen nicht erhöht.
Preise, Lizenzen und Bereitstellungsdokumentation geprüft am 11. Oktober 2026. Die folgenden Preise stammen von den jeweiligen Anbietern. Die Monatsbeträge sind Berechnungen auf Basis der genannten Annahmen, keine Rechnungen aus einem Produktionstest. Für diesen Vergleich wurde keines der Modelle ausgeführt.
Decision Models als Jev-Alternativen: Welches Modell passt zu welcher Aufgabe?
Zunächst sollten die Anforderungen an den Betrieb feststehen. Danach lässt sich die Qualität anhand der eigenen Entscheidungsaufgaben vergleichen. Bei einer gehosteten API betreibt der Anbieter das Modell. Offene Gewichte bedeuten, dass sich die Modelldateien unter den jeweiligen Lizenzbedingungen herunterladen und selbst ausführen lassen. Kostenlose Rechenleistung gehört nicht dazu.
Die Preise der gehosteten Dienste gelten nicht für Inferenz im eigenen Betrieb. Bei den herunterladbaren Modellen von Liquid und Strands bedeutet nicht veröffentlicht, dass die Anbieterseiten keinen festen Tarif für Eingabetokens nennen. Hardware, Strom, Hosting und Betrieb verursachen weiterhin Kosten. Die Einzelabschnitte erläutern Lizenzen und Checkpoints genauer.
Als aktuelle Vergleichsbasis dient bei TypeSafe Jev 1.13 mit der Modell-ID jev-1.13.0 für $0.042 pro Million Eingabetokens; die Ausgabe ist kostenlos. Das Modell verarbeitet Text und strukturierten Text wie JSON, aber keine Bilder, Audio- oder Videodaten. Microsoft liegt damit beim veröffentlichten Eingabepreis gleichauf mit Jev. OpenAI ist im Basistarif teurer, Perplexity und Clef-flash sind günstiger. TypeSafe-Modellkatalog
Eine bestehende Jev-Integration enthält bereits etwas Wertvolles: die Definition der Entscheidungen, die die Anwendung treffen muss. Diese Definition sollte erhalten bleiben. Müssen Rechnungsanfragen an die Finanzabteilung und Probleme beim Kontozugriff an den Support gehen, sollte sich ein Ersatz zunächst an genau diesen Fällen bewähren. Erst danach sollten auffällige Benchmark-Ergebnisse die Auswahl beeinflussen.
Nach welchen Kriterien wurden die Modelle ausgewählt?
Bevorzugt wurden Modelle mit einer vom Anbieter gepflegten API, Modellkarte oder einem entsprechenden Repository sowie ausreichend dokumentierten Details, um über den Einsatz entscheiden zu können. Community-Klone ohne verifizierte Anbieterseite bleiben außerhalb dieses Vergleichs. Die Liste umfasst sechs Anbieter und sieben Auswahloptionen: Die Cloudflare-Familie steht in einem gemeinsamen Abschnitt, die beiden Liquid-Modelle erfordern jeweils eine eigene Empfehlung.
Die Kriterien orientieren sich am praktischen Einsatz: benötigte Eingabeformate, gehosteter oder lokaler Betrieb, Lizenz der Gewichte, dokumentierte Grenzen, an denen die Anwendung scheitern kann, und Kosten einer brauchbaren Entscheidung. Brauchbar ist eine Entscheidung, die die Anwendung ohne teure Korrektur oder unnötige Eskalation übernehmen kann.
Den Anfang macht der aussichtsreichste günstigere Kandidat unter den gehosteten Angeboten. Danach folgen Alternativen für bestimmte Plattformen und den lokalen Betrieb. Die Reihenfolge ist keine Rangliste der Genauigkeit. Anbietertests unterscheiden sich bei Datensätzen, Hardware, Eingabelängen und Netzwerkwegen. Sämtliche hier genannten Leistungswerte sind Angaben der Anbieter. Keiner davon belegt, dass ein Modell bei den eigenen Tickets besser abschneidet als Jev.
Auch der Aufgabenbereich ist klar begrenzt: Diese Modelle wählen zwischen vorgegebenen Ergebnissen oder bewerten sie. Für eine ausformulierte Supportantwort oder Erklärung bleibt ein Generierungsschritt nötig. Unser Vergleich von Jev und GLM-5.3-Flash beleuchtet diese weitergehende Entscheidung.
Sieben Optionen im Vergleich
1. Perplexity pplx-decider-v1.1-27b: Der erste Kandidat für niedrigere API-Kosten
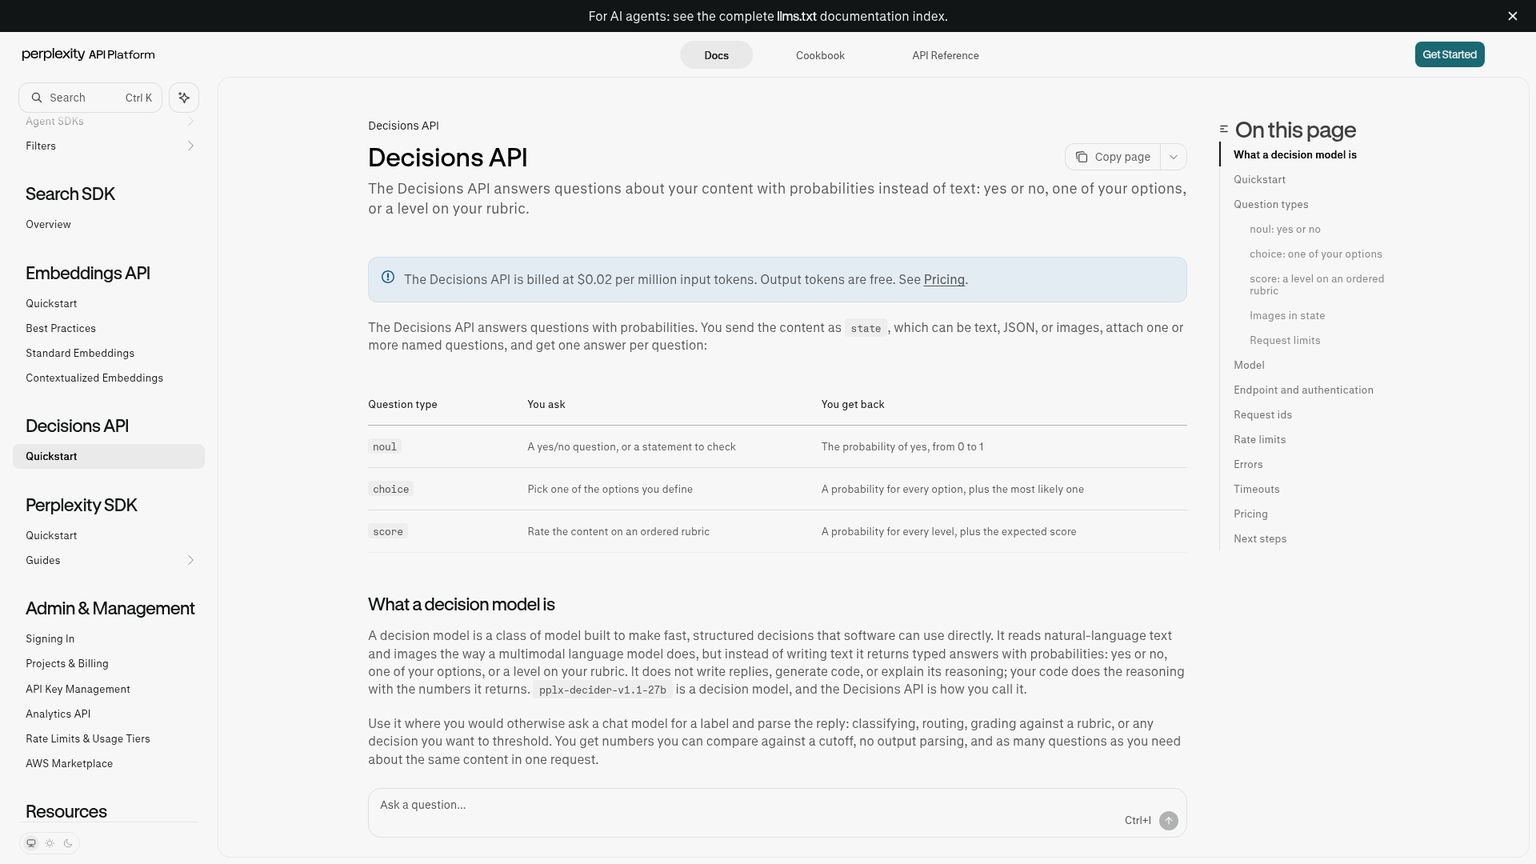
Perplexity pplx-decider-v1.1-27b ist ein Entscheidungsmodell, das über die gehostete Decisions API von Perplexity und als herunterladbarer Checkpoint verfügbar ist. Wenn es vor allem darum geht, die Eingabekosten von Jev zu senken, würde ich dieses Modell zuerst für gewöhnliches Support-Routing oder die Vergabe vieler Labels prüfen. Es hat den niedrigsten veröffentlichten Hosting-Tarif dieser Auswahl. Die Empfehlung gilt allerdings nur, solange Anfragelimit, Anforderungen an einen lokalen Betrieb und Fehlerquote zur eigenen Anwendung passen.
Geeignet für: Günstigeres gehostetes Routing, Labeling und Bewertungen anhand eines Kriterienrasters.
Besonderheit: Direkte API und zusätzlich ein eigener Bereitstellungsweg mit offenen Gewichten.
Preise: $0.02 pro 1M Eingabetokens; Ausgabe kostenlos; keine Gebühr pro Anfrage.
Kostenlos testen: In der verlinkten Decisions-Dokumentation nicht veröffentlicht.
Eingaben und Laufzeitumgebung: Text, JSON und direkt eingebettete Bilder über die Perplexity API; CUDA-Hardware für die mitgelieferte lokale Implementierung.
Lizenz: Apache-2.0 für den herunterladbaren Checkpoint; der gehostete Zugang bleibt ein separater Dienst. API-Dokumentation, Checkpoint-Lizenz
Beim gehosteten Dienst begrenzt der Durchsatz den Einsatz: Perplexity nennt 10 Anfragen pro Sekunde und Organisation in jedem Tarif. Möglich sind bis zu 128 Fragen auf Basis derselben Informationsgrundlage, bei einer gesamten Eingabe von unter 262,144 Tokens. Anfragelimits Ein Stapel unabhängiger Kundentickets ist nicht automatisch eine Anfrage mit gemeinsamem Zustand, nur weil alle Tickets ein Label benötigen. Werden zusammenhanglose Fälle gebündelt, darf das nicht die eigentliche Aufgabe verändern. Grenzen des gehosteten Dienstes
Bei diesem Anfragelimit dauern eine Million einzelne Anfragen selbst bei perfekter Planung und ohne Wiederholungen mindestens 27.8 Stunden. Das ist eine berechnete Untergrenze, kein gemessener Geschwindigkeitswert. Eine nächtliche Nachverarbeitung und ein gleichmäßiger Strom neuer Tickets stellen sehr unterschiedliche Anforderungen an dieselbe günstige API.
Im eigenen Betrieb liegt die Hürde anderswo. Die vom Anbieter bereitgestellte Konfiguration benötigt ungefähr 49 GiB für Gewichte zuzüglich Arbeitsspeicher. Ihre prepare-Implementierung weist kombinierte Eingaben mit mehr als 8,192 Tokens zurück. Die im Test verwendeten Attention- und Kalibrierungseinstellungen müssen erhalten bleiben. Außerdem verweist die Modellkarte weiterhin auf einen authentifizierten Zugang zu einem privaten Repository. Vor einer Entscheidung für den lokalen Einsatz sollte deshalb geprüft werden, ob sich der Checkpoint mit dem eigenen Konto tatsächlich herunterladen lässt. Perplexity-Modellkarte
Das Kontextlimit des gehosteten Dienstes gehört nicht ungeprüft in die Planung eines lokalen Deployments. Eine lokale Installation muss als eigene Laufzeitumgebung bewertet werden, einschließlich ihrer tatsächlichen Vorverarbeitung, Speichernutzung und Modellversion. Sonst scheitert der Ersatz womöglich genau an den langen Datensätzen, die schon dem primären Dienst Probleme bereitet haben.
- Niedrigster veröffentlichter Hosting-Preis für Eingabetokens in dieser Auswahl.
- Text und Bilder lassen sich in einer Entscheidungsanfrage kombinieren.
- Der Apache-2.0-Checkpoint eröffnet einen Weg jenseits des gehosteten Dienstes.
- Das Anfragelimit pro Organisation kann Nachverarbeitungen oder Lastspitzen ausbremsen.
- Die mitgelieferte lokale Konfiguration benötigt viel GPU-Speicher.
- Die Eingabelimits des gehosteten Dienstes und der lokalen Referenzimplementierung unterscheiden sich deutlich.
Für den ersten Vergleich sollte die Aufgabe so überschaubar bleiben, dass sich Fehler direkt prüfen lassen.
Bestehende Warteschlangendefinitionen beibehalten
Labels und Grenzfälle aus der Jev-Implementierung übernehmen. Für Tickets außerhalb dieser Definitionen muss eine ausdrückliche Option für Sonstiges oder manuelle Prüfung erhalten bleiben. Unser Leitfaden zum Support-Ticket-Routing mit Jev bietet einen Ausgangsworkflow für den Vergleich.
Das native Anfrageformat von Perplexity verwenden
Das Modell auf
pplx-decider-v1.1-27bsetzen undstatesowie benanntequestionsanPOST /v1/decisionssenden. Einechoice-Frage mitcriteriaverwenden, die jede Warteschlange beschreiben. Für das Anfrage- und Antwortformat gilt die native API-Referenz.Antworten protokollieren, ohne Zuweisungen zu ändern
Die Antwort unter dem Namen der jeweiligen Frage auslesen. Ausgewähltes Label, zurückgegebene Wahrscheinlichkeiten, abgerechnete Eingabenutzung und Anfragestatus zusammen mit dem aktuellen Jev-Ergebnis speichern. Anbieterausfälle getrennt von gültigen Entscheidungen mit geringer Konfidenz erfassen.
Wechselkriterien vor dem Ergebnis festlegen
Eine akzeptable Quote falscher Zuweisungen, den zulässigen Prüfaufwand und die maximale Antwortzeit festlegen. Der Kandidat darf erst übernehmen, wenn er diese Bedingungen an repräsentativen, gelabelten Fällen erfüllt. Eine niedrigere Eingaberechnung allein reicht dafür nicht.
2. Cloudflare Clef, Clef-flash und Clef-omni: Das Eingabeformat entscheidet
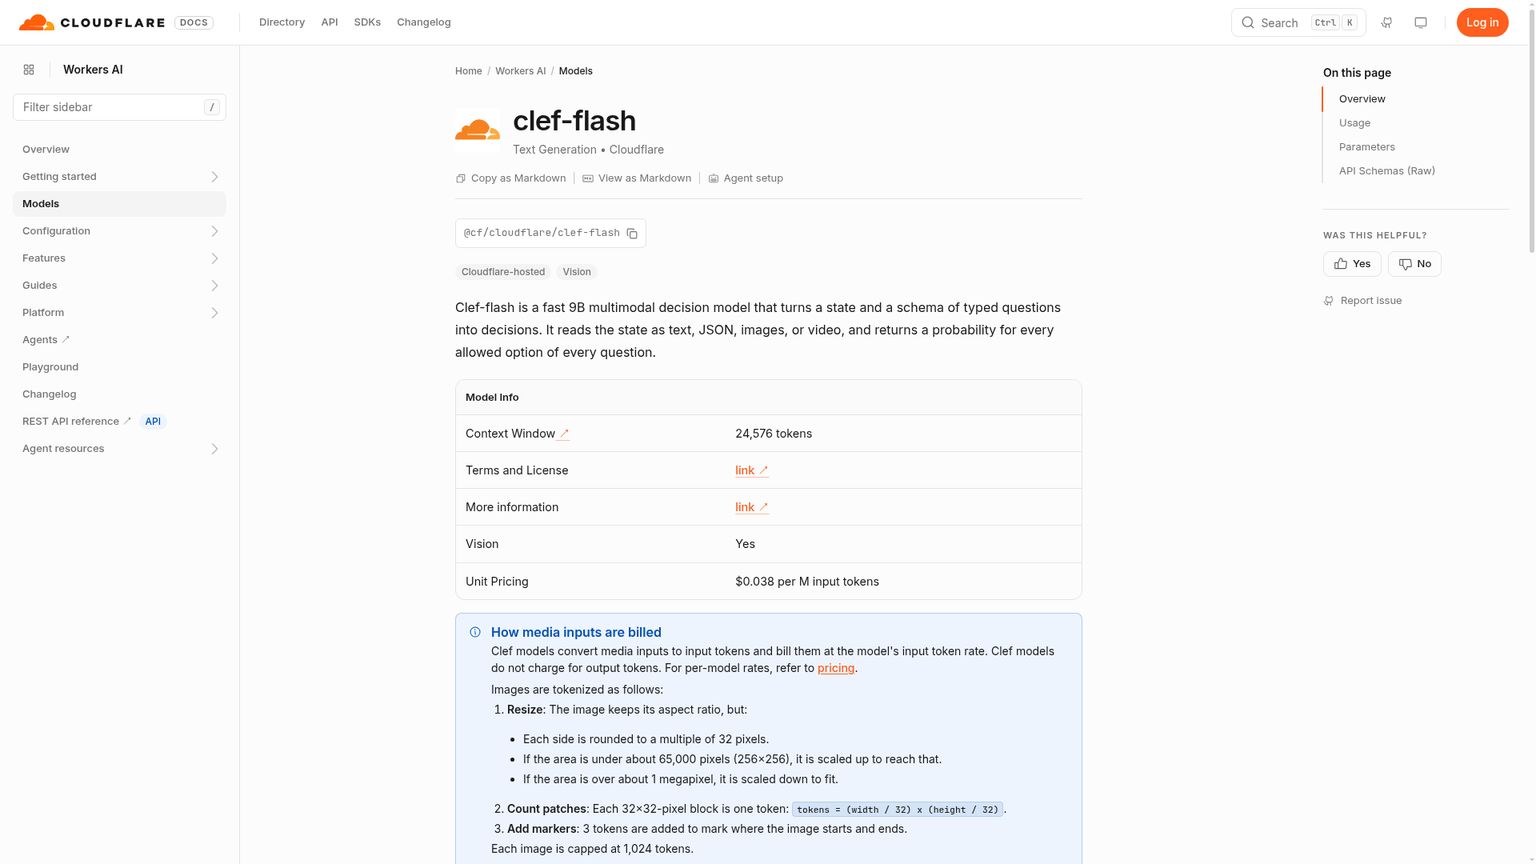
Cloudflare Clef-flash ist die naheliegende erste Wahl, wenn die Entscheidung in eine bestehende Workers-Anwendung gehört. Die Modellfamilie verbindet Hosting über Workers AI mit Gewichten unter Apache-2.0. So lässt sich ein verwalteter Dienst prüfen, während der spätere Eigenbetrieb offenbleibt. Welche Variante passt, hängt von den auszuwertenden Informationen und den Grenzen des gehosteten Endpunkts ab. Das günstigste Modell der Familie ersetzt weder Audiounterstützung noch ein ausreichend großes Kontextfenster.
Geeignet für: Routing und Klassifikation direkt im Umfeld einer Workers-Anwendung.
Besonderheit: Workers-AI-Bindings und REST-Zugang sowie herunterladbare Gewichte.
Preise: Clef-flash $0.038; Clef $0.240; Clef-omni $0.150 pro 1M Eingabetokens.
Kostenlos testen: Workers AI bietet ein gemeinsam genutztes tägliches Freikontingent, keinen separaten unbegrenzten Clef-Testzugang.
Eingaben und Laufzeitumgebung: Clef und Clef-flash verarbeiten Text, JSON, Bilder und Videoframes; Clef-omni ergänzt direkte Audioeingaben und Video mit Ton. Betrieb über Workers AI oder eine eigene Inferenzumgebung.
Lizenz: Gewichte unter Apache-2.0 für alle drei Modelle. Preise von Workers AI, ursprüngliche Veröffentlichung, Clef-omni-Modellkarte
Clef und Clef-flash erschienen am 1. Oktober 2026. Das Update vom 9. Oktober ergänzte Clef-omni und veränderte die Abwägung zwischen den gehosteten Varianten. Besonders relevant: Clef-flash hat jetzt ein gehostetes Kontextfenster von 24,576 Tokens. Der als Zustand übergebene Text kann gekürzt werden, damit er hineinpasst. Bei einem langen Störungsverlauf können dadurch wichtige Informationen verloren gehen, obwohl die Anwendung eine Antwort erhält. Aktuelle Clef-flash-Dokumentation, Oktober-Update
Für einen ersten Einsatz von flash eignet sich deshalb ein kurzes Erfassungsformular besser als ein unbegrenzt wachsendes Gesprächsarchiv. Die Regeln zur Warteschlangenzuweisung und die entscheidenden Kundeninformationen müssen in ein bewusst festgelegtes Eingabebudget passen. Wird der Datensatz vor dem Senden gekürzt, muss die Bewertung mit dieser gekürzten Fassung erfolgen, nicht mit einem idealisierten vollständigen Transkript.
Cloudflare Clef ist die größere Variante für Text und Bilder mit einem gehosteten Kontext von 65,536 Tokens. Der höhere Preis kann sich rechtfertigen, wenn die eigene Evaluation einen nützlichen Qualitätsgewinn zeigt oder das gehostete Kontextfenster von flash zu klein ist. Allein die Modellgröße belegt noch keinen Qualitätsvorsprung. Clef-Dokumentation
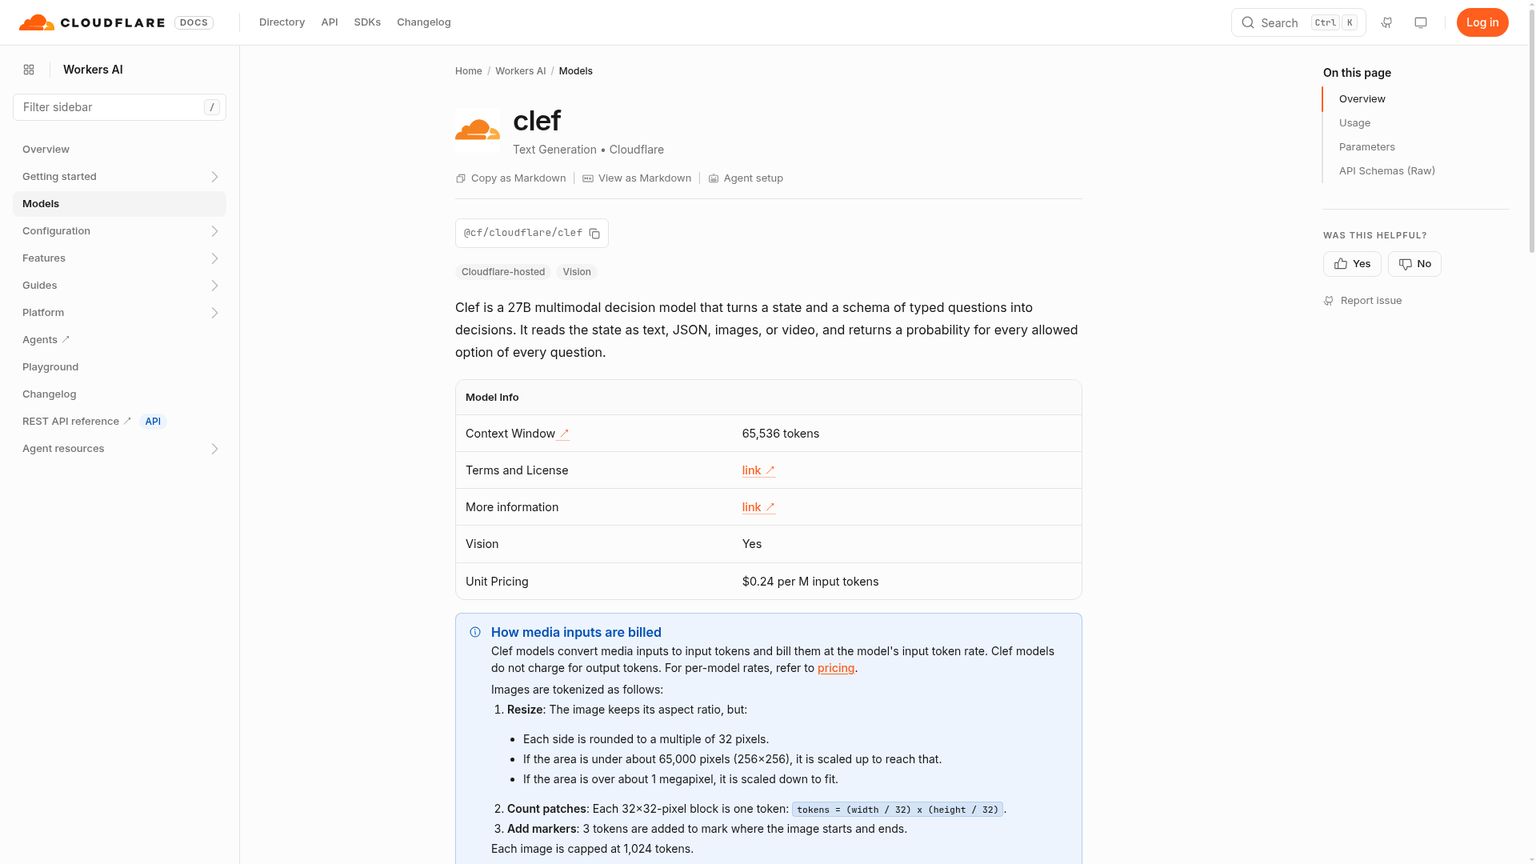
Cloudflare Clef-omni kommt infrage, sobald Ton Teil der Entscheidungsgrundlage ist. Eine Außendienstanwendung könnte etwa eine Maschinenaufnahme zusammen mit der Beschreibung eines Technikers klassifizieren müssen. Der Unterschied liegt in der direkten Verarbeitung von Audio und Video. Einzelbilder zu extrahieren und auf die darin enthaltenen Informationen zu hoffen, ist etwas anderes. Die Dokumentation nennt einen Kontext von 64,000 Tokens sowie eigene Mediengrenzen: Audioclips bis 300 Sekunden, Videos bis 60 Sekunden und zusätzliche Obergrenzen für Anzahl und Datenmenge. Clef-omni-Dokumentation
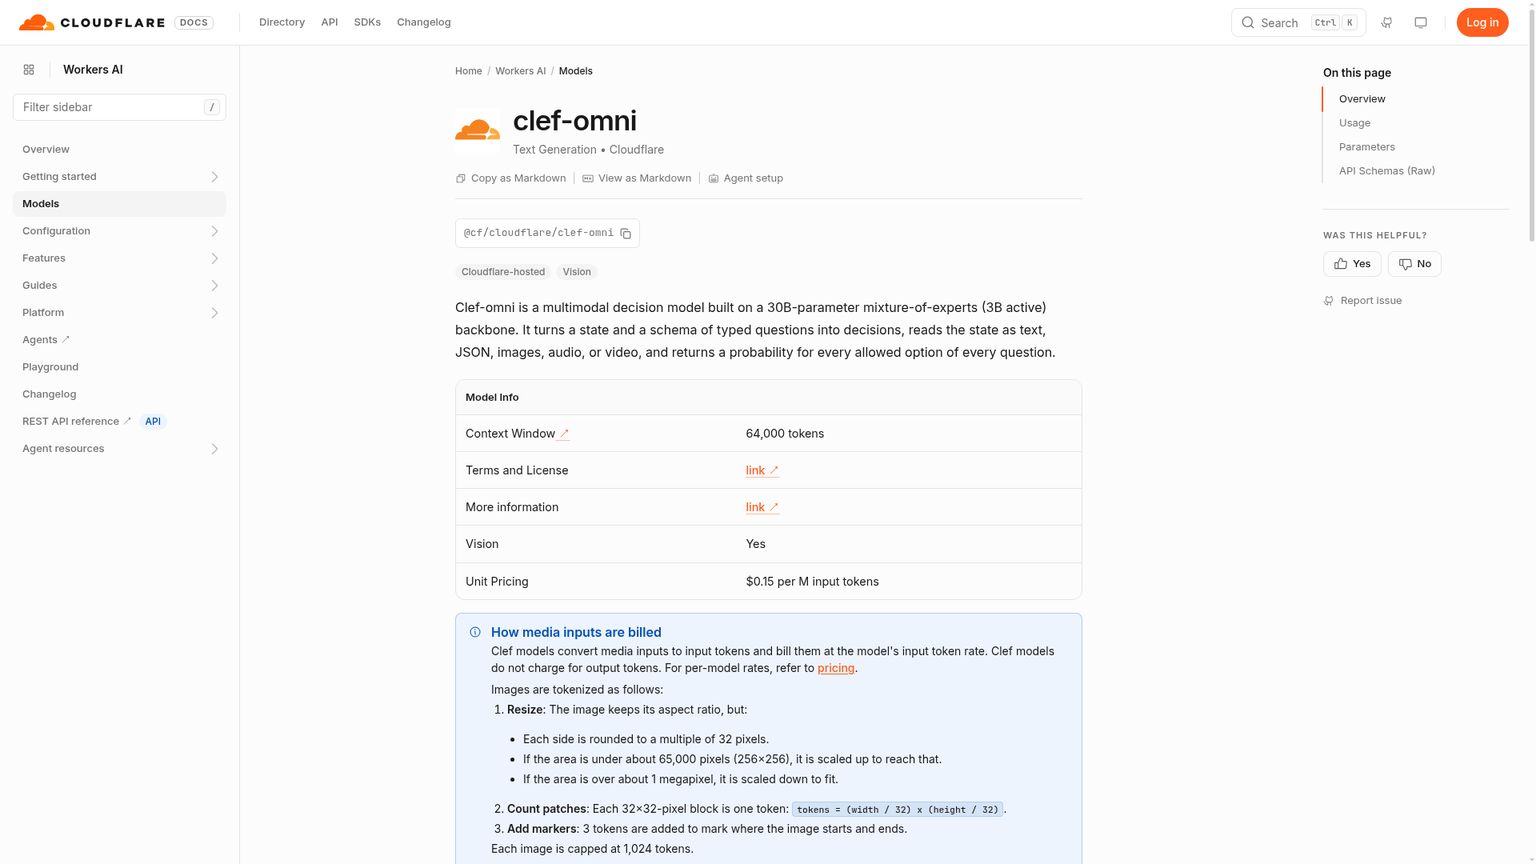
Offene Gewichte machen das omni-Modell noch nicht auf einem Smartphone einsetzbar. Cloudflares Referenzkonfiguration nennt etwa 64 GB GPU-Speicher für das Basismodell in bfloat16. Das ist eine Anforderung an den eigenen Inferenzbetrieb, die ins Budget gehört, kein Tokenpreis des gehosteten Dienstes. Clef-omni-Modellkarte
Cloudflares Freikontingent von 10,000 Neurons pro Tag ist gemeinsam genutzte Workers-AI-Kapazität. Neurons sind die Abrechnungseinheit für Rechenleistung. Wer das Kontingent überschreitet, benötigt Workers Paid. Die Tokenpreise sind daher als Modellgebühren zu betrachten; das übrige Workers-Abonnement und die Anwendungsnutzung gehören ebenfalls ins Betriebsbudget. Kontingent und Abrechnungsregeln
- Die native Workers-Integration erspart eine zusätzliche Anwendungsplattform.
- Gewichte unter Apache-2.0 halten den Eigenbetrieb offen.
- Die Familie reicht vom gewöhnlichen Text-Routing bis zu Entscheidungen auf Basis von Audio und Video.
- Das gehostete Kontextfenster von Clef-flash ist kleiner, als ältere Ankündigungen nahelegen.
- Wird ein langer Zustandstext gekürzt, können entscheidende Informationen entfallen.
- Der Eigenbetrieb von Clef-omni benötigt in der dokumentierten Konfiguration viel Speicher.
3. Microsoft-Decision-1: Labeling und Agentenprüfungen in Foundry
Microsoft-Decision-1 ist ein gehostetes Modell zur Bewertung von Entscheidungen für Entwickler, die bereits mit Microsoft Foundry arbeiten. Seine $0.042 pro Million Eingabetokens entsprechen dem aktuell veröffentlichten Jev-Tarif. Ausschlaggebend sind deshalb die Einbindung in die Plattform und die Qualität bei der konkreten Aufgabe, nicht direkte Tokenersparnisse. Als Einstieg eignen sich das Labeling von Feedback oder eine Agentenprüfung mit den Optionen Fortfahren, erneut versuchen und eskalieren. Das dokumentierte Anfrageformat akzeptiert Text oder JSON. Aus der zugrunde liegenden Modellfamilie lässt sich keine Bildunterstützung ableiten. Microsoft-Ankündigung, Foundry-Leitfaden
Geeignet für: Labeling, Priorisierung und Freigabeprüfungen für Agenten in einer Foundry-Umgebung.
Besonderheit: Dokumentierter Bereitstellungsweg in Foundry mit Entra ID oder API-Schlüssel.
Preise: $0.042 pro 1M Eingabetokens; Ausgabe kostenlos.
Kostenlos testen: Auf den verlinkten Seiten zum Entscheidungsmodell nicht veröffentlicht.
Eingaben und Laufzeitumgebung: Text oder JSON; Microsoft Foundry und OpenRouter.
Lizenz: Gehosteter Dienst; auf diesen Anbieterseiten ist keine Lizenz für herunterladbare Gewichte veröffentlicht. Microsoft-Preise und Zugang, Bereitstellungsvoraussetzungen
Microsoft nennt im Beitrag vom 9. Oktober 2026 Qwen3.5-9B als Basis. Der dort beschriebene mögliche Wechsel auf andere Basismodelle ist ein Zukunftsplan, nicht die derzeit angebotene Architektur. Ebenso wenig erlaubt ein offenes Basismodell automatisch den Download des von Microsoft nachtrainierten Modells. Solange Microsoft keine gesonderten Gewichte veröffentlicht, bleibt dies eine gehostete Option. Quelle zur Architektur
Der praktische Vorteil: Die Evaluation kann innerhalb der Plattform stattfinden, auf der die Anwendung bereits läuft. Angenommen, ein allgemeines Modell versieht Kundenfeedback mit Labels, bevor ein Produktmanager den Wochenbericht liest. Dann sollten Themen und eine Option für nicht zuordenbare Rückmeldungen definiert, beide Systeme mit demselben Feedback verglichen und vage Kommentare gezielt geprüft werden: Erhalten sie ungerechtfertigt konkrete Labels? Auch ein formal perfektes Label kann den Bericht verfälschen.
Microsoft meldet in seinem Vergleich über 36 Benchmarks die höchste durchschnittliche Genauigkeit. Das ist eine Angabe des Anbieters. Der Latenzvergleich misst Microsoft-Decision-1 zudem über Foundry innerhalb derselben Region. Diese Bedingungen sind relevant: Sie belegen weder die Antwortzeit aus der eigenen Anwendung heraus noch die Genauigkeit bei einer unternehmensinternen Taxonomie. Microsofts Beschreibung der Evaluation
Die Bereitstellung hat konkrete Voraussetzungen. Benötigt werden ein Foundry-Projekt, Berechtigungen zum Bereitstellen des Modells und eine Authentifizierungslösung. Eine andere Modellbezeichnung in einem beliebigen SDK genügt nicht. Der Leitfaden dokumentiert numerische Entscheidungen, keine ausformulierte Erklärung. Muss ein Label gegenüber einer prüfenden Person begründet werden, sollten die zugrunde liegenden Informationen erhalten bleiben und die Erklärung in einem weiteren Schritt entstehen. Foundry-Einrichtung und Ausgabeformat
- Passt zu bestehenden Identitäts- und Bereitstellungsabläufen in Foundry.
- Unterstützt binäre Entscheidungen, Auswahlfragen und Bewertungen auf geordneten Skalen.
- Microsoft nennt in der eigenen Ankündigung einen eindeutigen Eingabepreis.
- Keine Ersparnis gegenüber Jev beim Basistarif für Eingaben.
- Die Anbieterseiten belegen keinen Bereitstellungsweg mit offenen Gewichten.
- Dokumentiert sind Text- und JSON-Eingaben, kein zugesicherter multimodaler Ersatz.
4. OpenAI Decisions API: Entscheidungsaufgaben in bestehende OpenAI-Anwendungen einbinden
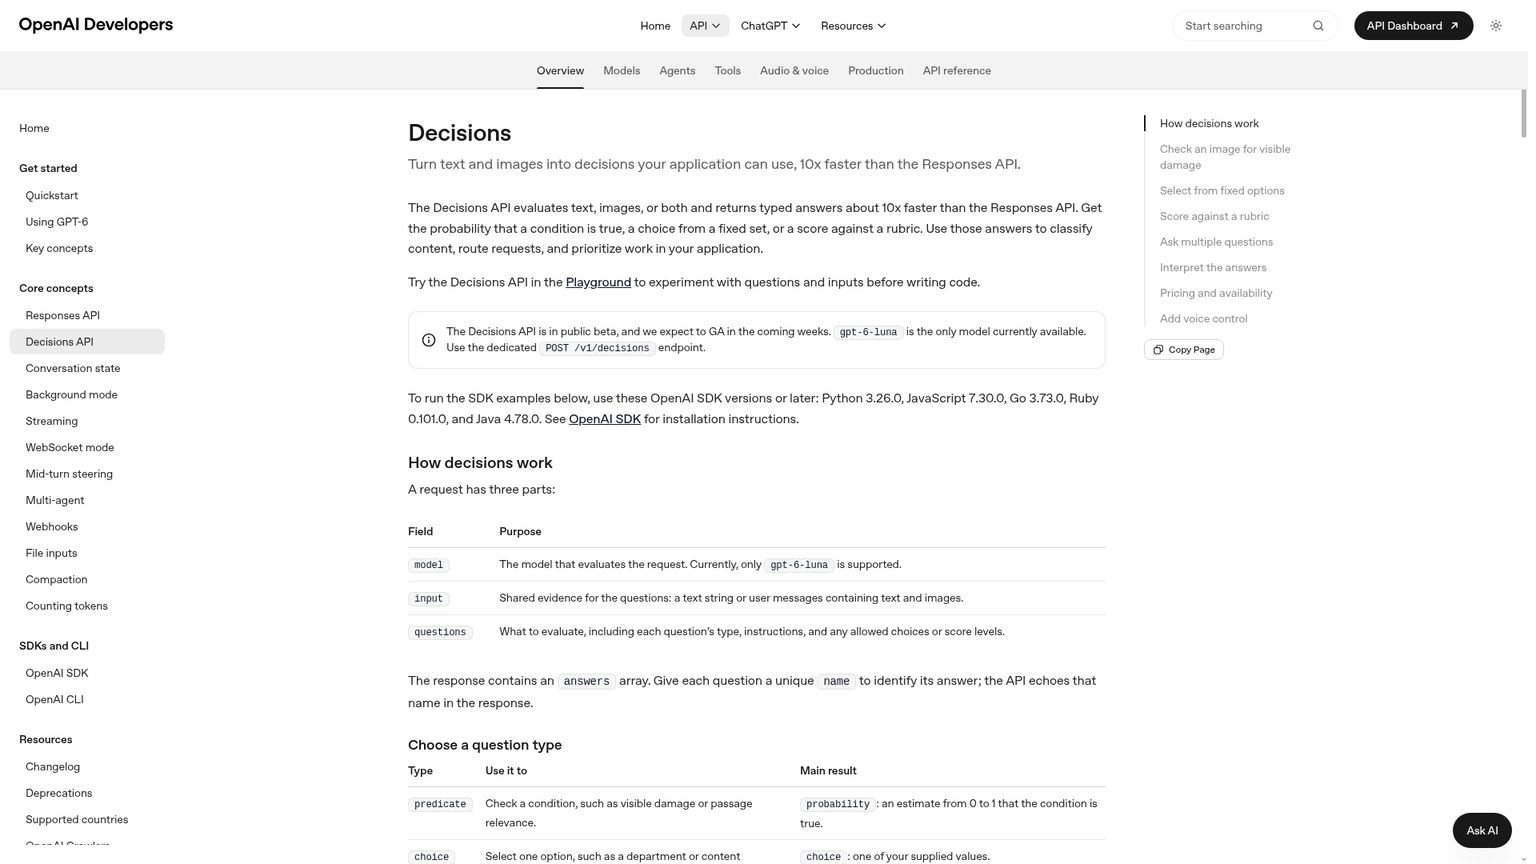
Die OpenAI Decisions API verarbeitet Text und Bilder mit gpt-6-luna zu typisierten Antworten. Sie ist ein plausibler Kandidat, wenn eine Anwendung bereits OpenAI nutzt und dort Klassifikation, eine Auswahl aus vorgegebenen Optionen oder Bewertungen anhand eines Kriterienrasters benötigt. Mit $0.10 pro Million Eingabetokens ist diese Entscheidungskomponente im Basistarif teurer als Jev. Der Mehrpreis muss sich durch die Integration oder eine gemessene höhere Qualität bei der Aufgabe rechtfertigen. OpenAI-Decisions-Leitfaden
Geeignet für: Text- und Bildklassifikation sowie Freigabeprüfungen in einer bestehenden OpenAI-Anwendung.
Besonderheit: Antworten vom Typ predicate, choice und score über einen eigenen Endpunkt.
Preise: $0.10 pro 1M Eingabetokens im Basistarif; keine Gebühren für Ausgabe, Cache-Lesezugriffe oder Cache-Schreibzugriffe. Regionale Aufschläge und Eingabemultiplikatoren für lange Kontexte kommen hinzu.
Kostenlos testen: Im Decisions-Leitfaden nicht veröffentlicht.
Eingaben und Laufzeitumgebung: Text und direkt eingebettete Bilder über den gehosteten Endpunkt POST /v1/decisions.
Lizenz: Zugang über eine gehostete API; der Leitfaden nennt keine Lizenz zur Verbreitung offener Gewichte. Aktueller Leitfaden und Preise
Die API startete am 6. Oktober 2026 in die öffentliche Beta. Dieser Status gehört in die Entscheidung über den produktiven Einsatz. Auch eine neue API kann eine Evaluation wert sein. Bevor sie als Ausweichlösung dient, sollte jedoch nachgewiesen sein, dass Antwortparser, Fehlerbehandlung und Kontozugang mit ihr funktionieren. OpenAI-Änderungsprotokoll
Die zentrale Migrationshürde ist das Anfrage- und Antwortformat. OpenAI verwendet input und ein Array benannter Fragen; der Ja/Nein-Typ heißt predicate. Ein bestehendes Fragenobjekt im Jev-Format lässt sich nicht unverändert weiterreichen. Die Antwort kann außerdem eine Verweigerung enthalten, die getrennt von einer Wahrscheinlichkeit behandelt werden muss. Anfrage- und Antwortmuster
Ein Retourenprozess könnte beispielsweise prüfen, ob auf einem Produktfoto sichtbare Schäden zu erkennen sind, und die passende Warteschlange zur Prüfung auswählen. Damit ist noch nicht geklärt, wer den Schaden verursacht hat, ob ein Garantieanspruch besteht oder ob eine Erstattung freigegeben ist. Das sind eigene Entscheidungen, die weitere Informationen oder feste Geschäftsregeln benötigen.
- Text und Bilder können gemeinsam ausgewertet werden.
- Typisierte Antworten ersparen das Auslesen eines Labels aus Fließtext.
- Der eigene Leitfaden grenzt die Abrechnung von Entscheidungen von anderen Modellendpunkten ab.
- Höherer Basistarif für Eingaben als bei Jev und den günstigsten gehosteten Alternativen.
- Der öffentliche Betastatus ist für die Einsatzplanung relevant.
- Native Anfrageformate und die Behandlung von Verweigerungen benötigen einen Adapter.
5. Liquid AI d1-3B: Der Einstieg in lokale Text- und Bildentscheidungen
Liquid AI d1-3B ist ein Entscheidungsmodell mit offenen Gewichten für Text- und Bildeingaben, veröffentlicht am 7. Oktober 2026. Für eine Desktop- oder Edge-Anwendung, die sowohl eine Beschreibung als auch ein Bild klassifizieren muss, würde ich diesen lokalen Kandidaten zuerst prüfen. Sein Reiz liegt in der Kontrolle darüber, wo die Inferenz stattfindet. Daraus folgt nicht, dass der Betrieb einer GPU günstiger ist als eine sehr preiswerte gehostete API. Veröffentlichung von Liquid AI
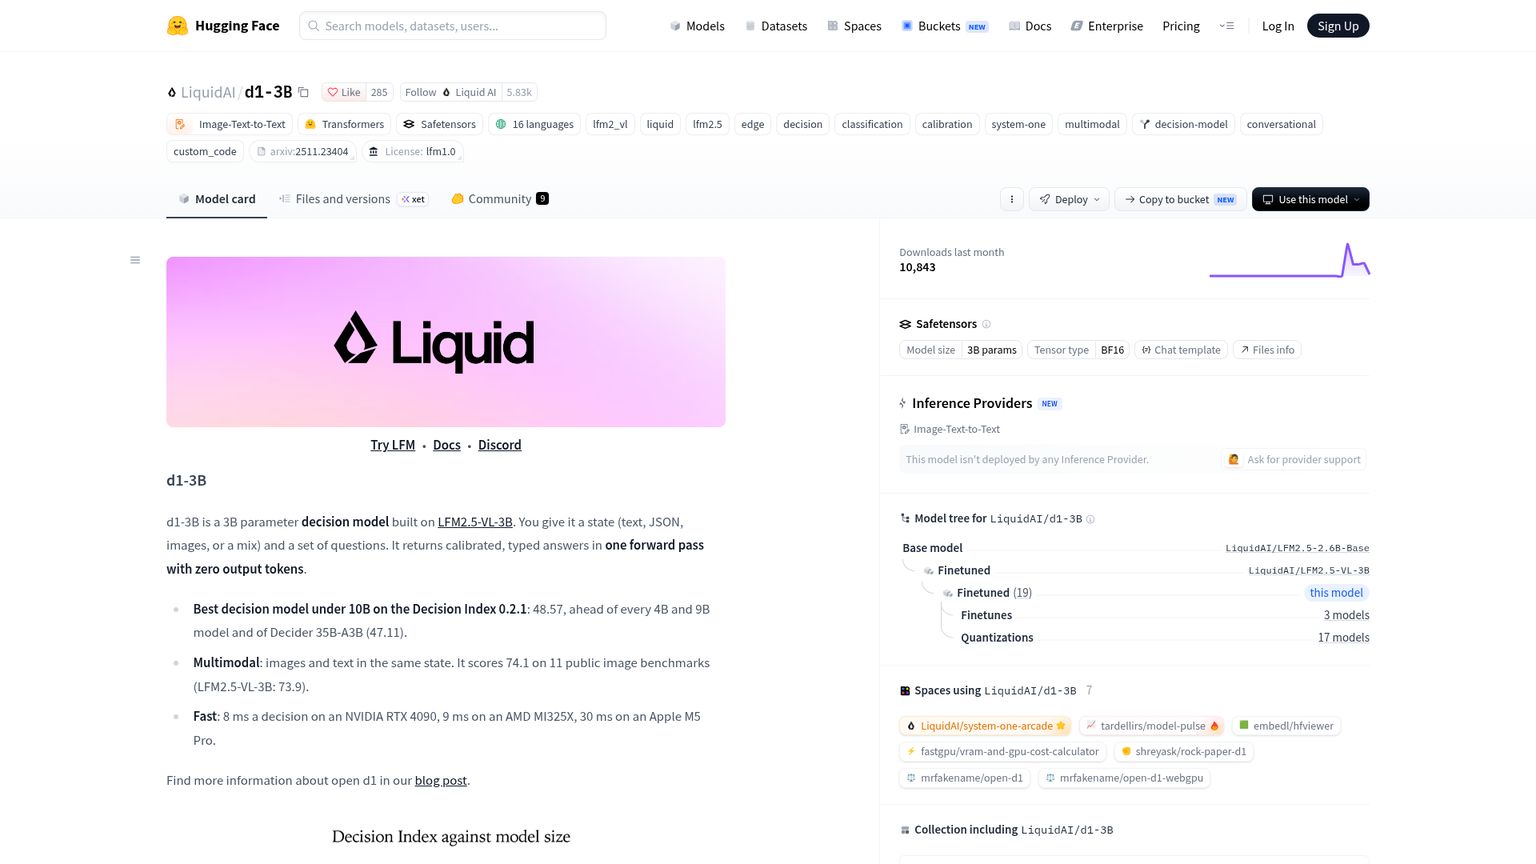
Geeignet für: Lokale Bildklassifikation, Sichtprüfungen und Text-Routing.
Besonderheit: Herunterladbares Modell mit dokumentierten Messungen auf lokaler Hardware.
Preise: Pro 1M Eingabetokens: für diesen offenen Checkpoint nicht veröffentlicht. Eigene Rechenkosten müssen eingeplant werden.
Kostenlos testen: Gewichte unter den jeweiligen Lizenzbedingungen herunterladbar; Rechenleistung separat.
Eingaben und Laufzeitumgebung: Text, JSON und Bilder; Anbieterbeispiele unterstützen CUDA, Apple MPS und CPU über angepassten Transformers-Code.
Lizenz: LFM Open License v1.0. Modellkarte, Lizenz der Gewichte
Das Modell basiert auf LFM2.5-VL-3B und dokumentiert einen Kontext von 32,768 Tokens. Ein denkbarer Einsatz ist ein Desktop-Tool zur Qualitätsprüfung: Eine Bedienperson liefert ein Produktbild und wählt eine bekannte Prüffrage aus. Im lokalen Betrieb kann die Anwendung ohne Aufruf eines gehosteten Entscheidungsdienstes weiterarbeiten, sofern auch der übrige Workflow lokal läuft. Kamerabedingungen, Änderungen der Bildgröße und die Definition eines Defekts müssen trotzdem validiert werden. Architektur und Kontext
Liquid nennt für einzelne Fragen Laufzeiten von 16 ms auf Jetson AGX Thor, 26 ms auf AGX Orin und 50 ms auf Orin Nano. Das sind Hardwaremessungen des Anbieters, keine Zusage für die eigene Eingabegröße und kein Vergleich mit einer vollständigen API-Anfrage über das Internet. Sie helfen, geeignete Hardware für eine Evaluation zu finden. Anschließend muss die gesamte Anwendung gemessen werden. Liquids Laufzeittabelle
Die Lizenz beeinflusst die Beschaffung. Beide Liquid-Checkpoints verwenden die LFM Open License v1.0. Deren Bedingung für die kommerzielle Nutzung bezieht sich auf eine Jahresumsatzgrenze von $10 Millionen. Bevor ein Einsatz als zulässig eingeordnet wird, sollten die Definition des maßgeblichen Rechtsträgers und Abschnitt 5 geprüft werden. Falls die Bedingung relevant ist, sind die Konditionen mit Liquid zu klären. Dieses Modell gehört in einer Beschaffungsübersicht nicht unter Apache-2.0. Lizenztext
Auch die Bezeichnung verdient Aufmerksamkeit. Liquid führt gehostetes d1 getrennt von d1-3B und d1-omni-600M. Die Dokumentation und Ankündigung des gehosteten Dienstes erläutern eine reine Eingabeabrechnung. Auf den für diesen Vergleich geprüften Seiten steht jedoch kein Dollarpreis pro Million Tokens. Tarif und Grenzen des gehosteten Modells lassen sich nicht auf die herunterladbaren Modelle übertragen. Liquid-Modellkatalog, Leitfaden zu gehostetem d1
Bei einem Offline-Produkt hängt der Wechsel davon ab, ob das Modell die Anforderungen an Qualität und Latenz auf dem tatsächlichen Zielgerät erfüllt. Der Test sollte mit laufender Begleitsoftware, realistischen Bildern und unter Dauerlast erfolgen. Eine einzelne erfolgreiche Inferenz ist erst der Anfang der Kapazitätsbewertung.
- Entscheidungsinferenz bleibt auf selbst betriebener Hardware.
- Unterstützt Text und Bilder.
- Anbietermessungen nennen konkrete Edge-Hardware für die Evaluation.
- Die LFM-Bedingungen für kommerzielle Nutzung müssen geprüft werden.
- Inferenzbetrieb, Kapazität und Pflege der Laufzeitumgebung liegen in eigener Verantwortung.
- Der Download garantiert weder feste noch entfallende Inferenzkosten.
6. Liquid AI d1-omni-600M: Kleine Sprachaufgaben mit den Grenzen einer Forschungsversion
Liquid AI d1-omni-600M ist das kompakte, experimentelle Schwestermodell für Text mit Bildern oder Text mit Audio. Es gehört auf die Auswahlliste für ein Gerät, das eine kleine Menge gesprochener Absichten unterscheiden muss. Als Ersatz für jeden multimodalen Hosting-Dienst sollte es dagegen nicht vorausgesetzt werden. Die Größe macht den lokalen Betrieb interessant; entscheidend bleiben jedoch die Grenzen der Eingaben und des Trainings. Ein Pilotprojekt mit Sprachbefehlen ist enger gefasst als die Analyse beliebiger Aufnahmen. Veröffentlichungsstatus, Modellkarte
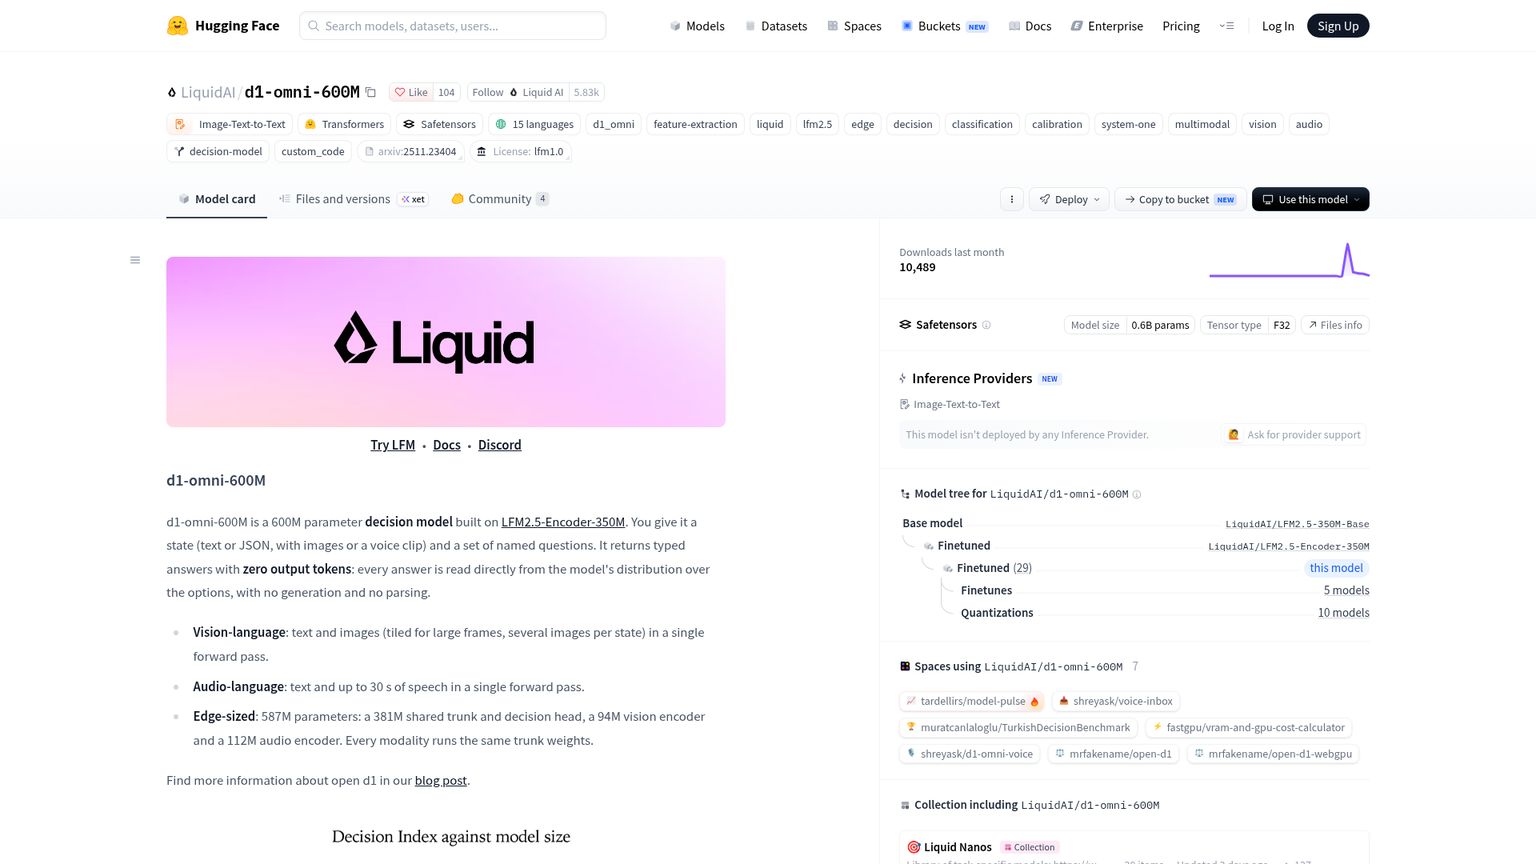
Geeignet für: Experimente mit Sprachabsichten oder Bildentscheidungen auf kleinen Geräten.
Besonderheit: Kompakter offener Checkpoint mit Audioeingabe.
Preise: Pro 1M Eingabetokens: für diesen offenen Checkpoint nicht veröffentlicht.
Kostenlos testen: Gewichte unter den Lizenzbedingungen herunterladbar; eigene Rechenkosten bleiben bestehen.
Eingaben und Laufzeitumgebung: Text/JSON mit Bildern oder Audio; lokale Beispiele für CUDA, MPS oder CPU.
Lizenz: LFM Open License v1.0 mit derselben Bedingung zur kommerziellen Nutzung. Modellkarte, Lizenz
Die Modellkarte nennt 587 Millionen Parameter. Das Audiotraining basiert auf Anfragen zwischen einer englischsprachigen Person und einem Assistenten. Audioclips werden nach 30 Sekunden abgeschnitten. Ein Befehl wie „pause the inspection“ ist deshalb ein geeigneteres Evaluationsziel als ein langes mehrsprachiges Kundengespräch. Die Unterstützung von Audioeingaben belegt keine Leistungsfähigkeit bei jeder Art von Geräusch oder Ton. Umfang der Audiounterstützung
Eine Grenze wird besonders leicht übersehen: Das Modell hat insgesamt 16,384 Kontextpositionen. Bei Bildeingaben werden Zustandstext und Fragetext jedoch auf 896 Tokens gekürzt. Eine lange Bedienungsanleitung zusammen mit einem Bild kann das relevante Textlimit schon überschreiten, lange bevor die Gesamtgröße des Kontextfensters ein Problem vermuten lässt. Kontextdetails
Bei einem Kiosksystem sollten Befehlsliste und lokale Regeln knapp bleiben. Für nicht erkannte Anfragen braucht es einen eigenen Verarbeitungspfad. Hintergrundgespräche und fehlender Kontext gehören ebenso gezielt in die Evaluation wie klar gesprochene Befehle. Nützlich ist ein System, das bei unklaren Anweisungen auf eine Entscheidung verzichtet, statt stets eine formal gültig wirkende Option zu liefern.
Liquid veröffentlicht zum Start keine Geschwindigkeitsmessungen für dieses experimentelle Modell. Die Laufzeiten des größeren d1-3B dürfen deshalb nicht übernommen werden. Auch aus der geringeren Parameterzahl lässt sich keine Latenzgarantie ableiten. Die Anwendung muss weiterhin Medien verarbeiten, das Modell laden und ihre Laufzeit in das verfügbare Betriebsbudget des Geräts einpassen. Umfang der veröffentlichten Messungen
- Der geringe Ressourcenbedarf ist für begrenzte lokale Geräte relevant.
- Bietet neben Bildentscheidungen auch einen Verarbeitungspfad für Audioentscheidungen.
- Offene Gewichte erlauben Einblick in das Modell und den eigenen Betrieb.
- Experimentelle Veröffentlichung mit eng umrissenem dokumentiertem Audiotraining.
- Bei Bildanfragen ist das Textbudget deutlich kleiner als der Gesamtkontext.
- Zur Veröffentlichung gibt es keinen modellspezifischen Geschwindigkeitswert.
7. Amazon Strands Decider 2B: Nachvollziehbare lokale Freigabeprüfungen für Agenten
Amazon Strands Decider 2B ist ein offenes Entscheidungsmodell von Strands Labs mit veröffentlichtem Inferenzcode, Trainingsmaterial und Evaluationen. Es passt besonders dann, wenn der Wechsel weg von einem gehosteten Jev-Aufruf mehr Kontrolle über eine kleine Entscheidungskomponente in der eigenen Agentenlaufzeit schaffen soll. Als Einstieg eignet sich eine klar begrenzte Aufgabe, etwa eine vorgeschlagene Aktion anhand einer kurzen Richtlinie zu prüfen. Der mitgelieferte lokale Server ist dabei noch kein vollständiges Hosting-Produkt. Repository des Anbieters
Geeignet für: Lokale Freigabeprüfungen für Agenten, Routing und Experimente mit dem Trainingsverfahren.
Besonderheit: Modellgewichte, Code und Evaluationsdetails sind gemeinsam verfügbar.
Preise: Gehosteter Preis pro 1M Eingabetokens: nicht veröffentlicht; die Laufzeitumgebung muss selbst bereitgestellt werden.
Kostenlos testen: Modell und Code unter Apache-2.0 herunterladbar; Rechenleistung separat.
Eingaben und Laufzeitumgebung: Text und optional Bilder über die Bildverarbeitung; Optionen für CUDA, Apple Silicon und CPU.
Lizenz: Apache-2.0 für den genannten Qwen-basierten Checkpoint und das Projekt. Aktuelle Modellkarte
Der genaue Checkpoint muss festgelegt werden: strands-decider-2B-qwen3.5-v1-2610 ist die derzeit im Repository beschriebene Referenz. Er verwendet Qwen3.5-2B-Base als Basismodell mit einem trainierten Adapter und einem Entscheidungskopf, der die zulässigen Antworten bewertet. Ältere Bezeichnungen wie hobson-v19 und hobson-v21 sind weiterhin sichtbar. Zu jeder Leistungsangabe gehört deshalb die entsprechende Version. Version und Architektur
Diese Unterscheidung betrifft auch die häufig genannten 115 ms. Die detaillierte Tabelle im Repository ordnet diesen Median auf einer RTX 3090 der Version v19 zu. Bei den neueren Spalten steht, dass Architektur und Größe übereinstimmen. Es handelt sich um eine historische Laufzeitangabe des Anbieters, nicht um eine neue Messung des aktuellen Checkpoints. Maßgeblich sollte die Messung für den tatsächlich vorgesehenen Checkpoint sein. Leistungstabelle nach Version
Der mitgelieferte Server bindet an localhost und hat keine Authentifizierung. Für lokale Experimente ist das nützlich. Ein Netzwerkdienst braucht zusätzlich Zugriffskontrolle, Planung gleichzeitiger Anfragen, klare Betriebsverantwortung und Überwachung. Bei einem internen Agenten muss feststehen, was passiert, wenn der Modellprozess noch nicht geladen, ausgelastet oder nicht verfügbar ist. „Lokal ausführen“ beschreibt eine Betriebsoption, keine Verfügbarkeitsstrategie. Anleitung zum Inferenzbetrieb
Eine erste konkrete Prüfung könnte unterscheiden, ob „die vorgeschlagene Aktion nur einen Datensatz liest“ oder „die vorgeschlagene Aktion einen Datensatz verändert“. Feste Anwendungsregeln müssen weiterhin die Benutzerberechtigungen und erlaubten Operationen prüfen. Hält das Modell eine Operation für sicher, darf der authentifizierte Benutzer sie aber nicht ausführen, bleibt sie gesperrt.
- Modell und Code unter Apache-2.0 ermöglichen eine selbst betriebene lokale Komponente.
- Veröffentlichtes Trainings- und Evaluationsmaterial macht die zugrunde liegenden Annahmen prüfbar.
- CPU- und Apple-Silicon-Optionen für das kleine Modell erweitern die Testmöglichkeiten.
- Ein vom Anbieter gehosteter Eingabetarif oder verwalteter Endpunkt ist hier nicht belegt.
- Ein lokaler Beispielserver ist noch kein fertiger Produktionsdienst.
- Historische Latenzwerte müssen dem jeweils gemessenen Checkpoint zugeordnet bleiben.
Was die Ersparnis auf der Monatsrechnung tatsächlich ausmacht
Eine große prozentuale Ersparnis kann in Dollar klein ausfallen. Angenommen werden eine Million Entscheidungen pro Monat mit jeweils 1,000 abgerechneten Eingabetokens. Das ergibt eine Milliarde Eingabetokens. Bei den geprüften Basistarifen betragen die reinen Eingabekosten des Modells $20 für Perplexity, $38 für Clef-flash, $42 für Jev oder Microsoft-Decision-1, $100 für OpenAI Decisions, $150 für Clef-omni und $240 für Clef. Perplexity, Cloudflare, TypeSafe, Microsoft, OpenAI
Dieses Rechenbeispiel setzt bewusst dieselbe Menge abrechenbarer Tokens an. Unterschiedliche Tokenizer, Frageformate und Verfahren zur Medienverarbeitung können bei derselben fachlichen Eingabe zu anderen Abrechnungsmengen führen. Nicht enthalten sind Freikontingente, Plattformabonnements, regionale Aufschläge oder Zuschläge für lange Kontexte, Wiederholungsanfragen, nachgelagerte Textgenerierung und manuelle Prüfungen.
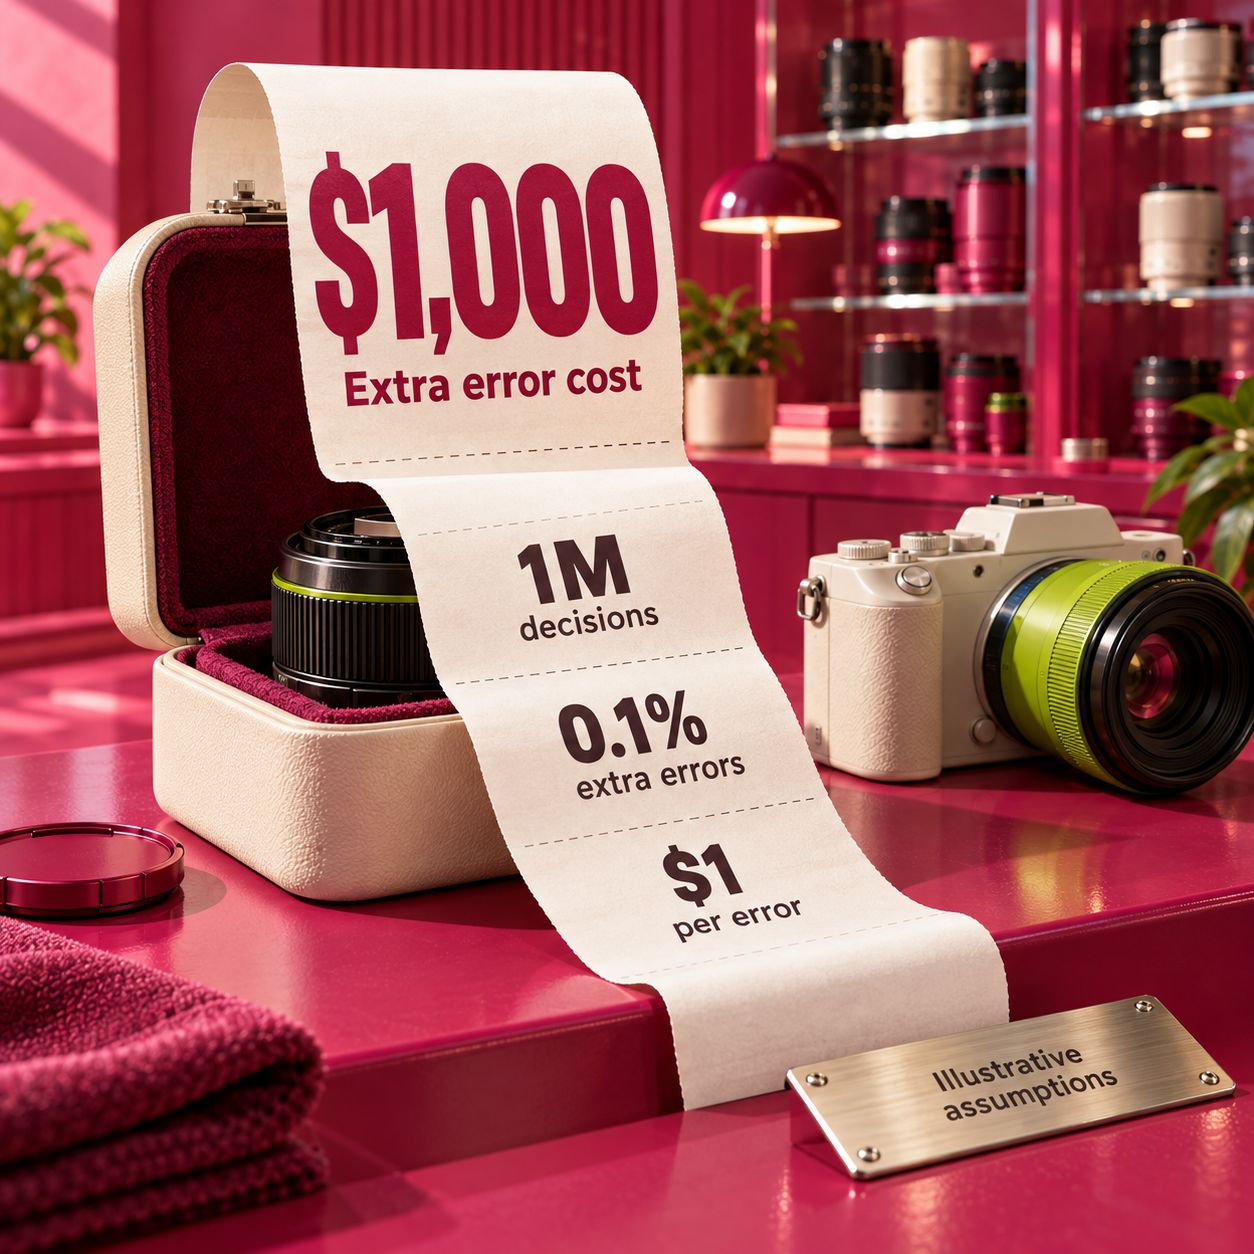
Nun die Annahme, dass ein Kandidat 0.1 Prozentpunkt mehr Fehler verursacht und jeder zusätzliche Fehler $1 Bearbeitungskosten auslöst. Bei einer Million Entscheidungen entstehen dadurch 1,000 zusätzliche Fehler und $1,000 zusätzliche Kosten. Das sind illustrative Annahmen, keine gemessenen Fehlerquoten und kein Marktpreis für Arbeitszeit. Sie zeigen, warum die Qualität der akzeptierten Entscheidungen optimiert werden sollte und nicht allein der Tokenpreis.
Für den Eigenbetrieb gilt eine ähnliche Rechnung. Bei einem zusätzlichen Infrastrukturbudget von $100 pro Monat wären fünf Milliarden Eingabetokens pro Monat nötig, um Perplexitys Basistarif von $0.02 pro Million zu erreichen. Betriebskosten und Qualitätsunterschiede sind dabei noch nicht berücksichtigt. Die $100 sind eine Annahme, kein GPU-Angebot. Bereits vorhandene freie Hardwarekapazität kann die Rechnung verändern. Lokale Datenhaltung oder ein Offline-Produkt können den Eigenbetrieb auch ohne Einsparungen beim Tokenpreis rechtfertigen.
Vor jeder Hochrechnung sollte die Abrechnung anhand der tatsächlichen Nutzung gemessen werden. Liquids separater gehosteter d1-Dienst zählt beispielsweise bei jeder Frage den Text und die mitgelieferten Bilder erneut. Mehrere Fragen in einem HTTP-Aufruf bedeuten deshalb nicht, dass die gemeinsame Informationsgrundlage nur einmal bezahlt wird. Diese Abrechnungsregel legt keinen Dollarpreis für die offenen Checkpoints fest. Liquids Erläuterung zur Abrechnung
Welches Modell eignet sich für den produktiven Einsatz?
Für gewöhnliches Routing ist Perplexity der erste Testkandidat, wenn niedrigere Hosting-Kosten das Ziel sind. Clef-flash sollte zuerst geprüft werden, wenn der Verbleib innerhalb von Workers die Anwendung vereinfacht. Ausschlaggebend ist, ob der Kandidat zur Anfragerate, Eingabelänge und den gemessenen Grenzen für Fehlzuweisungen und Prüfaufwand passt. Weder ein niedrigerer Tarif noch eine vertraute Plattform gleichen es aus, wenn Informationen verloren gehen, die über die richtige Warteschlange entscheiden.
Beim Labeling sollte das Modell bevorzugt werden, das die eigene Taxonomie auch bei mehrdeutigen Beispielen korrekt anwendet. Microsoft-Decision-1 liegt für Foundry nahe, Perplexity für einen preisorientierten gehosteten Einsatz. Zu prüfen ist, ob ein Kommentar mehreren Themen zugeordnet werden kann. Eine Einfachauswahl erzwingt ein einziges Ergebnis. Eine Aufgabe mit mehreren zulässigen Labels sollte daher in getrennte Prüfungen zerlegt oder anderweitig ausdrücklich abgebildet werden.
Bei Freigabeprüfungen für Agenten zählt eine zuverlässig betreibbare Laufzeitumgebung; die Befugnisse müssen im Code verankert bleiben. Für eine lokale Komponente lohnt sich eine Evaluation von Strands. Microsoft oder OpenAI können zu einer bestehenden gehosteten Integration passen. Das Modell darf eine Einschätzung zur vorgeschlagenen Aktion liefern. Die Anwendung muss Berechtigungen, Ausgabenregeln und erlaubte Operationen unabhängig davon durchsetzen.
Für den Betrieb direkt auf dem Gerät bietet sich d1-3B bei Text und Bildern an, d1-omni-600M bei einem eng begrenzten Sprachexperiment. Strands ist eine weitere lokale Option, wenn Lizenz und einsehbares Trainingsverfahren besser zum Projekt passen. In diesem Zweig entscheiden Gerät, Eingabevorverarbeitung und erlaubte kommerzielle Nutzung, bevor ein Preisvergleich gehosteter Dienste sinnvoll wird.
Für Audio- und Videoentscheidungen in einer gehosteten Anwendung sollte Clef-omni geprüft werden. Seine Medienverarbeitung ist ein wesentlicher Unterschied. Ein günstigeres Textmodell wird erst dann zur Alternative, wenn bewusst ein Vorverarbeitungsschritt ergänzt und geprüft wird, welche Informationen dabei verloren gehen.
Bei einer zusätzlichen Ausweichlösung muss klar sein, welchen Ausfall er abfangen soll. Zwei Modell-IDs hinter demselben Gateway hängen weiterhin von diesem Gateway ab. Auch eine lokale Ausweichlösung scheitert, wenn sie ihre Eingaben aus demselben nicht verfügbaren vorgeschalteten Dienst beziehen muss. Der gesamte Anfrageweg sollte aufgezeichnet werden. Anschließend gilt es, die Abhängigkeit zu isolieren, deren Ausfall überbrückt werden soll.
Erst eine Entscheidung migrieren, dann den gesamten Workflow
Ein Ersatz bewährt sich, wenn er die vereinbarte Entscheidungslogik der Anwendung erhält. Gültiges JSON allein genügt nicht. Beim Anpassen anbieterspezifischer Felder sollten Warteschlangennamen, Bedeutung der Bewertungskriterien und Ausweichverhalten stabil bleiben. So lassen sich abweichende Ergebnisse prüfen, ohne einen Modellwechsel mit einer Änderung der Regeln zu vermischen.
Entscheidung und Informationsgrundlage festhalten
Einen bestehenden Aufruf auswählen, etwa die Warteschlangenzuweisung für ein neues Supportticket. Zulässige Labels, Regelversion, Eingabefelder und die Kriterien für unzureichende Informationen dokumentieren. Der gelabelte Datensatz muss auch mehrdeutige Fälle und Aufgaben außerhalb des vorgesehenen Bereichs enthalten, nicht nur eindeutige Beispiele.
Die Schnittstelle zum Anbieter anpassen
Informationsgrundlage, Fragendefinitionen und Auslesen der Antworten ausdrücklich zuordnen. OpenAI verwendet ein Eingabefeld und ein Array benannter Fragen; die dokumentierten Beispiele von Perplexity und Microsoft verwenden einen Zustand und Fragen mit Schlüsseln. Auch die Einbettung von Bildern unterscheidet sich. Maßgeblich ist der native Leitfaden des Anbieters: Ähnliche Namen für Grundelemente bedeuten keine identischen Übertragungsformate.
Den Kandidaten parallel mitlaufen lassen
Der bestehende Workflow behält die Kontrolle, während der Kandidat nur seine Antwort protokolliert. Falsch akzeptierte Entscheidungen, Übergaben, fehlgeschlagene Anfragen, abgerechnete Nutzung und die langsamsten Antwortzeiten vergleichen. Beide Modelle müssen dieselbe Informationsgrundlage erhalten, damit eine geänderte Vorverarbeitung nicht als Modellverbesserung erscheint.
Schwellenwerte für Modell und Aufgabe festlegen
Ein Jev-Schwellenwert ist nicht allein deshalb übertragbar, weil eine andere API eine Wahrscheinlichkeit oder ein Feld namens confidence zurückgibt. Der Zusammenhang zwischen Bewertungen und tatsächlich beobachteter Korrektheit muss anhand gelabelter Beispiele erneut geprüft werden. Für fehlende Informationen, Anbieterausfälle und Verweigerungen ist ein eigener Prüfpfad nötig.
Schrittweise umstellen und die Rückkehr einfach halten
Nur den ausgewählten Workflow ändern. Die bisherige Modellkonfiguration und eine Möglichkeit zur Rückkehr bereithalten. Bei Änderungen am Checkpoint, Modellalias, Wortlaut der Fragen oder an der Vorverarbeitung erneut evaluieren: Jeder dieser Faktoren kann verändern, welche Entscheidungen die festgelegten Schwellenwerte akzeptieren.
Wenn der Ausgangspunkt Jev Router und kein direkter Jev-Entscheidungsaufruf ist, muss zuerst die Abrechnungsgrenze geklärt werden. Ein Routingdienst und das von ihm ausgewählte nachgelagerte Modell sind verschiedene Rechnungsposten. Der Preisleitfaden zu Jev Router erklärt den Unterschied. Ein günstiges Entscheidungsmodell macht die generierte Antwort nicht kostenlos.
Welche Kombinationen sich nicht anbieten
Microsoft-Decision-1 eignet sich nicht als Wechsel zur Tokenersparnis, wenn allein Jevs aktueller Basistarif stört. Die veröffentlichten Tarife sind identisch. Plattform oder Qualität können weiterhin für Microsoft sprechen, begründen dann aber eine andere Entscheidung.
Gehostetes Clef-flash sollte kein unbegrenzt wachsendes Informationsarchiv verarbeiten, solange dessen Eingabebudget nicht kontrolliert wird. Eine gültige Antwort nach dem Kürzen kann verdecken, dass eine entscheidende Information das Modell nie erreicht hat. Die Aufgabe muss zum Limit passen; andernfalls ist eine Variante mit ausreichendem Kontextfenster zu prüfen.
d1-omni-600M sollte nicht allein wegen des Namens omni zur uneingeschränkten Analyse langer Aufnahmen eingesetzt werden. Der dokumentierte Sprachumfang, die Begrenzung der Cliplänge und der experimentelle Status sind wesentlich. Wenn umfangreichere Medienverarbeitung gefragt ist, ist Clef-omni in dieser Auswahl der gehostete Kandidat, jeweils innerhalb seiner eigenen Grenzen.
Offene Gewichte sind kein Synonym für einen kostenlosen Produktionsdienst. Liquid hat eine an Bedingungen geknüpfte Lizenz, Perplexitys Referenzkonfiguration benötigt viel Speicher, und bei Strands liegt das Hosting in eigener Verantwortung. Mit dem Modelldownload beginnt die Verantwortung für den Betrieb.
Ein ungeprüfter Klon sollte nicht als Notfallersatz dienen. Ein ähnlicher Produktname oder ein scheinbar kompatibler Endpunkt belegt weder einen Anbieter noch eine nutzbare Lizenz, eine gepflegte Laufzeitumgebung oder einen unabhängigen Ausfallpfad. Der Ausschluss beruht auf fehlenden Nachweisen, nicht auf der Behauptung, jedes Community-Projekt liefere schlechte Ergebnisse.
Häufige Fragen
Gibt es kostenlose Jev-Alternativen?
Cloudflare bietet ein gemeinsam genutztes tägliches Freikontingent für Workers AI. Mehrere Alternativen veröffentlichen außerdem herunterladbare Gewichte. Rechenleistung muss jedoch selbst bereitgestellt werden, und die Lizenz gilt weiterhin. Liquids Dokumentation zum gehosteten Dienst führt separat ein reines Textmodell d1:free auf, ohne auf der hier geprüften Seite ein Kontingent zu nennen. Ein kostenloser Zugangsweg garantiert keinen kostenfreien Produktionsbetrieb. Leitfaden zu Liquids gehostetem Modell
Welche Jev-Alternativen bieten offene Gewichte?
Für die Clef-Familie, den genannten Perplexity-Checkpoint, Liquids beide d1-Checkpoints und Strands Decider haben die Anbieter Bezugswege für Gewichte veröffentlicht. Clef, Perplexity und der genannte Strands-Checkpoint verwenden Apache-2.0. Liquid nutzt die LFM Open License v1.0 mit einer Bedingung zur kommerziellen Nutzung. OpenAI Decisions und Microsoft-Decision-1 sind in diesem Vergleich gehostete Optionen; die zitierten Anbieterseiten nennen keine Lizenz für offene Gewichte.
Welche Jev-Alternative sollte zuerst getestet werden?
Für niedrigere gehostete Eingabekosten bietet sich Perplexity an, für eine bestehende Workers-Anwendung Clef-flash, für Foundry Microsoft-Decision-1 und für eine OpenAI-Integration OpenAI Decisions. Im lokalen Betrieb ist d1-3B ein Einstieg für Text und Bilder, d1-omni-600M für ein eng begrenztes Sprachexperiment und Strands für eine nachvollziehbare Agentenkomponente. Die endgültige Wahl hängt von der Evaluation mit der eigenen Anwendung ab.
Der erste Schritt für die Praxis
Am besten beginnt der Wechsel bei einem Entscheidungsaufruf, dessen Verantwortliche konkret benennen können, wie ein teurer Fehler aussieht. Ein Kandidat wird anhand des tatsächlichen Bedarfs ausgewählt: Preis, Plattform, Medienformat oder lokaler Betrieb. Anschließend läuft er mit derselben Informationsgrundlage neben Jev. Umgestellt wird erst, wenn akzeptierte Fehlentscheidungen, Prüfaufwand und Antwortzeiten im zulässigen Rahmen bleiben. Die ursprüngliche Konfiguration sollte bereitstehen, bis sich der neue Weg im normalen Betrieb bewährt hat.
Die Checkliste zur Prüfung von KI-gestützten Geschäftsabläufen hilft dabei, die erste lohnende Entscheidungsaufgabe für einen Wechsel zu finden.
- Veröffentlicht
- Kategorie
- Build
- Sprache

KI-Klassifizierung mit der OpenAI Decisions API
Tickets zuweisen und Daten klassifizieren mit der OpenAI Decisions API: drei Anfragetypen, Preise, Grenzen und der Umgang mit verweigerten Antworten.11. Okt. 2026Build
Claude Code Remote Control: Einrichtung und Fernzugriff
Claude Code Remote Control einrichten, per Smartphone oder Browser weiterarbeiten und typische Anmelde- und Verbindungsfehler gezielt beheben.9. Okt. 2026Build
Cursor App fürs iPhone: Lokale Agenten fernsteuern
Mit der Cursor App lokale Agenten vom iPhone aus steuern: So funktionieren Kopplung und Fernzugriff, so bleibt der Laptop erreichbar. Preise und Praxistipps.9. Okt. 2026Build
Firecrawl Pricing 2026: Welcher Tarif sich wirklich lohnt
Firecrawl Pricing im Überblick: Tarife, Credits und Zusatzkosten. Beispielrechnungen für JSON-Extraktion, Fehlerseiten und wöchentliche Crawls im Vergleich.9. Okt. 2026Build
Claude Code Kosten 2026: GitHub Copilot im Vergleich
Claude Code und GitHub Copilot im Vergleich: Kosten, Nutzungslimits, Modelle und Teamverwaltung. Welcher Tarif passt zu Editor, Terminal und Team?8. Okt. 2026Build
LangGraph oder CrewAI? KI-Agenten im Vergleich
LangGraph oder CrewAI für KI-Agenten? Der Vergleich zeigt Unterschiede bei Workflows, Freigaben, Speicher, MCP und den Kosten der gehosteten Plattformen.7. Okt. 2026Build
MCP Server erstellen: Mit Python vom lokalen Tool zum Teamdienst
MCP Server mit Python erstellen, in Inspector testen und an Claude Code oder Cursor anbinden. Dazu HTTP-Authentifizierung, Hosting und klare Zugriffsrechte.7. Okt. 2026Build