GLM Flash oder Jev: Welches Entscheidungsmodell passt?
GLM Flash oder Jev? Der Vergleich zeigt Kosten, Bildverarbeitung, Latenz und Einsatzgrenzen – plus einen fairen Testplan für die eigene Entscheidung.

- JJev
- PPrivatemode Decisions
- GGLM-5.3-Flash
- Lllama.cpp
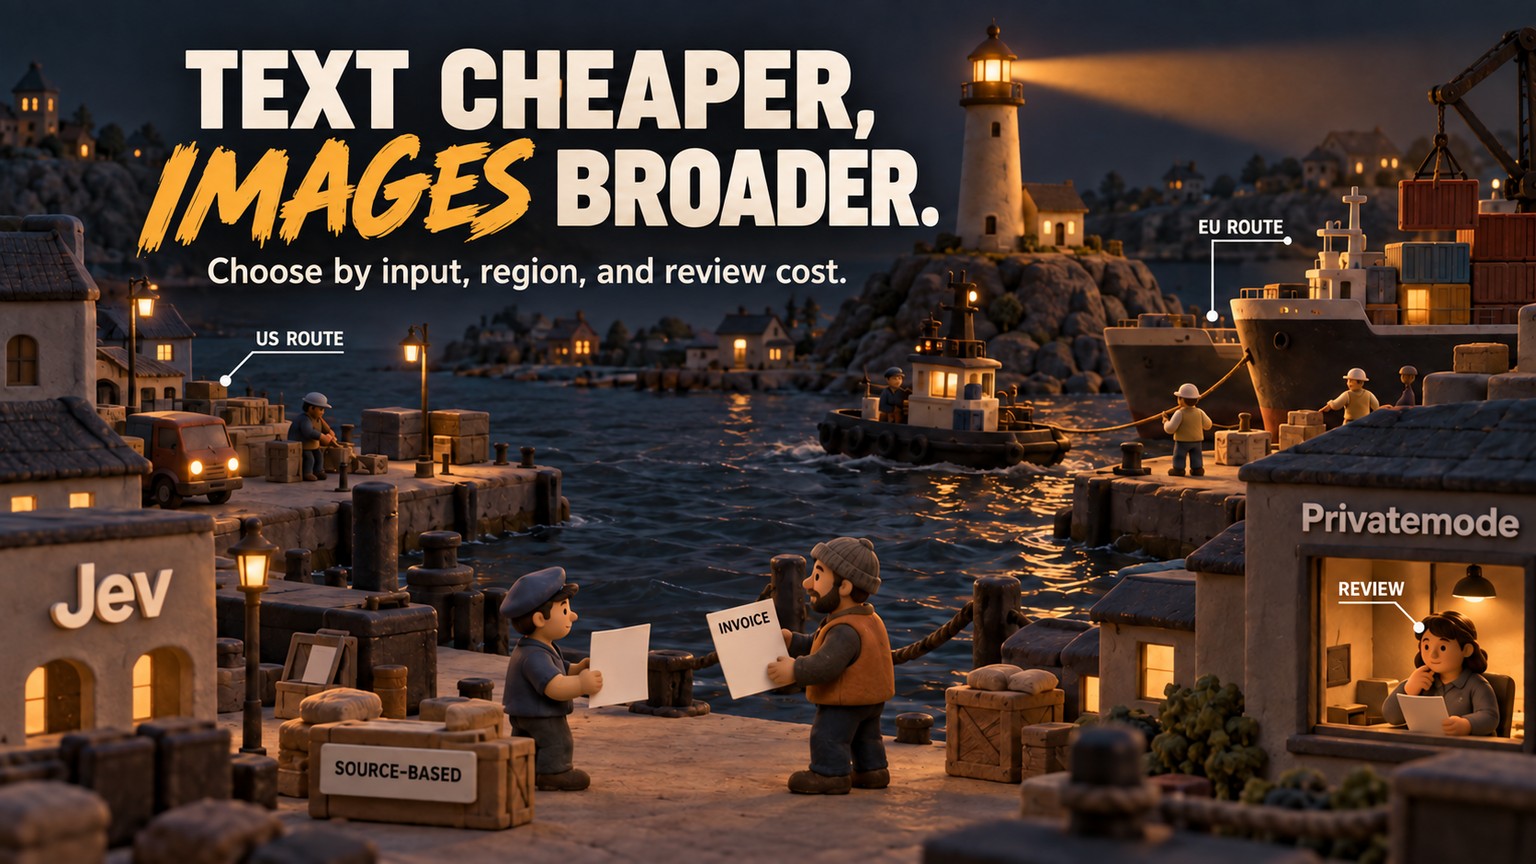
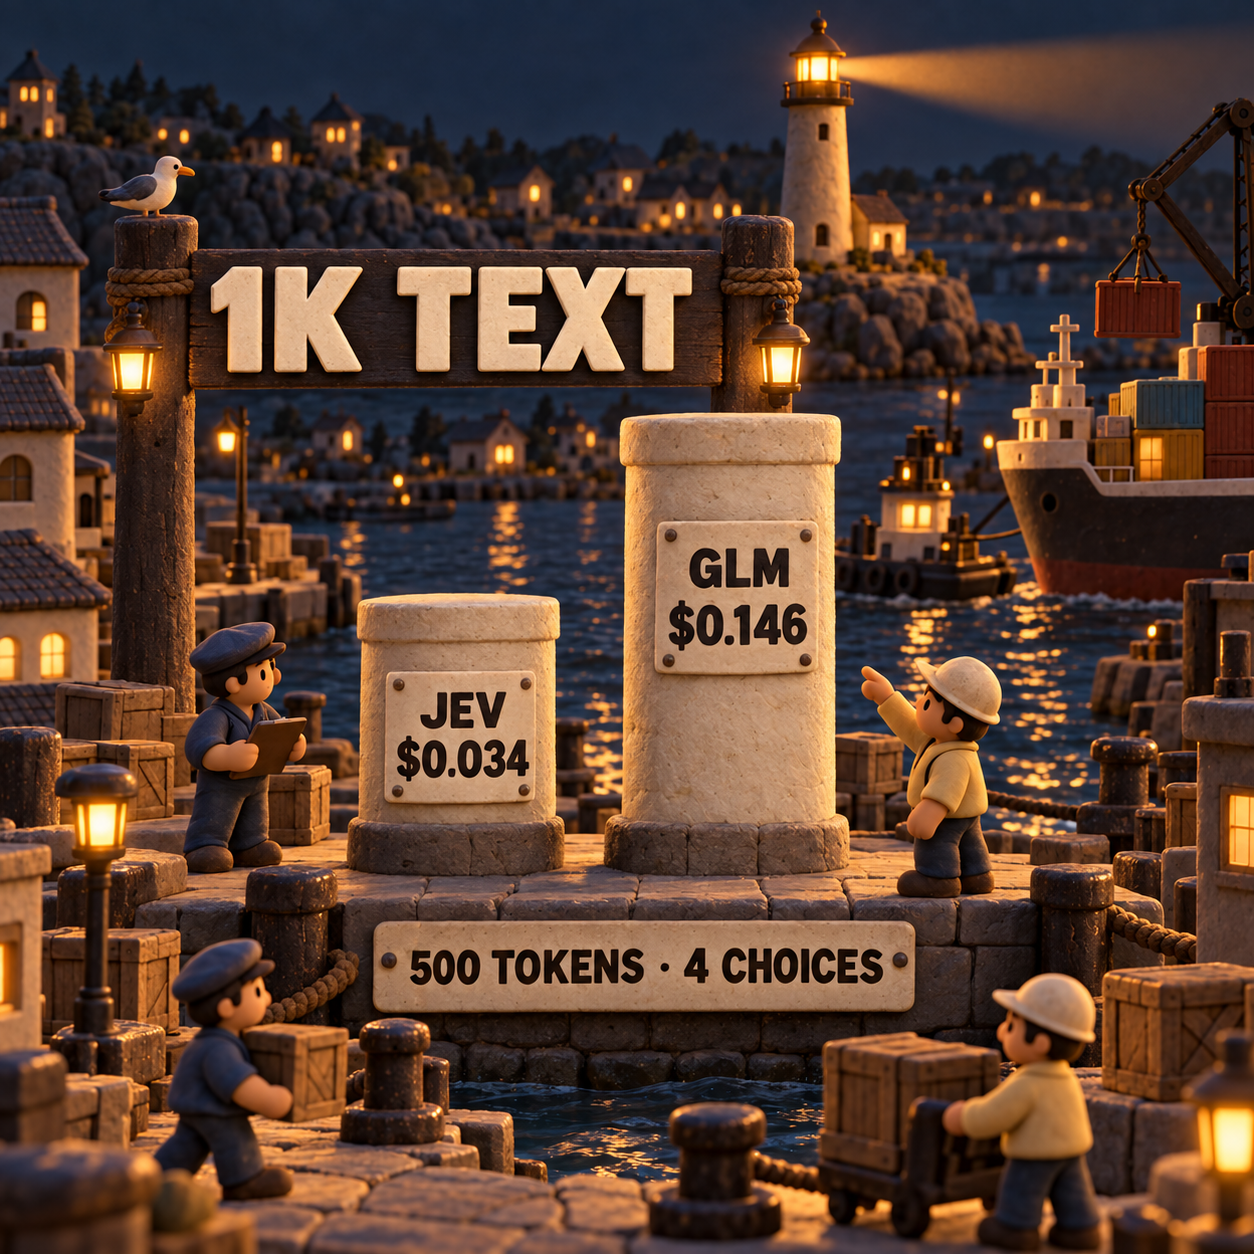
Jev ist die richtige Wahl für Text-Routing mit hohem Volumen, wenn vor allem möglichst niedrige reine Inferenzkosten zählen. GLM Flash – konkret GLM-5.3-Flash über Privatemode Decisions – passt besser, wenn Bilder, die Nähe zu einem europäischen Dienst, vertrauliche Verarbeitung oder Modellportabilität den Workflow bestimmen. Bei einem Ticket mit 500 Token und vier Auswahlmöglichkeiten ergeben die aktuellen Listenpreise rund $0.034 je 1,000 Entscheidungen mit Jev gegenüber $0.146 über Privatemode. Schon eine einzige gescannte Rechnung schließt Jev jedoch aus, sofern nicht zusätzlich ein OCR-Schritt vorgeschaltet wird.
GLM Flash oder Jev: Welches System passt?
Jev empfiehlt sich für reine Textklassifikation in großem Maßstab: Support-Tickets weiterleiten, Richtlinienbedingungen bewerten oder aus einer bekannten Menge genau eine Antwort auswählen. Der niedrige Eingabepreis macht das Modell beim reinen Kostenvergleich zum klaren Sieger. Zugleich hält die speziell entwickelte API den Entscheidungsvorgang unkompliziert.
GLM-5.3-Flash über Privatemode Decisions ist sinnvoller, sobald ein Zustand auch ein Bild enthalten kann, der Client näher am europäischen Privatemode-Dienst sitzt, vertrauliche Verarbeitung zum Kaufargument gehört oder dieselbe Bibliothek später einen anderen vLLM-basierten Server ansprechen soll. Jede Textentscheidung kostet mehr, dafür kommen multimodale Eingaben und eine portablere Implementierung hinzu.
Für eine Textwarteschlange in den USA ist Jev die stärkere Standardwahl. Für eine bildbasierte Warteschlange in Deutschland ist der Privatemode-Weg sinnvoller. Passt keines dieser Profile, sollte die Entscheidung nicht anhand einer Feature-Tabelle fallen. Lassen Sie dieselben beschrifteten Fälle durch beide Systeme laufen und bewerten Sie Fehler sowie Übergaben – nicht nur Token.
GLM Flash im Vergleich: Was Jev und GLM-5.3-Flash unterscheidet
Jev und GLM-5.3-Flash sind keine austauschbaren Chatmodelle. Jev ist ein speziell trainiertes Entscheidungsmodell. Die API erhält einen Zustand samt typisierter Frage wie Choice oder Score und gibt eine Antwort mit Wahrscheinlichkeiten sowie einer Konfidenzkennzahl zurück. Das Produkt ist für den klar umrissenen Moment gedacht, in dem Software entscheiden statt sich unterhalten soll.
Privatemode Decisions legt eine Bibliothekstechnik um ein allgemeines Sprachmodell. Die Bibliothek übergibt GLM-5.3-Flash benannte Optionen, beschränkt das nächste Token auf die zulässigen Optionsindizes, liest deren Token-Wahrscheinlichkeiten aus und normalisiert sie neu. Ein Forward-Pass und ein Ausgabetoken machen so aus einem breit einsetzbaren multimodalen Modell einen schnellen, kontrollierten Entscheider.
Dieser Unterschied verändert die Kaufentscheidung. Jev ist der spezialisierte Dienst. Privatemode Decisions besteht aus der Entscheidungsschicht sowie dem dahinterliegenden Modell und Endpunkt. Die Bibliothek kann einen OpenAI-kompatiblen vLLM-Server ansprechen; der eigene Privatemode-Endpunkt ergänzt die Bereitstellung mit Confidential Computing. Die Portabilität gehört zur Bibliothek. Die Garantien von Privatemode für verschlüsselte Verarbeitung gelten dagegen nicht automatisch auf einem beliebigen Server.
Hinzu kommt eine leicht zu übersehende Namensfalle. Die hier verglichene Jev Decisions API ist nicht das OpenRouter-Produkt namens Jev Router. Letzteres wählt für einen Prompt ein Modell aus. Falls genau dieses Produkt bewertet werden soll, hilft der separate Leitfaden zu den Kosten von Jev Router. Wer beide Produkte vermischt, erhält bei Kosten und Fähigkeiten durchweg falsche Vergleiche.
Beim Text-Routing gewinnt Jev über den Preis
Für eine Warteschlange mit gewöhnlichen Texttickets ist Jev passender, weil die Schnittstelle bereits in Entscheidungen denkt. Die aktuelle Modellseite von TypeSafe führt jev-1.13.0 mit $0.042 je Million Eingabetoken und kostenloser Ausgabe. Der Alias jev-latest verweist derzeit auf diese Version. Die Antwort enthält außerdem ein versioniertes Feld model, das ins Testprotokoll gehört.
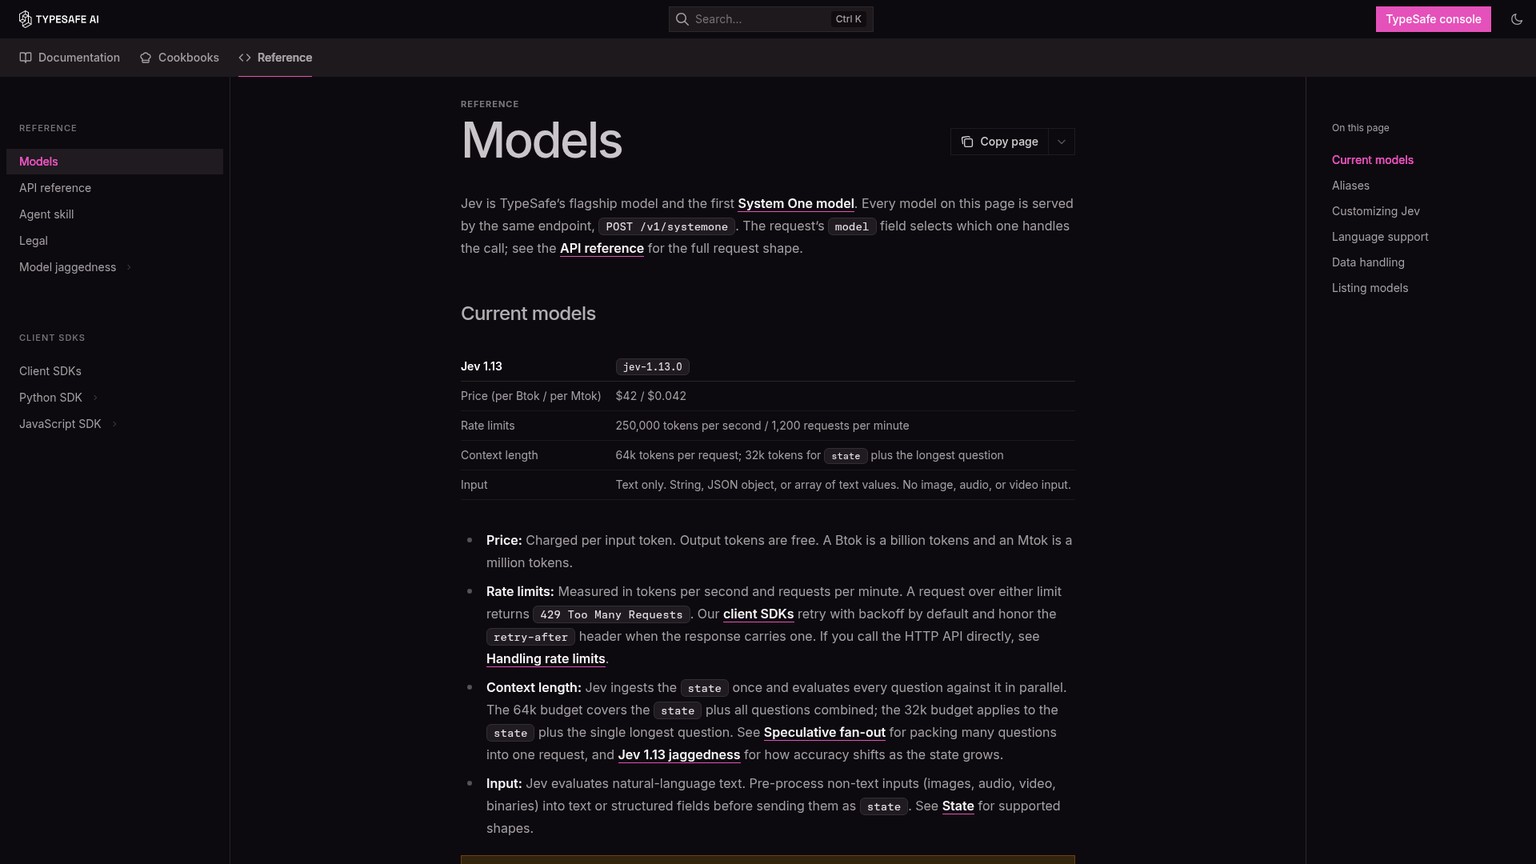
Ein Aufruf für das Support-Routing kann das Ticket als Zustand und Optionen wie Abrechnung, Kündigung, Fehler und keine dieser Optionen enthalten. Jev akzeptiert Zeichenketten und strukturierte Texte wie JSON oder Arrays, aber keine Bilder, Audio- oder Videodaten. Pro Anfrage gilt eine Grenze von 64,000 Token; für den Zustand plus die längste Frage sind es 32,000 Token. Für Ticket-Routing ist das großzügig bemessen, doch ein angehängter Scan wird dadurch nicht zu Text.
Der Vorteil ist wirtschaftlicher Natur. Nach der Verpackungsschätzung des Anbieters kommen bei einer Entscheidung mit vier Optionen ungefähr 270 feste Token sowie 10 Token je Option hinzu. Zusammen mit einem Ticket von 500 Token entstehen 810 abrechenbare Eingabetoken. Beim aktuellen Preis sind das $0.00003402 je Entscheidung.
Wenn Jev im eigenen Stack noch neu ist, erklärt die vorhandene Anleitung zum Support-Routing mit Jev die API-Einrichtung. Dieser Vergleich setzt danach an: bei der Frage, ob ein Spezialist für reine Textdaten weiterhin genügt.
Kategoriesieger: Jev für reines Text-Routing im Support und niedrige Inferenzkosten.
Privatemode Decisions: GLM Flash als Entscheidungsmodell
Privatemode Decisions ist die passendere Lösung, wenn der Fall selbst ein Bild enthält oder die Entscheidungslogik zwischen kompatiblen Modellservern wechseln können soll. Der erste Commit der Bibliothek erschien am 21. September 2026. Die festgeschriebenen Release-Metadaten nennen Version 0.1.0, Python >=3.10 und einen Kern ohne Abhängigkeiten.
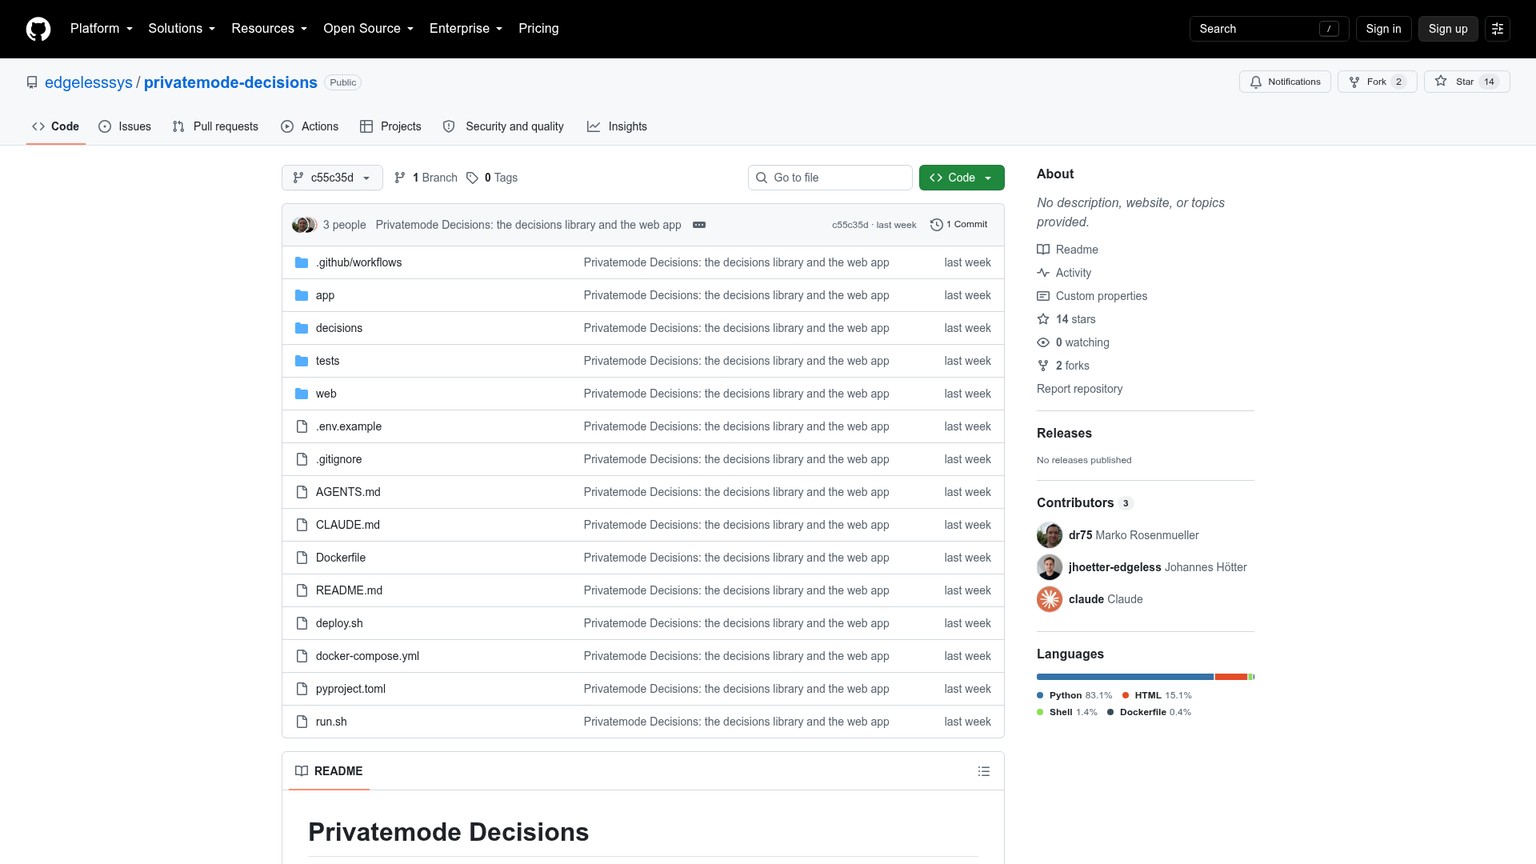
Der aktuelle Privatemode-Modellkatalog stellt GLM-5.3-Flash über Endpunkte für Chat Completions, Completions und Messages bereit. Das Modell verarbeitet Text und Bilder und bietet ein Kontextfenster von 1 Million Token. Die offizielle Modellkarte beschreibt ein nativ multimodales Mixture-of-Experts-Modell mit insgesamt 320 Milliarden und 18 Milliarden aktiven Parametern.
Für die Integrität eines Tests ist der Modellname entscheidend. Der Beispielcode nutzt glm-flash-latest, also einen beweglichen Alias. Aktuell verweist er auf die Preview glm-5.3-flash; daraus folgt jedoch nicht, dass jeder künftige Lauf ebenfalls GLM-5.3-Flash verwendet. Vor der Ergebniserfassung sollte deshalb das tatsächlich ausgelieferte Modell ermittelt und protokolliert werden. Außerdem speichert die Bibliothek die Token-IDs der Optionen je Modell 10 Minuten lang im Cache. Bei einem kontrollierten Test sollten daher sowohl ein Versionswechsel als auch ein veralteter Cache ausgeschlossen werden.
Die Ein-Token-Methode ist effizient, hat aber Grenzen. Optionen müssen sich auf Indizes abbilden lassen, die jeweils aus einem einzelnen Token bestehen. Die Implementierung unterstützt bis zu 191 Indizes. Eine Frage mit 151 Optionen benötigt jedoch zwei Lesevorgänge, weil der gehostete Endpunkt pro Antwort höchstens 128 angeforderte Token-IDs mit Log-Wahrscheinlichkeiten liefert. Für übliche Routing-Taxonomien reicht das bequem; bei einem riesigen flachen Labelraum ist eine Hierarchie womöglich die bessere Konstruktion.
Kategoriesieger: GLM-5.3-Flash über Privatemode Decisions bei Bildeingaben, Kontext und Laufzeitportabilität.
Genauigkeit ist ein Workload-Ergebnis, keine Wahrscheinlichkeit
Weder eine hohe Wahrscheinlichkeit noch ein breit angelegter Benchmark beweist, dass das nächste Ticket richtig eingeordnet wird. Beide Systeme normalisieren die Konfidenz über die gestellte Frage. Fehlt die richtige Antwort, kann das Modell trotzdem großes Vertrauen in die am wenigsten falsche angebotene Option zeigen. Eine ausdrückliche Auswahl none of these gehört daher zur Aufgabendefinition und ist kein optionaler Notausgang.
Der veröffentlichte Vergleich von Privatemode umfasste 29 öffentlich verfügbare beschriftete Datensätze; beide Systeme konnten 28 Textdatensätze beantworten. Jedes System führte bei 10, weitere acht lagen innerhalb eines Prozentpunkts. Die gemeldete mediane Differenz betrug 0.7 Prozentpunkte zugunsten von Jev bei p=0.64. Identische Läufe mit Temperatur null veränderten bis zu 3.5% der Antworten, weshalb der Anbieter kleine Abstände als Rauschen behandelte. Das sind nützliche, vom Anbieter gemeldete Messwerte – aber kein Benchmark dieses Artikels.
Ein unabhängiger Benchmark von Kumzha testete je Aufgabe 200 von Menschen beschriftete Elemente. Für Banking77 wurden 83.5% Genauigkeit bei GLM-5.3-Flash und 81.5% bei Jev 1.13 gemeldet; bei der Klassifikation von Prompt-Injection waren es anschließend 91.0% gegenüber 86.0%. Die Evidenz ist unabhängig, validiert Privatemode Decisions aber nicht. Im GLM-Zweig kam gewöhnliche kontrollierte Generierung über OpenRouter mit niedrigem Reasoning zum Einsatz, während Jev direkt eine AWS-Origin in Oregon ansprach. Damit unterschieden sich sowohl die Latenzpfade als auch die Entscheidungsmethoden.
Die belastbare Schlussfolgerung bleibt bewusst zurückhaltend: Veröffentlichte Daten belegen keinen universellen Sieger bei der Genauigkeit. Sie zeigen jedoch, dass beide Wege seriöse Kandidaten für einen Test mit den eigenen Labels sind. Die Scorecard sollte eine gewöhnliche Fehlentscheidung getrennt von einer falschen Entscheidung mit hoher Konfidenz ausweisen, denn letztere umgeht mit höherer Wahrscheinlichkeit die menschliche Prüfung.
Kategoriesieger: kein allgemeiner Sieger bei der veröffentlichten Textgenauigkeit. Jev oder GLM gewinnt erst, wenn derselbe beschriftete Workload durch beide Systeme gelaufen ist.
Die Latenz hängt von der Client-Region ab
Latenz ist zunächst eine Frage der Geografie und erst danach des Modells. Bei der gleichzeitigen Messung von Privatemode über vier Datensätze lagen die Mediane in Deutschland bei 180 ms für Privatemode und 264 ms für Jev. Bei einem Client in den USA kehrte sich die Reihenfolge um: 299 ms für Privatemode und 164 ms für Jev.
Das Repository nennt separat etwa 150 ms einschließlich Netzwerkzeit für eine typische Privatemode-Entscheidung. Dieser Wert bietet eine nützliche Orientierung, stammt aber nicht aus derselben Messung wie der regionale Test mit vier Datensätzen. Die Kernaussage des Repositorys und der Blogtest sind deshalb als zwei getrennte, vom Anbieter gemeldete Perspektiven zu behandeln – nicht als ein gemeinsamer Benchmark.
Für einen Support-Desk in Frankfurt weist der veröffentlichte Latenzwert zugunsten des europäischen Privatemode-Pfads. Für einen Worker in den USA zeigt der vom Anbieter gemeldete Median einen Vorteil für Jev. Ein aussagekräftiger Test hält die Client-Region konstant und zeichnet sowohl p50 als auch p95 auf, denn eine Warteschlange spürt das langsame Ende der Verteilung und nicht nur den mittleren Aufruf.
Kategoriesieger: Privatemode in den gemeldeten Deutschland-Tests; Jev im gemeldeten US-Test.
Preisunterschied und das Ergebnis ohne Schnittpunkt
Die am 27. September 2026 geprüften Live-Preise sind eindeutig. Jev 1.13 kostet $0.042 je Million Eingabetoken; die Ausgabe ist kostenlos. Das Preisblatt von Privatemode führt GLM-5.3-Flash mit €0.20 je Million Eingabetoken, €0.65 je Million Ausgabetoken und €0.05 je Million zwischengespeicherter Eingabetoken auf, zuzüglich Mehrwertsteuer, wo sie anfällt. Für einen direkten Vergleich in USD verwendet die folgende Rechnung den EZB-Referenzkurs vom 25. September von €1 zu $1.1403.
Die gängige Entscheidung geht von einem Zustand mit 500 Token und vier Optionen einschließlich none of these aus. Mit der vom Anbieter angegebenen Prompt-Verpackung sendet Jev etwa 810 Eingabetoken. Privatemode Decisions sendet ungefähr 635 Eingabetoken und erzeugt ein Ausgabetoken. GLM verpackt hier weniger Token, doch der umgerechnete Preis je Eingabetoken liegt etwa 5.43-mal so hoch wie bei Jev. Dadurch kostet die Entscheidung ungefähr das 4.28-Fache.
Bei diesen Listenpreisen und linearen Verpackungsschätzungen gibt es keinen nichtnegativen Schnittpunkt der reinen Tokenkosten. Zwar bleibt der Privatemode-Prompt bei weniger als etwa 21 Optionen kürzer, doch der Preisunterschied ist zu groß, als dass sich die Linien schneiden könnten. Liefern beide Wege dasselbe betriebliche Ergebnis, bleibt Jev günstiger.
Die Inferenz ist allerdings nicht die gesamte Rechnung. Bei 100,000 gängigen Entscheidungen beträgt die reine Differenz etwa $11.1539. Angenommen, eine Prüfung kostet $30 pro Stunde, dauert zwei Minuten und verursacht damit $1 je Übergabe. Dann müsste Privatemode pro 100,000 Entscheidungen 12 menschliche Übergaben vermeiden, um den Inferenzaufschlag auszugleichen. Das ist ein Szenario und keine Behauptung, dass dies tatsächlich gelingt.
Verantwortet werden sollte diese Kennzahl: (inference cost + review cost + retry cost) / correct decisions. Ein günstigerer Aufruf kann verlieren, wenn er mehr Eskalationen auslöst. Ein teurerer Aufruf kann gewinnen, wenn er ein Bild ohne separaten OCR-Dienst verarbeitet. Ohne Zugangsdaten für beide Systeme lässt sich keine ehrliche beobachtete Kennzahl zu den Kosten je korrekter Entscheidung veröffentlichen.
Kategoriesieger: Jev bei den reinen Textkosten. Der Sieger im Workflow hängt von gemessenen Fehlern, Wiederholungen, OCR und menschlicher Prüfung ab.
Bei Dokumenten-Triage geben Bilder den Ausschlag
GLM-5.3-Flash gewinnt den direkten Eingabevergleich bei gescannten Rechnungen, weil Privatemode Bilder akzeptiert und Jev nicht. Das ist eine klare Fähigkeitsgrenze und kein kleines Feature-Delta. Ein Jev-Workflow benötigt vor dem Entscheidungsaufruf OCR oder ein weiteres Vision-Modell. Damit kommen ein zweiter Anbieter, eine zusätzliche Fehlerquelle, mehr Latenz und eigene Kosten hinzu.
Privatemode meldet 70.2% Genauigkeit bei 1,600 gescannten RVL-CDIP-Dokumenten aus 16 Klassen. Jev konnte an diesem Bildtest nicht teilnehmen. Laut Anbieter erhöht jedes Bild die Eingabe um rund 1,350 Token; geschätzt werden etwa €270 für 1 Million Dokumententscheidungen. Die Ergebnisse belegen, dass dieser Weg Scans verarbeiten kann. Wie er mit den eigenen Rechnungen umgeht, belegen sie nicht.
Fünf synthetische Rechnungen sollten als eigener Fähigkeitstest geführt werden. Bei der üblichen Basis von 500 Token zuzüglich der gemeldeten 1,350 Token je Bild würde eine Privatemode-Entscheidung etwa €0.00039765 oder $0.00045344 kosten; für fünf wären es etwa €0.00198825 oder $0.0022672. Diese fünf Ergebnisse dürfen nicht in die Genauigkeitswertung der 30 Texttickets einfließen. Andernfalls erhält GLM Punkte für die Teilnahme an einem Test, zu dem Jev gar nicht antreten kann, und der Textvergleich verliert seine Aussagekraft.
Kategoriesieger: GLM-5.3-Flash für die direkte Triage von Dokumentbildern.
Vor einem Wechsel: derselbe Test mit 30 Tickets
Der kleinste glaubwürdige interne Vergleich besteht aus einem eingefrorenen Satz von 30 beschrifteten synthetischen Tickets. Beide Systeme erhalten identische Optionen in identischer Reihenfolge und ausdrücklich die Auswahl none of these. Synthetische Fälle verhindern, dass bei der Evaluierung Kundendaten übertragen werden. Trotzdem sollten sie auch kurze, mehrdeutige und außerhalb des Geltungsbereichs liegende Tickets abbilden, an denen ein produktives Routing scheitert.
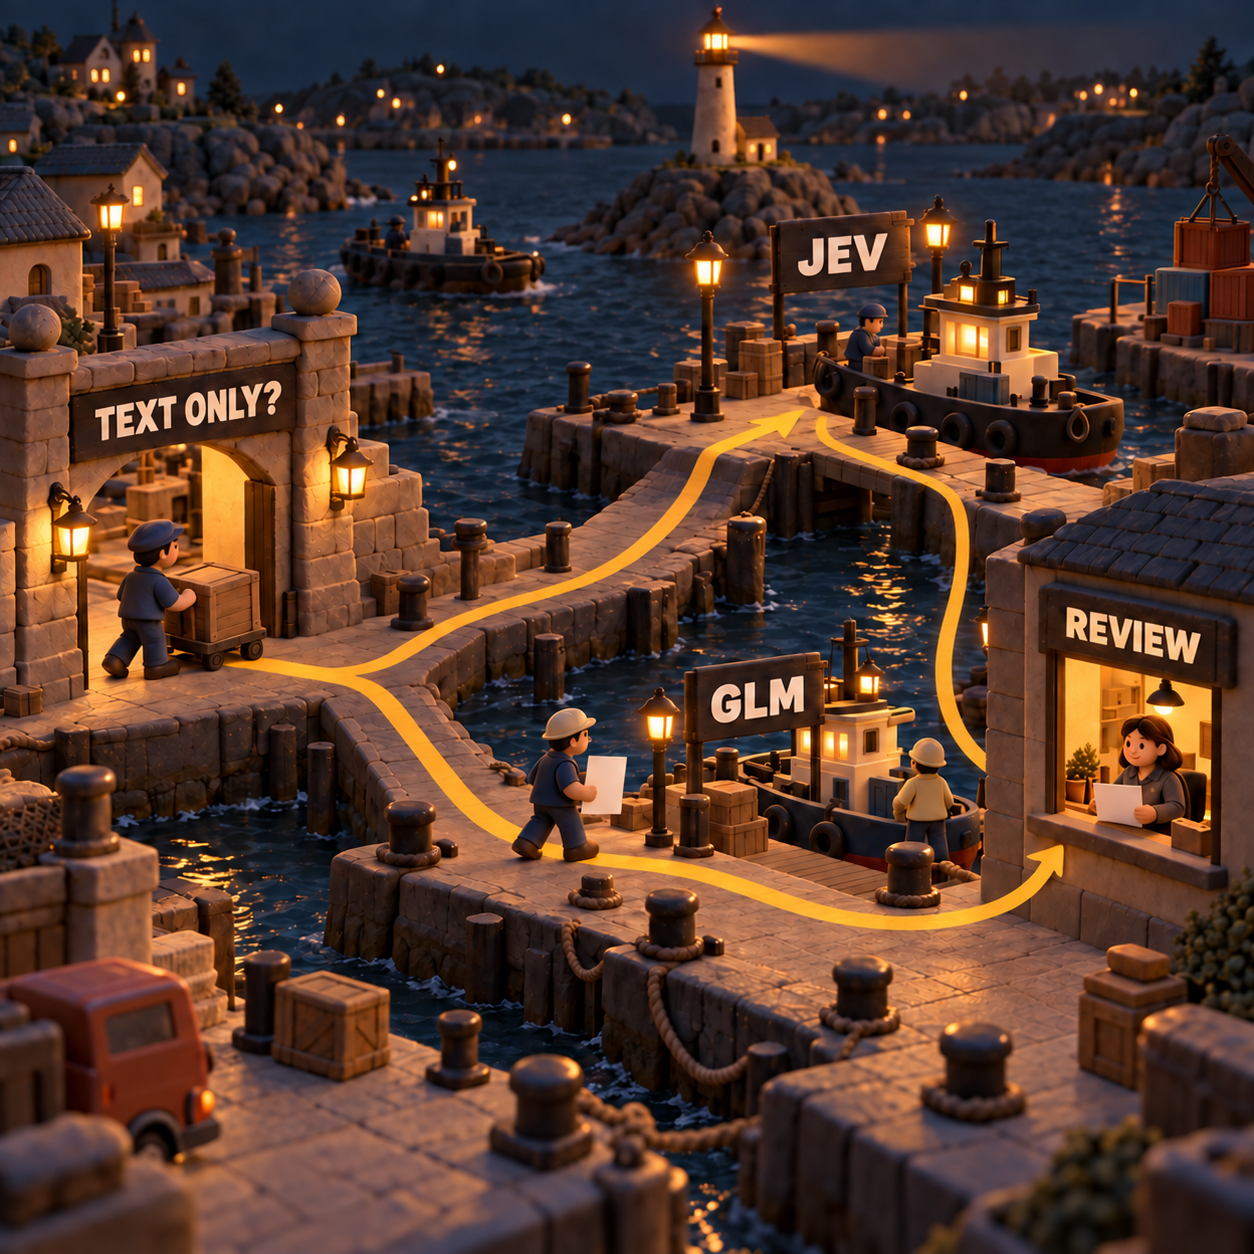
Testbestand einfrieren
Speichern Sie 30 Texttickets, ihre erwarteten Labels und die erlaubten Optionen in einer einzigen versionierten Datei. Nehmen Sie
none of theseauf, halten Sie die Reihenfolge der Optionen fest und legen Sie die fünf Rechnungsbilder als separaten Fähigkeitstest zurück.Ausgelieferte Endpunkte und Modelle festhalten
Rufen Sie die fest versionierte Variante
jev-1.13.0auf oder protokollieren Sie das von Jev zurückgegebene Feldmodel. Lösen Sieglm-flash-latestauf und halten Sie das tatsächlich bereitgestellte Modell fest, bevor das Ergebnis als GLM-5.3-Flash-Test bezeichnet wird. Notieren Sie bei beiden auch Endpunkt und Client-Region.Identische Entscheidungen wiederholen
Senden Sie denselben Zustand und semantisch identische Optionen an beide Wege. Verbessern Sie nicht stillschweigend nur einen Prompt, ändern Sie nicht nur eine Labelreihenfolge und zählen Sie Wiederholungen nicht nur auf einer Seite.
Betriebsdaten vollständig erfassen
Speichern Sie für jeden Aufruf die Laufwerte p50 und p95, Eingabetoken, abgerechnete Kosten, ausgewählte Option, Wahrscheinlichkeit oder Konfidenz, Korrektheit, Wiederholung und menschliche Übergabe. Kennzeichnen Sie falsche Entscheidungen mit hoher Konfidenz gesondert.
Bilder außerhalb der Textwertung testen
Senden Sie fünf synthetische Rechnungsbilder über Privatemode. Erfassen Sie Modell, Token, Kosten, Latenz und Label. Markieren Sie Jev als für direkte Eingaben ungeeignet, statt es als fehlerhaften Textklassifikator zu werten.
Kosten je korrekter Entscheidung berechnen
Addieren Sie Inferenz-, Wiederholungs-, Vorverarbeitungs- und Personalkosten und teilen Sie die Summe anschließend durch die Anzahl korrekter Entscheidungen. Weisen Sie das gemeinsame Ergebnis der 30 Texttickets und das Ergebnis der fünf Bilder getrennt aus.
Die reine Inferenz für den geplanten Textlauf läge vor Wiederholungen bei etwa $0.0010206 mit Jev gegenüber €0.0038295 oder $0.0043668 mit Privatemode. Diese Differenz ist zu klein, um eine Kaufentscheidung zu tragen. Wertvoll ist der Lauf, weil er die Passung der Labels, die Kalibrierung, die regionale Tail-Latenz und das Übergabeverhalten sichtbar macht.
Wechselkosten – und wer nicht wechseln sollte
Der Umstieg von Jev auf Privatemode Decisions ist mehr als der Austausch eines Modellnamens. Aus einer Jev-Choice oder einem Score wird eine Bibliotheks-Choice mit festen Optionsindizes. Das Team muss die vorhandene Taxonomie abbilden, Konfidenzschwellen neu erstellen, Client- und Wiederholungslogik ersetzen, den OpenAI-kompatiblen Endpunkt validieren und die Alias-Auflösung beobachtbar machen. War vertrauliche Verarbeitung der Grund für den Wechsel, muss die Bereitstellung auf dem abgedeckten Privatemode-Pfad bleiben und darf nicht zu einem beliebigen vLLM-Host wandern.
Auch der Wechsel in die Gegenrichtung verursacht Aufwand. Bilddaten benötigen OCR oder eine weitere Vision-Stufe. Lange Prompts müssen in die Kontextgrenzen von Jev passen. GLM-spezifische Prompt-Annahmen sind in Jev-Fragen zu überführen, und historische Wahrscheinlichkeiten dürfen nicht als austauschbare Kalibrierung behandelt werden.
Ist GLM-5.3-Flash eine Alternative zu Jev?
Ja – bei Textentscheidungen mit endlich vielen Optionen und besonders dann, wenn derselbe Workflow auch Bilder benötigt. Nein, wenn „Alternative“ einen nahtlosen Ersatz mit identischer Konfidenz sowie gleichen Infrastruktur- und Compliance-Eigenschaften meint. API-Form, Vorverarbeitung, Modelllebenszyklus und Bereitstellungsgrenze ändern sich sämtlich.
Ein Wechsel weg von Jev lohnt sich nicht, wenn die Warteschlange nur Text enthält, die Labels stabil sind, die derzeitige Genauigkeit genügt und eingesparte Bruchteile eines Cents je tausend Entscheidungen wichtiger sind als multimodale Eingaben. Ein Wechsel weg von Privatemode ist nicht sinnvoll, wenn direkte Bildeingaben oder der vertrauliche europäische Dienst unverzichtbar sind. In beiden Richtungen genügt ein knapper Vorsprung in einem öffentlichen Benchmark nicht, um das Migrationsrisiko zu rechtfertigen.
Der nächste Schritt am Montag
Frieren Sie den Testbestand ein, bevor jemand Prompts auf bevorzugte Beispiele zuschneidet. Erfassen Sie die 30 synthetischen Tickets, fünf synthetischen Rechnungen, die Auswahltaxonomie, erwartete Labels, die Annahme zu Prüfungskosten und die Client-Region in einem Testprotokoll. Ergänzen Sie Felder für tatsächliche Modellversion, Endpunkt, p50, p95, Token, abgerechnete Kosten, Wiederholungen, falsche Entscheidungen mit hoher Konfidenz und Übergaben.
Warten Sie dann auf beide Zugangsdaten und führen Sie den gemeinsamen Workload aus. Bis dahin bleibt nur eine bedingte, aber belastbare Entscheidung: Jev führt beim günstigen Text-Routing; GLM-5.3-Flash über Privatemode Decisions bei direkter Bildeingabe und dem portablen Bibliothekspfad.
Häufig gestellte Fragen
Was unterscheidet GLM-5.3 von GLM-5.3-Flash?
Bei Privatemode verarbeitet GLM-5.3 ausschließlich Text und kostet €1.55 je Million Eingabetoken sowie €7.74 je Million Ausgabetoken. GLM-5.3-Flash akzeptiert Bilder und kostet €0.20 für die Eingabe und €0.65 für die Ausgabe je Million Token. Damit ist Flash dort die günstigere und multimodale Option.
Ist GLM Flash gut?
GLM-5.3-Flash ist ein ernst zu nehmender Kandidat, wenn eine Entscheidungsaufgabe Bilder, langen Kontext oder die Privatemode-Bereitstellung verlangt. Ob das Modell „gut“ ist, hängt dennoch von Genauigkeit, Fehlern mit hoher Konfidenz, Latenz und den Kosten je korrekter Entscheidung auf den eigenen Labels ab.
Ist GLM-5.3-Flash Open Source?
Die Modelldateien stehen unter der MIT License. Damit ist die Frage nach der Modelllizenz beantwortet; Datenschutz und Bedingungen der Bereitstellung hängen weiterhin davon ab, wo und wie das Modell betrieben wird.
Unterstützt GLM-5.3-Flash Bilder?
Ja. Die offizielle Modellkarte beschreibt es als nativ multimodal, und Privatemode führt Bildeingaben für seinen GLM-5.3-Flash-Endpunkt auf.
Wofür steht GLM?
Die ursprüngliche Forschungsarbeit löst GLM als General Language Model auf.
Verfügt GLM-5.3-Flash über Vision-Fähigkeiten?
Ja. Das Modell akzeptiert Bilder ebenso wie Text und kann deshalb an einem Test mit gescannten Dokumenten teilnehmen, für den Jev als direkte Eingabe nicht infrage kommt.
Wie viele Parameter hat GLM-5.3-Flash?
Die offizielle Modellkarte von Z.ai nennt insgesamt 320 Milliarden Parameter, davon 18 Milliarden aktiv.
Ist GLM-4.7-Flash ein MoE-Modell?
Ja, allerdings handelt es sich um ein anderes Modell. Seine offizielle Modellkarte beschreibt eine Mixture-of-Experts-Architektur mit 30B-A3B. Diese Spezifikationen dürfen daher nicht auf GLM-5.3-Flash übertragen werden.
Ist GLM-5.3-Flash multimodal?
Ja. In diesem Vergleich ist genau das der entscheidende Vorteil bei der Triage gescannter Dokumente.
Sie möchten beide Optionen einfacher in den eigenen Stack einordnen? Der AI Tools Map for Business Owners hilft dabei, die Entscheidungsschicht zu planen, bevor ein weiteres Modell hinzukommt.
- Zuletzt aktualisiert
- 27. Sept. 2026
- Kategorie
- AI
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
Claude Opus 5.5 Vergleich: Lohnt sich der Wechsel von Opus 5?
Der Claude Opus 5.5 Vergleich zeigt Preise, Cache-Vorteile, Coding-Leistung und API-Änderungen, die vor einem Wechsel von Opus 5 zu prüfen sind.23. Sept. 2026AI
GPT-6 Sol oder Luna: Welches Modell passt zu welchem Job?
GPT-6 Sol oder Luna? Der Vergleich zeigt Preise, Stärken und Einsatzgebiete – und wann Sol den 20× höheren Tokenpreis gegenüber Luna wirklich rechtfertigt.23. Sept. 2026AI
Ist GPT-6 Luna kostenlos? Pläne, Limits und API-Kosten
Ist GPT-6 Luna kostenlos? Der Überblick zeigt Gratiszugang, nötige Tarife, separate API-Kosten und die bislang nicht veröffentlichten Nutzungslimits.22. Sept. 2026AI
Xiaomi MiMo nutzen: V2.6 vom Prompt bis zur API
Xiaomi MiMo V2.6 praxisnah einrichten: Prompt in Studio testen, passenden API-Schlüssel wählen und Flash, Pro oder UltraSpeed gezielt einsetzen.22. Sept. 2026AI
Xiaomi MiMo V2.6: Wann Flash, wann Pro?
Xiaomi MiMo V2.6 im Kostenvergleich: Warum Flash meist genügt, wann Pro den Aufpreis verdient und wie ein belastbarer Drei-Aufgaben-Test entscheidet.22. Sept. 2026AI
MiMo V2.6 kostenlos nutzen: Was wirklich gratis ist
MiMo V2.6 Flash ist vorübergehend kostenlos. So unterscheiden sich OpenCode-Aktion, MIT-Downloads, kostenpflichtige API und Desktop-Angebote.22. Sept. 2026AI
Grok API Kosten im Vergleich: Grok 4.7 oder Grok 4.6?
Was Grok 4.7 besser kann, wo Grok 4.6 die sichere Wahl bleibt und warum identische API-Preise noch nichts über die tatsächlichen Aufgabenkosten sagen.21. Sept. 2026AI