GLM-5.3-Flash ou Jev : quel modèle de décision IA choisir ?
Jev réduit le coût du routage texte, tandis que GLM-5.3-Flash gère les images. Comparez prix, latence, précision et contraintes avant de choisir.

- JJev
- PPrivatemode Decisions
- GGLM-5.3-Flash
- Lllama.cpp
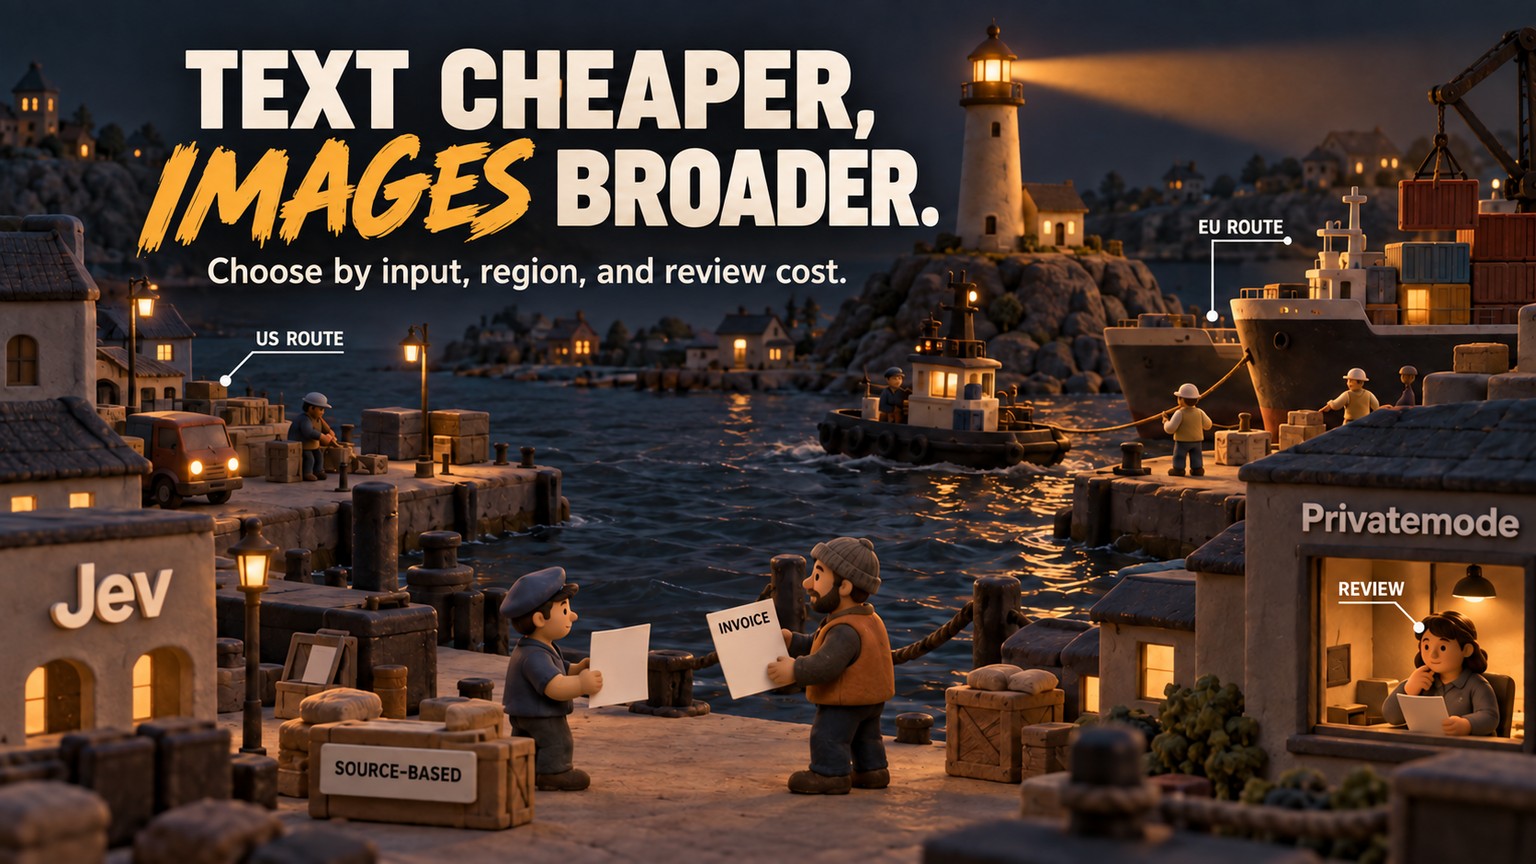
Choisissez Jev pour traiter de gros volumes de texte lorsque le coût brut d’inférence doit rester au plus bas. Préférez GLM-5.3-Flash via Privatemode Decisions si le workflow inclut des images, exige une infrastructure européenne ou un traitement confidentiel, ou doit pouvoir changer de modèle. Pour un ticket de 500 tokens et quatre choix, les tarifs affichés aujourd’hui reviennent à environ $0.034 pour 1,000 décisions avec Jev, contre $0.146 via Privatemode. En revanche, la présence d’une seule facture numérisée exclut Jev sans étape d’OCR séparée.
Quel modèle choisir ?
Jev convient aux tâches de classification textuelle à grande échelle : aiguiller un ticket de support, évaluer une condition de règle ou sélectionner une réponse dans une liste connue. Son faible tarif en entrée lui donne un avantage net sur le coût brut, et son API spécialisée garde le mécanisme de décision simple.
GLM-5.3-Flash via Privatemode Decisions prend l’avantage dès que l’état peut contenir une image, que le client est plus proche du service européen de Privatemode, que le traitement confidentiel compte dans l’achat ou que la même bibliothèque doit pouvoir pointer ensuite vers un autre serveur compatible vLLM. Chaque décision textuelle coûte plus cher, mais l’entrée devient multimodale et l’implémentation plus portable.
Pour une file de textes basée aux États-Unis, Jev constitue le meilleur choix par défaut. Pour une file d’images basée en Allemagne, la voie Privatemode est préférable. Si votre cas ne correspond à aucun de ces profils, ne tranchez pas à partir d’une grille de fonctionnalités. Faites traiter les mêmes cas étiquetés par les deux solutions et chiffrez les erreurs et les transferts, pas seulement les tokens.
Jev face à GLM-5.3-Flash : ce que ce choix implique vraiment
Jev et GLM-5.3-Flash ne sont pas deux modèles de chat interchangeables. Jev est un modèle de décision entraîné spécifiquement pour cette fonction. On lui envoie un état et une question typée, par exemple Choice ou Score ; l’API renvoie une réponse assortie de probabilités et d’un indicateur de confiance. Le produit vise cet instant précis où un logiciel doit choisir, et non converser.
Privatemode Decisions est une technique implémentée sous forme de bibliothèque autour d’un modèle de langage généraliste. Elle présente à GLM-5.3-Flash des options nommées, limite le token suivant aux index autorisés, lit leurs probabilités puis les renormalise. Une seule passe avant et un seul token de sortie suffisent ainsi à transformer un vaste modèle multimodal en moteur de choix contraint et rapide.
Cette différence change la question d’achat. Jev est le service spécialisé. Privatemode Decisions associe une couche de décision au modèle et à l’endpoint qui la sous-tendent. La bibliothèque peut cibler un serveur vLLM compatible avec l’API OpenAI, tandis que l’endpoint de Privatemode y ajoute son déploiement en informatique confidentielle. La portabilité vient de la bibliothèque ; les garanties de traitement chiffré de Privatemode ne se transfèrent pas automatiquement à n’importe quel serveur.
Attention aussi au piège du nom. L’API Jev Decisions comparée ici n’est pas le produit OpenRouter appelé Jev Router. Ce dernier sélectionne un modèle pour un prompt. Si c’est cette solution que vous évaluez, consultez plutôt le guide consacré au prix de Jev Router. Confondre les deux produits fausse toute comparaison de coût et de capacités.
Jev gagne sur le coût du routage de support textuel
Pour une file de tickets texte classiques, Jev s’intègre plus naturellement, car son contrat d’API exprime déjà des décisions. La page des modèles TypeSafe affiche actuellement jev-1.13.0 à $0.042 par million de tokens en entrée, sans frais de sortie. L’alias jev-latest pointe aujourd’hui vers cette version, et la réponse comporte un champ model versionné à consigner dans le journal de test.
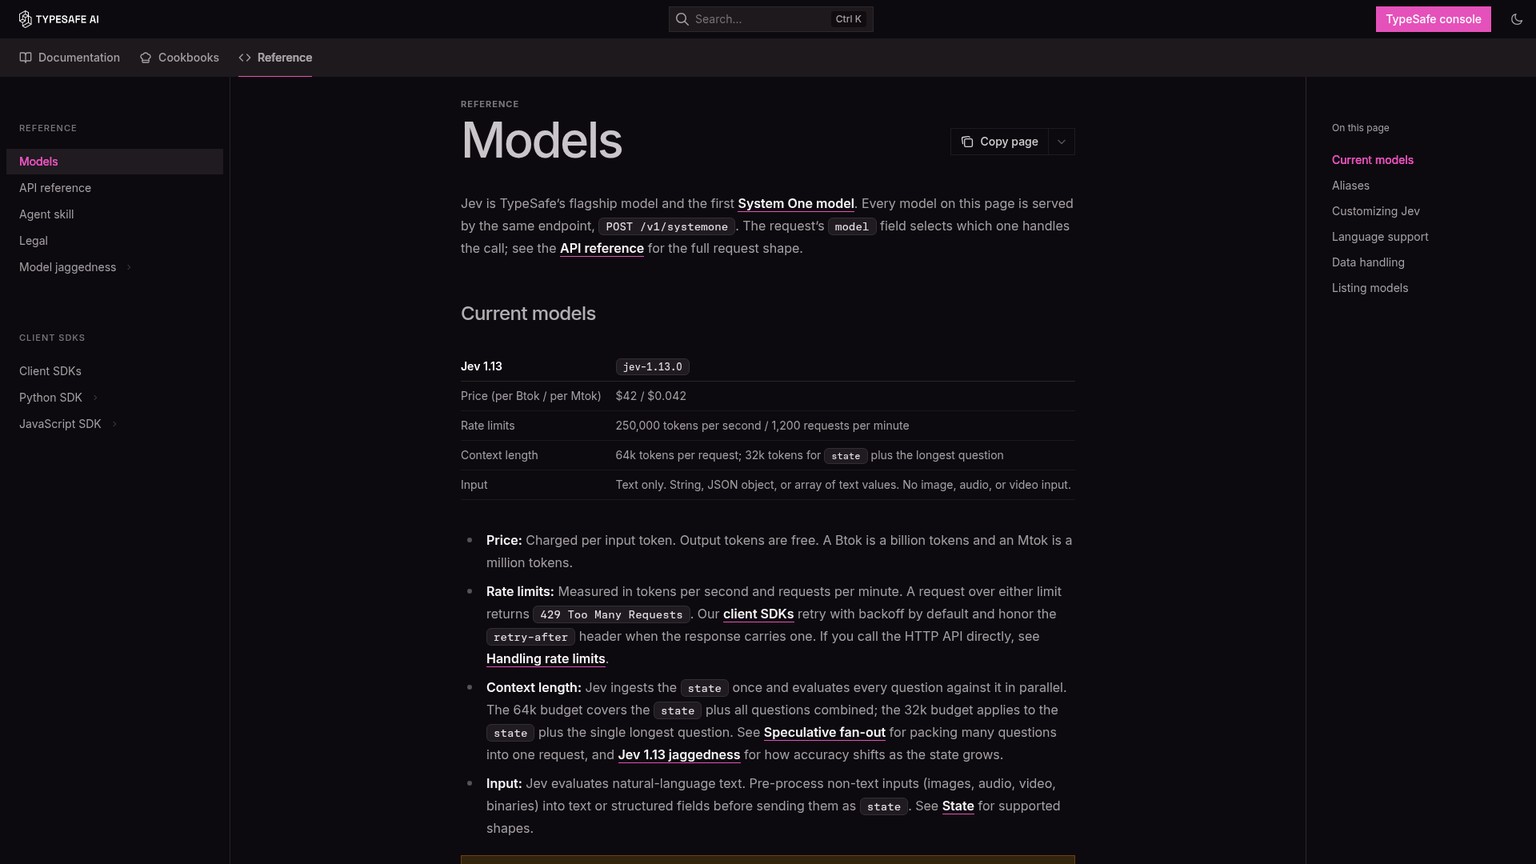
Un appel de routage peut transmettre le ticket comme état, avec des choix tels que facturation, résiliation, bug et aucun de ces choix. Jev accepte les chaînes de caractères et les textes structurés, notamment JSON ou tableaux, mais pas les images, l’audio ou la vidéo. Une requête est limitée à 64,000 tokens, et l’état additionné à la question la plus longue à 32,000 tokens. Ces plafonds sont généreux pour aiguiller des tickets, mais ils ne convertissent pas une pièce jointe numérisée en texte.
L’avantage est économique, pas magique. Selon l’estimation de packaging du fournisseur, une décision à quatre options ajoute environ 270 tokens fixes, puis 10 par option. Avec un ticket de 500 tokens, l’entrée facturable atteint donc 810 tokens. Au tarif actuel, chaque décision coûte $0.00003402.
Si Jev est nouveau dans votre stack, le guide existant sur le routage des tickets de support avec Jev détaille la configuration de l’API. Le présent comparatif intervient ensuite, lorsqu’il faut déterminer si un spécialiste limité au texte suffit encore.
Vainqueur de la catégorie : Jev pour le routage de support exclusivement textuel et le coût brut d’inférence.
Privatemode Decisions : le modèle de décision GLM Flash
Privatemode Decisions est mieux adapté lorsque le dossier contient lui-même une image ou lorsque la logique de décision doit pouvoir passer d’un serveur de modèles compatible à un autre. Le premier commit de la bibliothèque date du 21 septembre 2026. Les métadonnées épinglées indiquent la version 0.1.0, Python >=3.10 et un cœur sans dépendance.
Le catalogue Privatemode propose GLM-5.3-Flash via des endpoints de chat completions, completions et messages. Le modèle accepte le texte et les images, avec une fenêtre de contexte de 1 million de tokens. Sa fiche officielle le présente comme un modèle mixture-of-experts nativement multimodal, doté de 320 milliards de paramètres au total, dont 18 milliards actifs.
Pour préserver l’intégrité du test, le nom du modèle est décisif. Le code d’exemple utilise glm-flash-latest, un alias évolutif. Aujourd’hui, il correspond à la preview glm-5.3-flash, mais rien ne garantit que les prochains essais porteront encore sur GLM-5.3-Flash. Résolvez et consignez le modèle effectivement servi avant de collecter les résultats. La bibliothèque met aussi en cache les identifiants de tokens des options pendant 10 minutes pour chaque modèle : lors d’un test contrôlé, il faut donc écarter à la fois un changement de version et un cache périmé.
La méthode à un token est efficace, mais elle a ses limites. Les options doivent correspondre à des index tenant dans un seul token. L’implémentation gère jusqu’à 191 index ; une question à 151 options exige toutefois deux lectures, car l’endpoint hébergé renvoie au maximum 128 identifiants de tokens de log-probabilité par requête. Cela suffit largement aux taxonomies de routage ordinaires. Pour un immense espace d’étiquettes à plat, une hiérarchie peut être plus pertinente.
Vainqueur de la catégorie : GLM-5.3-Flash via Privatemode Decisions pour les images, le contexte et la portabilité d’exécution.
La précision dépend de la charge réelle, pas d’une probabilité
Ni une forte probabilité ni un benchmark généraliste ne prouvent que le prochain ticket sera correctement classé. Les deux systèmes normalisent leur confiance sur la question reçue. Si la bonne réponse manque, le modèle peut rester très sûr de l’option fournie la moins mauvaise. Un choix explicite none of these fait donc partie de la définition de la tâche ; ce n’est pas une simple porte de sortie facultative.
Le comparatif publié par Privatemode portait sur 29 jeux de données publics étiquetés ; les deux systèmes ont pu répondre à 28 jeux textuels. Chacun arrive en tête sur 10, et huit autres se jouent à moins d’un point de pourcentage. L’écart médian annoncé est de 0.7 point en faveur de Jev, avec p=0.64. Des exécutions identiques à température zéro ont fait varier jusqu’à 3.5% des réponses ; le fournisseur a donc considéré les petits écarts comme du bruit. Ces mesures publiées par le fournisseur sont utiles, mais elles ne constituent pas le benchmark de cet article.
Un benchmark indépendant de Kumzha a testé 200 éléments annotés par des humains pour chaque tâche. Il annonce une précision Banking77 de 83.5% pour GLM-5.3-Flash et de 81.5% pour Jev 1.13, puis respectivement 91.0% et 86.0% sur la détection d’injection de prompt. Cette source est indépendante, mais ne valide pas Privatemode Decisions. Le parcours GLM utilisait une génération contrainte classique via OpenRouter avec un faible niveau de raisonnement, tandis que Jev contactait directement une origine AWS située en Oregon. Les chemins réseau et les méthodes de décision différaient.
La conclusion utile reste volontairement mesurée : les données publiées ne désignent aucun champion universel de la précision sur texte. Elles montrent en revanche que les deux solutions méritent d’être testées sur vos propres étiquettes. Votre grille d’évaluation doit distinguer une simple erreur d’une erreur commise avec une confiance élevée, car cette dernière risque davantage d’échapper à la revue humaine.
Vainqueur de la catégorie : aucun au niveau général d’après les résultats publiés. Jev ou GLM ne gagne qu’après exécution de la même charge étiquetée sur les deux.
La latence varie selon la région du client
La latence dépend d’abord de la géographie, avant même de dépendre du modèle. Dans les mesures simultanées de Privatemode sur quatre jeux de données, les médianes relevées depuis l’Allemagne atteignaient 180 ms pour Privatemode et 264 ms pour Jev. Depuis un client américain, l’ordre s’inversait : 299 ms pour Privatemode, contre 164 ms pour Jev.
Le dépôt indique séparément qu’une décision Privatemode type prend environ 150 ms, réseau compris. C’est un repère utile, mais il ne s’agit pas de la même mesure que le test régional mené sur quatre jeux de données. Le chiffre mis en avant dans le dépôt et le test du blog doivent être lus comme deux observations distinctes du fournisseur, et non comme un benchmark unique.
Pour un service client à Francfort, la liaison européenne de Privatemode affiche la latence publiée la plus favorable. Pour un worker aux États-Unis, la médiane communiquée par le fournisseur favorise Jev. Un test pertinent fixe la région du client et relève à la fois p50 et p95 : une file subit les requêtes les plus lentes, pas seulement la valeur médiane.
Vainqueur de la catégorie : Privatemode dans les tests allemands publiés ; Jev dans le test américain publié.
Écart de prix : pourquoi les courbes ne se croisent pas
Les tarifs en vigueur vérifiés le 27 septembre 2026 sont simples. Jev 1.13 coûte $0.042 par million de tokens en entrée, la sortie étant gratuite. La grille tarifaire de Privatemode affiche GLM-5.3-Flash à €0.20 par million de tokens en entrée, €0.65 par million de tokens en sortie et €0.05 par million de tokens d’entrée mis en cache, auxquels s’ajoute la TVA le cas échéant. Pour comparer à périmètre égal en dollars, le calcul ci-dessous applique le taux de référence de la BCE au 25 septembre, soit €1 pour $1.1403.
La décision de référence suppose un état de 500 tokens et quatre choix, dont none of these. D’après le packaging communiqué par le fournisseur, Jev envoie environ 810 tokens en entrée. Privatemode Decisions en envoie environ 635 et génère un token en sortie. Ici, GLM compose un prompt plus court, mais son tarif converti par token d’entrée est environ 5.43 fois supérieur à celui de Jev. Au final, une décision coûte environ 4.28 fois plus cher.
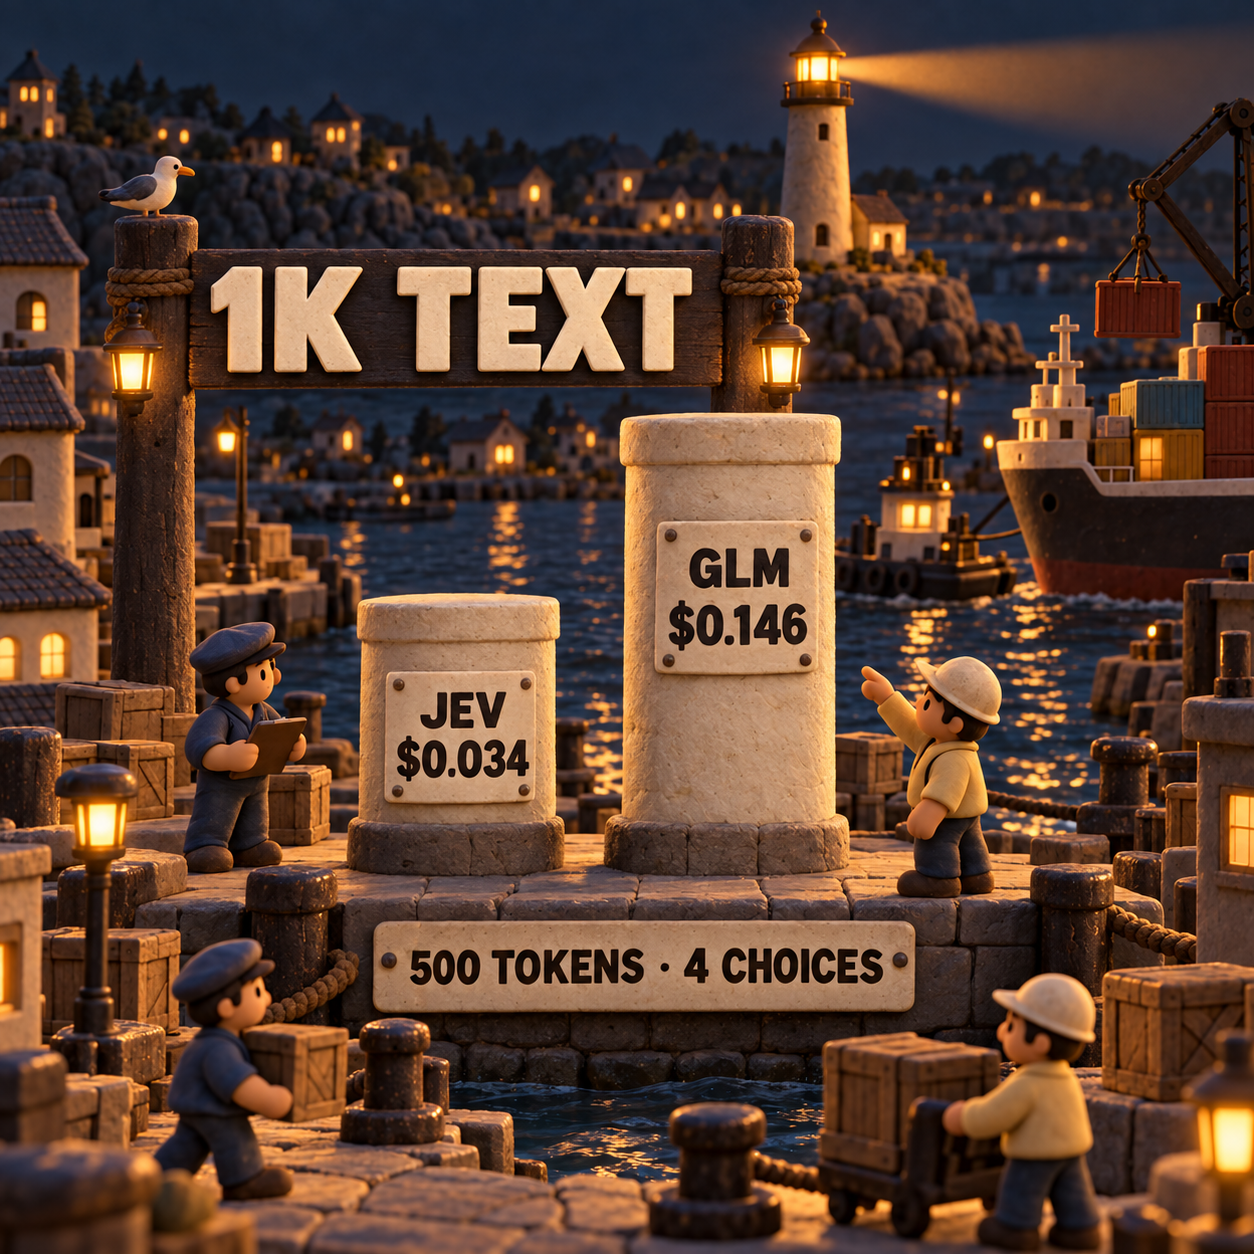
Avec ces tarifs affichés et ces estimations linéaires de packaging, les coûts bruts par token ne se croisent jamais pour une valeur positive ou nulle. Même si le prompt de Privatemode reste plus court jusqu’à environ 21 options, l’écart de tarif est trop grand pour que les courbes se rejoignent. À résultat opérationnel égal, Jev reste moins cher.
Mais l’inférence ne représente pas toute la facture. Sur 100,000 décisions courantes, l’écart brut avoisine $11.1539. Supposons qu’une revue coûte $30 de l’heure et prenne deux minutes, soit $1 par transfert humain. Privatemode devrait éviter 12 transferts humains par tranche de 100,000 décisions pour compenser son surcoût d’inférence. Il s’agit d’un scénario, pas de l’affirmation qu’il y parvient.
Voici l’indicateur à piloter : (inference cost + review cost + retry cost) / correct decisions. Un appel moins cher peut perdre s’il multiplie les escalades. Un appel plus coûteux peut gagner s’il traite une image sans service d’OCR séparé. Sans identifiants pour les deux solutions, il serait malhonnête de publier un coût observé par décision correcte.
Vainqueur de la catégorie : Jev sur le coût brut du texte. Le meilleur workflow dépend des erreurs, des nouvelles tentatives, de l’OCR et de la revue humaine mesurés.
Pour trier des documents, les images changent le verdict
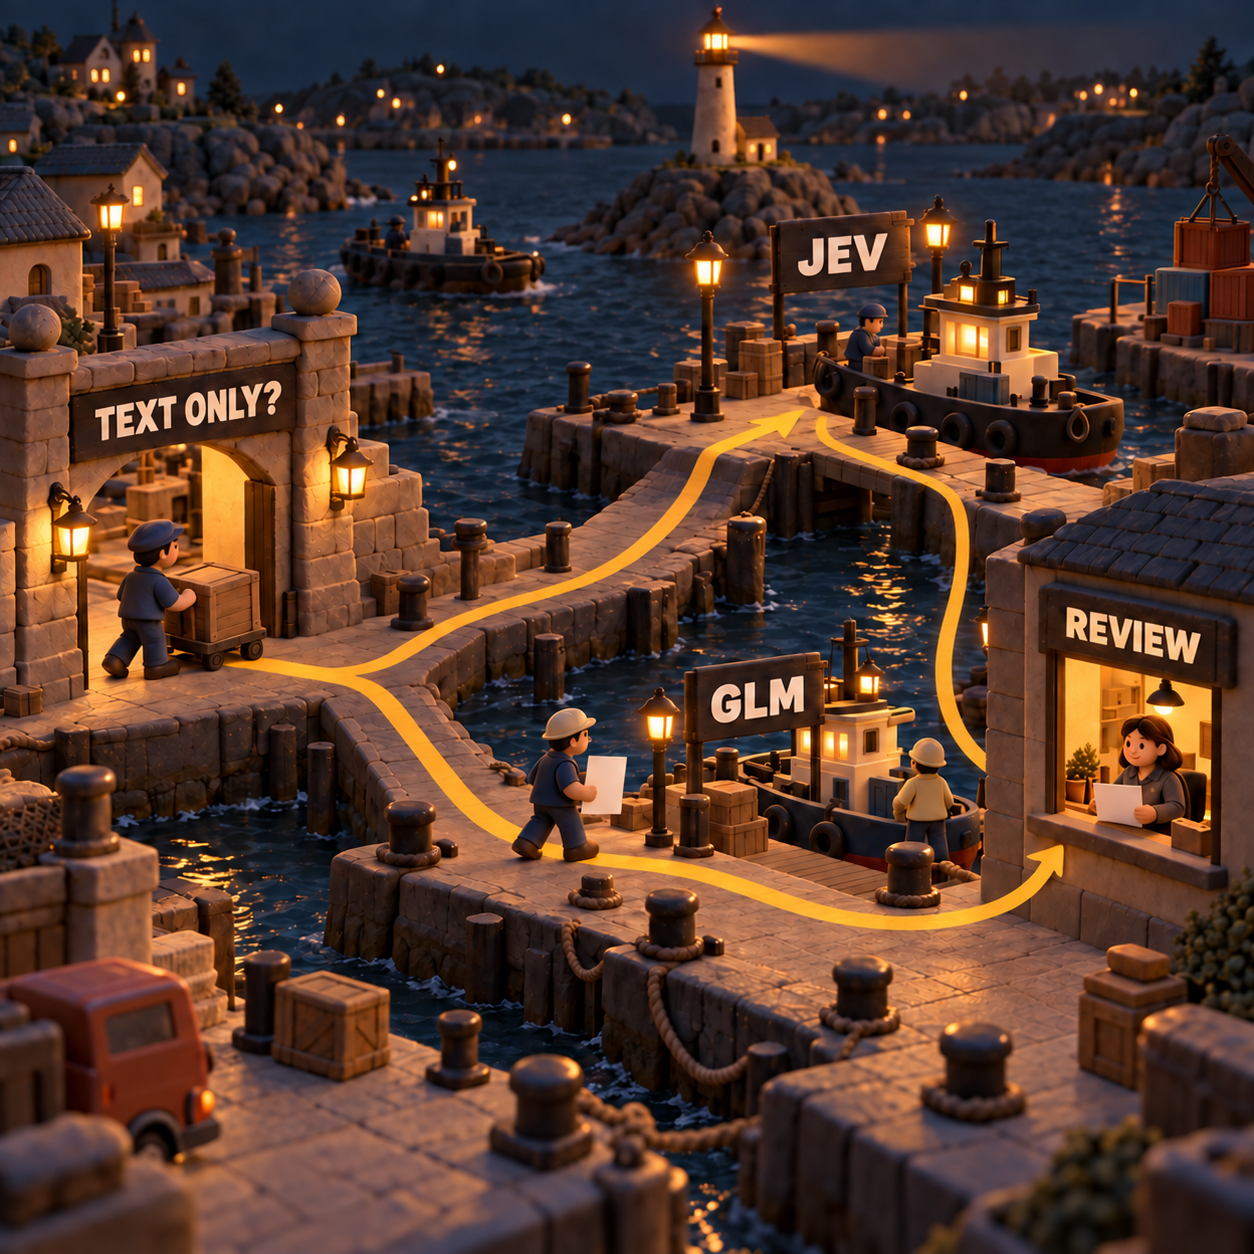
GLM-5.3-Flash remporte la comparaison des entrées directes pour les factures numérisées : Privatemode accepte les images, contrairement à Jev. C’est une limite de capacité, pas une petite différence fonctionnelle. Un workflow Jev doit ajouter un OCR ou un autre modèle de vision avant l’appel de décision, donc un second fournisseur, un autre risque de panne, davantage de latence et un coût propre.
Privatemode annonce une précision de 70.2% sur 1,600 documents RVL-CDIP numérisés répartis en 16 classes. Jev ne pouvait pas participer à ce test d’images. Selon le fournisseur, chaque image ajoutait environ 1,350 tokens en entrée, pour un coût estimé d’environ €270 par 1 million de décisions documentaires. Ces résultats prouvent que cette voie sait ingérer des scans ; ils ne disent pas comment elle traitera vos factures.
Conservez cinq factures synthétiques dans un test de capacité distinct. Avec la base commune de 500 tokens et l’ajout de 1,350 tokens par image annoncé, une décision Privatemode coûterait environ €0.00039765, soit $0.00045344 ; cinq coûteraient environ €0.00198825, soit $0.0022672. N’intégrez pas ces cinq résultats au score de précision des 30 tickets texte. Sinon, GLM serait récompensé pour avoir passé un test auquel Jev ne peut pas participer, et la comparaison textuelle deviendrait illisible.
Vainqueur de la catégorie : GLM-5.3-Flash pour le tri direct d’images de documents.
Testez les mêmes 30 tickets avant de changer
Le plus petit comparatif interne crédible repose sur un jeu figé de 30 tickets synthétiques étiquetés, rejoué avec les mêmes choix, dans le même ordre et avec une option explicite none of these. Les cas synthétiques évitent d’envoyer des données client pendant l’évaluation. Ils doivent néanmoins représenter les tickets courts, ambigus et hors périmètre qui mettent un routeur de production en défaut.
Figer le jeu de test
Consignez 30 tickets texte, leurs étiquettes attendues et les choix autorisés dans un même fichier versionné. Incluez
none of these, conservez l’ordre des choix et réservez les cinq images de factures à un jeu de capacité distinct.Épingler la version servie par chaque endpoint
Appelez la version
jev-1.13.0ou journalisez le champmodelrenvoyé par Jev. Résolvezglm-flash-latestet notez le modèle réellement servi avant de qualifier l’essai de test GLM-5.3-Flash. Pour les deux, consignez aussi l’endpoint et la région du client.Rejouer des décisions identiques
Envoyez aux deux solutions le même état et des options sémantiquement identiques. N’améliorez pas discrètement un seul prompt, ne réordonnez pas un seul jeu d’étiquettes et ne comptabilisez pas les nouvelles tentatives d’un seul côté.
Enregistrer les données opérationnelles
Pour chaque appel, conservez les latences p50 et p95 au niveau de l’exécution, les tokens d’entrée, le coût facturé, le choix retenu, la probabilité ou la confiance, l’exactitude, les nouvelles tentatives et les transferts humains. Signalez séparément les réponses fausses données avec une confiance élevée.
Tester les images hors du score textuel
Envoyez cinq images de factures synthétiques à Privatemode. Relevez le modèle, les tokens, le coût, la latence et l’étiquette. Indiquez que Jev n’accepte pas ce type d’entrée directe au lieu de lui compter une erreur de classification textuelle.
Calculer le coût par décision correcte
Additionnez les coûts d’inférence, de nouvelle tentative, de prétraitement et de revue humaine, puis divisez le total par le nombre de décisions correctes. Présentez séparément le résultat partagé des 30 tickets texte et celui des cinq images.
L’inférence brute pour le test textuel prévu coûterait environ $0.0010206 avec Jev, contre €0.0038295, soit $0.0043668, avec Privatemode avant toute nouvelle tentative. Cet écart est trop faible pour guider un achat. L’intérêt du test est ailleurs : il révèle l’adéquation des étiquettes, la calibration, la latence de queue dans chaque région et le comportement des transferts.
Coût de migration : qui ne devrait pas changer ?
Passer de Jev à Privatemode Decisions ne consiste pas à remplacer un nom de modèle. Un Choice ou Score de Jev devient un Choice de la bibliothèque avec des index d’options fixes. L’équipe doit faire correspondre la taxonomie existante, recréer les seuils de confiance, remplacer la gestion du client et des nouvelles tentatives, valider l’endpoint compatible OpenAI et rendre observable la résolution de l’alias. Si le traitement confidentiel motive la migration, le déploiement doit rester sur l’infrastructure Privatemode couverte, et non basculer vers un hôte vLLM arbitraire.
Le trajet inverse demande aussi du travail. Les images doivent passer par un OCR ou une autre couche de vision. Les prompts longs doivent respecter les limites de contexte de Jev. Toute hypothèse propre à GLM doit être reformulée sous forme de question Jev, et les probabilités historiques ne peuvent pas être considérées comme une calibration interchangeable.
GLM-5.3-Flash peut-il remplacer Jev ?
Oui pour les décisions textuelles à choix fini, surtout si le même workflow doit aussi gérer des images. Non si « remplacer » signifie une substitution immédiate avec une confiance, une infrastructure et des propriétés de conformité identiques. La forme de l’API, le prétraitement, le cycle de vie du modèle et la frontière de déploiement changent tous.
Ne quittez pas Jev si la file ne contient que du texte, si ses étiquettes sont stables, si la précision actuelle est satisfaisante et si économiser des fractions de centime par millier de décisions compte davantage que l’entrée multimodale. Ne quittez pas Privatemode si les images directes ou son service européen confidentiel sont indispensables. Dans un sens comme dans l’autre, un léger avantage sur un benchmark public ne suffit pas à amortir le risque d’une migration.
Ce qu’il faut lancer lundi
Figez le jeu d’évaluation avant que quiconque n’ajuste les prompts autour de ses exemples favoris. Réunissez dans un même dossier de test les 30 tickets synthétiques, les cinq factures synthétiques, la taxonomie des choix, les étiquettes attendues, l’hypothèse de coût de revue et la région du client. Ajoutez des champs pour la version réellement servie, l’endpoint, p50, p95, les tokens, le coût facturé, les nouvelles tentatives, les erreurs à forte confiance et les transferts.
Attendez ensuite de disposer des deux identifiants, puis exécutez la charge commune. D’ici là, la seule décision défendable reste conditionnelle : Jev domine le routage textuel à bas coût ; GLM-5.3-Flash via Privatemode Decisions domine l’entrée directe d’images et la portabilité de la bibliothèque.
Questions fréquentes
Quelles différences entre GLM-5.3 et GLM-5.3 Flash ?
Chez Privatemode, GLM-5.3 est limité au texte et coûte €1.55 par million de tokens en entrée et €7.74 par million en sortie. GLM-5.3-Flash accepte les images et coûte €0.20 en entrée et €0.65 en sortie par million de tokens : Flash est donc à la fois moins cher et multimodal sur ce service.
GLM Flash est-il un bon modèle ?
GLM-5.3-Flash est un candidat crédible lorsqu’une tâche de décision exige des images, un contexte long ou le déploiement Privatemode. Mais sa pertinence dépend toujours de la précision, des erreurs à forte confiance, de la latence et du coût par décision correcte sur vos propres étiquettes.
GLM-5.3-Flash est-il open source ?
Ses fichiers de modèle sont publiés sous licence MIT. Cela répond à la question de la licence du modèle, mais la confidentialité du déploiement et les conditions du service dépendent toujours du lieu et de la manière dont il est exécuté.
GLM-5.3-Flash accepte-t-il les images ?
Oui. La fiche officielle le présente comme nativement multimodal, et Privatemode indique que son endpoint GLM-5.3-Flash accepte les images.
Que signifie GLM ?
L’article de recherche original développe l’acronyme GLM en General Language Model.
GLM-5.3-Flash possède-t-il des capacités de vision ?
Oui. Il accepte les images comme le texte, ce qui lui permet de participer directement à un test de documents numérisés dont Jev est exclu.
Combien de paramètres compte GLM-5.3-Flash ?
La fiche officielle de Z.ai annonce 320 milliards de paramètres au total, dont 18 milliards actifs.
GLM-4.7-Flash est-il un modèle MoE ?
Oui, mais il s’agit d’un autre modèle. Sa fiche officielle décrit une architecture mixture-of-experts 30B-A3B ; ses caractéristiques ne doivent donc pas être attribuées à GLM-5.3-Flash.
GLM-5.3-Flash est-il multimodal ?
Oui. Dans ce comparatif, c’est son avantage décisif pour le tri de documents numérisés.
Vous cherchez une méthode plus simple pour positionner ces deux solutions dans votre stack ? Téléchargez l’AI Tools Map for Business Owners et cartographiez la couche de décision avant d’ajouter un autre modèle.
- Dernière mise à jour
- 27 sept. 2026
- Catégorie
- AI
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
Claude Opus 5.5 ou Opus 5 : prix, code et migration
Claude Opus 5.5 coûte moins cher, mais cinq changements d’API compliquent la migration. Comparez les prix, le code, le thinking et les critères de choix.23 sept. 2026AI
GPT-6 Sol ou Luna : quel modèle choisir ?
GPT-6 Sol ou Luna : comparez prix, usages, limites et coût par résultat accepté pour choisir le bon modèle sans payer 20× plus cher par défaut.23 sept. 2026AI
GPT-6 Luna gratuit : accès, limites et tarifs API
GPT-6 Luna gratuit à l’essai dans l’app desktop : découvrez les comptes compatibles, les limites connues, l’accès à Codex et les tarifs de l’API.22 sept. 2026AI
MiMo AI : comment utiliser Xiaomi MiMo V2.6 et son API
Testez MiMo AI dans Studio, choisissez la bonne clé et le bon modèle, puis lancez un premier workflow métier fiable avec l’API Xiaomi MiMo V2.6.22 sept. 2026AI
Comparatif MiMo V2.6 : Pro ou Flash, lequel choisir ?
Comparatif MiMo V2.6 Pro et Flash pour le code et les agents IA : réussite des tâches, coût des tokens, cache et cas où Pro justifie son prix.22 sept. 2026AI
MiMo V2.6 gratuit : ce qui l’est vraiment
MiMo V2.6 gratuit ? Pas partout. Découvrez l’accès OpenCode temporaire, les checkpoints MIT, les tarifs API et les limites avant de choisir.22 sept. 2026AI
Grok 4.7 vs Grok 4.6 : quel modèle choisir ?
Grok 4.7 vs Grok 4.6 : les tarifs sont identiques. Comparez leurs performances, leurs coûts réels et les risques de migration avant de choisir.21 sept. 2026AI