OpenAI Decisions API 实战:工单分流、分类评分与迁移取舍
OpenAI Decisions API 如何用于工单分流、数据标注和智能体操作审核?本文拆解三种请求示例、拒答处理、置信度阈值与输入限制,并用一组明确假设计算费用,说明哪些场景值得试用、哪些情况应保留 Responses API,以及如何通过已标注工单和人工复核,判断迁移是否真正划算。
发布于
 作者 Omid Saffari




OpenAI Decisions API 可以为工单分流、给记录打标签,也可以评估 AI 智能体拟执行的操作,返回结果可供代码直接使用。如果你现在调用 LLM 只是为了得到一个类别或评分,这个接口值得试用。不过,只有在分流质量不逊于现有方案、工作流的改善也足以抵消迁移成本时,才值得替换。
先想清楚:代码需要 OpenAI Decisions API 返回什么?
可以把 Decisions 理解为一个分派员,可选去向由你预先定义:你提供依据和问题,应用程序拿到答案后,再决定下一步怎么做。
截至 2026 年 10 月 11 日,这个 API 仍处于公开测试阶段,OpenAI 预计会在**“未来几周内”正式推出**。这是 OpenAI 的预期,并非确定的发布日期。目前唯一支持的模型是 gpt-6-luna,接口端点为 POST /v1/decisions。OpenAI 称其**“速度约为 Responses API 的 10 倍”**。这是 OpenAI 的说法,并不代表你的应用实测也能达到这个结果。OpenAI Decisions 使用指南
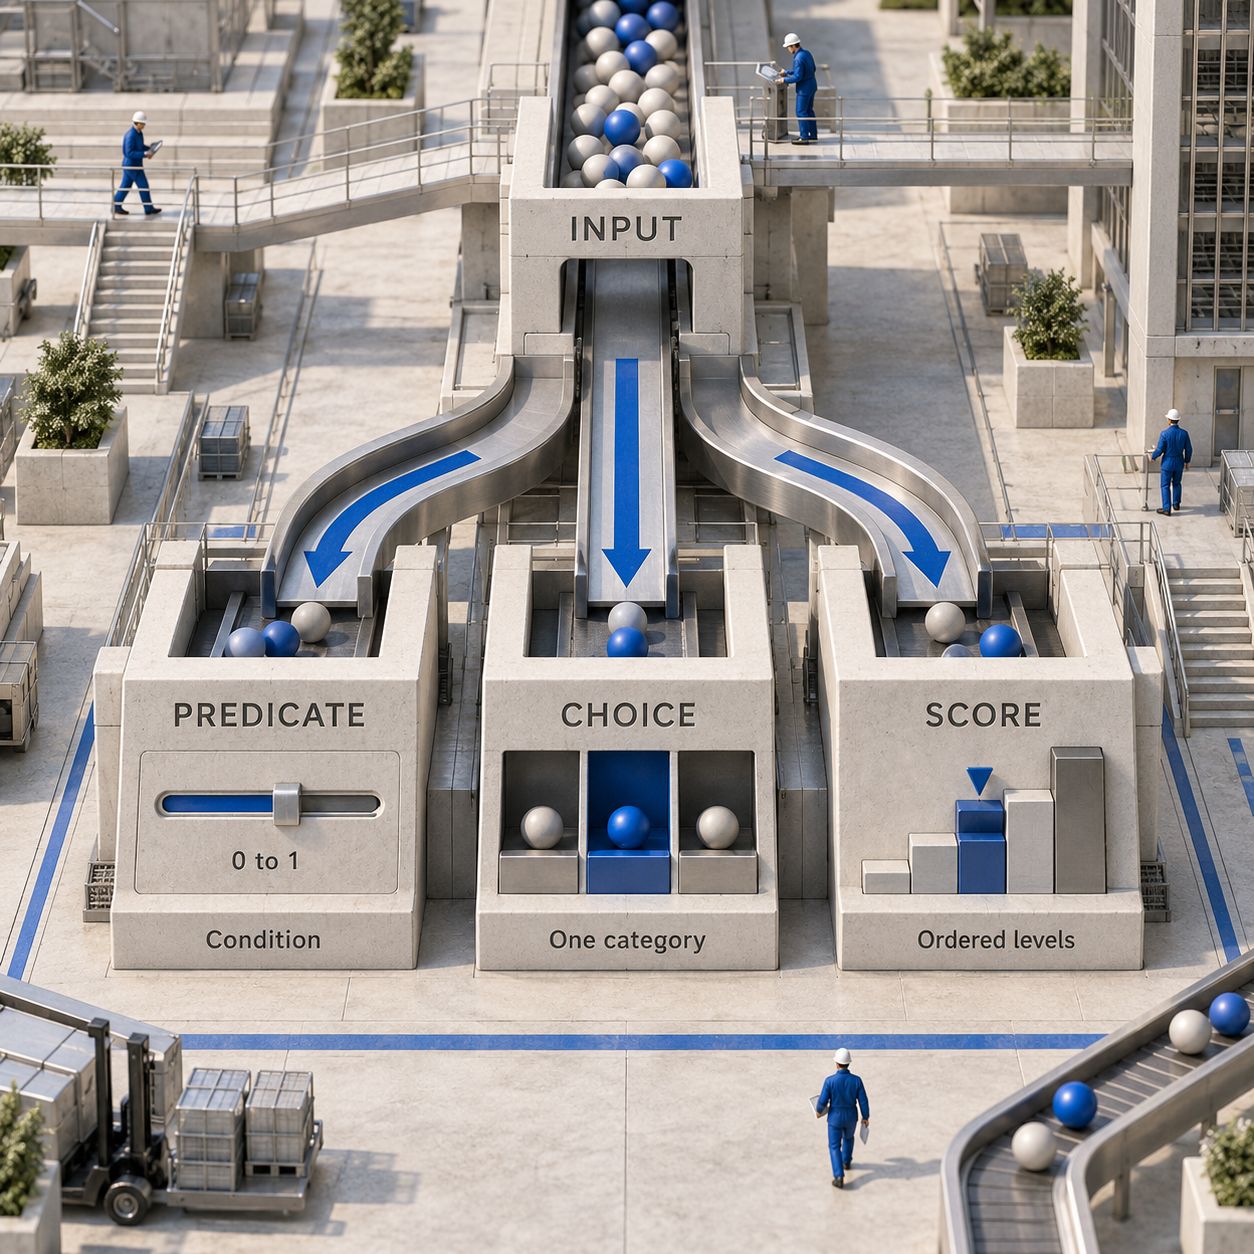
写提示词之前,先选好答案类型:
使用评分时,等级索引从 0 开始。结果可能落在两个等级之间,体现模型对各等级判断的不确定性。如果代码需要的是一个确定的类别,应使用选择类型。问题类型说明
三种请求分别怎么调用?
下面是指南中的三个 cURL 请求示例,已统一格式,并添加注释以便区分。先在 shell 环境中设置 OPENAI_API_KEY;条件判断示例还需要本地的 product.png 文件。每条命令都会单独发起请求。这些示例已对照公开指南核查,但未登录账户实际运行。原始请求示例
几个示例的共同部分是 input 和 questions:前者提供判断依据,后者定义要据此作出的判断。每个问题的 name 用于在返回的 answers 数组中识别对应答案。请求与响应参考文档
# Predicate: inspect product.png for visible damage
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"

curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @- <<JSON
{
  "model": "gpt-6-luna",
  "input": [{
    "role": "user",
    "content": [
      {"type": "input_text", "text": "Inspect the product in this photo."},
      {"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
    ]
  }],
  "questions": [{
    "type": "predicate",
    "name": "visible_damage",
    "instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
  }]
}
JSON

# Choice: route a customer complaint
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice",
      "name": "department",
      "instructions": "Which department should handle this complaint?",
      "choices": [
        {"value": "billing", "description": "Payments, invoices, and refunds."},
        {"value": "technical", "description": "Problems using the product."},
        {"value": "shipping", "description": "Delivery and tracking."},
        {"value": "other", "description": "Requests outside these categories."}
      ]
    }]
  }'

# Score: assess issue severity
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Export fails in Safari but works in Chrome.",
    "questions": [{
      "type": "score",
      "name": "severity",
      "instructions": "How severe is this issue?",
      "levels": [
        {"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
        {"label": "Workaround available", "description": "A task fails, but another way works."},
        {"label": "Fully blocked", "description": "A task fails with no workaround."}
      ]
    }]
  }'
选择类型的示例已经可以作为实际业务的起点:客户投诉订单被重复扣款,就需要将工单分到某个固定队列。评分示例回答的是另一个问题:如果换个浏览器就能正常使用,这次故障究竟有多大影响?队列归属和严重程度应分开处理,这样紧急的账单问题也不会被误当成技术工单。
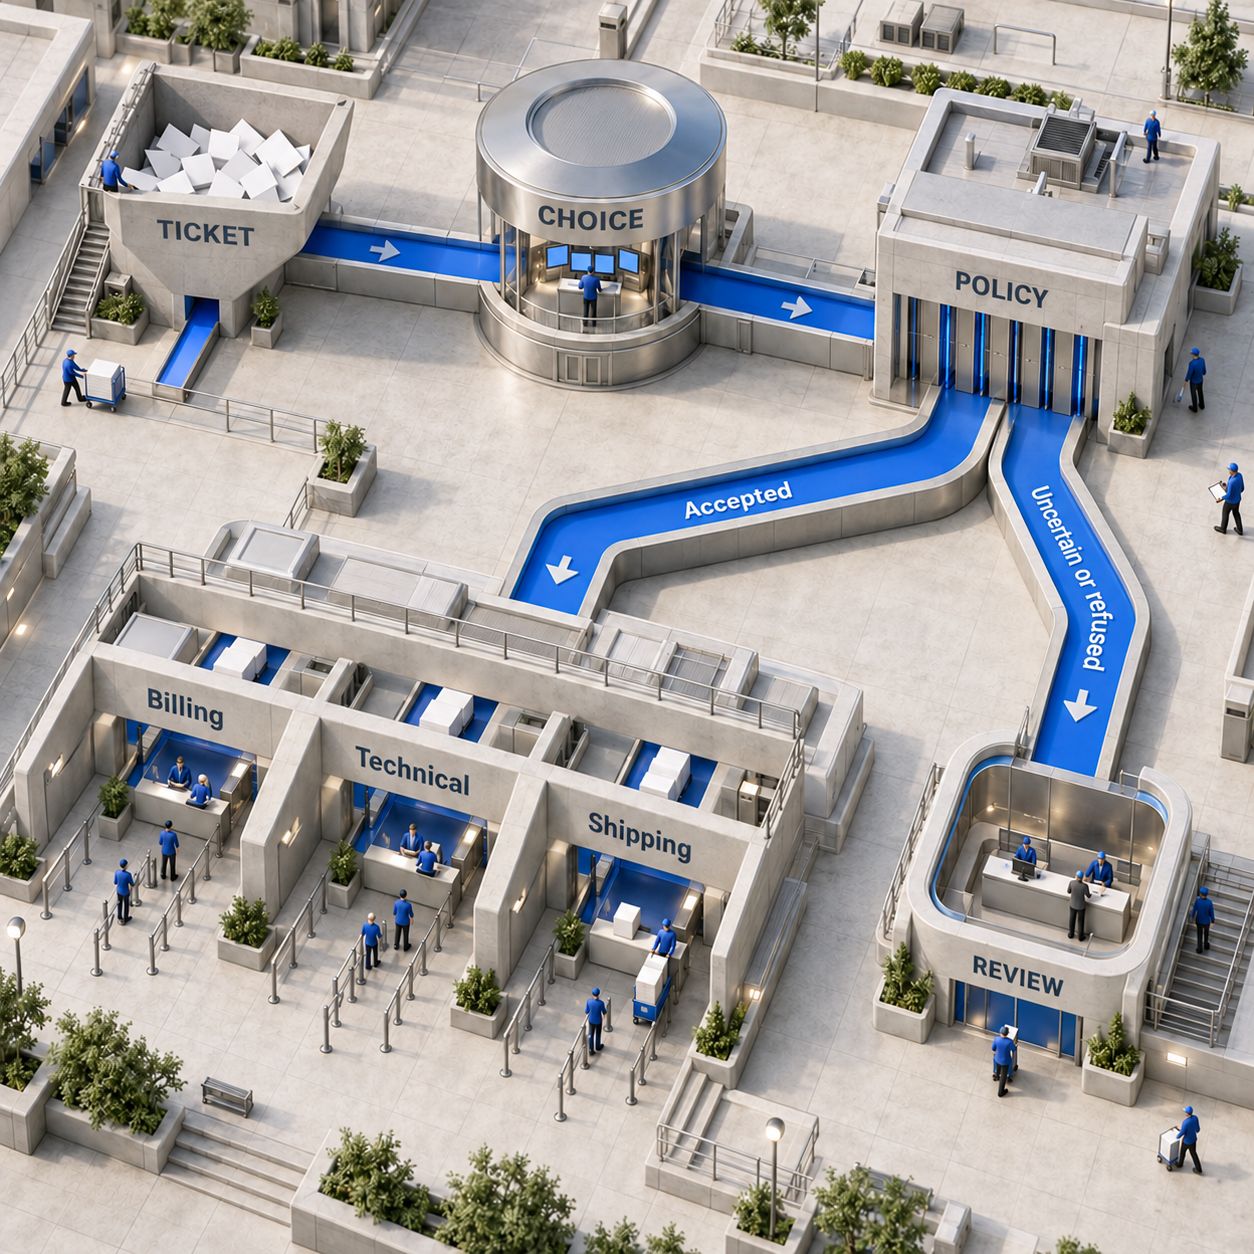
读取答案值之前,先处理拒答。 指南中的 SDK 示例会先检查 answer.type == "refusal",再访问 probability、choice 或 score。拒答是一种独立结果,既不等于低置信度答案,也不属于你定义的 other 类别。拒答行为说明
用 choice 做客服工单自动分类与分流
第一版可以先解决队列分配。客服团队把工单主题和相关客户消息发给接口,拿到部门选项后,再由常规应用代码执行分流策略。
指南中的队列定义可以作为起点,但应按团队实际的职责边界调整。保留 other 选项,用来接住不属于已列出部门的请求。退款申请应交给账务团队,但把工单分过去,并不等于批准退款。
下面这段简短的应用适配代码演示了后续策略:先成功解析 JSON 响应,再取出 department 答案。thresholds 中的阈值必须依据已标注工单确定;如果某个类别没有设置阈值,工单就留待人工复核。
QUEUES = {
    "billing": "billing",
    "technical": "technical",
    "shipping": "shipping",
}

def queue_for(answer, thresholds):
    if answer.get("type") == "refusal":
        return "manual_review"
    if answer.get("type") != "choice":
        return "manual_review"
    department = answer.get("choice")
    if department not in QUEUES:  # Includes the guide's "other" choice.
        return "manual_review"
    cutoff = thresholds.get(department)
    confidence = answer.get("confidence")
    if cutoff is None or confidence is None or confidence < cutoff:
        return "manual_review"
    return QUEUES[department]
在这个建议方案中,API 报错、请求超时或缺少答案时,也应将工单留待人工复核。记录问题版本、建议队列、置信度、最终队列,以及工作人员的修正。队列更新还应支持安全重试,避免重试请求造成重复分配。
同一张工单上相互独立的问题,可以放在一次请求中。如果后续问题的含义取决于前一个答案,就应放到下一次请求中。多问题请求指南
用已标注的实际工单确定阈值
先衡量业务能容忍哪些错误,再选择阈值。OpenAI 的指南没有公布置信度校准数据,而是建议开发者使用自己应用中的已标注数据。某个置信度数值,并不保证你的工单能达到相应的正确率。如何解读答案
先找一批历史工单,由客服负责人确认它们应当进入哪个队列。样本要覆盖简短请求、混合问题、上下文缺失的情况,以及夹带针对模型指令的投诉。用于调整问题和阈值的样本,应与留作最终对比的测试集分开。
衡量错分工单的情况、送交人工复核的比例,以及工作人员修正分配所花的时间。每个队列都要单独检查。把物流问题分到账务队列,与漏掉账户被盗的报告,可能带来完全不同的运营代价。
先让候选方案与现有分类器并行运行,保持线上分配不变。只有结果达到事先写明的验收标准,才正式启用新方案。同时保留原有路径,方便回滚。这些是建议的上线步骤,并非对该 API 的测试结论。
六个值得尝试的场景,先做哪个?
适合优先尝试的场景,通常具备三个特点:类别稳定、错误容易发现,而且异常情况已经有明确负责人。下面的排序是实施层面的判断,不是准确率排行榜。
做数据标注时,先确定一条记录能否对应多个主题。单个选择题只会选出一个类别;如果标签可以重叠,拆成多个问题可能更合适。评估事件严重程度时,要用实际运营影响来定义等级,例如哪些功能无法使用、有没有变通方案。“严重”这类词给模型留下的解释空间太大。
这套定价,实际能省多少?
指南给出的 Decisions 价格是:gpt-6-luna 每 1M 输入 token 收费 $0.10,不收取输出、缓存读取或缓存写入费用。区域处理附加费和长上下文输入倍率可能适用。 这是 Decisions 的计费规则,不能套用到同一模型的普通调用上。Decisions 定价
下面按一批假定任务算账,并非实测用量,也不是每次决策的固定价格。假设有 100,000 次分类调用,每次包含 1,000 个未缓存的输入 token,指令和选项也计入其中。对于现有的 Responses 调用,再假设每次总共有 50 个计费输出 token。采用标准短上下文基础价格,不计缓存写入、区域附加费、重试或其他费用。
普通模型的费率来自 OpenAI 标准价格表。在这个例子里,取消输出计费让整批任务节省 $2.50。单凭这点节省,很难证明重写一个已经正常运行的集成值得投入。
更有说服力的理由来自实际运营:串行工作流的等待时间缩短、处理响应的代码减少,或者在相同错误率下减少人工分类工作。对比时,应使用你的实际账单和复核工作量。如果原先使用的模型更贵、生成答案更长,计算结果就会变化;已有的缓存折扣也会影响结果。工程投入和工单错分的代价,同样要计入迁移预算。
两个值得做成产品的方向
首选:带人工复核和改派记录的客服分流工具
客服运营负责人可能愿意为这样一个连接器付费:它推荐固定队列,暂缓处理不确定的工单,并把工作人员的修正转化为评估数据。真正有用的产品,是包含持续维护在内的完整分流工作流。
截至 2026 年 10 月 11 日核查时,DataForSEO 估算,“ticket triage”在美国 Google 上每月有 170 次搜索。这只说明一个范围较窄的信息查询需求,并不代表买家数量。现有客服平台也在解决这个问题:Zendesk 提供智能分流分类功能,但要将这些分类用于工作流,需要其 Copilot 附加组件。Zendesk 智能分流指南
最小可用版本可以先对接一个客服平台,支持导入历史工单、预览队列分配,并提供允许人工改派的复核收件箱。最有力的销售依据,是客户减少了多少本可避免的转交。难点在于现有产品可能已经覆盖了需求:如果客服平台本身就能把队列分好,再加一个分流工具只会增加维护负担。要赢得客户,就应解决具体的职责归属问题,或跨系统转交问题。
次选:面向固定标签集的审核工作台
研究或数据团队可能愿意为一个工作台付费:它推荐标签、收集修正,并显示哪些类别反复引发分歧。在同一次核查中,DataForSEO 估算,“automated data labeling”在美国 Google 上每月有 90 次搜索。这表明有人关心这项工作,但不能证明他们愿意为这种实现付费。
第一版可以导入 CSV,应用有版本记录的标签集,将不确定的行交给人工审核,再导出修正结果。保留独立的评估集,才能公平比较标签调整前后的效果。难点在于,模型也能以很低的成本不断套用一套定义含糊的分类体系。产品需要完善的审核和类别管理工具;仅仅封装一次 API 调用,很容易被复制。
客服分流工具更适合作为第一个产品。 队列归属让错误清晰可见,有具体的操作人员能够纠正,也有持续发生的工作流可供验证价值。动手做通用决策平台之前,先去访谈负责这项工作的人。
哪些情况下,应继续用现有方案?
如果需要按自定义 JSON schema 提取字段、生成文字解释,或让模型发起带参数的工具调用,就继续使用 Responses API。Decisions 提供的是前文所列、范围更窄的答案类型。OpenAI 关于接口选择的说明
如果答案已经写在账户字段或明确的策略中,就继续使用确定性规则。对于“将这个地区的客户交给这个团队”这样的规则,模型能增加的价值很有限。涉及重要后果的操作,仍应保留人工授权和应用权限检查。分流判断可以为退款流程提供参考,但不能据此认定客户有权获得退款,或操作人员拥有退款权限。
安排迁移之前,先核对这些集成限制:
- **图片:**指南只允许内联 base64 data URL,也就是把图片字节编码后放进请求。按照指南的要求,不支持托管的 HTTP 或 HTTPS 图片 URL,也不支持
file_id,即指向已上传文件的标识。图片输入要求 - 数据控制:指南说明支持零数据保留(Zero Data Retention,简称 ZDR),符合条件的客户也可用于 HIPAA 场景。数据驻留和区域处理支持美国及欧洲,欧洲具体为欧洲经济区(EEA)及瑞士。这些能力受资格、协议、配置和相关限制约束,并非账户默认自动启用。Decisions 可用范围、OpenAI 数据控制说明
- **产品成熟度:**接口仍在公开测试阶段,因此应保留回滚路径。如果现有分类器已经达标,替换也没有可衡量的收益,就继续使用现有方案。
替代方案:Jev、Clef 和 Microsoft-Decision-1
更换服务商之前,先用同一批已标注任务比较候选方案。TypeSafe 的 Jev 通过 System One API 接收状态和指定类型的问题。Cloudflare Clef 在 Workers AI 中提供指定类型的决策结果。Microsoft-Decision-1 已在 Microsoft Foundry 上提供,可用于分类、路由和优先级排序等任务。TypeSafe 快速入门、Cloudflare Clef 文档、Microsoft 公告
筛选候选方案时,应依据现有集成、托管要求、评估结果和异常处理方式。我们的 Jev 客服工单分流指南介绍了这种分流模式;Jev Router 免费吗?则解释了路由软件与托管推理的区别。每家服务商的请求格式和置信度表现,都应分别评估。
Decisions 适合替换现有的分类调用吗?
如果输出是固定类别、条件成立的概率,或按标准给出的评分,就值得试用。用同一批已标注样本,对比分流错误、人工复核工作量、成本和耗时。如果改善不足以抵消迁移成本,就保留当前调用。
接口拒答时,应用该怎么处理?
读取答案值之前,先检查答案类型。在客服分流场景中,应将拒答交给人工复核,并保留足够的上下文,方便工作人员处理。不能把拒答理解为允许执行默认操作。
置信度阈值该设多少?
使用自身工作流中的已标注数据来确定。对每个候选阈值,测量错误情况和人工复核量,最好分队列统计。本文没有提供通用阈值,OpenAI 的指南也没有提供校准表。
能直接传托管图片 URL 或已上传文件的 ID 吗?
请使用指南中的内联 base64 data URL 格式。指南明确说明,这个端点不接受托管图片 URL 和 file_id 输入。前面的 predicate 请求演示了指南支持的用法。
下周一,就从这一步开始
找出现有系统中那次将工单分到固定队列的分类调用。请负责人核查一批有代表性的已标注样本,写清楚可接受的错误率和人工复核比例,再让 Decisions 与当前调用并行比较,暂不改变工单分配。只有证明它能胜任这段工作流,才正式切换。
如果你希望围绕现有工具搭建分流工作流,我们提供生产级 AI 系统开发服务。
- 发布日期
- 分类
- Build
- 语言

Jev 替代方案怎么选?2026 年七种决策模型的价格、部署与适用场景
想替换 Jev,却不确定该选哪款决策模型?本文比较 Perplexity、Cloudflare Clef、Microsoft、OpenAI、Liquid d1 与 Strands 的美元输入单价、许可证、输入限制和部署条件,并用月度费用算例说明迁移能省多少,帮助你按工单分流、打标签或本地推理需求缩小候选范围。2026年10月11日Build
Claude Code 远程控制教程:手机连接、配置与故障排查
Claude Code 远程控制怎么用?本文讲清 CLI、VS Code 与 Desktop 的启动方式,教你用手机或浏览器接入本地会话,配置自动连接与通知,并排查登录凭据、环境变量、网络和组织策略导致的连接失败。同时说明套餐要求、工作区信任、数据同步与断线恢复,帮助你离开电脑后继续推进已有编程任务。2026年10月9日Build
Cursor 远程控制:用 iPhone 跟进本地 AI 编程任务
用 iPhone 查看并指挥电脑上的 Cursor 智能体:从账号登录、设备配对到保持电脑唤醒,逐步理清设置流程。本文说明电源、上盖和联网要求、企业管理员开关与订阅价格,比较本地远程控制、云端智能体、Claude Code 和 Codex 的连接方式,并给出适合手机处理的任务场景与连接问题排查清单。2026年10月9日Build
Firecrawl 价格怎么算?2026 套餐与积分账单指南
Firecrawl 价格怎么算?按 2026 年 10 月核验的套餐与积分价格,拆解普通抓取、JSON 提取、每周爬取和错误页的月账单,说明年付总额、自动充值、额度结转及升级收费,并比较自部署、Bright Data、Browse AI 和 Apify,帮助 AI 与 RAG 工作流按有效文档产出选择套餐。2026年10月9日Build
Claude Code 价格与 GitHub Copilot 对比:2026 年开发者怎么选
Claude Code 价格与 GitHub Copilot 怎么比?本文梳理个人订阅、10 人团队费用、AI credits、共享用量限制与模型权限,比较编辑器、终端和 GitHub 云端代理的工作流程,并说明升级临界点、预算控制及同时使用两款工具的成本,帮你按实际任务选择合适套餐。价格均为美元,额外用量另计。2026年10月8日Build
LangGraph vs CrewAI:AI 智能体框架怎么选,看工作流、审批与成本
LangGraph vs CrewAI 怎么选?本文以公司研究、开发信起草和人工审批为同一任务,比较两款 AI 智能体框架的状态持久化、记忆、MCP 工具集成与可观测性,说明 LangSmith 和 CrewAI 托管方案的费用边界,并保留席位、追踪用量与运行资源的计算假设,帮助你按产品工作流和专业分工做出选择。2026年10月7日Build
MCP 教程:用 Python 搭建订单查询服务,接入 Claude Code 和 Cursor
MCP 教程:用 Python 搭建只读订单查询服务,先用 Inspector 验证工具,再接入 Claude Code 与 Cursor。随后配置 OAuth 认证与订单权限,选择本地 stdio 或共享 HTTP 部署;附完整代码、Render 与 Cloudflare Workers 托管价格及上线前的安全检查。2026年10月7日Build