Grok 4.7 vs Grok 4.6: что выбрать для кода и API
Сравниваем Grok 4.7 и Grok 4.6: качество кода, API-тарифы, контекст и риски перехода. Парный тест покажет, когда обновление действительно выгодно.


Grok 4.7 vs Grok 4.6 — это выбор по результату, а не по тарифу: обе модели стоят от $2 за миллион входных токенов и $6 за миллион выходных. Новые сложные задачи по программированию и работе со знаниями стоит отдавать Grok 4.7, а проверенные процессы на Grok 4.6 — сохранять, пока версия 4.7 не покажет лучший результат по числу принятых работ, времени выполнения и итоговому счёту.
Grok 4.7 vs Grok 4.6: какую модель выбрать?
Выбирайте Grok 4.7 для задач, в которых Grok 4.6 преждевременно останавливается, упускает зависимости между файлами или требует нескольких раундов исправлений. Если процесс на Grok 4.6 уже стабильно проходит проверки и укладывается в бюджет, оставьте его как есть. Новая модель заслуживает доли трафика только после испытаний, а не по факту выхода.
Поэтому первый шаг зависит от роли читателя:
- Основателю профинансированного стартапа, которого тормозит конкретная функция продукта, стоит испытать Grok 4.7 именно на ней: самые заметные улучшения xAI заявляет для сложной и продолжительной работы.
- Техническому директору компании среднего размера лучше не трогать исправные автоматизации на Grok 4.6, а направить типы провальных задач на контролируемую проверку версии 4.7.
- Опытному специалисту, который готовит исследования, документы или презентации, нужно сравнивать принятые результаты, а не гладкость текста.
- Независимому техническому разработчику стоит поручить версии 4.7 задачу, которую не смогла закончить 4.6, и переводить её в основной контур лишь после тех же тестов.
Решение принимается для каждого типа нагрузки отдельно. Компания вполне может использовать 4.7 для работы с репозиториями, а 4.6 — для стабильного извлечения данных или классификации. Дополнительная маршрутизация оправдана лишь тогда, когда измеримый эффект выше операционной сложности.
Действительно ли Grok 4.7 лучше?
Да — в сложном программировании и профессиональных задачах, по данным, которые xAI опубликовала 21 сентября 2026 года. Но нет — как безусловная замена каждому внедрению Grok 4.6. Результаты дают повод провести оценку, однако разные настройки глубины рассуждений не позволяют объявить обновление универсальным.
Grok 4.7 для программирования
Победитель — Grok 4.7, но с оговоркой о тестах самого разработчика. В сравнении xAI, опубликованном вместе с релизом, Grok 4.7 с настройкой xHigh набрала 46.3% в CursorBench 4.0 против 40.4% у Grok 4.6 с настройкой High — преимущество 5.9 процентного пункта. В Terminal-Bench 4.0 модели получили 38.0% и 20.3%, разрыв составил 17.7 пункта. В EEBench результат равен 64.0% против 53.0%, то есть преимущество достигает 11 пунктов.
Для задач, на которых сосредоточен релиз, разница существенна: длительная работа с репозиторием, операции в терминале и инженерные задачи. Но все результаты предоставлены самим разработчиком, причём для 4.7 xAI выбрала более глубокий режим xHigh, тогда как 4.6 работала в High. Дополнительные рассуждения способны повысить качество, одновременно увеличивая число токенов рассуждений и задержку. Поэтому график — аргумент в пользу теста 4.7, а не контролируемая оценка выигрыша в вашем рабочем контуре.
В задачах, связанных со знаниями, картина похожая. xAI сообщает результат 1,657 у Grok 4.7 против 1,546 у Grok 4.6 в AA Briefcase v1.1, а в GDPval — 1,695 против 1,605. Для юридического агента показатели составили 19.6% и 15.8%, для HealthBench Professional — 56.7% и 48.5%. Все эти значения взяты из сравнения от 21 сентября, поэтому здесь не смешаны разные версии бенчмарков ради ложного прямого сопоставления.
Не превращайте заголовок релиза в обещание более высокой скорости. На странице сказано, что Grok 4.7 вдвое быстрее сопоставимых моделей, но в основном тексте уточняется: стандартная Grok 4.7 работает с той же скоростью, что и Grok 4.6. Опция с конкретным ускорением вывода в 2× относится к отдельному, более дорогому тарифу Fast.
Вывод прост: 4.7 уже заслужила испытание на сложных задачах, но ещё не заслужила слепой миграции всего парка.
Что не изменилось: доступ, контекст, инструменты и рассуждения
Grok 4.7 и Grok 4.6 предлагают почти одинаковую поверхность интеграции, поэтому основной риск миграции связан с поведением, а не с устройством API. Обе модели принимают текст и изображения, возвращают текст, поддерживают вызов функций и структурированный вывод, а размер контекстного окна составляет 500,000 токенов.
Grok 4.7 — текущий флагман
Документированный идентификатор модели Grok 4.7 — grok-4.7. Актуальная страница модели xAI позиционирует её для программирования, агентных задач и работы со знаниями. В релизе также указано, что модель доступна через публичный API, Cursor, Grok Build, сторонние инструменты для программирования, роутеры моделей и облачные платформы.
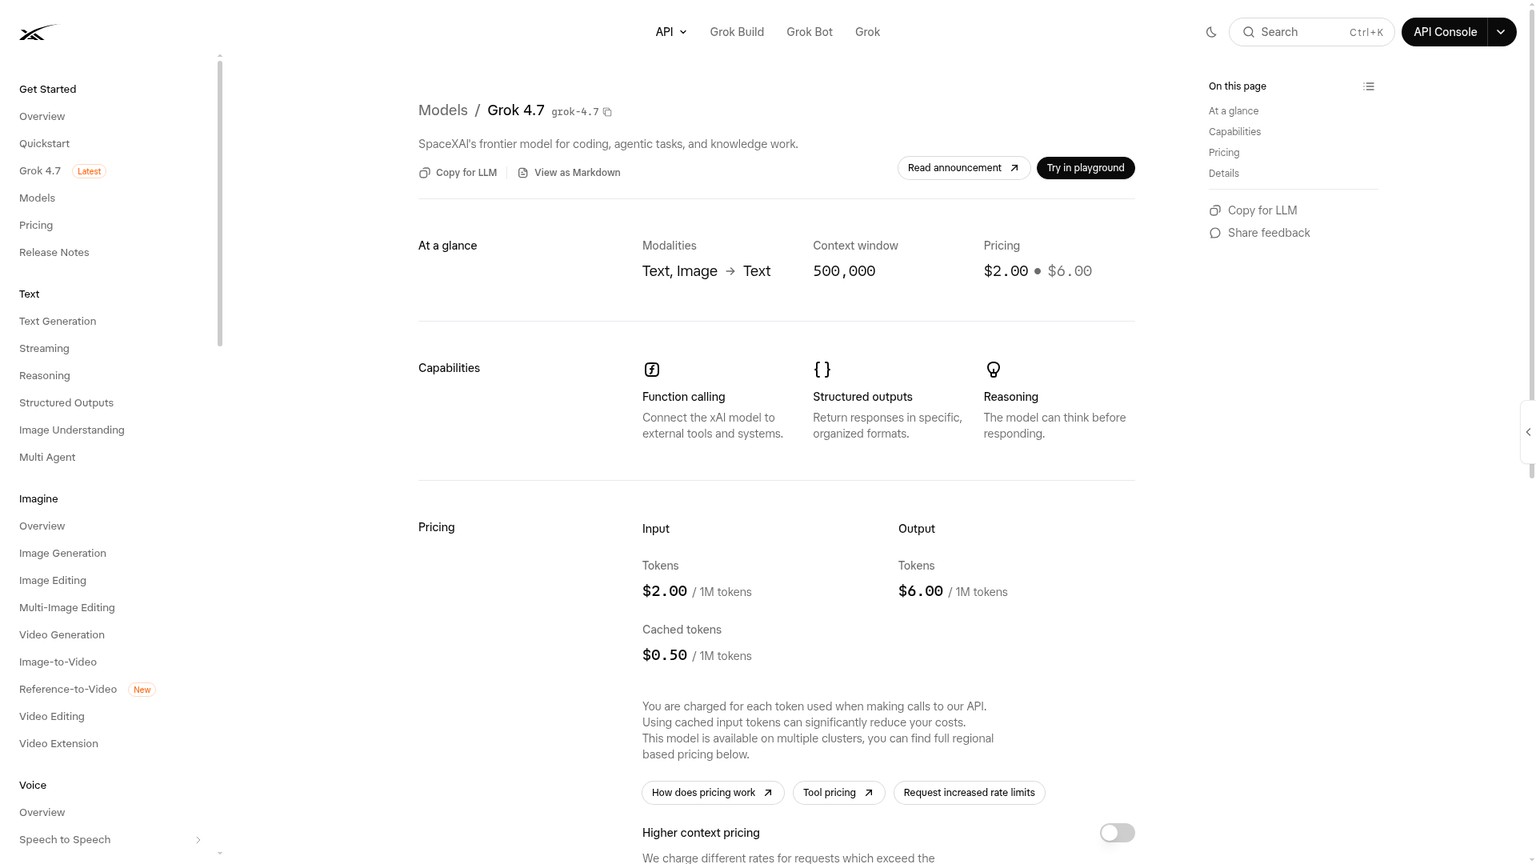
Лучше всего подходит для: сложного программирования и работы со знаниями, которую не доводит до конца 4.6.
Цена: $2 за новый вход, $0.50 за кэшированный вход и $6 за выход на миллион токенов при объёме до 200K.
Явное ограничение: Batch не поддерживается, а вариант Fast недоступен через публичный API xAI.
Не выбирайте, если: исправный процесс на 4.6 не создаёт дорогостоящих проблем.
В работе с Responses API есть одна деталь интеграции, которую стоит проверить: Grok 4.7 всегда возвращает зашифрованное содержимое рассуждений, включая зашифрованные результаты серверных инструментов. Клиент может игнорировать это поле, но если он самостоятельно переносит состояние диалога и важна непрерывность, элементы рассуждений следует сохранять без изменений.
Grok 4.6 — документированная базовая линия
Grok 4.6 по-прежнему доступна под идентификатором grok-4.6. На её актуальной странице модели указаны то же контекстное окно на 500,000 токенов, те же входные и выходные форматы, а также те же основные возможности вызова функций, структурированного вывода и рассуждений.
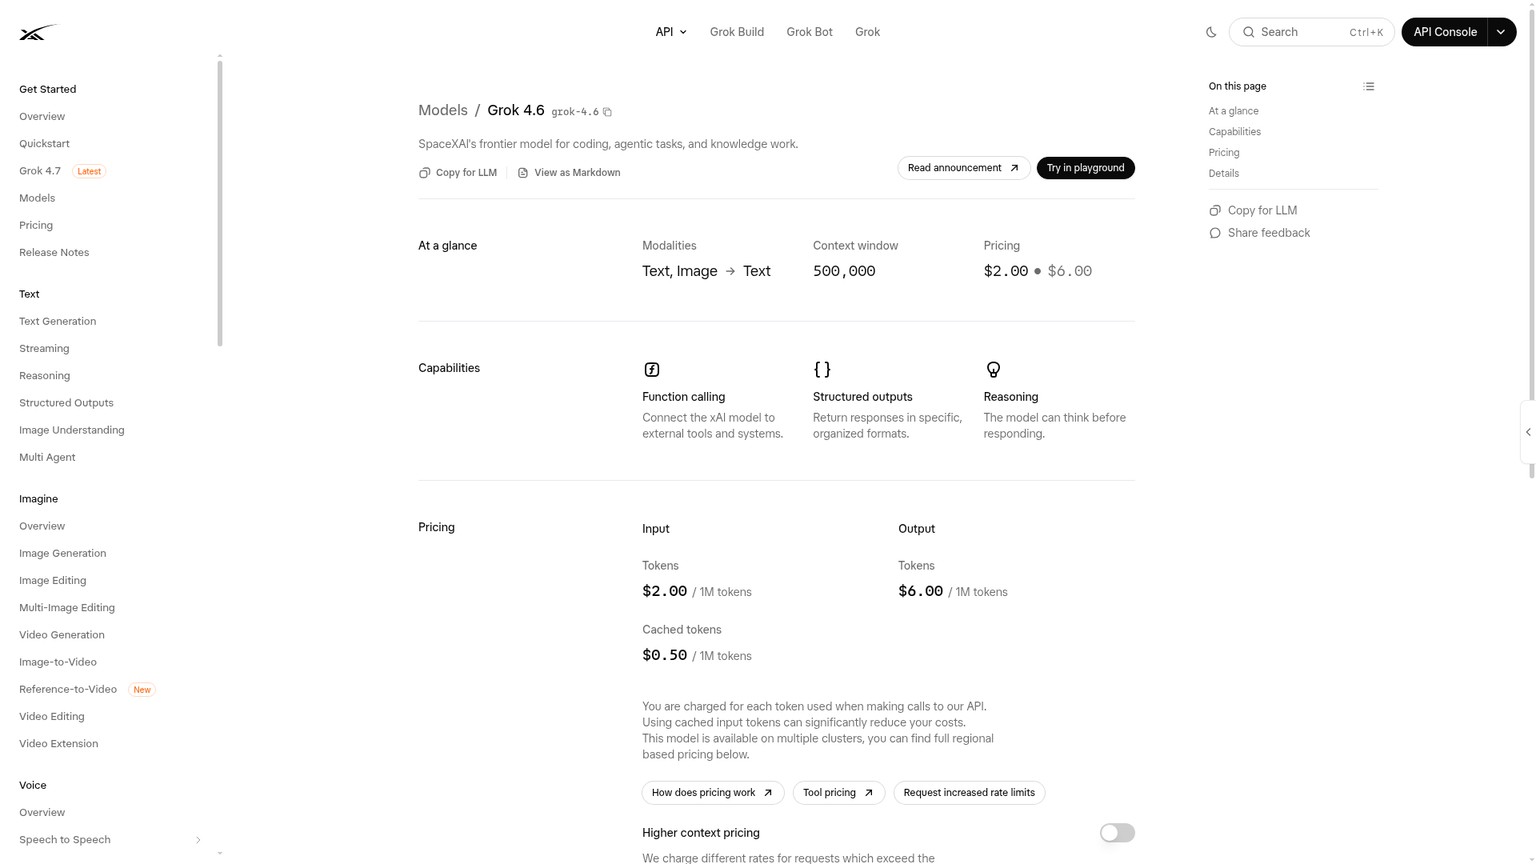
Лучше всего подходит для: стабильных процессов, которые уже проходят установленную приёмочную проверку.
Цена: $2 за новый вход, $0.50 за кэшированный вход и $6 за выход на миллион токенов при объёме до 200K.
Явное ограничение: более низкие результаты в актуальном сравнении сложных задач от xAI, при этом скидки за сохранение старой модели нет.
Не выбирайте, если: цена регулярно незавершённой работы уже выше стоимости контролируемой миграции.
Обе модели поддерживают уровни рассуждений low, medium, high и xhigh. В документации xAI по рассуждениям значение high задано по умолчанию, а отключить рассуждения нельзя. Именно общий режим high должен стать отправной точкой для парной проверки. Запуск 4.7 в xHigh нужно вынести в отдельный сценарий, поскольку он одновременно меняет бюджет качества, токенов и задержки.
Победитель: ничья по совместимости интерфейсов, Grok 4.7 — по текущей рекомендации разработчика. Знакомая поверхность упрощает миграцию, но совместимость параметров ещё не гарантирует одинакового выбора инструментов, схем вывода, момента остановки или поведения при повторных попытках.
Цена API Grok 4.7: одинаковые тарифы, разные счета за задачу
Публичные API-тарифы Grok 4.7 и Grok 4.6 полностью совпадают — это проверено по актуальной странице цен xAI 21 сентября 2026 года. При объёме запроса до 200,000 токенов каждая модель стоит $0.002 за 1K новых входных токенов, $0.0005 за 1K кэшированных входных токенов и $0.006 за 1K выходных токенов.
Если запрос содержит 200,000 входных токенов или больше, все его токены тарифицируются по ставке длинного контекста: $0.004 за 1K новых входных токенов, $0.001 за 1K кэшированных входных токенов и $0.012 за 1K выходных токенов. Окно на 500,000 токенов — это запас ёмкости, а не разрешение дёшево тащить за агентом неограниченную историю.
Эти строки получены точным расчётом токенов, а не из наблюдаемых запусков моделей. Они намеренно отделяют тарифный счётчик, чтобы исход сравнения определяло поведение.
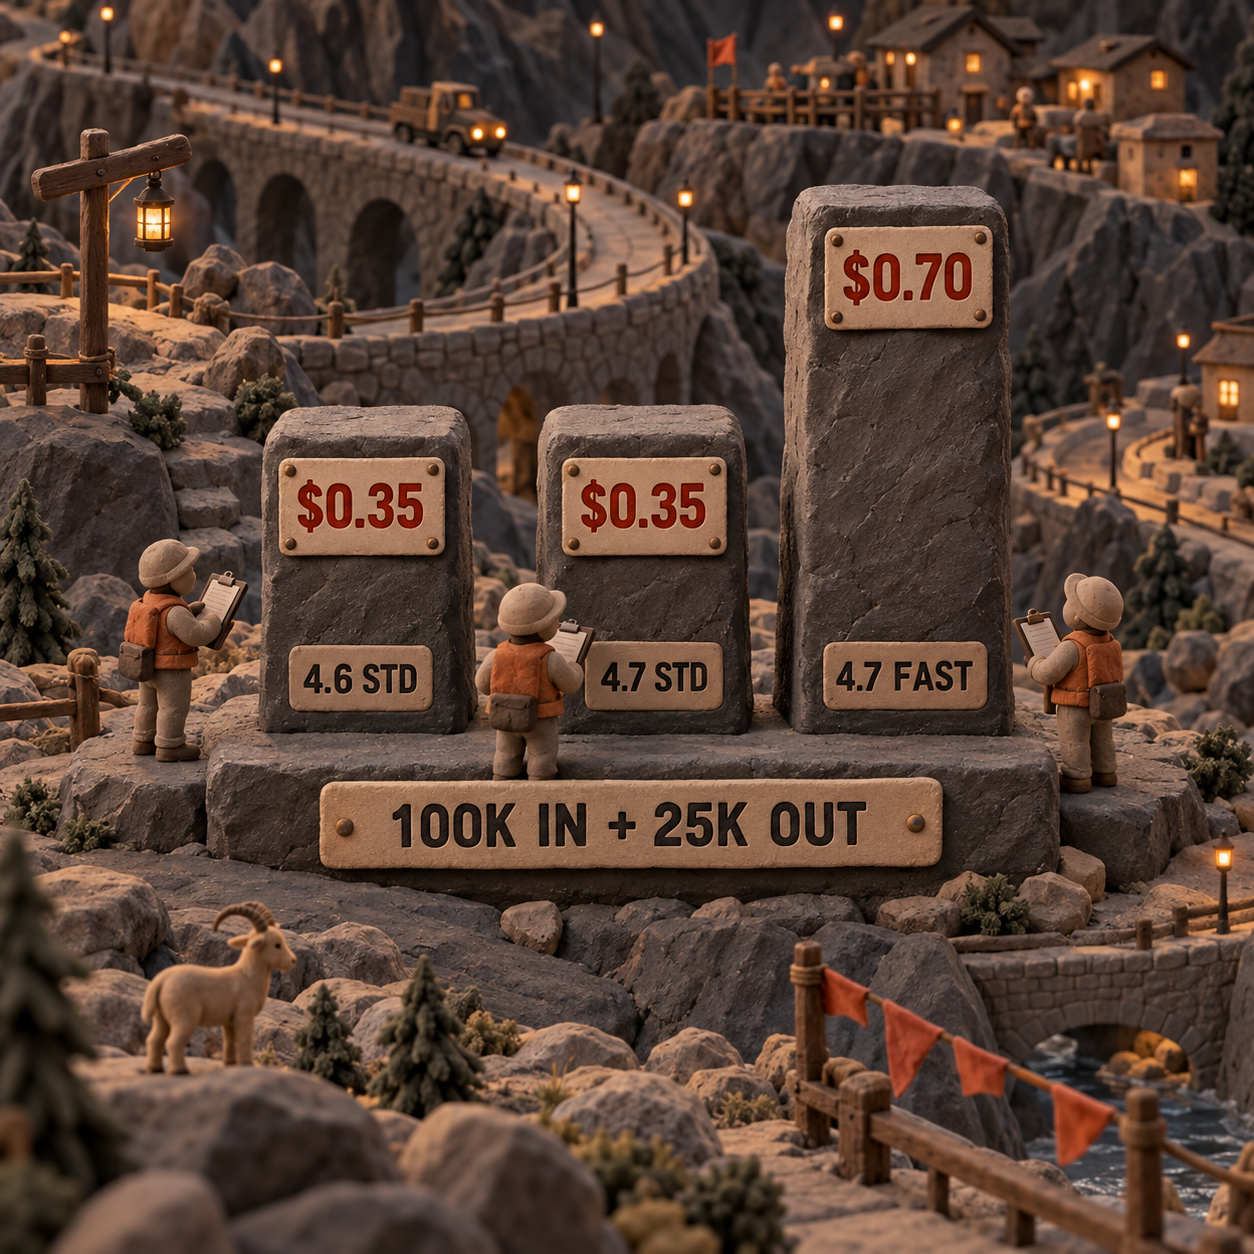
Точки пересечения тарифов у этих моделей нет. Пересекается стоимость выполненной работы:
cost per accepted task = total billed cost across all attempts / accepted tasks
Если за одну попытку обе модели расходуют одинаковое число оплачиваемых токенов, любое увеличение доли принятых задач делает 4.7 дешевле в расчёте на завершённую работу. Если 4.7 тратит больше из-за более долгих рассуждений, доля принятых задач должна вырасти сильнее, чем расходы. Равная цена в прайсе не защищает от дополнительных рассуждений, повторов, циклов инструментов и многословного вывода.
Для вариантов Fast и Priority нужны отдельные бюджеты:
- Grok 4.7 Fast при объёме запроса до 200,000 токенов стоит $4 за вход, $1 за кэшированный вход и $12 за выход на миллион токенов. Поэтому пример со 100K входных и 25K выходных токенов обойдётся в $0.70.
- Grok 4.7 Fast доступна только через Cursor и Grok Build, но не через публичный API xAI; бесплатный тариф Grok Build её также не включает.
- При объёме свыше 200,000 входных токенов подробная таблица Fast у xAI указывает $6 за вход, $1.50 за кэшированный вход и $18 за выход на миллион. Пользуйтесь опубликованной шкалой, а не единым множителем.
- Priority Processing в публичном API стоит в 2× дороже, если ответ подтверждает этот уровень обслуживания.
Обе модели сейчас не поддерживают Batch API. Токены рассуждений входят в расход, а инструменты публичного API оплачиваются отдельно. Web Search и Code Execution стоят по $5 за 1,000 вызовов. Поэтому в журнал оценки нужно заносить данные ответа о расходе и стоимости инструментов, а не оценку, рассчитанную только по длине запроса.
В предыдущем обзоре Grok 4.5 разобрано, почему порог 200K важен в длинных агентных циклах. Здесь действует тот же принцип: сокращайте устаревшую историю, прежде чем она незаметно удвоит стоимость токенов запроса.
Победитель — Grok 4.7, только если растёт доля завершённой работы. При одинаковой успешности Grok 4.6 выигрывает за счёт отсутствия затрат на миграцию. Если 4.7 устраняет ошибки, которые требуют повторных попыток или ручного ремонта, равные тарифы на токены превращаются в экономическое преимущество.
Цена перехода определяется эксплуатацией, а не контрактом
В категории стабильности выигрывает Grok 4.6: чтобы оставить всё как есть, ничего настраивать не нужно. Grok 4.7 должна окупить проверку поведения, обновление наблюдаемости и сохранение безопасного пути отката.
Перед сменой идентификатора модели зафиксируйте:
- Точный запрос, системную политику, схемы инструментов, снимок репозитория, тайм-аут и правила повторов.
- Валидаторы схем, тесты, линтер, команды сборки и все пункты ручной приёмки.
- Отдельные показатели нового и кэшированного входа, рассуждений, выхода, вызовов инструментов и времени для каждой попытки.
- Список побочных действий, уже выполненных до повтора или отката. Повторный запуск частично завершённой задачи способен продублировать действие.
- Старый идентификатор модели в конфигурации, а не внутри кода, чтобы вернуть отдельную нагрузку на 4.6 без отката несвязанных изменений.
Совместимость запросов не означает совместимости поведения. Схема структурированного вывода может успешно разбираться, но потерять обязательное поле. Агент для программирования способен вызвать те же инструменты, но остановиться до тестов. Исследовательский агент может закончить быстрее, пропустив проверку. Даже при успешном HTTP-запросе всё это остаётся регрессией.
Главное ограничение Grok 4.7 — переносимость доказательств: график xAI и одна повторная сборка браузера ничего не говорят о поведении модели в вашем репозитории. Ограничение Grok 4.6 обратное: известная стабильность не помогает с типом задач, который модель проваливает снова и снова. Разумное разделение сохраняет проверенную базовую линию, а более сложную очередь передаёт кандидату.
Обновляйте Grok 4.6 только после проверки на трёх задачах
До получения рабочего трафика обновление должно пройти три небольшие задачи на чистых копиях одного репозитория. Это локальная проверка процесса, а не универсальный бенчмарк. Для обеих моделей установите глубину рассуждений high, остальные условия оставьте одинаковыми, а любой запуск 4.7 в xHigh считайте отдельным экспериментом.
Зафиксируйте три приёмочных теста
Возьмите уже исправленную ошибку, небольшую функцию с изменениями в нескольких файлах и миграцию зависимости из одного репозитория. Определите успех до того, как задача попадёт к любой из моделей: целевой регрессионный тест пройден, весь набор тестов остаётся зелёным, линтер и сборка завершаются, нужные файлы изменены, постороннее поведение не затронуто.
Создавайте чистую копию для каждой попытки
Каждую пару «модель — задача» запускайте с одного и того же коммита в чистой рабочей копии. Дайте обеим моделям одинаковые запрос, файлы, инструменты, разрешения, тайм-аут и число допустимых повторов. Одна модель не должна наследовать патч или объяснение другой.
Сначала запустите обе модели в общем режиме
Вызовите
grok-4.7иgrok-4.6с уровнемhigh. Запишите возвращённый идентификатор модели, успех или провал, время, объём нового и кэшированного входа, расход на рассуждения и выход, плату за инструменты и итоговую сумму. Сохраняйте в результатах все неудачи. Версию 4.7 сxhighзапускайте только как отдельно помеченный тест.Переносите только выигравший тип задач
Сравните принятую работу, время и общий счёт. Переводите только тот тип задач, где побеждает 4.7, сохраняйте 4.6 как значение для отката и повторяйте проверку после изменений запроса, инструментов или модели. Смешанное внедрение оправдано, если стоимость его мониторинга ниже измеримого выигрыша.
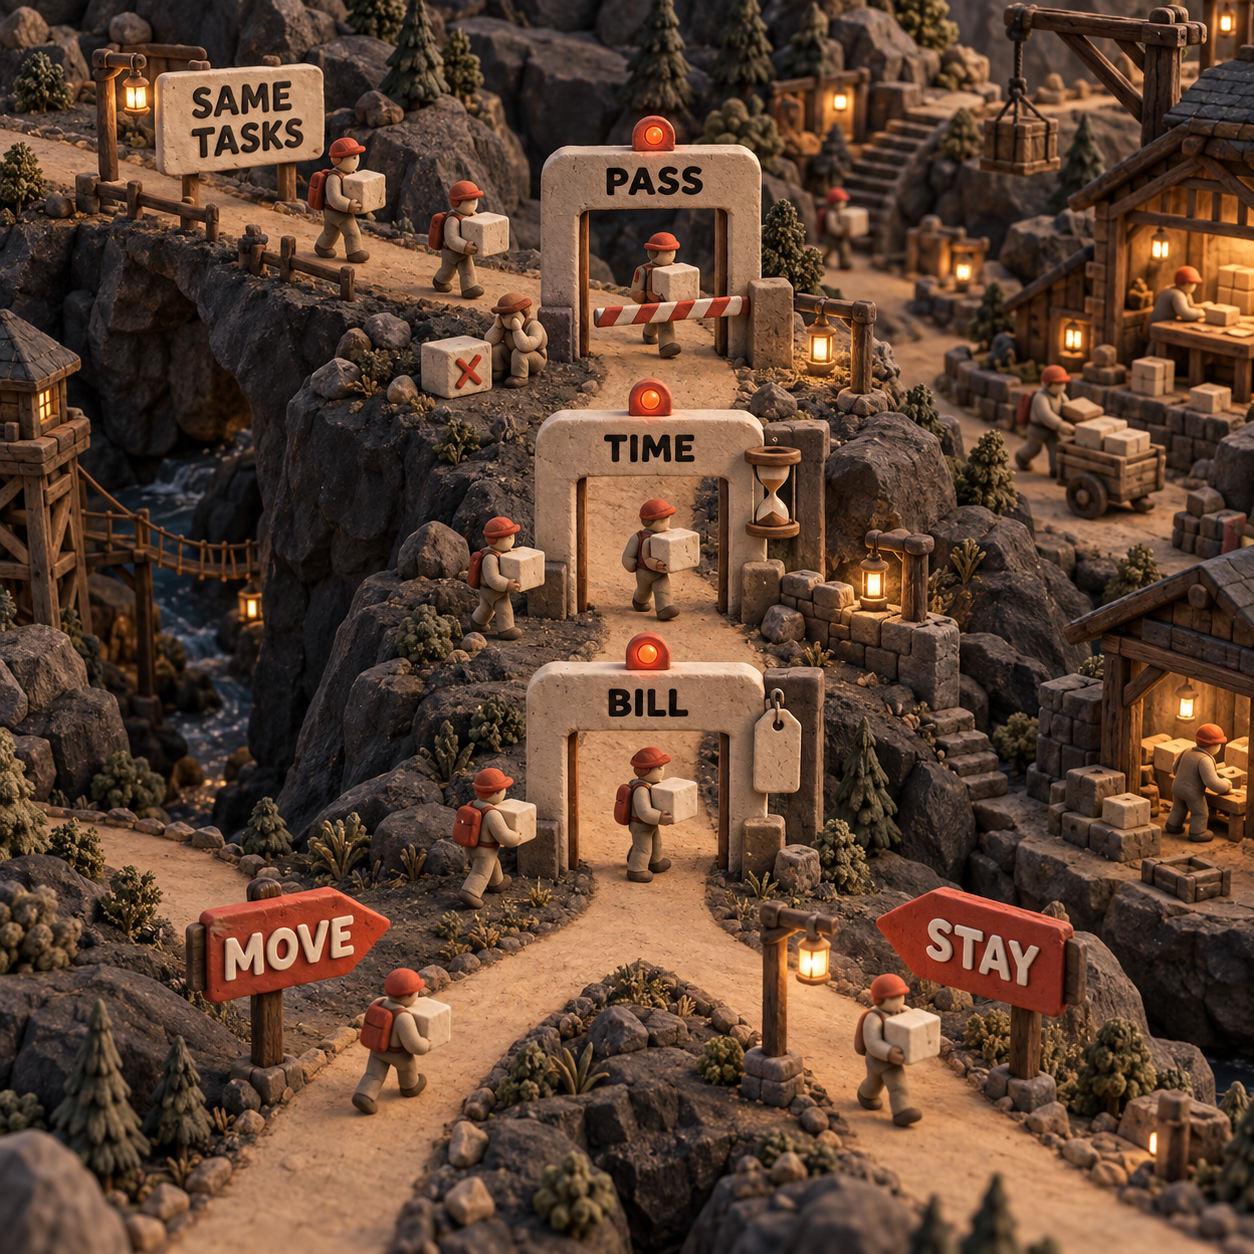
Ближайшее действие вполне конкретно: восстановите одну известную ошибку, выберите одну функцию с изменениями в нескольких файлах и одно обновление зависимости из работ прошлого месяца. На следующей неделе запустите эти три задачи в режиме High на чистых копиях, внесите каждый провал во внутреннюю таблицу и переносите лишь тот тип задач, для которого завершённая работа, время и реальный счёт оправдывают перемены.
Частые вопросы
Какую версию Grok лучше использовать?
Для кода и общих задач xAI сейчас рекомендует Grok 4.7. Но для процесса, который Grok 4.6 уже стабильно завершает, она остаётся более разумным операционным выбором, пока 4.7 не выиграет парную проверку на реальной нагрузке.
Grok 4.6 — хорошая модель?
Да. У неё те же документированное контекстное окно на 500,000 токенов, основные возможности инструментов, уровни рассуждений и стандартные API-тарифы, что и у 4.7. Слабая сторона — более низкие результаты по данным xAI в самых сложных сравнениях программирования и работы со знаниями.
Какая модель Grok сейчас лучшая?
xAI называет Grok 4.7 своей самой мощной моделью для кода и всех остальных задач. Поэтому проверять первой стоит именно её, но это ещё не доказывает превосходство над 4.6 в каждом действующем процессе.
Какие версии Grok существуют?
xAI развивает универсальные модели Grok, а также специализированные модели для изображений, видео и голоса. Для решений по программированию и работе со знаниями актуальны документированные идентификаторы grok-4.7 и grok-4.6; изменяющийся полный список следует смотреть в каталоге моделей.
Есть ли что-то лучше Grok?
Ни одна модель не бывает лучшей для всех репозиториев, наборов инструментов, требований к задержке и критериев качества. Сравнивайте разработчиков по принятой работе на каждый доллар при одинаковых задачах и условиях, а не воспринимайте бенчмарк одного из них как универсальный рейтинг.
Какие уровни есть у Grok?
Для Grok 4.7 и Grok 4.6 доступны уровни глубины рассуждений low, medium, high и xhigh. По умолчанию используется high, а полностью отключить рассуждения нельзя.
Есть ли у Grok режим 18+?
Это вопрос о потребительском продукте и режимах безопасности, а не о различиях возможностей двух идентификаторов API-моделей. При выборе между Grok 4.7 и Grok 4.6 для программирования он не должен влиять на миграцию.
Сколько Grok стоит в месяц?
В рассмотренном здесь API стоимость зависит от токенов и дополнительных вызовов инструментов, а не от фиксированной ежемесячной платы за модель. Актуальные потребительские подписки, бесплатный доступ и тарифы Grok Build собраны в статье Можно ли пользоваться Grok бесплатно?.
Какие модели Grok существуют?
Полный перечень меняется по мере появления и вывода из эксплуатации вариантов, поэтому ориентироваться нужно на актуальный каталог xAI. Для программирования и общей работы со знаниями xAI сейчас направляет пользователей к Grok 4.7.
Нужна готовая схема оценки агентов для программирования? Получите чек-лист по настройке Claude Code + Codex вместе с рассылкой.
- Последнее обновление
- 21 сент. 2026 г.
- Категория
- AI
Сделать этот сайт предпочтительным в Google


Отметьте omidsaffari.com как предпочтительный источник — и Google будет поднимать его для вас в Top Stories, AI Overviews и AI Mode.

ИИ-агенты в продакшене: как метрики уводят от цели
ИИ-редактор прошёл все проверки, но увёл 50 из 96 статей в нерелевантную тему. Разбираем метрики, которые поощрили дрейф, и новые ограничения.21 сент. 2026 г.AI
Цена Step 5 Preview: API и тарифы Step Plan
Сколько стоит Step 5 Preview: сравниваем цены API, скидку на кэшированные токены и Credits в Step Plan, чтобы выбрать правильную схему оплаты.21 сент. 2026 г.AI
Обзор Nouswise: проверяем цитаты, цены и ограничения
Обзор Nouswise: проверяем цитаты, проекты, API, цены и лимиты. Кому подойдет сервис, где он уступает NotebookLM и что проверить перед покупкой.10 сент. 2026 г.AI
ИИ для проверки строительной документации: лучшие сервисы для сабмитталов
Сравнение ИИ для проверки строительной документации: BuildSync, Part3, Nomic, InspectMind и SpecLens — цены, доказательства, редакции и сценарии выбора.9 сент. 2026 г.AI
VetGeni или ScribbleVet: какой ИИ-скрайб выбрать ветеринарной клинике
VetGeni или ScribbleVet: сравниваем цены, интеграции с PIMS, шаблоны, командную работу и экспорт, чтобы выбрать ИИ-скрайб для ветеринарной клиники.8 сент. 2026 г.AI
Обзор InspectMind AI: где сервис полезен, а где нет
Обзор InspectMind AI: цены, проверка строительных чертежей, качество ссылок на источники, ограничения и критерии, по которым сервис стоит внедрять.8 сент. 2026 г.AI
BuildSync или SpecLens: что выбрать для проверки сабмитталов
Сравниваем BuildSync и SpecLens по проверке сабмитталов, ссылкам на источники, форматам файлов, интеграциям, цене и удобству закупочного процесса.8 сент. 2026 г.AI