Grok 4.7 vs Grok 4.6: qual modelo escolher?
Grok 4.7 vs Grok 4.6: compare desempenho, preços da API, contexto e custos de migração para decidir qual modelo usar em cada carga de trabalho.


Grok 4.7 vs Grok 4.6 é uma decisão de avaliação, não de preço: ambos partem de $2 por milhão de tokens de entrada e $6 por milhão de tokens de saída. Direcione ao Grok 4.7 as novas tarefas difíceis de programação e conhecimento; mantenha os fluxos comprovados do Grok 4.6 até que o 4.7 vença em entregas concluídas, tempo decorrido e custo final.
Grok 4.7 vs Grok 4.6: qual escolher?
Escolha o Grok 4.7 para trabalhos em que o Grok 4.6 para antes de terminar, deixa passar uma dependência entre arquivos ou exige correções repetidas. Se um fluxo de produção com o Grok 4.6 já passa nas verificações dentro do orçamento, mantenha-o. Um modelo novo merece disputar tráfego, mas não justifica migrar todas as cargas de trabalho por si só.
Na prática, o primeiro passo muda conforme o perfil:
- Um fundador com capital captado e uma funcionalidade de produto bloqueada deve testar o Grok 4.7 nessa entrega, porque os maiores ganhos divulgados pela xAI aparecem em trabalhos difíceis e prolongados.
- Um CTO de empresa de médio porte deve preservar as automações aprovadas no Grok 4.6 e encaminhar as classes de tarefas que falharam para uma avaliação controlada do 4.7.
- Um profissional sênior que produz pesquisas, documentos ou apresentações deve comparar entregáveis aceitos, não o polimento do texto.
- Um desenvolvedor técnico independente deve usar o 4.7 no problema que o 4.6 não conseguiu concluir e só promovê-lo se o resultado passar pelos mesmos testes.
A escolha deve ser feita por carga de trabalho. Uma empresa pode usar o 4.7 em tarefas de repositório e manter o 4.6 em um fluxo estável de extração ou classificação. Esse roteamento adicional só vale a pena quando o benefício medido supera a complexidade operacional.
O Grok 4.7 é melhor?
Sim, considerando as evidências de programação difícil e trabalho profissional que a xAI publicou em 21 de setembro de 2026. Não, se a ideia for substituir automaticamente toda implantação do Grok 4.6. Os dados justificam uma avaliação, mas as configurações de raciocínio diferentes impedem que a comparação prove uma superioridade universal.
Grok 4.7 para programação
Vencedor: Grok 4.7, com a ressalva de que os benchmarks são do fornecedor. Na comparação publicada pela xAI no mesmo lançamento, o Grok 4.7 em xHigh marcou 46.3% no CursorBench 4.0, contra 40.4% do Grok 4.6 em High: vantagem de 5.9 pontos percentuais. No Terminal-Bench 4.0, os resultados foram 38.0% e 20.3%, uma diferença de 17.7 pontos. No EEBench, o placar foi 64.0% contra 53.0%, vantagem de 11 pontos.
São diferenças relevantes nas tarefas destacadas pelo lançamento: trabalho prolongado em repositórios, operação de terminal e engenharia. Ainda assim, os resultados foram divulgados pelo próprio fornecedor, e a xAI deu ao 4.7 a configuração mais profunda xHigh, enquanto o 4.6 rodou em High. Mais raciocínio pode elevar a qualidade, mas também acrescentar tokens de raciocínio e latência. O gráfico é um bom motivo para testar o 4.7, não uma estimativa controlada do ganho em produção.
Os resultados em tarefas de conhecimento apontam na mesma direção. A xAI informa 1,657 para o Grok 4.7 e 1,546 para o Grok 4.6 no AA Briefcase v1.1, além de 1,695 contra 1,605 no GDPval. No teste de agente jurídico, os modelos obtiveram 19.6% e 15.8%; no HealthBench Professional, 56.7% e 48.5%. Todos esses números pertencem à comparação de 21 de setembro, sem misturar uma versão antiga de benchmark em um falso confronto direto.
Não transforme a manchete do lançamento em promessa de velocidade. A página afirma que o Grok 4.7 é duas vezes mais rápido que modelos comparáveis, mas explica no corpo que o Grok 4.7 padrão é servido na mesma velocidade do Grok 4.6. A opção específica com saída 2× mais rápida é um nível de serviço Fast separado e mais caro.
A conclusão direta: o 4.7 conquistou o direito de ser testado nas tarefas difíceis. Ainda não justificou uma migração cega de toda a operação.
O que não muda: acesso, contexto, ferramentas e raciocínio
Grok 4.7 e Grok 4.6 oferecem superfícies de integração quase idênticas. Por isso, o maior risco da migração está no comportamento, não no formato básico da API. Os dois aceitam texto e imagens, retornam texto, oferecem chamadas de função e saídas estruturadas e têm uma janela de contexto de 500,000 tokens.
Grok 4.7: o modelo principal atual
O Grok 4.7 usa o ID de modelo documentado grok-4.7. A página atual do modelo na xAI o posiciona para programação, tarefas com agentes e tarefas de conhecimento. O anúncio informa disponibilidade pela API pública, Cursor, Grok Build, ferramentas de programação de terceiros, roteadores de modelos e plataformas de nuvem.
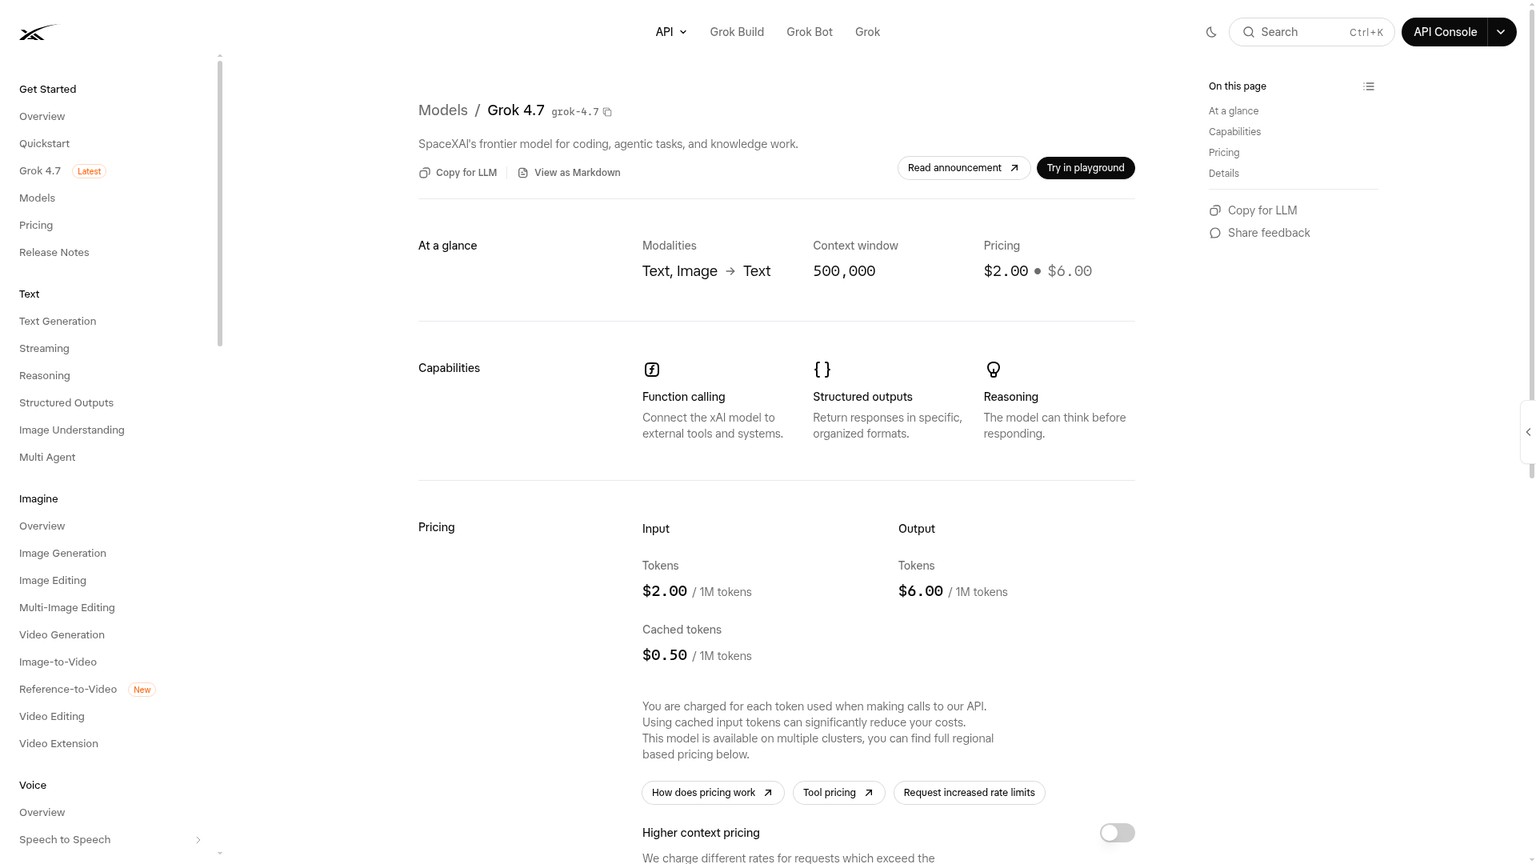
Melhor uso: programação difícil e tarefas de conhecimento que o 4.6 não conclui.
Preço: $2 por entrada sem cache, $0.50 por entrada em cache e $6 por saída a cada milhão de tokens abaixo de 200K.
Limite declarado: não oferece Batch, e a variante Fast não está disponível pela API pública da xAI.
Não use quando: um fluxo aprovado no 4.6 não tem uma falha cara a corrigir.
O comportamento na Responses API traz um detalhe de integração que merece verificação: o Grok 4.7 sempre retorna conteúdo de raciocínio criptografado, inclusive saídas criptografadas de ferramentas executadas no servidor. O cliente pode ignorar esse campo, mas, se gerencia manualmente o estado da conversa, deve preservar os itens de raciocínio sem alterações quando a continuidade for importante.
Grok 4.6: a referência documentada
O Grok 4.6 continua disponível como grok-4.6. A página atual do modelo ainda documenta a mesma janela de 500,000 tokens, as mesmas modalidades de entrada e saída e os mesmos recursos centrais de chamada de função, saída estruturada e raciocínio.
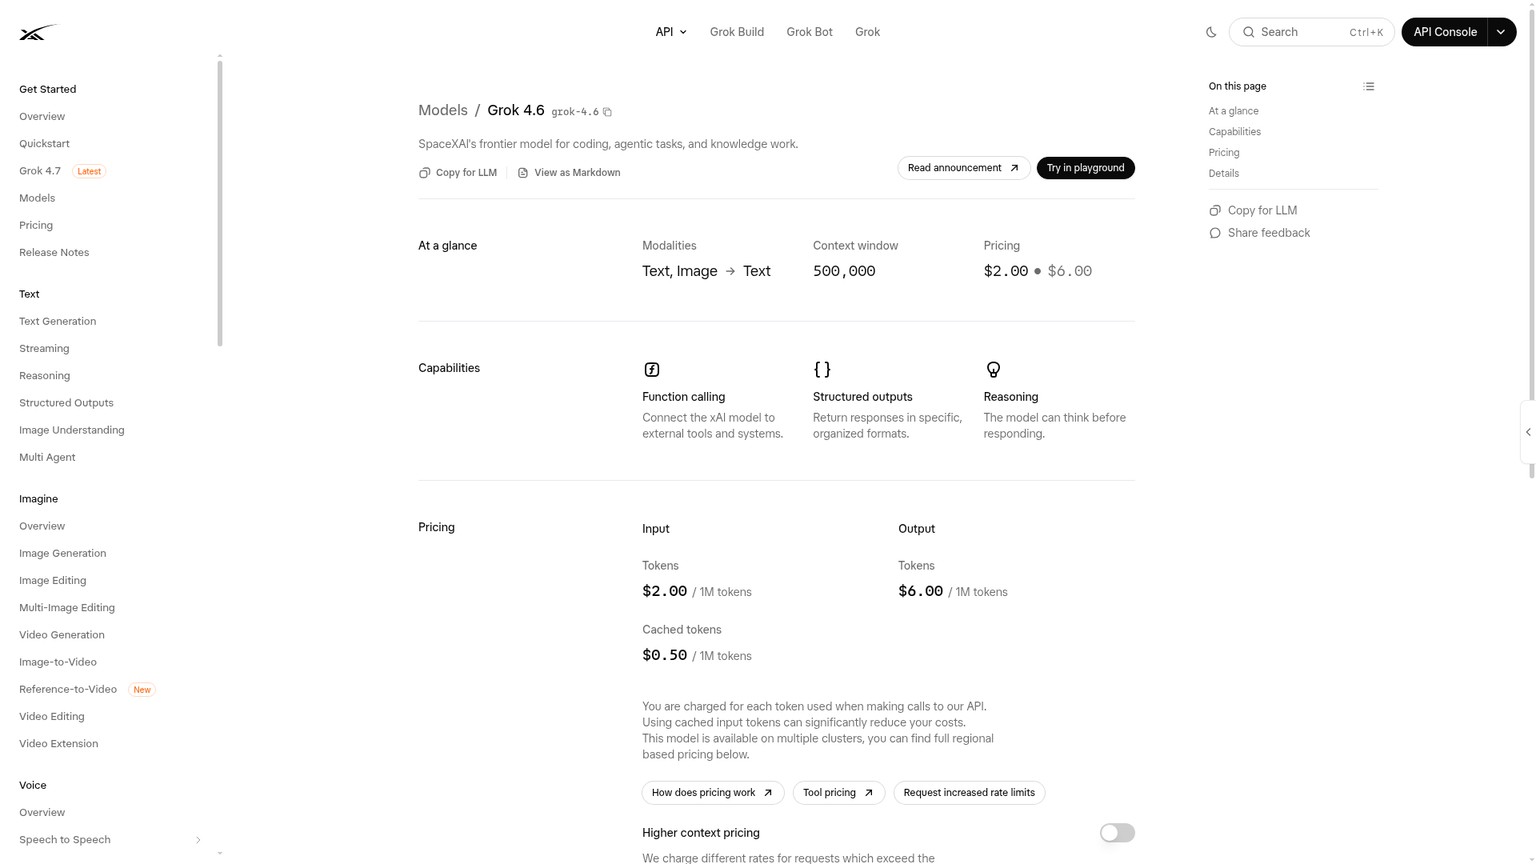
Melhor uso: fluxos estáveis que já atendem a um critério de aceitação definido.
Preço: $2 por entrada sem cache, $0.50 por entrada em cache e $6 por saída a cada milhão de tokens abaixo de 200K.
Limite declarado: pontuações menores nos testes atuais de tarefas difíceis divulgados pela xAI, sem desconto na tarifa de tokens por permanecer no modelo anterior.
Não use quando: o custo do trabalho repetidamente inacabado já supera o de uma migração controlada.
Os dois modelos aceitam os níveis de esforço de raciocínio low, medium, high e xhigh. A documentação de raciocínio da xAI define high como padrão e informa que o raciocínio não pode ser desativado. Esse nível high, comum aos dois, é o ponto de partida justo para uma avaliação pareada. Uma execução do 4.7 em xHigh deve ficar em uma trilha separada, pois altera ao mesmo tempo os orçamentos de qualidade, tokens e latência.
Vencedor: empate em compatibilidade de interface; Grok 4.7 na recomendação atual do fornecedor. A superfície familiar reduz o esforço de migração, mas parâmetros compatíveis não garantem as mesmas escolhas de ferramentas, esquemas de saída, decisões de parada ou padrões de nova tentativa.
Grok 4.7 API: mesmas tarifas, contas diferentes por tarefa
Grok 4.7 e Grok 4.6 têm as mesmas tarifas públicas de tokens na API, verificadas na página atual de preços da xAI em 21 de setembro de 2026. Abaixo de 200,000 tokens no prompt, cada modelo custa $0.002 por 1K tokens de entrada sem cache, $0.0005 por 1K tokens de entrada em cache e $0.006 por 1K tokens de saída.
A partir de 200,000 tokens no prompt, todos os tokens da solicitação passam para a tabela de contexto longo: $0.004 por 1K tokens de entrada sem cache, $0.001 por 1K tokens de entrada em cache e $0.012 por 1K tokens de saída. Uma janela de 500,000 tokens representa capacidade, não permissão para carregar um histórico ilimitado de agente a baixo custo.
As linhas mostram a aritmética exata dos tokens, não execuções observadas dos modelos. Assim, a variável de preço fica isolada e o comportamento pode decidir a comparação.
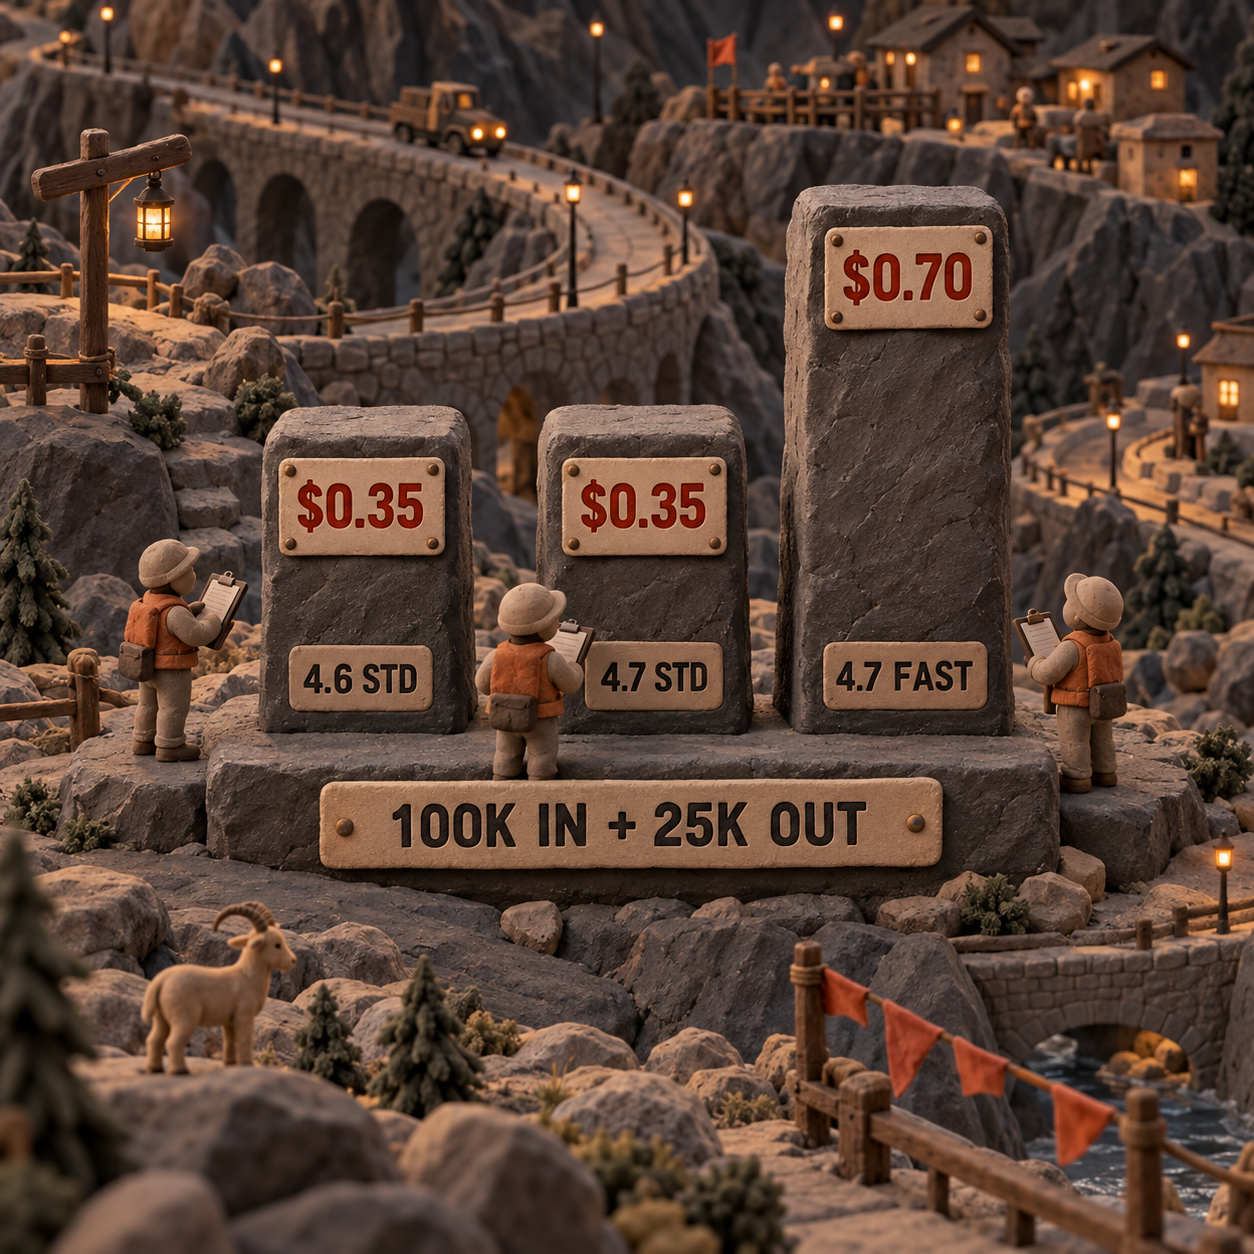
Não há ponto de cruzamento entre as tarifas de tokens desses modelos. O que muda o resultado são as entregas concluídas:
cost per accepted task = total billed cost across all attempts / accepted tasks
Se os dois modelos consumirem a mesma quantidade faturada de tokens por tentativa, qualquer aumento na taxa de tarefas aceitas tornará o 4.7 mais barato por entrega concluída. Se o 4.7 gastar mais por raciocinar durante mais tempo, a taxa de aceitação precisará crescer em proporção maior que esse aumento de gasto. Preços de tabela iguais não evitam custos extras de raciocínio, novas tentativas, ciclos de ferramentas ou saídas longas.
As opções Fast e prioritária exigem orçamentos separados:
- O Grok 4.7 Fast abaixo de 200,000 tokens no prompt custa $4 por entrada, $1 por entrada em cache e $12 por saída a cada milhão de tokens. Portanto, o exemplo com 100K de entrada e 25K de saída custa $0.70.
- O Grok 4.7 Fast está disponível apenas pelo Cursor e pelo Grok Build, não pela API pública da xAI, e o plano gratuito do Grok Build não o inclui.
- Acima de 200,000 tokens no prompt, a tabela detalhada do Fast publicada pela xAI traz $6 por entrada, $1.50 por entrada em cache e $18 por saída a cada milhão. Use essa tabela, em vez de aplicar um multiplicador genérico.
- O Priority Processing da API pública cobra uma tarifa 2× maior quando a resposta confirma o nível de serviço prioritário.
Nenhum dos dois modelos oferece suporte à Batch API no momento. Tokens de raciocínio entram no consumo, e as ferramentas da API pública acrescentam outra fonte de cobrança. Web Search e Code Execution custam, cada um, $5 por 1,000 chamadas. Por isso, o registro da avaliação deve usar os dados de consumo e as cobranças de ferramentas retornados na resposta, não uma estimativa baseada apenas no tamanho do prompt.
A análise anterior do Grok 4.5 explica por que esse limite de 200K importa em ciclos longos de agentes. A mesma lição vale aqui: compacte o histórico obsoleto antes que ele dobre silenciosamente as tarifas de tokens da solicitação.
Vencedor: Grok 4.7 apenas quando aumenta o volume de entregas concluídas. Se os dois modelos forem aprovados na mesma proporção, o Grok 4.6 vence por evitar o trabalho de migração. Se o 4.7 resolver falhas que exigiriam novas tentativas ou correção humana, suas tarifas iguais de tokens se tornam uma vantagem econômica.
O custo da troca é operacional, não contratual
O Grok 4.6 vence em estabilidade porque permanecer nele não exige nenhuma configuração. O Grok 4.7 precisa compensar o trabalho de validar comportamento, atualizar a observabilidade e manter uma rota segura de rollback.
Preserve estes controles antes de trocar o ID do modelo:
- O prompt exato, a política de sistema, os esquemas das ferramentas, o snapshot do repositório, o timeout e a política de novas tentativas.
- Validadores de esquema, testes, lint, comandos de build e todo checklist de aprovação humana.
- Registros separados de entrada sem cache, entrada em cache, raciocínio, saída, chamadas de ferramentas e tempo decorrido em cada tentativa.
- Um registro dos efeitos colaterais já concluídos antes de uma nova tentativa ou rollback. Repetir uma tarefa parcialmente concluída pode duplicar uma ação.
- O ID do modelo antigo na configuração, sem ficar escondido no código, para que uma carga possa voltar ao 4.6 sem reverter mudanças não relacionadas.
Compatibilidade de prompt não é compatibilidade de comportamento. Um esquema de saída estruturada pode continuar válido, mas perder um campo obrigatório. Um agente de programação pode chamar as mesmas ferramentas e parar antes dos testes. Um agente de pesquisa pode terminar mais rápido por pular a verificação. Tudo isso é regressão, mesmo quando a solicitação HTTP funciona.
A principal limitação do Grok 4.7 é transferir as evidências para o seu contexto: o gráfico da xAI e a reconstrução de um navegador não revelam como o modelo se comporta no seu repositório. A limitação do Grok 4.6 é o inverso: a estabilidade conhecida não corrige uma classe de tarefas em que ele falha repetidamente. A divisão certa preserva a referência conhecida e entrega a fila mais difícil ao candidato.
Só migre do Grok 4.6 depois deste teste de três tarefas
Antes de receber tráfego de produção, o modelo novo deve passar por três tarefas pequenas em cópias limpas de um repositório. É uma verificação curta de fluxo, não um benchmark geral. Use raciocínio high nos dois modelos, mantenha todos os outros controles idênticos e trate qualquer execução do 4.7 em xHigh como experimento separado.
Congele três testes de aceitação
Use um bug corrigido anteriormente, uma pequena funcionalidade que altere vários arquivos e uma migração de dependência do mesmo repositório. Defina o sucesso antes que qualquer modelo veja a tarefa: o teste de regressão selecionado passa, a suíte completa de testes continua verde, lint e build terminam, os arquivos solicitados mudam e o comportamento não relacionado permanece intacto.
Crie cópias limpas para cada tentativa
Inicie cada par de modelo e tarefa no mesmo commit, em uma cópia de trabalho limpa. Dê aos dois modelos o mesmo prompt, arquivos, ferramentas, permissões, timeout e limite de novas tentativas. Não permita que um modelo herde o patch ou a explicação do outro.
Comece pela configuração comum
Execute
grok-4.7egrok-4.6emhigh. Registre o ID de modelo retornado, aprovação ou falha, tempo decorrido, entrada sem cache e em cache, consumo de raciocínio e saída, cobranças de ferramentas e valor faturado. Mantenha todas as falhas nos resultados. Rode o 4.7 emxhighapenas como um teste identificado separadamente.Promova por classe de tarefa
Compare tarefas aceitas, tempo decorrido e custo total. Migre apenas a classe em que o 4.7 vencer, mantenha o 4.6 como valor de rollback e repita a verificação depois de mudanças no prompt, nas ferramentas ou no modelo. Uma implantação mista é válida quando seu custo de monitoramento fica abaixo do benefício medido.
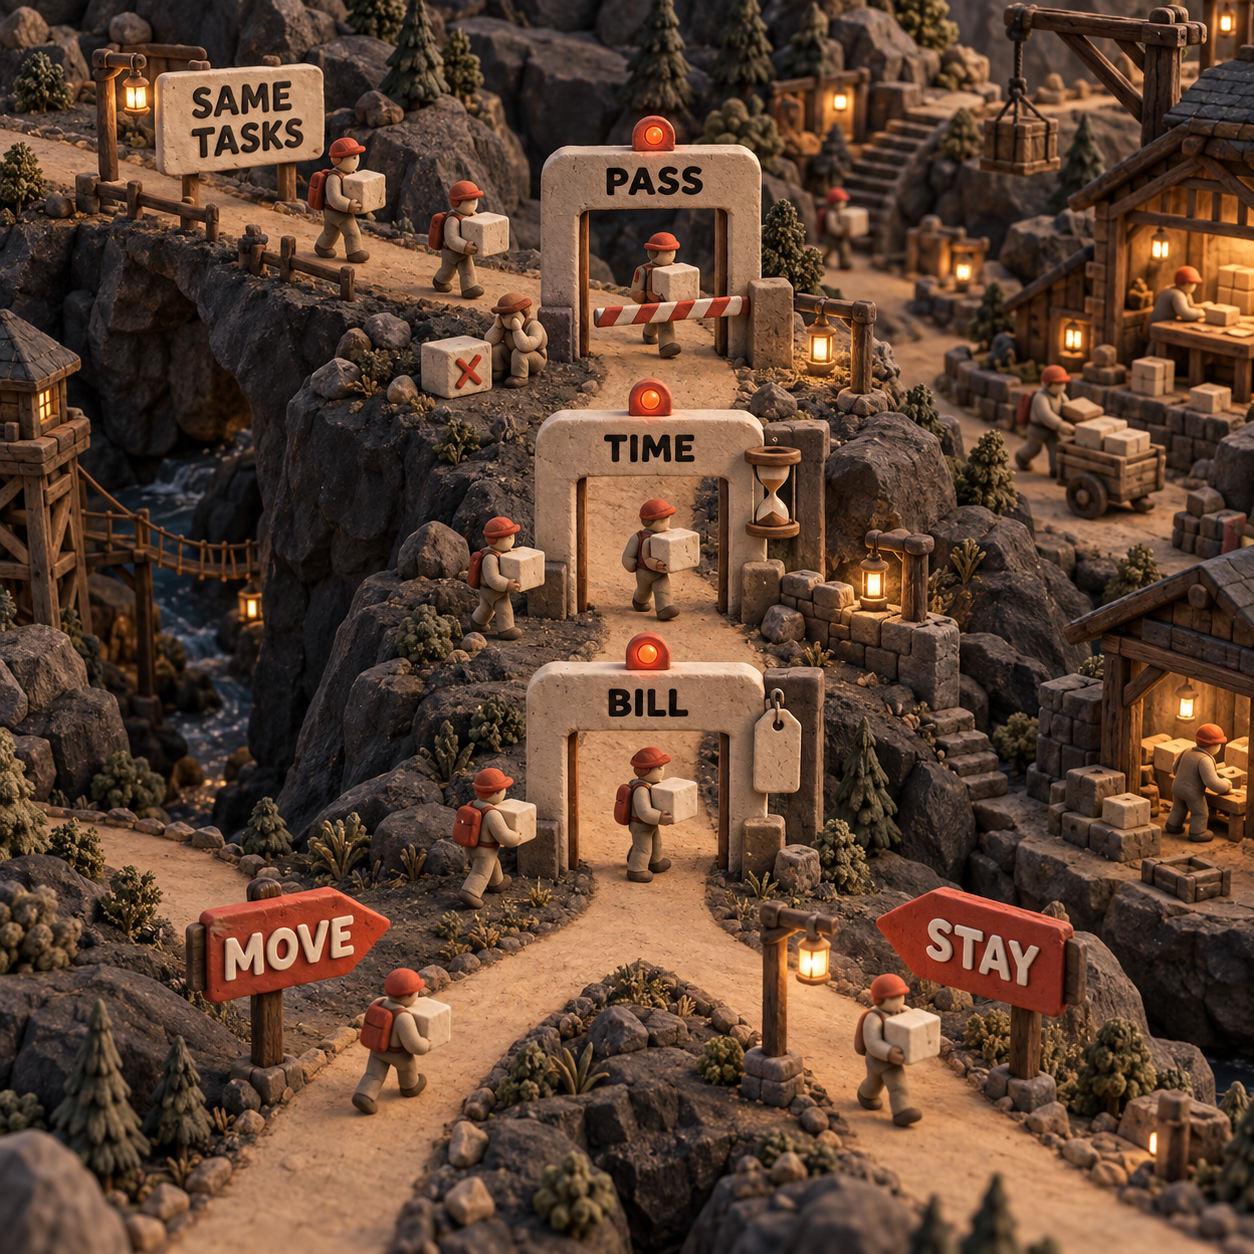
A ação para segunda-feira é concreta: recrie um bug conhecido, escolha uma funcionalidade que altere vários arquivos e selecione uma atualização de dependência do trabalho do mês passado. Execute essas três tarefas na próxima semana em High e em cópias limpas, publique internamente todas as falhas na planilha de resultados e migre apenas a classe de tarefa em que as entregas concluídas, o tempo decorrido e o custo real justificarem a mudança.
Perguntas frequentes
Qual é a melhor versão do Grok para usar?
O Grok 4.7 é a recomendação atual da xAI para programação e trabalho geral. O Grok 4.6 continua sendo a melhor escolha operacional para um fluxo que ele já conclui com confiabilidade, até que o 4.7 vença um teste pareado com essa carga.
O Grok 4.6 é bom?
Sim. Ele tem a mesma janela de contexto documentada de 500,000 tokens, os mesmos recursos centrais de ferramentas, configurações de raciocínio e preços padrão da API que o 4.7. O ponto fraco são os resultados inferiores divulgados pela xAI nas comparações mais difíceis de programação e tarefas de conhecimento.
Qual é o melhor modelo Grok atualmente?
A xAI chama o Grok 4.7 de seu modelo mais capaz para código e todo o restante. Isso faz dele o primeiro candidato a uma avaliação, não uma prova de que supera o 4.6 em todo fluxo implantado.
Quais são as diferentes versões do Grok?
A xAI mantém modelos Grok de uso geral, além de modelos especializados em imagem, vídeo e voz. Para esta decisão de programação e tarefas de conhecimento, os IDs documentados relevantes são grok-4.7 e grok-4.6; consulte o catálogo atual de modelos para acompanhar a lista completa, que muda com o tempo.
Existe algo melhor que o Grok?
Nenhum modelo é o melhor em todo repositório, conjunto de ferramentas, meta de latência e critério de qualidade. Compare fornecedores pelas tarefas aceitas por dólar, usando as mesmas tarefas e controles, em vez de tratar um benchmark de fornecedor como ranking universal.
Quais são os níveis do Grok?
No Grok 4.7 e no Grok 4.6, os níveis de esforço de raciocínio são low, medium, high e xhigh. O padrão é high, e o raciocínio não pode ser desativado.
O Grok tem modo 18+?
Essa é uma questão sobre o produto para consumidores e seus modos de segurança, não uma diferença de capacidade entre esses dois IDs de modelo da API. Ela não deve orientar uma migração de programação do Grok 4.6 para o Grok 4.7.
Quanto custa o Grok por mês?
No uso da API comparado aqui, o custo é medido por tokens e chamadas opcionais de ferramentas, não por uma mensalidade fixa de cada modelo. Assinaturas para consumidores, acesso gratuito e planos do Grok Build são mantidos atualizados em O Grok é grátis?.
Quais são todos os modelos Grok?
A lista completa muda conforme a xAI adiciona e descontinua variantes, por isso o catálogo atual é a fonte oficial. Para programação e tarefas gerais de conhecimento, hoje a xAI direciona os usuários ao Grok 4.7.
Quer um ambiente pronto para avaliar agentes de programação? Receba o checklist de configuração do Claude Code + Codex pela newsletter.
- Última atualização
- 21 de set. de 2026
- Categoria
- AI
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Agentes de IA em produção: quando cumprir regras vira o problema
Um editor de IA tirou 50 de 96 artigos do foco. Entenda os custos medidos, as regras que premiaram o desvio e os controles adotados para corrigi-lo.21 de set. de 2026AI
Preço do Step 5 Preview: API, cache e Step Plan
Veja o preço do Step 5 Preview, compare a API padrão com os Credits do Step Plan e entenda cache, raciocínio e custo real antes de assinar com segurança.21 de set. de 2026AI
Nouswise vale a pena? Análise da IA para pesquisa com fontes
Analisamos em detalhes o Nouswise, uma IA para pesquisa com citações: preços, limites, riscos e o que validar antes de adotá-lo no lugar do NotebookLM.10 de set. de 2026AI
IA na construção civil: 5 ferramentas para revisar submittals
Veja quais ferramentas de IA na construção civil conferem submittals contra especificações, com fontes, controle de revisões, preços e testes.9 de set. de 2026AI
IA veterinária: VetGeni ou ScribbleVet — qual vale mais?
VetGeni ou ScribbleVet? Compare preços, limite de notas SOAP, integrações com PIMS, modelos e acesso da equipe antes de escolher a IA veterinária.9 de set. de 2026AI
IA para construção civil: o InspectMind vale a pena?
Veja como a IA para construção civil do InspectMind revisa projetos, quanto custa cada checagem e quais limites pesam antes de adotar a ferramenta.8 de set. de 2026AI
BuildSync ou SpecLens: qual software para construção civil escolher?
Compare BuildSync e SpecLens em submittals, integrações, arquivos, exportações e preços para escolher o software para construção civil ideal para sua obra.8 de set. de 2026AI