Grok 4.7 对比 Grok 4.6:谁更强,是否值得升级?
Grok 4.7 对比 Grok 4.6:两者标准 API 价格相同,真正差别在复杂编程、知识工作和迁移风险。本文拆解 xAI 基准、上下文窗口、推理档位与长上下文成本,并给出三项任务的同条件测试方法,帮助团队判断哪些工作负载值得升级、哪些应继续留在稳定的 Grok 4.6 流程,避免只看发布分数做决定。
发布于
 作者 Omid Saffari
Grok 4.7 对比 Grok 4.6,核心是评估取舍,而不是价格取舍:两者起步价同为每百万输入 token $2、每百万输出 token $6。新的高难度编程和知识工作优先用 Grok 4.7 试跑;已经验证的 Grok 4.6 流程先保留,直到 4.7 在交付结果、耗时和最终账单上胜出。
Grok 4.7 对比 Grok 4.6:该怎么选?
如果 Grok 4.6 会提前停下、漏掉跨文件依赖,或需要反复纠正,选择 Grok 4.7。如果现有 Grok 4.6 生产流程已能在预算内通过检查,就继续保留。新模型值得进入流量测试,但不是所有工作负载都必须迁移的理由。
不同读者的第一步也应有所区别:
- 资金充足、产品功能卡住的创业者,应先让 Grok 4.7 试做这个功能,因为 xAI 公布的最大提升集中在高难度、长流程任务上。
- 中型企业 CTO 应保持已经通过验证的 Grok 4.6 自动化不动,只把失败的任务类型送入受控的 4.7 评估。
- 负责研究、文档或演示材料的资深从业者,应比较最终被接受的交付物,而不是文字看起来是否更精致。
- 独立技术开发者可以让 4.7 攻克 4.6 未能完成的问题;只有结果通过同一套测试后,再将其升级为正式选择。
这是按工作负载做出的决策。同一家公司完全可以让 4.7 负责代码仓库工作,同时保留 4.6 处理稳定的抽取或分类流程。只有实测收益超过额外的运维复杂度,这套分流才值得。
Grok 4.7 真的更好吗?
就 xAI 在 2026 年九月 21 日公布的高难度编程和专业工作证据而言,是的;但它并不必然适合替换所有 Grok 4.6 部署。现有证据足以支持启动评估,却因两款模型采用了不同的推理档位,无法证明这是普遍适用的升级。
Grok 4.7 编程表现
胜者:Grok 4.7,但需注意这是厂商基准。 在 xAI 同期发布的对比中,采用 xHigh 的 Grok 4.7 在 CursorBench 4.0 上得分 46.3%,采用 High 的 Grok 4.6 为 40.4%,领先 5.9 个百分点。Terminal-Bench 4.0 的成绩分别是 38.0% 和 20.3%,差距为 17.7 个百分点;EEBench 则是 64.0% 对 53.0%,领先 11 个百分点。
这些差距与发布内容重点强调的任务一致:持续的代码仓库作业、终端操作和工程任务。但结果仍由厂商报告,而且 xAI 给 4.7 使用了更深的 xHigh 档位,4.6 则使用 High。增加推理可能提升质量,也会增加推理 token 和延迟。因此,这张图表应被视为测试 4.7 的理由,而不是对生产环境收益的受控估算。
知识工作的趋势也相同。xAI 报告称,在 AA Briefcase v1.1 上,Grok 4.7 与 Grok 4.6 的成绩分别为 1,657 和 1,546;GDPval 上则是 1,695 和 1,605。法律智能体成绩为 19.6% 对 15.8%,HealthBench Professional 为 56.7% 对 48.5%。这些数据全部来自九月 21 日的同一轮对比,因此没有把旧版基准混入这次正面对照。
不要把发布标题理解成速度承诺。页面称 Grok 4.7 的速度是同类模型的两倍,但正文明确写着,标准版 Grok 4.7 的服务速度与 Grok 4.6 相同。输出速度达到 2× 的选项属于单独的 Fast 服务档位,价格也更高。
直截了当地说,4.7 已经证明自己值得接受高难度任务测试,但还没有证明应当盲目进行全系统迁移。
哪些没有变化:访问方式、上下文、工具与推理
Grok 4.7 和 Grok 4.6 提供的集成接口几乎相同,因此大多数迁移风险来自行为差异,而不是基础 API 形态。两者都接受文本和图像输入、返回文本,支持函数调用和结构化输出,并拥有 500,000-token 上下文窗口。
Grok 4.7:当前旗舰模型
Grok 4.7 使用文档中的模型 ID grok-4.7。xAI 的实时模型页面将其定位于编程、智能体任务和知识工作;发布信息显示,它可通过公共 API、Cursor、Grok Build、第三方编程工具、模型路由器和云平台使用。
最适合: 4.6 无法完成的高难度编程和知识工作。
价格: 200K 以下,每百万 token 的新输入为 $2、缓存输入为 $0.50、输出为 $6。
明确限制: 不支持 Batch,Fast 版本也无法通过 xAI 公共 API 使用。
不适合: 已经稳定通过的 4.6 流程不存在代价高昂、亟待解决的失败。
它在 Responses API 中还有一个值得检查的集成细节:Grok 4.7 始终返回加密的推理内容,包括服务端工具生成的加密输出。客户端可以忽略该字段;但如果客户端手动维护对话状态,在连续性很重要时,就应原样保留这些推理项。
Grok 4.6:有文档支持的稳定基线
Grok 4.6 仍可通过 grok-4.6 使用。它的当前模型页面仍记录着相同的 500,000-token 窗口、相同的输入与输出模态,以及相同的核心函数调用、结构化输出和推理能力。
最适合: 已经能够通过明确验收门槛的稳定流程。
价格: 200K 以下,每百万 token 的新输入为 $2、缓存输入为 $0.50、输出为 $6。
明确限制: 在 xAI 当前的高难度任务对比中得分较低,继续使用也没有 token 费率折扣。
不适合: 反复出现的未完成工作,其成本已经超过一次受控迁移。
两款模型都支持 low、medium、high 和 xhigh 推理强度。xAI 的推理文档将 high 设为默认值,并说明推理无法关闭。共同的 high 档位是配对评估的公平起点。4.7 的 xHigh 运行应放在单独的测试通道中,因为它会同时改变质量、token 和延迟预算。
结论:接口兼容性平手,厂商当前推荐则是 Grok 4.7 胜出。 熟悉的接口降低了迁移难度,但参数兼容并不代表工具选择、输出 schema、停止行为或重试模式也会完全一致。
Grok 4.7 价格:费率相同,单项任务账单未必相同
Grok 4.7 与 Grok 4.6 的公共 API token 费率完全相同;该信息已于 2026 年九月 21 日对照 xAI 实时价格页面核实。提示词低于 200,000 token 时,两者每 1K 新输入 token 的价格均为 $0.002,每 1K 缓存输入 token 为 $0.0005,每 1K 输出 token 为 $0.006。
当提示词达到或超过 200,000 token,请求中的所有 token 都会切换到长上下文计费:每 1K 新输入 token 为 $0.004、每 1K 缓存输入 token 为 $0.001、每 1K 输出 token 为 $0.012。500,000-token 窗口代表容量,并不意味着可以毫无成本意识地携带不断膨胀的智能体历史记录。
表中各行来自精确的 token 算术,并非模型实跑结果。它们把计价因素单独固定下来,让模型行为决定比较结果。
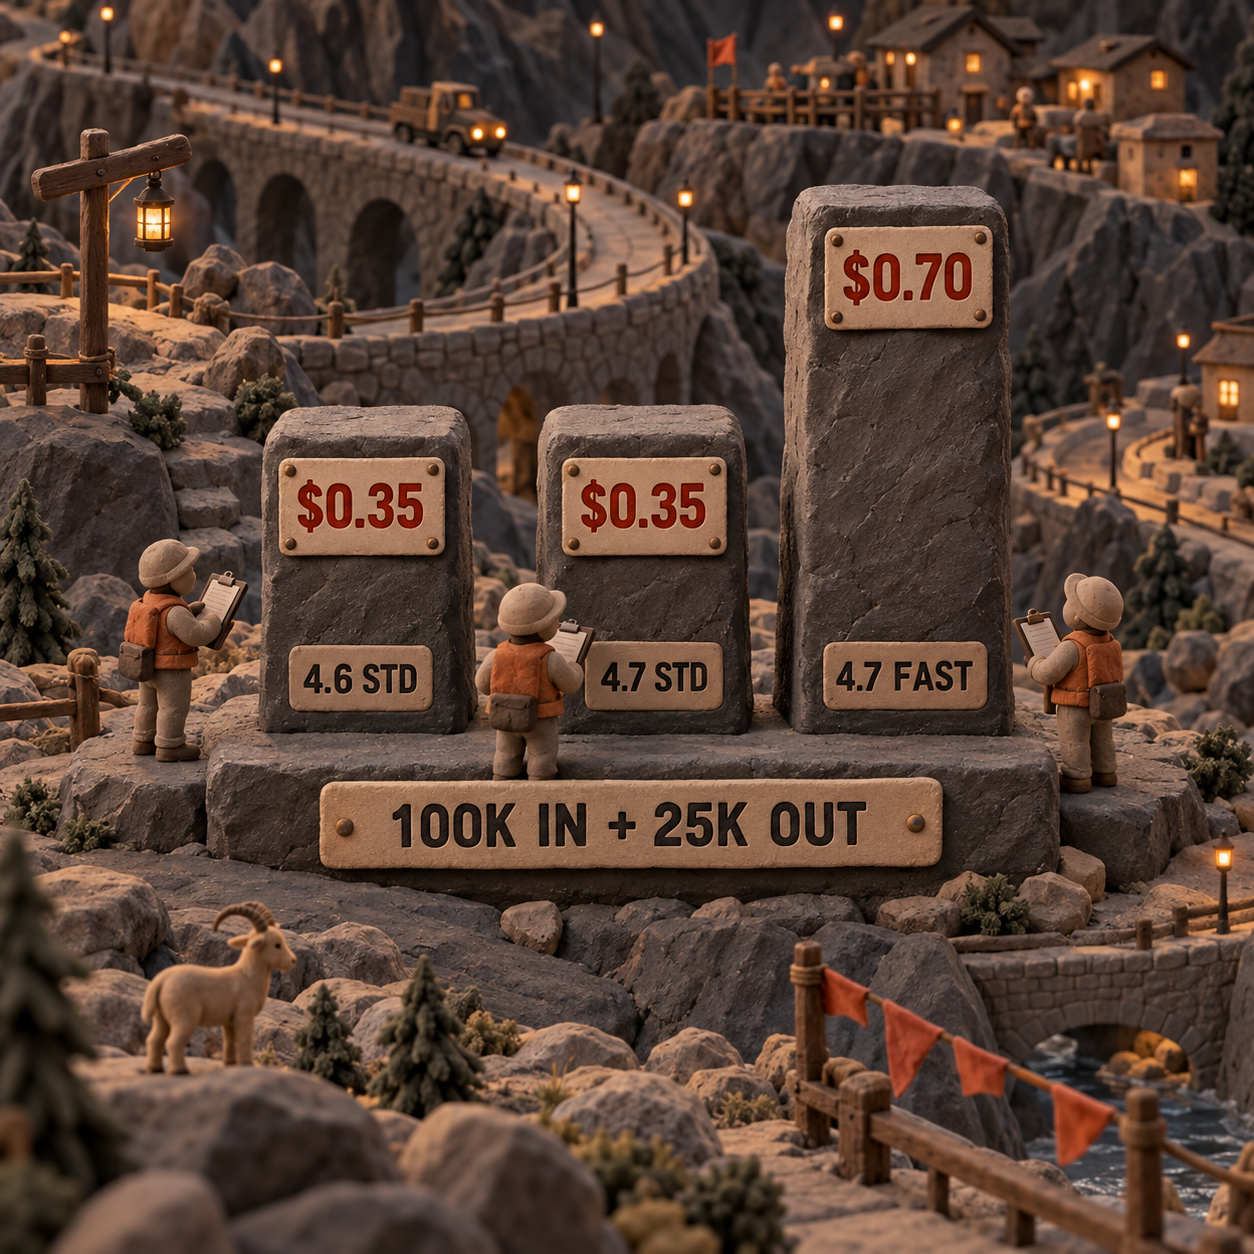
这两款模型之间不存在 token 费率的交叉点,真正的分界线是完成的工作量:
cost per accepted task = total billed cost across all attempts / accepted tasks
如果两款模型每次尝试消耗的计费 token 相同,那么只要 4.7 提高任务通过率,其单位已完成任务成本就会更低。如果 4.7 因推理更久而花费更多,它提升任务通过率的比例就必须高于成本增幅。标价相同,并不能抵消额外推理、重试、工具循环或冗长输出带来的费用。
Fast 与优先处理选项需要单独设置预算:
- Grok 4.7 Fast 在提示词低于 200,000 token 时,每百万 token 的输入价格为 $4、缓存输入为 $1、输出为 $12。因此,100K 输入、25K 输出的示例成本为 $0.70。
- Grok 4.7 Fast 只能通过 Cursor 和 Grok Build 使用,无法通过 xAI 公共 API 使用;Grok Build 免费档位也不包含该服务。
- 提示词超过 200,000 token 时,xAI 的 Fast 详细价目表列出的每百万 token 价格为:输入 $6、缓存输入 $1.50、输出 $18。应采用这份公开费率,而不是一概套用固定倍数。
- 当响应确认使用优先服务档位时,公共 API 的 Priority Processing 会收取 2× 溢价。
两款模型目前都不支持 Batch API。推理 token 会计入用量,公共 API 工具还会产生另一项计费。Web Search 和 Code Execution 的价格均为每 1,000 次调用 $5。因此,评估日志需要记录响应中的用量和工具费用,不能只根据提示词长度估算。
此前的 Grok 4.5 评测解释了为什么 200K 门槛在长智能体循环中至关重要。同样的原则也适用于这里:及时压缩过时的历史记录,避免请求的 token 费率在不知不觉中翻倍。
胜者:只有有效交付率提高时,才是 Grok 4.7。 如果两款模型的通过率相同,Grok 4.6 因无需迁移而胜出。如果 4.7 能解决那些原本需要重试或人工修复的失败,它相同的 token 费率就会转化为经济优势。
切换成本来自运维,而不是合同
Grok 4.6 在稳定性这一项胜出,因为维持现状无需任何配置成本。Grok 4.7 则必须用收益覆盖行为验证、可观测性更新和安全回滚路径的投入。
更改模型 ID 前,请保留以下控制条件:
- 完全相同的提示词、系统策略、工具 schema、代码仓库快照、超时与重试策略。
- Schema 验证器、测试、lint、构建命令,以及所有人工验收清单。
- 每次尝试的新输入、缓存输入、推理、输出、工具调用和耗时记录,并分别统计。
- 重试或回滚前已经完成的副作用记录。重放一个只完成了部分步骤的任务,可能造成重复操作。
- 将旧模型 ID 保存在配置中,而不是埋进代码,以便单项工作负载无需回滚其他改动就能返回 4.6。
提示词兼容不等于行为兼容。结构化输出的 schema 可能仍能解析,却缺失必填字段;编程智能体可能调用同样的工具,却在测试之前停下;研究智能体也可能通过跳过验证来更快结束。即使 HTTP 请求成功,这些仍然属于回归问题。
Grok 4.7 的主要局限是证据无法直接迁移:xAI 的图表和一次浏览器重建,并不能说明它在你的代码仓库中会如何表现。Grok 4.6 的局限则正好相反:已知的稳定性无法解决它反复失败的那类任务。合理的分工,是保留已知基线,把更难的任务队列交给候选模型。
升级 Grok 4.6 前,先完成这项三任务测试
在候选模型获得生产流量前,应先让它在同一代码仓库的干净副本中通过三项小任务。这是小型工作流检查,不是通用基准。两款模型都使用 high 推理强度,其他控制条件保持完全一致;任何 4.7 xHigh 运行都应视为独立实验。
固定三项验收测试
从同一代码仓库中选择一个曾经修复的 bug、一项小型跨文件功能和一次依赖迁移。在两款模型看到任务前先定义成功标准:目标回归测试通过、完整测试套件保持绿色、lint 与构建完成、指定文件发生预期改动,而且无关行为不受影响。
每次尝试都使用干净副本
每组模型与任务的组合,都从干净工作副本中的同一 commit 开始。给两款模型相同的提示词、文件、工具、权限、超时和重试额度。不要让任何一款模型继承另一款模型的补丁或解释。
先运行共同档位
调用
grok-4.7和grok-4.6,推理强度设为high。记录返回的模型 ID、通过或失败、耗时、新输入与缓存输入、推理与输出用量、工具费用和计费金额。所有失败都必须保留在结果中。只有作为单独标记的试验时,才以xhigh运行 4.7。按任务类型升级
比较有效交付、耗时与总账单。只迁移 4.7 胜出的任务类型,保留 4.6 作为回滚值,并在提示词、工具或模型变化后重复检查。如果监控混合部署的成本低于实测收益,同时使用两款模型完全合理。
周一就可以这样开始:复现一个已知 bug,从上个月的工作中选一项跨文件功能和一次依赖更新。下周在干净副本中,让两款模型以 High 分别运行这三项任务;在内部结果表中公开每一次失败,只迁移那些在有效交付、耗时和实际账单上足以证明升级合理的任务类型。
常见问题
Grok 哪个版本最好用?
Grok 4.7 是 xAI 当前针对代码和通用工作的推荐选择。对于已经能够稳定完成的流程,在 4.7 赢得配对工作负载测试前,Grok 4.6 仍是更稳妥的运维选择。
Grok 4.6 好用吗?
好用。它拥有与 4.7 相同的 500,000-token 上下文窗口、核心工具能力、推理档位和标准 API 费率。其弱点是在 xAI 报告的最高难度编程与知识工作对比中表现较低。
目前最强的 Grok 模型是什么?
xAI 称 Grok 4.7 是其处理代码及其他任务能力最强的模型。因此它应成为优先评估的候选,但这并不能证明它在每个已经部署的工作流中都胜过 4.6。
Grok 有哪些版本?
xAI 除了通用的 Grok 模型,还维护专用的图像、视频和语音模型。针对这次编程与知识工作的决策,相关的文档模型 ID 是 grok-4.7 和 grok-4.6;不断变化的完整列表应以实时模型目录为准。
有比 Grok 更好的模型吗?
没有任何模型能在所有代码仓库、工具配置、延迟目标和质量门槛下都做到最好。应在相同任务和控制条件下,按单位成本的有效交付比较不同供应商,而不是把厂商基准当成通用排名。
Grok 的推理档位有哪些?
Grok 4.7 和 Grok 4.6 的推理强度档位为 low、medium、high 和 xhigh。默认值是 high,而且推理无法关闭。
Grok 有 18+ 模式吗?
这是消费级产品与安全模式的问题,不是这两个 API 模型 ID 之间的能力差异,不应成为 Grok 4.7 与 Grok 4.6 编程迁移的决策依据。
Grok 每月多少钱?
本文比较的 API 用量按 token 和可选工具调用计费,并非每款模型收取固定月费。消费级订阅、免费访问和 Grok Build 套餐的最新信息请参阅 Grok 免费吗?。
Grok 的全部模型有哪些?
随着 xAI 增加或淘汰模型变体,完整列表会不断变化,因此应以其实时目录为准。针对编程和通用知识工作,xAI 目前建议用户选择 Grok 4.7。
想直接拿到一套现成的编程智能体评估方案?订阅邮件简报,获取 Claude Code + Codex 配置清单。
- 发布日期
- 分类
- AI
- 语言
AI PPT 工具怎么选?2026 年 Gamma 替代方案对比
正在寻找 Gamma 替代品?本文按团队品牌统一、客户可编辑交付、融资路演和现场演示等需求,对比 Beautiful.ai、Plus AI、Prezi 等 AI PPT 工具,说明免费套餐、美元价格、AI 额度与导出限制。结合完整交付流程和团队成本,判断何时值得换工具,何时继续用 Gamma 更合适。2026年10月11日AI
Reflection AI Beam 值得换吗?编程模型选型与部署前要核实的事
Reflection AI Beam 是否值得成为你的下一个 AI 编程模型?本文梳理 10 月权重发布计划、Beta 申请与 API 试用流程,解读官方基准成绩和效率估算,并用存储计算与迁移预算说明自部署的判断依据,帮助开发者、运维负责人和 CTO 安排验收测试,在保持现有服务运行的同时,判断何时值得切换。2026年10月10日AI
Claude Google Workspace 使用指南:安装、审批与团队试点
Claude Google Workspace 公测版可在 Docs、Sheets 和 Slides 中改写文档、清洗数据和制作演示文稿。了解付费套餐要求、安装部署、编辑审批与独立连接器设置,通过三项带验收步骤的试点任务,核对数据、权限与返工耗时,并与现有 Gemini 能力比较,再决定是否扩大部署。2026年10月10日AI
Claude 仪表盘怎么用:Dashboards 测试版设置与销售数据核验
Claude Dashboards 测试版如何接入公司数据、生成可核验的销售仪表盘?本文梳理套餐费用、连接器配置、SQL 检查与分享权限,并用按地区统计已赢单商机金额的示例,说明如何核对日期、币种、重复记录和刷新时间,判断何时适合试点,何时应继续使用现有 BI 工具,避免把销售金额误当作会计收入。2026年10月10日AI
Granola AI 评测:价格、用法与会议笔记的局限
Granola AI 适合商务会议吗?本文依据官方文档,梳理无须机器人入会的笔记流程、模板、Recipes、集成与各方案价格,说明桌面端和手机端的功能差异、录音限制、隐私与同意要求,并对比 Krisp、MeetGeek、Circleback 和 Claap,帮助创业者、销售人员与顾问判断是否值得付费。2026年10月10日AI
Fyxer 评测:AI 邮件助手值不值得买?价格、隐私与替代方案
Fyxer 评测:从公开文档出发,解析这款 AI 邮件助手在 Gmail 和 Outlook 中的自动分类、回复草稿、会议纪要与日程安排。逐项梳理 Pro、Team 的美元价格、试用和积分限制,说明数据训练、删除政策与团队权限,再对照 SaneBox、Gemini 和 Copilot,判断哪些工作值得额外付费。2026年10月9日AI
GPT-6 全解析:模型怎么选、何时发布、在哪用、多少钱
GPT-6 家族的 Astra、Sol、6.1 Sol 和 Luna 有何区别?本文梳理各模型发布时间、ChatGPT 套餐对应的使用权限,以及 Work、Codex 和 API 的开放范围,列出美元计价的 API 费率,并用任务预算示例说明缓存、重试与模型升级如何影响总成本,帮助你按实际工作需求选择模型。2026年10月9日AI