Grok API: confronto tra Grok 4.7 e Grok 4.6
Grok API, confronto tra Grok 4.7 e 4.6: benchmark, prezzi, limiti e un test in tre attività per scegliere il modello giusto senza migrazioni alla cieca.


Grok API: scegliere tra Grok 4.7 e Grok 4.6 è una decisione di valutazione, non di prezzo: entrambi partono da $2 per milione di token in input e $6 per milione di token in output. Affidate a Grok 4.7 i nuovi lavori complessi di programmazione e knowledge work; mantenete su Grok 4.6 i flussi già collaudati finché 4.7 non prevale per lavoro portato a termine, tempo impiegato e costo finale.
Grok API: meglio Grok 4.7 o Grok 4.6?
Scegliete Grok 4.7 per le attività in cui Grok 4.6 si ferma prima del dovuto, trascura una dipendenza tra file o richiede correzioni ripetute. Mantenete Grok 4.6 nei flussi di produzione che superano già i controlli rispettando il budget. Un modello più recente merita una quota di traffico da valutare, non una migrazione indiscriminata di tutti i carichi.
Il primo passo cambia quindi in base a chi deve decidere:
- Un founder che ha raccolto capitali e ha una funzionalità di prodotto bloccata dovrebbe provare Grok 4.7 proprio su quella funzionalità, perché i miglioramenti più marcati dichiarati da xAI riguardano lavori difficili e prolungati.
- Il CTO di un'azienda di medie dimensioni dovrebbe lasciare in pace le automazioni Grok 4.6 che funzionano e indirizzare le classi di attività fallite verso una valutazione controllata di 4.7.
- Un professionista senior che produce ricerche, documenti o presentazioni dovrebbe confrontare gli elaborati accettati, non la brillantezza della prosa.
- Uno sviluppatore tecnico indipendente dovrebbe usare 4.7 per affrontare il problema che 4.6 non è riuscito a completare, promuovendolo solo se il risultato supera gli stessi test.
La scelta va fatta per singolo carico di lavoro. Un'azienda può ragionevolmente usare 4.7 per le attività su repository e mantenere 4.6 per un flusso stabile di estrazione o classificazione. Il routing aggiuntivo ha senso solo quando il vantaggio misurato supera la complessità operativa.
Grok 4.7 è davvero migliore?
Sì, alla luce dei dati su programmazione complessa e lavoro professionale pubblicati da xAI il 21 settembre 2026. No, se la domanda è se debba sostituire automaticamente ogni implementazione di Grok 4.6. Le evidenze giustificano una valutazione, ma le diverse impostazioni di ragionamento impediscono di dimostrare un miglioramento universale.
Grok 4.7 nella programmazione
Vincitore: Grok 4.7, con la cautela dovuta a un benchmark del provider. Nel confronto pubblicato da xAI insieme al modello, Grok 4.7 con xHigh ha ottenuto il 46.3% su CursorBench 4.0, contro il 40.4% di Grok 4.6 con High: un vantaggio di 5.9 punti percentuali. Su Terminal-Bench 4.0, i due modelli hanno totalizzato rispettivamente 38.0% e 20.3%, con un divario di 17.7 punti. Su EEBench il risultato è stato 64.0% contro 53.0%, pari a 11 punti di vantaggio.
Sono differenze rilevanti per le attività al centro del lancio: lavoro prolungato sui repository, uso del terminale e ingegneria. Restano però risultati dichiarati dal fornitore, e xAI ha assegnato a 4.7 l'impostazione xHigh, più profonda, mentre 4.6 ha lavorato in High. Più ragionamento può aumentare la qualità, ma anche i token di ragionamento e la latenza. Il grafico è un buon motivo per provare 4.7, non una stima controllata del miglioramento in produzione.
La tendenza è simile nel knowledge work. xAI dichiara un punteggio di 1,657 per Grok 4.7 contro 1,546 per Grok 4.6 su AA Briefcase v1.1, e di 1,695 contro 1,605 su GDPval. Nel test per agenti legali il risultato è 19.6% contro 15.8%, mentre su HealthBench Professional è 56.7% contro 48.5%. Tutti questi dati provengono dal confronto del 21 settembre, quindi non costruiscono un testa a testa fuorviante mescolando versioni diverse dei benchmark.
Non trasformate il titolo del lancio in una promessa di velocità. La pagina definisce Grok 4.7 due volte più veloce di modelli comparabili, ma nel testo precisa che la versione standard di Grok 4.7 viene erogata alla stessa velocità di Grok 4.6. L'opzione specifica con velocità di output 2× è un livello di servizio Fast separato e più costoso.
La conclusione, senza giri di parole, è che 4.7 si è guadagnato una prova sui compiti difficili. Non si è ancora guadagnato una migrazione alla cieca dell'intera infrastruttura.
Cosa non cambia: accesso, contesto, strumenti e ragionamento
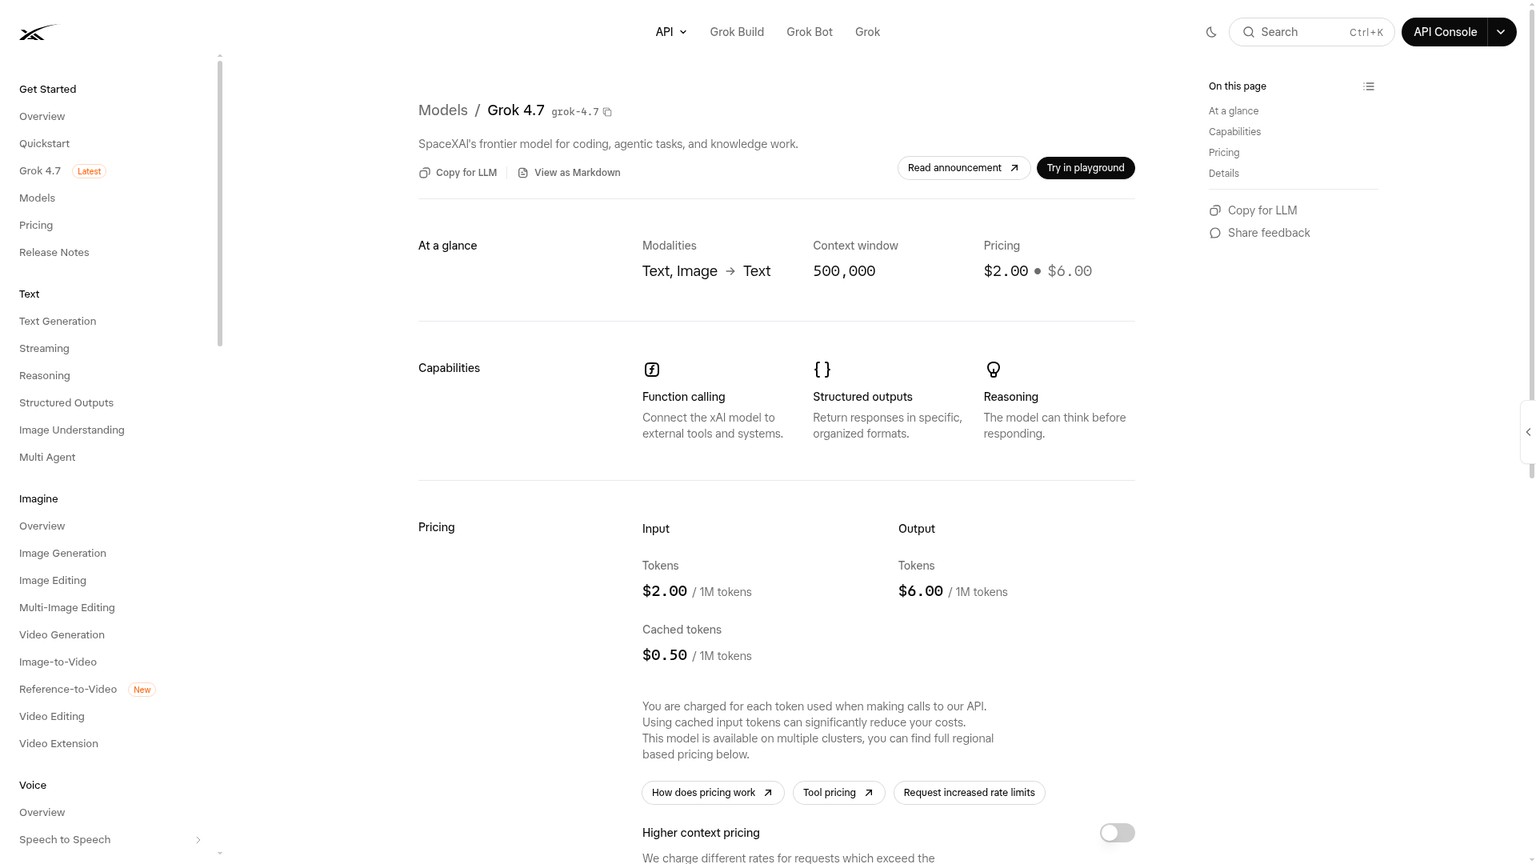
Grok 4.7 e Grok 4.6 espongono un'integrazione pressoché identica, quindi gran parte del rischio di migrazione riguarda il comportamento, non la struttura di base dell'API. Entrambi accettano testo e immagini, restituiscono testo, supportano function calling e output strutturati e offrono una finestra di contesto da 500,000 token.
Grok 4.7: l'attuale modello di punta
Grok 4.7 usa l'ID modello documentato grok-4.7. La pagina aggiornata del modello xAI lo presenta per programmazione, attività agentiche e knowledge work; secondo l'annuncio, è disponibile tramite l'API pubblica, Cursor, Grok Build, strumenti di programmazione di terze parti, router di modelli e piattaforme cloud.
Ideale per: programmazione complessa e knowledge work che 4.6 non riesce a completare.
Prezzi: $2 per l'input non memorizzato, $0.50 per l'input in cache e $6 per l'output per milione di token sotto 200K.
Limite dichiarato: nessun supporto Batch; inoltre, la variante Fast non è disponibile tramite l'API pubblica di xAI.
Da evitare quando: un flusso 4.6 già funzionante non presenta fallimenti costosi da risolvere.
Il comportamento nella Responses API presenta un dettaglio d'integrazione da verificare: Grok 4.7 restituisce sempre il contenuto di ragionamento cifrato, compresi gli output cifrati degli strumenti lato server. Il client può ignorare quel campo, ma se gestisce manualmente lo stato della conversazione deve conservare inalterati gli elementi di ragionamento quando la continuità è importante.
Grok 4.6: la baseline documentata
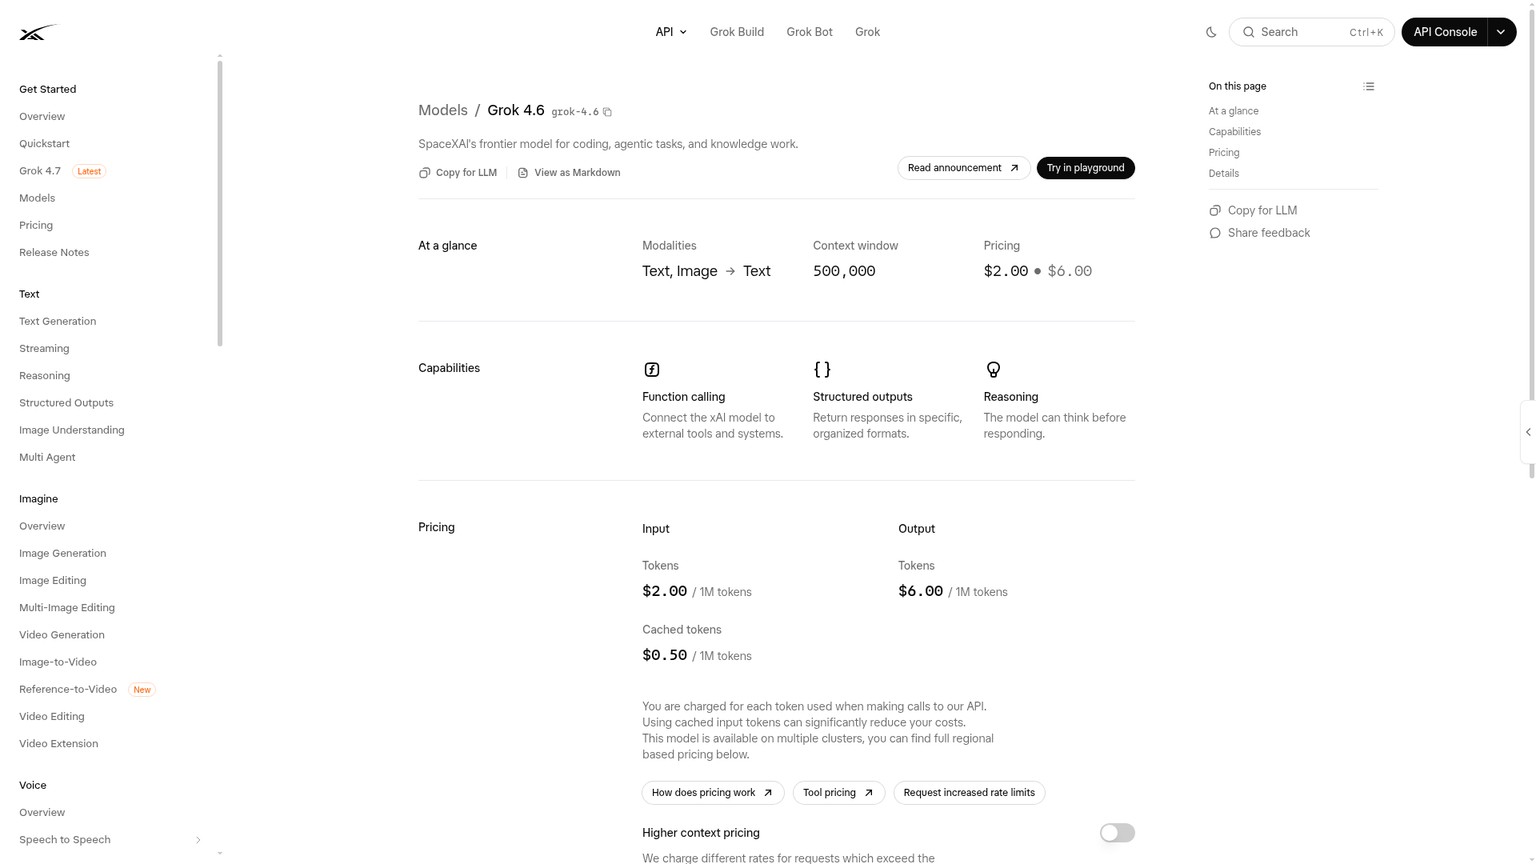
Grok 4.6 resta disponibile con l'ID grok-4.6. La sua pagina attuale del modello documenta ancora la stessa finestra da 500,000 token, le stesse modalità di input e output e le stesse funzionalità principali per function calling, output strutturati e ragionamento.
Ideale per: flussi stabili che superano già un criterio di accettazione definito.
Prezzi: $2 per l'input non memorizzato, $0.50 per l'input in cache e $6 per l'output per milione di token sotto 200K.
Limite dichiarato: punteggi inferiori nei confronti xAI più recenti sui compiti difficili, senza alcuno sconto sulla tariffa per chi resta al modello precedente.
Da evitare quando: il costo del lavoro lasciato ripetutamente incompleto supera già quello di una migrazione controllata.
Entrambi i modelli supportano i livelli di reasoning effort low, medium, high e xhigh. La documentazione xAI sul ragionamento imposta high come valore predefinito e specifica che il ragionamento non può essere disattivato. L'impostazione condivisa high è il punto di partenza corretto per un confronto a parità di condizioni. Un'esecuzione di 4.7 in xHigh va trattata separatamente, perché modifica allo stesso tempo qualità, budget di token e latenza.
Vincitore: parità per la compatibilità dell'interfaccia, Grok 4.7 per l'attuale raccomandazione del fornitore. La superficie familiare riduce il lavoro di migrazione, ma parametri compatibili non garantiscono scelte degli strumenti, schemi di output, comportamento di arresto o strategie di retry compatibili.
Quanto costa Grok API: stesse tariffe, costi diversi per attività
Grok 4.7 e Grok 4.6 hanno tariffe pubbliche per token identiche, verificate sulla pagina aggiornata dei prezzi xAI il 21 settembre 2026. Sotto 200,000 token nel prompt, entrambi costano $0.002 per 1K token di input non memorizzati, $0.0005 per 1K token di input in cache e $0.006 per 1K token di output.
A partire da 200,000 token nel prompt, ogni token della richiesta passa alla tariffa per contesti lunghi: $0.004 per 1K token di input non memorizzati, $0.001 per 1K token di input in cache e $0.012 per 1K token di output. Una finestra da 500,000 token indica una capacità, non autorizza a trascinare senza limiti e a basso costo l'intera cronologia di un agente.
Le righe mostrano calcoli esatti sui token, non esecuzioni osservate dei modelli. Isolano il contatore dei prezzi, lasciando che sia il comportamento a decidere il confronto.
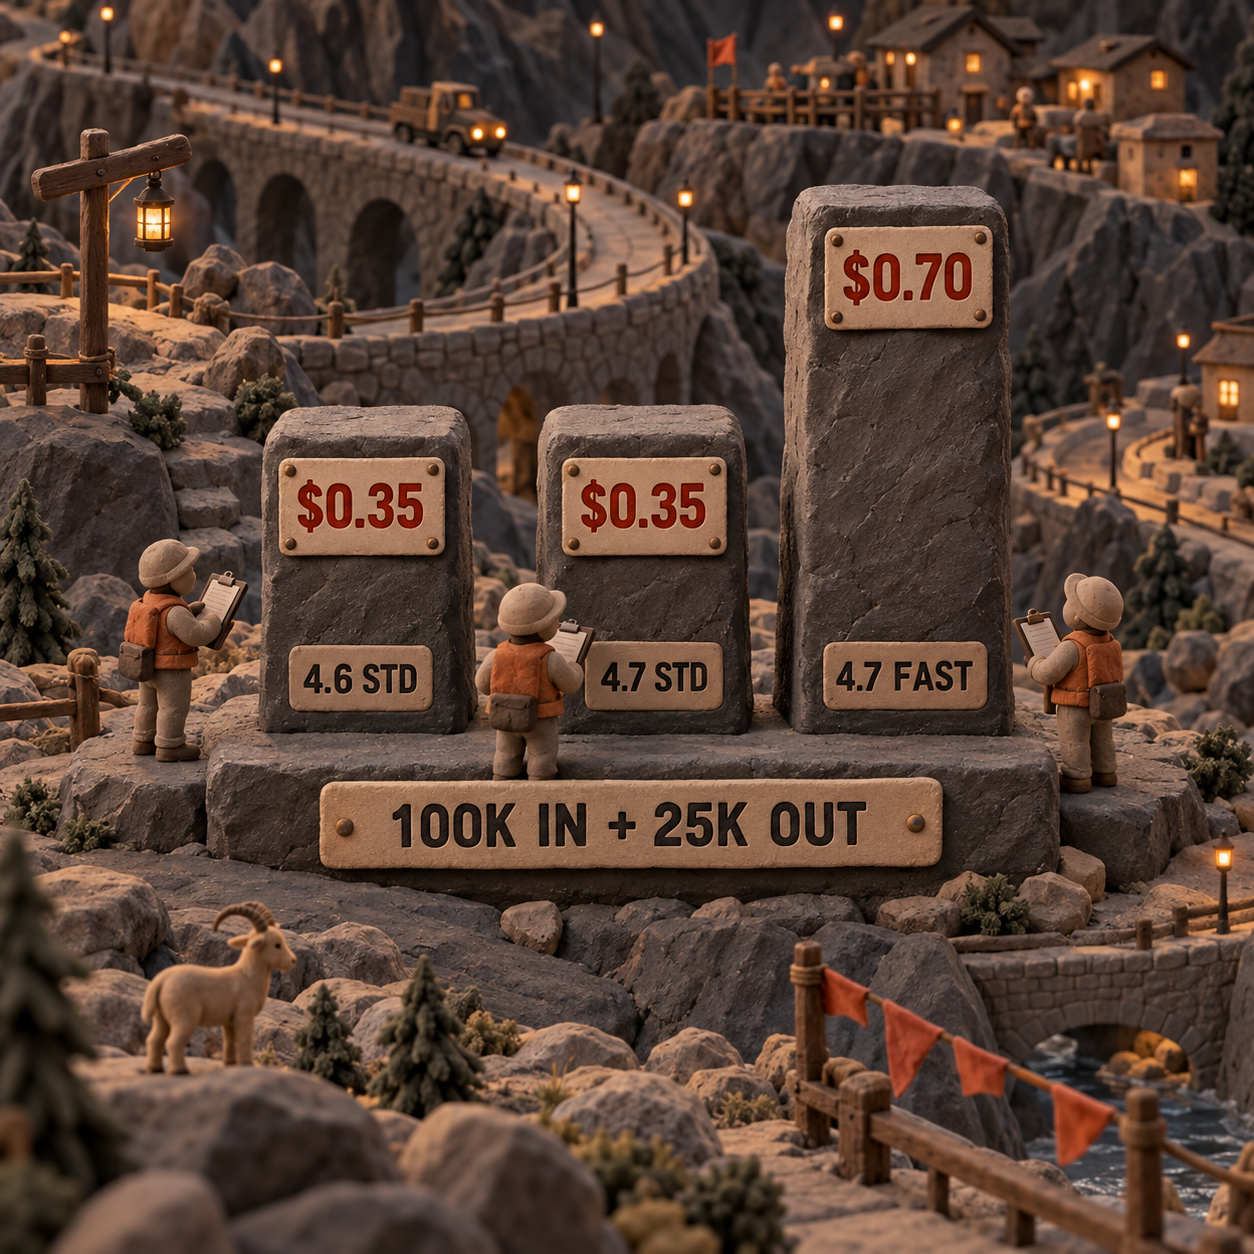
Non esiste un punto di pareggio tra le tariffe per token di questi modelli. Il vero discrimine è il lavoro completato:
cost per accepted task = total billed cost across all attempts / accepted tasks
Se entrambi i modelli consumano gli stessi token fatturati per tentativo, qualsiasi aumento del tasso di attività accettate rende 4.7 più economico per lavoro completato. Se 4.7 spende di più perché ragiona più a lungo, deve migliorare il tasso di accettazione in misura superiore all'aumento della spesa. Prezzi di listino uguali non proteggono dal costo aggiuntivo di ragionamento, retry, cicli di strumenti o output prolissi.
Le opzioni Fast e Priority richiedono budget separati:
- Grok 4.7 Fast sotto 200,000 token nel prompt costa $4 per l'input, $1 per l'input in cache e $12 per l'output per milione di token. L'esempio con 100K token in input e 25K in output costa quindi $0.70.
- Grok 4.7 Fast è disponibile solo tramite Cursor e Grok Build, non attraverso l'API pubblica di xAI, e il piano gratuito di Grok Build non lo include.
- Sopra 200,000 token nel prompt, la tabella dettagliata Fast di xAI indica $6 per l'input, $1.50 per l'input in cache e $18 per l'output per milione. Usate questa tariffa pubblicata, invece di applicare un moltiplicatore indistinto.
- Il Priority Processing dell'API pubblica applica un sovrapprezzo di 2× quando la risposta conferma il livello di servizio Priority.
Al momento, nessuno dei due modelli supporta la Batch API. I token di ragionamento concorrono al consumo e gli strumenti dell'API pubblica aggiungono un altro contatore. Web Search e Code Execution costano ciascuno $5 ogni 1,000 chiamate. Per questo il registro di valutazione deve acquisire dalla risposta l'utilizzo e gli addebiti degli strumenti, non ricavarli con una stima basata solo sulla lunghezza del prompt.
La precedente recensione di Grok 4.5 spiega perché questa soglia di 200K conta nei cicli agentici lunghi. La lezione resta valida: compattate la cronologia obsoleta prima che raddoppi silenziosamente le tariffe della richiesta.
Vincitore: Grok 4.7 solo se aumenta la resa del lavoro completato. Se entrambi superano i controlli con la stessa frequenza, vince Grok 4.6 perché evita il lavoro di migrazione. Se 4.7 risolve fallimenti che altrimenti richiedono retry o interventi umani, le tariffe per token identiche diventano un vantaggio economico.
Il costo del passaggio è operativo, non contrattuale
Grok 4.6 vince sul piano della stabilità, perché restare sul modello attuale non comporta alcun costo di configurazione. Grok 4.7 deve ripagare il lavoro necessario per validarne il comportamento, aggiornare l'osservabilità e mantenere un percorso di rollback sicuro.
Prima di cambiare l'ID del modello, conservate questi controlli:
- Lo stesso prompt, la policy di sistema, gli schemi degli strumenti, lo snapshot del repository, il timeout e la policy di retry.
- Validatori di schema, test, lint, comandi di build ed eventuali checklist di accettazione umana.
- Registrazioni separate per input non memorizzato, input in cache, ragionamento, output, chiamate agli strumenti e tempo trascorso per ogni tentativo.
- Un registro degli effetti collaterali già prodotti prima di un retry o di un rollback. Rieseguire un'attività completata solo in parte può duplicare un'azione.
- L'ID del vecchio modello nella configurazione, anziché incorporato nel codice, così da poter riportare un singolo carico a 4.6 senza annullare modifiche estranee.
La compatibilità dei prompt non equivale alla compatibilità del comportamento. Uno schema di output strutturato può continuare a essere valido pur perdendo un campo obbligatorio. Un agente di programmazione può chiamare gli stessi strumenti ma fermarsi prima dei test. Un agente di ricerca può finire prima saltando le verifiche. Sono tutte regressioni, anche quando la richiesta HTTP va a buon fine.
Il limite principale di Grok 4.7 riguarda la trasferibilità delle evidenze: il grafico di xAI e la ricostruzione di un singolo browser non rivelano come si comporterà nel vostro repository. Il limite di Grok 4.6 è l'opposto: la stabilità già nota non risolve una classe di attività che continua a fallire. La ripartizione corretta mantiene la baseline conosciuta e assegna al candidato la coda più difficile.
Passate da Grok 4.6 a 4.7 solo dopo questo test su tre attività
Prima di ricevere traffico di produzione, l'upgrade dovrebbe superare tre piccole attività in copie pulite dello stesso repository. È una verifica circoscritta del flusso, non un benchmark generale. Usate il livello di ragionamento high per entrambi i modelli, mantenete identico ogni altro controllo e trattate qualsiasi esecuzione di 4.7 in xHigh come esperimento separato.
Bloccate tre test di accettazione
Usate un bug già corretto in passato, una piccola funzionalità che coinvolge più file e una migrazione di dipendenza nello stesso repository. Definite il successo prima di mostrare l'attività ai modelli: la regressione interessata deve essere risolta, l'intera suite di test deve restare verde, lint e build devono completarsi, i file richiesti devono cambiare e il comportamento non correlato deve restare invariato.
Create copie pulite per ogni tentativo
Avviate ogni coppia modello-attività dallo stesso commit, in una copia di lavoro pulita. Fornite ai due modelli gli stessi prompt, file, strumenti, permessi, timeout e numero di retry. Un modello non deve ereditare la patch o la spiegazione dell'altro.
Partite dall'impostazione comune
Eseguite
grok-4.7egrok-4.6conhigh. Registrate l'ID modello restituito, l'esito, il tempo trascorso, l'input non memorizzato e quello in cache, l'uso per ragionamento e output, gli addebiti degli strumenti e l'importo fatturato. Conservate ogni fallimento nei risultati. Eseguite 4.7 conxhighsoltanto come prova separata e chiaramente etichettata.Promuovete per classe di attività
Confrontate il lavoro accettato, il tempo trascorso e il costo totale. Spostate solo la classe in cui vince 4.7, mantenete 4.6 come valore di rollback e ripetete il controllo dopo ogni modifica a prompt, strumenti o modello. Una distribuzione mista è valida quando il relativo costo di monitoraggio resta inferiore al beneficio misurato.
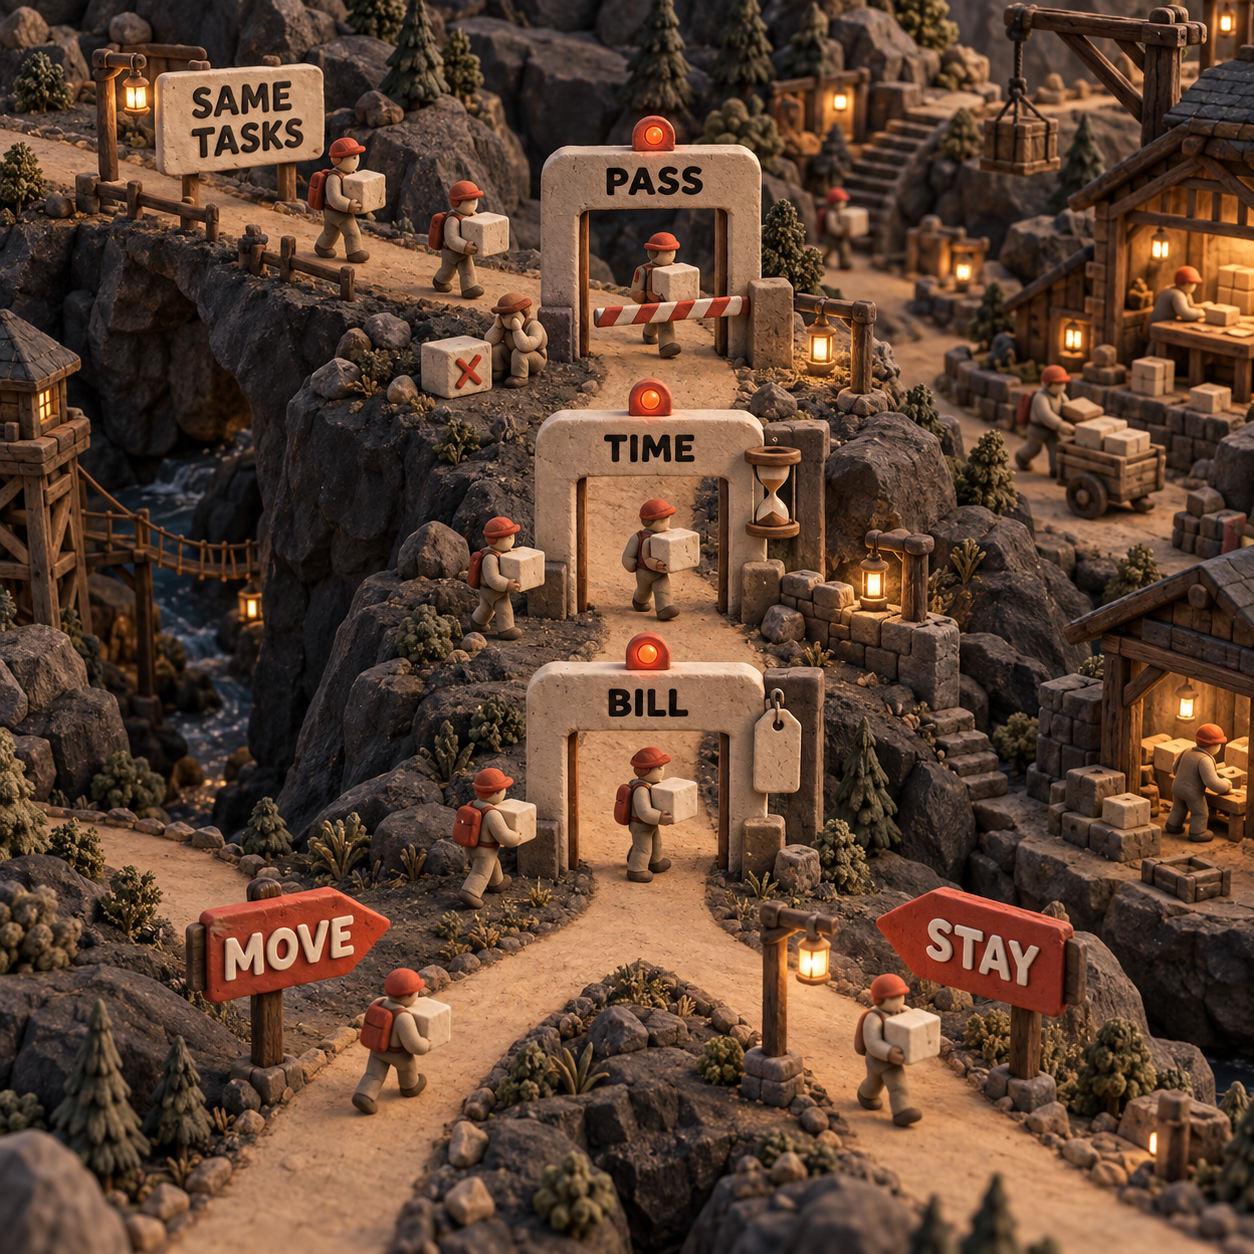
La prossima mossa del lunedì è concreta: ripristinate un bug noto, scegliete una funzionalità tra più file e individuate un aggiornamento di dipendenza tra i lavori del mese scorso. La settimana prossima eseguite queste tre attività in High su copie pulite, riportate ogni fallimento nel foglio interno dei risultati e spostate soltanto la classe di attività per cui lavoro completato, tempo effettivo e costo reale giustificano il cambiamento.
Domande frequenti
Qual è la versione migliore di Grok?
Grok 4.7 è la versione attualmente consigliata da xAI per la programmazione e l'uso generale. Grok 4.6 resta la scelta operativa migliore per un flusso che completa già in modo affidabile, finché 4.7 non prevale in un test comparativo sul carico reale.
Grok 4.6 è valido?
Sì. Offre la stessa finestra di contesto documentata da 500,000 token, le stesse funzionalità principali per gli strumenti, gli stessi livelli di ragionamento e le stesse tariffe API standard di 4.7. Il suo punto debole sono le prestazioni inferiori dichiarate da xAI nei confronti più impegnativi su programmazione e knowledge work.
Qual è oggi il miglior modello Grok?
xAI definisce Grok 4.7 il suo modello più capace per la programmazione e tutto il resto. Questo lo rende il primo candidato da valutare, non dimostra che superi 4.6 in ogni flusso già implementato.
Quali sono le diverse versioni di Grok?
xAI mantiene modelli Grok general purpose e modelli specializzati per immagini, video e voce. Per questa decisione su programmazione e knowledge work, gli ID documentati rilevanti sono grok-4.7 e grok-4.6; per l'elenco completo, che cambia nel tempo, va consultato il catalogo aggiornato dei modelli.
Esiste qualcosa di migliore di Grok?
Nessun modello è il migliore per ogni repository, configurazione degli strumenti, obiettivo di latenza e soglia di qualità. Confrontate i provider in base al lavoro accettato per ogni dollaro, usando le stesse attività e gli stessi controlli, anziché considerare un benchmark del fornitore una classifica universale.
Quali sono i livelli di Grok?
Per Grok 4.7 e Grok 4.6, i livelli di reasoning effort sono low, medium, high e xhigh. Il valore predefinito è high e il ragionamento non può essere disattivato.
Grok offre una modalità 18+?
È una domanda sul prodotto consumer e sulle modalità di sicurezza, non una differenza di capacità tra questi due ID modello API. Non dovrebbe influire su una migrazione di programmazione da Grok 4.6 a Grok 4.7.
Quanto costa Grok al mese?
Per l'uso via API confrontato qui, il costo dipende dai token e dalle eventuali chiamate agli strumenti, non da un canone mensile fisso per modello. Abbonamenti consumer, accesso gratuito e piani Grok Build sono aggiornati in Grok è gratis?.
Quali sono tutti i modelli Grok?
L'elenco completo cambia quando xAI aggiunge o ritira varianti, quindi il suo catalogo aggiornato è la fonte ufficiale. Per la programmazione e il knowledge work generale, xAI indirizza attualmente gli utenti verso Grok 4.7.
Volete una configurazione pronta per valutare gli agenti di programmazione? Ricevete con la newsletter la checklist per configurare Claude Code + Codex.
- Ultimo aggiornamento
- 21 set 2026
- Categoria
- AI
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Agenti AI in produzione: quando le metriche premiano il fallimento
Un caso reale mostra come gli agenti AI possano superare ogni controllo e mancare l’obiettivo: numeri, cause e guardrail per fermare la deriva.21 set 2026AI
StepFun Step 5 Preview: prezzi API, piani e costi reali
Prezzi API, cache, Crediti e piani di StepFun Step 5 Preview: tariffe verificate, esempi di costo e criteri per scegliere il canale corretto.21 set 2026AI
Ricerca con intelligenza artificiale: Nouswise alla prova
Recensione di Nouswise per la ricerca con intelligenza artificiale: citazioni, progetti, API, limiti e prezzi da verificare prima dell’acquisto.10 set 2026AI
Intelligenza artificiale edilizia: i migliori software per verificare i submittal
Intelligenza artificiale edilizia: confronto tra BuildSync, Part3, Nomic, InspectMind e SpecLens per verificare i submittal rispetto ai capitolati.9 set 2026AI
ScribbleVet o VetGeni? Il confronto su costi, PIMS e lavoro in team
Confronto tra ScribbleVet e VetGeni su prezzi, limiti SOAP, integrazioni PIMS, template e lavoro in team per scegliere lo scribe veterinario più adatto.8 set 2026AI
Intelligenza artificiale edilizia: InspectMind AI alla prova
Intelligenza artificiale edilizia alla prova: InspectMind AI controlla tavole e capitolati con fonti verificabili. Prezzi, limiti e criteri per valutarlo.8 set 2026AI
Intelligenza artificiale edilizia: meglio BuildSync o SpecLens?
Intelligenza artificiale edilizia: confronto tra BuildSync e SpecLens su submittal, capitolati, integrazioni, export, prezzi e limiti operativi.8 set 2026AI