Grok API Kosten im Vergleich: Grok 4.7 oder Grok 4.6?
Was Grok 4.7 besser kann, wo Grok 4.6 die sichere Wahl bleibt und warum identische API-Preise noch nichts über die tatsächlichen Aufgabenkosten sagen.


Bei Grok 4.7 und Grok 4.6 entscheiden nicht die Grok API Kosten über die Wahl: Beide starten bei $2 pro Million Eingabetoken und $6 pro Million Ausgabetoken. Neue, anspruchsvolle Programmier- und Wissensaufgaben gehören zunächst auf Grok 4.7; bewährte Abläufe mit Grok 4.6 sollten bleiben, bis 4.7 bei abgeschlossenen Aufgaben, Laufzeit und Endrechnung gewinnt.
Grok 4.7 oder Grok 4.6: Welches Modell passt?
Grok 4.7 empfiehlt sich für Aufgaben, bei denen Grok 4.6 vorzeitig abbricht, eine dateiübergreifende Abhängigkeit übersieht oder wiederholt korrigiert werden muss. Grok 4.6 sollte in einem Produktionsprozess bleiben, der seine Prüfungen zuverlässig und innerhalb des Budgets besteht. Ein neueres Modell ist ein Kandidat für echten Traffic – kein Grund, sämtliche Workloads sofort umzustellen.
Je nach Rolle ergibt sich daraus ein anderer erster Schritt:
- Ein finanzierter Gründer mit einem blockierten Produkt-Feature sollte Grok 4.7 gezielt an diesem Feature erproben, denn xAI meldet die größten Fortschritte bei schwieriger, länger laufender Arbeit.
- Ein CTO im Mittelstand sollte funktionierende Automatisierungen mit Grok 4.6 unangetastet lassen und gescheiterte Aufgabenklassen in eine kontrollierte 4.7-Evaluierung leiten.
- Wer als erfahrene Fachkraft Recherchen, Dokumente oder Präsentationen erstellt, sollte abgenommene Ergebnisse vergleichen – nicht den sprachlichen Feinschliff.
- Ein technischer Solo-Entwickler sollte 4.7 auf genau das Problem ansetzen, das 4.6 nicht lösen konnte, und es erst übernehmen, wenn das Ergebnis dieselben Tests besteht.
Die Entscheidung fällt auf Workload-Ebene. Ein Unternehmen kann 4.7 sinnvoll für Repository-Arbeit einsetzen und 4.6 für einen stabilen Extraktions- oder Klassifizierungsprozess behalten. Das zusätzliche Routing lohnt sich nur, wenn der gemessene Nutzen die operative Komplexität übersteigt.
Ist Grok 4.7 besser?
Für die von xAI am 21. September 2026 veröffentlichten Belege zu anspruchsvoller Programmier- und Facharbeit: ja. Als automatischer Ersatz für jede Grok-4.6-Installation: nein. Die Daten sprechen für eine Evaluierung; wegen der unterschiedlichen Reasoning-Einstellungen belegen sie jedoch kein allgemeingültiges Upgrade.
Grok 4.7 im Coding-Test
Gewinner: Grok 4.7, mit Vorbehalt zum Anbieterbenchmark. Im Vergleich derselben Veröffentlichung von xAI erzielte Grok 4.7 mit xHigh im CursorBench 4.0 einen Wert von 46.3%, Grok 4.6 mit High dagegen 40.4% – ein Vorsprung von 5.9 Prozentpunkten. Im Terminal-Bench 4.0 erreichten die beiden Modelle 38.0% beziehungsweise 20.3%, also einen Abstand von 17.7 Punkten. Beim EEBench standen 64.0% gegen 53.0%, ein Vorsprung von 11 Punkten.
Für die Aufgaben, die xAI zum Start hervorhebt – länger laufende Repository-Arbeit, Terminal-Bedienung und Engineering –, sind das deutliche Unterschiede. Trotzdem stammen die Ergebnisse vom Anbieter selbst, und xAI gab 4.7 die tiefere Einstellung xHigh, während 4.6 mit High lief. Mehr Reasoning kann die Qualität erhöhen, verursacht aber möglicherweise zusätzliche Reasoning-Token und mehr Latenz. Die Grafik ist deshalb ein Anlass, 4.7 zu testen, nicht eine kontrollierte Schätzung des eigenen Produktionsgewinns.
Bei Wissensarbeit zeigt sich dieselbe Richtung. xAI meldet im AA Briefcase v1.1 einen Wert von 1,657 für Grok 4.7 gegenüber 1,546 für Grok 4.6 und im GDPval 1,695 gegenüber 1,605. Beim Legal-Agent-Ergebnis stehen 19.6% gegen 15.8%, beim HealthBench Professional 56.7% gegen 48.5%. Alle Werte stammen aus dem Vergleich vom 21. September, sodass hier keine ältere Benchmark-Version zu einem vermeintlichen Direktvergleich vermischt wird.
Aus der Überschrift zum Launch darf kein Geschwindigkeitsversprechen werden. Die Seite bezeichnet Grok 4.7 als doppelt so schnell wie vergleichbare Modelle, erklärt im Text aber, dass das Standardmodell Grok 4.7 gleich schnell wie Grok 4.6 bereitgestellt wird. Die konkrete Option mit 2× Ausgabegeschwindigkeit ist eine eigene, teurere Fast-Servicestufe.
Das klare Fazit: 4.7 hat sich den Test mit schwierigen Aufgaben verdient. Eine ungeprüfte Migration der gesamten Modellflotte hat es sich noch nicht verdient.
Was gleich bleibt: Zugriff, Kontext, Tools und Reasoning
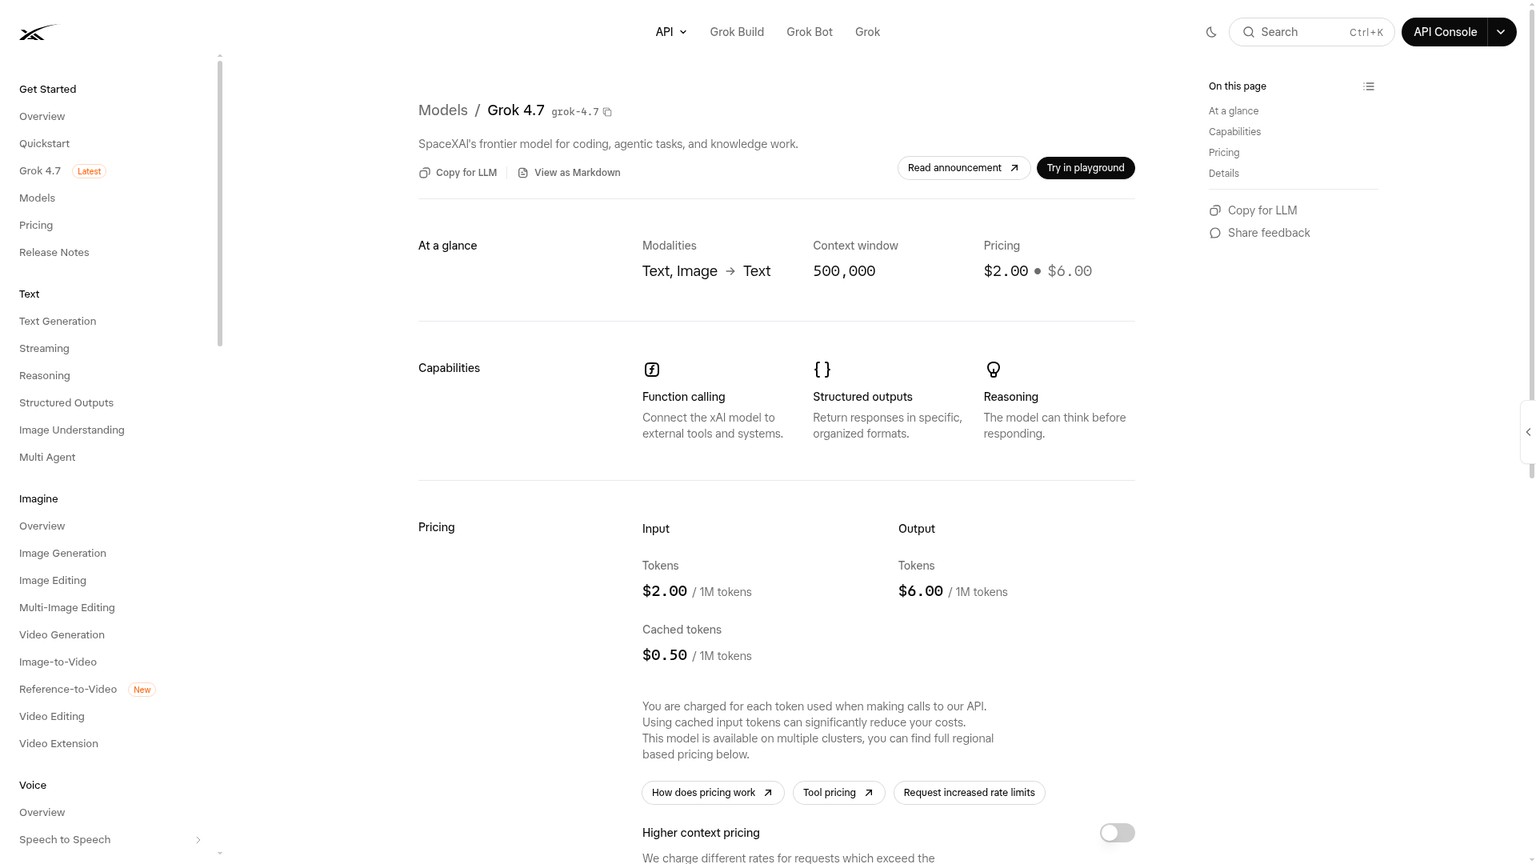
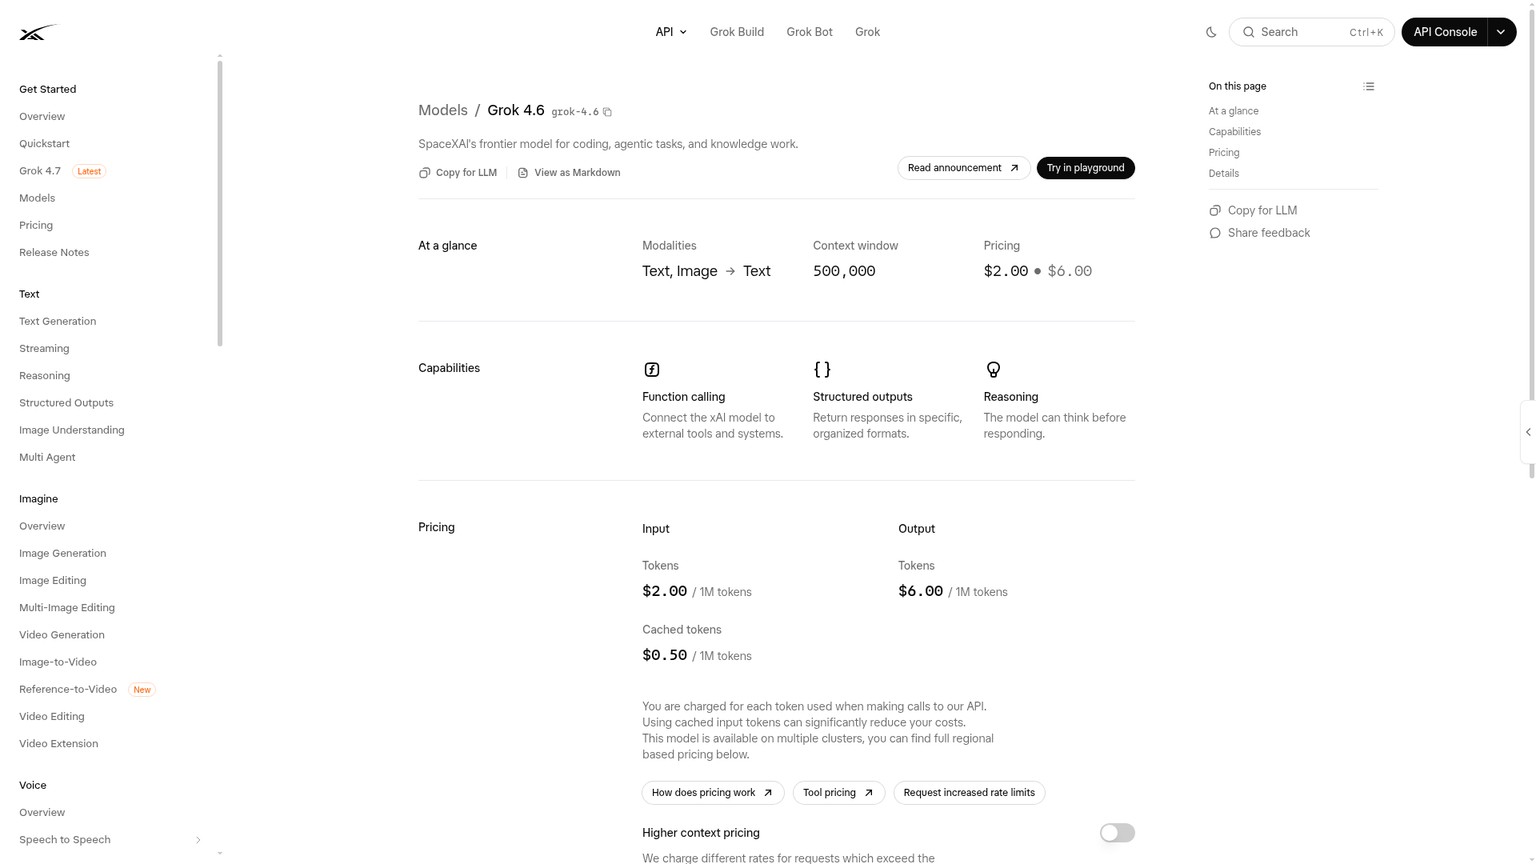
Grok 4.7 und Grok 4.6 bieten nahezu dieselbe Integrationsoberfläche. Das Migrationsrisiko liegt daher eher im Verhalten als in der grundlegenden API-Struktur. Beide verarbeiten Text und Bilder, geben Text aus, unterstützen Function Calling sowie strukturierte Ausgaben und besitzen ein Kontextfenster mit 500,000 Token.
Grok 4.7: das aktuelle Spitzenmodell
Grok 4.7 verwendet die dokumentierte Modell-ID grok-4.7. Die aktuelle Modellseite von xAI positioniert es für Coding, agentische Aufgaben und Wissensarbeit. Laut Ankündigung ist es über die öffentliche API, Cursor, Grok Build, Coding-Tools von Drittanbietern, Modellrouter und Cloud-Plattformen verfügbar.
Am besten geeignet für: schwierige Programmier- und Wissensarbeit, die 4.6 nicht abschließt.
Preise: $2 für neue Eingaben, $0.50 für Cache-Eingaben und $6 für Ausgaben pro Million Token unter 200K.
Genannte Einschränkung: keine Batch-Unterstützung; die Fast-Variante ist nicht über die öffentliche xAI API verfügbar.
Nicht einsetzen, wenn: ein funktionierender 4.6-Ablauf kein kostspieliges Problem verursacht, das gelöst werden müsste.
Beim Verhalten der Responses API gibt es ein Integrationsdetail, das geprüft werden sollte: Grok 4.7 gibt immer verschlüsselte Reasoning-Inhalte zurück, einschließlich verschlüsselter Ausgaben serverseitiger Tools. Ein Client kann dieses Feld ignorieren. Verwaltet er den Gesprächszustand jedoch manuell, sollte er die Reasoning-Elemente unverändert übernehmen, wenn Kontinuität wichtig ist.
Grok 4.6: die dokumentierte Ausgangsbasis
Grok 4.6 bleibt unter grok-4.6 verfügbar. Die aktuelle Modellseite dokumentiert weiterhin dasselbe Kontextfenster mit 500,000 Token, dieselben Ein- und Ausgabemodalitäten sowie dieselben grundlegenden Funktionen für Function Calling, strukturierte Ausgaben und Reasoning.
Am besten geeignet für: stabile Workflows, die bereits eine klar definierte Abnahmeprüfung bestehen.
Preise: $2 für neue Eingaben, $0.50 für Cache-Eingaben und $6 für Ausgaben pro Million Token unter 200K.
Genannte Einschränkung: niedrigere von xAI gemeldete Werte im aktuellen Vergleich schwieriger Aufgaben, ohne günstigeren Tokenpreis für das ältere Modell.
Nicht einsetzen, wenn: wiederholt unvollendete Arbeit bereits mehr kostet als eine kontrollierte Migration.
Beide Modelle unterstützen die Reasoning-Stufen low, medium, high und xhigh. In der Reasoning-Dokumentation von xAI ist high als Standard festgelegt; außerdem lässt sich Reasoning demnach nicht deaktivieren. Diese gemeinsame Einstellung high ist der faire Ausgangspunkt für einen Paralleltest. Ein Lauf von 4.7 mit xHigh gehört in eine eigene Testspur, weil damit gleichzeitig Qualitäts-, Token- und Latenzbudget verändert werden.
Gewinner: Gleichstand bei der Schnittstellenkompatibilität, Grok 4.7 bei der aktuellen Anbieterempfehlung. Die vertraute Oberfläche verringert den Migrationsaufwand. Kompatible Parameter garantieren jedoch weder identische Tool-Auswahl und Ausgabeschemata noch gleiches Abbruch- und Wiederholungsverhalten.
Grok API Kosten für Grok 4.7: gleiche Tarife, andere Aufgabenrechnungen
Grok 4.7 und Grok 4.6 haben identische öffentliche API-Tokentarife. Das wurde am 21. September 2026 anhand der aktuellen Preisseite von xAI geprüft. Unter 200,000 Prompt-Token kostet jedes Modell $0.002 pro 1K neue Eingabetoken, $0.0005 pro 1K Cache-Eingabetoken und $0.006 pro 1K Ausgabetoken.
Ab 200,000 Prompt-Token gilt für jedes Token der Anfrage der Langkontexttarif: $0.004 pro 1K neue Eingabetoken, $0.001 pro 1K Cache-Eingabetoken und $0.012 pro 1K Ausgabetoken. Ein Kontextfenster mit 500,000 Token schafft Kapazität – es ist keine Einladung, eine unbegrenzt wachsende Agentenhistorie günstig mitzuführen.
Die Tabellenzeilen beruhen auf exakter Tokenarithmetik, nicht auf beobachteten Modellläufen. Sie isolieren den Preismechanismus, damit das Verhalten den Vergleich entscheidet.
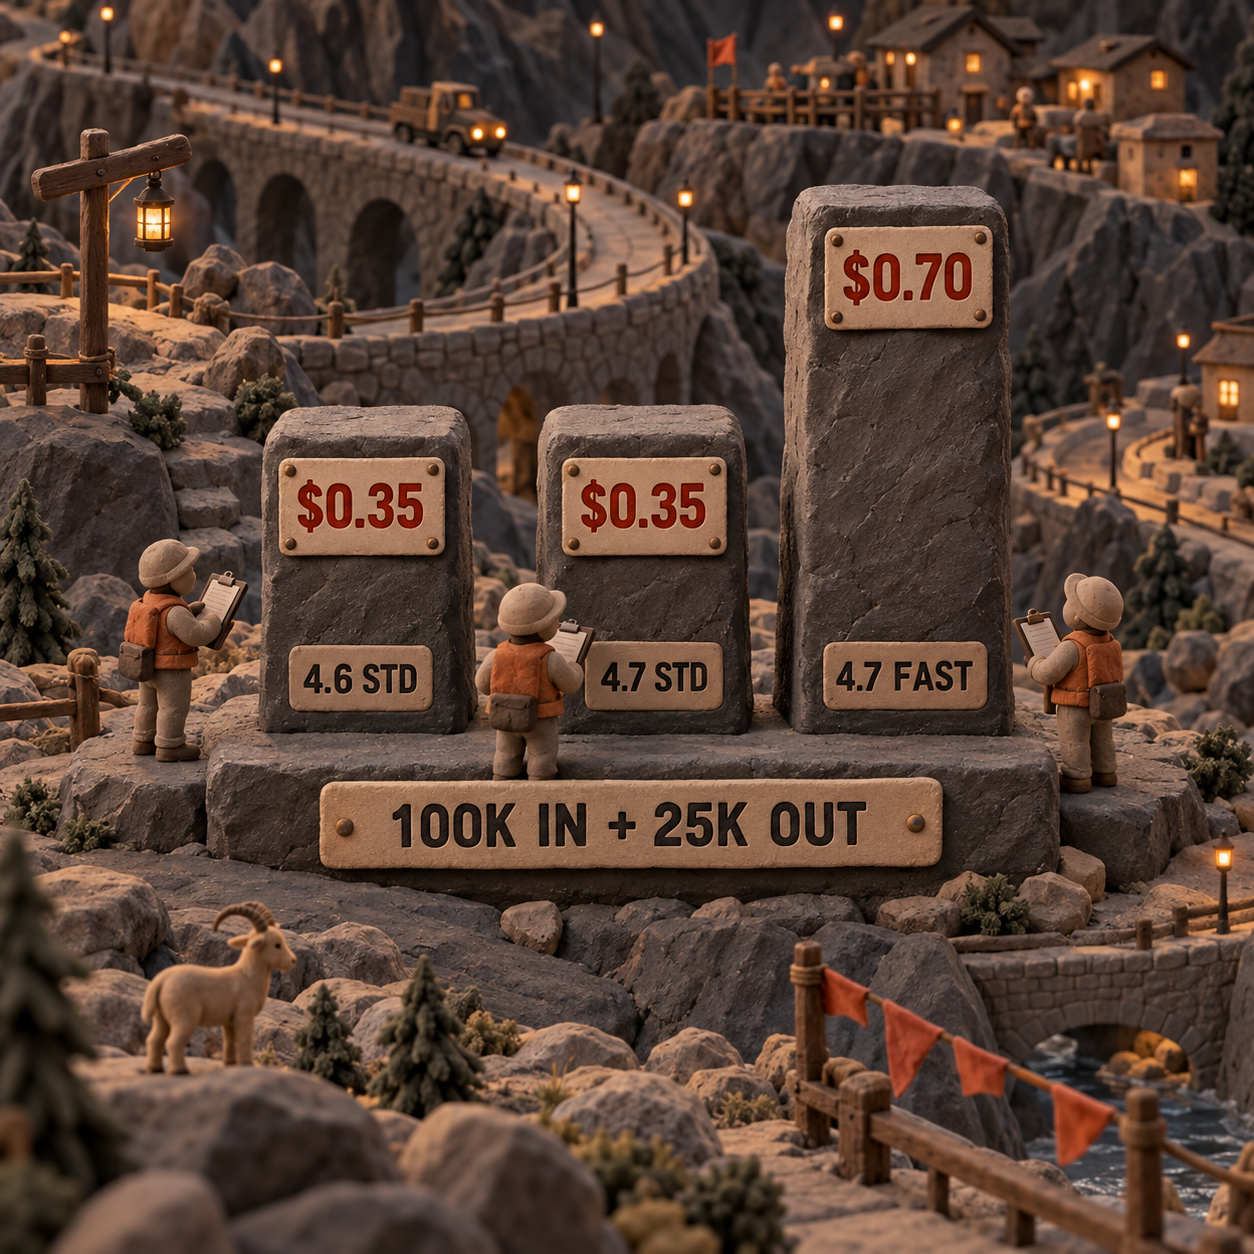
Zwischen diesen Modellen gibt es keinen Schnittpunkt bei den Tokentarifen. Entscheidend ist die abgeschlossene Arbeit:
cost per accepted task = total billed cost across all attempts / accepted tasks
Verbrauchen beide Modelle pro Versuch gleich viele abgerechnete Token, macht jede höhere Erfolgsquote 4.7 pro abgeschlossener Aufgabe günstiger. Gibt 4.7 wegen längeren Reasonings mehr aus, muss seine Quote abgenommener Aufgaben stärker steigen als die Ausgaben. Gleiche Listenpreise schützen nicht vor zusätzlichem Reasoning, Wiederholungen, Tool-Schleifen oder weitschweifigen Ausgaben.
Fast- und Priority-Optionen benötigen eigene Budgets:
- Grok 4.7 Fast kostet unter 200,000 Prompt-Token $4 für Eingaben, $1 für Cache-Eingaben und $12 für Ausgaben pro Million Token. Das Beispiel mit 100K Eingabe- und 25K Ausgabetoken kostet damit $0.70.
- Grok 4.7 Fast ist nur über Cursor und Grok Build verfügbar, nicht über die öffentliche xAI API. Im kostenlosen Tarif von Grok Build ist es ebenfalls nicht enthalten.
- Oberhalb von 200,000 Prompt-Token nennt die ausführliche Fast-Tabelle von xAI $6 für Eingaben, $1.50 für Cache-Eingaben und $18 für Ausgaben pro Million. Maßgeblich ist dieser veröffentlichte Tarifplan, nicht ein pauschaler Multiplikator.
- Für Priority Processing über die öffentliche API fällt ein Aufpreis von 2× an, wenn die Antwort die Priority-Servicestufe bestätigt.
Beide Modelle unterstützen derzeit keine Batch API. Reasoning-Token fließen in den Verbrauch ein, und öffentliche API-Tools werden zusätzlich abgerechnet. Web Search und Code Execution kosten jeweils $5 pro 1,000 Aufrufe. Deshalb gehören die Verbrauchsdaten und Tool-Kosten aus der Antwort ins Evaluierungsprotokoll – nicht nur eine Schätzung anhand der Prompt-Länge.
Der frühere Test von Grok 4.5 erklärt, warum diese 200K-Schwelle in langen Agentenschleifen relevant ist. Die Lehre gilt auch hier: Veraltete Historie sollte komprimiert werden, bevor sie unbemerkt die Tokentarife der Anfrage verdoppelt.
Gewinner: Grok 4.7 nur bei höherer Ausbeute abgeschlossener Arbeit. Bestehen beide Modelle mit derselben Quote, gewinnt Grok 4.6, weil kein Migrationsaufwand entsteht. Behebt 4.7 Fehler, die sonst Wiederholungen oder manuelle Nacharbeit erzwingen, werden seine gleichen Tokentarife zum wirtschaftlichen Vorteil.
Die Wechselkosten sind operativ, nicht vertraglich
In der Stabilitätskategorie gewinnt Grok 4.6, denn das Beibehalten des Modells erfordert keine neue Konfiguration. Grok 4.7 muss den Aufwand für die Verhaltensprüfung, die Anpassung der Beobachtbarkeit und einen sicheren Rollback-Pfad wieder einspielen.
Vor einem Wechsel der Modell-ID sollten diese Kontrollen erhalten bleiben:
- Der exakte Prompt, die Systemrichtlinie, Tool-Schemata, der Repository-Snapshot, das Zeitlimit und die Wiederholungsrichtlinie.
- Schemavalidierungen, Tests, Linting, Build-Befehle und jede Checkliste für die menschliche Abnahme.
- Getrennte Aufzeichnungen zu neuen Eingaben, Cache-Eingaben, Reasoning, Ausgaben, Tool-Aufrufen und Laufzeit für jeden Versuch.
- Ein Protokoll der Seiteneffekte, die vor einem erneuten Versuch oder Rollback bereits ausgeführt wurden. Das Wiederholen einer teilweise erledigten Aufgabe kann eine Aktion duplizieren.
- Die alte Modell-ID in der Konfiguration statt fest im Code, damit ein einzelner Workload zu 4.6 zurückkehren kann, ohne andere Änderungen rückgängig zu machen.
Prompt-Kompatibilität bedeutet nicht Verhaltenskompatibilität. Ein Schema für strukturierte Ausgaben kann sich weiterhin parsen lassen und trotzdem ein Pflichtfeld verlieren. Ein Coding-Agent kann dieselben Tools aufrufen, aber vor den Tests aufhören. Ein Recherche-Agent kann schneller fertig werden, indem er die Prüfung auslässt. Das sind Regressionen, auch wenn die HTTP-Anfrage erfolgreich war.
Die wichtigste Einschränkung von Grok 4.7 ist die Übertragbarkeit der Belege: Aus der Grafik von xAI und einem einzelnen Browser-Neubau lässt sich nicht ableiten, wie sich das Modell im eigenen Repository verhält. Grok 4.6 hat das umgekehrte Problem: Seine bekannte Stabilität löst keine Aufgabenklasse, an der es wiederholt scheitert. Die sinnvolle Aufteilung behält die bekannte Basis und gibt die schwierigere Warteschlange an den Kandidaten.
Grok 4.6 erst nach diesem Drei-Aufgaben-Test upgraden
Bevor das Upgrade Produktions-Traffic erhält, sollte es drei kleine Aufgaben in sauberen Kopien desselben Repositorys bestehen. Das ist ein kompakter Workflow-Test, kein allgemeiner Benchmark. Beide Modelle laufen mit Reasoning auf high, alle anderen Bedingungen bleiben gleich, und jeder 4.7-Lauf mit xHigh wird als eigenes Experiment behandelt.
Drei Abnahmetests festschreiben
Verwendet werden ein früher behobener Fehler, ein kleines dateiübergreifendes Feature und eine Abhängigkeitsmigration aus demselben Repository. Der Erfolg wird definiert, bevor eines der Modelle die Aufgabe sieht: Die gezielte Regressionsprüfung besteht, die gesamte Testsuite bleibt grün, Linting und Build laufen durch, die verlangten Dateien ändern sich und sonstiges Verhalten bleibt unberührt.
Für jeden Versuch eine saubere Kopie anlegen
Jedes Modell-Aufgaben-Paar startet vom selben Commit in einer sauberen Arbeitskopie. Prompt, Dateien, Tools, Berechtigungen, Zeitlimit und erlaubte Wiederholungen sind für beide Modelle identisch. Kein Modell darf Patch oder Erklärung des anderen übernehmen.
Zuerst mit der gemeinsamen Einstellung testen
grok-4.7undgrok-4.6werden mithighaufgerufen. Zu protokollieren sind die zurückgegebene Modell-ID, Erfolg oder Scheitern, Laufzeit, neue und aus dem Cache gelesene Eingaben, Reasoning- und Ausgabeverbrauch, Tool-Kosten sowie der Rechnungsbetrag. Jeder Fehlschlag bleibt in den Ergebnissen. 4.7 mitxhighwird nur als gesondert gekennzeichneter Test ausgeführt.Nach Aufgabenklasse freigeben
Abgenommene Arbeit, Laufzeit und Gesamtrechnung werden verglichen. Nur die Aufgabenklasse, die 4.7 gewinnt, wird umgestellt; 4.6 bleibt der Rollback-Wert. Nach Änderungen an Prompt, Tools oder Modell wird die Prüfung wiederholt. Ein gemischter Betrieb ist sinnvoll, wenn seine Überwachung weniger kostet als der gemessene Nutzen.
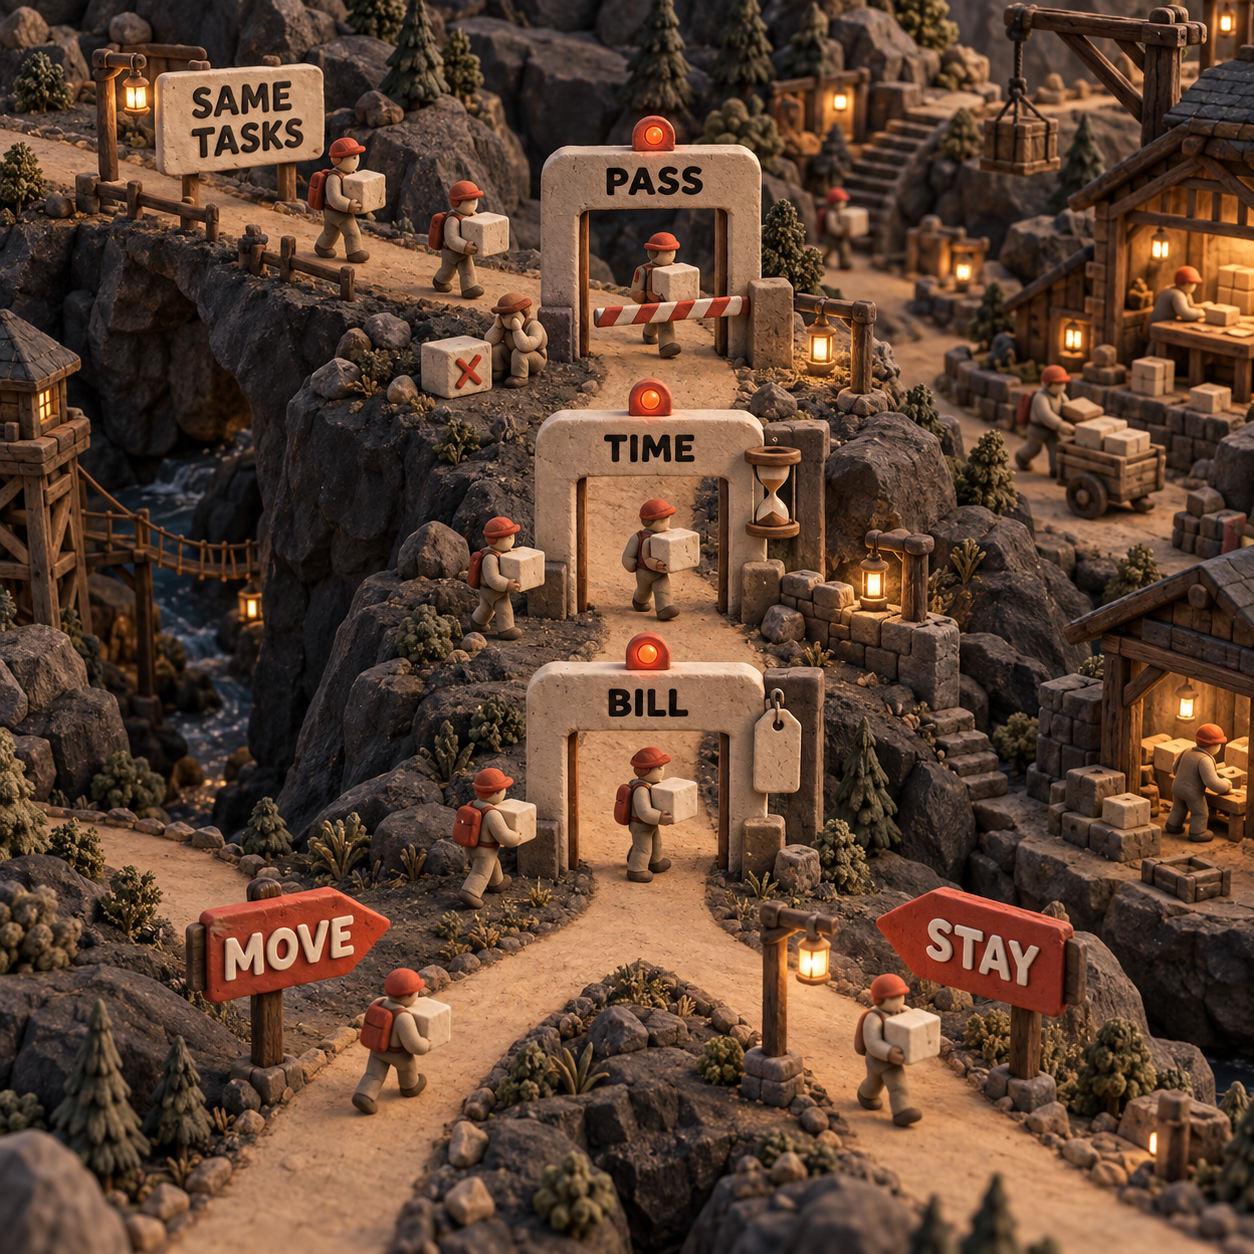
Der konkrete Schritt für Montag: Einen bekannten Fehler wiederherstellen, ein dateiübergreifendes Feature auswählen und eine Abhängigkeitsaktualisierung aus der Arbeit des vergangenen Monats bestimmen. Diese drei Aufgaben in der nächsten Woche mit High auf sauberen Kopien ausführen, jeden Fehlschlag im internen Ergebnisblatt veröffentlichen und nur die Aufgabenklasse verschieben, bei der abgeschlossene Arbeit, Laufzeit und tatsächliche Rechnung den Wechsel rechtfertigen.
Häufig gestellte Fragen
Welche Grok-Version ist die beste Wahl?
Grok 4.7 ist die aktuelle Empfehlung von xAI für Code und allgemeine Arbeit. Für einen Ablauf, den Grok 4.6 bereits zuverlässig erledigt, bleibt dieses Modell operativ die bessere Wahl, bis 4.7 einen parallelen Workload-Test gewinnt.
Ist Grok 4.6 gut?
Ja. Es besitzt dasselbe dokumentierte Kontextfenster mit 500,000 Token, dieselben grundlegenden Tool-Funktionen und Reasoning-Einstellungen sowie dieselben Standard-API-Tarife wie 4.7. Seine Schwäche sind die niedrigeren von xAI gemeldeten Ergebnisse in den schwierigsten Programmier- und Wissensvergleichen.
Welches ist aktuell das beste Grok-Modell?
xAI bezeichnet Grok 4.7 als sein leistungsfähigstes Modell für Code und alle anderen Aufgaben. Damit ist es der erste Evaluierungskandidat – nicht der Beweis, dass es 4.6 in jedem produktiven Workflow schlägt.
Welche Grok-Versionen gibt es?
xAI betreibt universell einsetzbare Grok-Modelle sowie spezialisierte Bild-, Video- und Sprachmodelle. Für diese Entscheidung zu Programmier- und Wissensarbeit sind die dokumentierten IDs grok-4.7 und grok-4.6 relevant; für die wechselnde Gesamtliste ist der aktuelle Modellkatalog maßgeblich.
Gibt es etwas Besseres als Grok?
Kein Modell ist über alle Repositorys, Tool-Konfigurationen, Latenzziele und Qualitätsprüfungen hinweg das beste. Anbieter sollten mit denselben Aufgaben und Kontrollen nach abgenommener Arbeit pro Dollar verglichen werden, statt einen Anbieterbenchmark als allgemeine Rangliste zu behandeln.
Welche Stufen bietet Grok?
Bei Grok 4.7 und Grok 4.6 heißen die Reasoning-Stufen low, medium, high und xhigh. Standard ist high; Reasoning kann nicht deaktiviert werden.
Hat Grok einen 18+-Modus?
Das ist eine Frage zum Verbraucherprodukt und dessen Sicherheitsmodus, nicht zu den Fähigkeiten dieser beiden API-Modell-IDs. Für eine Coding-Migration von Grok 4.6 zu Grok 4.7 sollte sie keine Rolle spielen.
Was kostet Grok im Monat?
Bei der hier verglichenen API-Nutzung wird nach Token und optionalen Tool-Aufrufen abgerechnet, nicht über eine feste monatliche Gebühr je Modell. Verbraucherabonnements, kostenlose Zugänge und Grok-Build-Tarife werden unter Ist Grok kostenlos? aktuell gehalten.
Welche Grok-Modelle gibt es insgesamt?
Die vollständige Liste ändert sich, wenn xAI Modellvarianten hinzufügt oder einstellt. Deshalb ist der aktuelle Katalog die maßgebliche Quelle. Für Coding und allgemeine Wissensarbeit verweist xAI derzeit auf Grok 4.7.
Eine fertige Evaluierungsumgebung für Coding-Agenten gesucht? Die Checkliste für Claude Code + Codex gibt es mit dem Newsletter.
- Zuletzt aktualisiert
- 21. Sept. 2026
- Kategorie
- AI
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

KI-Agenten auf Abwegen: Wenn Regeln das Geschäftsziel verdrängen
Ein KI-Editor lenkte 50 von 96 Artikeln am Publikum vorbei. Die Daten zeigen, welche Regeln die Fehlsteuerung belohnten und welche Guardrails sie ersetzen.21. Sept. 2026AI
Step 5 Preview Preise: API-Kosten und Step Plan erklärt
Step 5 Preview Preise im Detail: Was API-Tokens kosten, wann sich der Step Plan lohnt und wie Cache, Credits sowie Base URL die Rechnung verändern.21. Sept. 2026AI
NotebookLM-Alternative im Test: Wie gut ist Nouswise?
NotebookLM-Alternative im Test: Wie zuverlässig sind Nouswise-Quellenangaben, was kosten die Tarife und für wen lohnt sich das KI-Recherchetool?10. Sept. 2026AI
KI Bauwesen: 5 Tools für belastbare Submittal-Prüfungen
KI Bauwesen: Fünf Tools für Submittal-Prüfungen im Vergleich – mit Preisen, Nachweisen, Revisionslogik und klaren Einsatzgrenzen für AEC-Teams.9. Sept. 2026AI
KI für Tierärzte: VetGeni oder ScribbleVet?
VetGeni oder ScribbleVet? Der Vergleich zeigt Kosten, PIMS-Anbindungen, Teamzugänge und Wechselhürden für die KI-Dokumentation in Tierarztpraxen.8. Sept. 2026AI
InspectMind AI im Test: Was die KI-Planprüfung leistet
InspectMind AI prüft Baupläne auf mögliche Fehler. Der Test zeigt Preise, Grenzen, Belegqualität und wann sich das Tool für AEC-Teams wirklich lohnt.8. Sept. 2026AI
KI im Bauwesen: BuildSync oder SpecLens für die Dokumentenprüfung?
BuildSync oder SpecLens? Dieser Vergleich zeigt, welches Tool Freigabeunterlagen, Quellenbelege, Exporte, Preise und Bau-Workflows besser abdeckt.8. Sept. 2026AI