Grok 4.7 vs Grok 4.6 : quel modèle choisir ?
Grok 4.7 vs Grok 4.6 : les tarifs sont identiques. Comparez leurs performances, leurs coûts réels et les risques de migration avant de choisir.


Le comparatif Grok 4.7 vs Grok 4.6 se joue sur l’évaluation, pas sur le prix : les deux modèles démarrent à $2 par million de tokens en entrée et $6 par million de tokens en sortie. Confiez à Grok 4.7 les nouvelles tâches complexes de code et de traitement des connaissances ; conservez les workflows éprouvés de Grok 4.6 tant que 4.7 ne l’emporte pas sur le travail effectivement terminé, le temps écoulé et la facture finale.
Grok 4.7 vs Grok 4.6 : quel modèle choisir ?
Choisissez Grok 4.7 pour les missions sur lesquelles Grok 4.6 s’arrête trop tôt, oublie une dépendance entre plusieurs fichiers ou exige des corrections répétées. Gardez Grok 4.6 dans un circuit de production qui passe déjà ses contrôles sans dépasser le budget. Un nouveau modèle mérite de recevoir une partie du trafic, pas de remplacer d’office toutes les charges de travail.
Le premier test à mener dépend donc du profil :
- Un fondateur ayant levé des fonds et bloqué sur une fonctionnalité produit a intérêt à essayer Grok 4.7 sur cette fonctionnalité, car les progrès les plus marqués revendiqués par xAI concernent les travaux difficiles et prolongés.
- Le CTO d’une entreprise de taille intermédiaire devrait laisser intactes les automatisations Grok 4.6 qui fonctionnent et orienter les catégories de tâches en échec vers une évaluation encadrée de 4.7.
- Un responsable expérimenté qui produit des études, des documents ou des présentations devrait comparer les livrables acceptés, et non la seule qualité de la prose.
- Un développeur indépendant devrait demander à 4.7 de résoudre le ticket que 4.6 n’a pas su terminer, puis ne le promouvoir que si le résultat passe les mêmes tests.
La décision se prend charge de travail par charge de travail. Une entreprise peut tout à fait utiliser 4.7 pour intervenir dans un dépôt de code et conserver 4.6 pour un flux stable d’extraction ou de classification. Ce routage supplémentaire ne se justifie que si le bénéfice mesuré dépasse la complexité opérationnelle qu’il ajoute.
Grok 4.7 est-il meilleur ?
Oui, au vu des résultats publiés par xAI le 21 septembre 2026 sur le code difficile et le travail professionnel. Non, si la question est de savoir s’il doit remplacer automatiquement chaque déploiement de Grok 4.6. Les données plaident pour une évaluation, mais la différence de niveau de raisonnement ne permet pas d’en déduire une supériorité universelle.
Grok 4.7 pour le code
Gagnant : Grok 4.7, avec la réserve propre aux benchmarks d’un fournisseur. Dans la comparaison publiée le même jour par xAI, Grok 4.7 en xHigh atteint 46.3% sur CursorBench 4.0, contre 40.4% pour Grok 4.6 en High, soit 5.9 points de pourcentage d’avance. Sur Terminal-Bench 4.0, les deux modèles obtiennent respectivement 38.0% et 20.3%, pour un écart de 17.7 points. Sur EEBench, le résultat est de 64.0% contre 53.0%, soit 11 points d’avance.
Ces écarts comptent sur les tâches mises en avant lors du lancement : travail prolongé dans un dépôt, opérations dans le terminal et ingénierie. Mais ils restent issus du fournisseur, et xAI a accordé à 4.7 le niveau de raisonnement plus poussé xHigh, tandis que 4.6 fonctionnait en High. Davantage de raisonnement peut améliorer la qualité tout en augmentant les tokens de raisonnement et la latence. Ce graphique est une raison de tester 4.7, pas une estimation contrôlée du gain à attendre en production.
Le constat va dans le même sens pour le travail intellectuel. xAI annonce un score de 1,657 pour Grok 4.7 contre 1,546 pour Grok 4.6 sur AA Briefcase v1.1, et de 1,695 contre 1,605 sur GDPval. Le résultat de son agent juridique s’établit à 19.6% contre 15.8%, tandis que HealthBench Professional affiche 56.7% contre 48.5%. Toutes ces données proviennent de la comparaison du 21 septembre : aucun benchmark plus ancien n’est donc mêlé à tort à ce face-à-face.
Ne transformez pas le slogan du lancement en promesse de vitesse. La page présente Grok 4.7 comme deux fois plus rapide que des modèles comparables, mais précise dans le corps du texte que Grok 4.7 standard est servi à la même vitesse que Grok 4.6. L’option spécifique offrant une vitesse de sortie 2× supérieure correspond à un niveau de service Fast distinct, facturé plus cher.
En clair, 4.7 a gagné le droit d’être essayé sur les tâches difficiles. Il n’a pas encore gagné celui de déclencher une migration aveugle de tout le parc.
Ce qui ne change pas : accès, contexte, outils et raisonnement
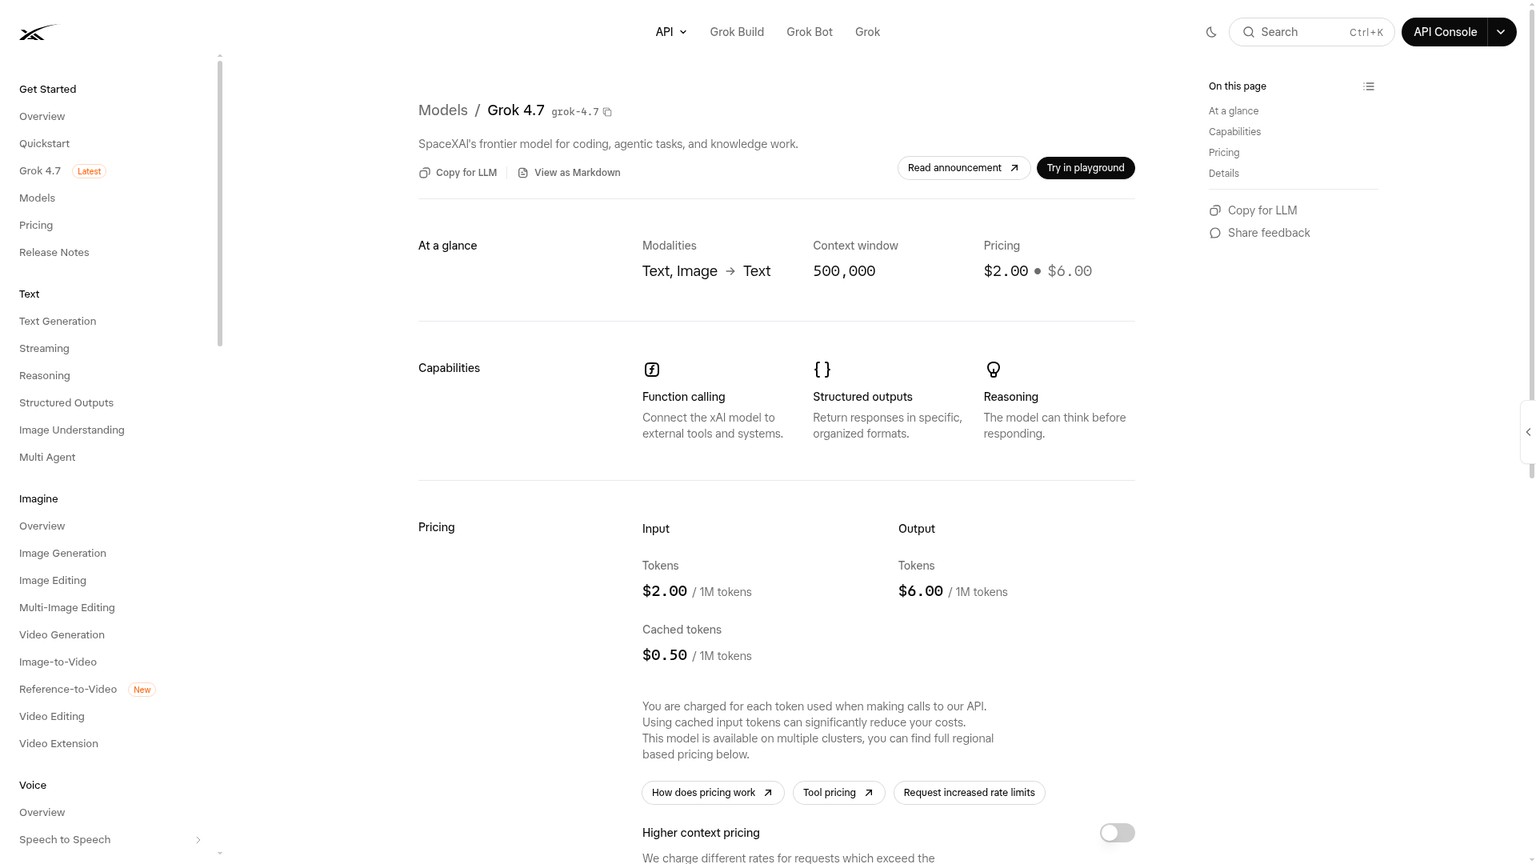
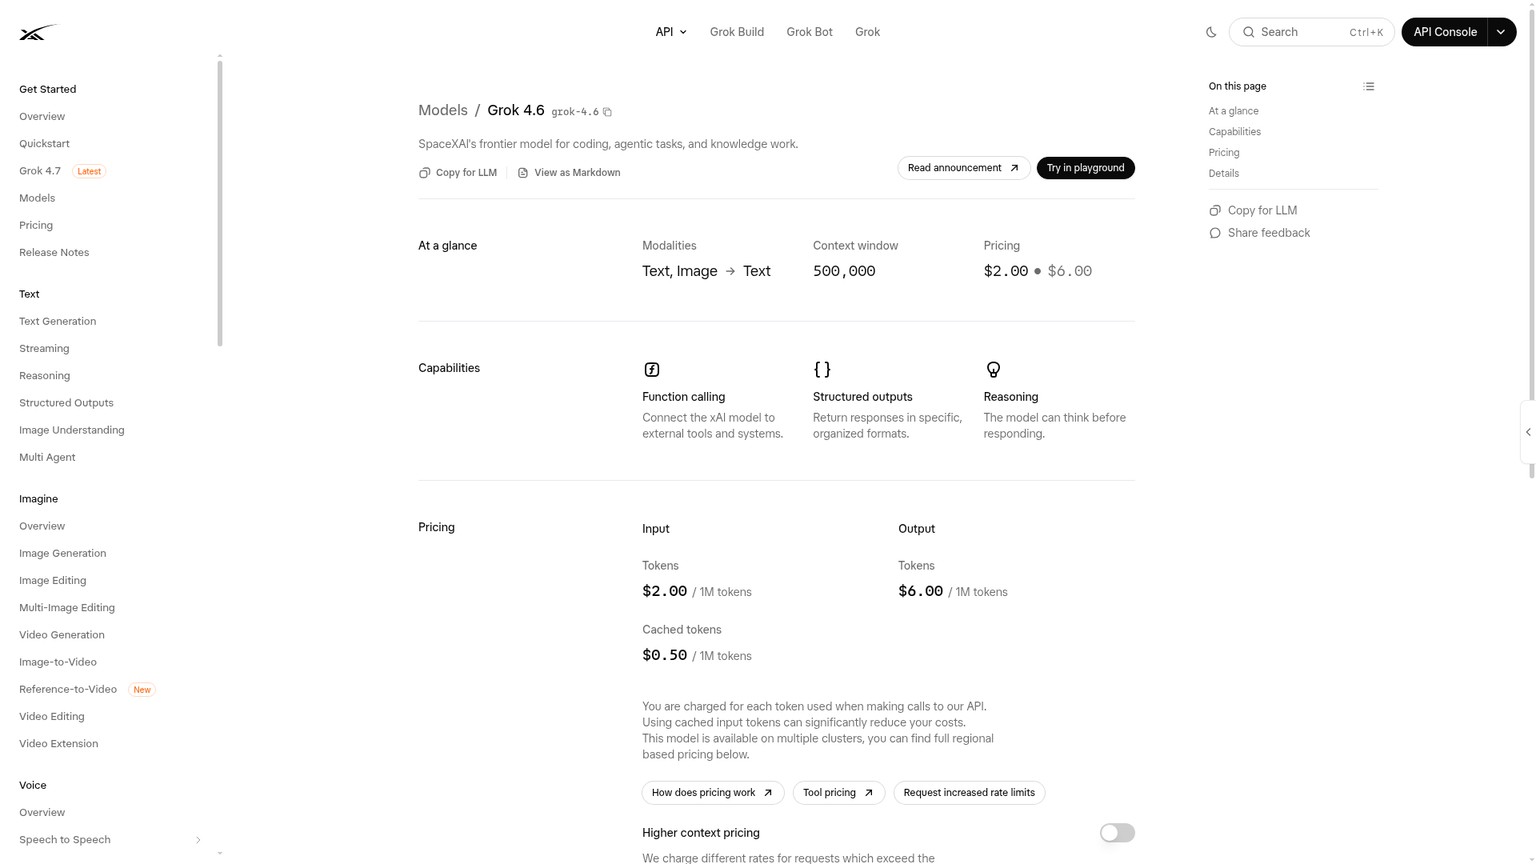
Grok 4.7 et Grok 4.6 proposent presque la même surface d’intégration. L’essentiel du risque de migration concerne donc le comportement, pas la forme de l’API. Tous deux acceptent du texte et des images, renvoient du texte, prennent en charge l’appel de fonctions et les sorties structurées, et disposent d’une fenêtre de contexte de 500,000 tokens.
Grok 4.7 : le modèle phare actuel
Grok 4.7 utilise l’identifiant de modèle documenté grok-4.7. La page officielle du modèle chez xAI le destine au code, aux tâches agentiques et au traitement des connaissances. L’annonce indique qu’il est accessible via l’API publique, Cursor, Grok Build, des outils de code tiers, des routeurs de modèles et des plateformes cloud.
Idéal pour : les tâches complexes de code et de traitement des connaissances que 4.6 ne termine pas.
Tarifs : $2 pour les nouvelles entrées, $0.50 pour les entrées mises en cache et $6 pour les sorties, par million de tokens sous 200K.
Limite signalée : aucune prise en charge de Batch, et la variante Fast n’est pas accessible via l’API publique de xAI.
À éviter lorsque : un workflow 4.6 qui fonctionne ne présente aucun échec coûteux à corriger.
Le comportement de son Responses API comporte un détail d’intégration à vérifier : Grok 4.7 renvoie toujours le contenu de raisonnement sous forme chiffrée, y compris les sorties chiffrées des outils côté serveur. Un client peut ignorer ce champ. En revanche, s’il transporte manuellement l’état de la conversation, il doit conserver les éléments de raisonnement sans les modifier lorsque la continuité est importante.
Grok 4.6 : la référence documentée
Grok 4.6 reste disponible sous l’identifiant grok-4.6. Sa page de modèle actuelle documente toujours la même fenêtre de 500,000 tokens, les mêmes modalités d’entrée et de sortie, ainsi que les mêmes capacités essentielles : appel de fonctions, sorties structurées et raisonnement.
Idéal pour : les workflows stables qui passent déjà un contrôle d’acceptation défini.
Tarifs : $2 pour les nouvelles entrées, $0.50 pour les entrées mises en cache et $6 pour les sorties, par million de tokens sous 200K.
Limite signalée : des scores publiés par xAI inférieurs dans la comparaison actuelle des tâches difficiles, sans réduction tarifaire sur les tokens pour ceux qui restent sur cette version.
À éviter lorsque : le coût des travaux inachevés à répétition dépasse déjà celui d’une migration encadrée.
Les deux modèles proposent les niveaux d’effort de raisonnement low, medium, high et xhigh. La documentation de xAI sur le raisonnement définit high comme valeur par défaut et précise qu’il est impossible de désactiver le raisonnement. Ce réglage high, commun aux deux modèles, constitue le point de départ équitable d’une évaluation appariée. Une exécution de 4.7 en xHigh doit rester dans un volet distinct, car elle modifie simultanément la qualité, le budget de tokens et la latence.
Gagnant : égalité sur la compatibilité de l’interface, Grok 4.7 pour la recommandation actuelle du fournisseur. Cette surface familière réduit l’effort de migration, mais des paramètres compatibles ne garantissent ni les mêmes choix d’outils, ni les mêmes schémas de sortie, ni le même comportement d’arrêt ou de nouvelle tentative.
Prix de l’API Grok 4.7 : mêmes tarifs, factures différentes selon la tâche
Grok 4.7 et Grok 4.6 appliquent les mêmes tarifs publics par token pour l’API, vérifiés sur la page tarifaire actuelle de xAI le 21 septembre 2026. Sous 200,000 tokens de prompt, chaque modèle coûte $0.002 par 1K de nouveaux tokens en entrée, $0.0005 par 1K de tokens d’entrée mis en cache et $0.006 par 1K de tokens en sortie.
À partir de 200,000 tokens de prompt, tous les tokens de la requête passent au barème du contexte long : $0.004 par 1K de nouveaux tokens en entrée, $0.001 par 1K de tokens d’entrée mis en cache et $0.012 par 1K de tokens en sortie. Une fenêtre de 500,000 tokens indique une capacité ; elle n’autorise pas à conserver indéfiniment, et à moindre coût, l’historique d’un agent.
Ces lignes reposent sur un calcul exact des tokens, pas sur des exécutions observées des modèles. Elles isolent la tarification afin que le comportement puisse décider du comparatif.
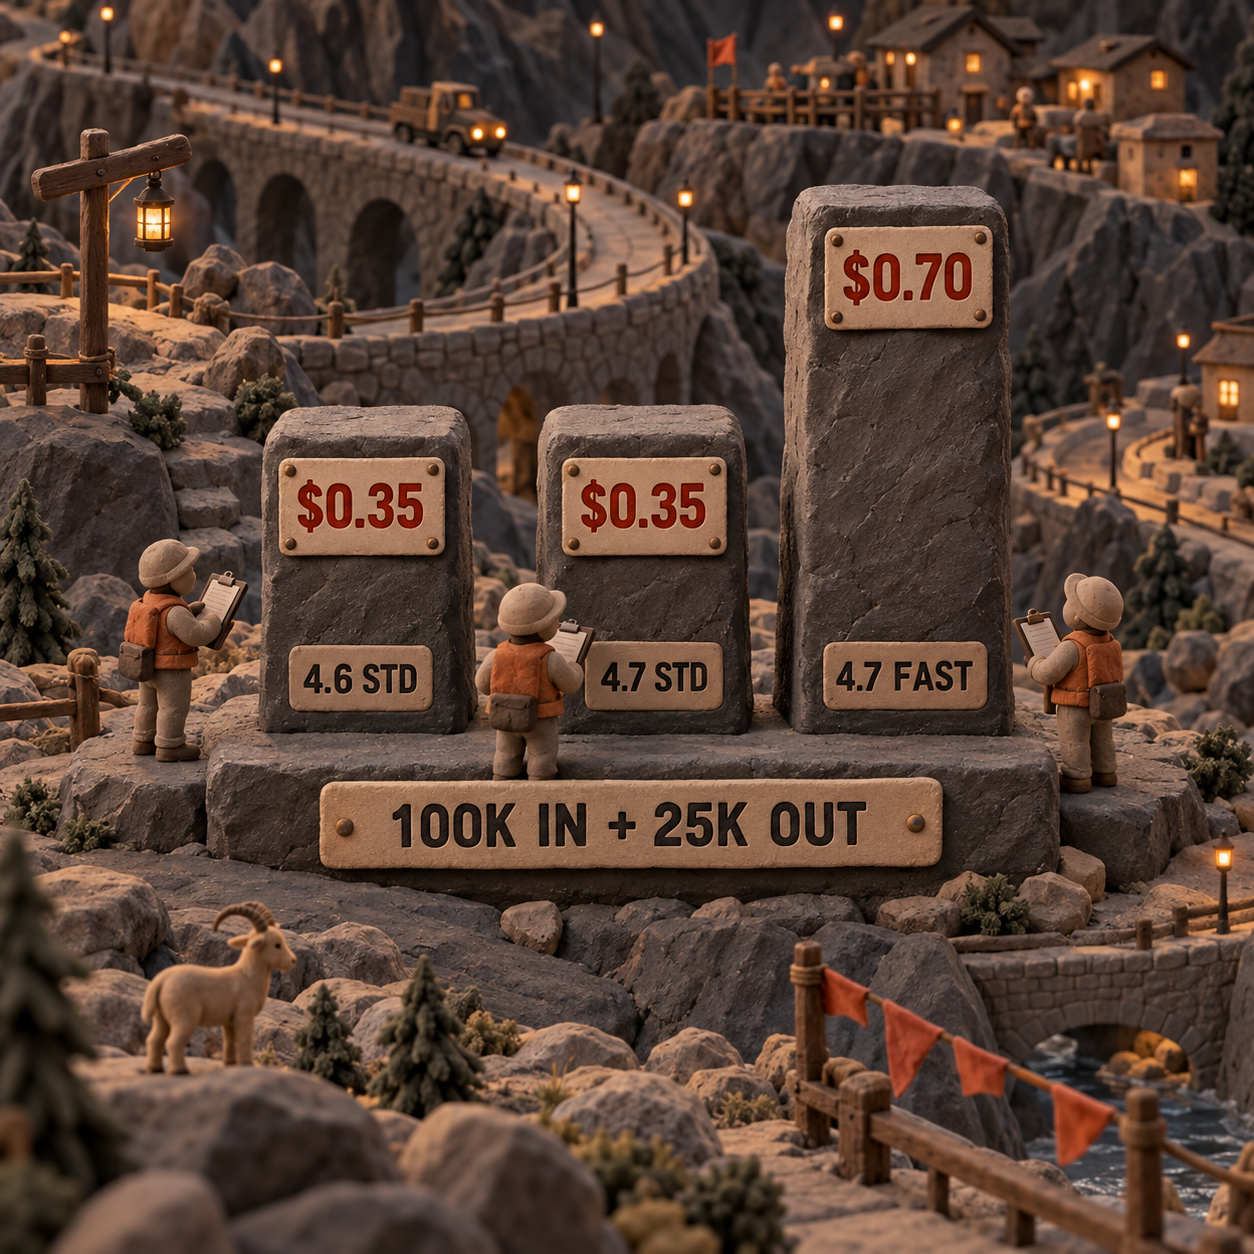
Aucun seuil tarifaire sur les tokens ne départage ces modèles. Le véritable point de bascule est le travail terminé :
cost per accepted task = total billed cost across all attempts / accepted tasks
Si les deux modèles consomment le même nombre de tokens facturés par tentative, toute hausse du taux de tâches acceptées rend 4.7 moins cher par mission terminée. Si 4.7 dépense davantage parce qu’il raisonne plus longtemps, la progression du taux de tâches acceptées doit être proportionnellement supérieure à celle des dépenses. Un prix catalogue identique ne protège ni d’un raisonnement plus long, ni des nouvelles tentatives, ni des boucles d’outils, ni des réponses trop développées.
Les options Fast et Priority exigent des budgets séparés :
- Sous 200,000 tokens de prompt, Grok 4.7 Fast coûte $4 en entrée, $1 pour les entrées mises en cache et $12 en sortie, par million de tokens. L’exemple avec 100K tokens en entrée et 25K en sortie revient donc à $0.70.
- Grok 4.7 Fast est proposé uniquement dans Cursor et Grok Build, pas via l’API publique de xAI, et l’offre gratuite de Grok Build ne l’inclut pas.
- Au-delà de 200,000 tokens de prompt, le tableau détaillé de l’offre Fast publié par xAI indique $6 en entrée, $1.50 pour les entrées mises en cache et $18 en sortie par million. Utilisez ce barème plutôt que d’appliquer un multiplicateur uniforme.
- Le Priority Processing de l’API publique applique un supplément de 2× lorsque la réponse confirme ce niveau de service prioritaire.
Aucun des deux modèles ne prend actuellement en charge l’API Batch. Les tokens de raisonnement sont comptabilisés dans la consommation, et les outils de l’API publique ajoutent un autre poste. Web Search et Code Execution coûtent chacun $5 pour 1,000 appels. Voilà pourquoi le journal d’évaluation doit reprendre la consommation et les frais d’outils indiqués dans la réponse, et non une estimation fondée sur la seule longueur du prompt.
Le précédent test de Grok 4.5 explique pourquoi ce seuil de 200K compte dans les longues boucles d’agents. La même leçon s’applique ici : réduisez l’historique obsolète avant qu’il ne double discrètement les tarifs en tokens de la requête.
Gagnant : Grok 4.7, uniquement si son taux de travaux menés à bien progresse. Si les deux modèles passent les contrôles au même rythme, Grok 4.6 l’emporte en évitant le travail de migration. Si 4.7 résout des échecs qui imposeraient autrement une nouvelle tentative ou une correction humaine, ses tarifs par token identiques deviennent un avantage économique.
Le coût du changement est opérationnel, pas contractuel
Grok 4.6 gagne dans la catégorie de la stabilité, car le conserver n’exige aucune configuration. Grok 4.7 doit amortir le travail nécessaire pour valider son comportement, adapter l’observabilité et maintenir une voie de retour sûre.
Avant de changer l’identifiant du modèle, préservez ces éléments de contrôle :
- Le prompt exact, la politique système, les schémas des outils, l’instantané du dépôt, le délai d’expiration et la politique de nouvelle tentative.
- Les validateurs de schéma, les tests, le lint, les commandes de build et toute liste de contrôle humaine pour l’acceptation.
- Pour chaque tentative, des relevés séparés des nouveaux tokens en entrée, des tokens en cache, du raisonnement, de la sortie, des appels d’outils et du temps écoulé.
- La liste des effets de bord déjà produits avant une nouvelle tentative ou un retour arrière. Rejouer une tâche partiellement exécutée peut dupliquer une action.
- L’ancien identifiant du modèle dans la configuration, et non enfoui dans le code, afin qu’une charge de travail puisse revenir à 4.6 sans annuler d’autres changements.
La compatibilité des prompts ne garantit pas celle des comportements. Un schéma de sortie structurée peut encore être valide tout en perdant un champ requis. Un agent de code peut appeler les mêmes outils, mais s’arrêter avant les tests. Un agent de recherche peut finir plus vite parce qu’il a sauté la vérification. Ce sont bien des régressions, même lorsque la requête HTTP aboutit.
La principale limite de Grok 4.7 réside dans la transférabilité des résultats : ni le graphique de xAI ni la reconstruction d’un navigateur ne disent comment il se comportera dans votre dépôt. La limite de Grok 4.6 est l’inverse : sa stabilité connue ne résout pas une catégorie de tâches sur laquelle il échoue systématiquement. La bonne répartition conserve la référence connue et confie au candidat la file des travaux plus difficiles.
Ne remplacez Grok 4.6 qu’après ce test en trois tâches
Avant de recevoir du trafic de production, le nouveau modèle doit réussir trois petites tâches dans des copies propres d’un même dépôt. Il s’agit d’un contrôle limité du workflow, pas d’un benchmark général. Utilisez le niveau de raisonnement high avec les deux modèles, gardez tous les autres paramètres identiques et considérez toute exécution de 4.7 en xHigh comme une expérience distincte.
Figez trois tests d’acceptation
Prenez dans le même dépôt un bug déjà corrigé, une petite fonctionnalité touchant plusieurs fichiers et une migration de dépendance. Définissez la réussite avant que l’un ou l’autre modèle ne voie la tâche : la régression ciblée est corrigée, la suite de tests complète reste au vert, le lint et le build aboutissent, les fichiers demandés sont modifiés et le reste du comportement ne change pas.
Créez une copie propre pour chaque tentative
Faites démarrer chaque paire modèle-tâche à partir du même commit, dans une copie de travail propre. Donnez aux deux modèles le même prompt, les mêmes fichiers et outils, les mêmes autorisations, le même délai d’expiration et le même nombre de nouvelles tentatives. Ne laissez pas un modèle hériter du patch ou de l’explication de l’autre.
Commencez avec le réglage commun
Appelez
grok-4.7etgrok-4.6enhigh. Relevez l’identifiant du modèle renvoyé, le succès ou l’échec, le temps écoulé, les nouveaux tokens en entrée et ceux mis en cache, la consommation du raisonnement et de la sortie, les frais d’outils et le montant facturé. Conservez chaque échec dans les résultats. N’exécutez 4.7 enxhighque dans un essai identifié séparément.Promouvez par catégorie de tâche
Comparez le travail accepté, le temps écoulé et la facture totale. Ne migrez que la catégorie remportée par 4.7, gardez 4.6 comme valeur de retour arrière et répétez le contrôle après toute modification du prompt, des outils ou du modèle. Un déploiement mixte est pertinent si son coût de supervision reste inférieur au bénéfice mesuré.
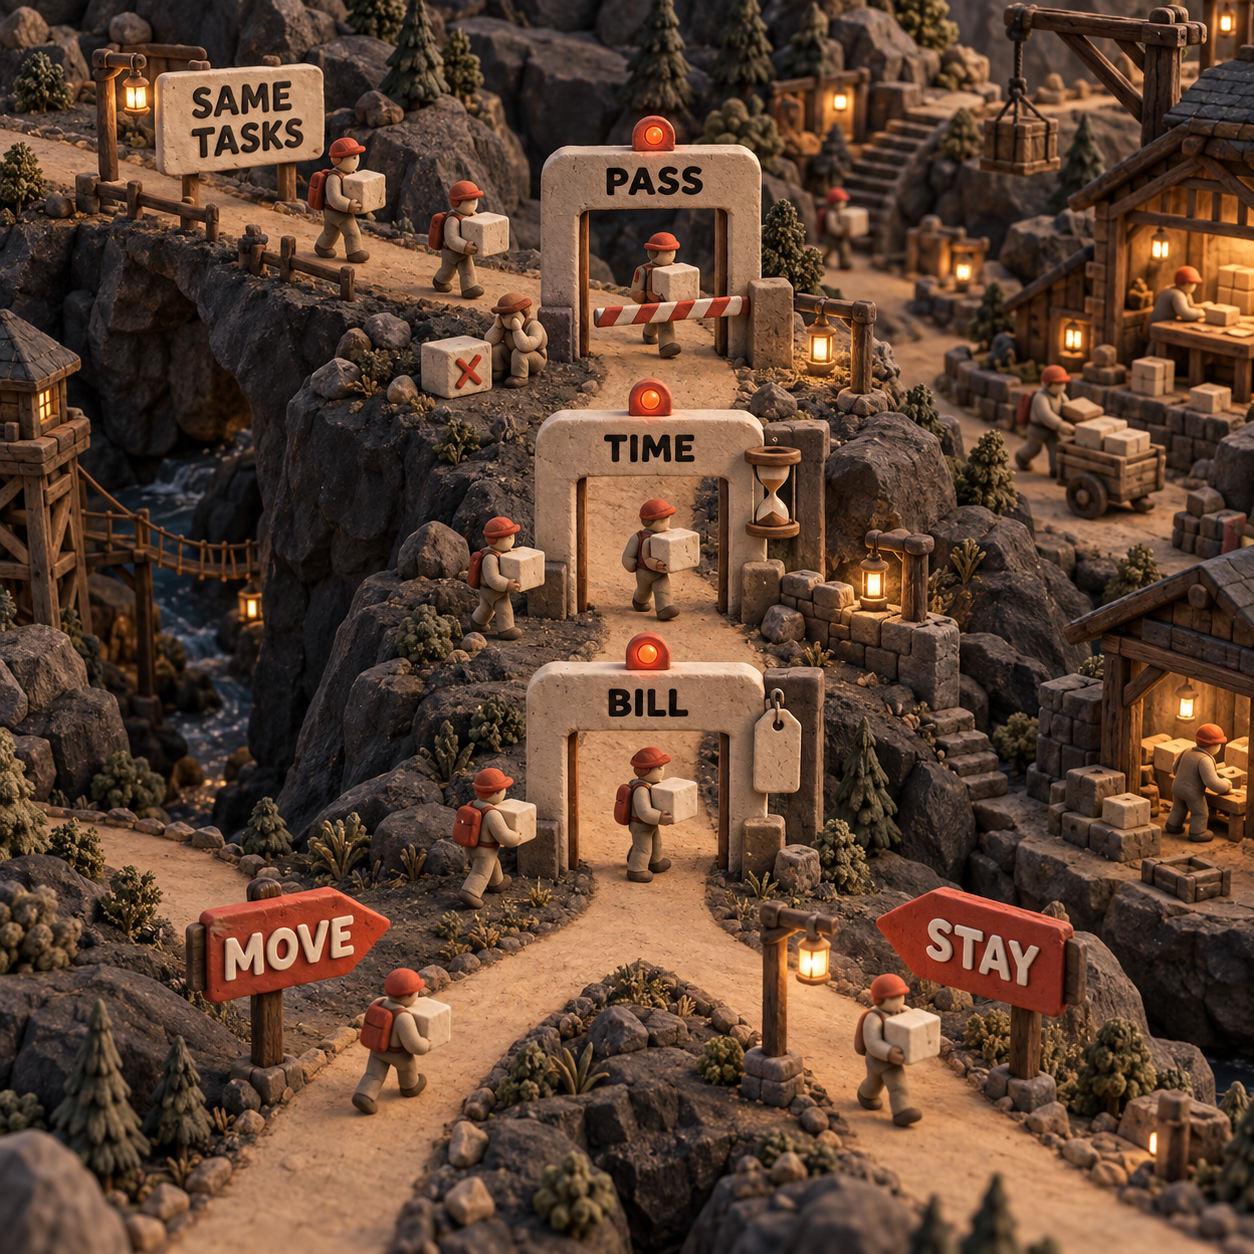
L’action à mener lundi est concrète : réintroduisez un bug connu, choisissez une fonctionnalité touchant plusieurs fichiers et sélectionnez une mise à jour de dépendance parmi les travaux du mois dernier. La semaine prochaine, exécutez ces trois tâches en High dans des copies propres, consignez chaque échec dans le tableau de résultats interne et ne migrez que la catégorie dont le travail terminé, le temps écoulé et la facture réelle justifient le changement.
Questions fréquentes
Quelle est la meilleure version de Grok ?
Grok 4.7 est le choix actuellement recommandé par xAI pour le code et les tâches généralistes. Grok 4.6 reste la meilleure option opérationnelle pour un flux qu’il exécute déjà de manière fiable, jusqu’à ce que 4.7 remporte un test apparié sur cette charge de travail.
Grok 4.6 est-il performant ?
Oui. Il propose la même fenêtre de contexte documentée de 500,000 tokens, les mêmes fonctions essentielles pour les outils, les mêmes niveaux de raisonnement et les mêmes tarifs API standard que 4.7. Son point faible réside dans les performances inférieures publiées par xAI sur les comparaisons les plus difficiles de code et de traitement des connaissances.
Quel est actuellement le meilleur modèle Grok ?
xAI présente Grok 4.7 comme son modèle le plus performant pour le code et tout le reste. Il faut donc l’évaluer en premier, sans y voir la preuve qu’il surpasse 4.6 sur chaque workflow déjà déployé.
Quelles sont les différentes versions de Grok ?
xAI maintient des modèles Grok généralistes, ainsi que des modèles spécialisés pour l’image, la vidéo et la voix. Pour cette décision portant sur le code et le traitement des connaissances, les identifiants documentés pertinents sont grok-4.7 et grok-4.6 ; consultez le catalogue actuel des modèles pour la liste complète, qui évolue.
Existe-t-il un modèle meilleur que Grok ?
Aucun modèle n’est le meilleur pour tous les dépôts, toutes les configurations d’outils, tous les objectifs de latence et tous les critères de qualité. Comparez les fournisseurs sur le nombre de travaux acceptés par dollar, avec les mêmes tâches et les mêmes paramètres, plutôt que de traiter le benchmark d’un fournisseur comme un classement universel.
Quels sont les différents niveaux de Grok ?
Pour Grok 4.7 et Grok 4.6, les niveaux d’effort de raisonnement sont low, medium, high et xhigh. La valeur par défaut est high, et le raisonnement ne peut pas être désactivé.
Grok propose-t-il un mode 18+ ?
C’est une question de produit grand public et de mode de sécurité, pas une différence de capacité entre ces deux identifiants de modèle API. Elle ne doit pas intervenir dans une migration de code de Grok 4.7 vers Grok 4.6 ou inversement.
Combien coûte Grok par mois ?
Pour l’utilisation de l’API comparée ici, le coût dépend des tokens et des éventuels appels d’outils, et non d’un abonnement mensuel fixe propre à chaque modèle. Les abonnements grand public, les accès gratuits et les offres Grok Build sont tenus à jour dans Grok est-il gratuit ?.
Quels sont tous les modèles Grok ?
La liste complète évolue à mesure que xAI ajoute et retire des variantes ; son catalogue actuel fait donc foi. Pour le code et le travail général de traitement des connaissances, xAI oriente actuellement les utilisateurs vers Grok 4.7.
Vous voulez un environnement d’évaluation prêt à l’emploi pour les agents de code ? Recevez la checklist Claude Code + Codex avec la newsletter.
- Dernière mise à jour
- 21 sept. 2026
- Catégorie
- AI
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

Agent IA autonome : quand les règles récompensent la dérive
Comment un agent IA autonome a publié 50 articles hors sujet malgré tous les voyants au vert, et quels garde-fous ont remplacé les règles défaillantes.21 sept. 2026AI
Tarifs Step 5 Preview : API, cache et crédits Step Plan
Comparez les tarifs Step 5 Preview, le cache de prompts, les coûts de raisonnement et les Credits Step Plan pour choisir le bon circuit de facturation.21 sept. 2026AI
Avis Nouswise : citations, prix et verdict après examen
Avis Nouswise : prix, citations, limites et verdict. Découvrez quand cet outil de recherche IA mérite un test et pourquoi ses sources doivent être vérifiées.10 sept. 2026AI
Logiciel suivi chantier : cinq outils IA pour vérifier les fiches techniques
Comparez cinq outils d’IA pour contrôler les fiches techniques de chantier, vérifier les sources, gérer les révisions et chiffrer un pilote.9 sept. 2026AI
Scribe vétérinaire IA : VetGeni ou ScribbleVet ?
VetGeni ou ScribbleVet ? Comparez tarifs, intégrations PIMS, modèles, accès équipe et export pour choisir le scribe vétérinaire IA adapté à votre clinique.8 sept. 2026AI
IA BTP : notre avis sur InspectMind pour contrôler les plans
Notre avis sur InspectMind AI : tarifs, contrôle des plans, qualité des sources et limites à tester avant d’intégrer cette IA BTP à votre workflow.8 sept. 2026AI
IA construction : BuildSync ou SpecLens, lequel choisir ?
BuildSync ou SpecLens ? Comparez dossiers techniques, sources, formats, intégrations et tarifs pour choisir l’IA construction adaptée à votre workflow.8 sept. 2026AI