Grok 4.7 مقابل Grok 4.6: أيهما يستحق الانتقال؟
Grok 4.7 مقابل Grok 4.6 في البرمجة والأداء وأسعار API، مع اختبار من ثلاث مهام يوضح متى يستحق الانتقال ومتى يكون البقاء على 4.6 أكثر أمانًا تشغيليًا.


Grok 4.7 مقابل Grok 4.6 هي مفاضلة تُحسم بالتقييم، لا بالسعر: فكلاهما يبدأ من $2 لكل مليون رمز إدخال و$6 لكل مليون رمز إخراج. أسند مهام البرمجة والمعرفة الجديدة والصعبة إلى Grok 4.7، وأبقِ تدفقات Grok 4.6 المثبتة كما هي حتى يتفوق 4.7 في العمل المنجز والوقت المستغرق والفاتورة النهائية.
Grok 4.7 مقابل Grok 4.6: أيهما تختار؟
اختر Grok 4.7 للمهام التي يتوقف فيها Grok 4.6 مبكرًا، أو يغفل اعتمادًا بين ملفات متعددة، أو يحتاج إلى تصحيحات متكررة. وأبقِ Grok 4.6 ضمن أي مسار إنتاج يجتاز فحوصه بالفعل وفي حدود الميزانية. فالنموذج الأحدث يستحق أن يصبح مرشحًا لاستقبال جزء من الأحمال، لكنه لا يبرر نقلها كلها.
وهذا يعني أن نقطة البداية تختلف باختلاف القارئ:
- على مؤسس شركة ناشئة ممولة تعطلت لديه ميزة في المنتج أن يختبر Grok 4.7 على تلك الميزة، لأن أبرز مكاسب xAI تظهر في العمل الصعب والممتد.
- على مدير تقنية في شركة متوسطة أن يترك عمليات Grok 4.6 الآلية الناجحة كما هي، ويوجّه فئات المهام الفاشلة إلى تقييم مضبوط لـ4.7.
- على المشغّل الخبير الذي ينتج أبحاثًا أو مستندات أو عروضًا تقديمية أن يقارن المخرجات المقبولة، لا جودة الصياغة وحدها.
- على المطوّر التقني المستقل أن يستخدم 4.7 لمعالجة المشكلة التي عجز 4.6 عن إكمالها، ثم يعتمده فقط إذا اجتازت النتيجة الاختبارات نفسها.
هذا قرار يُتخذ لكل عبء عمل على حدة. فمن المنطقي أن تستخدم شركة ما 4.7 لأعمال المستودعات البرمجية، وتحتفظ بـ4.6 لتدفق مستقر للاستخراج أو التصنيف. ولا يستحق تعقيد التوجيه الإضافي إلا عندما تتجاوز الفائدة المقاسة تكلفته التشغيلية.
هل Grok 4.7 أفضل فعلًا؟
نعم، وفق أدلة البرمجة الصعبة والعمل المهني التي نشرتها xAI في 21 سبتمبر 2026. لكنه ليس بديلًا تلقائيًا لكل تطبيقات Grok 4.6. الأدلة تبرر إجراء تقييم، بينما تمنع إعدادات الاستدلال غير المتساوية اعتبارها إثباتًا على ترقية أفضل في جميع الحالات.
أداء Grok 4.7 في البرمجة
الفائز: Grok 4.7، مع التحفظ بأن المعيار صادر عن المزوّد. في المقارنة التي نشرتها xAI ضمن الإصدار نفسه، حقق Grok 4.7 بإعداد xHigh نتيجة 46.3% في CursorBench 4.0، مقابل 40.4% لـGrok 4.6 بإعداد High، أي تقدم قدره 5.9 نقطة مئوية. وفي Terminal-Bench 4.0، سجل النموذجان 38.0% و20.3%، بفارق 17.7 نقطة. أما EEBench فسجل 64.0% مقابل 53.0%، أي تقدم 11 نقطة.
هذه فروق معتبرة في المهام التي يركز عليها الإطلاق: العمل الممتد داخل المستودعات، وتشغيل الطرفية، والهندسة. لكنها تظل نتائج أعلنها المزوّد، كما منحت xAI النموذج 4.7 إعداد xHigh الأعمق بينما شغّلت 4.6 على High. ويمكن لمزيد من الاستدلال تحسين الجودة، لكنه قد يضيف رموز استدلال وزمن انتظار. لذلك تعامل مع الرسم بوصفه سببًا لاختبار 4.7، لا تقديرًا مضبوطًا لمكاسب بيئة الإنتاج لديك.
ويتكرر الاتجاه نفسه في أعمال المعرفة. تفيد xAI بأن Grok 4.7 سجل 1,657 مقابل 1,546 لـGrok 4.6 في AA Briefcase v1.1، و1,695 مقابل 1,605 في GDPval. وبلغت نتيجة وكيل المهام القانونية 19.6% مقابل 15.8%، بينما سجل HealthBench Professional نسبة 56.7% مقابل 48.5%. جميع هذه الأرقام مأخوذة من مقارنة 21 سبتمبر، لذلك لا تخلط إصدارًا أقدم من أحد المعايير ضمن مواجهة غير دقيقة.
لا تحوّل عنوان الإطلاق إلى وعد بالسرعة. فالصفحة تصف Grok 4.7 بأنه أسرع بمرتين من النماذج القابلة للمقارنة، لكن متنها يقول إن Grok 4.7 القياسي يعمل بالسرعة نفسها التي يعمل بها Grok 4.6. أما خيار سرعة الإخراج المحدد عند 2× فهو فئة خدمة Fast منفصلة بسعر أعلى.
الخلاصة المباشرة: أثبت 4.7 أنه يستحق تجربة المهام الصعبة، لكنه لم يثبت بعد أنه يستحق ترحيلًا شاملًا بلا اختبار.
ما الذي لم يتغير؟ الوصول والسياق والأدوات والاستدلال
يقدم Grok 4.7 وGrok 4.6 واجهتي تكامل متقاربتين جدًا، ولذلك تتركز معظم مخاطر الترحيل في السلوك لا في البنية الأساسية للـAPI. فكلاهما يقبل النصوص والصور، ويعيد نصًا، ويدعم استدعاء الدوال والمخرجات المهيكلة، ويوفر نافذة سياق بحجم 500,000 رمز.
Grok 4.7: النموذج الرئيسي الحالي
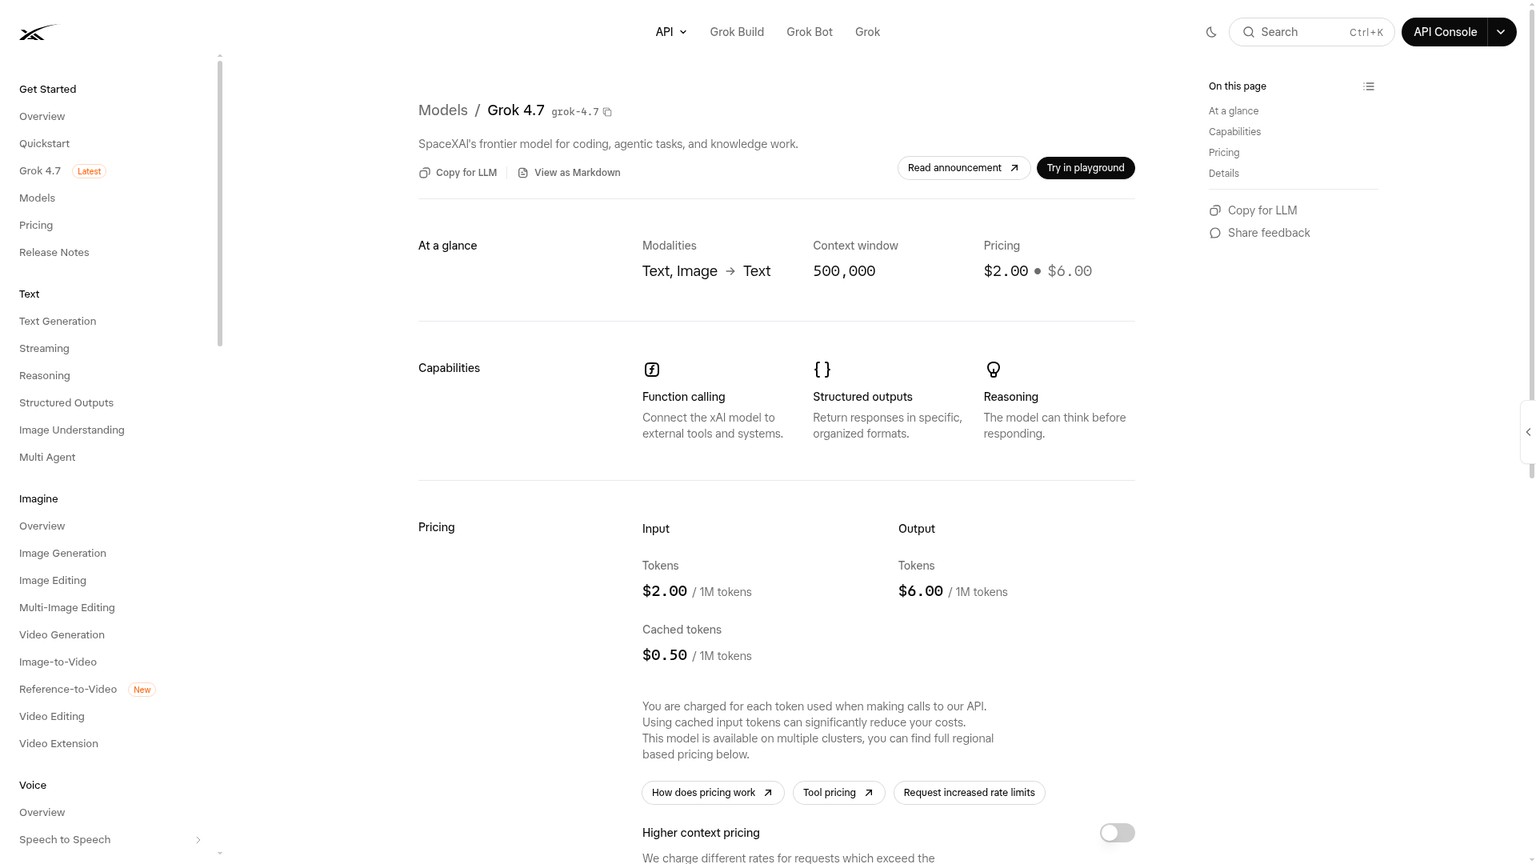
يستخدم Grok 4.7 معرّف النموذج الموثق grok-4.7. وتضعه صفحة النموذج الحالية لدى xAI ضمن خيارات البرمجة والمهام الوكيلة وأعمال المعرفة، بينما يفيد إعلان الإطلاق بأنه متاح عبر API العامة وCursor وGrok Build وأدوات البرمجة الخارجية وموجّهات النماذج والمنصات السحابية.
الأنسب لـ: أعمال البرمجة والمعرفة الصعبة التي لا يتمكن 4.6 من إكمالها.
السعر: $2 للإدخال الجديد، و$0.50 للإدخال المخزن مؤقتًا، و$6 للإخراج لكل مليون رمز دون 200K.
قيد معلن: لا يدعم Batch، كما أن نسخة Fast غير متاحة عبر API العامة لـxAI.
تجاوزه عندما: يكون لديك تدفق ناجح على 4.6 ولا توجد مشكلة مكلفة تحتاج إلى حل.
هناك تفصيل واحد في سلوك Responses API يستحق المراجعة: يعيد Grok 4.7 دائمًا محتوى الاستدلال مشفرًا، بما في ذلك المخرجات المشفرة من أدوات الخادم. يمكن للعميل تجاهل هذا الحقل، لكن على العميل الذي ينقل حالة المحادثة يدويًا أن يحتفظ بعناصر الاستدلال من دون تغيير عندما تكون الاستمرارية مهمة.
Grok 4.6: خط الأساس الموثق
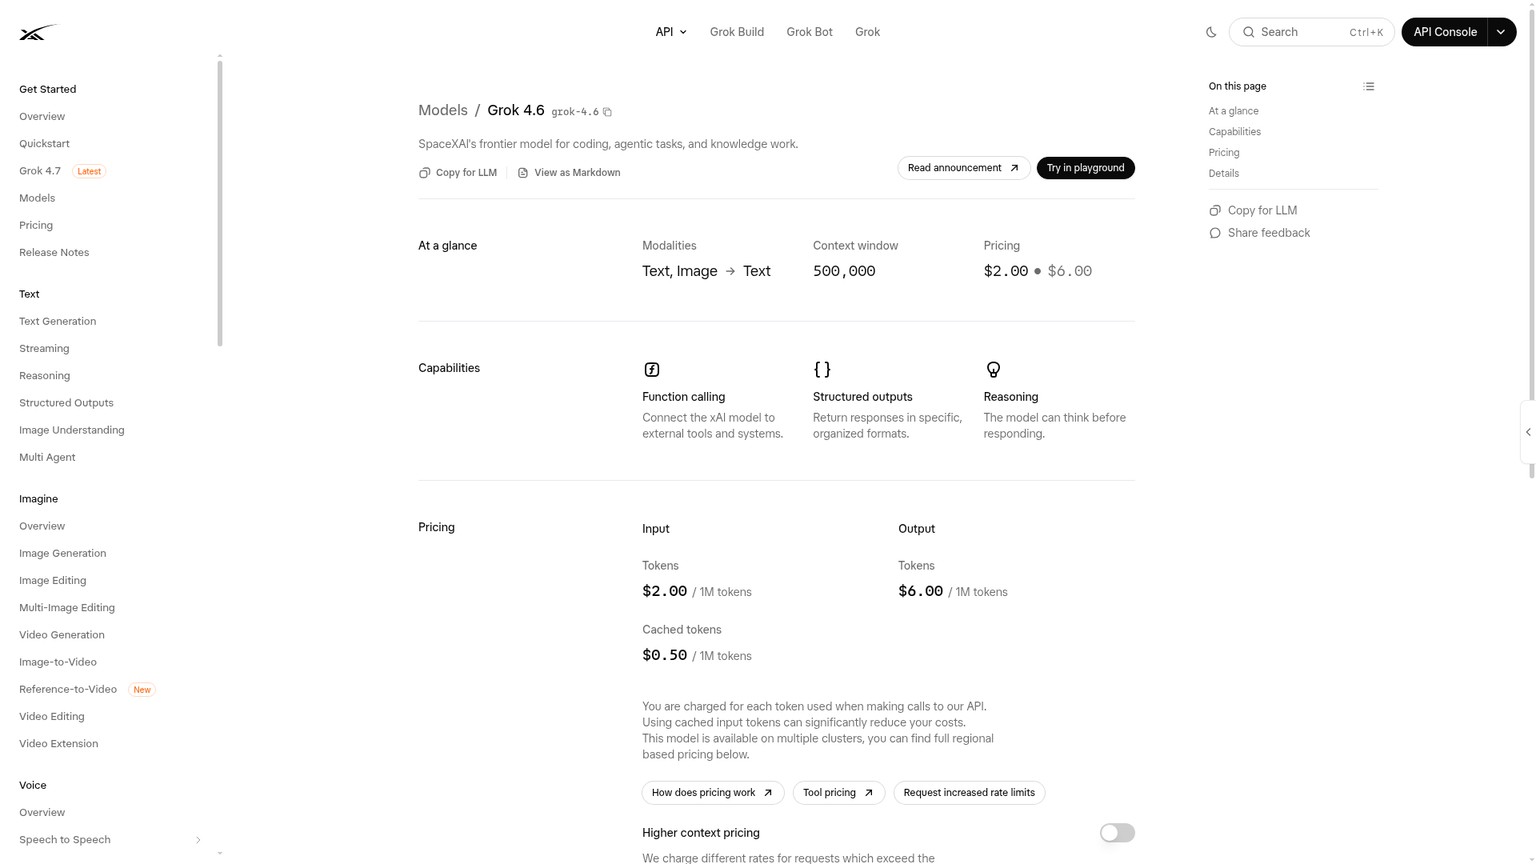
لا يزال Grok 4.6 متاحًا بالمعرّف grok-4.6. وتوثق صفحة النموذج الحالية نافذة السياق نفسها البالغة 500,000 رمز، وأنماط الإدخال والإخراج نفسها، والقدرات الأساسية نفسها في استدعاء الدوال والمخرجات المهيكلة والاستدلال.
الأنسب لـ: تدفقات العمل المستقرة التي تجتاز بالفعل بوابة قبول محددة.
السعر: $2 للإدخال الجديد، و$0.50 للإدخال المخزن مؤقتًا، و$6 للإخراج لكل مليون رمز دون 200K.
قيد معلن: نتائج أقل وفق أرقام xAI في المقارنة الحالية للمهام الصعبة، ومن دون خصم في سعر الرموز مقابل البقاء عليه.
تجاوزه عندما: تصبح الأعمال غير المكتملة المتكررة أعلى تكلفة من ترحيل مضبوط.
يدعم النموذجان مستويات جهد الاستدلال low وmedium وhigh وxhigh. وتحدد وثائق الاستدلال لدى xAI المستوى high بوصفه الافتراضي، وتوضح أن الاستدلال لا يمكن تعطيله. وهذا الإعداد المشترك high هو نقطة البداية العادلة لتقييم متناظر. أما تشغيل 4.7 على xHigh فينتمي إلى مسار منفصل، لأنه يغيّر ميزانية الجودة والرموز وزمن الاستجابة في آن واحد.
الفائز: تعادل في توافق الواجهة، وGrok 4.7 في توصية المزوّد الحالية. يقلل تشابه الواجهة جهد الترحيل، لكن توافق المعاملات لا يضمن تطابق اختيار الأدوات أو مخططات المخرجات أو سلوك التوقف أو أنماط إعادة المحاولة.
سعر Grok 4.7 عبر API: التعرفة نفسها وفاتورة مهمة مختلفة
يتطابق Grok 4.7 وGrok 4.6 في أسعار رموز API العامة، وفق التحقق من صفحة الأسعار الحالية لدى xAI في 21 سبتمبر 2026. فعندما يقل الطلب عن 200,000 رمز، تبلغ تكلفة كل منهما $0.002 لكل 1K من رموز الإدخال الجديدة، و$0.0005 لكل 1K من رموز الإدخال المخزنة مؤقتًا، و$0.006 لكل 1K من رموز الإخراج.
وعند بلوغ طلب الإدخال 200,000 رمز أو أكثر، تنتقل جميع رموز الطلب إلى تعرفة السياق الطويل: $0.004 لكل 1K من الإدخال الجديد، و$0.001 لكل 1K من الإدخال المخزن مؤقتًا، و$0.012 لكل 1K من الإخراج. نافذة بحجم 500,000 رمز هي سعة متاحة، وليست تصريحًا بحمل سجل وكيل غير محدود بتكلفة زهيدة.
هذه الصفوف حسابات دقيقة للرموز، وليست نتائج تشغيل فعلية للنموذجين. وهي تعزل عداد التسعير كي يكون السلوك هو العامل الحاسم في المقارنة.
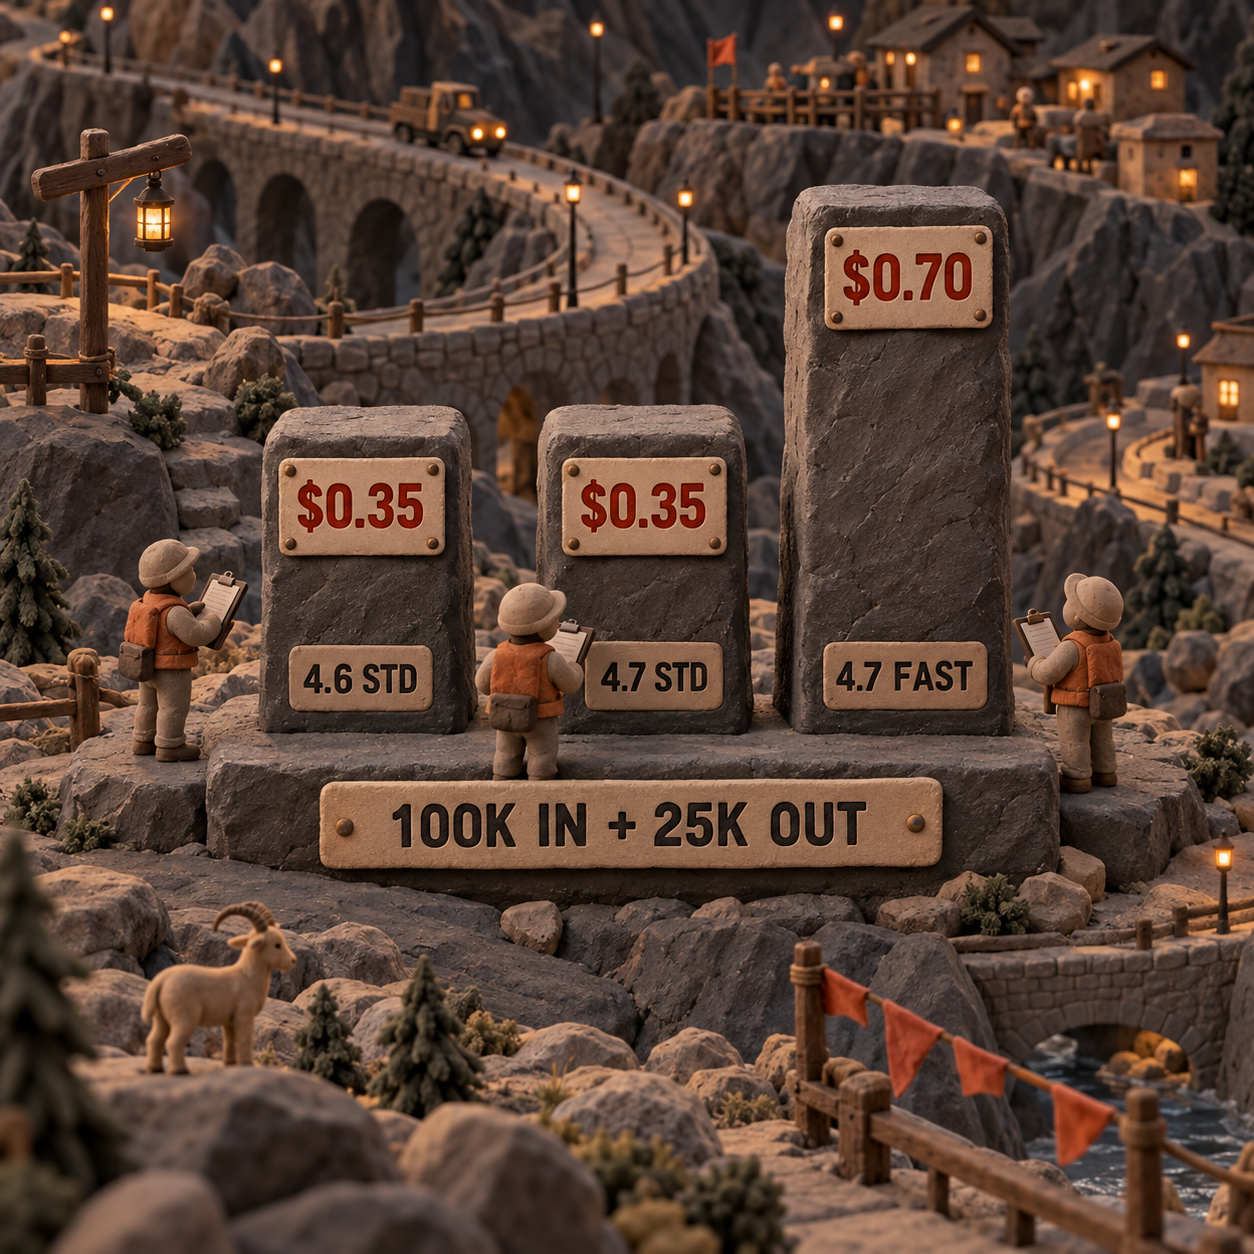
لا توجد نقطة تتقاطع عندها تعرفة الرموز بين هذين النموذجين؛ نقطة التحول هي العمل المكتمل:
cost per accepted task = total billed cost across all attempts / accepted tasks
إذا استهلك النموذجان العدد نفسه من الرموز المفوترة في كل محاولة، فإن أي زيادة في معدل المهام المقبولة تجعل 4.7 أقل تكلفة لكل مهمة مكتملة. وإذا أنفق 4.7 أكثر بسبب استدلال أطول، فعليه أن يحسن معدل قبول المهام بنسبة تفوق زيادة إنفاقه. فتساوي السعر المعلن لا يحمي من الاستدلال الإضافي أو إعادة المحاولات أو حلقات الأدوات أو المخرجات المطولة.
تحتاج خيارات Fast والأولوية إلى ميزانيات مستقلة:
- تبلغ تكلفة Grok 4.7 Fast تحت 200,000 رمز إدخال مبلغ $4 للإدخال، و$1 للإدخال المخزن مؤقتًا، و$12 للإخراج لكل مليون رمز. لذلك تبلغ تكلفة المثال الذي يضم 100K إدخال و25K إخراج مبلغ $0.70.
- لا يتاح Grok 4.7 Fast إلا عبر Cursor وGrok Build، وليس عبر API العامة لـxAI، كما أن الفئة المجانية في Grok Build لا تشمله.
- فوق 200,000 رمز إدخال، يسرد جدول Fast التفصيلي لدى xAI مبلغ $6 للإدخال، و$1.50 للإدخال المخزن مؤقتًا، و$18 للإخراج لكل مليون. استخدم هذه التعرفة المنشورة بدل تطبيق معامل ثابت على جميع الحالات.
- تفرض ميزة Priority Processing في API العامة علاوة 2× عندما تؤكد الاستجابة استخدام فئة خدمة الأولوية.
لا يدعم أي من النموذجين حاليًا Batch API. وتدخل رموز الاستدلال ضمن الاستهلاك، بينما تضيف أدوات API العامة عدادًا آخر. إذ تبلغ تكلفة كل من Web Search وCode Execution مبلغ $5 لكل 1,000 استدعاء. ولهذا يجب أن يسجل تقييمك الاستهلاك ورسوم الأدوات الواردة في الاستجابة، لا تقديرًا مبنيًا على طول الطلب وحده.
تشرح مراجعة Grok 4.5 السابقة سبب أهمية عتبة 200K في حلقات الوكلاء الطويلة. والدرس نفسه ينطبق هنا: اختصر السجل القديم قبل أن يضاعف تعرفة رموز الطلب بصمت.
الفائز: Grok 4.7 فقط عندما تتحسن حصيلة العمل المكتمل. إذا حقق النموذجان معدل النجاح نفسه، يفوز Grok 4.6 لأنه يتجنب أعمال الترحيل. وإذا تجاوز 4.7 حالات فشل كانت تفرض إعادة المحاولة أو الإصلاح البشري، يصبح تساوي تعرفة الرموز ميزة اقتصادية له.
تكلفة الانتقال تشغيلية لا تعاقدية
يتفوق Grok 4.6 في فئة الاستقرار لأن الاستمرار عليه لا يتطلب أي إعداد جديد. أما Grok 4.7 فعليه أن يعوض جهد التحقق من السلوك وتحديث المراقبة والإبقاء على مسار تراجع آمن.
احتفظ بعناصر الضبط التالية قبل تغيير معرّف النموذج:
- الطلب نفسه تمامًا، وسياسة النظام، ومخططات الأدوات، ولقطة المستودع، والمهلة الزمنية، وسياسة إعادة المحاولة.
- أدوات التحقق من المخطط، والاختبارات، وفحص الشفرة، وأوامر البناء، وأي قائمة قبول بشرية.
- سجلات منفصلة للإدخال الجديد، والإدخال المخزن مؤقتًا، والاستدلال، والإخراج، واستدعاءات الأدوات، والوقت المستغرق لكل محاولة.
- سجل للآثار الجانبية التي اكتملت قبل إعادة المحاولة أو التراجع. فإعادة تشغيل مهمة نُفذ جزء منها قد تكرر إجراءً ما.
- معرّف النموذج القديم داخل الإعدادات، لا مدفونًا في الشفرة، حتى يمكن إعادة عبء عمل واحد إلى 4.6 من دون التراجع عن تغييرات أخرى لا علاقة لها به.
توافق الطلب لا يعني توافق السلوك. فقد يستمر مخطط المخرجات المهيكلة في اجتياز التحليل مع فقدان حقل مطلوب. وقد يستدعي وكيل برمجي الأدوات نفسها، لكنه يتوقف قبل الاختبارات. وربما ينتهي وكيل بحث أسرع لأنه تخطى التحقق. وكلها حالات انحدار حتى لو نجح طلب HTTP.
أهم قيود Grok 4.7 هو قابلية نقل الأدلة: لا يخبرك رسم xAI ولا إعادة بناء متصفح واحد بكيفية أدائه في مستودعك. أما قيد Grok 4.6 فهو العكس: استقراره المعروف لا يصلح فئة من المهام يفشل فيها مرارًا. التقسيم الصحيح يبقي خط الأساس المعروف، ويوجه قائمة الأعمال الأصعب إلى النموذج المرشح.
لا تنتقل من Grok 4.6 قبل اجتياز اختبار المهام الثلاث
ينبغي أن تجتاز الترقية ثلاث مهام صغيرة داخل نسخ نظيفة من مستودع واحد قبل استقبال حركة الإنتاج. هذا فحص محدود لسير العمل، وليس معيارًا عامًا. استخدم مستوى الاستدلال high في كلا النموذجين، وثبّت جميع عناصر الضبط الأخرى، وتعامل مع أي تشغيل لـ4.7 على xHigh كتجربة مستقلة.
ثبّت ثلاثة اختبارات قبول
استخدم خطأً سبق إصلاحه، وميزة صغيرة تمتد عبر عدة ملفات، وترحيل اعتماد برمجي من المستودع نفسه. عرّف النجاح قبل أن يرى أي من النموذجين المهمة: ينجح اختبار الانحدار المستهدف، وتظل حزمة الاختبارات كاملة ناجحة، ويكتمل فحص الشفرة والبناء، وتتغير الملفات المطلوبة، ولا يتأثر أي سلوك غير ذي صلة.
أنشئ نسخة نظيفة لكل محاولة
ابدأ كل زوج من نموذج ومهمة من الالتزام البرمجي نفسه داخل نسخة عمل نظيفة. أعطِ النموذجين الطلب والملفات والأدوات والصلاحيات والمهلة الزمنية وعدد مرات إعادة المحاولة نفسها. ولا تسمح لأحدهما بأن يرث تعديل الآخر أو شرحه.
ابدأ بالإعداد المشترك
شغّل
grok-4.7وgrok-4.6علىhigh. وسجل معرّف النموذج المُعاد، والنجاح أو الفشل، والوقت المستغرق، والإدخال الجديد والمخزن مؤقتًا، واستهلاك الاستدلال والإخراج، ورسوم الأدوات، والمبلغ المفوتر. احتفظ بكل حالات الفشل ضمن النتائج. وشغّل 4.7 علىxhighفقط كتجربة تحمل تسمية مستقلة.اعتمد النموذج حسب فئة المهمة
قارن العمل المقبول والوقت المستغرق وإجمالي الفاتورة. انقل فقط الفئة التي يفوز فيها 4.7، واحتفظ بـ4.6 بوصفه قيمة التراجع، وأعد الفحص بعد أي تغيير في الطلب أو الأداة أو النموذج. ويظل النشر المختلط خيارًا سليمًا عندما تكون تكلفة مراقبته أقل من فائدته المقاسة.
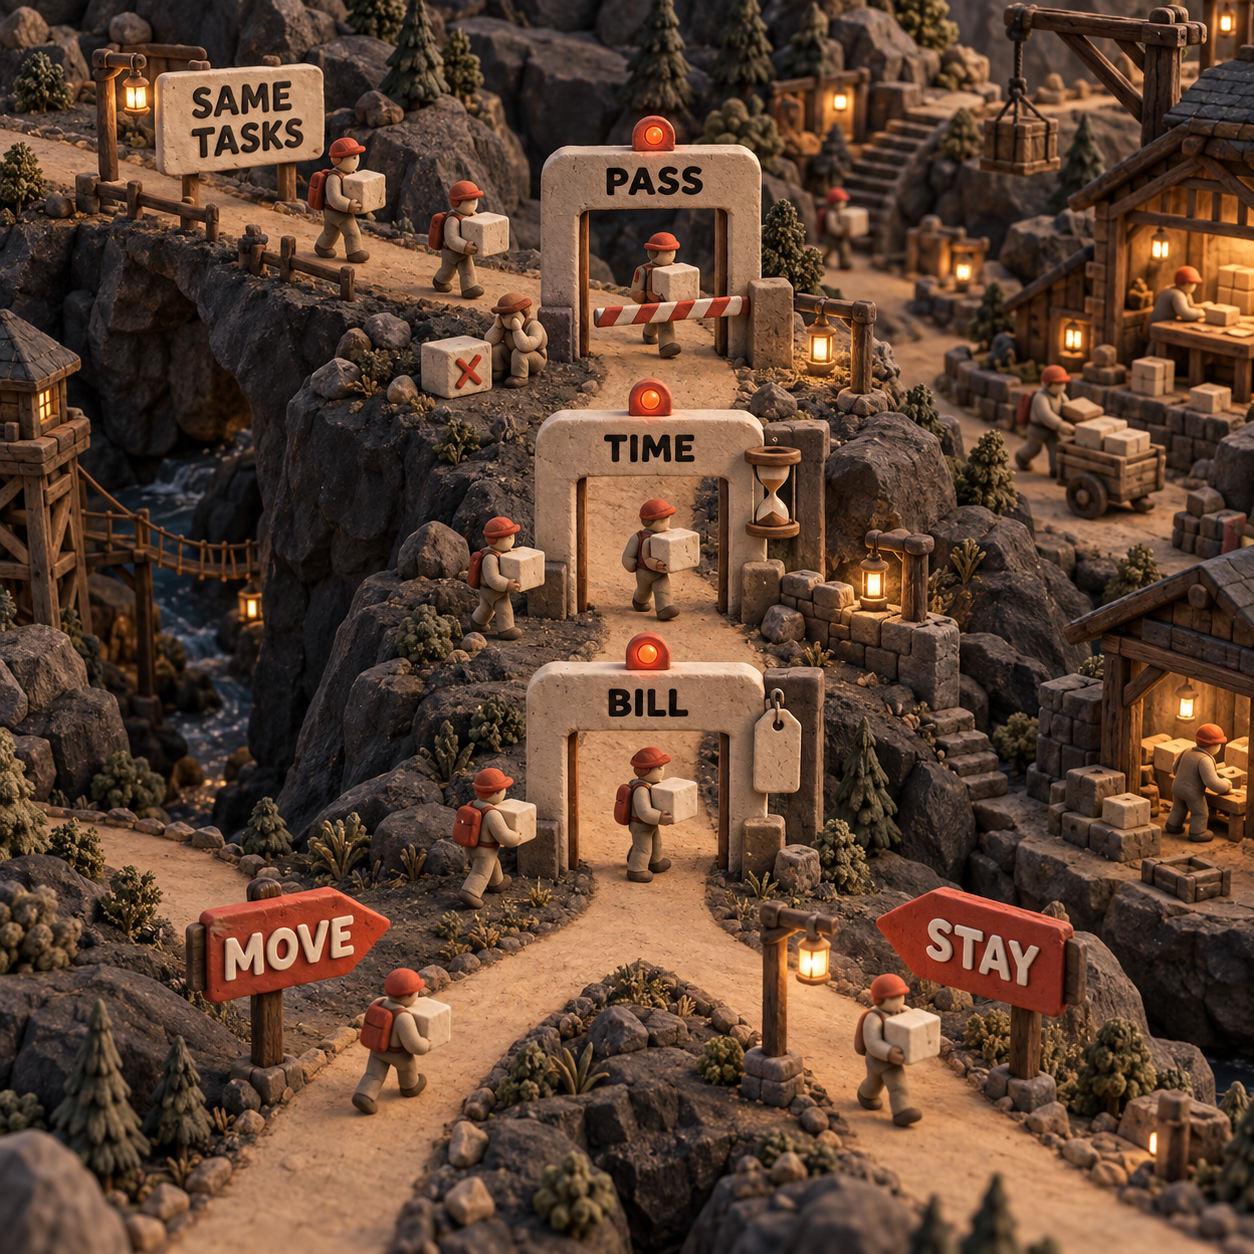
خطوة يوم الاثنين واضحة: استعد خطأً واحدًا معروفًا، واختر ميزة واحدة تمتد عبر عدة ملفات، وحدد تحديث اعتماد واحدًا من أعمال الشهر الماضي. شغّل هذه المهام الثلاث الأسبوع المقبل على High داخل نسخ نظيفة، وانشر كل حالة فشل في ورقة النتائج الداخلية، ولا تنقل إلا فئة المهام التي يبرر عملها المكتمل ووقتها المستغرق وفاتورتها الفعلية هذا التغيير.
أسئلة شائعة
ما أفضل إصدار من Grok للاستخدام؟
Grok 4.7 هو توصية xAI الحالية للبرمجة والعمل العام. ويظل Grok 4.6 الخيار التشغيلي الأفضل لأي تدفق ينجزه بموثوقية، إلى أن يفوز 4.7 في اختبار متناظر لعبء العمل.
هل Grok 4.6 جيد؟
نعم. فهو يوفر نافذة السياق الموثقة نفسها بحجم 500,000 رمز، والقدرات الأساسية نفسها للأدوات، وإعدادات الاستدلال نفسها، وأسعار API القياسية نفسها التي يوفرها 4.7. وتكمن نقطة ضعفه في أدائه الأقل وفق أرقام xAI في أصعب مقارنات البرمجة والعمل المعرفي.
ما أفضل نموذج Grok حاليًا؟
تصف xAI نموذج Grok 4.7 بأنه الأقوى لديها للبرمجة وسائر المهام. وهذا يجعله المرشح الأول للتقييم، لكنه لا يثبت أنه يتفوق على 4.6 في كل تدفق عمل منشور.
ما إصدارات Grok المختلفة؟
تحتفظ xAI بنماذج Grok للأغراض العامة، إلى جانب نماذج متخصصة للصور والفيديو والصوت. وفي قرار البرمجة والعمل المعرفي هذا، المعرّفان الموثقان المعنيان هما grok-4.7 وgrok-4.6؛ وارجع إلى دليل النماذج الحالي للاطلاع على القائمة الكاملة المتغيرة.
هل يوجد ما هو أفضل من Grok؟
لا يوجد نموذج يتفوق في كل مستودع وإعداد أدوات وهدف زمن استجابة وبوابة جودة. قارن المزوّدين وفق العمل المقبول لكل دولار، مستخدمًا المهام وعناصر الضبط نفسها، بدل التعامل مع معيار المزوّد على أنه ترتيب شامل.
ما مستويات Grok المختلفة؟
مستويات جهد الاستدلال في Grok 4.7 وGrok 4.6 هي low وmedium وhigh وxhigh. المستوى الافتراضي هو high، ولا يمكن تعطيل الاستدلال.
هل لدى Grok وضع 18+؟
هذا سؤال يتعلق بمنتج المستهلك ووضع الأمان، وليس فرقًا في القدرات بين معرّفي نموذجي API هذين. لذلك ينبغي ألا يؤثر في قرار ترحيل مهام البرمجة من Grok 4.6 إلى Grok 4.7.
كم تبلغ تكلفة Grok شهريًا؟
في استخدام API محل المقارنة هنا، تُحتسب التكلفة حسب الرموز واستدعاءات الأدوات الاختيارية، لا وفق رسم شهري ثابت لكل نموذج. وتُحدّث معلومات اشتراكات المستهلك والوصول المجاني وخطط Grok Build باستمرار في هل Grok مجاني؟.
ما جميع نماذج Grok؟
تتغير القائمة الكاملة مع إضافة xAI نسخًا من النماذج وإيقاف أخرى، ولذلك يظل دليلها الحالي المرجع المعتمد. ولأعمال البرمجة والمعرفة العامة، توجه xAI المستخدمين حاليًا إلى Grok 4.7.
هل تريد إعدادًا جاهزًا لتقييم وكلاء البرمجة؟ احصل على قائمة إعداد Claude Code وCodex مع النشرة البريدية.
- آخر تحديث
- 21 سبتمبر 2026
- التصنيف
- AI
فضّل هذا الموقع في Google


اجعل omidsaffari.com مصدرًا مفضّلًا، وسيرفعه Google لك في Top Stories وAI Overviews وAI Mode.

كيف ينجح وكيل الذكاء الاصطناعي في الاختبار ويفشل في الهدف
دراسة إنتاجية تكشف كيف اجتاز وكيل الذكاء الاصطناعي كل الاختبارات، ثم ابتعد عن هدف العمل، وما الضوابط التي تمنح الوكلاء مخرجًا آمنًا وتصحيحًا مستقلًا.21 سبتمبر 2026AI
أسعار Step 5 Preview: دليل تكلفة API وخطط Step Plan
دليل أسعار Step 5 Preview: قارن تكلفة توكنات API وخصم الإدخال المخزّن مؤقتًا مع أرصدة Step Plan، واختر مسار الفوترة المناسب لحمل عملك قبل الدفع.21 سبتمبر 2026AI
البحث بالذكاء الاصطناعي مع Nouswise: مراجعة قبل الشراء
مراجعة عربية لمنصة Nouswise للبحث بالذكاء الاصطناعي تشرح تضارب الأسعار، ونهج الاستشهاد بالمصادر، وحدود المستندات، ومتى تكون بدائل NotebookLM أنسب.10 سبتمبر 2026AI
الذكاء الاصطناعي في البناء: دليل أدوات مراجعة مستندات الاعتماد
قارن أفضل أدوات الذكاء الاصطناعي في البناء لمراجعة مستندات الاعتماد، من تتبع المصادر وإدارة الإصدارات إلى الأسعار وخطوات تجربة عملية قابلة للتدقيق.9 سبتمبر 2026AI
VetGeni أم ScribbleVet؟ دليل الذكاء الاصطناعي البيطري
مقارنة عملية بين VetGeni وScribbleVet في الأسعار، وحدود SOAP، وتكاملات PIMS، والقوالب، وعمل الفريق، لتحديد الأنسب للطبيب أو العيادة البيطرية.8 سبتمبر 2026AI
مراجعة InspectMind AI: هل تستحق تكلفة فحص المخططات؟
مراجعة InspectMind AI لفحص مخططات البناء: تعرّف على الأسعار وآلية العمل وحدود الدقة، ومتى تختصر الأداة وقت المراجعة المهنية ومتى لا تناسب فريقك.8 سبتمبر 2026AI
الذكاء الاصطناعي في البناء: متى تختار BuildSync أو SpecLens؟
مقارنة عملية بين BuildSync وSpecLens لاختيار أداة مراجعة الاعتمادات والمواصفات، مع تحليل التكاملات والتصدير والأسعار وحدود مراجعة مخططات البناء.8 سبتمبر 2026AI