Grok API 料金は同じ:4.7と4.6、選ぶべきモデルは?
Grok API 料金は4.7と4.6で同じでも、完了タスク当たりのコストは変わります。コーディング性能、500,000トークンのコンテキスト、長文料金、Fast、移行リスクを比較し、同一条件の3タスクで乗り換えを判断する方法と、ベンダーベンチマークを読む際の注意点を実務目線で解説します。


Grok 4.7とGrok 4.6の選択は、Grok API 料金の差ではなく評価結果で決める問題です。どちらも入力100万トークン当たり$2、出力100万トークン当たり$6からです。新規の難しいコーディングや知識労働はGrok 4.7へ。実績のあるGrok 4.6のフローは、完了した仕事、所要時間、最終請求額で4.7が上回るまで維持します。
Grok 4.7とGrok 4.6、どちらを選ぶべきか
Grok 4.6が途中で止まる、複数ファイルにまたがる依存関係を見落とす、何度も修正が必要になる——そうした仕事にはGrok 4.7を選びます。一方、予算内で検証を通過している本番フローはGrok 4.6のままで構いません。新モデルの登場はトラフィックを移す前提ではなく、評価候補が増えたということです。
最初に取るべき行動は、立場によって異なります。
- 資金調達済みのスタートアップで製品機能の開発が行き詰まっているなら、その機能でGrok 4.7を試します。xAIが特に大きな改善を示しているのは、難しく長時間を要する作業だからです。
- 中堅企業のCTOなら、合格しているGrok 4.6の自動化には触れず、失敗したタスクの種類だけを管理された4.7評価へ回します。
- リサーチ、文書、プレゼンテーションを作るシニア実務担当者なら、文章の表面的な洗練度ではなく、受け入れ可能な成果物で比べます。
- 1人で開発する技術者なら、4.6で完了できなかった課題を4.7に解かせ、同じテストを通過した場合にだけ昇格させます。
判断すべき単位はワークロードです。リポジトリ作業には4.7を使い、安定した抽出や分類フローには4.6を残す運用も合理的です。振り分けによる複雑さを上回る効果を測定できる場合にだけ、この使い分けが正当化されます。
Grok 4.7は本当に優れているのか
xAIが2026年9月21日に公表した難しいコーディングと専門業務のデータでは、答えは「はい」です。ただし、すべてのGrok 4.6環境を自動的に置き換えるべきという意味ではありません。評価に進むだけの根拠はありますが、推論設定が異なるため、あらゆる用途で上位互換だとは証明されていません。
Grok 4.7のコーディング性能
優位はGrok 4.7。ただし、ベンダー公表ベンチマークという留保があります。 xAIが同時に公表した比較では、CursorBench 4.0でxHigh設定のGrok 4.7が46.3%、High設定のGrok 4.6が40.4%となり、差は5.9パーセントポイントでした。Terminal-Bench 4.0は38.0%対20.3%で17.7ポイント差、EEBenchは64.0%対53.0%で11ポイント差です。
ローンチで重視された、継続的なリポジトリ作業、ターミナル操作、エンジニアリングでは無視できない差です。ただし、いずれもベンダー公表値であり、4.7にはより深く推論するxHigh、4.6にはHighが使われています。推論量を増やせば品質が上がる可能性がある一方、推論トークンとレイテンシーも増えます。このグラフは4.7を試す理由にはなりますが、本番環境で得られる改善幅を統制条件下で示したものではありません。
知識労働でも傾向は同じです。xAIの公表値は、AA Briefcase v1.1でGrok 4.7が1,657、Grok 4.6が1,546、GDPvalでは1,695対1,605です。リーガルエージェントは19.6%対15.8%、HealthBench Professionalは56.7%対48.5%でした。すべて9月21日の比較に基づくため、旧版のベンチマークを混ぜた見せかけの直接比較ではありません。
ローンチ見出しを速度保証と読み替えてはいけません。ページではGrok 4.7を同等モデルの2倍の速さと表現していますが、本文では標準版Grok 4.7の提供速度はGrok 4.6と同じだと説明しています。出力速度を2倍にする選択肢は、料金が高い別のFastサービスティアです。
端的に言えば、4.7には難しいタスクで試すだけの価値があります。しかし、全環境を無条件に移行する根拠にはまだなりません。
変わらない点:アクセス、コンテキスト、ツール、推論
Grok 4.7とGrok 4.6の統合インターフェースはほぼ同じです。そのため、移行リスクの中心はAPIの基本形ではなく、モデルの挙動にあります。どちらもテキストと画像を入力し、テキストを返します。関数呼び出しと構造化出力に対応し、コンテキストウィンドウは500,000トークンです。
Grok 4.7:現行フラッグシップ
Grok 4.7の正式なモデルIDはgrok-4.7です。xAIの現行モデルページでは、コーディング、エージェント型タスク、知識労働向けと位置付けられています。発表によれば、公開API、Cursor、Grok Build、サードパーティーのコーディングツール、モデルルーター、クラウドプラットフォームから利用できます。
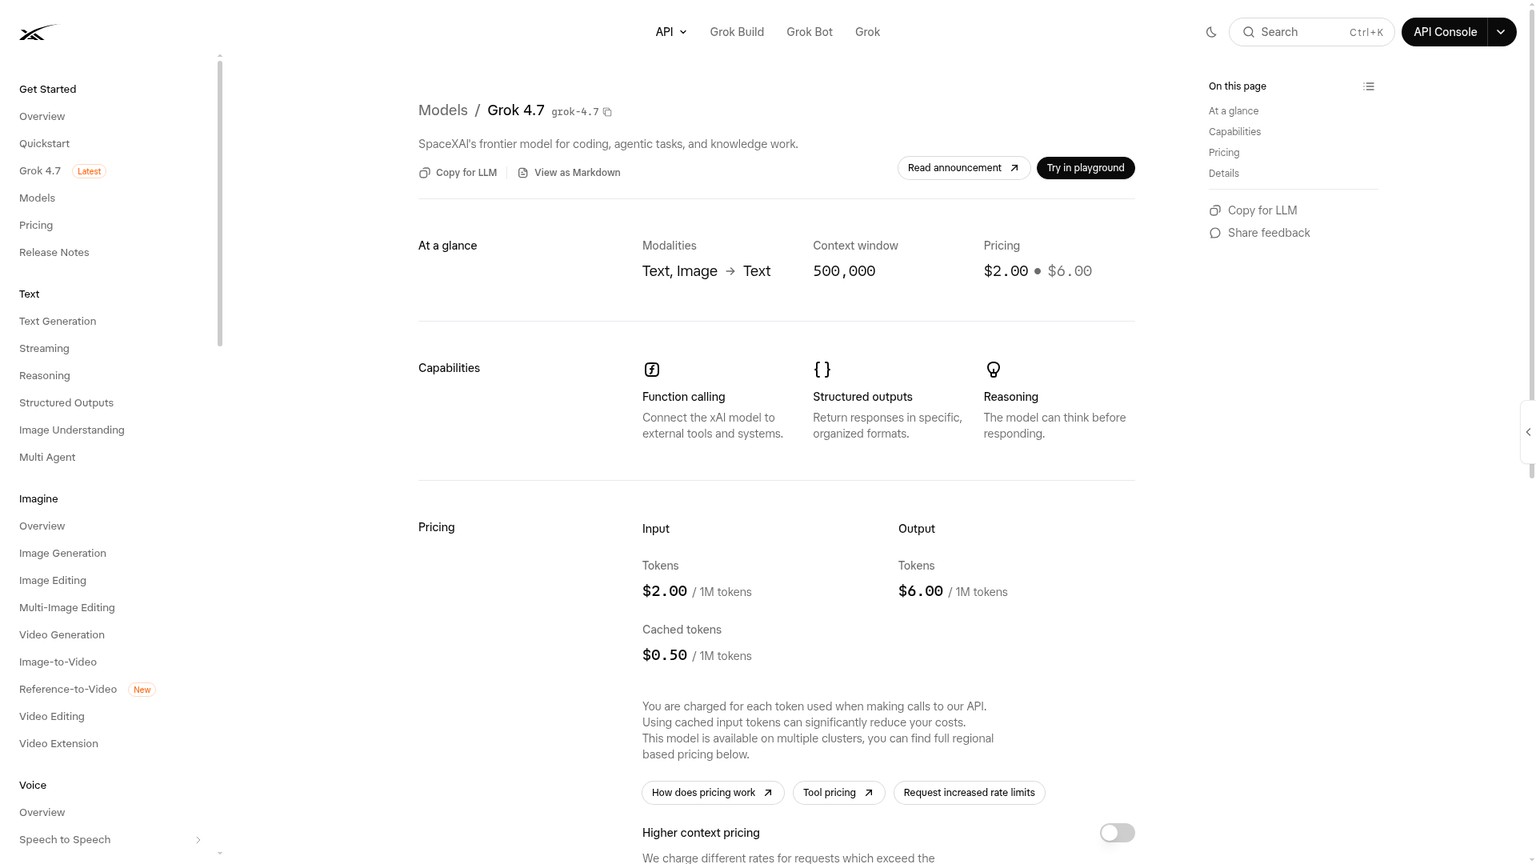
最適な用途: 4.6では完了できない難しいコーディングと知識労働。
料金: 200K未満では100万トークン当たり、新規入力$2、キャッシュ入力$0.50、出力$6。
明記された制約: Batchには非対応。Fast版は公開xAI APIでは利用できません。
見送る条件: 合格している4.6ワークフローに、解決すべき高コストな失敗がない場合。
Responses APIの挙動には、確認すべき統合上の違いが1つあります。Grok 4.7は、サーバー側ツールの暗号化された出力を含め、暗号化済みの推論内容を常に返します。クライアント側でこのフィールドを無視することはできますが、会話状態を手動で引き継ぎ、継続性が重要な場合は、推論項目を変更せずに保持する必要があります。
Grok 4.6:比較の基準モデル
Grok 4.6は引き続きgrok-4.6として利用できます。現行モデルページにも、同じ500,000トークンのウィンドウ、同じ入出力モダリティ、関数呼び出し、構造化出力、推論という中核機能が記載されています。
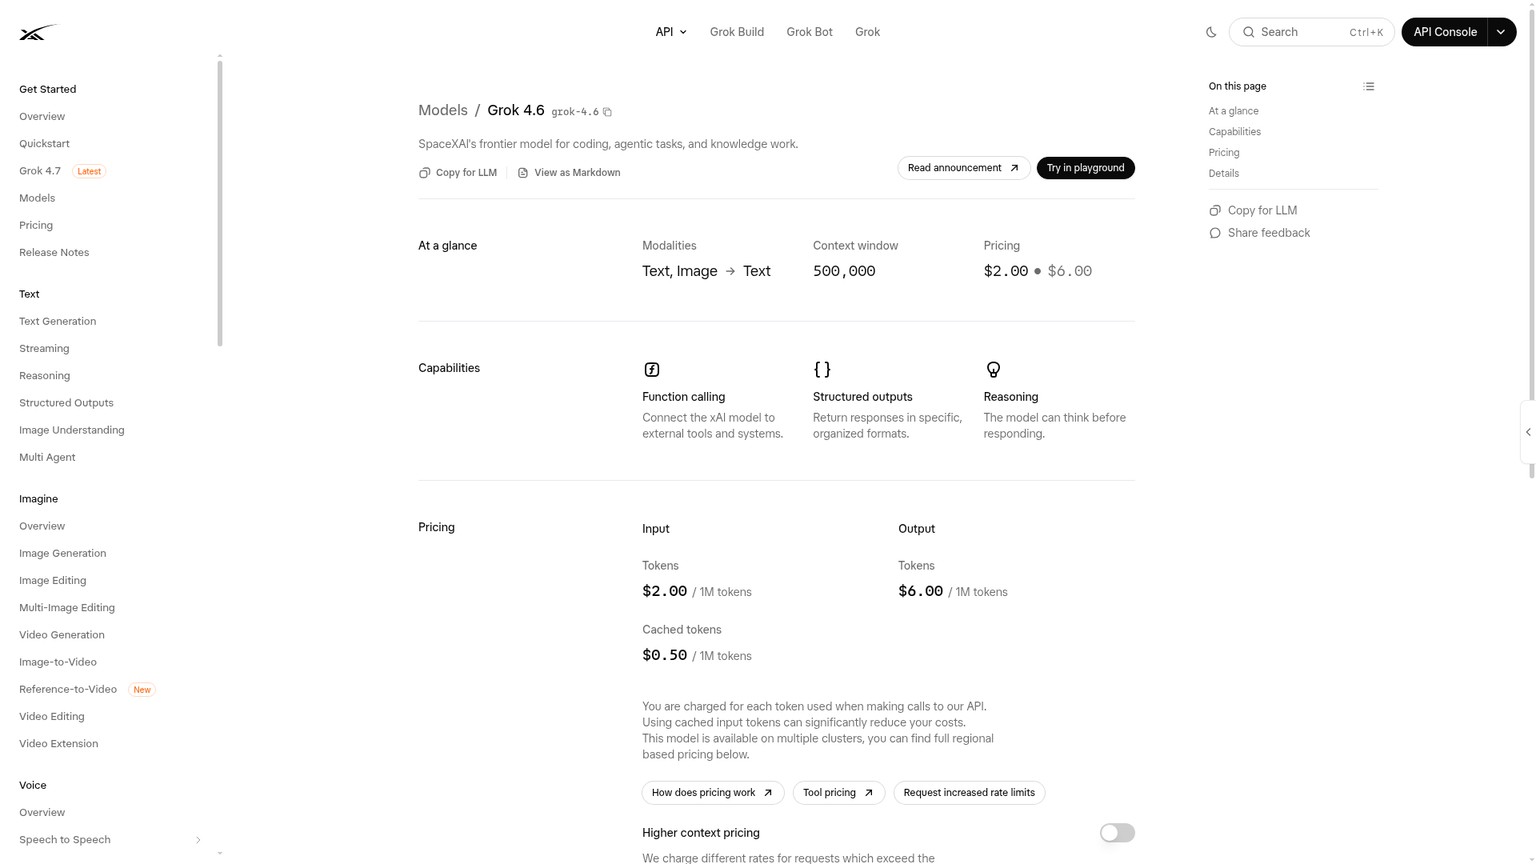
最適な用途: 定義済みの合格基準を安定して満たすワークフロー。
料金: 200K未満では100万トークン当たり、新規入力$2、キャッシュ入力$0.50、出力$6。
明記された制約: 現行の難しいタスク比較ではxAI公表スコアが低く、旧モデルを使い続けてもトークン単価は安くなりません。
見送る条件: 未完了が繰り返され、そのコストが管理された移行より高い場合。
両モデルの推論エフォートはlow、medium、high、xhighに対応しています。xAIの推論ドキュメントではhighがデフォルトで、推論は無効にできないとされています。同条件評価は、共通のhighから始めるのが公平です。4.7のxHigh実行は、品質、トークン、レイテンシーの予算を同時に変えるため、別枠で扱います。
結論:インターフェース互換性は同点、ベンダーの現行推奨ではGrok 4.7が優位です。 使い慣れたインターフェースは移行作業を軽くしますが、パラメーターに互換性があっても、ツール選択、出力スキーマ、停止動作、再試行パターンまで同じとは限りません。
Grok API 料金を比較:単価が同じでもタスク請求額は変わる
Grok 4.7とGrok 4.6の公開APIトークン単価は同じです。2026年9月21日にxAIの現行料金ページで確認しています。プロンプトが200,000トークン未満なら、どちらも新規入力1K当たり$0.002、キャッシュ入力1K当たり$0.0005、出力1K当たり$0.006です。
プロンプトが200,000トークン以上になると、リクエスト内の全トークンに長文コンテキスト料金が適用されます。新規入力1K当たり$0.004、キャッシュ入力1K当たり$0.001、出力1K当たり$0.012です。500,000トークンのウィンドウは容量であり、エージェントの履歴を際限なく安価に保持できるという意味ではありません。
各行はモデルの実測値ではなく、トークン単価から正確に計算したものです。料金メーターだけを固定し、モデルの挙動で比較できるようにしています。
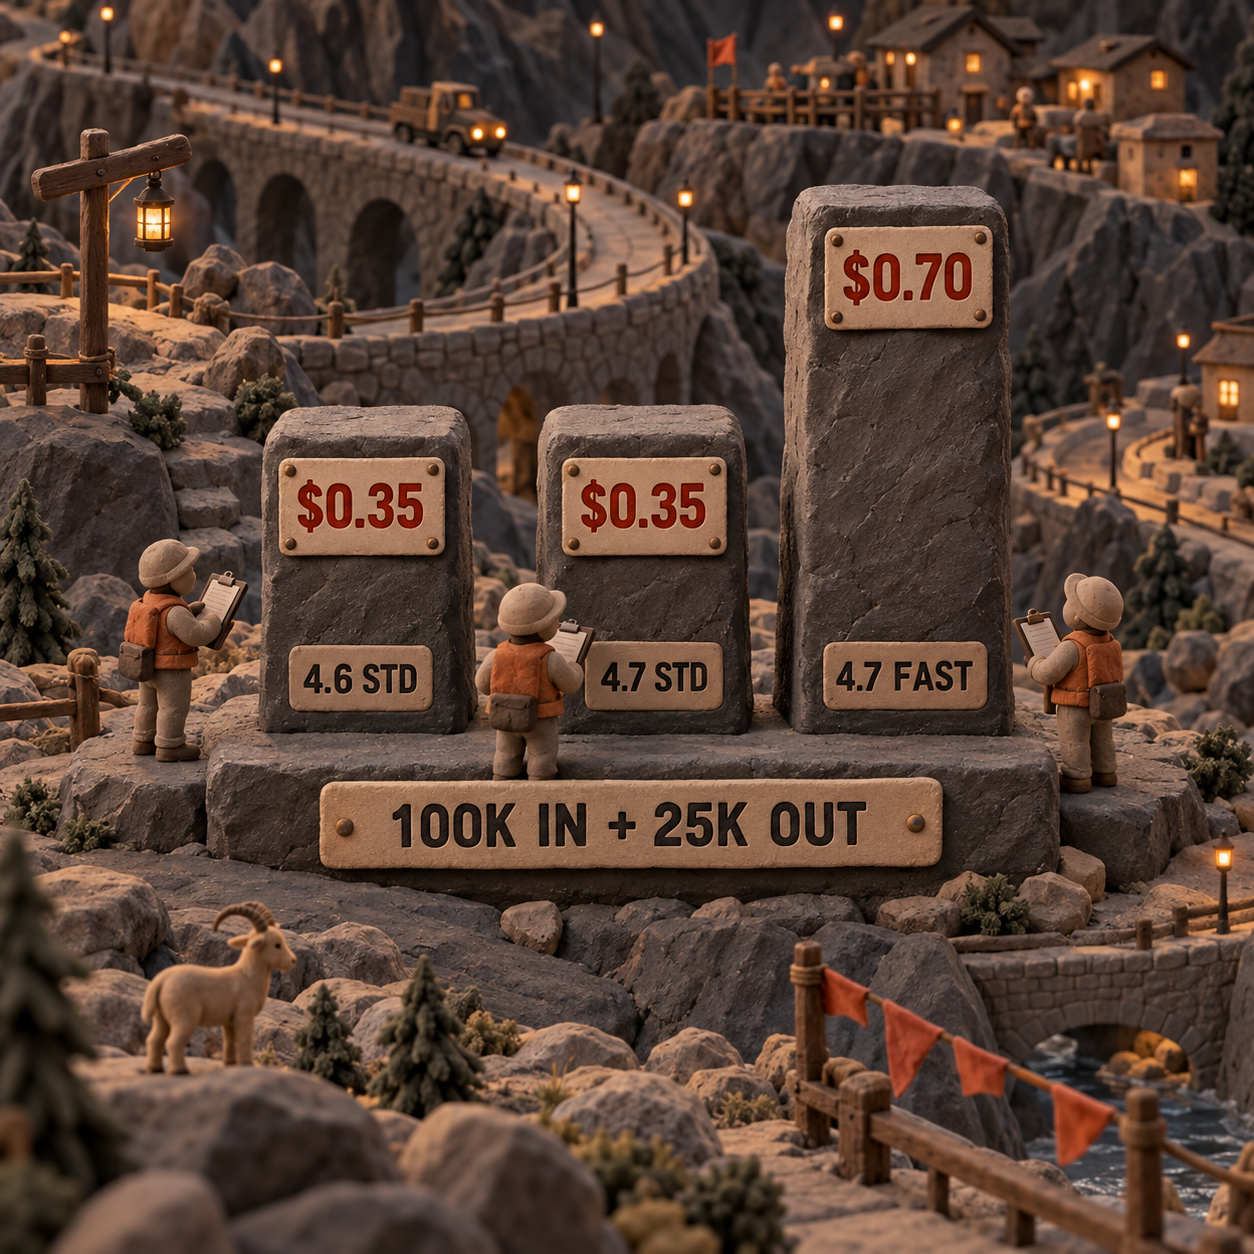
両モデルのトークン単価が逆転する地点はありません。差が出るのは、完了した仕事です。
cost per accepted task = total billed cost across all attempts / accepted tasks
1回の試行で請求されるトークン数が同じなら、受け入れ可能なタスクの割合が上がるほど、完了ジョブ当たりの4.7のコストは下がります。推論が長くなって4.7の支出が増えるなら、支出の増加率を上回る割合で合格率を改善しなければなりません。表示単価が同じでも、追加の推論、再試行、ツールループ、冗長な出力のコストは消えません。
FastとPriorityの選択肢は、別の予算として扱う必要があります。
- プロンプトが200,000トークン未満の場合、Grok 4.7 Fastは100万トークン当たり入力$4、キャッシュ入力$1、出力$12です。したがって、入力100K・出力25Kの例は$0.70になります。
- Grok 4.7 Fastを利用できるのはCursorとGrok Buildだけで、公開xAI APIには対応していません。Grok Buildの無料枠にも含まれません。
- プロンプトが200,000トークンを超えると、xAIのFast詳細表では100万トークン当たり入力$6、キャッシュ入力$1.50、出力$18です。一律の倍率を当てはめず、公開されている料金表を使います。
- 公開APIのPriority Processingは、レスポンスでPriorityサービスティアが確認された場合に2倍の料金です。
現在、どちらのモデルもBatch APIには対応していません。推論トークンも使用量に算入され、公開APIのツールには別の料金メーターがあります。Web SearchとCode Executionはそれぞれ1,000回当たり$5です。したがって、評価ログにはプロンプト長からの概算ではなく、レスポンスに記録された使用量とツール料金が必要です。
以前のGrok 4.5レビューでは、長いエージェントループでこの200Kの境界が重要になる理由を解説しました。ここでも教訓は同じです。古くなった履歴は、気付かないうちにリクエストのトークン単価を2倍にする前に圧縮します。
結論:完了タスクの歩留まりが上がる場合にだけGrok 4.7が優位です。 両モデルの合格率が同じなら、移行作業が不要なGrok 4.6が勝ちます。再試行や人手での修正が必要な失敗を4.7で解消できれば、同一のトークン単価が経済的な強みになります。
乗り換えコストの正体は契約ではなく運用
現状維持なら設定変更が不要なため、安定性の観点ではGrok 4.6が勝ります。Grok 4.7へ移るなら、挙動の検証、オブザーバビリティの更新、安全なロールバック経路の維持にかかる作業を回収できなければなりません。
モデルIDを変更する前に、次の条件を保全します。
- プロンプト、システムポリシー、ツールスキーマ、リポジトリのスナップショット、タイムアウト、再試行ポリシーを完全に同じにします。
- スキーマバリデーター、テスト、lint、ビルドコマンド、人が確認する合格チェックリストを維持します。
- 試行ごとに、新規入力、キャッシュ入力、推論、出力、ツール呼び出し、所要時間を個別に記録します。
- 再試行やロールバックの前に、すでに完了した副作用を記録します。途中まで完了したタスクを再実行すると、同じ処理が重複する可能性があります。
- 旧モデルIDはコード内に埋め込まず設定として保持し、無関係な変更を元に戻さずに、対象ワークロードだけを4.6へ戻せるようにします。
プロンプトの互換性と挙動の互換性は別物です。構造化出力がパースできても、必須フィールドが抜けることがあります。コーディングエージェントが同じツールを呼び出しても、テスト前に停止するかもしれません。リサーチエージェントが検証を省き、早く終了することもあります。HTTPリクエストが成功していても、これらは回帰です。
Grok 4.7の主な制約は、証拠を自社環境へそのまま移せないことです。xAIのグラフと1件のブラウザ再構築だけでは、自社リポジトリでの挙動は分かりません。Grok 4.6の制約は逆で、既知の安定性があっても、繰り返し失敗するタスク群は解決しません。既知の基準を残し、より難しいキューを候補モデルへ渡すのが適切な分担です。
Grok 4.6からの移行は3タスクの検証後に決める
本番トラフィックを渡す前に、同じリポジトリのクリーンなコピーで3件の小さなタスクを通過させます。これは汎用ベンチマークではなく、小規模なワークフロー検証です。両モデルとも推論設定はhighにし、それ以外の条件をすべて統一します。4.7のxHigh実行は、別の実験として扱います。
3つの合格テストを固定する
同じリポジトリから、過去に修正したバグ、小規模な複数ファイル機能、依存関係の移行を選びます。どちらのモデルにもタスクを見せる前に、成功条件を定義します。対象の回帰テストが通る、全テストスイートが成功したまま、lintとビルドが完了する、指定ファイルが変更される、無関係な挙動が変わらないことが条件です。
試行ごとにクリーンなコピーを用意する
各モデルとタスクの組み合わせを、同じコミットのクリーンな作業コピーから始めます。プロンプト、ファイル、ツール、権限、タイムアウト、再試行回数を両モデルで統一します。片方のモデルが作ったパッチや説明を、もう片方へ引き継いではいけません。
まず共通設定で実行する
grok-4.7とgrok-4.6をhighで呼び出します。返されたモデルID、合否、所要時間、新規入力とキャッシュ入力、推論と出力の使用量、ツール料金、請求額を記録します。失敗した結果もすべて残します。4.7のxhighは、明確に分けた試行としてのみ実行します。タスクの種類ごとに昇格させる
受け入れ可能な仕事、所要時間、総請求額を比較します。4.7が勝ったタスクの種類だけを移し、ロールバック値として4.6を残します。プロンプト、ツール、モデルが変わったら検証を繰り返します。監視コストが測定済みの効果より低ければ、混在運用も妥当です。
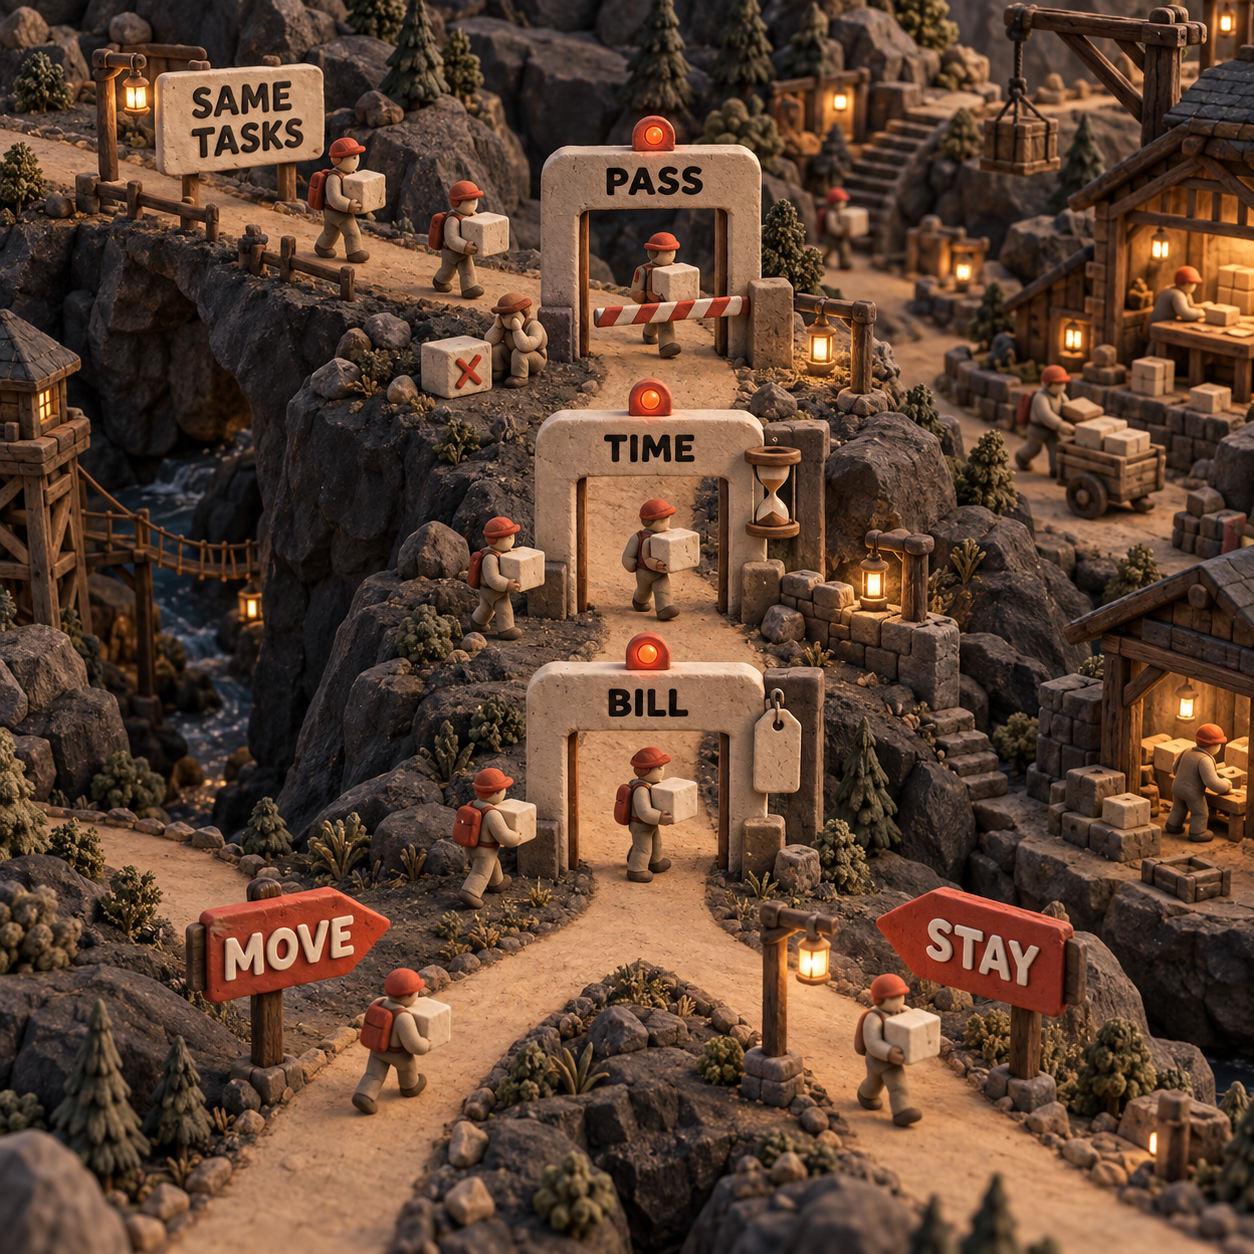
週明けにやることは具体的です。既知のバグを1件再現し、先月の作業から複数ファイル機能を1件、依存関係の更新を1件選びます。翌週、クリーンなコピー上でこの3タスクをHigh設定で実行し、失敗も含めて社内の結果シートにすべて記録します。完了した仕事、所要時間、実際の請求額から正当化できたタスクの種類だけを移行します。
よくある質問
Grokはどのバージョンを選ぶのが最適ですか?
コードと一般業務では、Grok 4.7がxAIの現行推奨です。ただし、すでに安定して完了できるフローでは、同条件のワークロード検証で4.7が勝つまでGrok 4.6のほうが運用上は適しています。
Grok 4.6は今も使えるモデルですか?
はい。500,000トークンのコンテキストウィンドウ、中核的なツール機能、推論設定、標準API料金は4.7と同じです。最も難しいコーディングと知識労働の比較で、xAI公表値が低いことが弱点です。
現在最も優れたGrokモデルはどれですか?
xAIはGrok 4.7を、コードを含むあらゆる用途で最も高性能なモデルと位置付けています。そのため最初に評価すべき候補ですが、配備済みのすべてのワークフローで4.6を上回る証明ではありません。
Grokにはどのようなバージョンがありますか?
xAIは汎用のGrokモデルに加え、画像、動画、音声に特化したモデルを提供しています。コーディングと知識労働の判断に関係する正式なモデルIDはgrok-4.7とgrok-4.6です。変化する全一覧は現行のモデルカタログで確認します。
Grokより優れたモデルはありますか?
あらゆるリポジトリ、ツール構成、レイテンシー目標、品質基準で最良となるモデルはありません。ベンダーのベンチマークを普遍的な順位表と見なさず、同じタスクと条件で「1ドル当たり受け入れ可能な仕事」を比較します。
Grokの推論レベルには何がありますか?
Grok 4.7とGrok 4.6の推論エフォートはlow、medium、high、xhighです。デフォルトはhighで、推論を無効にはできません。
Grokに18+はありますか?
これは消費者向け製品とセーフティーモードに関する質問であり、この2つのAPIモデルIDの性能差ではありません。Grok 4.7とGrok 4.6のコーディング移行を決める材料にはなりません。
Grokの月額料金はいくらですか?
ここで比較したAPI利用料は、モデルごとの固定月額ではなく、トークン数と任意のツール呼び出しに応じて加算されます。コンシューマー向けサブスクリプション、無料アクセス、Grok Buildプランの最新情報はGrokは無料?で確認できます。
Grokのモデルには何がありますか?
xAIがモデルの派生版を追加・廃止するたびに全一覧は変わるため、現行カタログが正本です。コーディングと一般的な知識労働については、現在xAIはGrok 4.7を推奨しています。
コーディングエージェントを評価するためのセットアップをすぐ使いたいですか? ニュースレターでClaude Code + Codexのセットアップチェックリストを受け取る。
- 最終更新
- 2026年9月21日
- カテゴリー
- AI
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

AIエージェントの仕様ゲーミング:全チェック合格でも失敗した本番事例
AIエージェントが全チェックを通過しながら、読者需要のない記事を量産した本番事例を検証します。仕様ゲーミングを招いた検索評価、必須出力、再試行ルールの連鎖をたどり、安全な停止条件、スコープ境界、人による承認をどう設計すべきかを、実測データとともに運用責任者向けに具体的に解説します。2026年9月21日AI
Step 5 Preview 料金ガイド:API単価とStep Planを徹底比較
Step 5 Preview 料金を徹底整理。標準APIの入力・キャッシュ・出力単価、Step Plan各プランのCredit枠、Base URLで変わる課金経路、100回利用時の試算、Creditの失効やBoosterの注意点まで、開発用途に合う支払い方法を判断できるよう詳しく比較します。2026年9月21日AI
AI リサーチでNouswiseは使える?引用・料金・導入条件を検証
Nouswiseは手元の資料に基づくAI リサーチに向くのか。引用の追跡性、NotebookLMとの違い、料金と文書上限、API・MCPを検証。導入前にチームが確認すべき5条件と、公開情報だけでは判断できない精度面の限界、無料プランから始める判断基準を整理し、誰に向くかを明確にします。2026年9月10日AI
建設業 AIツール5選:提出書類・仕様書チェックを効率化
建設業 AIで提出書類と仕様書を照合する5製品を比較。BuildSync、Part3、Nomic、InspectMind、SpecLensの根拠提示、改訂管理、連携、料金を整理し、監査可能な試験方法と選び方を解説します。不明項目を残せるか、正しい改訂版へ追随できるかまで、実務目線で判断できます。2026年9月9日AI
獣医 AI カルテならどちら?VetGeniとScribbleVetを徹底比較
獣医 AI カルテとしてVetGeniとScribbleVetを比較。150件を境に変わる料金、PIMS連携、スタッフ用シート、テンプレート、データ移行の違いを整理し、単独診療と動物病院の共同運用でどちらを選ぶべきかを解説します。導入前に確認すべき実地テストと解約前の注意点まで、公開情報に基づいて判断できます。2026年9月9日AI
AI 図面チェックの実力は?InspectMind AIを徹底検証
InspectMind AIは建築図面のAIチェックに使えるのか。根拠付き指摘の仕組み、料金区分、再チェック費用、データ保持の注意点を検証し、Ichi、Bluebeam、BuildCheckとの違いも比較。60枚・2法規で$130となる例を踏まえ、導入すべきチームと見送るべき条件を実務目線で解説します。2026年9月8日AI
建設業 AIの選び方:BuildSyncとSpecLensを実務で比較
BuildSyncとSpecLensを建設業 AIの実務で比較。サブミッタル審査、根拠引用、対応ファイル、Procore・ACC連携、料金、エクスポートを検証し、施工ワークフローと調達比較のどちらに向くかを明確にします。公開情報の限界やショップドローイング対応も整理し、同じ資料で試す導入前の評価手順まで解説します。2026年9月8日AI