Grok 4.7 vs Grok 4.6: cuál conviene y cuándo migrar
Grok 4.7 vs Grok 4.6: compare rendimiento, contexto, precios y costo por tarea para decidir qué modelo probar y qué flujos conviene mantener.


Comparar Grok 4.7 vs Grok 4.6 es una decisión de evaluación, no de precio: ambos parten de $2 por cada millón de tokens de entrada y $6 por cada millón de tokens de salida. Conviene asignar a Grok 4.7 las nuevas tareas difíciles de programación y conocimiento, y mantener en Grok 4.6 los flujos ya probados hasta que 4.7 gane en trabajo completado, tiempo transcurrido y costo final.
Grok 4.7 vs Grok 4.6: ¿cuál conviene elegir?
Elija Grok 4.7 para las tareas en las que Grok 4.6 se detiene antes de terminar, pasa por alto una dependencia entre archivos o exige correcciones reiteradas. Mantenga Grok 4.6 en cualquier flujo de producción que ya supere sus controles sin salirse del presupuesto. Un modelo más reciente merece recibir tráfico de prueba, pero no justifica trasladar todas las cargas de trabajo.
Por eso, el primer paso cambia según el perfil:
- Un fundador con capital y una función de producto bloqueada debería probar Grok 4.7 en esa función, porque las mayores mejoras que reporta xAI aparecen en trabajos difíciles y prolongados.
- El CTO de una empresa mediana debería dejar intactas las automatizaciones de Grok 4.6 que ya funcionan y enviar las clases de tareas fallidas a una evaluación controlada de 4.7.
- Un profesional sénior que prepara investigaciones, documentos o presentaciones debería comparar entregables aceptados, no el acabado de la redacción.
- Un desarrollador técnico independiente debería encargar a 4.7 el problema que 4.6 no pudo resolver y adoptarlo solo si el resultado supera las mismas pruebas.
La decisión debe tomarse por carga de trabajo. Una empresa puede usar 4.7 para trabajar en repositorios y conservar 4.6 en un flujo estable de extracción o clasificación. Esa capa adicional de enrutamiento solo se justifica cuando el beneficio medido supera la complejidad operativa.
¿Grok 4.7 es mejor?
Sí, según la evidencia que xAI publicó el 21 de septiembre de 2026 sobre programación difícil y trabajo profesional. No, si se interpreta como sustituto automático de todas las implementaciones de Grok 4.6. Los datos justifican evaluarlo, pero los distintos niveles de razonamiento impiden afirmar que sea una mejora universal.
Grok 4.7 para programación
Ganador: Grok 4.7, con la salvedad de que las pruebas pertenecen al proveedor. En la comparación publicada por xAI junto con el lanzamiento, Grok 4.7 con xHigh obtuvo 46.3% en CursorBench 4.0 frente a 40.4% de Grok 4.6 con High, una ventaja de 5.9 puntos porcentuales. En Terminal-Bench 4.0, los resultados fueron 38.0% y 20.3%, una diferencia de 17.7 puntos. En EEBench, la comparación fue de 64.0% frente a 53.0%, con 11 puntos de ventaja.
Son diferencias relevantes para las tareas que destaca el lanzamiento: trabajo sostenido en repositorios, uso de terminal e ingeniería. Aun así, son resultados proporcionados por el proveedor, y xAI concedió a 4.7 el nivel de razonamiento más profundo, xHigh, mientras 4.6 se ejecutó con High. Un mayor razonamiento puede elevar la calidad, pero también sumar tokens de razonamiento y latencia. El gráfico es una buena razón para probar 4.7, no una estimación controlada de la mejora que tendrá en producción.
La tendencia en trabajo de conocimiento es similar. xAI informa una puntuación de 1,657 para Grok 4.7 frente a 1,546 para Grok 4.6 en AA Briefcase v1.1, y de 1,695 frente a 1,605 en GDPval. En su prueba de agente jurídico, el resultado es 19.6% frente a 15.8%; en HealthBench Professional, 56.7% frente a 48.5%. Todas estas cifras proceden de la comparación del 21 de septiembre, por lo que no mezclan una versión anterior de las pruebas en una falsa confrontación directa.
El anuncio no debe convertirse en una promesa de velocidad. La página afirma que Grok 4.7 es dos veces más rápido que modelos comparables, pero en el texto aclara que la versión estándar de Grok 4.7 se sirve a la misma velocidad que Grok 4.6. La opción específica con velocidad de salida 2× corresponde a un nivel de servicio Fast separado y más caro.
La conclusión directa es que 4.7 se ha ganado una prueba con las tareas difíciles. Aún no se ha ganado una migración generalizada y sin controles.
Qué se mantiene igual: acceso, contexto, herramientas y razonamiento
Grok 4.7 y Grok 4.6 ofrecen superficies de integración casi idénticas, de modo que la mayor parte del riesgo de migración está en el comportamiento, no en la forma básica de la API. Ambos aceptan texto e imágenes, devuelven texto, admiten llamadas a funciones y salidas estructuradas, y ofrecen una ventana de contexto de 500,000 tokens.
Grok 4.7: el modelo insignia actual
Grok 4.7 utiliza el ID de modelo documentado grok-4.7. La página vigente del modelo de xAI lo presenta para programación, tareas con agentes y trabajo de conocimiento; el anuncio indica que está disponible mediante la API pública, Cursor, Grok Build, herramientas de programación de terceros, enrutadores de modelos y plataformas en la nube.
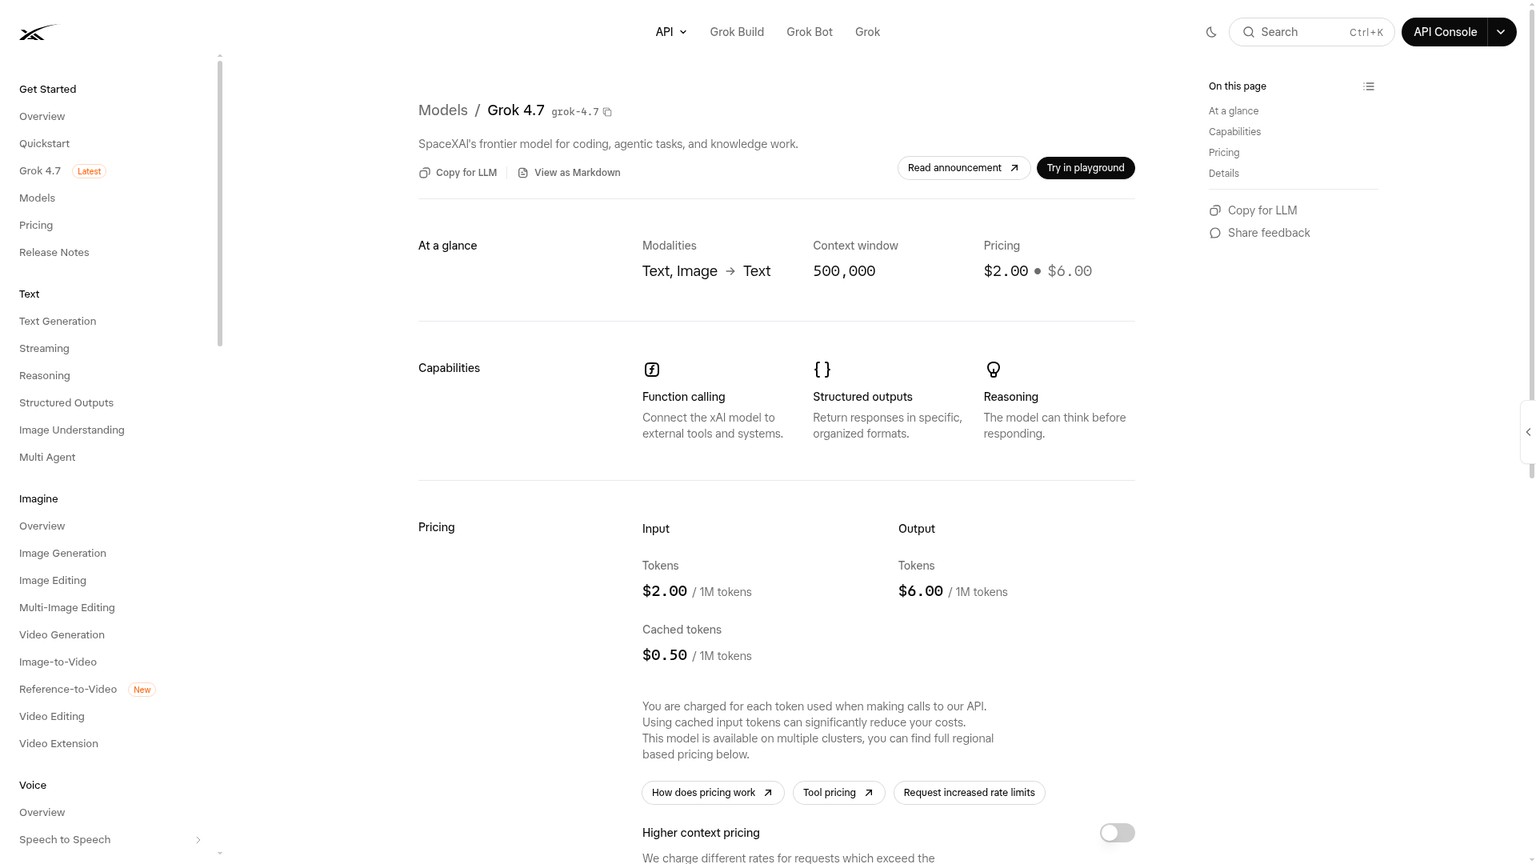
Ideal para: programación difícil y trabajo de conocimiento que 4.6 no consigue completar.
Precio: $2 por entrada nueva, $0.50 por entrada en caché y $6 por salida por cada millón de tokens por debajo de 200K.
Limitación declarada: no admite Batch, y la variante Fast no está disponible mediante la API pública de xAI.
Conviene evitarlo cuando: un flujo con 4.6 ya funciona y no hay ningún fallo costoso que corregir.
El comportamiento de su Responses API incluye un detalle de integración que conviene revisar: Grok 4.7 siempre devuelve el contenido de razonamiento cifrado, incluidas las salidas cifradas de herramientas del lado del servidor. Un cliente puede ignorar ese campo, pero si gestiona manualmente el estado de la conversación debe conservar sin cambios los elementos de razonamiento cuando la continuidad sea importante.
Grok 4.6: la referencia documentada
Grok 4.6 sigue disponible con el ID grok-4.6. Su página actual del modelo aún documenta la misma ventana de 500,000 tokens, las mismas modalidades de entrada y salida, y las mismas funciones esenciales de llamada a funciones, salida estructurada y razonamiento.
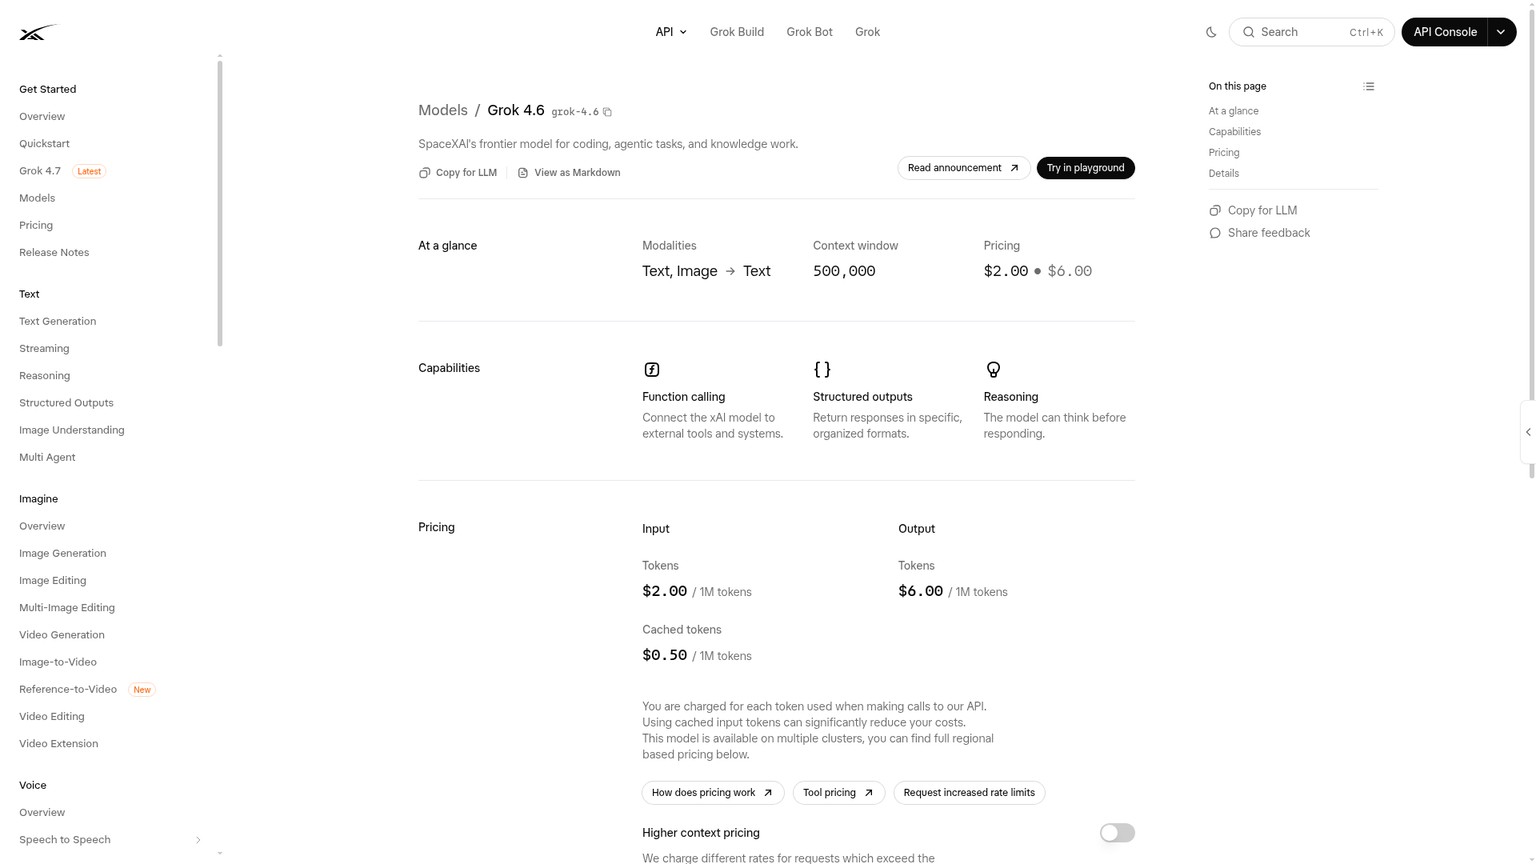
Ideal para: flujos estables que ya superan un criterio de aceptación definido.
Precio: $2 por entrada nueva, $0.50 por entrada en caché y $6 por salida por cada millón de tokens por debajo de 200K.
Limitación declarada: peores resultados reportados por xAI en la comparación actual de tareas difíciles, sin descuento en la tarifa de tokens por mantener el modelo anterior.
Conviene evitarlo cuando: el costo reiterado del trabajo inconcluso ya supera el de una migración controlada.
Ambos modelos permiten los niveles de razonamiento low, medium, high y xhigh. La documentación de razonamiento de xAI establece high como valor predeterminado e indica que el razonamiento no se puede desactivar. Ese nivel high compartido es el punto de partida justo para una prueba comparativa. Una ejecución de 4.7 con xHigh debe ir en una categoría separada, porque modifica al mismo tiempo los presupuestos de calidad, tokens y latencia.
Ganador: empate en compatibilidad de interfaz; Grok 4.7 en la recomendación actual del proveedor. La familiaridad de la interfaz reduce el esfuerzo de migración, pero usar parámetros compatibles no garantiza las mismas decisiones de herramientas, esquemas de salida, conductas de finalización o patrones de reintento.
Precio de la API de Grok 4.7: mismas tarifas, distinto costo por tarea
Grok 4.7 y Grok 4.6 tienen las mismas tarifas públicas de API por token, verificadas en la página de precios vigente de xAI el 21 de septiembre de 2026. Por debajo de 200,000 tokens de prompt, cada uno cuesta $0.002 por 1K tokens de entrada nueva, $0.0005 por 1K tokens de entrada en caché y $0.006 por 1K tokens de salida.
A partir de 200,000 tokens de prompt, todos los tokens de la solicitud pasan a la tarifa de contexto largo: $0.004 por 1K de entrada nueva, $0.001 por 1K de entrada en caché y $0.012 por 1K de salida. Una ventana de 500,000 tokens ofrece capacidad; no es una invitación a mantener sin control un historial de agente costoso.
Las filas muestran cálculos exactos con tokens, no ejecuciones observadas de los modelos. Aíslan el medidor de precios para que el comportamiento decida la comparación.
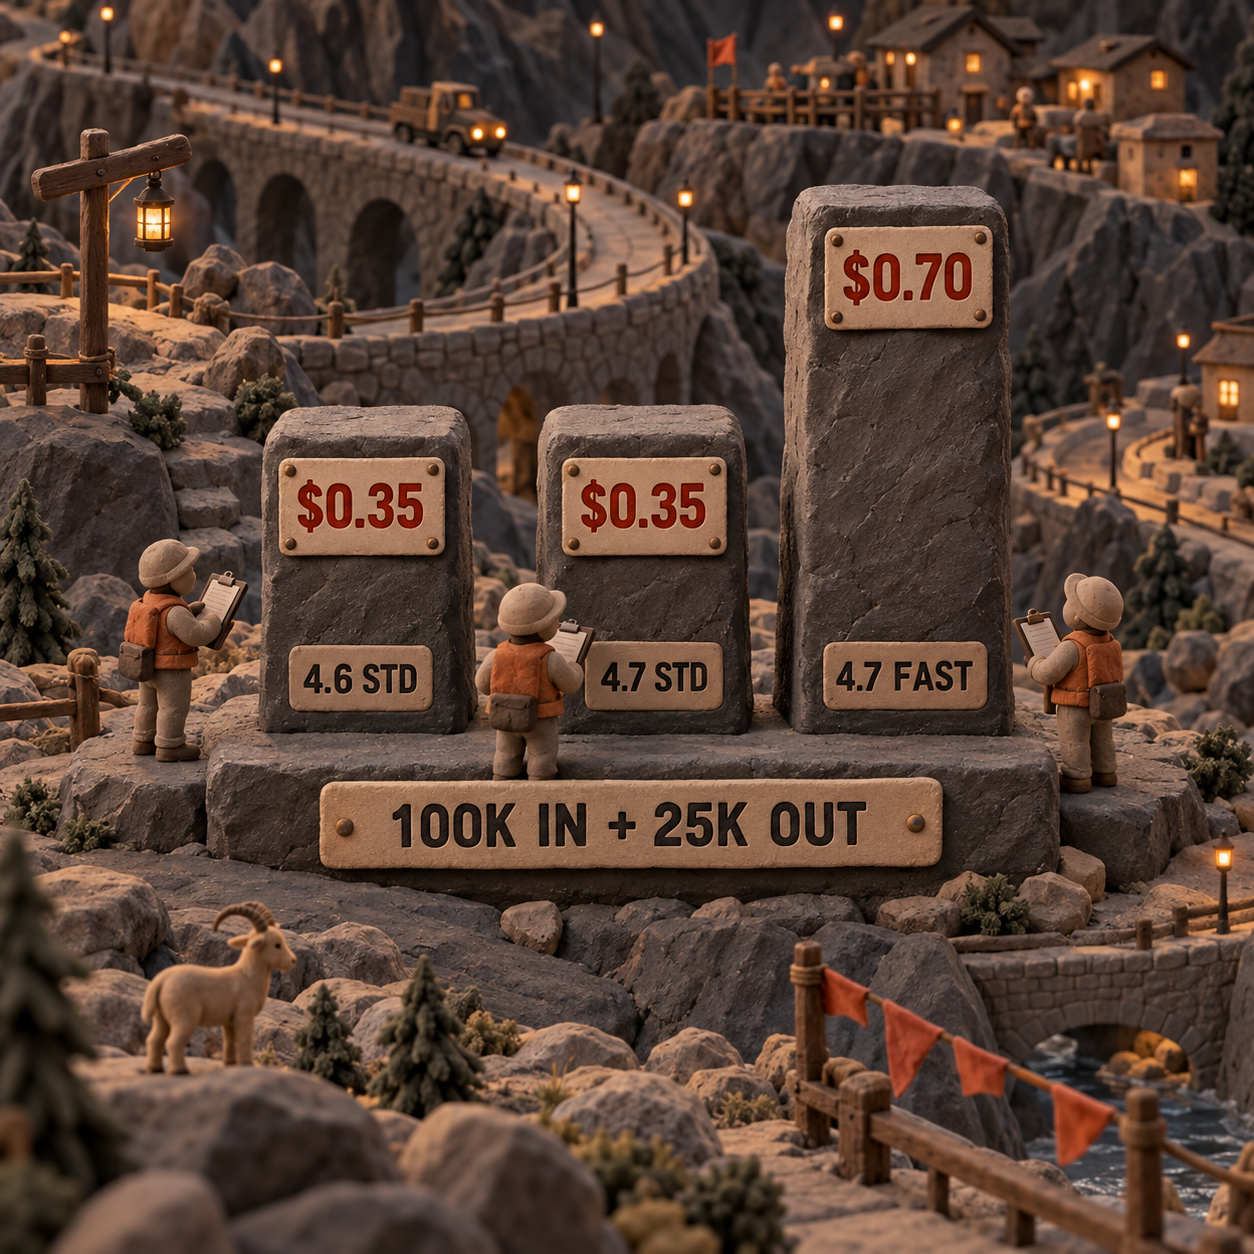
No existe un punto de cruce entre las tarifas por token de estos modelos. El punto de cruce está en el trabajo completado:
cost per accepted task = total billed cost across all attempts / accepted tasks
Si ambos modelos consumen la misma cantidad de tokens facturados por intento, cualquier aumento en la tasa de tareas aceptadas hace que 4.7 sea más barato por trabajo completado. Si 4.7 gasta más porque razona durante más tiempo, debe mejorar la tasa de aceptación en una proporción superior al aumento del gasto. Un precio de lista idéntico no protege frente a más razonamiento, reintentos, ciclos de herramientas o salidas extensas.
Las opciones Fast y de prioridad necesitan presupuestos separados:
- Grok 4.7 Fast por debajo de 200,000 tokens de prompt cuesta $4 de entrada, $1 de entrada en caché y $12 de salida por cada millón de tokens. Por tanto, el ejemplo de 100K de entrada y 25K de salida cuesta $0.70.
- Grok 4.7 Fast solo está disponible mediante Cursor y Grok Build, no mediante la API pública de xAI; además, el nivel gratuito de Grok Build no lo incluye.
- Por encima de 200,000 tokens de prompt, la tabla detallada de Fast de xAI indica $6 de entrada, $1.50 de entrada en caché y $18 de salida por millón. Debe aplicarse esa tarifa publicada, no un multiplicador general.
- Priority Processing de la API pública cobra un recargo de 2× cuando la respuesta confirma el nivel de servicio prioritario.
En este momento, ninguno de los dos modelos admite la API Batch. Los tokens de razonamiento cuentan para el consumo y las herramientas de la API pública agregan otro medidor. Web Search y Code Execution cuestan $5 por cada 1,000 llamadas cada uno. Por eso, el registro de evaluación debe recoger el uso y los cargos de herramientas que devuelve la respuesta, no una estimación basada únicamente en la longitud del prompt.
El análisis anterior de Grok 4.5 explica por qué este umbral de 200K importa en ciclos largos de agentes. La misma lección vale aquí: hay que compactar el historial obsoleto antes de que duplique silenciosamente las tarifas de tokens de la solicitud.
Ganador: Grok 4.7 solo cuando mejora el rendimiento del trabajo completado. Si ambos modelos aprueban en la misma proporción, Grok 4.6 gana porque evita el trabajo de migración. Si 4.7 resuelve fallos que obligan a reintentar o reparar manualmente, sus tarifas iguales por token se convierten en una ventaja económica.
El costo de cambiar es operativo, no contractual
Grok 4.6 gana en estabilidad porque no hay que configurar nada para mantenerlo. Grok 4.7 debe compensar el trabajo de validar su comportamiento, actualizar la observabilidad y conservar una vía segura de reversión.
Antes de cambiar el ID del modelo, mantenga estos controles:
- El prompt exacto, la política del sistema, los esquemas de herramientas, la instantánea del repositorio, el tiempo de espera y la política de reintentos.
- Los validadores de esquemas, las pruebas, el lint, los comandos de compilación y cualquier lista de aceptación humana.
- Registros separados de entrada nueva, entrada en caché, razonamiento, salida, llamadas a herramientas y tiempo transcurrido para cada intento.
- Un registro de los efectos secundarios ya completados antes de reintentar o revertir. Repetir una tarea parcialmente terminada puede duplicar una acción.
- El ID del modelo anterior en la configuración, no incrustado en el código, para que una carga de trabajo pueda regresar a 4.6 sin revertir cambios ajenos.
La compatibilidad de prompts no equivale a compatibilidad de comportamiento. Un esquema de salida estructurada puede seguir siendo válido aunque pierda un campo obligatorio. Un agente de programación puede llamar a las mismas herramientas, pero detenerse antes de ejecutar las pruebas. Un agente de investigación puede terminar antes porque omitió la verificación. Todos son retrocesos, aunque la solicitud HTTP haya funcionado.
La principal limitación de Grok 4.7 es la transferencia de evidencia: el gráfico de xAI y la reconstrucción de un navegador no revelan cómo se comportará en su repositorio. La limitación de Grok 4.6 es la contraria: su estabilidad conocida no resuelve una clase de tareas en la que falla repetidamente. La división adecuada conserva la referencia conocida y asigna la cola más difícil al candidato.
Migre desde Grok 4.6 solo después de esta prueba con tres tareas
Antes de recibir tráfico de producción, la actualización debería superar tres tareas pequeñas en copias limpias de un mismo repositorio. Es una comprobación breve del flujo, no una prueba general. Use el nivel de razonamiento high en ambos modelos, mantenga idénticos todos los demás controles y trate cualquier ejecución de 4.7 con xHigh como un experimento independiente.
Fije tres pruebas de aceptación
Utilice un error corregido anteriormente, una pequeña función que abarque varios archivos y una migración de dependencia del mismo repositorio. Defina el éxito antes de que cualquiera de los modelos vea la tarea: la regresión objetivo queda resuelta, el conjunto completo de pruebas sigue en verde, el lint y la compilación terminan, cambian los archivos solicitados y el comportamiento no relacionado permanece intacto.
Prepare copias limpias para cada intento
Inicie cada pareja de modelo y tarea desde el mismo commit en una copia de trabajo limpia. Entregue a ambos modelos el mismo prompt, archivos, herramientas, permisos, tiempo de espera y margen de reintentos. No permita que un modelo herede el parche ni la explicación del otro.
Ejecute primero la configuración común
Use
grok-4.7ygrok-4.6conhigh. Registre el ID de modelo devuelto, aprobación o fallo, tiempo transcurrido, entrada nueva y en caché, uso de razonamiento y salida, cargos de herramientas e importe facturado. Conserve todos los fallos en los resultados. Ejecute 4.7 conxhighsolo como una prueba etiquetada por separado.Adopte el modelo por clase de tarea
Compare el trabajo aceptado, el tiempo transcurrido y la factura total. Migre únicamente la clase en la que gane 4.7, mantenga 4.6 como valor de reversión y repita la prueba cuando cambien el prompt, las herramientas o el modelo. Una implementación mixta es válida cuando su costo de monitoreo es inferior al beneficio medido.
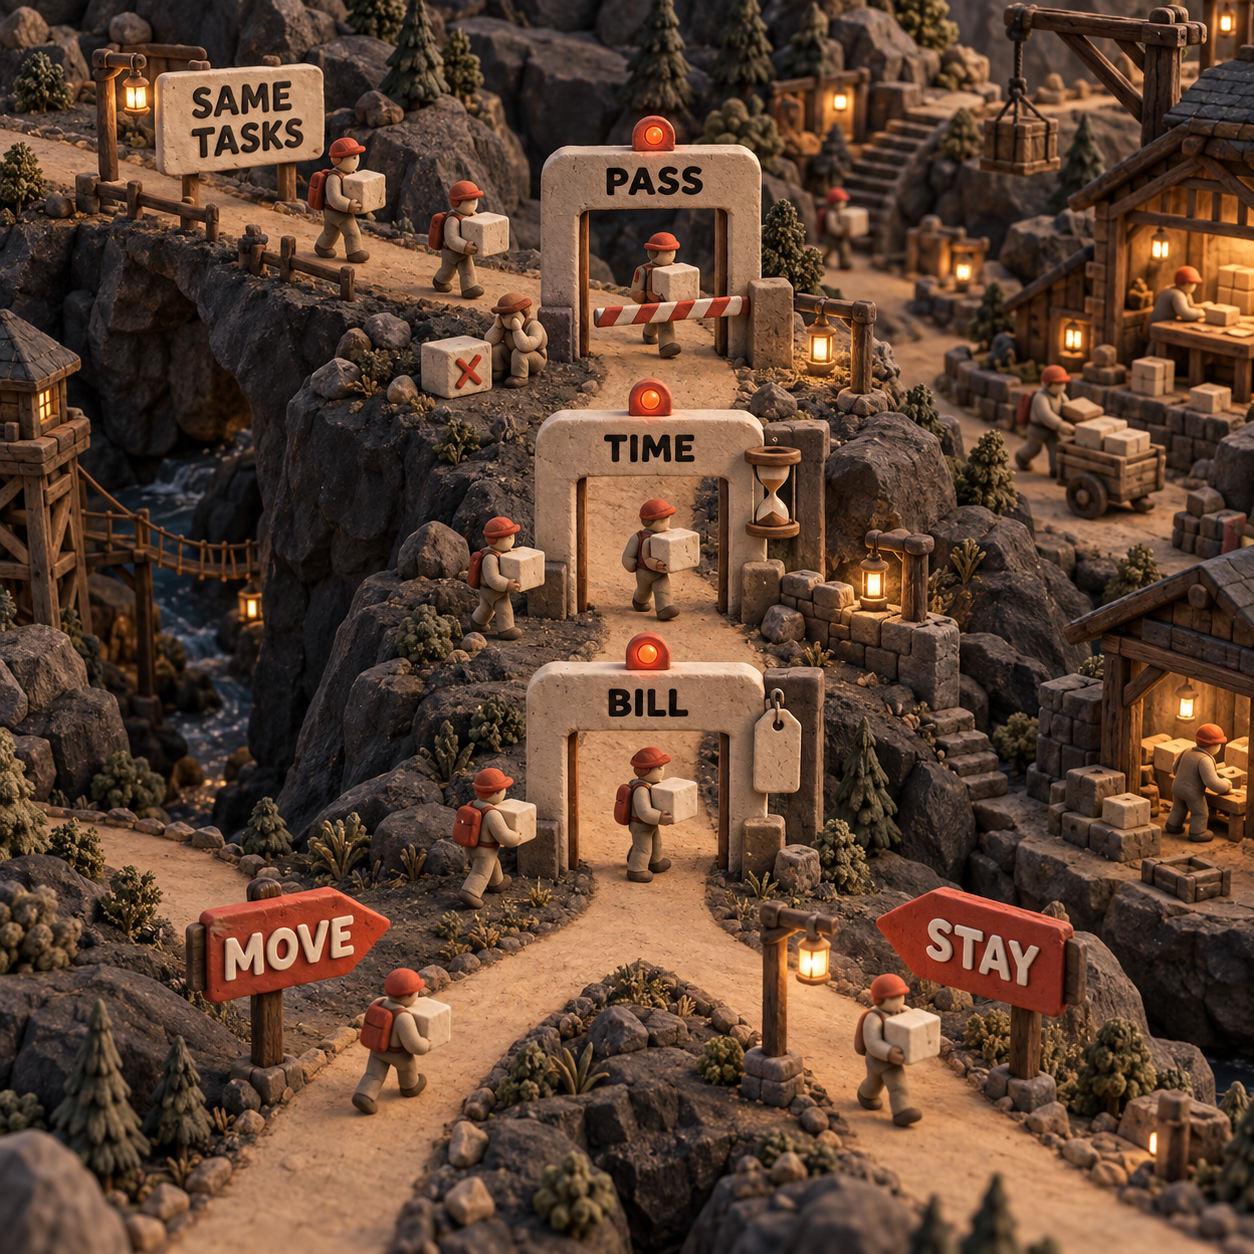
La acción concreta para el lunes es recuperar un error conocido, elegir una función que abarque varios archivos y seleccionar una actualización de dependencia del trabajo del mes pasado. Ejecute esas tres tareas la próxima semana con High en copias limpias, publique cada fallo en la hoja interna de resultados y migre únicamente la clase de tarea cuyo trabajo completado, tiempo real y factura efectiva justifiquen el cambio.
Preguntas frecuentes
¿Cuál es la mejor versión de Grok?
Grok 4.7 es la recomendación actual de xAI para programación y trabajo general. Grok 4.6 sigue siendo la mejor opción operativa para un flujo que ya completa de forma fiable, hasta que 4.7 gane una prueba comparativa con la misma carga de trabajo.
¿Grok 4.6 es bueno?
Sí. Tiene la misma ventana de contexto documentada de 500,000 tokens, las mismas funciones esenciales de herramientas, los mismos niveles de razonamiento y las mismas tarifas estándar de API que 4.7. Su punto débil son los peores resultados que reporta xAI en las comparaciones más difíciles de programación y trabajo de conocimiento.
¿Cuál es actualmente el mejor modelo Grok?
xAI presenta Grok 4.7 como su modelo más capaz para código y todo lo demás. Eso lo convierte en el primer candidato que se debe evaluar, no en una prueba de que supera a 4.6 en todos los flujos implementados.
¿Qué versiones de Grok existen?
xAI mantiene modelos de propósito general de Grok, además de modelos especializados de imagen, video y voz. Para esta decisión sobre programación y trabajo de conocimiento, los ID documentados relevantes son grok-4.7 y grok-4.6; el catálogo vigente de modelos es la referencia para consultar la lista completa, que cambia con el tiempo.
¿Hay algo mejor que Grok?
Ningún modelo es el mejor en todos los repositorios, configuraciones de herramientas, objetivos de latencia y criterios de calidad. Compare proveedores por trabajo aceptado por dólar usando las mismas tareas y controles, en lugar de tratar la prueba de un proveedor como una clasificación universal.
¿Cuáles son los niveles de Grok?
En Grok 4.7 y Grok 4.6, los niveles de esfuerzo de razonamiento son low, medium, high y xhigh. El valor predeterminado es high y el razonamiento no se puede desactivar.
¿Grok tiene un modo 18+?
Esa es una cuestión del producto de consumo y sus modos de seguridad, no una diferencia de capacidad entre estos dos ID de modelo de API. No debería influir en una migración de programación de Grok 4.7 frente a Grok 4.6.
¿Cuánto cuesta Grok al mes?
En el uso de la API que se compara aquí, el costo se calcula por tokens y llamadas opcionales a herramientas, no mediante una mensualidad fija por modelo. Las suscripciones para consumidores, el acceso gratuito y los planes de Grok Build se mantienen actualizados en ¿Grok es gratis?.
¿Cuáles son todos los modelos Grok?
La lista completa cambia a medida que xAI añade y retira variantes, por lo que su catálogo vigente es la fuente de referencia. Para programación y trabajo de conocimiento general, xAI dirige actualmente a los usuarios hacia Grok 4.7.
¿Quiere una configuración lista para evaluar agentes de programación? Reciba con el boletín la lista de configuración de Claude Code + Codex.
- Última actualización
- 21 sept 2026
- Categoría
- AI
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Agentes de IA en producción: cómo las reglas premiaron el objetivo equivocado
Un editor de IA desvió 50 de 96 artículos hacia software de manualidades. Los datos revelan qué reglas premiaron el desvío y qué controles las sustituyeron.21 sept 2026AI
Precio de Step 5 Preview: API, Step Plan y costo real
Compara el precio de Step 5 Preview en la API con los Créditos de Step Plan, el descuento por caché y el costo del razonamiento antes de elegir.21 sept 2026AI
Nouswise a prueba: ¿es fiable como IA con fuentes?
Analizamos Nouswise como IA con fuentes: citas, proyectos, API, precios y límites. Descubre qué debes probar antes de adoptarla para trabajo serio.10 sept 2026AI
Revisión de submittals con IA: qué herramienta elegir
Comparamos herramientas de IA para la revisión de submittals por evidencia, control de versiones, integraciones, precio y facilidad para probarlas.9 sept 2026AI
IA para veterinarios: VetGeni o ScribbleVet, ¿cuál conviene?
Comparamos VetGeni y ScribbleVet en precio, integraciones PIMS, plantillas, acceso del equipo y exportación para elegir la mejor IA para veterinarios.8 sept 2026AI
IA para arquitectura: ¿conviene InspectMind AI?
Analizamos el enfoque, los precios y los límites de InspectMind AI para saber cuándo su revisión de planos aporta valor y cuándo conviene otra opción.8 sept 2026AI
BuildSync o SpecLens: qué software para construcción elegir
Descubre qué software para construcción encaja mejor: BuildSync para submittals en Procore o ACC, y SpecLens para comparar archivos y exportar resultados.8 sept 2026AI