Mit KI programmieren: Ist Reflection AI Beam schon eine Option?
Reflection AI Beam zum Programmieren mit KI: Was Beta-Zugang, angekündigte Modellgewichte und Anbieterbenchmarks für einen möglichen Modellwechsel bedeuten.
Veröffentlicht am
 Von Omid Saffari
- RReflection AI Beam
Wer mit KI programmieren und Agenten einsetzen will, sollte Reflection AI Beam für einen Vergleich vormerken. Ein funktionierender Coding-Agent sollte deshalb aber nicht später in Betrieb gehen. Reflection hat am 5. Oktober 2026 eine begrenzte Vorabversion angekündigt; die Modellgewichte sollen im Laufe des Oktobers zum Download folgen. Das bisherige Modell sollte produktiv bleiben, während geprüft wird, ob Beam einen Platz verdient.
Stand der Prüfung: 10. Oktober 2026, anhand von Reflections Ankündigung und der öffentlichen Entwicklerdokumentation. Die folgenden Empfehlungen zur Einführung und Berechnungen sind redaktionelle Einschätzungen. Für diesen Artikel wurden weder Inferenzanfragen mit Beam ausgeführt noch Benchmarks nachvollzogen.
Mit KI programmieren: Was ändert sich durch Beam?
Mit Beam kommt ein weiterer Kandidat für Programmieraufgaben und Agenten hinzu. Reflection beschreibt ein dünn besetztes Mixture-of-Experts-Modell mit insgesamt 501 Milliarden Parametern, davon 23 Milliarden aktiv, das auf Programmierung, logisches Schlussfolgern und agentische Aufgaben ausgerichtet ist. Als geplante Lizenz für die Modellgewichte nennt das Unternehmen Apache 2.0. Quelle: Reflections Modellankündigung.
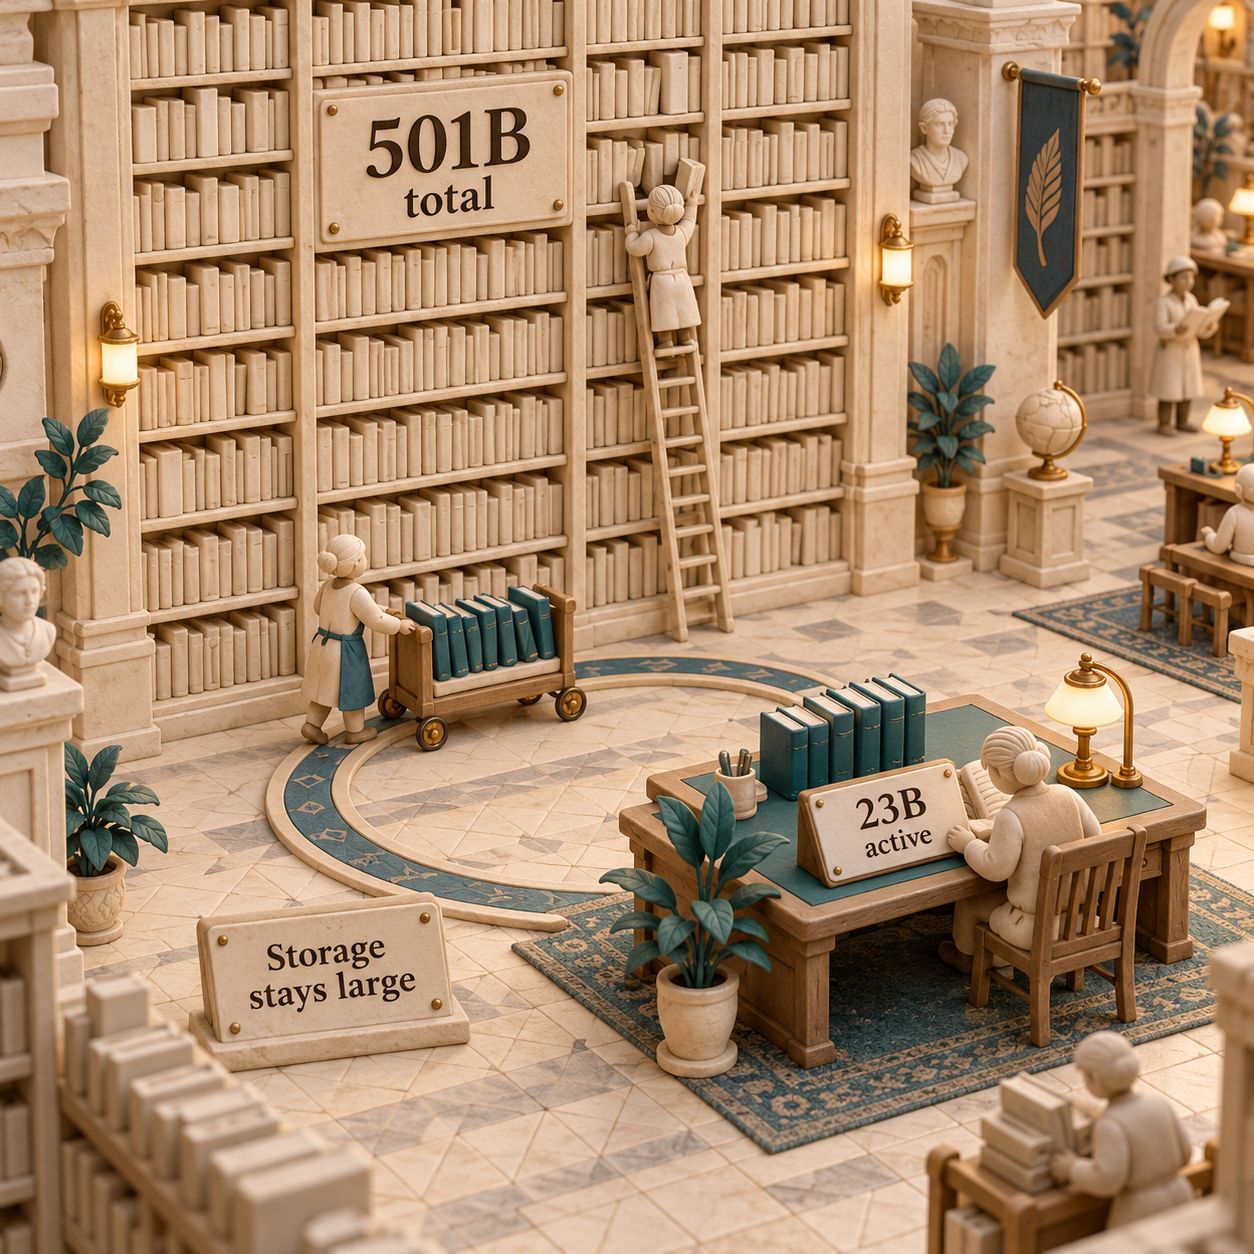
Parameter sind die im Training erlernten Zahlenwerte eines Modells. Ein Mixture-of-Experts-Modell, kurz MoE, nutzt für jedes Token nur ausgewählte Teile des Modells. Ein Token ist eine kleine Texteinheit, die das Modell verarbeitet. Das lässt sich mit einer Bibliothek vergleichen: Einzelne Bücher nachzuschlagen kostet weniger Aufwand, als sämtliche Regale durchzulesen. Der übrige Bestand braucht trotzdem Platz.
Für Entwickler zählt, ob diese Architektur brauchbare Codeänderungen bei geringerem Inferenzaufwand liefern kann. Für CTOs stellt sich zusätzlich die Frage, ob das spätere Bereitstellungspaket zur vorhandenen Infrastruktur und zu den betrieblichen Anforderungen passt. Die Parameterzahl allein beantwortet keine dieser Fragen.
Ein Coding-Agent verbindet ein Modell mit Tools, Ausführungsrechten und einer Steuerungsschleife, die den nächsten Schritt bestimmt. Ein Modellwechsel kann beeinflussen, wie oft der Agent Dateien liest, Tests ausführt, einen fehlgeschlagenen Befehl wiederholt oder zu früh aufhört. Die bisherige Agentenkonfiguration gehört deshalb zum Vergleich, selbst wenn der Modellwechsel nur wie eine kleine Konfigurationsänderung aussieht.
Was ist bereits verfügbar, und wann kommen die Modellgewichte?
Der öffentlich beschriebene Zugang führt über eine Warteliste für die gehostete Beta. Laut Reflections Schnellstartanleitung stehen API-Schlüssel nach der Freischaltung zur Verfügung. Die Dokumentation beschreibt außerdem einen Playground zum Ausprobieren von Prompts.
Zum Zeitpunkt der Prüfung gilt folgender Veröffentlichungsstand:
Quellen: angekündigte Veröffentlichungen, Dokumentation zum Beta-Zugang. Reflection nennt einen Monat, keinen Kalendertag. Ein konkretes Veröffentlichungsdatum im Oktober, das sich in einem Liefervertrag festhalten ließe, gibt es nicht.
Bei der Beschaffung von Infrastruktur sollte das herunterladbare Modellpaket als eigener Meilenstein gelten, unabhängig von der Freischaltung eines gehosteten Kontos. Ein gehosteter Pilotversuch zeigt, wie sich das Modell bei Aufgaben verhält. Er belegt jedoch nicht, dass die vorgesehene Quantisierung, die Inferenzsoftware, die Hardwarekonfiguration oder eine Offlineinstallation funktionieren.
Die endgültige Model Card und der technische Bericht sind wichtig, weil sie eine verlässliche Grundlage liefern, um Modelldetails und Testbedingungen zu prüfen. Die öffentlichen API-Anleitungen sind schon jetzt nützlich, beantworten aber eine andere betriebliche Frage: Wie stellt ein freigeschalteter Nutzer eine Anfrage?
Wie lässt sich Beam jetzt ausprobieren?
Zuerst den Zugang beantragen, nach der Freischaltung den dokumentierten Playground oder die API nutzen. Die Registrierung ist ein Zugangsantrag und garantiert noch nicht, dass sich sofort eine erfolgreiche Anfrage stellen lässt.
Für den Zugang registrieren
Die in der Ankündigung verlinkte Reflection-Plattform öffnen und ein Konto anlegen. Bereits freigeschaltete Nutzer können direkt ihr Konto aufrufen. Für diesen Artikel wurde die öffentliche Plattform geprüft; ein angemeldetes Konto und eine Modellantwort wurden nicht getestet.
Nach der Freischaltung einen Schlüssel erstellen
In der Plattform API Keys öffnen und einen Projektschlüssel erstellen. Diesen als
REFLECTION_API_KEYin der Umgebung speichern. Die offizielle Schnellstartanleitung beschreibt diesen Ablauf und den Playground als Alternative.Vor der Agentenanbindung eine kleine Anfrage senden
Die unten dokumentierte Modell-ID und den Endpunkt verwenden. Sobald der grundlegende Zugriff funktioniert, mit einer entbehrlichen Kopie eines Repositorys und einer Aufgabe mit eindeutigem Abnahmetest weiterarbeiten.
curl https://api.reflection.ai/openai/v1/chat/completions \
  -H "Authorization: Bearer $REFLECTION_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Beam-501B-A23B",
    "messages": [
      {"role": "user", "content": "Explain what makes a regression test useful."}
    ]
  }'
Endpunkt und Modellkennung stammen aus Reflections Schnellstartanleitung; die Anfrage wurde hier nicht ausgeführt. Bevor eine Anwendung auf ein bestimmtes Inferenzlimit ausgelegt wird, sollten die Angaben für die eigene Beta-Konfiguration in der aktuellen Modelldokumentation geprüft werden. Angaben zur Kontextlänge während des Trainings sind keine verbindliche Zusage für Anfragen im Produktivbetrieb.
Was sagen die veröffentlichten Benchmarks aus?
Die gemeldeten Ergebnisse rechtfertigen einen Test, aber noch keinen Modellwechsel. Es handelt sich um von Reflection selbst veröffentlichte Beam-Ergebnisse, die hier nicht unabhängig überprüft wurden. Auf der Seite ist die Tabelle als am 8. Oktober 2026 aktualisiert gekennzeichnet.
Quelle: Reflections aktualisierte Benchmark-Tabelle. Die Werte sind wie veröffentlicht wiedergegeben, ohne Einheiten hinzuzufügen, die in der Tabelle nicht genannt werden.
Ein aussagekräftiger Vergleich hält Aufgabe, Toolzugriff und Abbruchregeln konstant. Hat das bisherige Modell ein strenges Zeitbudget, während der neue Kandidat unbegrenzt viele Versuche bekommt, werden neben den Modellen auch unterschiedliche Betriebsregeln verglichen. Ändert der Agent den Testbefehl oder die Tests selbst, muss dieses Verhalten geprüft werden, bevor die Aufgabe als bestanden zählt.
Für die Wartung eines Repositorys eignen sich Issues, deren erwartetes Verhalten bereits geklärt ist. In die Auswahl gehören die Behebung einer Regression, eine Änderung über mehrere Dateien hinweg, eine unbekannte Abhängigkeit und eine Aufgabe, bei der der richtige nächste Schritt darin besteht, fehlende Informationen zu erfragen. Die Ergebnisse werden anhand von Tests und Prüfkriterien bewertet, die vor Sichtung der Antwort festgelegt wurden.
Aus fachlich unterschiedlichen Ranglistenwerten sollte kein Durchschnitt für die Beschaffungsentscheidung entstehen. Eine Terminalaufgabe, eine Codereparatur und eine Toolinteraktion können jeweils andere Schwächen sichtbar machen. Das Unternehmen braucht abnahmefähige Ergebnisse in der eigenen Umgebung, keinen Mittelwert aus gerade verfügbaren Kennzahlen.
Der Effizienzvorteil muss sich erst messen lassen
Reflection beansprucht bei Vergleichen zu anspruchsvollem logischem Schlussfolgern einen um den Faktor 3 bis 4 geringeren Rechenaufwand für die Inferenz als GLM-5.2. Die Schätzung lässt Promptverarbeitung, kontextabhängige Attention-Berechnungen und den Zusatzaufwand des Inferenzbetriebs außen vor. Die Vergleichsauswertungen stammen von Artificial Analysis und DataCurve. Quelle: Reflections Methodik zur Effizienzbewertung.
Diese Ausnahmen sind für Agenten relevant, die wiederholt einen umfangreichen Repositorykontext übergeben. Rechenarbeit, die in der Schätzung fehlt, kann die eigenen Server trotzdem auslasten. Bevor aus einem Rechenvorteil eine Budgetersparnis abgeleitet wird, müssen Bearbeitungsdauer, Ressourcenverbrauch, Wiederholungsversuche und Eingriffe durch Prüfer über die gesamte Aufgabe erfasst werden.
Welche Zahlen zählen für Self-Hosting und Budget?
Die aktiven Parameter allein reichen nicht zur Dimensionierung einer Installation. Aus Reflections Angaben ergibt sich ein aktiver Anteil von 23 ÷ 501 × 100 = ungefähr 4.6%. Dieses Verhältnis beschreibt den ausgewählten Teil der Modellkapazität. Es bedeutet nicht, dass Speicherbedarf, Latenz oder Rechnung im selben Verhältnis sinken.
Eine bewusst vereinfachte Speicherrechnung zeigt den Unterschied. Würde jeder Parameter mit 4 Bit gespeichert, benötigten die reinen Modellgewichte 501 Milliarden × 4 ÷ 8 = 250.5 GB, gerechnet in dezimalen Gigabyte. Das ist unsere Berechnung auf Grundlage der angekündigten Parameterzahl, keine unterstützte Beam-Quantisierung und kein gemessener Speicherbedarf. Metadaten des Packformats, Laufzeitpuffer und der während der Generierung verwendete Cache sind darin nicht enthalten.
Vor dem Kauf von Kapazität sollte eine funktionierende Konfiguration vorliegen. Dazu gehören eine unterstützte Version, eine konkret benannte Inferenzimplementierung, gemessener Speicherverbrauch und ein ausreichender Durchsatz bei der erwarteten Zahl paralleler Anfragen. Die theoretische Größe der Modellgewichte sagt nicht, wie viele gleichzeitige Agentensitzungen die Installation bewältigt.
Reflections Ankündigung enthält keinen API-Preis pro Token. Ein belastbarer Vergleich der Betriebskosten vor und nach einem Wechsel lässt sich daraus deshalb nicht erstellen. Quelle: Ankündigung.
Die wirtschaftliche Hürde lässt sich dennoch festlegen. Ein beispielhaftes Migrationsbudget könnte mit 20 Entwicklungsstunden zu $100 pro Stunde rechnen. Der Wechsel kostet dann zunächst $2,000, bevor laufende Einsparungen entstehen. Misst ein späterer Pilotversuch $500 Nettoersparnis pro Monat, ist die Investition nach 4 Monaten ausgeglichen. Das sind ausdrücklich Planungsannahmen, keine Beam-Preise, beobachteten Einsparungen oder Prognosen.
Für die Nettoersparnis müssen Infrastruktur, Toolausführung, Fehlversuche, laufende Wartung und Prüfaufwand berücksichtigt werden. Bei einem selbst gehosteten Modell ist es aussagekräftiger, die gesamten Betriebskosten durch die Zahl abgenommener Aufgaben zu teilen, als einen nominellen Preis pro erzeugtem Token zu nennen. Bei einem gehosteten Modell gehört auch der Verbrauch während der Wiederholungsversuche in die Rechnung, nicht nur die letzte Antwort.
Wo geht die Euphorie zu weit?
Verfrüht ist die Schlussfolgerung, die Ankündigung kläre bereits die Einsatzreife oder die Betriebskosten. Weder eine geplante Lizenz noch ein attraktiver Benchmark ersetzt die fehlenden Nachweise für Installation und Abnahme.
Die typischen Fehler lassen sich klar benennen:
- Zugang zur Vorabversion mit einer Self-Hosting-Veröffentlichung gleichsetzen. Kontozugang, Verfügbarkeit der Modelldateien und erfolgreiche Installation brauchen eigene Termine im Projektplan.
- Das Budget aus den aktiven Parametern ableiten. Speicherbedarf, Rechenaufwand pro Token und Durchsatz müssen getrennt gemessen werden.
- Eine Effizienzschätzung zum Preisvergleich machen. Ein Anbieter kann effizient arbeiten, ohne den Vorteil als niedrigeren Preis an das eigene Kundenkonto weiterzugeben.
- Eine überzeugende Demo als abgenommene Codeänderung werten. Erforderlich sind Tests, Codeprüfung und eine Erklärung des geänderten Verhaltens.
Besonders teuer kann es werden, eine tragfähige Einführung wegen eines angekündigten Modells anzuhalten. Dabei wird ein bekannter Weg zur Auslieferung gegen eine ungewisse Verbesserung eingetauscht. Die Anwendung sollte weiterentwickelt und der spätere Vergleich so vorbereitet werden, dass er sich nach der Freischaltung leicht ergänzen lässt.
Lohnt es sich, auf Beam zu warten?
Mit der Migration warten, mit dem bereits geeigneten Open-Weight-Modell weiter ausliefern. Für einen Pilotversuch liegt die Hürde niedriger als für den Austausch des standardmäßig verwendeten Modells.
Entwickler und Gründer: Den Vergleich vorbereiten
Soloentwickler und Gründer mit Finanzierung sollten eine kleine Auswahl repräsentativer Repositoryaufgaben sowie die Ausgaben des bisherigen Modells sichern. Nach der Freischaltung wird Beam mit denselben Fällen geprüft; dabei zählen die vollständigen Änderungen. Es sollte nur dort zum Einsatz kommen, wo bessere, abgenommene Ergebnisse den Integrationsaufwand rechtfertigen.
Wenn eine bestehende Installation mit Qwen, DeepSeek, GLM, Mistral oder einem anderen Open-Weight-Modell die Anforderungen erfüllt, entsteht aus der Ankündigung kein Wechselzwang. Der Leitfaden zu den besten Open-Source-LLMs behandelt die größere Auswahl. Diese Entscheidung beginnt jedoch beim bereits betriebenen Modell und bei dessen konkret benennbaren Schwächen.
Betriebsteams: Den funktionierenden Betrieb absichern
Verantwortliche im Betrieb sollten eine Rückfalloption beibehalten und Bearbeitungsdauer, verworfene Ergebnisse sowie den nötigen Eingriffsaufwand vergleichen. Ein Modell mit einem besseren ersten Entwurf kann insgesamt schlechter abschneiden, wenn es bei der Toolnutzung wiederholt hängen bleibt oder zu viel Prüfzeit beansprucht. Solche Fehler müssen im Pilotversuch sichtbar werden, bevor das Standardmodell gewechselt wird.
Routineaufgaben, die ihre Abnahmekriterien bereits erfüllen, bleiben davon unberührt. Die Testzeit sollte in teure Fehler fließen: wiederholte Reparaturversuche, unvollständige Änderungen am Repository oder unnötige Eskalationen an ein kostspieligeres Modell.
CTOs und Einkauf: Auf einen nachweislich möglichen Einsatz warten
Wer als CTO eine private Bereitstellung voraussetzt, sollte erst nach Verfügbarkeit der herunterladbaren Modelldateien und einer überprüften Installation den Produktionszeitplan festlegen. Ein API-Pilotversuch lohnt sich nur, wenn dieser Zugang zu den Datenanforderungen und betrieblichen Vorgaben des Tests passt.
Steht auch Mistral Large 4 auf der Auswahlliste, bietet der separate Leitfaden zu Mistral Large 4 Einzelheiten zu Veröffentlichung und Beschaffung. Jeder Kandidat sollte auf der tatsächlich nutzbaren Bereitstellungsstufe verglichen werden. Ankündigungen bedeuten nicht automatisch, dass alle Produkte gleichermaßen verfügbar sind.
Der nächste Schritt am Montag: Den bisherigen Produktivbetrieb beibehalten, bei Bedarf Zugang für einen Pilotversuch beantragen und die Verantwortung für die Abnahmeaufgaben zuweisen. Sobald die benötigten Modelldateien und Messergebnisse vorliegen, wird die Migrationsentscheidung erneut geprüft. Eine Kundenauslieferung darf nicht von einem unbestimmten Veröffentlichungstag abhängen.
Häufige Fragen
Hat Reflection AI bereits etwas veröffentlicht?
Das Unternehmen hat Beam angekündigt und den Zugang zur gehosteten Beta dokumentiert. Die Übersicht zum Veröffentlichungsstand oben trennt die Vorabversion von herunterladbaren Modellgewichten.
Was kostet Beam AI?
Die Beam-Ankündigung nennt keinen API-Preis. Bevor ein Pilotversuch budgetiert wird, müssen die für das eigene Konto geltenden Konditionen geklärt sein. Ähnlich benannte Produkte liefern keine Preisinformationen für dieses Modell.
Wie gut ist Reflection AI?
Die Benchmark-Ergebnisse des Anbieters machen Beam für die hier angesprochene Zielgruppe zu einem interessanten Testkandidaten. Eine unabhängige Wiederholung der Tests fand hier nicht statt. Die Empfehlung lautet deshalb, einen eigenen Vergleich anhand fester Abnahmekriterien durchzuführen.
Hat Reflection AI schon ein nutzbares Produkt ausgeliefert?
Für Entwickler ist die Unterscheidung zwischen gehostetem Zugang und einem installierbaren Modell entscheidend. Maßgeblich ist der dokumentierte Zugangsprozess. Eine Vorankündigung allein reicht nicht, um Self-Hosting einzuplanen.
Kann man in Reflection AI investieren?
Die Registrierung für Beam dient dem Modellzugang. Die Ankündigung beschreibt keinen Weg für eine Investition.
Wer sind die wichtigsten Wettbewerber von Reflection AI?
Für die eigene Einführungsentscheidung ist zunächst das Modell maßgeblich, das den Coding-Agent bereits betreibt. Der verlinkte Leitfaden zu Open-Weight-Modellen nennt Alternativen. Verglichen werden sollten jeweils die tatsächlich eingesetzte Version und Konfiguration.
Wem gehört Reflection AI?
Die Beam-Ankündigung enthält keine Aufschlüsselung der Anteilseigner. Sie beschreibt eine Modellveröffentlichung und legt keine Eigentumsverhältnisse offen.
Wie verdient Reflection AI Geld?
Reflection dokumentiert eine gehostete API, legt in der Ankündigung aber keine Umsatzaufteilung offen. Aus einem Benchmark lassen sich keine wirtschaftlichen Kennzahlen des Geschäftsmodells ableiten.
Welche Gehälter zahlt Reflection AI?
Die Beam-Ankündigung enthält keine Angaben zur Mitarbeitervergütung. Gehälter sind von den Kosten für den Zugang zu Beam oder dessen Betrieb zu unterscheiden.
Der Newsletter liefert praktische Entscheidungshilfen zur Modelleinführung und geprüfte Neuigkeiten zu Veröffentlichungen.
- Veröffentlicht
- Kategorie
- AI
- Sprache
Claude für Google Workspace: So gelingt der Teamstart
Claude in Docs, Sheets und Slides einrichten: So gelingt der Pilot im Team – mit kontrollierten Änderungen, klaren Prüfregeln und drei Praxisbeispielen.10. Okt. 2026AI
Dashboard erstellen mit Claude: Einrichtung, Kosten und Praxis
Dashboard erstellen mit Claude: Tarife, Datenanbindung und Freigabe erklärt. Mit Vertriebsbeispiel, SQL-Prüfung und klaren Grenzen der Beta im Überblick.10. Okt. 2026AI
Granola AI: Lohnt sich der KI-Notizassistent?
Granola AI im Überblick: KI-Notizen ohne Meetingbot, Preise, Vorlagen und Datenschutz. Für wen sich der Assistent lohnt und wo seine Grenzen liegen.10. Okt. 2026AI
Fyxer AI: Kosten, Funktionen und Grenzen im Überblick
Fyxer AI im Überblick: Preise, E-Mail-Entwürfe, Meetings und Datenschutz. Für wen sich Pro oder Team lohnt – und wann vorhandene Tools schon ausreichen.9. Okt. 2026AI
GPT 6 im Überblick: Modelle, Preise und Zugang zu ChatGPT
GPT 6 im Überblick: Astra, Sol, 6.1 Sol und Luna, ihre Release-Termine, der Zugang über ChatGPT, Work und Codex sowie API-Preise und konkrete Budgetbeispiele.9. Okt. 2026AI
ChatGPT kostenlos nutzen: Funktionen, Grenzen und Abos
Was lässt sich mit ChatGPT kostenlos erledigen? Alle Funktionen und Limits von Free, Hinweise zu Werbung und Anmeldung sowie der Vergleich mit Go und Plus.9. Okt. 2026AI
Gemini Enterprise: Funktionen prüfen, Kosten kalkulieren
Gemini Enterprise für Unternehmen: verfügbare Funktionen, Early Access, Konnektoren und Kosten einordnen – mit einem klar begrenzten 30-Tage-Pilotversuch.9. Okt. 2026AI