Reflection AIのBeamは導入すべき?使い方・性能・公開予定を整理
Reflection AIのBeamは、コーディングエージェントの移行先になるのでしょうか。公開予定、ベータ版の申請方法、ベンダー公表のベンチマーク、セルフホストの容量と費用を整理。重みの公開とAPI利用の違いを押さえ、既存モデルでの運用を続けながら、実測に基づいて導入を判断するための確認事項を解説します。
公開日
 著者 Omid Saffari
- RReflection AI Beam
Reflection AIのBeamは、コーディングエージェントに使うモデルの評価候補に入れる価値があります。ただし、すでに機能しているエージェントの導入を遅らせる理由にはなりません。Reflectionが2026年10月5日に発表したのは限定プレビューで、重みのダウンロード提供は10月中の後日を予定しています。Beamを採用する価値があるかを見極める間も、既存モデルでの運用は続けましょう。
2026年10月10日確認。 Reflectionの発表と公開開発者ドキュメントを照合しています。以下の導入判断に関する提案や計算は編集部による分析です。本記事では、Beamの推論実行やベンチマークの追試は行っていません。
Reflection AIのBeamで、開発者の選択肢はどう変わる?
Beamの登場で、コーディングやエージェント用途の評価候補が増えました。 Reflectionによると、Beamは総パラメータ数501B、アクティブパラメータ数23BのスパースなMixture-of-Expertsモデルで、コーディング、推論、エージェントによる作業を想定しています。重みにはApache 2.0ライセンスを採用する予定です。出典:Reflectionのモデル発表。
パラメータとは、モデルが学習によって獲得する内部の数値です。Mixture-of-Experts、略してMoEは、処理するテキストの小さな単位であるトークンごとに、モデルの一部を選んで使います。図書館に例えると、必要な本だけを調べるほうが、すべての棚の本を読むよりも手間は少なくなります。ただし、読まない本も蔵書として場所を取ります。
開発者が確かめたいのは、この設計によって推論処理の負荷を抑えながら、受け入れ基準を満たすコード修正が得られるかどうかです。CTOには、最終的に提供されるデプロイ用パッケージが、既存のインフラや運用要件に合うかという判断も必要です。どちらもパラメータ数だけでは答えが出ません。
コーディングエージェントは、モデル、ツール、実行権限、そして次の行動を決めるループを組み合わせたものです。モデルを変えると、ファイルを読む頻度、テストの実行回数、失敗したコマンドを再試行する回数、作業を早々に打ち切ってしまう頻度も変わり得ます。モデルの入れ替えが小さな設定変更に見えても、現在のエージェント構成を含めて比較する必要があります。
今使えるものは?重みはいつ公開される?
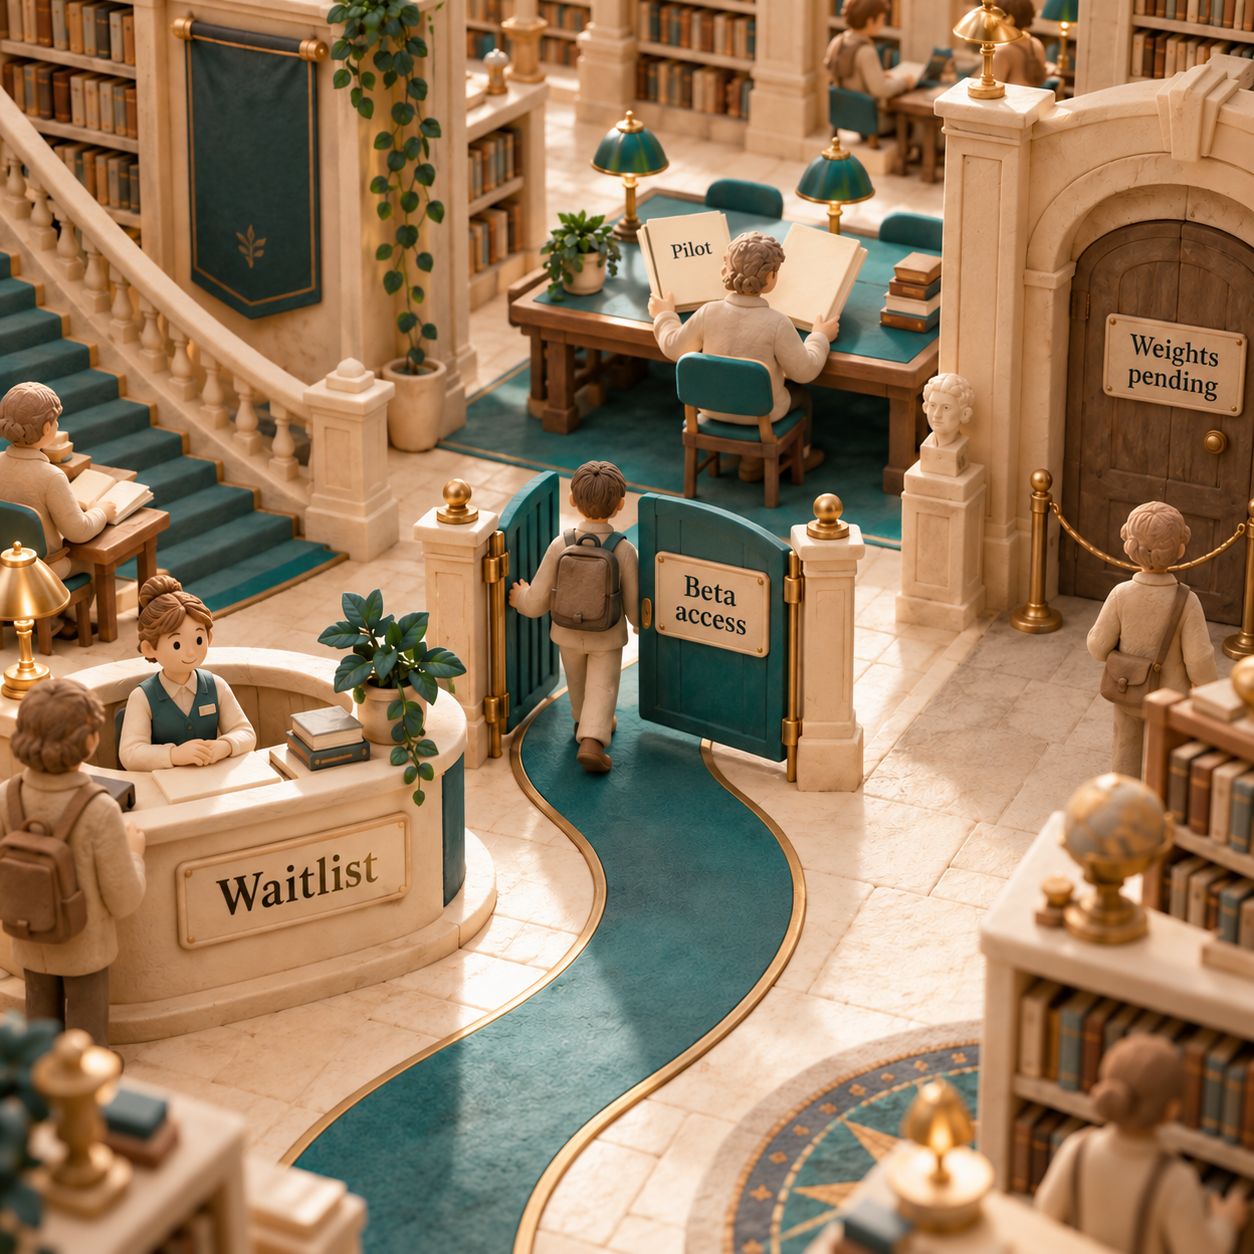
現時点で一般に案内されているのは、ホスト型ベータ版の利用待ちリストです。 Reflectionのクイックスタートによると、アクセスが有効になってからAPIキーを取得できます。プロンプトを試せるPlaygroundの使い方も掲載されています。
確認日時点の公開状況は、以下のとおりです。
出典:公開予定の発表、ベータ版のアクセス手順。Reflectionが示しているのは月までで、具体的な日付ではありません。 納品契約に書き込めるような、10月の確定した公開日は示されていません。
インフラ調達を判断する際は、ダウンロード可能なパッケージの提供と、ホスト型サービスのアカウント取得を別の節目として扱いましょう。ホスト型での試験運用では、タスクへの対応を確かめられます。しかし、予定している量子化方式、推論エンジン、ハードウェア構成、オフライン環境へのインストールが動作するかまでは確認できません。
最終版のモデルカードと技術レポートが重要なのは、モデルの詳細や評価条件を継続して参照できる資料になるためです。公開済みのAPI手順も今すぐ役立ちますが、そこで分かるのは、アクセスを承認されたユーザーがどうリクエストを送るかという、別の運用上の事項です。
Beamの使い方:アクセス申請から最初のリクエストまで
まずアクセスを申請し、承認後にドキュメントに沿ってPlaygroundまたはAPIを使います。 登録はあくまで利用申請です。登録直後からリクエストが通るとは限りません。
利用待ちリストに登録する
発表ページからリンクされているReflectionのプラットフォームを開き、登録します。すでに承認されているユーザーは、自分のアカウントに進めます。本記事では公開されているプラットフォームを確認しましたが、ログイン後のアカウント操作やモデルの応答は検証していません。
アクセスが有効になったらキーを作成する
プラットフォームでAPI Keysを開き、プロジェクト用のキーを作成します。環境変数
REFLECTION_API_KEYとして保存してください。公式クイックスタートには、この手順と、代わりにPlaygroundを使う方法が記載されています。エージェントにつなぐ前に、小さなリクエストを送る
以下に示す、ドキュメント記載のモデルIDとエンドポイントを使います。基本的なアクセスが動作したら、破棄してよいリポジトリのコピーと、明確な受け入れテストがあるタスクで試しましょう。
curl https://api.reflection.ai/openai/v1/chat/completions \
  -H "Authorization: Bearer $REFLECTION_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Beam-501B-A23B",
    "messages": [
      {"role": "user", "content": "Explain what makes a regression test useful."}
    ]
}'エンドポイントとモデル識別子はReflectionのクイックスタートに基づいています。本記事では、このリクエストを実行していません。推論サービスの上限を前提に実装する前に、現行のモデルドキュメントで、自分のベータ環境の設定を確認してください。学習段階のコンテキスト長の数値を、本番リクエストで保証される仕様として扱うべきではありません。
公表されたベンチマークから、どこまで判断できる?
公表スコアは詳しく調べる理由にはなりますが、移行を決める根拠としては不十分です。 以下はReflection自身が公表したBeamの結果であり、本記事で独立に検証したものではありません。同社のページでは、表の更新日は2026年10月8日とされています。
出典:Reflectionの更新済みベンチマーク表。スコアは掲載どおりに転記しており、元の表にない単位は補っていません。
意味のある評価にするには、タスク、利用できるツール、終了条件をそろえる必要があります。既存モデルには厳しい時間制限を設け、候補モデルには無制限の再試行を認めれば、モデルだけでなく運用方針も比較することになります。エージェントがテストコマンドを変えたり、テストそのものを書き換えたりした場合は、タスクを合格扱いにする前に、その挙動を確認してください。
リポジトリの保守作業で評価するなら、期待される動作がすでに分かっている課題を使います。リグレッションの修正、複数ファイルにまたがる変更、不慣れな依存関係を扱う作業、そして不足情報を質問することが正解となるタスクを含めましょう。出力を見てから基準を決めるのではなく、あらかじめ選んだテストとレビュー要件に照らして成果を採点します。
性質の異なるランキングのスコアを平均して、調達先の順位にしないでください。ターミナルでの作業、コード修正、ツール操作では、表面化する失敗が異なります。事業に必要なのは、自社の環境で受け入れ基準を満たす成果です。手近にあるスコアの平均ではありません。
効率の高さは、実測で確かめる仮説です
Reflectionは、高度な推論での比較において、GLM-5.2よりも推論計算量を3〜4分の1に抑えられると主張しています。この推計には、プロンプト処理、コンテキストに応じたアテンションの計算、推論サービスのオーバーヘッドが含まれません。比較対象の評価はArtificial AnalysisとDataCurveによるものです。出典:Reflectionの効率評価の方法。
大きなリポジトリのコンテキストを繰り返し渡すエージェントでは、こうした除外項目が効いてきます。推計に含まれない処理も、実際にはサーバーを使います。計算量の優位を予算削減と見なす前に、タスク全体の完了時間、リソース使用量、再試行、レビュアーの介入を記録しましょう。
セルフホストと予算で見るべき数値は?
アクティブパラメータ数だけでは、必要な構成を見積もれません。 Reflectionが示した数値から計算すると、アクティブな部分の割合は**23 ÷ 501 × 100 = 約4.6%**です。この比率が表すのは、モデル全体のうち選択して使う部分の割合です。メモリ、レイテンシ、請求額が同じ割合で減ることを意味しません。
この違いは、保存容量をあえて単純化して計算すると分かりやすくなります。すべてのパラメータを4ビットに詰め込めたとすると、重みそのものの容量は、10進数のギガバイトで501 billion × 4 ÷ 8 = 250.5 GBとなります。これは公表されたパラメータ数に基づく本記事独自の計算であり、Beamが対応する量子化方式や、実測した使用容量を示すものではありません。パッキング用メタデータ、実行時のバッファ、生成中に使うキャッシュは含んでいません。
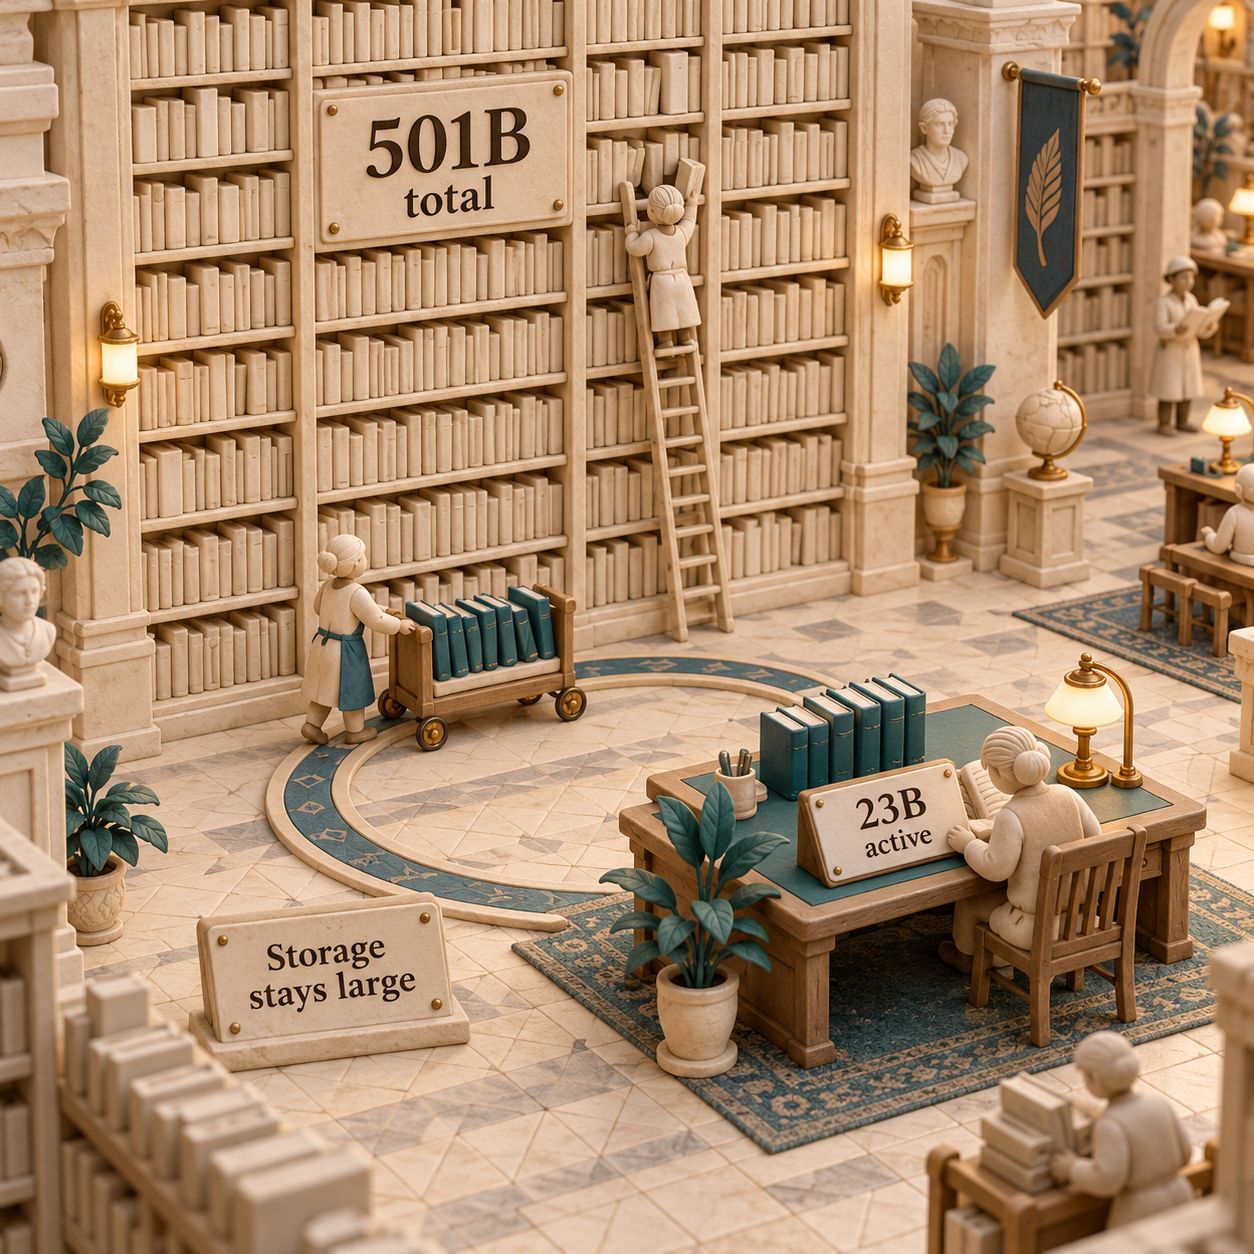
容量を購入する前に、実際に動く構成を求めましょう。必要なのは、サポート対象のリリース、具体的な推論実装、実測メモリ使用量、そして想定する同時実行数で十分なスループットを得られるという証拠です。理論上の重みサイズだけでは、何本のエージェントセッションを同時に動かせるかは分かりません。
Reflectionの発表には、APIのトークン料金が示されていません。 したがって、そのページだけを根拠に、移行前後の信頼できる運用予算を埋めることはできません。出典:発表ページ。
それでも、採用に必要な条件は決められます。移行予算の仮の例として、エンジニアの作業20時間、時給$100を想定すると、継続的な削減効果が出る前に**$2,000がかかります。その後の試験運用で月$500の純削減額が測定できれば、投資回収には4か月**かかります。これらは明示的な計画上の仮定であり、Beamの料金、実際に観測した削減額、将来予測ではありません。
純削減額は、インフラ、ツール実行、失敗した試行、継続的な保守、レビュー時間を差し引いて計算します。セルフホスト型のモデルでは、生成トークン当たりの名目上の単価を示すよりも、運用費用全体を受け入れ基準に合格したタスク数で割るほうが役立ちます。ホスト型でも、最終応答だけでなく、再試行中に積み上がった利用量を含めてください。
Beamへの期待は、どこが先走っている?
発表を読んだだけで、導入準備や運用費用の問題まで解決したと考えるのは早計です。 予定されているライセンスも、魅力的なベンチマークも、インストールの動作確認や受け入れ評価の代わりにはなりません。
特に繰り返されやすい誤りは、次のとおりです。
- プレビューへのアクセスを、セルフホスト版の公開と同一視する。 プロジェクト計画には、アカウントでの利用開始、必要ファイルの提供、インストール成功を、それぞれ別の日程として記載しましょう。
- アクティブパラメータ数から予算を組む。 保存容量、トークン当たりの計算量、スループットは、別々に測定してください。
- 効率の推計を、そのまま料金比較に使う。 ベンダーの推論処理が効率的でも、その差が利用者の支払う料金に反映されるとは限りません。
- 見栄えのよいデモを、合格した開発成果として数える。 テスト、レビュー、そして動作がどう変わったかの説明を求めましょう。
特に高くつくのは、公開予定のモデルを待つために、実行可能な導入計画を止めてしまうことです。確立した提供手段を、不確かな改善の可能性と引き換えにする判断だからです。アプリケーションの開発は進め、アクセスできた時点で評価を追加しやすいようにしておきましょう。
Beamを待つべき?今のモデルを使い続けるべき?
移行の判断は待ちつつ、要件を満たしている既存のオープンウェイトモデルで開発と提供を続けましょう。 試験運用を始めるための基準は、標準で使うモデルを置き換える基準より低く設定できます。
開発者:同じ条件で比較できる準備をする
個人開発者や資金調達済みの創業者は、代表的なリポジトリ作業を少数選び、既存モデルの出力とともに保存しておきましょう。アクセスが承認されたら、同じ課題をBeamに実行させ、変更内容をすべて確認します。受け入れ基準を満たす成果が十分に改善し、組み込み作業に見合う場合に限って採用してください。
現在のQwen、DeepSeek、GLM、Mistral、その他のオープンウェイトモデルで十分に対応できているなら、この発表を理由に置き換える必要はありません。幅広い候補はおすすめのオープンソースLLMガイドで紹介しています。ただし、今回の判断は、すでに運用しているモデルと、具体的に把握している失敗から始めるべきです。
運用担当者:安定稼働している構成を守る
運用責任者はフォールバックを確保し、完了時間、不合格となった出力、介入の負担を比較してください。初稿の質が高いモデルでも、ツール操作で繰り返し止まったり、レビューに時間がかかりすぎたりすれば、総合的には劣ることがあります。標準モデルを変更した後で気づくのではなく、試験運用の段階でそうした失敗条件を見えるようにしましょう。
すでに受け入れ確認に合格している定型業務は、そのままで構いません。評価の時間は、修正のやり直し、不完全なリポジトリ変更、よりコストの高い処理先への不要な切り替えといった、費用のかかる失敗に使いましょう。
CTO・調達担当者:実際に導入できる証拠を待つ
プライベート環境での導入を要件とするCTOは、本番スケジュールを確約する前に、ダウンロード用ファイルの提供と、インストールの動作確認を待つべきです。APIでの試験運用に価値があるのは、その利用形態が評価に必要なデータ要件と運用要件を満たす場合です。
Mistral Large 4も候補に入っているなら、公開状況や調達判断の詳細は別記事のMistral Large 4ガイドを参照してください。すべての発表を同じ程度に利用可能な製品と考えるのではなく、自社が使える導入段階にあるかを踏まえて各候補を比較しましょう。
週明けに着手すること: 現在の本番環境の構成を維持し、試験運用が有用ならアクセスを申請して、受け入れ評価タスクの担当者を決めましょう。必要なファイルと実測結果がそろった時点で、移行を再検討します。具体的な日付が示されていない公開予定に、顧客への納品を依存させないでください。
よくある質問
Reflection AIは何かリリースしていますか?
Beamを発表し、ホスト型ベータ版へのアクセス方法を公開しています。プレビューとダウンロード可能な重みの違いは、上の公開状況一覧で確認してください。
Beam AIの料金はいくらですか?
Beamの発表にはAPI料金が記載されていません。試験運用の予算を組む前に、自分のアカウントに適用される条件を確認してください。似た名前の製品の料金を、このモデルの料金として参照することはできません。
Reflection AIの性能はどのくらいですか?
ベンダーが公表したベンチマーク結果から、この記事が想定する開発者や導入担当者にとって、Beamは評価する価値のある候補といえます。本記事では独立した追試を行っていないため、自社の受け入れ基準で比較することを推奨します。
Reflection AIには、すでに使える製品がありますか?
開発者の判断に必要なのは、ホスト型での利用と、インストール可能なモデルを区別することです。公開されているアクセス手順に従い、プレビューの発表だけを根拠にセルフホストの日程を組まないでください。
Reflection AIに投資できますか?
Beamの登録はモデルを利用するためのものです。発表には投資の手続きは示されていません。
Reflection AIの主な競合は?
導入判断では、まず現在のコーディングエージェントで稼働しているモデルを比較対象にしてください。代替候補はリンク先のオープンウェイトモデルのガイドを参照し、実際に運用しているバージョンと構成を明確にして比較しましょう。
Reflection AIの所有者は誰ですか?
Beamの発表には株主構成の内訳は記載されていません。モデルの公開に関する資料であり、所有関係を開示する資料ではありません。
Reflection AIはどのように収益を上げていますか?
Reflectionはホスト型APIのドキュメントを公開していますが、発表では収益の内訳を開示していません。ベンチマークから事業の収益構造を推測しないでください。
Reflection AIの給与水準は?
Beamの発表には、従業員の報酬に関する数値はありません。給与と、Beamの利用・運用にかかる費用は別の話です。
実務に役立つモデル導入の判断材料と、確認済みのリリース情報は、ニュースレターでお届けします。
- 公開日
- カテゴリー
- AI
- 言語
Claudeでスライド作成から文書編集まで:Google Workspace導入ガイド
Claudeでスライド作成を始め、Docsの推敲やSheetsの集計までGoogle Workspace内で進める方法を解説します。有料プラン向けベータの導入手順、管理者設定、編集承認、コネクターとの違いを整理。具体的な試行例と検証基準を使い、修正時間も含めてチームへの導入価値を見極めます。2026年10月10日AI
営業ダッシュボードをClaude Dashboardsで作る:設定・SQL検証・共有の手順
Claude Dashboardsのベータ版で営業ダッシュボードを作る手順を解説します。対象プランと料金、データ接続、SQLの検証、更新時刻、共有先の権限を確認。地域別の受注額を集計する具体例を通じて、数値を照合するポイントと、既存のBIツールを使い続けるべき業務、小さく試すための進め方を整理します。2026年10月10日AI
AI 議事録ツールGranolaレビュー:料金・使い方と選ぶべき人
AI 議事録ツールGranolaを、公式ドキュメントに基づいてレビュー。ボット不要のメモ作成、料金プラン、無料版の30日間の履歴制限、テンプレートや外部連携、同意・データ管理、端末ごとの制約を解説します。創業者・営業担当者・コンサルタント向けに、会議後の仕事で役立つ場面と代替ツールを選ぶ基準を整理しました。2026年10月10日AI
Fyxer レビュー:料金・評判から考える、導入に向く人と注意点
Fyxerの料金・評判・機能を公開資料から詳しく検討します。GmailやOutlookの自動仕分け、返信の下書き、会議メモは月額料金に見合うのでしょうか。ProとTeamの違い、クレジット上限、学習用データの設定、既存ツールとの比較を通じて、創業者や営業チームが導入前に確認したい条件を整理します。2026年10月9日AI
GPT6とは?モデルの違い・料金・リリース日・使えるプランを解説
GPT6のAstra、Sol、6.1 Sol、Lunaはどう違う?各モデルのリリース日、ChatGPTのプラン別対応、Work・Codex・APIでの利用条件と米ドル料金を整理します。キャッシュ入力の単価や月額費用の試算、再試行によるコストの変化、GPT-5.5の提供終了前に確認したい設定まで解説します。2026年10月9日AI
ChatGPT 無料版でできることは?制限・料金・有料版との違い
ChatGPTは無料でどこまで仕事に使えるのでしょうか。Freeで使える機能と、ファイルのアップロード・画像生成・音声・リサーチの制限を整理。広告の表示や登録なしでの利用、APIの別料金も解説し、米国で月額$8のGo、月額$20のPlusを選ぶ目安を、作業の中断や待ち時間から考えます。2026年10月9日AI
Gemini Enterpriseとは?料金・機能・試験導入の判断基準
Gemini Enterpriseの導入を検討するIT担当者向けに、機能の提供状況、コネクタ、エージェントのID、支出上限、料金確認の要点を整理します。30日間無料のPlus試用で、利用できる機能と権限の範囲を確かめ、レビューや運用の時間も含めて業務の価値を見極めるためのガイドです。2026年10月9日AI