IA para programação: vale esperar pelo Reflection AI Beam?
Entenda o Reflection AI Beam: acesso ao beta, previsão de pesos abertos e limites dos benchmarks para decidir se vale esperar antes de trocar seu modelo.
Publicado em
 Por Omid Saffari
- RReflection AI Beam
O Reflection AI Beam merece entrar na sua lista de avaliação de IA para programação, mas não deve atrasar a implantação de um agente de programação que já funciona. O anúncio da Reflection de 5 de outubro de 2026 apresenta uma prévia de acesso limitado e promete pesos para download ainda em outubro. Mantenha o modelo atual atendendo à aplicação enquanto verifica se há espaço para o Beam.
Verificado em 10 de outubro de 2026 com base no anúncio da Reflection e na documentação pública para desenvolvedores. As recomendações de adoção e os cálculos abaixo são análises editoriais; este artigo não envolveu execuções de inferência com o Beam nem a reprodução de benchmarks.
IA para programação: o que muda com o Reflection AI Beam?
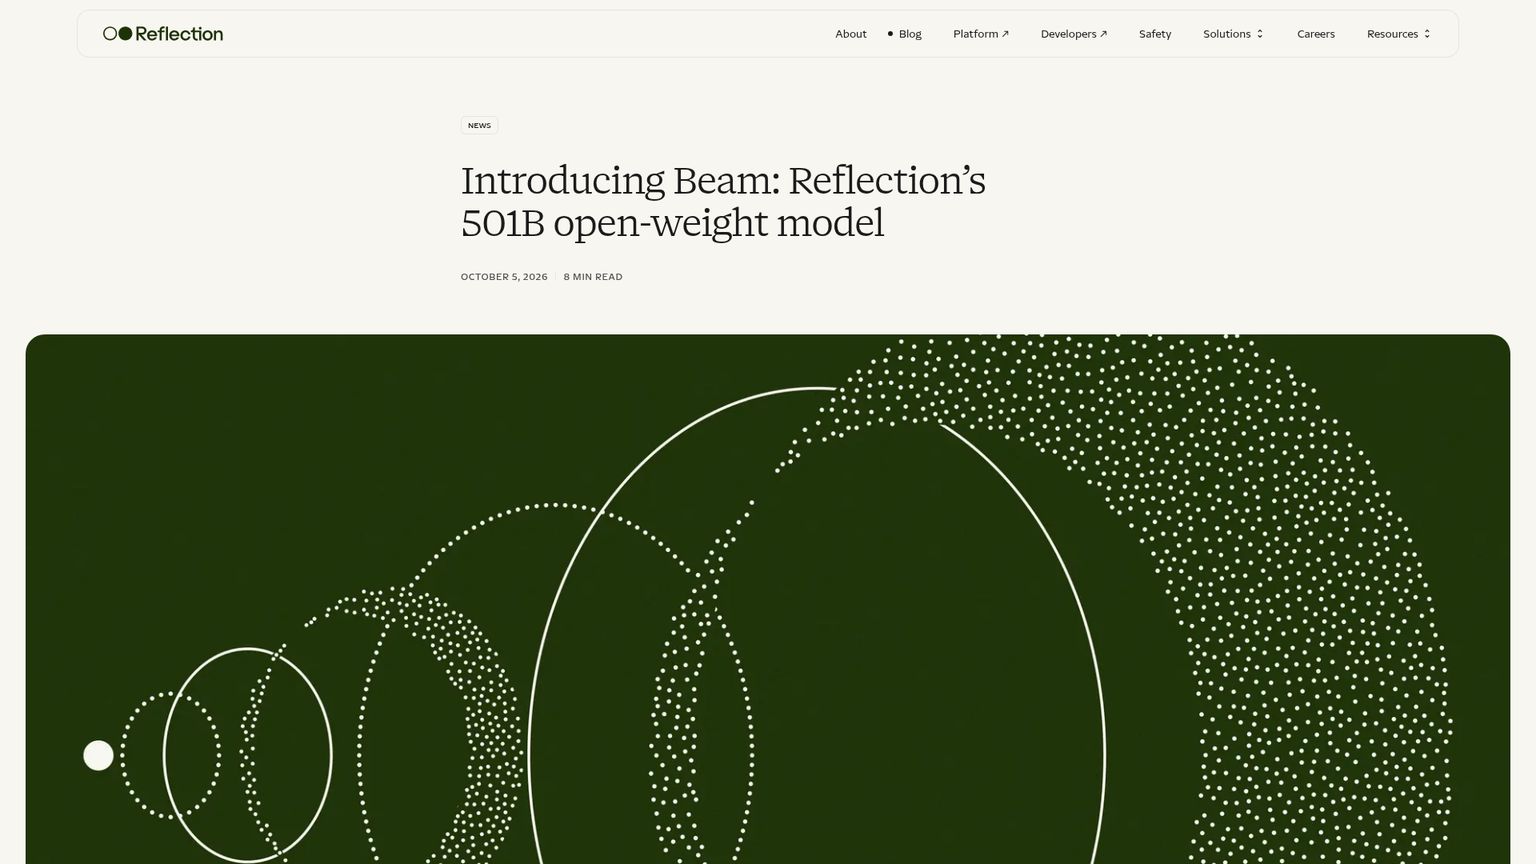
O Beam acrescenta um candidato à sua lista de modelos para programação e agentes. A Reflection descreve um modelo esparso com arquitetura Mixture-of-Experts e 501 bilhões de parâmetros no total, dos quais 23 bilhões ficam ativos, voltado a programação, raciocínio e tarefas com agentes. A empresa informa que pretende disponibilizar os pesos sob a licença Apache 2.0. Fonte: anúncio do modelo pela Reflection.
Parâmetros são os valores numéricos aprendidos pelo modelo. Uma arquitetura Mixture-of-Experts, ou MoE, aciona partes selecionadas do modelo para cada token, a pequena unidade de texto que ele processa. Pense em uma biblioteca: consultar alguns livros dá menos trabalho do que ler todas as estantes, mas o restante do acervo continua ocupando espaço.
Para quem desenvolve, a pergunta útil é se essa arquitetura consegue produzir alterações de código aceitáveis com menos esforço de infraestrutura para servir o modelo. Para um CTO, também importa saber se o futuro pacote de implantação será compatível com a infraestrutura e os requisitos operacionais existentes. A contagem de parâmetros, sozinha, não responde a nenhuma dessas perguntas.
Um agente de programação reúne um modelo, ferramentas, permissões de execução e um ciclo que determina a próxima ação. Trocar o modelo pode mudar a frequência com que o agente lê arquivos, executa testes, repete um comando que falhou ou encerra o trabalho cedo demais. Por isso, a configuração atual do agente faz parte da comparação, mesmo quando a troca parece exigir apenas um pequeno ajuste.
O que já está disponível e quando chegam os pesos?
O caminho público de acesso é uma lista de espera para o beta hospedado. O guia de início rápido da Reflection informa que as chaves de API ficam disponíveis depois da liberação do acesso. Ele também apresenta um Playground para testar prompts.
Na data da verificação, a situação do lançamento era a seguinte:
Fontes: compromissos de lançamento, documentação de acesso ao beta. A Reflection informa o mês, mas não um dia específico. Não há uma data exata de lançamento em outubro para incluir em um contrato de entrega.
Para quem contrata infraestrutura, a disponibilidade do pacote para download deve ser um marco separado do recebimento de uma conta no serviço hospedado. Um piloto hospedado ajuda a entender o comportamento do modelo nas tarefas. Ele não comprova que a quantização pretendida, o mecanismo de inferência, a configuração de hardware ou a instalação offline vão funcionar.
A ficha final do modelo e o relatório técnico importam porque oferecem uma referência estável para examinar os detalhes do modelo e as condições de avaliação. As instruções públicas da API já são úteis, mas respondem a outra questão operacional: como um usuário com acesso liberado faz uma requisição.
Como testar o Beam agora?
Solicite acesso primeiro; depois da aprovação, use o Playground ou a API conforme a documentação. O cadastro é uma solicitação de acesso, não uma garantia de que uma requisição funcionará imediatamente.
Entre na fila de acesso
Abra a plataforma da Reflection indicada no anúncio e faça o cadastro. Quem já teve o acesso aprovado pode entrar na própria conta. A plataforma pública foi inspecionada para este artigo; não foram testados uma conta autenticada nem o retorno do modelo.
Crie uma chave depois da liberação do acesso
Na plataforma, abra API Keys e crie uma chave de projeto. Salve-a na variável de ambiente
REFLECTION_API_KEY. O guia oficial de início rápido descreve essa sequência e a alternativa de usar o Playground.Faça uma requisição simples antes de conectar um agente
Use o identificador do modelo e o endpoint documentados abaixo. Depois de confirmar que o acesso básico funciona, passe para uma cópia descartável de um repositório e uma tarefa com um teste de aceitação bem definido.
curl https://api.reflection.ai/openai/v1/chat/completions \
  -H "Authorization: Bearer $REFLECTION_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Beam-501B-A23B",
    "messages": [
      {"role": "user", "content": "Explain what makes a regression test useful."}
    ]
  }'
O endpoint e o identificador do modelo vêm do guia de início rápido da Reflection; essa requisição não foi executada aqui. Consulte a documentação atual do modelo para a sua configuração do beta antes de desenvolver algo que dependa de um limite do serviço. Os números de contexto da etapa de treinamento não devem ser tratados como uma garantia para requisições em produção.
O que os resultados divulgados nos benchmarks demonstram?
As pontuações justificam uma avaliação, mas não bastam para decidir uma migração. Estes são resultados do Beam publicados pela própria Reflection, sem verificação independente neste artigo. A página informa que a tabela foi atualizada em 8 de outubro de 2026.
Fonte: tabela atualizada de benchmarks da Reflection. As pontuações foram reproduzidas como aparecem na tabela, sem acrescentar unidades que ela não informa.
Uma avaliação útil mantém a mesma tarefa, o mesmo acesso a ferramentas e as mesmas regras de encerramento. Se o modelo atual tem um limite rígido de tempo enquanto o candidato pode tentar indefinidamente, a comparação passa a envolver políticas de operação, além dos modelos. Se o agente mudar o comando de teste ou editar os próprios testes, examine esse comportamento antes de considerar o trabalho aceito.
Para tarefas de manutenção de repositórios, use issues cujo comportamento esperado já seja conhecido. Inclua uma correção de regressão, uma alteração que envolva vários arquivos, uma dependência pouco familiar e uma tarefa em que a ação correta seja pedir informações que faltam. Avalie o resultado pelos testes e critérios de revisão definidos antes de ver a resposta.
Não transforme a média de pontuações de rankings sem relação entre si em um ranking de compra. Uma tarefa de terminal, uma correção de código e uma interação com ferramentas podem revelar falhas diferentes. A empresa precisa de trabalho aceito no próprio ambiente, e não de uma média dos resultados que estavam à mão.
A eficiência precisa ser medida
A Reflection afirma usar 3 a 4 vezes menos computação na inferência do que o GLM-5.2 em comparações de raciocínio avançado. A estimativa exclui o processamento do prompt, a atenção que depende do contexto e o custo adicional de servir o modelo; as avaliações dos modelos usados na comparação vêm da Artificial Analysis e da DataCurve. Fonte: metodologia de eficiência da Reflection.
Essas exclusões fazem diferença para agentes que enviam repetidamente um contexto extenso do repositório. O trabalho deixado de fora de uma estimativa ainda pode consumir recursos dos seus servidores. Registre o tempo até a conclusão, o uso de recursos, as novas tentativas e a intervenção de quem revisa durante toda a tarefa antes de tratar uma vantagem computacional como economia no orçamento.
Quais números importam para hospedar o modelo e planejar o orçamento?
A quantidade de parâmetros ativos, sozinha, não dimensiona uma implantação. Pelos números informados pela Reflection, a parcela ativa é de 23 ÷ 501 × 100 = aproximadamente 4.6%. Essa proporção descreve a capacidade do modelo selecionada para uso; ela não implica uma redução equivalente na memória, na latência ou na sua conta.
Um cálculo de armazenamento deliberadamente simplificado deixa essa diferença clara. Se cada parâmetro fosse armazenado em 4 bits, os pesos brutos ocupariam 501 bilhões × 4 ÷ 8 = 250.5 GB, em gigabytes decimais. Esse é um cálculo nosso a partir da contagem de parâmetros anunciada, não uma quantização compatível com o Beam nem uma medição do espaço ocupado. Ele exclui metadados de empacotamento, buffers de execução e o cache usado durante a geração.
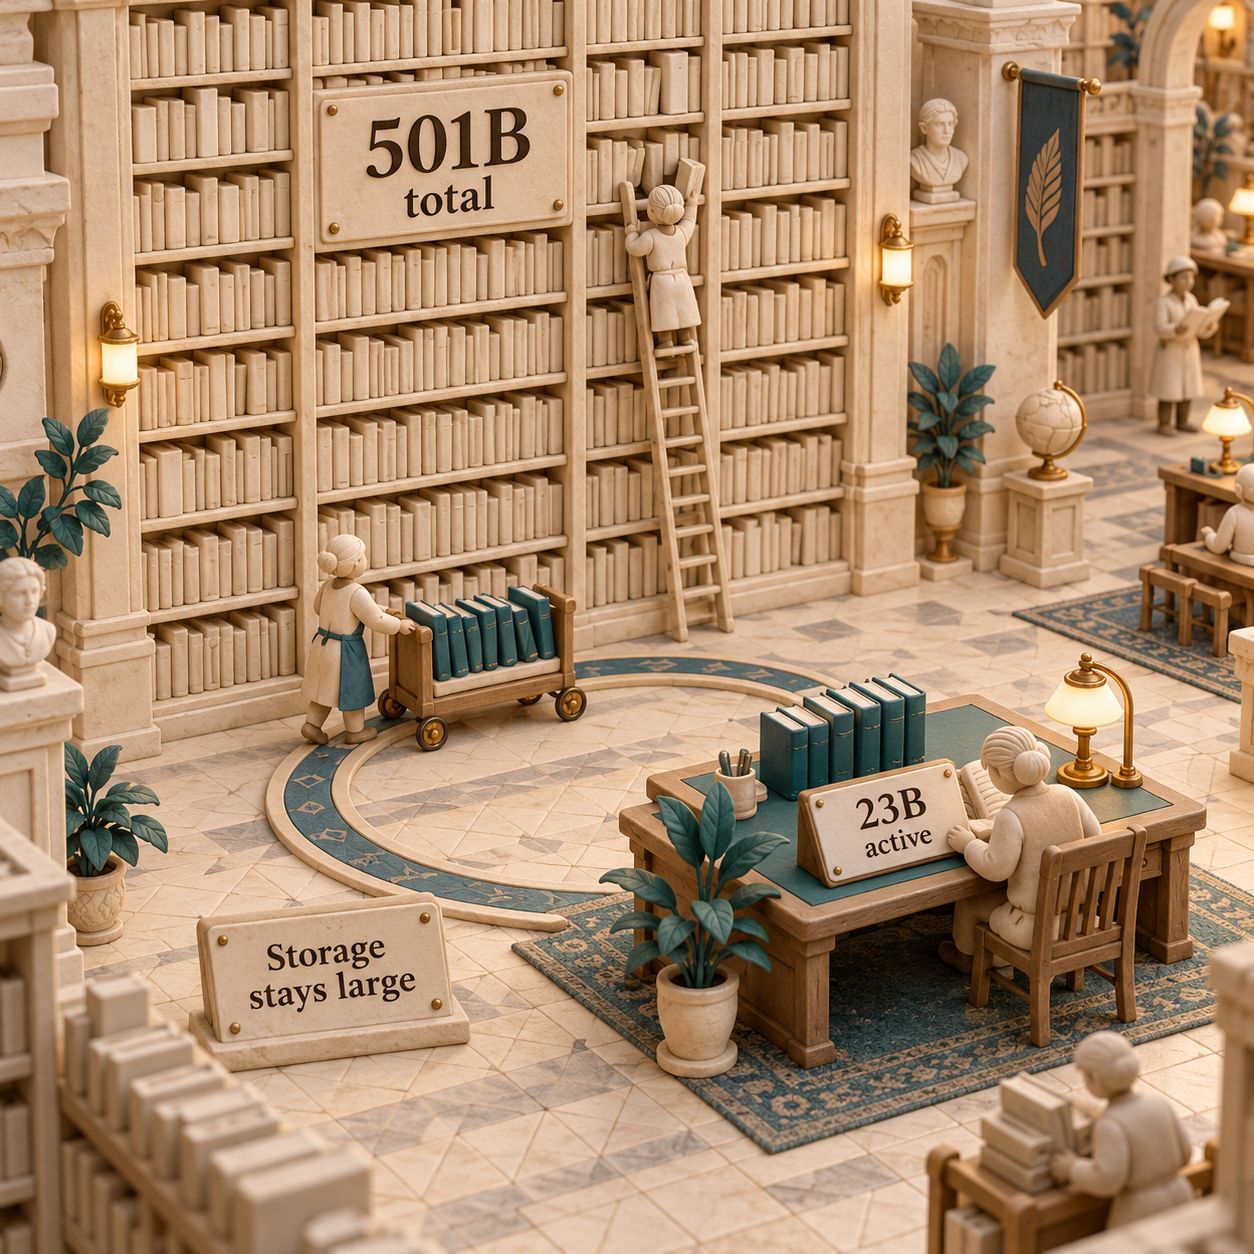
Peça uma configuração que funcione antes de comprar capacidade. É preciso ter uma versão com suporte, uma implementação de inferência identificada, medições de uso de memória e uma taxa de processamento aceitável para a simultaneidade esperada. O tamanho teórico dos pesos não revela quantas sessões de agentes a sua instalação consegue sustentar ao mesmo tempo.
O anúncio da Reflection não informa o preço por token da API. Portanto, essa página não permite montar um orçamento operacional confiável que compare o antes e o depois. Fonte: anúncio.
Ainda assim, é possível definir o retorno mínimo necessário. Em um orçamento ilustrativo de migração, suponha 20 horas de engenharia a $100 por hora: a troca custa $2,000 antes de qualquer economia recorrente. Se um piloto posterior medir $500 de economia líquida por mês, o investimento será recuperado em 4 meses. São premissas explícitas de planejamento, não preços do Beam, economias observadas ou uma previsão.
Calcule a economia líquida depois de descontar infraestrutura, execução de ferramentas, tentativas malsucedidas, manutenção contínua e tempo de revisão. Para um modelo hospedado em infraestrutura própria, dividir o custo operacional total pelas tarefas aceitas é mais útil do que citar um custo nominal por token gerado. Para um modelo em serviço hospedado, inclua o consumo acumulado nas novas tentativas, além da resposta final.
Onde está o exagero?
A conclusão precipitada é achar que um anúncio já comprova a prontidão para implantação ou define o custo operacional. Nem uma licença planejada nem um benchmark atraente substituem as evidências de instalação e aceitação que ainda faltam.
Os erros recorrentes são bem concretos:
- Tratar o acesso à prévia como um lançamento para hospedagem própria. Reserve datas separadas no projeto para o acesso à conta, a disponibilidade dos artefatos e uma instalação bem-sucedida.
- Montar o orçamento com base nos parâmetros ativos. Meça separadamente o armazenamento, a computação por token e a taxa de processamento.
- Transformar uma estimativa de eficiência em uma comparação de preços. Um fornecedor pode servir o modelo com eficiência sem repassar essa diferença ao preço cobrado da sua conta.
- Considerar uma demonstração bem-acabada como uma alteração de engenharia aceita. Exija testes, revisão e uma explicação do comportamento que mudou.
Um erro especialmente caro é paralisar uma implantação viável à espera de um modelo prometido. Isso troca um caminho de entrega conhecido por uma melhoria incerta. Continue avançando com a aplicação e facilite a inclusão da avaliação quando o acesso estiver disponível.
Vale a pena esperar pelo Beam?
Espere para migrar; continue entregando com o modelo de pesos abertos que já atende aos seus requisitos. Os critérios para iniciar um piloto são menos exigentes do que os necessários para substituir o modelo usado por padrão.
Desenvolvedores: preparem a comparação
Quem desenvolve por conta própria ou fundou uma empresa que recebeu investimento deve guardar um pequeno conjunto de tarefas representativas do repositório e as respostas do modelo atual. Depois da liberação do acesso, use o Beam nos mesmos casos e examine as alterações completas. Adote-o apenas onde a melhoria dos resultados aceitos justificar o trabalho de integração.
Se a sua implantação atual de Qwen, DeepSeek, GLM, Mistral ou outro modelo de pesos abertos é adequada, o anúncio não cria a obrigação de substituí-la. O guia dos melhores LLMs open source apresenta um panorama mais amplo de opções; esta decisão começa pelo modelo que você já opera e pelas falhas que consegue identificar.
Responsáveis pela operação: preservem o que já funciona
Quem lidera a operação deve manter uma alternativa de contingência e comparar tempo de conclusão, resultados rejeitados e necessidade de intervenção. Um modelo que produz uma primeira versão melhor ainda pode sair perdendo se travar repetidamente ao usar ferramentas ou consumir tempo demais de revisão. Torne essas falhas visíveis no piloto, antes de trocar o modelo padrão.
As tarefas rotineiras que já passam nos critérios de aceitação não são afetadas. Concentre a avaliação nas falhas caras: tentativas repetidas de correção, alterações incompletas no repositório ou encaminhamentos desnecessários para uma opção mais cara.
CTOs e compradores: aguardem provas de que o modelo pode ser implantado
Um CTO que precisa de implantação privada deve esperar pelos artefatos para download e por uma instalação verificada antes de comprometer o cronograma de produção. Um piloto via API só vale a pena se esse acesso atender aos requisitos de dados e operação da avaliação.
Se o Mistral Large 4 também estiver na lista, consulte o guia do Mistral Large 4 para os detalhes de lançamento e aquisição. Compare cada candidato na etapa de implantação que você consegue usar, em vez de presumir que todos os anúncios representam produtos igualmente disponíveis.
O próximo passo para segunda-feira: mantenha o modelo atual em produção, solicite acesso se um piloto for útil e defina um responsável pelas tarefas de aceitação. Retome a decisão de migração quando os artefatos necessários e os resultados medidos estiverem disponíveis. Não condicione uma entrega ao cliente a um dia de lançamento que não foi especificado.
Perguntas frequentes
A Reflection AI já lançou algum produto?
A empresa anunciou o Beam e documentou o acesso ao beta hospedado. Consulte a lista de lançamento acima para distinguir a prévia dos pesos para download.
Quanto custa o Beam AI?
O anúncio do Beam não informa o preço da API. Confirme as condições disponíveis para a sua conta antes de orçar um piloto; produtos com nomes semelhantes não servem de referência para os preços deste modelo.
A Reflection AI é boa?
Os resultados dos benchmarks divulgados pelo fornecedor justificam avaliar o Beam para o público deste artigo. Não houve reprodução independente desses testes aqui; por isso, a recomendação é fazer sua própria comparação com critérios de aceitação.
A Reflection AI já disponibilizou algo para uso?
Para quem desenvolve, a distinção prática é entre acesso hospedado e um modelo que pode ser instalado. Siga o processo de acesso documentado; não planeje a hospedagem própria apenas com base no anúncio de uma prévia.
Posso investir na Reflection AI?
O cadastro do Beam se destina ao acesso ao modelo. O anúncio não apresenta um processo para investir na empresa.
Quem são os principais concorrentes da Reflection AI?
Para decidir sobre a adoção, comece pelo modelo que já atende ao seu agente de programação. Consulte o guia de modelos de pesos abertos indicado no texto para conhecer alternativas e compare a versão e a configuração exatas que você opera.
Quem são os donos da Reflection AI?
O anúncio do Beam não detalha a composição acionária. É um documento de lançamento de modelo, não uma divulgação sobre a participação dos acionistas.
Como a Reflection AI ganha dinheiro?
A Reflection documenta uma API hospedada, mas o anúncio não detalha as fontes de receita. Não tire conclusões sobre a viabilidade econômica de um modelo de negócio a partir de um benchmark.
Quanto a Reflection AI paga aos funcionários?
O anúncio do Beam não informa a remuneração dos funcionários. Salários são uma questão separada do custo de acessar ou operar o Beam.
Assine a newsletter para acompanhar orientações práticas sobre adoção de modelos e atualizações verificadas de lançamentos.
- Publicado
- Categoria
- AI
- Idioma
Claude no Google Workspace: como testar com sua equipe
Veja como instalar o Claude no Google Workspace, controlar edições e testar o beta em Docs, Sheets e Slides com três fluxos práticos para sua equipe.10 de out. de 2026AI
Dashboard de vendas com Claude Dashboards: do acesso à revisão
Aprenda a configurar Claude Dashboards beta, conferir o SQL e validar um dashboard de vendas antes de compartilhar. Veja quando manter sua ferramenta de BI.10 de out. de 2026AI
Granola IA: vale a pena para suas reuniões de trabalho?
Veja se o Granola IA vale a pena para reuniões de trabalho: preços em dólar, notas sem bot, integrações, privacidade e limites para escolher o plano certo.10 de out. de 2026AI
Fyxer AI vale a pena? Preços, privacidade e análise
Fyxer AI vale a pena? Entenda os planos, os limites de créditos, a privacidade e quando a organização de e-mails e os rascunhos justificam a assinatura.9 de out. de 2026AI
GPT 6: entenda os modelos, os preços e o acesso no ChatGPT
Entenda as diferenças entre GPT-6 Astra, Sol, 6.1 Sol e Luna, veja preços da API em dólar, datas de lançamento e acesso no ChatGPT, Work e Codex.9 de out. de 2026AI
ChatGPT gratuito: o que dá para fazer sem pagar
Veja o que o ChatGPT gratuito oferece, os limites no trabalho, os anúncios e o acesso sem cadastro. Entenda quando vale pagar pelos planos Go ou Plus.9 de out. de 2026AI
Gemini Enterprise: agentes, custos e critérios para um piloto
Entenda o Gemini Enterprise, seus agentes e conectores, as limitações de acesso antecipado e como avaliar custos e entregas no teste gratuito da edição Plus.9 de out. de 2026AI