Beam AI di Reflection: quando adottarlo per coding e agenti
Beam AI di Reflection: rilascio previsto a ottobre, accesso alla beta e benchmark dichiarati. Cosa valutare prima di cambiare modello per coding e agenti.
Pubblicato il
 Di Omid Saffari
- RReflection AI Beam
Beam AI di Reflection merita un posto tra i modelli da valutare, ma non dovrebbe rallentare la messa in produzione di un agente di coding che già funziona. L'annuncio di Reflection del 5 ottobre 2026 presenta un'anteprima ad accesso limitato e promette pesi scaricabili entro la fine di ottobre. Continuate a usare il modello attuale in produzione mentre verificate se Beam merita di affiancarlo o sostituirlo.
Verificato il 10 ottobre 2026 sulla base dell'annuncio di Reflection e della documentazione pubblica per sviluppatori. Le raccomandazioni sull'adozione e i calcoli che seguono sono analisi redazionali: per questo articolo non sono state eseguite inferenze con Beam né repliche dei benchmark.
Beam AI di Reflection: cosa cambia per chi sviluppa
Beam aggiunge un candidato alla lista dei modelli da valutare per coding e agenti. Reflection lo descrive come un modello Mixture-of-Experts sparso con 501 miliardi di parametri totali, di cui 23 miliardi attivi, pensato per programmazione, ragionamento e attività svolte da agenti. La licenza prevista per i pesi è Apache 2.0. Fonte: annuncio del modello di Reflection.
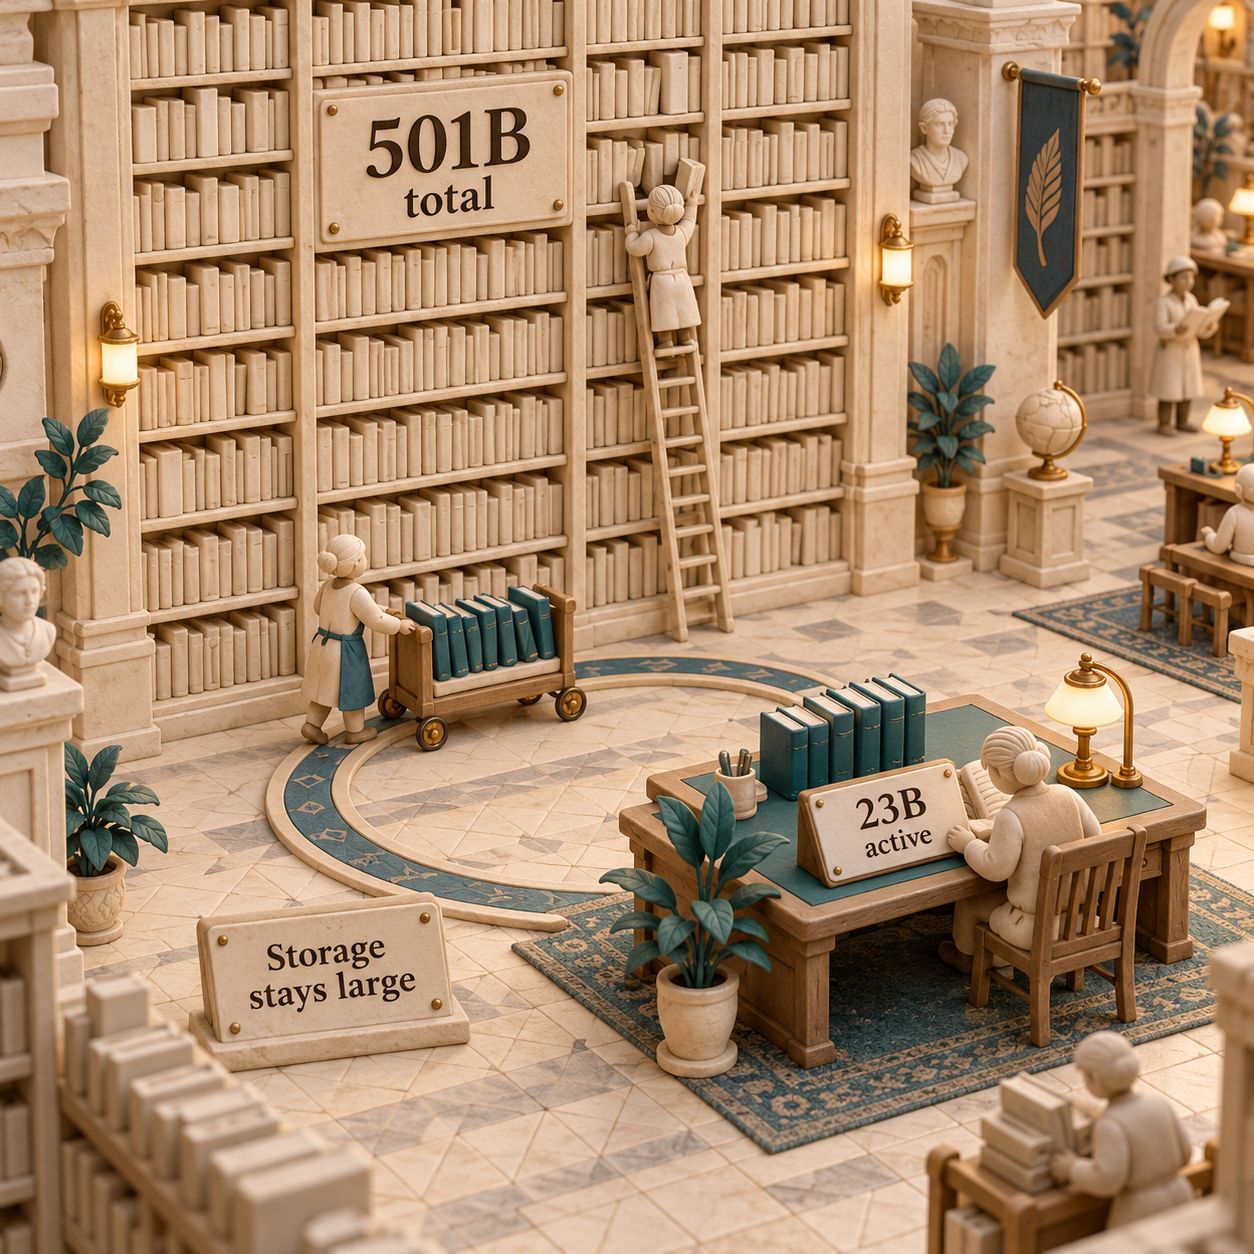
I parametri sono i valori numerici che un modello apprende durante l'addestramento. Un'architettura Mixture-of-Experts, o MoE, usa solo alcune parti del modello per ogni token, la piccola unità di testo che elabora. Pensate a una biblioteca: consultare alcuni libri richiede meno lavoro che leggere tutti gli scaffali, ma il resto della collezione continua a occupare spazio.
Per chi sviluppa, la domanda utile è se questa architettura riesca a produrre patch accettabili con un minore carico di esecuzione. Un CTO deve anche capire se il pacchetto di distribuzione finale sarà compatibile con l'infrastruttura e i requisiti operativi esistenti. Il solo numero di parametri non risponde a nessuna delle due domande.
Un agente di coding combina un modello, strumenti, permessi di esecuzione e un ciclo che decide l'azione successiva. Cambiare modello può modificare la frequenza con cui l'agente legge i file, esegue i test, riprova un comando fallito o si ferma troppo presto. La configurazione attuale dell'agente fa quindi parte del confronto, anche quando sostituire il modello sembra richiedere solo una piccola modifica alla configurazione.
Cosa è disponibile oggi e quando arriveranno i pesi?
Il percorso pubblico di accesso passa da una lista d'attesa per la beta ospitata da Reflection. La guida rapida di Reflection spiega che le chiavi API diventano disponibili dopo l'abilitazione dell'accesso; documenta anche un Playground in cui provare i prompt.
Alla data della verifica, lo stato del rilascio è questo:
Fonti: impegni sul rilascio, documentazione sull'accesso alla beta. Reflection indica un mese, non un giorno preciso. Non c'è una data specifica di ottobre da inserire in un contratto di consegna.
Chi acquista infrastruttura dovrebbe considerare la disponibilità del pacchetto scaricabile come una tappa distinta dall'attivazione di un account sul servizio ospitato. Un progetto pilota sul servizio può mostrare come il modello si comporta nei compiti assegnati. Non può dimostrare che funzionino la quantizzazione prevista, il motore di inferenza, la configurazione hardware o l'installazione offline.
La scheda definitiva del modello e il rapporto tecnico sono importanti perché offrono a chi valuta un riferimento stabile per esaminare i dettagli del modello e le condizioni dei test. Le istruzioni pubbliche delle API sono già utili, ma rispondono a una domanda operativa diversa: come inviare una richiesta una volta ottenuto l'accesso.
Come provare Beam oggi
Prima richiedete l'accesso; dopo l'approvazione, usate il Playground o le API documentate. L'iscrizione serve a candidarsi per l'accesso e non garantisce che una richiesta funzioni subito.
Iscrivetevi alla lista d'attesa
Aprite la piattaforma Reflection collegata nell'annuncio e registratevi. Gli utenti già approvati possono accedere al proprio account. Per questo articolo è stata esaminata la piattaforma pubblica; non sono stati provati un account autenticato né una risposta del modello.
Create una chiave dopo l'abilitazione dell'accesso
Nella piattaforma, aprite API Keys e create una chiave di progetto. Salvatela nella variabile d'ambiente
REFLECTION_API_KEY. La guida rapida ufficiale descrive questa procedura e l'alternativa del Playground.Inviate una richiesta semplice prima di collegare un agente
Usate l'identificativo del modello e l'endpoint documentati qui sotto. Quando l'accesso di base funziona, passate a una copia temporanea di un repository e a un compito con un test di accettazione chiaro.
curl https://api.reflection.ai/openai/v1/chat/completions \
  -H "Authorization: Bearer $REFLECTION_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Beam-501B-A23B",
    "messages": [
      {"role": "user", "content": "Explain what makes a regression test useful."}
    ]
  }'
L'endpoint e l'identificativo del modello provengono dalla guida rapida di Reflection; questa richiesta non è stata eseguita per l'articolo. Prima di progettare il sistema intorno a un limite del servizio, consultate la documentazione aggiornata del modello per la vostra configurazione beta. I valori della finestra di contesto usati in addestramento non vanno considerati limiti garantiti per le richieste in produzione.
Cosa dimostrano i benchmark dichiarati?
I punteggi pubblicati giustificano un approfondimento, non una decisione di migrazione. Sono risultati di Beam pubblicati da Reflection e non verificati in modo indipendente in questo articolo. La pagina indica che la tabella è stata aggiornata l'8 ottobre 2026.
Fonte: tabella aggiornata dei benchmark di Reflection. I punteggi sono riportati come compaiono nella tabella, senza aggiungere unità che la fonte non specifica.
Una valutazione utile mantiene invariati il compito, l'accesso agli strumenti e le condizioni di arresto. Se il modello attuale ha un limite di tempo rigido e il candidato può riprovare senza limiti, state confrontando anche le regole operative, oltre ai modelli. Se l'agente modifica il comando con cui esegue i test o interviene sui test stessi, esaminate quel comportamento prima di considerare il lavoro accettato.
Per attività di manutenzione di un repository, scegliete issue di cui sia già chiaro il comportamento atteso. Includete la correzione di una regressione, una modifica che coinvolga più file, una dipendenza poco conosciuta e un compito in cui l'azione corretta sia chiedere informazioni mancanti. Valutate il lavoro prodotto in base a test e requisiti di revisione definiti prima di vedere la risposta.
Non fate la media di punteggi ottenuti in classifiche eterogenee per stilare una graduatoria d'acquisto. Un'attività da terminale, una correzione del codice e un'interazione con uno strumento possono far emergere problemi diversi. All'azienda serve lavoro accettabile nel proprio ambiente, non una media dei punteggi che si trovano più facilmente.
L'efficienza resta un'ipotesi da misurare
Reflection dichiara un fabbisogno di calcolo in inferenza da 3 a 4 volte inferiore a quello di GLM-5.2 nei confronti sul ragionamento avanzato. La stima esclude l'elaborazione del prompt, il calcolo dell'attenzione legato al contesto e il sovraccarico del servizio di inferenza; le valutazioni del modello di confronto provengono da Artificial Analysis e DataCurve. Fonte: metodologia di Reflection per l'efficienza.
Queste esclusioni contano per gli agenti che inviano ripetutamente un ampio contesto del repository. Il lavoro lasciato fuori da una stima può comunque impegnare i vostri server. Registrate tempo di completamento, risorse utilizzate, tentativi ripetuti e interventi dei revisori sull'intero compito prima di considerare il vantaggio di calcolo un risparmio di budget.
Self-hosting e budget: quali numeri contano davvero?
I soli parametri attivi non bastano a dimensionare un'installazione. Sulla base dei valori dichiarati da Reflection, la quota attiva è 23 ÷ 501 × 100 = circa 4.6%. Il rapporto descrive la porzione di modello selezionata; non implica una riduzione equivalente della memoria, della latenza o della fattura.
Un calcolo volutamente semplificato dello spazio necessario rende chiara la distinzione. Se ogni parametro fosse memorizzato in 4 bit, i pesi grezzi occuperebbero 501 miliardi × 4 ÷ 8 = 250.5 GB, espressi in gigabyte decimali. È un nostro calcolo ricavato dal numero di parametri annunciato, non una quantizzazione supportata di Beam né una misura dell'occupazione effettiva. Esclude i metadati di impacchettamento, i buffer di esecuzione e la cache usata durante la generazione.
Prima di acquistare capacità, chiedete una configurazione funzionante. Servono una versione supportata, un'implementazione di inferenza identificata, misure dell'uso di memoria e una capacità di elaborazione accettabile al livello di concorrenza previsto. La dimensione teorica dei pesi non dice quante sessioni simultanee di agenti possa sostenere la vostra installazione.
L'annuncio di Reflection non indica un prezzo dei token API. Da quella pagina non si può quindi ricavare un budget operativo credibile per confrontare la situazione prima e dopo la migrazione. Fonte: annuncio.
Potete comunque definire la soglia da raggiungere. In un budget di migrazione puramente illustrativo, ipotizzate 20 ore di lavoro tecnico a $100 l'ora: il passaggio costa $2,000 prima di qualsiasi risparmio ricorrente. Se un successivo progetto pilota misura $500 al mese di risparmio netto, per recuperare l'investimento servono 4 mesi. Sono ipotesi esplicite di pianificazione, non tariffe di Beam, risparmi osservati o previsioni.
Calcolate il risparmio netto dopo aver incluso infrastruttura, esecuzione degli strumenti, tentativi falliti, manutenzione continuativa e tempo di revisione. Per un modello gestito sulla propria infrastruttura, dividere il costo operativo complessivo per i compiti accettati è più utile che citare un costo nominale per token generato. Per un modello ospitato dal fornitore, includete i consumi accumulati durante i tentativi ripetuti, non solo quelli della risposta finale.
Dove si sta esagerando?
È prematuro pensare che un annuncio basti a stabilire se il modello sia pronto per la produzione o quanto costi gestirlo. Né una licenza prevista né un benchmark promettente forniscono le prove di installazione e accettazione ancora mancanti.
Gli errori ricorrenti sono concreti:
- Confondere l'accesso all'anteprima con il rilascio per il self-hosting. Nel piano di progetto, assegnate date distinte all'accesso all'account, alla disponibilità degli artefatti e al completamento di un'installazione funzionante.
- Fare il budget a partire dai parametri attivi. Misurate separatamente spazio di archiviazione, calcolo per token e capacità di elaborazione.
- Trasformare una stima di efficienza in un confronto di prezzi. Un fornitore può eseguire il modello in modo efficiente senza trasferire quel vantaggio al prezzo pagato dal vostro account.
- Considerare una demo curata come una modifica software accettata. Richiedete test, revisione e una spiegazione del comportamento che è cambiato.
Un errore particolarmente costoso è bloccare una messa in produzione già praticabile nell'attesa di un modello promesso. Significa scambiare un percorso di consegna noto con un miglioramento incerto. Continuate a far avanzare l'applicazione e preparate la valutazione in modo da poterla avviare facilmente quando avrete accesso.
Conviene aspettare Beam?
Aspettate prima di migrare; continuate a rilasciare con il modello a pesi aperti che già soddisfa i vostri requisiti. Per avviare un progetto pilota bastano meno prove di quante ne servano per sostituire il modello usato di default.
Sviluppatori: preparate il confronto
Chi sviluppa da solo o ha fondato una startup finanziata dovrebbe conservare un piccolo insieme di compiti rappresentativi sul repository, insieme agli output del modello attuale. Una volta ottenuto l'accesso, usate Beam sugli stessi casi ed esaminate tutte le modifiche prodotte. Adottatelo solo dove i risultati accettati migliorano abbastanza da giustificare il lavoro di integrazione.
Se l'attuale installazione di Qwen, DeepSeek, GLM, Mistral o di un altro modello a pesi aperti è adeguata, l'annuncio non impone alcuna sostituzione. La guida ai migliori LLM open source offre una panoramica più ampia; questa decisione parte dal modello che già utilizzate e dai problemi che sapete identificare.
Responsabili operativi: tutelate ciò che già funziona
Un responsabile operativo esperto dovrebbe mantenere un'alternativa di riserva e confrontare tempi di completamento, output respinti e carico degli interventi umani. Un modello capace di produrre una prima bozza migliore può comunque risultare peggiore se si blocca ripetutamente nell'uso degli strumenti o richiede troppo tempo di revisione. Fate emergere queste condizioni di fallimento nel progetto pilota, invece di scoprirle dopo aver cambiato il modello predefinito.
Le attività ordinarie che già superano i controlli di accettazione non richiedono cambiamenti. Dedicate la valutazione ai problemi più costosi: ripetuti tentativi di correzione, modifiche incomplete al repository o ricorso non necessario a una soluzione più cara.
CTO e acquirenti: aspettate prove di un'installazione funzionante
Un CTO che richiede un'installazione privata dovrebbe attendere gli artefatti scaricabili e un'installazione verificata prima di impegnarsi sul calendario di produzione. Un progetto pilota via API ha senso solo se quell'accesso soddisfa i requisiti sui dati e sull'operatività della valutazione.
Se tra i candidati c'è anche Mistral Large 4, consultate la guida dedicata a Mistral Large 4 per i dettagli sul rilascio e sull'acquisto. Confrontate ogni candidato nella forma di distribuzione che potete effettivamente usare, senza presumere che tutti gli annunci corrispondano a prodotti ugualmente disponibili.
La mossa da fare lunedì: mantenete la configurazione attuale in produzione, richiedete l'accesso se un progetto pilota è utile e assegnate a un responsabile i compiti di accettazione. Tornate sulla decisione di migrare quando saranno disponibili gli artefatti necessari e risultati misurati. Non fate dipendere una consegna al cliente da un giorno di rilascio non ancora specificato.
Domande frequenti
Reflection AI ha già rilasciato qualcosa?
Ha annunciato Beam e documentato l'accesso alla beta ospitata. Consultate il riepilogo del rilascio qui sopra per distinguere l'anteprima dai pesi scaricabili.
Quanto costa Beam AI?
L'annuncio di Beam non indica un prezzo delle API. Prima di definire il budget di un progetto pilota, verificate le condizioni disponibili per il vostro account; i prodotti con nomi simili non sono una fonte per le tariffe di questo modello.
Quanto è valido Reflection AI?
I risultati dei benchmark del fornitore rendono Beam un candidato da valutare per i lettori a cui si rivolge questo articolo. Qui non è stata eseguita alcuna replica indipendente: la raccomandazione è quindi di effettuare un confronto basato sui propri criteri di accettazione.
Reflection AI ha già reso disponibile un prodotto utilizzabile?
Per chi sviluppa, la distinzione pratica è tra accesso a un servizio ospitato e modello installabile. Seguite la procedura di accesso documentata; non pianificate il self-hosting basandovi soltanto sull'annuncio di un'anteprima.
Si può investire in Reflection AI?
L'iscrizione a Beam serve a ottenere l'accesso al modello. L'annuncio non descrive alcuna procedura di investimento.
Quali sono i principali concorrenti di Reflection AI?
Per decidere cosa adottare, partite dal modello che già alimenta il vostro agente di coding. Consultate la guida ai modelli a pesi aperti collegata nell'articolo per le alternative e confrontate la versione e la configurazione esatte che utilizzate.
Chi possiede Reflection AI?
L'annuncio di Beam non riporta la composizione dell'azionariato. È un documento sul rilascio di un modello, non una comunicazione sull'assetto proprietario.
Come guadagna Reflection AI?
Reflection documenta un'API ospitata, ma l'annuncio non rivela la ripartizione dei ricavi. Non deducete l'economia di un modello di business da un benchmark.
Quanto paga Reflection AI ai dipendenti?
L'annuncio di Beam non contiene dati sulle retribuzioni dei dipendenti. Gli stipendi sono una questione distinta dal costo di accesso a Beam o della sua gestione.
Iscrivetevi alla newsletter per indicazioni pratiche sull'adozione dei modelli e aggiornamenti verificati sui rilasci.
- Pubblicato
- Categoria
- AI
- Lingua
Claude per Google Workspace: come provarlo in azienda
Claude per Google Workspace: installazione, controlli e tre prove pratiche in Docs, Sheets e Slides per valutare la beta con un progetto pilota aziendale.10 ott 2026AI
Creare dashboard con Claude: dalla configurazione ai controlli SQL
Come creare dashboard con Claude: configura la beta, verifica SQL, dati e accessi e valuta quando affiancarla a Looker Studio, Metabase o Power BI.10 ott 2026AI
Granola AI: recensione, prezzi e limiti per le riunioni
Granola AI prende appunti senza bot nelle riunioni. Scopri prezzi, integrazioni, limiti e privacy, e quando conviene a consulenti e team commerciali.10 ott 2026AI
Fyxer AI: conviene per gestire email e riunioni?
Recensione di Fyxer AI: prezzi, crediti, privacy e limiti per email e riunioni. Scopri a chi conviene e quando scegliere SaneBox, Gemini o Copilot.9 ott 2026AI
GPT 6: quale modello scegliere, quanto costa e dove usarlo
GPT 6: guida ad Astra, Sol, 6.1 Sol e Luna. Scopri date di uscita, prezzi API e accesso con i piani ChatGPT, Work e Codex per scegliere il modello adatto.9 ott 2026AI
ChatGPT gratis: cosa include e quando conviene pagare
ChatGPT gratis: funzioni, limiti, pubblicità e accesso senza account. Scopri quando basta Free e quando conviene passare a Go o Plus, con prezzi in USD.9 ott 2026AI
Gemini Enterprise in azienda: funzioni, costi e prova Plus
Gemini Enterprise per le aziende: funzioni disponibili, connettori, controlli e prova Plus di 30 giorni. Come valutare costi e risultati prima dell’acquisto.9 ott 2026AI