Mistral Large 4: Was es kostet und wann es sich lohnt
Mistral Large 4 im Überblick: API-Preise, Einführungsrabatt und Benchmarks. Wann sich die Preview lohnt und wer auf die Modellgewichte warten sollte.
Mistral Large 4 lohnt sich für einen Pilotversuch über den gehosteten Dienst, wenn Sicherheitsaufgaben oder umfangreiche Dokumente im Mittelpunkt stehen. Wer das Modell selbst betreiben muss, sollte dagegen auf die Modellgewichte warten, die Mistral bis Ende Oktober 2026 angekündigt hat. Der angekündigte API-Preis beträgt $1.36 pro Million Eingabetokens und $4.18 pro Million Ausgabetokens; der aktuelle Einführungsrabatt von 50% senkt diese Preise auf $0.68 und $2.09. Ein günstigeres Modell, das seine Aufgaben bereits ausreichend gut erfüllt, sollte im Einsatz bleiben. Large 4 muss sich an den Kosten pro akzeptiertem Arbeitsergebnis messen lassen.
Dokumentation zu Veröffentlichung, Preisen und Bereitstellung geprüft am 7. Oktober 2026. Die folgenden Angaben zum Modellstart und zu den Benchmarks stammen aus Mistrals Ankündigung; die aktuell berechneten Preise aus der API-Preisliste für die einzelnen Modellversionen. Das Budget für die Dokumentenverarbeitung ist eine ausdrücklich ausgewiesene Beispielrechnung. Es handelt sich weder um gemessene Ausgaben noch um die Behauptung, dass dieses Modell hier getestet wurde.
Mistral Large 4: Was seit dem 6. Oktober neu ist
Mistral hat am 6. Oktober 2026 eine gehostete öffentliche Preview veröffentlicht. Herunterladbare Modellgewichte sind weiterhin erst für später angekündigt. Damit gehört das Modell jetzt auf die Liste möglicher Testkandidaten. Unternehmen können es aber noch nicht herunterladen und in ihrer eigenen Infrastruktur betreiben. Mistral nennt Ende Oktober als Ziel und will zusammen mit den Gewichten weitere Angaben zur Architektur und zum nachgelagerten Training veröffentlichen. Quelle: Ankündigung zum Modellstart.
Laut Ankündigung verfügt Mistral Large 4 über insgesamt 1T Parameter und 49B aktive Parameter, eine hybride Mixture-of-Experts-Architektur für Instruktionsbefolgung und Reasoning sowie multimodale Eingaben. Parameter sind die Zahlenwerte, die ein Modell während des Trainings lernt. Eine Mixture-of-Experts-Architektur, kurz MoE, aktiviert für jedes Token ausgewählte Teile des Modells, statt bei jedem Schritt sämtliche Parameter zu nutzen. Der hybride Ansatz verbindet die gewöhnliche Befolgung von Anweisungen mit ausführlicherer Problemlösung im selben Modell. Multimodale Eingaben ermöglichen die Verarbeitung visueller Inhalte. Das ist etwa für Diagramme, technische Zeichnungen und Belege in Dokumenten relevant. Diese Angaben beschreiben das Modell laut Ankündigung; sie reichen nicht zur Planung der nötigen Hardware. Quelle: Mistrals Modellbeschreibung.
Der derzeit bestätigte Zugang führt über Mistral Studio und die Preview-API, die Entwicklerplattform im Umfeld von La Plateforme. Für reproduzierbare Tests dieser Version sollte die Kennung mistral-large-4-0 verwendet werden. Die Dokumentation der Modellversion nennt außerdem den kürzeren Namen mistral-large-4 und unterstützt Chat Completions, strukturierte Ausgaben, Function Calling sowie die Beantwortung von Fragen zu Dokumenten. Mit strukturierten Ausgaben kann eine Anwendung ein festgelegtes Antwortformat anfordern. Über Function Calling kann sie eine Aktion eines von ihr bereitgestellten Tools anfordern.
Die Ankündigung verweist auf Studio. Sie belegt nicht, dass genau dieses Preview-Modell in Le Chat oder Vibe auswählbar ist. Ein Abonnement für Endnutzer und ein Entwicklerendpunkt für eine bestimmte Modellversion erfüllen unterschiedliche Beschaffungsanforderungen. Für reproduzierbare Modelltests ist deshalb der API-Zugang maßgeblich.
Eine Abweichung in den technischen Angaben muss sichtbar bleiben: Die aktuelle Dokumentation der Modellversion nennt insgesamt 1.05T und 52B aktive Parameter, die Ankündigung dagegen 1T und 49B. Es handelt sich um unterschiedliche Angaben desselben Anbieters. Keine davon sollte stillschweigend durch die andere ersetzt werden. Die oben genannten Werte sind ausdrücklich der Ankündigung zugeordnet. Die endgültige Architektur und die Voraussetzungen für den Betrieb müssen nach Veröffentlichung der Gewichte erneut geprüft werden. Quelle: aktuelle Dokumentation der Modellversion.
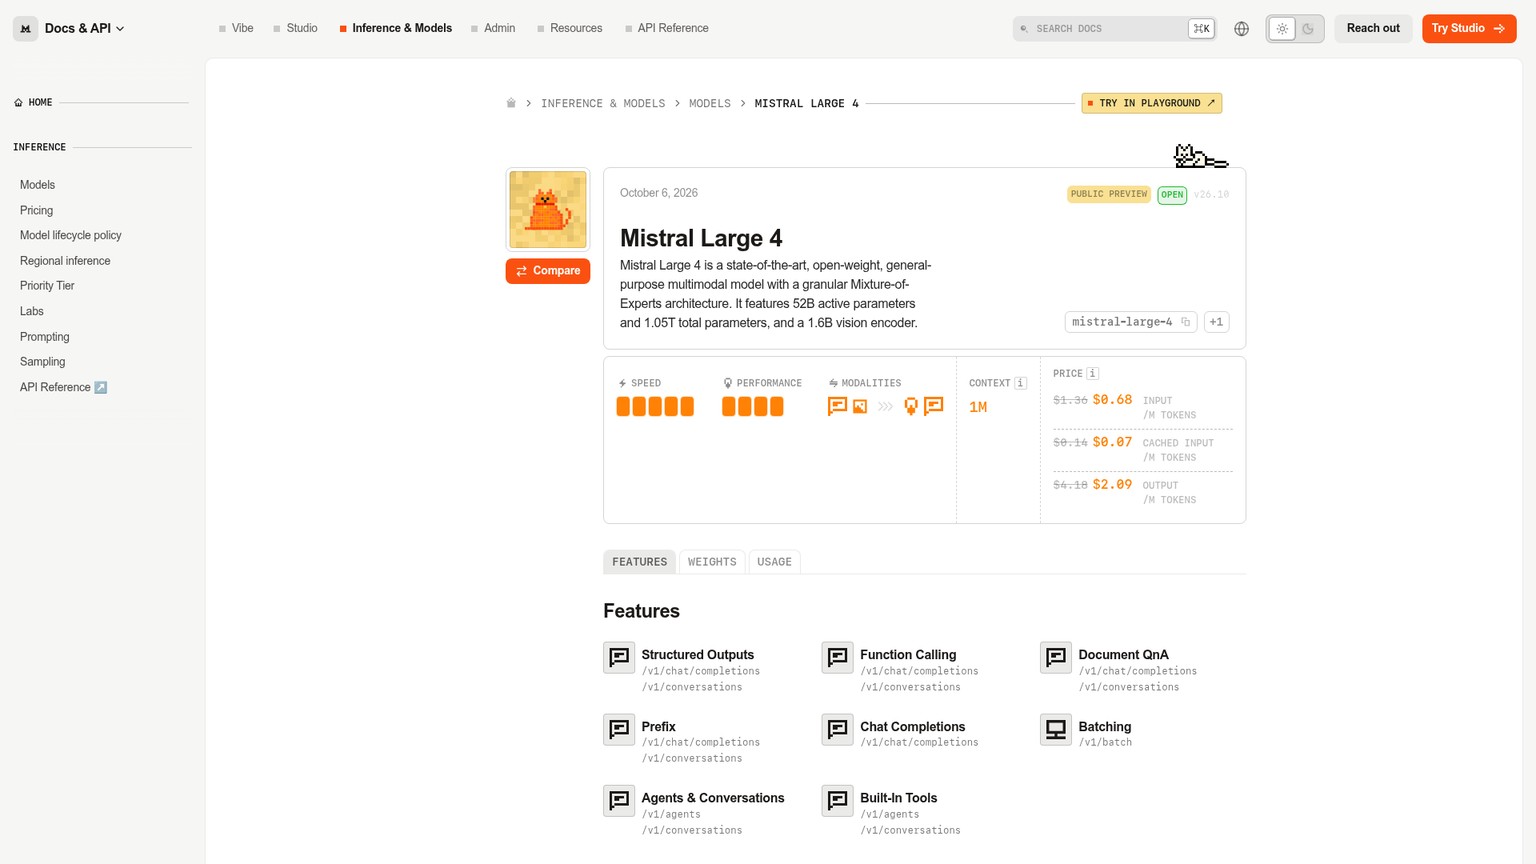
Mistral Large 4: Preise und Einführungsrabatt
Für den laufenden Betrieb gelten als Planungsgrundlage $1.36 für Eingaben und $4.18 für Ausgaben pro Million Tokens. Für einen rabattberechtigten Pilotversuch zum Modellstart lässt sich mit dem niedrigeren Preis rechnen. Tokens sind die Einheiten, die das Modell verarbeitet: Zur Eingabe gehören die Anweisungen und das bereitgestellte Material, zur Ausgabe die erzeugten Inhalte, die der Dienst abrechnet. Beide Seiten haben unterschiedliche Preise. Ein zusammengefasster Durchschnittspreis kann daher verbergen, wie teuer ein Arbeitsablauf mit vielen Ausgabetokens wird.
Mistrals Ankündigung nennt die Listenpreise. In der aktuellen Standard-Preisliste ist Large 4 bei deaktivierter regionaler Inferenz als Sonderangebot gekennzeichnet; die ursprünglichen Preise sind durchgestrichen. Alle hier genannten Beträge sind US-Dollar pro Million Tokens. Quellen: Ankündigung, API-Preise.
Dieselbe Preisliste nennt für zwischengespeicherte Eingaben regulär $0.14 und während der Aktion $0.07. Gemeint sind bereits verarbeitete Inhalte, die zu einem niedrigeren Preis wiederverwendet werden dürfen. Ein Dokument, das erstmals übermittelt wird, gehört weiterhin in die Kalkulation für neue Eingaben. Quelle: API-Preise.
Wie lange gilt der Rabatt?
Mistral nennt einen Einführungsrabatt von 50% für zwei Wochen. Die Dauer steht im Änderungsprotokoll; die Model Card und die Preisliste nennen die reduzierten Dollarbeträge. Die für diesen Leitfaden geprüften öffentlichen Dokumente enthalten weder ein genaues Ablaufdatum noch eine Uhrzeit oder Zeitzone für das Ende der Aktion. Der Preis in der angemeldeten Konsole ließ sich nicht prüfen, da die Preisansicht eine Anmeldung erforderte. Ein verifiziertes Datum für den letzten Aktionstag liegt daher nicht vor. Bevor Arbeiten gezielt für den Aktionszeitraum eingeplant werden, sollte das Ende in der eigenen Konsole bestätigt werden.
Für die Beschaffungsplanung sollten die ursprünglichen Preise gelten und der Rabatt als vorübergehend behandelt werden. So führt ein günstiger Testmonat nicht zu einem zu niedrig angesetzten Budget für den Dauerbetrieb.
Auch das allgemeine Beispiel mit $0.50 für Eingaben und $1.50 für Ausgaben auf Mistrals öffentlicher Preisseite sollte nicht auf Large 4 übertragen werden. Diese Werte entsprechen der Zeile für Mistral Large 3 in der Preisliste nach Modellversion. Der Name einer Modellfamilie legt den Preis ihrer aktuellen Version nicht fest. Unser Leitfaden zu den Mistral-Preisen enthält die vollständige Modellliste und die gesonderten Abonnementoptionen.
Ein Monat Dokumentenprüfung kostet zum Listenpreis $48.10
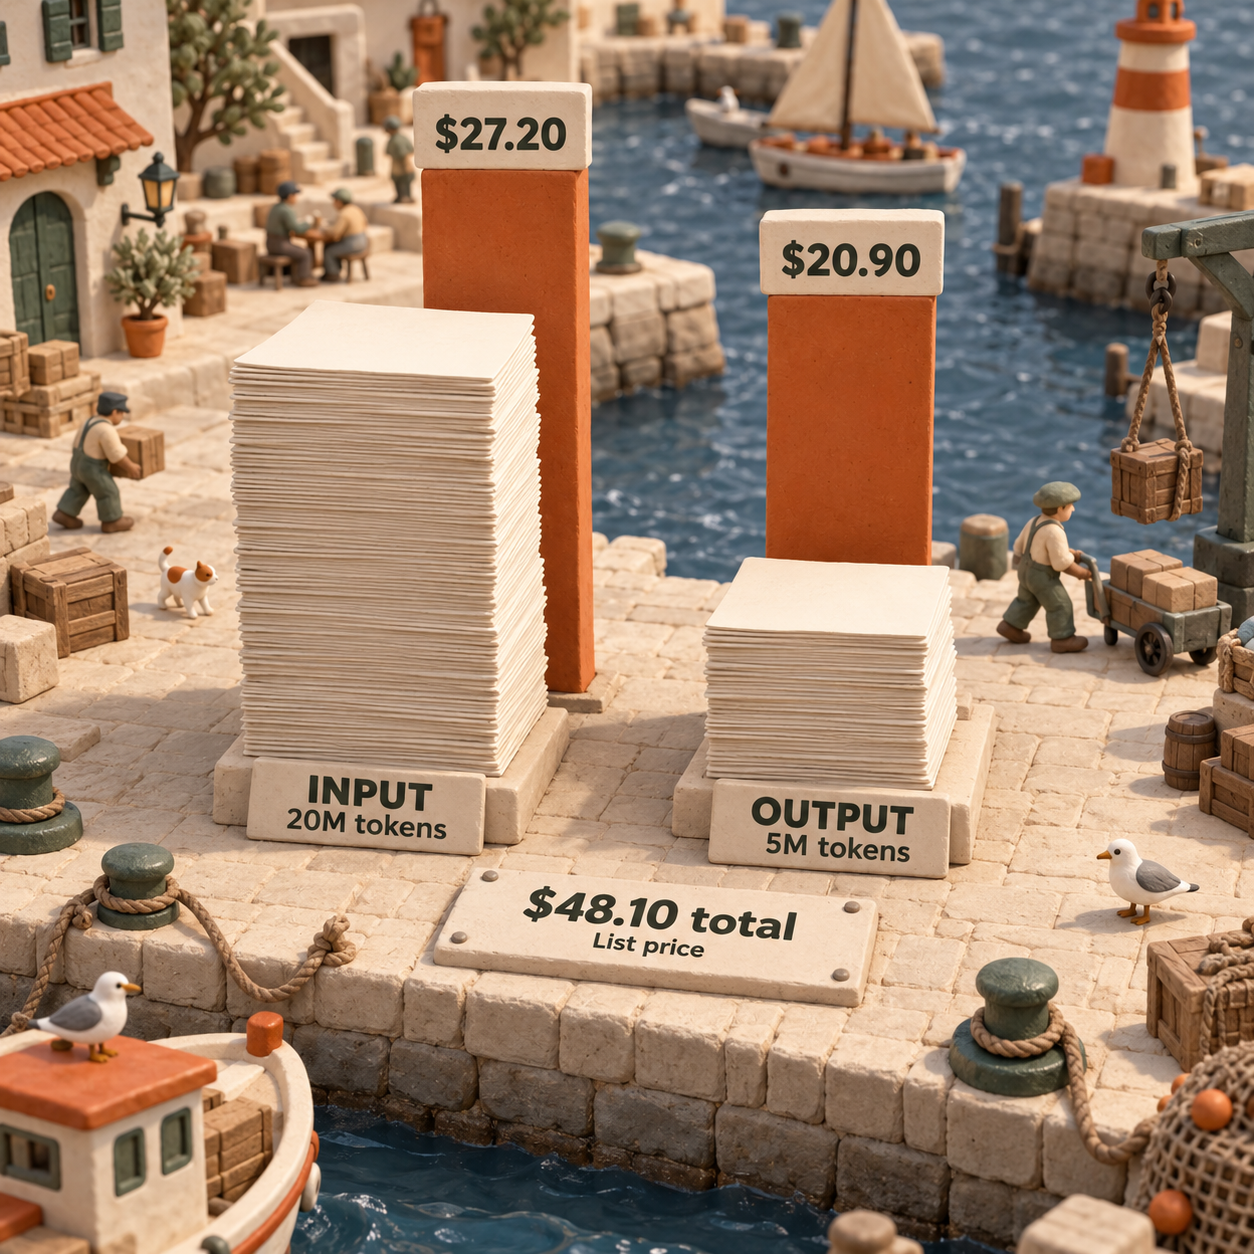
Für das hier angesetzte Pensum von 1,000 Dokumentenprüfungen fallen mit Large 4 zum Listenpreis $48.10 an Modellkosten an. Die Annahme: Jeder Auftrag umfasst im Mittel 20,000 neue Eingabetokens und 5,000 abgerechnete Ausgabetokens, einschließlich aller Modellaufrufe, die zu diesem Auftrag gehören. Im Monat ergeben sich damit 20 Millionen Eingabetokens und 5 Millionen Ausgabetokens. Das ist ein beispielhaftes Nutzungsbudget, keine Umrechnung aus Seitenzahlen und keine Messung eines realen Betriebs.
Die Rechnung lautet:
- Eingaben: 20 × $1.36 = $27.20.
- Ausgaben: 5 × $4.18 = $20.90.
- Gesamt: $27.20 + $20.90 = $48.10.
Solange das Einführungsangebot gilt, kostet dieselbe feste Tokenmenge 20 × $0.68 + 5 × $2.09 = $24.05. Steuern, Guthaben, Gebühren für Dokumentenverarbeitung und Tools sowie zusätzliche Modellnutzung über die angegebenen Tokenmengen hinaus sind in diesen Schätzungen nicht berücksichtigt. Die Preisangaben stammen aus Mistrals Preisliste; die Berechnung stammt von uns.
Die Ausgabe macht in diesem Beispiel nur 20% der Tokenmenge, aber etwa 43% der Rechnung zum Listenpreis aus. Ein Arbeitsablauf, der lange Untersuchungsberichte erzeugt oder einen Bericht immer wieder überarbeitet, kann die Gesamtkosten stärker verändern, als die Größe der Eingabe vermuten lässt. Deshalb sollte die vom Dienst gemeldete Nutzung für die gesamte Aufgabe erfasst werden. Nur den letzten Absatz einzuplanen, den der Nutzer sieht, reicht nicht aus.
Das günstigere Modell setzt die Messlatte
Mistral Small 4 kostet bei derselben festen Tokenmenge $6, berechnet mit den aufgeführten Preisen von $0.15 für Eingaben und $0.60 für Ausgaben: 20 × $0.15 + 5 × $0.60. Das ist eine Preisreferenz, keine Aussage darüber, dass beide Modelle dieselben Aufgaben gleich gut lösen. Zum Listenpreis beträgt der Aufpreis für Large 4 $42.10 pro Monat, während der Aktion $18.05. Quelle: aktuelle Modellpreise.
Bewertet ein Gründer die interne Prüfzeit mit $60 pro Stunde, also $1 pro Minute, müsste Large 4 in diesem Beispiel über den Monat 42.1 Minuten Korrekturarbeit einsparen, um seinen Aufpreis zum Listenpreis auszugleichen. Genau dieser Punkt ist im Test zu messen. Der angenommene Wert der Arbeitszeit lässt sich durch die eigenen Kosten ersetzen; der tatsächliche Tokenverbrauch kann sich zwischen den Modellen unterscheiden.
Für technische Verantwortliche gilt dasselbe: Ein größeres Modell rechtfertigt seinen Einsatz durch weniger verworfene Antworten, weniger Korrekturarbeit oder die Einhaltung einer erforderlichen Betriebsgrenze. Ein niedriger Tokenpreis allein bedeutet noch keine niedrigen Kosten pro akzeptiertem Ergebnis. Ebenso sollte ein Einführungsrabatt nicht über die dauerhafte Architektur entscheiden.
Was sagen die Benchmarks tatsächlich aus?
Mistrals Ergebnisse rechtfertigen einen Platz auf der Testliste. Sie belegen nicht, dass das Modell für den eigenen Arbeitsablauf die beste Wahl ist. Ein Benchmark besteht aus festgelegten Aufgaben, die unter bestimmten Bedingungen bearbeitet werden. Bewertungen von Programmieragenten hängen auch von Tools und Ausführungsumgebungen ab; sie messen mehr als die Antwort eines Modells auf einen kurzen Prompt. Bei der visuellen Verortung geht es darum, etwas in einem Bild zu lokalisieren. Diese Unterschiede bestimmen, ob ein Ergebnis für eine Anwendung aussagekräftig ist.
Die folgenden Werte sind Mistrals eigene Angaben aus der Ankündigung vom 6. Oktober, einschließlich der Bewertungen, die das Unternehmen externen Benchmark-Systemen zuschreibt. Sie wurden nicht von dieser Website ermittelt. Prozentwerte aus unterschiedlichen Tests lassen sich zudem nicht gleichsetzen.
Quelle für sämtliche Tabellenwerte: Mistrals Evaluation zum Modellstart. Elo ist eine vergleichende Bewertung, kein Prozentsatz korrekt erledigter Aufgaben. Ebenso garantiert ein Ergebnis in einem Sicherheitsbenchmark nicht, dass ein Agent jedes bösartige Dokument abwehrt, auf das er trifft.
Für berufliche Aufgaben beansprucht Mistral eine führende Leistung unter offenen Modellen im Harvey's Legal Agent benchmark. Für Finanzaufgaben und Tabellenkalkulationen hebt das Unternehmen Vals.ai Finance Agent v2 und FinWorkBench, auch Finch genannt, hervor. Außerdem beansprucht es die Führung unter offenen Modellen bei SciCode-Verified, einer Evaluation für wissenschaftliches Programmieren. Das sind sinnvolle Anhaltspunkte, um juristische, finanzbezogene oder wissenschaftliche Fälle für einen Pilotversuch auszuwählen. Die Prüfung jeder Antwort anhand der bereitgestellten Belege ersetzen sie nicht. Quelle: Mistrals fachspezifische Evaluationen.
Eine unabhängige Einordnung: Artificial Analysis vom 6. Oktober 2026
Artificial Analysis veröffentlichte am 6. Oktober 2026 eine eigene Evaluation und meldete für Mistral Large 4 Preview 38 im Intelligence Index sowie 50 im Cyber Index. Das Unternehmen berechnete $1.13 pro Aufgabe des Intelligence Index zum regulären Preis, mit Einführungsrabatt $0.57. Das sind die von diesem Benchmark-Anbieter ermittelten Kosten seiner Testaufgaben. Sie entsprechen nicht dem Preis eines einzelnen Kundendokuments oder API-Aufrufs. Quelle: datierter Bericht von Artificial Analysis.
Das unabhängige Ergebnis spricht dafür, das Modell als ernsthaften Kandidaten für spezialisierte Aufgaben zu betrachten. Die ermittelten Kosten pro Aufgabe zeigen zugleich, warum der Verbrauch an Ausgabetokens gemessen werden sollte. Daraus folgt noch keine automatische Entscheidung für einen Modellwechsel. Ein von dieser Website selbst erstelltes Ranking gegenüber GPT-6 oder Claude liegt hier nicht vor. Die folgenden Empfehlungen beruhen auf geprüften Bereitstellungsbedingungen, den angegebenen Preisen und Abnahmekriterien, die sich auf die eigene Arbeit anwenden lassen.
Mistral Large 4 im Einsatz: Wer sollte es diesen Monat testen?
Ein Test von Large 4 lohnt sich, wenn ein konkreter Fehler im bisherigen Modellpfad schwer genug wiegt, um für ein besseres, akzeptiertes Ergebnis mehr zu bezahlen. Günstige Modellpfade, die bereits zuverlässig funktionieren, sollten bestehen bleiben. Entwickler, operative Verantwortliche und Unternehmenskäufer haben damit unterschiedliche Gründe, auf dieselbe Veröffentlichung zu reagieren.
Entwickler: Ein zusätzlicher Modellpfad für schwierige Fälle
Ein Gründer mit gesicherter Finanzierung sollte zunächst einen schwierigen Arbeitsablauf testen, bevor er das Standardmodell wechselt. Ein Dokumentenassistent kann beispielsweise gewöhnliche Felder günstig extrahieren, aber Schwierigkeiten haben, wenn die Belege über Diagramme, Fußnoten und widersprüchliche Anlagen verteilt sind. Genau diese Fälle gehören in die Evaluation. Gemessen wird, ob Large 4 den Korrekturaufwand verringert. Die angekündigten multimodalen Fähigkeiten und die Tool-Nutzung machen einen solchen Test plausibel. Über den künftigen Modellpfad entscheiden allein die tatsächlich akzeptierten Ergebnisse.
Für einen allein arbeitenden technischen Entwickler, dessen bisheriges Modell bereits brauchbare Klassifikationen liefert, gibt es wenig Anlass zum Wechsel. Der kleinere Modellpfad sollte erhalten bleiben; Large 4 bleibt ein Kandidat für Aufgaben, an denen dieser scheitert. Für alternative Agentenmodelle bietet der Leitfaden zu kompakten Programmiermodellen einen gezielteren Einstieg, als jeden Aufruf durch ein neues Spitzenmodell zu ersetzen.
Operative Teams: Zuerst Sicherheitsaufgaben und belegintensive Dokumente
Für Sicherheitsverantwortliche gibt es einen konkreten Anlass, genehmigte defensive Aufgaben zu testen. Mistral nennt Malware-Analyse, die Priorisierung von Schwachstellen und das Schreiben von Erkennungsregeln sowie die Reproduktion und Behebung von Schwachstellen. Ein sinnvoller Pilotversuch prüft, ob ein vorgeschlagener Patch das vorgelegte Problem behebt und ob die erzeugte Erkennungsregel zu den Belegen passt. Die erlaubten Aktionen sollten ausdrücklich festgelegt und die Ausgaben geprüft werden, bevor sie operative Systeme verändern. Quelle: Mistrals Abschnitt zur Cybersicherheit.
Verantwortliche für juristische Arbeitsabläufe sollten einen freigegebenen Dokumentensatz verwenden und bewerten, ob eine Antwort die maßgebliche Passage findet, Ausnahmen berücksichtigt und Belege von Schlussfolgerungen trennt. Im Finanzbereich zählt, ob die Antwort den richtigen Zeitraum verwendet, die Rechnung korrekt wiedergibt und jede Eingangsgröße auf das Quelldokument zurückführt. Ein elegant formuliertes Memorandum mit der falschen Vertragsklausel oder dem falschen Zeitraum ist ein verworfenes Arbeitsergebnis, unabhängig vom Benchmark des Modells.
Mistral nennt außerdem technische Zeichnungen, Fertigung, Geodatenbilder und wissenschaftliches Programmieren. Dafür sind getrennte Tests nötig: Ein Bauteil in einer technischen Zeichnung zu erkennen, ein Objekt auf Satellitenbildern zu finden und eine wissenschaftliche Routine zu implementieren erfordert jeweils andere Abnahmekriterien. Die Veröffentlichung macht diese Aufgaben zu Testkandidaten. Sie belegt nicht, dass sich ein allgemeiner Wert auf alle drei übertragen lässt. Quelle: Mistrals ausführliche Darstellung der Fähigkeiten.
Unternehmenskäufer: Die zugesagte EU-Verarbeitung genau prüfen
Vorgaben zur Datenverarbeitung in der EU sind ein Grund, Mistral in die engere Auswahl zu nehmen und anschließend die genaue Grenze des Dienstes zu prüfen. Mistral erklärt, dass die öffentliche Preview auf der eigenen europäischen Rechenzentrumsinfrastruktur läuft. Die allgemeine Dokumentation zur regionalen Inferenz erklärt separat, dass der globale Endpunkt keinen bestimmten Verarbeitungsort zusichert. Aus diesen Aussagen lässt sich keine pauschale Garantie für jede Anfrage an Mistral ableiten. Quellen: Preview-Infrastruktur, regionale Inferenz.
Der regionale Zugang lautet api.eu.mistral.ai. Zunächst muss geprüft werden, ob das benötigte Modell dort tatsächlich verfügbar ist, denn die regionale Modellverfügbarkeit variiert. Die Regionstabelle nennt Rechenzentren in EU- und EFTA-Ländern; die EFTA ist die eigenständige Europäische Freihandelsassoziation. Eine Vorgabe, die ausschließlich Verarbeitung in der EU erlaubt, erfordert deshalb eine Bestätigung der zulässigen Verarbeitungsorte. Mistral nennt für regionale Inferenz einen Aufschlag von 10% auf die regulären Listenpreise. Ob er mit dem Einführungsangebot kombinierbar ist, sollte anhand des konkret geltenden Angebots bestätigt werden. Außerdem stehen laut Mistral an regionalen Endpunkten weder Agents noch Batch oder die Files API zur Verfügung. Function Calling ist dort das einzige unterstützte Tool. Quelle: regionale Funktionen und Preise.
Für einen CTO, der einen Dokumentenagenten plant, ist das entscheidend: Die Funktionsliste der globalen Model Card belegt nicht, dass derselbe vom Anbieter verwaltete Arbeitsablauf über den regionalen Endpunkt läuft. Der Verarbeitungsort von Anfragen und Antworten legt außerdem nicht automatisch den Ort sämtlicher Konto-, Abrechnungs- oder Nutzungsdaten fest. Auch der Verzicht auf Datenspeicherung ist eine separate Frage. Bevor reguliertes Material übertragen wird, müssen daher die Anforderungen des konkreten Systems an Verarbeitung, Speicherung und abhängige Tools geprüft werden.
Was ändert sich mit der Veröffentlichung der Modellgewichte?
Die Modellgewichte würden mehr Kontrolle über den Betrieb ermöglichen. Zugleich müssten Infrastruktur und Betriebskosten neu bewertet werden. Open Weights sind die herunterladbaren Dateien mit den numerischen Modellgewichten. Abhängig von der tatsächlichen Lizenz und der unterstützten Software können sie ermöglichen, Inferenz nach eigenen Vorgaben zu betreiben, statt vollständig auf einen gehosteten Endpunkt angewiesen zu sein. Mistrals angekündigtes Veröffentlichungsziel bleibt Ende Oktober 2026. Einen bestimmten Tag verspricht die Ankündigung nicht. Quelle: Veröffentlichungsplan.
Für Unternehmenskäufer liegt der Nutzen darin, die Ausführungsumgebung, die Zugriffsgrenzen und die Betriebsabläufe selbst wählen zu können. Das kann relevant sein, wenn eine Änderung der Richtlinien oder Verfügbarkeit eines gehosteten Dienstes einen kritischen Arbeitsablauf unterbrechen würde. Gleichzeitig geht mehr Verantwortung für Kapazität, Aktualisierungen, Überwachung und die Wiederherstellung nach Ausfällen auf den Betreiber über.
49B aktive Parameter bedeuten nicht, dass sich Download oder Speicherbedarf wie bei einem Modell mit insgesamt 49B Parametern planen lassen. Aktive Parameter beschreiben die für ein Token ausgewählte Berechnung. Die gesamten Gewichte müssen dennoch gespeichert werden und dem Inferenzsystem zur Verfügung stehen. Was für den Eigenbetrieb tatsächlich nötig ist, hängt vom späteren Format der Gewichte, den unterstützten Laufzeitumgebungen, der Hardwarekonfiguration und der erforderlichen Parallelität ab. Aus den Angaben zum Modellstart folgt weder eine genaue Hardwareempfehlung noch ein Preis für das Hosting.
Ein künftiger Vergleich sollte die Infrastrukturkosten pro erfolgreich erledigter Aufgabe berücksichtigen, dazu den Betriebsaufwand und den Wert der benötigten Kontrolle. Bei geringer Auslastung fallen Kosten für ungenutzte Kapazität an; bei hoher Auslastung verteilen sie sich auf mehr Aufgaben. Keine dieser Situationen belegt für sich, dass der Eigenbetrieb günstiger als die API ist.
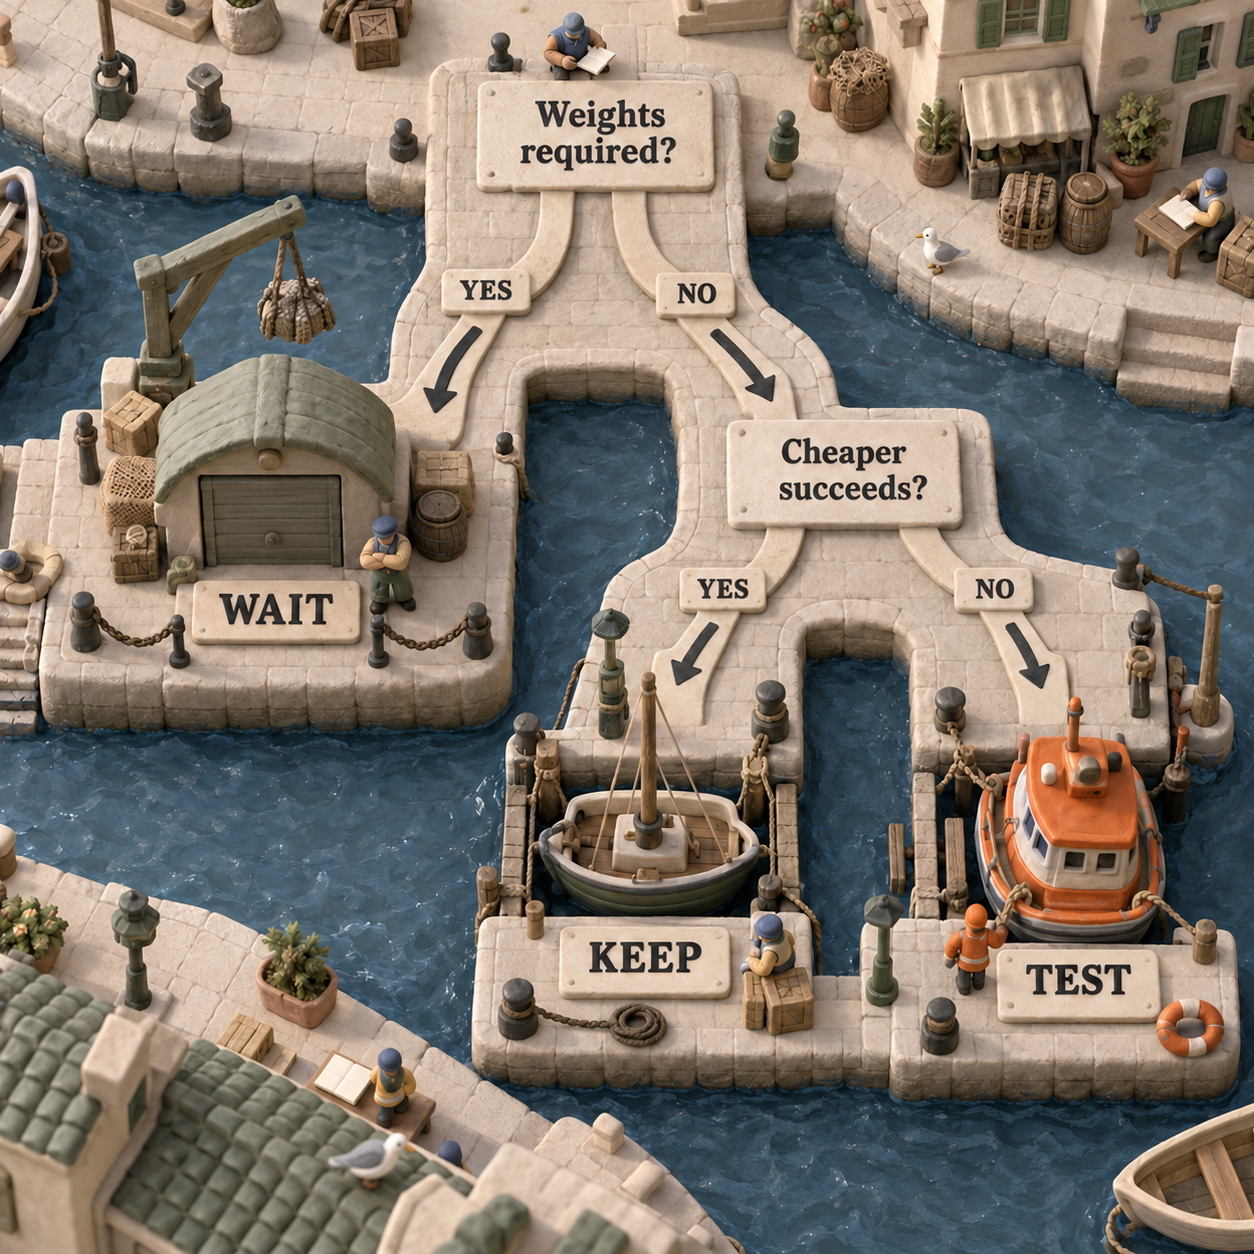
Sind herunterladbare Gewichte eine zwingende Beschaffungsvoraussetzung, heißt es: auf die Dateien, ihre Lizenz und einen überprüfbaren Betrieb warten. Der Testsatz und die Integrationsgrenzen lassen sich bereits vorbereiten. Die gehostete Preview kann Fragen zur Leistungsfähigkeit nur dort beantworten, wo die eigenen Datenrichtlinien ihre Nutzung erlauben. Eine Ankündigung allein erfüllt keine Anforderung an den Betrieb vor Ort.
Wo die Erwartungen zu weit gehen
Überzogen ist es, drei getrennte Meilensteine gleichzusetzen: Preview-Zugang, die künftige Veröffentlichung der Gewichte und ein produktiv einsetzbares System. Jeder beantwortet eine andere Frage. Die heutige API ermöglicht Tests der Preview. Die angekündigten Gewichte könnten eine andere Betriebsform erlauben. Ein System, das sich bereitstellen, rechtlich nutzen und zuverlässig betreuen lässt, muss weiterhin gesondert geprüft werden.
Die Bezeichnung Open Weights belegt weder eine bestimmte Open-Source-Lizenz noch uneingeschränkte kommerzielle Nutzungsrechte. Maßgeblich sind die Bedingungen der tatsächlichen Veröffentlichung von Large 4, nicht die Lizenz eines früheren Mistral-Modells.
Auch die Benchmark-Diagramme belegen keine allgemeine Überlegenheit. Die Ablehnung sicherheitsrelevanter Anfragen, der Tool-Zugriff, die Ausführungsumgebungen und die Definition der Aufgaben können Ergebnisse beeinflussen. Ein juristischer Benchmark zertifiziert keine Rechtsberatung. Ein Tabellenkalkulations-Benchmark entscheidet nicht darüber, ob ein eigener Berichtsablauf die richtigen Belege bewahrt. Die jeweils relevante Behauptung hilft bei der Auswahl eines Tests; anschließend zählt die Bewertung des tatsächlich benötigten Arbeitsergebnisses.
Ein weiterer Unterschied betrifft den erweiterten Zugang zu Cybersicherheitsfunktionen. Mistral erklärt, dass führende Cybersicherheitsexperten, überprüfte Partner und staatliche Stellen beim Red-Teaming eine reduzierte Moderation und erweiterte Cyberfähigkeiten erhalten. Damit wird nicht jedem Kunden der öffentlichen Preview derselbe Zugang zugesagt. Zu prüfen sind die Berechtigungen und das Verhalten, die im eigenen Konto tatsächlich verfügbar sind. Quelle: Beschreibung des Preview-Zugangs.
Schließlich kann der Aktionspreis den Pilotversuch günstiger erscheinen lassen als den Dauerbetrieb. Eine vorübergehende Ersparnis beim Modellpreis sagt wenig über den Migrationsaufwand, die Prüfzeit oder die Wirtschaftlichkeit eines späteren Eigenbetriebs aus. Diese Entscheidungen sollten auf den regulären Preisen und den tatsächlichen Betriebsgrenzen beruhen.
Der nächste Schritt: Ein klar begrenzter Pilotversuch
In der nächsten Woche sollte ein technischer Verantwortlicher einen kleinen, freigegebenen Testsatz an mistral-large-4-0 übergeben und den Produktivbetrieb auf dem bisherigen, bewährten Modellpfad belassen. Unternehmenskäufer, die Modellgewichte benötigen, sollten dieselben Fälle vorbereiten. Einen Eigenbetrieb sollten sie erst freigeben, wenn die angekündigten Dateien und Nutzungsbedingungen vorliegen.
Repräsentative Fälle auswählen und Abnahmekriterien festlegen
Als Einstieg bieten sich 50 repräsentative Fälle an, darunter schwierige Beispiele, die der bisherige Modellpfad falsch bearbeitet. Das ist eine praktikable Größe für einen Pilotversuch, keine statistische Garantie. Korrektheit, erforderliche Belege und erlaubte Aktionen sollten feststehen, bevor die Ausgaben vorliegen. Bei juristischen und finanziellen Aufgaben sollte eine qualifizierte Fachkraft die Quellenbindung und die Berechnungen bewerten.
Die konkrete Modellversion und den zulässigen Endpunkt verwenden
Die gehostete Preview lässt sich in Mistral Studio ausprobieren oder über die dokumentierte Chat-Completions-API mit
mistral-large-4-0aufrufen. Die bereitgestellten Belege und das Budget für Tool-Nutzung müssen für alle Kandidaten gleich bleiben. Ist der Verarbeitungsort eine Vorgabe, sollte zuerst die regionale Verfügbarkeit des Modells und seiner Funktionen geprüft werden.Akzeptierte Ergebnisse messen und die laufenden Kosten planen
Erfasst werden akzeptierte Ergebnisse, Korrekturen, sämtliche Eingabetokens und abgerechneten Ausgabetokens, Latenz, Tool-Nutzung und Prüfzeit. Für die Prognose gelten die Listenpreise. Der Modellpfad sollte nur bestehen bleiben, wenn der Nutzen den Aufpreis deckt oder eine erforderliche Fähigkeit beziehungsweise Kontrolle ermöglicht. Sobald die Gewichte tatsächlich verfügbar sind, müssen Modell, Lizenz und Betriebskosten erneut geprüft werden.
Für einen einfachen Verbindungstest am globalen Endpunkt, bei dem der eigene Mistral-API-Schlüssel bereits in MISTRAL_API_KEY gesetzt ist, lautet der dokumentierte Chat-Completions-Aufruf:
curl https://api.mistral.ai/v1/chat/completions \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-large-4-0",
    "messages": [
      {"role": "user", "content": "Explain the difference between input and output tokens in two sentences."}
    ]
  }'
Dieser Aufruf prüft die Verbindung und die Modellauswahl. Er bewertet weder die Qualität bei Dokumentenaufgaben noch die Einhaltung regionaler Vorgaben. Über den Einsatz entscheiden die freigegebenen Aufgaben und ihre akzeptierten Ergebnisse.
Praktische Entscheidungshilfen zu Modellen und Arbeitsabläufen liefert der Newsletter.
- Zuletzt aktualisiert
- 7. Okt. 2026
- Kategorie
- AI
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
KI-Assistent Lindy AI: Was er kann und was er kostet
KI-Assistent Lindy AI im Überblick: Preise, Credit-Verbrauch, E-Mails, Meetings und Freigabegrenzen – mit Einordnung von Gumloop, n8n und Marblism.7. Okt. 2026AI
Mistral API Pricing 2026: API-Kosten und Vibe im Überblick
Mistral-Preise für API und Vibe: Modellkosten, Gratislimits, EU-Hosting und eine Monatsrechnung im Vergleich. Geprüft im Oktober 2026, alle Preise in USD.6. Okt. 2026AI
Claude Skills im Einsatz: Kundenberichte automatisieren
Claude Skills erstellen, installieren und im Team teilen: Anleitung für wöchentliche Kundenberichte mit geprüften Kennzahlen und menschlicher Prüfung.6. Okt. 2026AI
KI-Agenten als Mitarbeiter: Kosten, Tools und Einstieg
KI-Agenten als digitale Mitarbeiter: Aufgaben, Preise und Grenzen von sechs Tools. So gelingt der Einstieg mit klaren Zuständigkeiten und einem 30-Tage-Pilot.6. Okt. 2026AI
Sprache zu Text: Alternativen zu Wispr Flow im Vergleich (2026)
Wispr Flow, VoiceOS, Superwhisper, Aqua Voice, Willow und Monologue im Vergleich: Preise, Offline-Nutzung, Teamfunktionen und Eingabe für Coding-Agenten.5. Okt. 2026AI
KI-Agenten: 13 Aufgaben für kleine Unternehmen im Kostencheck
13 Beispiele zeigen, wie KI-Agenten kleine Unternehmen bei Support, Telefon, Recherche und Code unterstützen – mit Preisen, Nutzungslimits und Prüfpunkten.5. Okt. 2026AI
Claude-Preise 2026: Was die API für drei Apps kostet
Claude-Preise für API, Cache, Batch und Tools: drei App-Budgets mit klaren Annahmen und der Vergleich mit Pro und Max für die persönliche Nutzung.4. Okt. 2026AI