Mistral Large 4 가격과 성능: 프리뷰를 쓸 때와 웨이트를 기다릴 때
Mistral Large 4 가격과 출시 할인, 벤치마크 주장을 정리합니다. 문서 업무의 토큰 비용 예시로 더 저렴한 모델과 비교하고, 보안·문서 작업에 호스팅 프리뷰를 시험할 조건과 EU 리전의 기능 제약을 짚습니다. 자체 호스팅에 필요한 웨이트를 기다려야 할 때도 확인합니다.
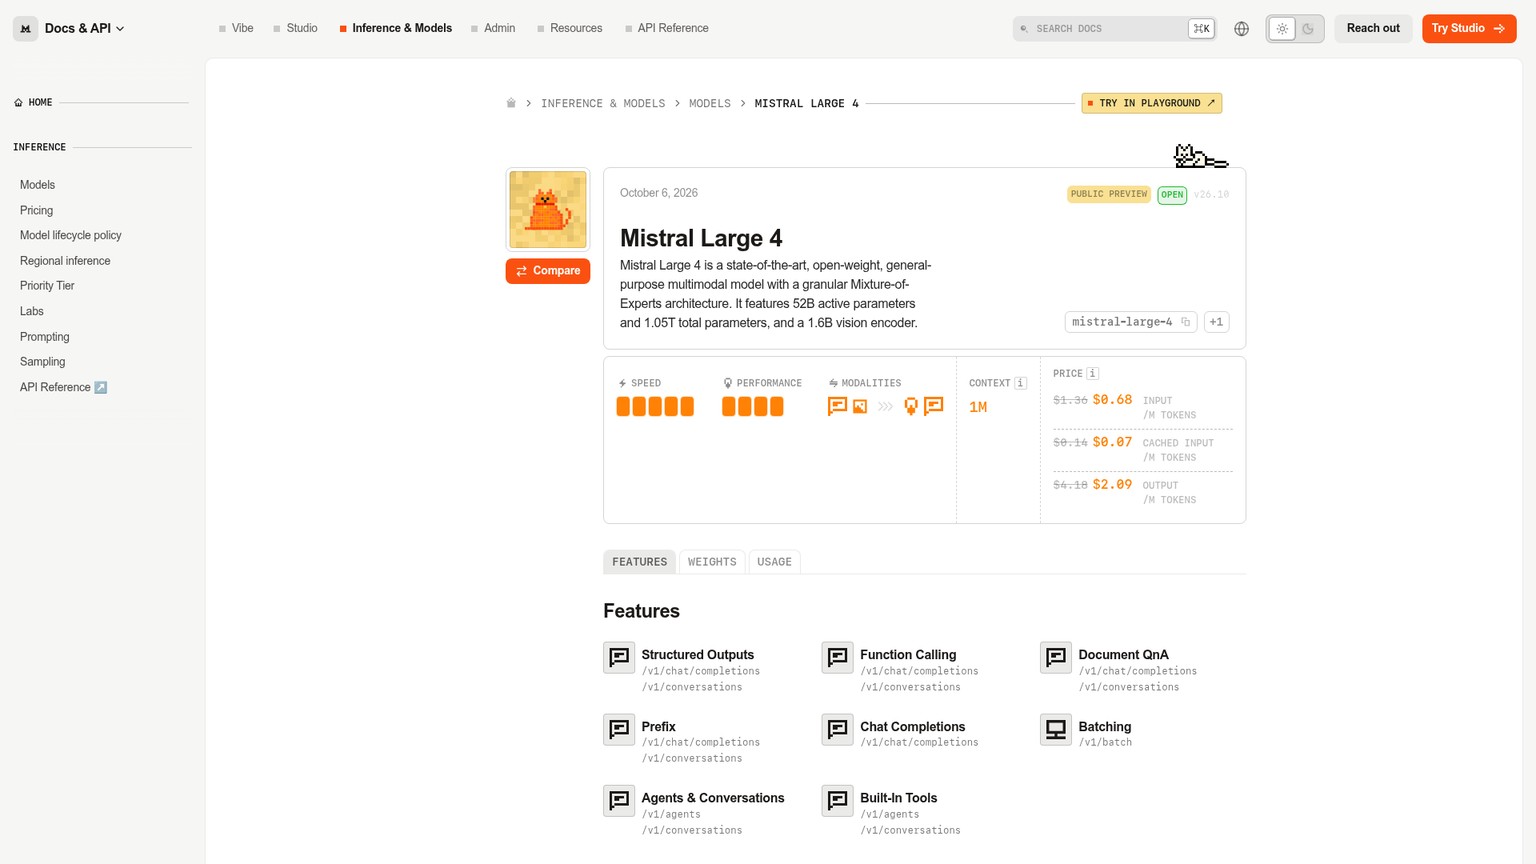
Mistral Large 4 가격과 도입 조건을 함께 살펴보면, 보안 업무와 문서 중심 작업에는 호스팅 방식의 파일럿을 진행할 만합니다. 다만 자체 호스팅이 필수라면 Mistral이 2026년 10월 말까지 공개하겠다고 약속한 웨이트를 기다려야 합니다. 발표된 API 요금은 100만 토큰당 입력 $1.36, 출력 $4.18이며, 현재 적용되는 50% 출시 할인으로 각각 $0.68, $2.09로 낮아집니다. 기존의 더 저렴한 모델이 업무를 충분히 처리한다면 유지하고, Large 4는 검수를 통과한 작업 결과당 비용으로 평가해야 합니다.
출시, 가격, 배포 문서는 2026년 10월 7일에 확인했습니다. 아래의 출시 사양과 벤치마크 주장은 Mistral의 발표를, 현재 요금은 모델 버전별 API 요금표를 기준으로 합니다. 문서 처리 예산은 가정을 명시한 계산 예시입니다. 실제 지출을 측정한 값이 아니며, 이 사이트에서 모델을 직접 테스트했다는 뜻도 아닙니다.
Mistral Large 4, 10월 6일 출시로 무엇이 달라졌습니까?
Mistral은 2026년 10월 6일 호스팅 방식의 공개 프리뷰를 출시했습니다. 다운로드할 수 있는 웨이트는 추후 공개할 예정입니다. 이제 평가 후보에 올릴 수는 있지만, 기업이 모델을 내려받아 자체 인프라에서 실행할 수 있게 된 것은 아닙니다. Mistral이 밝힌 목표 시점은 10월 말이며, 웨이트와 함께 아키텍처 및 후속 학습에 관한 추가 정보를 공개할 계획입니다. 출처: 출시 발표.
발표에 따르면 Mistral Large 4는 전체 파라미터 1T, 활성 파라미터 49B 규모이며, 지시 수행과 추론을 결합한 하이브리드 Mixture-of-Experts 아키텍처와 멀티모달 입력을 지원합니다. 파라미터는 모델이 학습하는 수치입니다. Mixture-of-Experts, 즉 MoE는 매 단계에서 전체 파라미터를 모두 쓰는 대신 토큰마다 모델의 일부를 선택해 활성화합니다. 지시 수행과 추론을 결합했다는 것은 일반적인 지시 이행과 더 긴 문제 해결 과정을 같은 모델에서 처리한다는 뜻입니다. 멀티모달 입력을 통해 시각 자료도 워크플로에 넣을 수 있어 차트, 설계 도면, 문서 안의 증거를 다루는 데 의미가 있습니다. 이 수치와 설명은 발표된 사양이지, 필요한 하드웨어 규모를 산정하는 지침은 아닙니다. 출처: Mistral의 모델 설명.
현재 확인된 이용 경로는 La Plateforme와 연결된 개발자 플랫폼인 Mistral Studio와 프리뷰 API입니다. 평가에서는 이 버전을 식별할 수 있도록 **mistral-large-4-0**을 사용해야 합니다. 버전별 모델 카드에는 더 짧은 이름인 mistral-large-4와 함께 채팅 완성, 구조화된 출력, 함수 호출, 문서 질의응답 지원도 명시돼 있습니다. 구조화된 출력은 애플리케이션이 정해진 형식의 응답을 요청하는 기능입니다. 함수 호출은 애플리케이션이 제공하는 툴에 실행할 작업을 요청하는 기능입니다.
출시 발표는 Studio로 안내하지만, 이 프리뷰 모델을 Le Chat이나 Vibe에서 선택할 수 있는지는 확인해 주지 않습니다. 소비자용 구독과 특정 버전의 개발자 엔드포인트는 서로 다른 구매 판단에 필요한 정보입니다. 같은 모델로 재현 가능한 평가를 해야 한다면 API 경로를 사용해야 합니다.
사양 문서 사이의 차이도 짚고 넘어가야 합니다. 현재 버전별 모델 카드에는 전체 파라미터 1.05T, 활성 파라미터 52B로 나와 있지만, 출시 발표에는 1T와 49B로 적혀 있습니다. 둘 다 공급업체가 제시한 설명이므로 어느 한쪽을 아무 설명 없이 다른 수치로 바꿔서는 안 됩니다. 위의 출시 수치는 발표문 기준임을 명시했습니다. 최종 아키텍처와 배포 요건은 웨이트가 공개되면 다시 확인해야 합니다. 출처: 현재 버전별 모델 카드.
Mistral Large 4 가격: 정가와 출시 할인
지속적으로 운영할 업무의 예산은 100만 토큰당 입력 $1.36, 출력 $4.18로 잡고, 출시 할인 대상인 파일럿에는 할인 요금을 적용합니다. 토큰은 모델이 처리하는 단위입니다. 입력에는 지시문과 제공한 자료가, 출력에는 서비스가 요금을 부과하는 생성 결과가 포함됩니다. 입력과 출력의 요금이 다르므로 둘을 합친 평균값만 보면 출력이 많은 워크로드의 비용을 놓칠 수 있습니다.
Mistral의 발표문에는 정가가 나와 있습니다. 리전별 추론을 끈 상태의 현재 Standard 요금표에는 Large 4가 할인 중인 모델로 표시돼 있고, 기존 요금에는 취소선이 그어져 있습니다. 아래 금액은 모두 100만 토큰당 USD 기준입니다. 출처: 발표문, API 요금표.
같은 요금표에서 캐시된 입력은 평소 $0.14, 할인 기간에는 $0.07입니다. 캐시된 입력은 이미 처리한 자료 중 더 낮은 요금으로 재사용할 수 있는 조건을 충족한 입력을 뜻합니다. 처음 제출하는 문서는 신규 입력 비용으로 계산해야 합니다. 출처: API 요금표.
할인 기간은 정해졌지만, 정확한 종료 일시는 공개되지 않았습니다
Mistral은 출시 기념 50% 할인을 두 주 동안 제공한다고 밝혔습니다. 기간은 출시 변경 기록에, 할인된 금액은 모델 카드와 요금표에 나와 있습니다. 이 글을 위해 확인한 공개 문서에는 정확한 종료 날짜, 마감 시각, 시간대가 없습니다. 가격 화면에 로그인이 필요해 인증된 콘솔의 요금도 확인하지 못했습니다. 할인 마지막 날로 제시할 수 있는 검증된 날짜는 없습니다. 할인에 맞춰 작업 일정을 잡기 전에 자신의 콘솔에서 확인해야 합니다.
구매 예산을 전망할 때는 정가를 기준으로 하고 할인은 일시적인 혜택으로 처리합니다. 그래야 평가 기간에 적게 나온 비용을 지속적인 운영 예산에도 그대로 적용하는 일을 피할 수 있습니다.
또한 Mistral의 공개 가격 페이지에 있는 일반적인 입력 $0.50, 출력 $1.50 예시를 Large 4에 적용해서는 안 됩니다. 이 금액은 버전별 요금표의 Mistral Large 3 행과 일치합니다. 모델 제품군 이름만으로 현재 버전의 가격을 알 수는 없습니다. 전체 모델 목록과 별도의 구독 옵션은 이 사이트의 Mistral 가격 가이드에 정리했습니다.
문서 검토 한 달 비용은 정가 기준 $48.10입니다
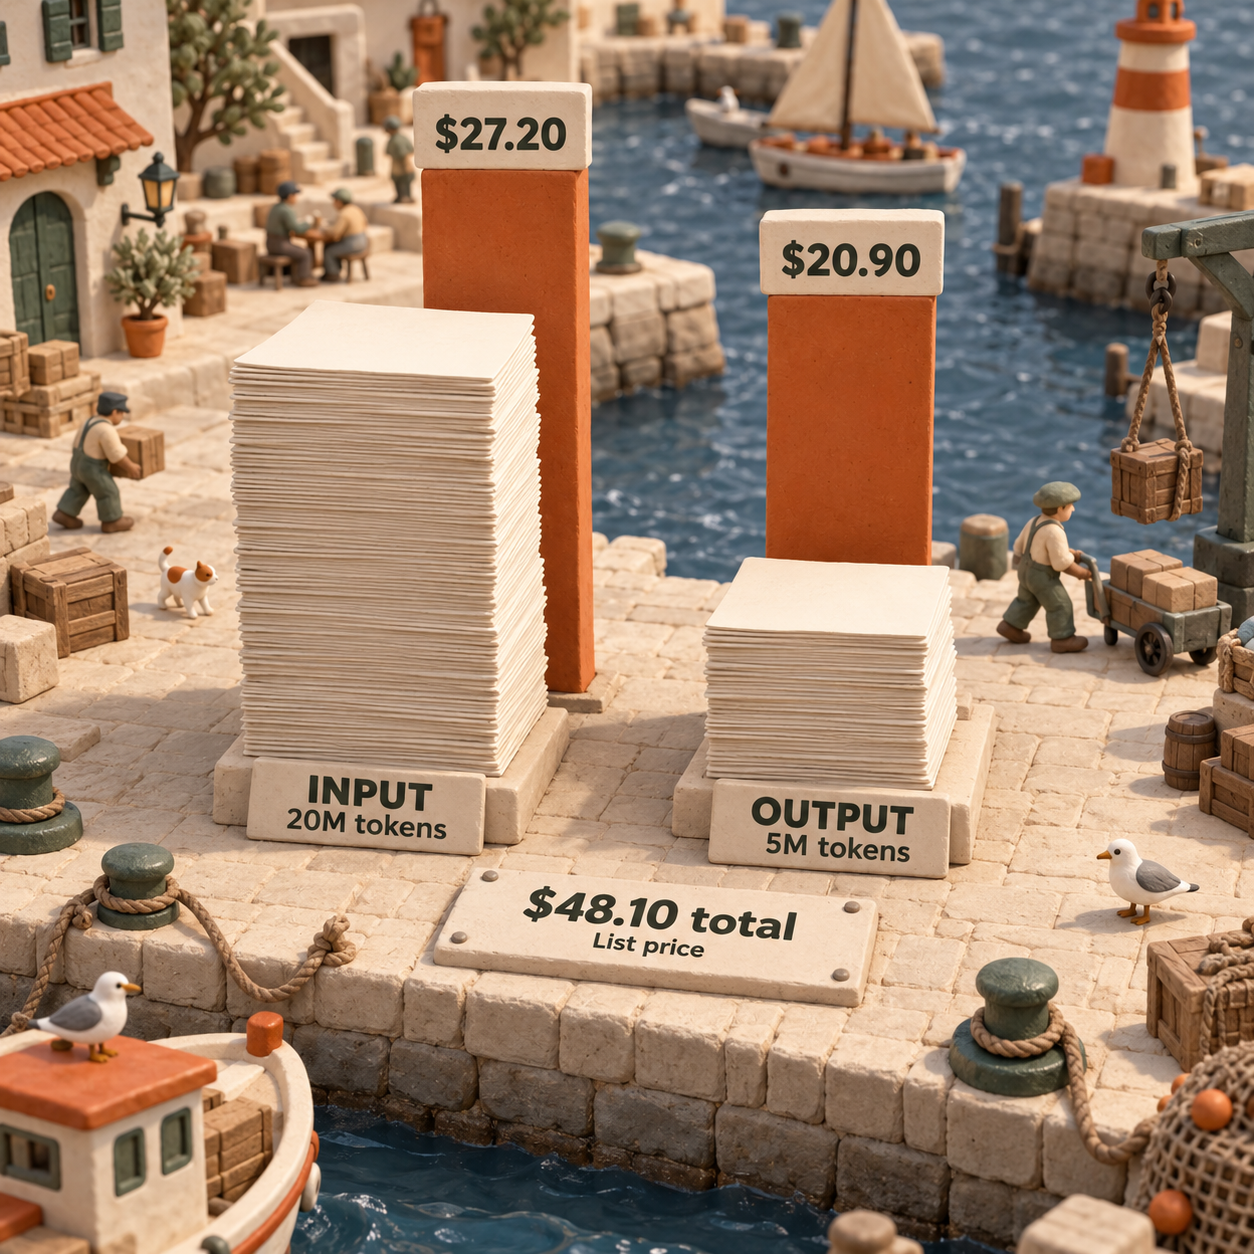
아래에서 가정한 문서 검토 1,000건의 Large 4 모델 요금은 정가 기준 $48.10입니다. 작업당 평균 신규 입력 20,000토큰, 과금되는 출력 5,000토큰을 사용한다고 가정합니다. 각 작업에 포함되는 모든 모델 호출을 합산한 수치입니다. 따라서 한 달 동안 처리하는 양은 입력 2,000만 토큰, 출력 500만 토큰입니다. 페이지 수를 토큰으로 환산한 값이나 실제 배포 환경에서 측정한 값이 아니라 사용량을 가정한 예산 예시입니다.
계산은 다음과 같습니다.
- 입력: 20 × $1.36 = $27.20.
- 출력: 5 × $4.18 = $20.90.
- 합계: $27.20 + $20.90 = $48.10.
출시 할인이 적용되는 동안 같은 고정 사용량의 비용은 20 × $0.68 + 5 × $2.09 = $24.05입니다. 이 추정에는 세금, 크레딧, 문서 처리 및 툴 요금, 명시된 토큰 총량을 넘는 추가 모델 사용량은 포함하지 않았습니다. 단가는 Mistral 요금표에서 가져왔고, 계산은 이 사이트에서 수행했습니다.
출력은 이 예시에서 **전체 토큰의 20%에 불과하지만 정가 기준 요금의 약 43%**를 차지합니다. 긴 조사 결과를 생성하거나 보고서를 반복해서 다시 쓰는 워크플로라면 입력 크기만 보고 예상한 것보다 총비용이 더 빠르게 바뀔 수 있습니다. 사용자가 보는 마지막 문단만으로 예산을 잡지 말고, 작업 전체에서 서비스가 반환하는 사용량을 합산해야 합니다.
더 저렴한 모델이 도입의 기준선입니다
같은 고정 토큰 사용량을 Mistral Small 4로 처리하면 $6입니다. 요금표의 입력 $0.15, 출력 $0.60을 적용한 계산은 20 × $0.15 + 5 × $0.60입니다. 가격 비교를 위한 기준선이지, 두 모델이 같은 작업을 똑같이 잘 처리한다는 주장은 아닙니다. Large 4에 추가로 드는 비용은 정가 기준 월 $42.10, 할인 기간에는 $18.05입니다. 출처: 현재 모델별 요금.
창업자가 검토자의 시간을 내부적으로 시간당 $60, 즉 분당 $1로 평가한다면, 이 예시에서 Large 4는 한 달 동안 수정 작업 42.1분을 줄여야 정가 기준 모델 요금의 차액을 상쇄합니다. 실제 평가에서 측정할 손익분기점입니다. 인건비 가정은 자신의 상황에 맞게 바꿔야 하며, 실제 토큰 소비량도 모델마다 다를 수 있습니다.
엔지니어링 리드에게도 같은 기준이 적용됩니다. 더 큰 모델을 도입하려면 검수를 통과하지 못한 답변이나 수정 작업을 줄이거나, 필요한 배포 요건을 충족해야 합니다. 토큰 단가가 낮다고 검수를 통과한 결과당 비용까지 낮다고 볼 수는 없습니다. 출시 할인만으로 장기 아키텍처를 결정해서도 안 됩니다.
벤치마크 결과로 어디까지 판단할 수 있습니까?
Mistral의 결과는 평가 후보에 포함할 근거가 되지만, 자신의 워크로드에서 가장 좋은 모델임을 입증하지는 않습니다. 벤치마크는 정해진 조건에서 수행하는 정해진 과제 집합입니다. 코딩 에이전트 점수에는 짧은 프롬프트에 답하는 모델뿐 아니라 툴과 실행 환경도 관여합니다. 시각적 그라운딩은 이미지 안에서 대상을 찾아 위치를 특정하는 능력을 측정합니다. 이런 차이를 알아야 결과가 자신의 애플리케이션과 얼마나 관련 있는지 판단할 수 있습니다.
아래는 외부 벤치마크 시스템의 결과로 소개한 점수를 포함해 Mistral이 10월 6일 발표에서 직접 제시한 주장입니다. 이 사이트가 측정한 결과가 아니며, 서로 다른 테스트의 백분율을 같은 기준으로 비교할 수는 없습니다.
표의 모든 항목은 Mistral의 출시 평가를 출처로 합니다. Elo는 상대적인 평가 점수이며, 작업을 정확히 완료한 비율이 아닙니다. 마찬가지로 보안 벤치마크 점수가 에이전트가 접하는 모든 악성 문서에 저항할 수 있다는 보장은 아닙니다.
전문 업무와 관련해 Mistral은 Harvey의 Legal Agent 벤치마크에서 오픈 모델 중 선도적인 성능을 보였다고 주장합니다. 금융 및 스프레드시트 업무에서는 Vals.ai Finance Agent v2와 Finch라고도 부르는 FinWorkBench를 강조합니다. 과학 프로그래밍 평가인 SciCode-Verified에서도 오픈 모델 중 선두라고 주장합니다. 법률, 금융, 과학 분야의 사례를 파일럿에 포함할 만한 근거입니다. 그렇다고 각 답변을 제공된 증거와 대조하는 절차를 대신할 수는 없습니다. 출처: Mistral의 분야별 평가.
독립 평가: Artificial Analysis의 2026년 10월 6일 보고서
Artificial Analysis는 2026년 10월 6일 자체 평가를 공개했습니다. Mistral Large 4 Preview는 Intelligence Index에서 38, Cyber Index에서 50을 기록했습니다. 이 평가기관이 계산한 Intelligence Index 과제당 비용은 표준 요금 기준 $1.13, 출시 할인 적용 시 $0.57입니다. 해당 벤치마크 기관이 측정한 과제별 비용이지, 고객의 문서 한 건이나 API 호출 한 번의 가격은 아닙니다. 출처: 날짜가 명시된 Artificial Analysis 보고서.
독립 평가 결과는 전문 분야의 유력한 후보로 검토할 근거가 됩니다. 과제당 비용에 관한 결과는 출력 소비량도 측정해야 한다는 점을 보여 줍니다. 다만 이 결과만으로 마이그레이션을 결정할 수는 없습니다. 이 글에는 사이트가 직접 측정한 GPT-6 또는 Claude와의 순위 비교가 없습니다. 아래의 판단 기준은 확인된 배포 조건, 명시된 가격, 실제 업무에 적용할 수 있는 검수 기준에 근거합니다.
Mistral Large 4, 이번 달에 테스트해야 할 사용자는 누구입니까?
현재 모델이 어떤 작업에서 실패하는지 분명하고, 그 작업에서 더 나은 결과를 얻기 위해 추가 비용을 지불할 이유가 있을 때 Large 4를 테스트합니다. 저렴한 모델이 이미 성공적으로 처리하는 작업은 그대로 둡니다. 같은 출시 소식을 보더라도 개발자, 운영 담당자, 기업 구매 담당자가 움직일 이유는 서로 다릅니다.
개발자: 어려운 사례에만 별도 모델을 사용합니다
투자를 받은 창업자라면 기본 모델을 바꾸기 전에 어려운 워크플로 하나를 파일럿으로 검증해야 합니다. 예를 들어 문서 어시스턴트가 일반적인 필드 추출은 저렴하게 처리하지만, 차트와 각주, 서로 상충하는 첨부 자료에 증거가 흩어져 있으면 어려움을 겪을 수 있습니다. 이 사례들을 평가에 넣고 Large 4가 수정 작업을 줄이는지 측정합니다. 멀티모달과 툴 사용에 관한 주장은 시험할 근거가 되지만, 어떤 모델로 처리할지는 실제 검수 결과를 보고 결정해야 합니다.
기존 모델이 이미 받아들일 만한 분류 결과를 내는 1인 개발자라면 바꿀 이유가 많지 않습니다. 더 작은 모델을 유지하면서, 그 모델이 실패하는 작업을 위한 후보로 Large 4를 남겨 두면 됩니다. 에이전트용 모델의 대안을 찾는다면 소형 코딩 모델 가이드에서 더 좁은 범위로 검토를 시작할 수 있습니다. 모든 호출을 새 플래그십 모델로 교체할 필요는 없습니다.
운영 담당자: 보안과 근거가 많은 문서부터 평가합니다
보안 리드에게는 허가된 방어 업무를 테스트할 구체적인 이유가 있습니다. Mistral은 취약점 재현과 패치뿐 아니라 악성코드 분석, 취약점 우선순위 지정, 탐지 규칙 작성을 활용 사례로 제시합니다. 파일럿에서는 제안된 패치가 제공된 문제를 해결하는지, 생성된 탐지 규칙이 증거와 맞는지 확인해야 합니다. 허용되는 작업을 명확히 정하고, 결과가 운영 시스템을 바꾸기 전에 검토합니다. 출처: Mistral의 사이버보안 설명.
법무 운영 리드라면 승인된 문서 집합을 사용해 답변이 판단의 근거가 되는 핵심 구절을 찾아내는지, 예외 조건을 빠뜨리지 않는지, 증거와 추론을 구분하는지 평가합니다. 재무 담당자는 올바른 기간을 사용하는지, 계산을 재현하는지, 각 입력값을 원본 문서까지 추적할 수 있는지 평가합니다. 아무리 매끄러운 검토 보고서라도 조항이나 기간이 틀렸다면 검수를 통과할 수 없습니다. 모델의 벤치마크 점수와는 별개의 문제입니다.
Mistral은 설계 도면, 제조, 지리 공간 영상, 과학 프로그래밍도 활용 분야로 언급합니다. 각각 별도로 평가해야 합니다. 기술 도면에서 부품을 식별하는 일, 위성 영상에서 대상을 찾는 일, 과학 계산 루틴을 구현하는 일에는 서로 다른 검수 기준이 필요합니다. 이번 출시는 평가 후보로 삼을 근거를 제공할 뿐, 하나의 종합 점수가 세 가지 업무 모두에 적용된다는 것을 입증하지는 않습니다. 출처: Mistral의 상세 기능 설명.
기업 구매 담당자: 구매할 서비스의 EU 처리 범위를 확인합니다
EU 내 데이터 위치 요건이 있다면 Mistral을 후보에 넣고, 실제로 사용할 서비스의 처리 범위를 확인해야 합니다. Mistral은 공개 프리뷰가 자사의 유럽 데이터센터 인프라에서 실행된다고 설명합니다. 한편 일반적인 리전별 추론 문서에는 글로벌 엔드포인트가 특정 처리 위치를 보장하지 않는다고 따로 명시돼 있습니다. 이 설명들을 모든 Mistral 요청에 적용되는 하나의 보장으로 합쳐 해석해서는 안 됩니다. 출처: 프리뷰 인프라, 리전별 추론.
리전별 경로는 **api.eu.mistral.ai**입니다. 리전마다 제공 모델이 다르므로 필요한 모델이 실제로 이 엔드포인트에서 제공되는지 확인해야 합니다. 리전 표에는 EU 및 EFTA 국가의 데이터센터가 설명돼 있습니다. EFTA는 EU와 별개인 유럽자유무역연합입니다. 따라서 EU 안에서만 처리해야 한다는 엄격한 요건이 있다면 허용된 처리 위치를 확인해야 합니다. Mistral은 리전별 추론에 표준 정가의 10% 할증을 명시합니다. 적용 견적을 확인하지 않은 채 출시 할인과 함께 적용된다고 가정해서는 안 됩니다. 또한 리전별 엔드포인트에서는 Agents, Batch, Files API를 제공하지 않으며, 지원되는 리전별 툴은 함수 호출뿐이라고 설명합니다. 출처: 리전별 기능과 가격.
문서 에이전트를 계획하는 CTO라면 이 차이가 중요합니다. 글로벌 모델 카드의 기능 목록만으로 같은 관리형 워크플로를 리전별 엔드포인트에서도 실행할 수 있다고 볼 수는 없습니다. 요청과 응답이 특정 지역에서 처리된다고 해서 계정, 청구, 사용량 기록까지 모두 같은 지역으로 제한되는 것도 아닙니다. 데이터를 전혀 보관하지 않는 정책과도 별개의 문제입니다. 규제를 받는 자료를 옮기기 전에 자신의 시스템에 필요한 처리, 저장, 툴 의존성을 확인해야 합니다.
웨이트가 공개되면 무엇이 달라집니까?
웨이트가 공개되면 배포를 직접 통제할 수 있는 선택지가 생기고, 인프라와 운영비를 새로 판단해야 합니다. 오픈 웨이트는 다운로드할 수 있는 모델의 수치 파일입니다. 실제 라이선스와 지원 소프트웨어의 조건에 따라, 호스팅 엔드포인트에 전적으로 의존하는 대신 자체 정책 아래에서 추론을 실행할 길이 열릴 수 있습니다. Mistral이 밝힌 공개 목표는 여전히 2026년 10월 말입니다. 발표문은 특정 날짜를 약속하지 않습니다. 출처: 공개 계획.
기업 구매 담당자에게 실질적인 변화는 실행 환경, 접근 범위, 운영 절차를 선택할 가능성입니다. 호스팅 서비스의 정책이나 가용성이 바뀌면 중요한 워크플로가 중단될 수 있는 상황에서 의미가 있습니다. 동시에 용량 확보, 업그레이드, 모니터링, 장애 복구의 책임도 배포를 운영하는 쪽으로 옮겨 갑니다.
활성 파라미터가 49B라고 다운로드 크기나 메모리 계획도 49B 규모가 되는 것은 아닙니다. 활성 파라미터는 토큰을 처리할 때 선택되는 연산을 설명하는 수치입니다. 전체 웨이트는 여전히 저장돼 있어야 하고, 서빙 시스템이 사용할 수 있어야 합니다. 실제 자체 호스팅 요건은 최종 웨이트 형식, 지원 런타임, 하드웨어 구성, 동시 처리 요구에 따라 결정됩니다. 출시 발표의 핵심 사양만으로 구체적인 하드웨어 권장안이나 호스팅 가격을 도출할 수는 없습니다.
향후 비교에서는 인프라 비용을 성공적으로 완료한 작업 수로 나눈 값에 운영 인건비와 필요한 통제권의 가치를 더해 판단합니다. 사용량이 적은 배포는 유휴 용량 비용을 부담할 수 있고, 사용량이 많은 배포는 그 비용을 더 많은 작업에 분산할 수 있습니다. 어느 경우에도 자체 호스팅이 API보다 저렴하다고 단정할 수는 없습니다.
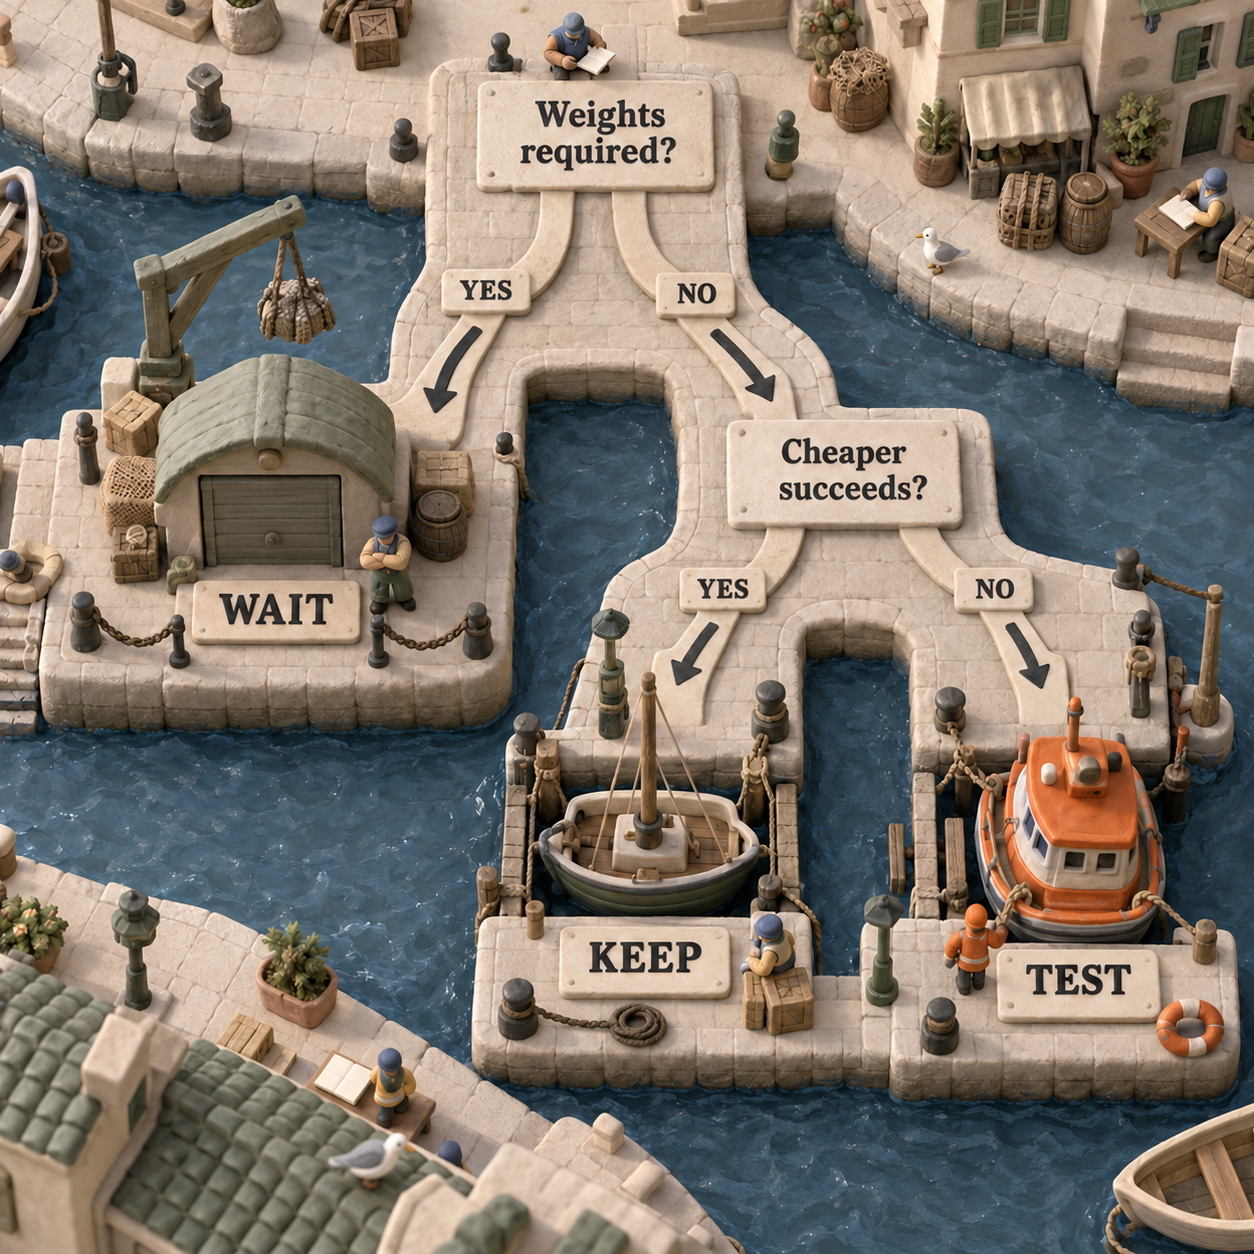
구매 조건에 다운로드 가능한 웨이트가 필수라면 실제 파일, 라이선스, 검증 가능한 배포가 준비될 때까지 기다려야 합니다. 평가용 사례와 연동 범위는 지금 준비할 수 있습니다. 호스팅 프리뷰는 데이터 정책상 사용이 허용되는 범위에서만 모델 역량을 확인하는 데 도움이 됩니다. 공개 약속만으로 온프레미스 요건을 충족할 수는 없습니다.
과장해서 받아들이기 쉬운 부분은 무엇입니까?
프리뷰 이용, 향후 웨이트 공개, 프로덕션 배포라는 세 단계를 하나로 취급하면 판단이 앞서갑니다. 각 단계가 답하는 질문은 다릅니다. 현재 API로는 프리뷰를 평가할 수 있습니다. 약속된 웨이트는 다른 운영 방식을 열어 줄 수 있습니다. 실제 배포가 가능하고, 라이선스를 확보했으며, 지원할 수 있는 시스템인지는 별도로 검증해야 합니다.
오픈 웨이트라는 설명만으로 특정 오픈소스 라이선스나 제한 없는 상업적 권리가 보장되지는 않습니다. 이전 Mistral 모델의 라이선스를 그대로 적용하지 말고, 실제 Large 4가 공개될 때 함께 제공되는 조건을 확인해야 합니다.
벤치마크 차트도 모든 영역의 우위를 입증하지는 않습니다. 보안상 거절하는 방식, 툴 접근 권한, 실행 환경, 과제 정의가 점수에 영향을 줄 수 있습니다. 법률 벤치마크가 법률 자문의 적절성을 인증하는 것은 아닙니다. 스프레드시트 벤치마크만으로 자신의 보고 워크플로가 올바른 증거를 보존하는지 판단할 수도 없습니다. 관련 주장을 근거로 테스트를 고르고, 실제 필요한 결과물을 평가해야 합니다.
확대된 사이버보안 접근 권한도 별도로 구분해야 합니다. Mistral은 사이버보안 리더, 검증된 파트너, 국가 기관에 레드팀 테스트 과정에서 완화된 모더레이션과 확대된 사이버 역량을 제공한다고 설명합니다. 모든 공개 프리뷰 고객에게 같은 접근 권한을 약속한 것은 아닙니다. 자신의 계정에서 사용할 수 있는 권한과 동작을 평가해야 합니다. 출처: 프리뷰 접근 권한 설명.
마지막으로 할인 요금 때문에 파일럿 비용이 지속적인 운영 비용보다 저렴해 보일 수 있습니다. 일시적인 모델 요금 절감만으로는 마이그레이션 작업, 검토자 시간, 향후 자체 호스팅의 경제성을 판단하기 어렵습니다. 이 결정들은 정가와 실제 운영 범위를 기준으로 해야 합니다.
다음 단계: 범위를 정한 파일럿을 진행합니다
다음 주에 엔지니어링 리드는 승인된 소규모 평가 집합을 mistral-large-4-0으로 보내고, 프로덕션 트래픽은 이미 검증된 기존 모델로 계속 처리하는 것이 좋습니다. 웨이트가 필요한 기업 구매 담당자는 같은 사례를 준비하되, 약속된 파일과 조건이 실제로 제공될 때까지 자체 호스팅 배포 승인을 기다려야 합니다.
대표 사례를 고르고 검수 기준을 정합니다
시작점으로는 현재 모델이 틀리는 어려운 예시를 포함해 대표 사례 50건을 제안합니다. 실무적인 파일럿 규모이지 통계적 보장은 아닙니다. 결과를 보기 전에 정확성 기준, 필요한 증거, 허용할 작업을 정합니다. 법률 및 금융 업무에서는 자격을 갖춘 검토자가 원문 근거와 계산을 평가하도록 합니다.
버전별 모델과 허용된 엔드포인트를 사용합니다
Mistral Studio에서 호스팅 프리뷰를 시험하거나, 문서에 명시된 채팅 완성 API를
mistral-large-4-0으로 호출합니다. 후보 모델마다 제공하는 증거와 툴 사용 예산을 동일하게 유지합니다. 처리 지역이 요건이라면 먼저 해당 리전의 모델과 기능 제공 여부를 확인합니다.검수를 통과한 작업을 측정하고 지속 비용을 예상합니다
검수를 통과한 결과, 수정 사항, 전체 입력과 과금되는 출력, 지연 시간, 툴 사용량, 검토자 시간을 기록합니다. 비용 전망에는 정가를 적용합니다. 개선 효과가 추가 비용을 상쇄하거나 필수 역량 또는 통제권을 제공할 때만 해당 모델을 계속 사용합니다. 웨이트가 실제로 공개되면 모델, 라이선스, 운영비를 다시 확인합니다.
자신의 Mistral API 키를 MISTRAL_API_KEY에 설정한 뒤 글로벌 엔드포인트의 기본 연결을 확인하려면, 문서에 명시된 채팅 완성 경로를 다음과 같이 호출합니다.
curl https://api.mistral.ai/v1/chat/completions \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-large-4-0",
    "messages": [
      {"role": "user", "content": "Explain the difference between input and output tokens in two sentences."}
    ]
  }'
이 호출로 확인하는 것은 연결과 모델 선택입니다. 문서 품질이나 리전 요건 준수 여부를 검증하는 것은 아닙니다. 도입 여부는 승인된 워크로드와 그 작업에서 검수를 통과한 결과를 바탕으로 결정해야 합니다.
실무에 필요한 모델 선택과 워크플로 판단 기준을 뉴스레터로 받아보실 수 있습니다.
- 마지막 업데이트
- 2026년 10월 7일
- 카테고리
- AI
Google에서 이 사이트를 우선하기


omidsaffari.com을 선호 소스로 지정하면 Google이 Top Stories, AI Overviews, AI Mode에서 우선적으로 보여 줍니다.
AI 에이전트 Lindy AI 리뷰: 요금·활용법·한계 비교
AI 에이전트 Lindy AI의 요금과 크레딧 비용, 이메일 자동화와 회의록 AI 설정을 살펴봅니다. 실제 문서로 확인한 연동·승인 범위와 사용량별 비용 예시를 바탕으로, AI 비서가 필요한 팀에 적합한지 판단하고 Gumloop, n8n, Marblism 대안까지 비교합니다.2026년 10월 7일AI
Mistral API 가격 가이드: 모델별 비용과 Vibe 구독 요금 (2026)
Mistral API 가격과 Vibe의 Pro·Team 요금을 비교합니다. 모델별 토큰 단가, 무료 사용 한도, API 크레딧과 EU 리전 추론의 추가 요금을 확인하고, Small 4와 Medium 3.5의 월 비용을 같은 사용량으로 계산합니다. 2026년 10월 기준입니다.2026년 10월 6일AI
AI 업무 자동화: Claude Skills로 주간 고객 보고서 만들기
Claude Skills로 AI 업무 자동화를 시작하는 방법을 소개합니다. 주간 고객 보고서 예제의 SKILL.md와 Python 계산 스크립트를 만들고, Claude 앱·Claude Code·API에 설치하는 절차와 팀 공유, 비용, 데이터 검증 및 사람의 검토 기준까지 살펴봅니다.2026년 10월 6일AI
AI 에이전트를 직원처럼 쓰는 법: 비용 비교와 도입 기준
AI 에이전트를 직원처럼 활용하려는 소규모 사업자를 위한 가이드입니다. 여섯 툴의 USD 요금과 사용량 한도를 비교하고, 메일·일정·고객지원·보고 업무를 30일 시범 운영으로 평가합니다. 사람의 검토와 수정, 설정 시간까지 계산해 어떤 역할을 유지할지 판단하는 방법을 설명합니다.2026년 10월 6일AI
Superwhisper부터 Wispr Flow 대안까지: 업무별 음성 입력 툴 비교 (2026)
Superwhisper, VoiceOS, Aqua Voice, Willow, Monologue와 무료 음성 입력 툴을 비교합니다. 요금과 결제 방식, 오프라인 처리 범위, 팀 SSO·HIPAA 조건, 코딩 에이전트 입력 흐름을 기준으로 업무에 맞는 Wispr Flow 대안을 고릅니다.2026년 10월 5일AI
AI 에이전트, 어디에 쓸까? 소규모 기업의 13가지 업무와 비용
AI 에이전트를 어디에 맡길지 고민하는 소규모 기업을 위해 고객 지원, 전화 예약, 영업 후속 연락, 사무 관리, 리서치, 코딩의 13가지 사례를 살펴봅니다. Tidio, Vida Global, Marblism 등의 시작 요금과 과금 단위, 사용 한도, 사람이 확인할 지점을 비교합니다.2026년 10월 5일AI
Claude 요금제와 API 가격 (2026): 모델별 단가와 앱 예산 계산
Claude 요금제와 API 가격을 비교하고 Haiku·Sonnet·Opus·Fable의 입력·출력·캐시 단가를 확인합니다. 세 가지 앱 예산 예시로 배치·검색·실행 시간 비용을 계산하고, 개인 작업에서 Pro·Max가 유리해지는 조건과 코드 실행 무료 한도의 차이까지 짚어 봅니다.2026년 10월 4일AI