Mistral Large 4: cuánto cuesta y cuándo conviene usarlo
Precios de Mistral Large 4, oferta de lanzamiento y pesos abiertos: qué dicen sus benchmarks y cuándo conviene probar la API o esperar al despliegue propio.
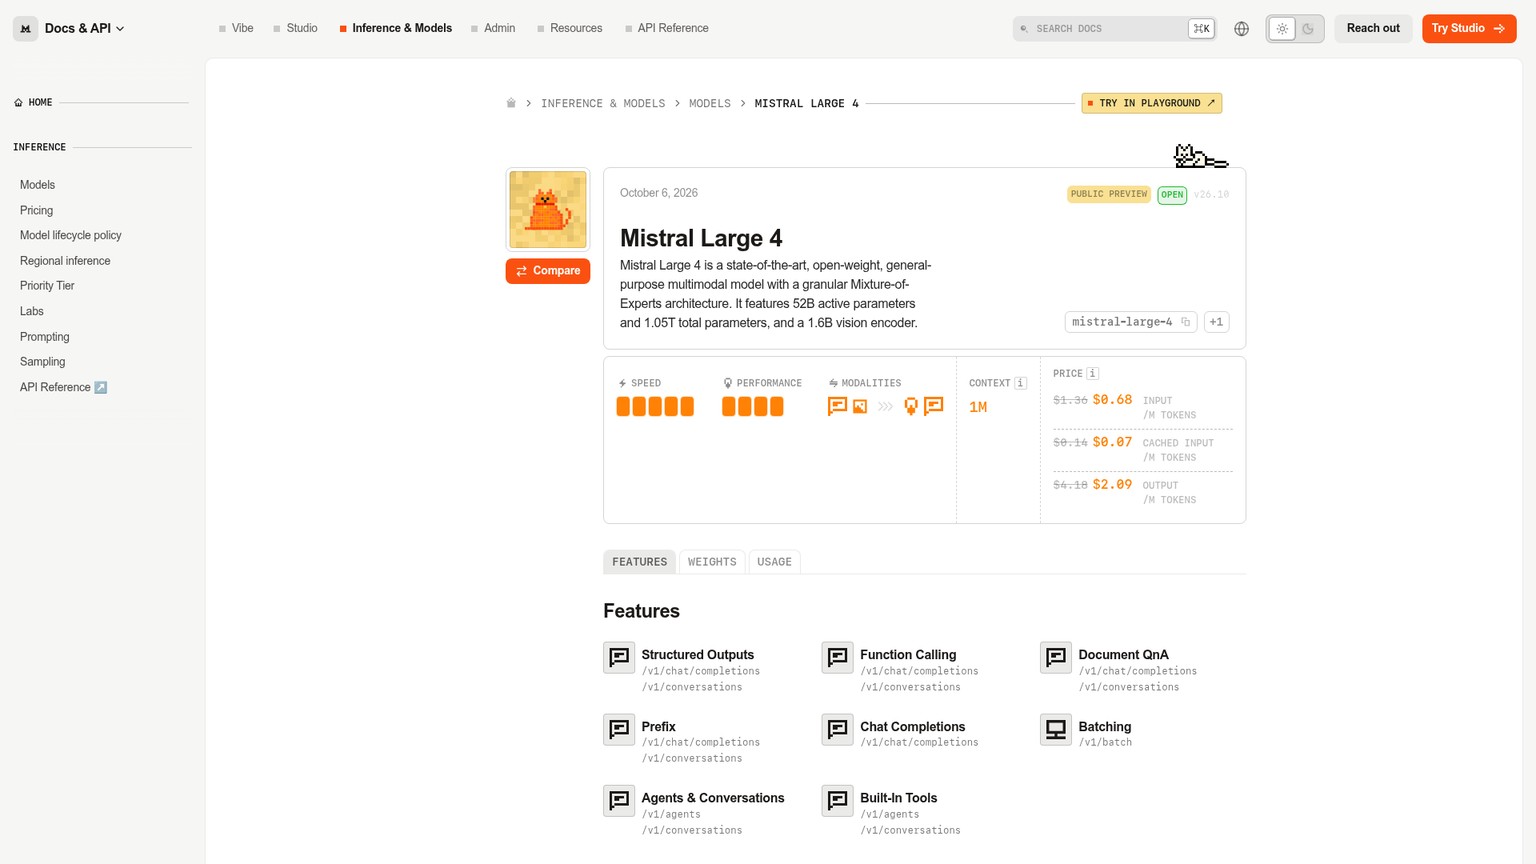
Mistral Large 4 merece una prueba piloto en su servicio alojado para tareas de seguridad y trabajo intensivo con documentos. Pero quienes necesiten alojarlo en su propia infraestructura deben esperar a los pesos que Mistral promete para finales de octubre de 2026. El precio anunciado de la API es de $1.36 por millón de tokens de entrada y $4.18 por millón de tokens de salida; la oferta de lanzamiento actual, con un descuento del 50%, los reduce a $0.68 y $2.09. Mantén el modelo más económico que ya cumpla su función y evalúa Large 4 por el costo del trabajo que supera tus criterios de aceptación.
Documentación de lanzamiento, precios y despliegue verificada el 7 de octubre de 2026. Las especificaciones de lanzamiento y los resultados declarados en las pruebas comparativas proceden del anuncio de Mistral; las tarifas actuales, de su tabla de precios de la API por versión. El presupuesto para documentos es un cálculo explícito: no representa un gasto medido ni implica que hayamos probado este modelo.
Mistral Large 4: qué cambió el 6 de octubre
Mistral lanzó una versión preliminar pública alojada el 6 de octubre de 2026; los pesos descargables siguen pendientes. Esto cambia desde ahora la lista de modelos que conviene evaluar. Todavía no ofrece a una empresa un modelo que pueda descargar y ejecutar en su propia infraestructura. Mistral apunta a finales de octubre y prevé acompañar los pesos con más detalles sobre la arquitectura y el entrenamiento posterior. Fuente: anuncio de lanzamiento.
Según el anuncio, Mistral Large 4 tiene 1T de parámetros totales y 49B de parámetros activos, una arquitectura Mixture-of-Experts que combina seguimiento de instrucciones y razonamiento, y entrada multimodal. Los parámetros son los valores numéricos que aprende el modelo. Una arquitectura Mixture-of-Experts, o MoE, activa partes seleccionadas para cada token, en lugar de utilizar todos los parámetros en cada paso. La combinación de instrucciones y razonamiento permite que el mismo modelo siga instrucciones habituales y resuelva problemas que exigen un análisis más extenso. La entrada multimodal incorpora material visual al flujo de trabajo, algo relevante para gráficos, planos de ingeniería y pruebas contenidas en documentos. Son las especificaciones del anuncio, no una guía para dimensionar el hardware. Fuente: descripción del modelo de Mistral.
La vía de acceso confirmada hoy es Mistral Studio y su API preliminar, la plataforma para desarrolladores asociada a La Plateforme. Utiliza mistral-large-4-0 para identificar esta versión en una evaluación. La ficha de la versión también recoge el nombre abreviado mistral-large-4 y la compatibilidad con generación de respuestas de chat, salidas estructuradas, llamadas a funciones y preguntas y respuestas sobre documentos. Las salidas estructuradas permiten solicitar respuestas con un formato definido; las llamadas a funciones permiten pedir acciones a las herramientas que expone tu aplicación.
El anuncio de lanzamiento remite a Studio. No confirma que esta versión preliminar concreta pueda seleccionarse en Le Chat o Vibe. Una suscripción de consumo y un endpoint para desarrolladores asociado a una versión resuelven necesidades de compra distintas. Por eso, si necesitas una evaluación reproducible del modelo, utiliza la API.
Hay una discrepancia en las especificaciones que conviene mantener a la vista: la ficha actual de la versión indica 1.05T de parámetros totales y 52B activos, mientras que el anuncio habla de 1T y 49B. Son dos descripciones del proveedor; no corresponde sustituir una por otra sin explicarlo. Las cifras de lanzamiento anteriores se atribuyen expresamente al anuncio. Habrá que comprobar de nuevo la arquitectura definitiva y los requisitos de despliegue cuando se publiquen los pesos. Fuente: ficha actual de la versión.
Precio de Mistral Large 4: tarifas de lista y oferta de lanzamiento
Presupuesta el uso continuado a $1.36 por millón de tokens de entrada y $4.18 por millón de tokens de salida; reserva la tarifa reducida para una prueba que cumpla las condiciones de la oferta. Los tokens son las unidades que procesa el modelo: la entrada incluye tus instrucciones y el material que proporcionas; la salida es el contenido generado que factura el servicio. Cada parte tiene su propia tarifa. Mezclarlas en un solo precio puede ocultar el costo de un flujo de trabajo que genere muchas respuestas extensas.
El anuncio de Mistral recoge las tarifas de lista. Su tabla actual de precios Standard, con la inferencia regional desactivada, muestra Large 4 en oferta y tacha las tarifas originales. Todas las cifras siguientes están expresadas en dólares estadounidenses por millón de tokens. Fuentes: anuncio, precios de la API.
La misma tabla fija la entrada en caché en $0.14 normalmente y $0.07 durante la oferta. Se trata de material procesado previamente que reúne las condiciones para reutilizarse a una tarifa menor. Si envías un documento por primera vez, inclúyelo en la estimación de entrada sin caché. Fuente: precios de la API.
La oferta tiene una duración, pero no una fecha de cierre publicada
Mistral anuncia un descuento de lanzamiento del 50% durante dos semanas. El registro de cambios indica esa duración; la ficha del modelo y la tabla de precios detallan los importes rebajados. Los documentos públicos consultados para esta guía no especifican la fecha exacta de vencimiento, la hora de cierre ni la zona horaria. No se pudo consultar el precio dentro de una cuenta autenticada porque la pantalla exigía iniciar sesión. No hay una fecha verificada que podamos presentar como último día de la oferta: confírmala en tu propia consola antes de programar trabajo en función de la promoción.
Para una previsión de compra, utiliza las tarifas originales y considera la oferta un descuento temporal. Así evitas que un mes de evaluación económico lleve a subestimar el presupuesto de uso continuado.
Tampoco apliques a Large 4 el ejemplo genérico de $0.50 de entrada y $1.50 de salida que aparece en la página pública de precios de Mistral. Esas cifras corresponden a Mistral Large 3 en la tabla por versión. El nombre de una familia de modelos no identifica el precio de su versión actual. Nuestra guía de precios de Mistral incluye la lista completa de modelos y las opciones de suscripción por separado.
Un mes de revisión documental cuesta $48.10 a precio de lista
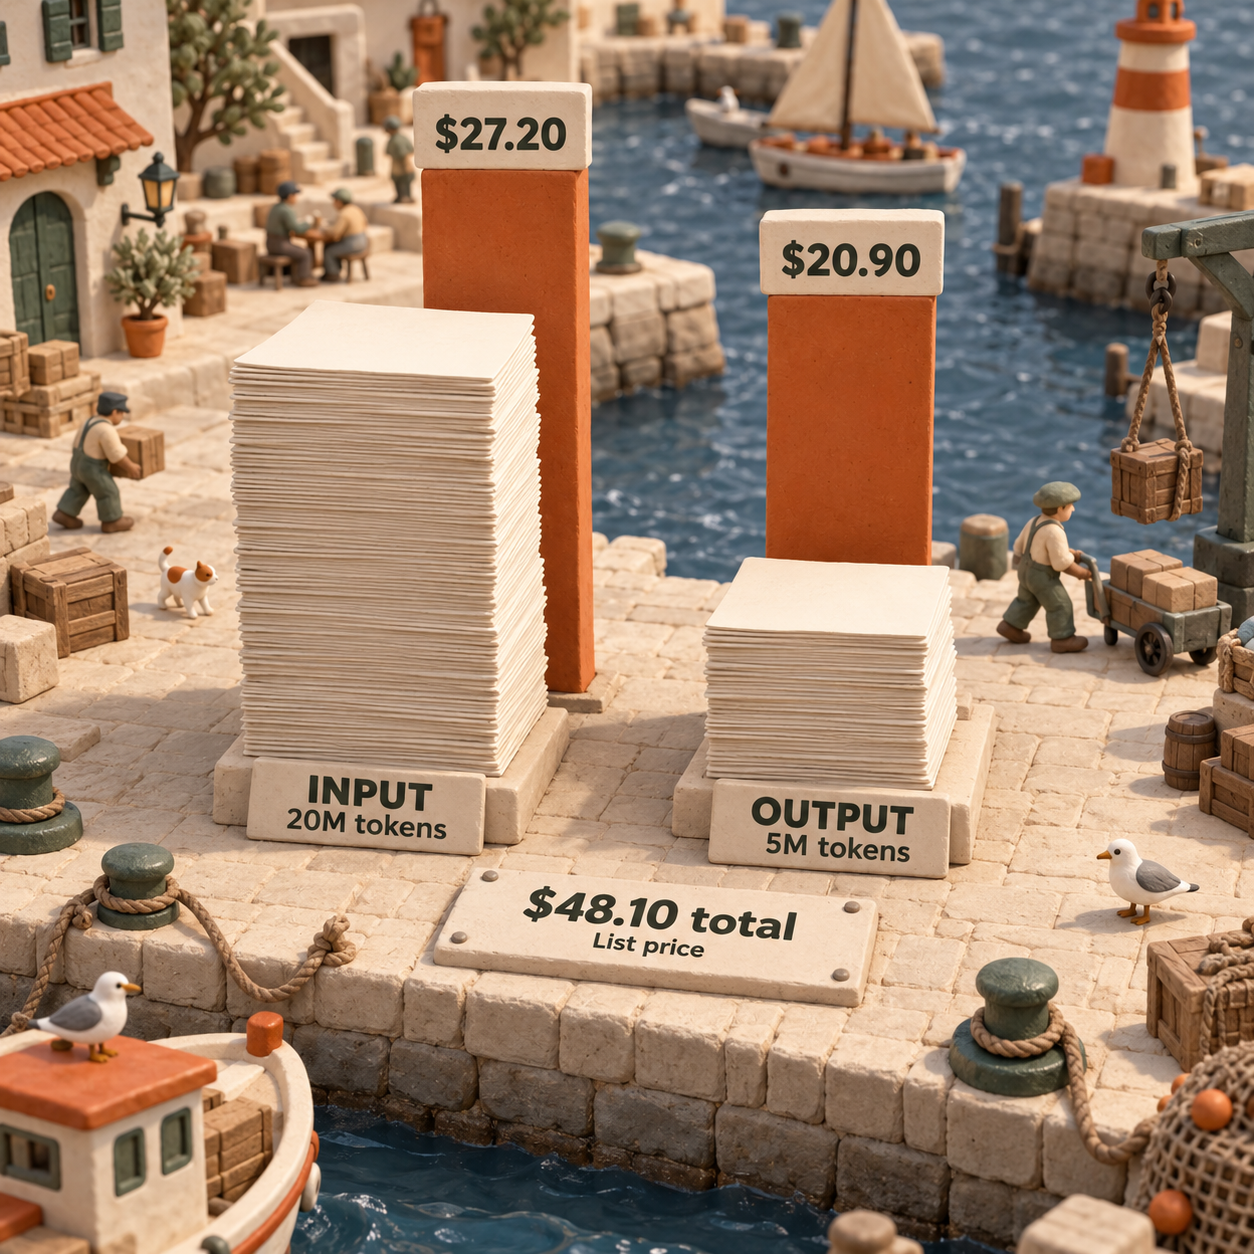
Una carga de 1,000 tareas de revisión documental cuesta $48.10 en uso del modelo Large 4 con las tarifas de lista. Supongamos que cada tarea consume, en promedio, 20,000 tokens de entrada sin caché y 5,000 tokens de salida facturados, contando todas las llamadas al modelo que correspondan a esa tarea. El mes suma entonces 20 millones de tokens de entrada y 5 millones de salida. Es un presupuesto ilustrativo de consumo, no una conversión de páginas a tokens ni una medición de un despliegue real.
El cálculo es el siguiente:
- Entrada: 20 × $1.36 = $27.20.
- Salida: 5 × $4.18 = $20.90.
- Total: $27.20 + $20.90 = $48.10.
Mientras se aplique la oferta de lanzamiento, el mismo volumen fijo cuesta 20 × $0.68 + 5 × $2.09 = $24.05. Estas estimaciones excluyen impuestos, créditos, cargos por procesamiento de documentos y herramientas, y cualquier consumo adicional del modelo que exceda los tokens indicados. Las tarifas proceden de la tabla de precios de Mistral; el cálculo es nuestro.
La salida representa solo el 20% de los tokens del ejemplo, pero alrededor del 43% de su factura a precio de lista. Un flujo que genere investigaciones extensas o reescriba un informe varias veces puede elevar el costo más rápido de lo que su volumen de entrada sugiere. Cuenta el consumo que devuelve el servicio para la tarea completa, en lugar de presupuestar únicamente el párrafo final que ve el usuario.
El modelo más económico marca cuándo vale la pena cambiar
Mistral Small 4 cuesta $6 para el mismo volumen fijo de tokens, con sus tarifas publicadas de $0.15 de entrada y $0.60 de salida: 20 × $0.15 + 5 × $0.60. Es una referencia de precio, no una afirmación de que ambos modelos resuelvan las mismas tareas igual de bien. El costo adicional de Large 4 a precio de lista es de $42.10 al mes; durante la promoción, de $18.05. Fuente: tarifas actuales de los modelos.
Si quien dirige una empresa valora internamente el tiempo de revisión en $60 por hora, o $1 por minuto, Large 4 debe ahorrar 42.1 minutos de correcciones a lo largo del mes para compensar ese costo adicional en el ejemplo. Ese es el punto de equilibrio que conviene medir. Puedes sustituir el valor supuesto del trabajo por el tuyo; además, el consumo real de tokens puede variar entre modelos.
Para los responsables de ingeniería, el criterio es el mismo: un modelo más grande se gana su lugar si reduce las respuestas rechazadas, requiere menos correcciones o permite cumplir un requisito de despliegue. Un precio bajo por token no garantiza un costo bajo por resultado aceptado, y un descuento de lanzamiento no debería decidir la arquitectura permanente.
Qué permiten concluir las pruebas comparativas
Los resultados de Mistral justifican incluir el modelo entre los candidatos a evaluar; no demuestran que sea el mejor para tu carga de trabajo. Un benchmark es un conjunto definido de tareas que se ejecutan bajo condiciones concretas. Las puntuaciones de agentes de programación dependen de herramientas y entornos de ejecución, no solo de un modelo que responde a un prompt breve. La localización visual mide la capacidad de encontrar algo en una imagen. Esas diferencias determinan si un resultado es relevante para tu aplicación.
Los datos siguientes son afirmaciones de Mistral en su anuncio del 6 de octubre, incluidas puntuaciones que atribuye a sistemas externos de evaluación. Este sitio no ha producido esos resultados, y los porcentajes de pruebas distintas no son intercambiables.
Fuente de todos los datos de la tabla: evaluación de lanzamiento de Mistral. Elo es una puntuación comparativa, no el porcentaje de tareas completadas correctamente. Del mismo modo, una puntuación en una prueba de seguridad no garantiza que un agente resista todos los documentos maliciosos que encuentre.
Para el trabajo profesional, Mistral afirma que lidera el rendimiento entre modelos abiertos en el benchmark Legal Agent de Harvey, y destaca Vals.ai Finance Agent v2 y FinWorkBench, también llamado Finch, para tareas financieras y hojas de cálculo. También se atribuye el liderazgo entre modelos abiertos en SciCode-Verified, una evaluación de programación científica. Son motivos útiles para elegir casos jurídicos, financieros o científicos para una prueba piloto. No sustituyen la comprobación de cada respuesta con las pruebas aportadas. Fuente: evaluaciones por especialidad de Mistral.
Una evaluación independiente: Artificial Analysis, 6 de octubre de 2026
Artificial Analysis publicó su propia evaluación el 6 de octubre de 2026, con una puntuación de 38 en su Intelligence Index y 50 en su Cyber Index para Mistral Large 4 Preview. Calculó $1.13 por tarea del Intelligence Index con las tarifas estándar, que bajan a $0.57 con el descuento de lanzamiento. Son costos medidos en las tareas de ese evaluador, no el precio de un documento de un cliente ni de una llamada a la API. Fuente: informe fechado de Artificial Analysis.
El resultado independiente respalda su consideración como candidato creíble para tareas especializadas. A la vez, el costo por tarea que recoge hace necesario medir el consumo de salida. No ofrece una conclusión automática a favor de migrar. Aquí no presentamos una clasificación frente a GPT-6 o Claude basada en pruebas propias: la decisión que sigue se apoya en condiciones de despliegue verificadas, precios publicados y criterios de aceptación que puedes aplicar a tu trabajo.
Análisis de Mistral Large 4: quién debería probarlo este mes
Prueba Large 4 cuando un fallo concreto del modelo que usas tenga suficiente impacto como para pagar por un resultado mejor que cumpla tus criterios. Conserva las soluciones económicas que ya funcionan. Quienes desarrollan productos, los responsables de operaciones y los compradores empresariales tienen así motivos distintos para actuar ante el mismo lanzamiento.
Desarrollo de productos: reserva una ruta para los casos difíciles
El fundador de una empresa con financiación debería probar un flujo de trabajo difícil antes de cambiar el modelo predeterminado. Un asistente documental, por ejemplo, puede extraer campos habituales a bajo costo y fallar cuando las pruebas se reparten entre gráficos, notas al pie y anexos contradictorios. Incluye esos casos en la evaluación y mide si Large 4 reduce las correcciones. Sus capacidades declaradas de entrada multimodal y uso de herramientas justifican la prueba; los resultados que superen tus criterios decidirán qué modelo utilizar.
Quien desarrolla por su cuenta y ya obtiene clasificaciones aceptables con su modelo actual tiene pocos motivos para cambiar. Mantén la opción más pequeña y conserva Large 4 como candidato para las tareas en las que esa opción falle. Si buscas alternativas para agentes, la guía de modelos compactos de programación ofrece un punto de partida más acotado que sustituir todas las llamadas por un nuevo modelo insignia.
Operaciones: empieza por seguridad y documentos con muchas pruebas
Un responsable de seguridad tiene un motivo concreto para probar tareas defensivas autorizadas. Mistral menciona el análisis de malware, la priorización de vulnerabilidades y la redacción de reglas de detección, junto con la reproducción de vulnerabilidades y la creación de parches. Una prueba útil comprueba si el parche propuesto resuelve el problema descrito y si la regla de detección resultante corresponde a las pruebas aportadas. Define expresamente las acciones permitidas y revisa la salida antes de que produzca cambios en los sistemas que utilizas en tus operaciones. Fuente: sección de ciberseguridad de Mistral.
En operaciones jurídicas, utiliza un conjunto de documentos aprobado y evalúa si la respuesta identifica el pasaje determinante, conserva las excepciones y distingue las pruebas de las inferencias. En operaciones financieras, comprueba si utiliza el periodo correcto, reproduce el cálculo y vincula cada dato de entrada con su documento de origen. Un informe bien redactado que cite la cláusula o el periodo equivocados es trabajo rechazado, por muy buena que sea la puntuación del modelo.
Mistral también menciona planos de ingeniería, fabricación, imágenes geoespaciales y programación científica. Son líneas de evaluación distintas: identificar un componente en un plano técnico, encontrar un objeto en imágenes satelitales e implementar una rutina científica exigen criterios de aceptación diferentes. El lanzamiento permite considerarlas para una prueba; no demuestra que una puntuación general sea aplicable a las tres. Fuente: análisis detallado de capacidades de Mistral.
Compra empresarial: confirma qué garantías de ubicación en la UE ofrece el servicio
Los requisitos de ubicación de datos en la UE justifican considerar Mistral y comprobar después el alcance exacto del servicio. Mistral afirma que la versión preliminar pública se ejecuta en su propia infraestructura de centros de datos europeos. Por separado, su documentación general de inferencia regional indica que el endpoint global no garantiza una ubicación concreta de procesamiento. Esas afirmaciones no deben convertirse en una garantía universal para todas las solicitudes a Mistral. Fuentes: infraestructura de la versión preliminar, inferencia regional.
La vía regional es api.eu.mistral.ai. Comprueba que el modelo requerido esté disponible allí, porque la disponibilidad varía según la región. Su tabla de regiones describe centros de datos en países de la UE y de la EFTA; esta última es la Asociación Europea de Libre Comercio, una organización separada. Si el requisito exige procesamiento exclusivamente en la UE, habrá que confirmar qué ubicaciones están permitidas. Mistral indica un recargo del 10% sobre las tarifas de lista estándar para la inferencia regional; no supongas que se puede combinar con la promoción de lanzamiento sin confirmar la cotización aplicable. También señala que los endpoints regionales no ofrecen Agents, Batch ni la Files API, y que las llamadas a funciones son la única herramienta regional compatible. Fuente: funciones y precios regionales.
Esto importa para un director de tecnología que planee un agente documental: la lista de funciones de la ficha global del modelo no confirma que el mismo flujo gestionado funcione a través del endpoint regional. La ubicación donde se procesan las solicitudes y respuestas tampoco determina la de todos los registros de cuenta, facturación o uso, y es una cuestión distinta de la retención cero de datos. Verifica las dependencias de procesamiento, almacenamiento y herramientas que necesita tu sistema antes de trasladar material regulado.
Pesos abiertos de Mistral: qué cambiará cuando se publiquen
Los pesos permitirían controlar el despliegue y abrirían una nueva decisión sobre infraestructura y costos operativos. Los pesos abiertos son los archivos numéricos descargables del modelo. Pueden permitir ejecutar la inferencia con tus propias políticas, en lugar de depender por completo de un endpoint alojado, siempre según la licencia y el software compatible que se publiquen. Mistral mantiene como objetivo finales de octubre de 2026; el anuncio no promete un día concreto. Fuente: plan de lanzamiento.
Para una empresa, el cambio útil es la posibilidad de elegir el entorno de ejecución, los límites de acceso y los procedimientos operativos. Esto puede importar cuando un cambio de política o de disponibilidad del servicio alojado interrumpa un flujo crítico. También traslada a quien opere el despliegue la responsabilidad por la capacidad, las actualizaciones, la supervisión y la recuperación ante fallos.
Tener 49B de parámetros activos no significa que la descarga o la memoria necesaria correspondan a un modelo de 49B. Los parámetros activos describen el cálculo seleccionado para un token. El conjunto completo de pesos sigue teniendo que almacenarse y estar disponible para el sistema que ejecuta la inferencia. El formato final de los pesos, los entornos de ejecución compatibles, la configuración del hardware y los requisitos de concurrencia determinarán qué exige realmente alojarlo por cuenta propia. Del anuncio inicial no se puede deducir una recomendación precisa de hardware ni un precio de alojamiento.
Plantea la comparación futura como el costo de infraestructura dividido entre el trabajo completado correctamente, más el trabajo operativo y el valor del control que necesitas. Un despliegue con poco uso puede pagar capacidad ociosa; uno muy utilizado puede repartir ese costo entre más tareas. Ninguno de los dos casos demuestra por sí solo que alojarlo en infraestructura propia vaya a ser más barato que usar la API.
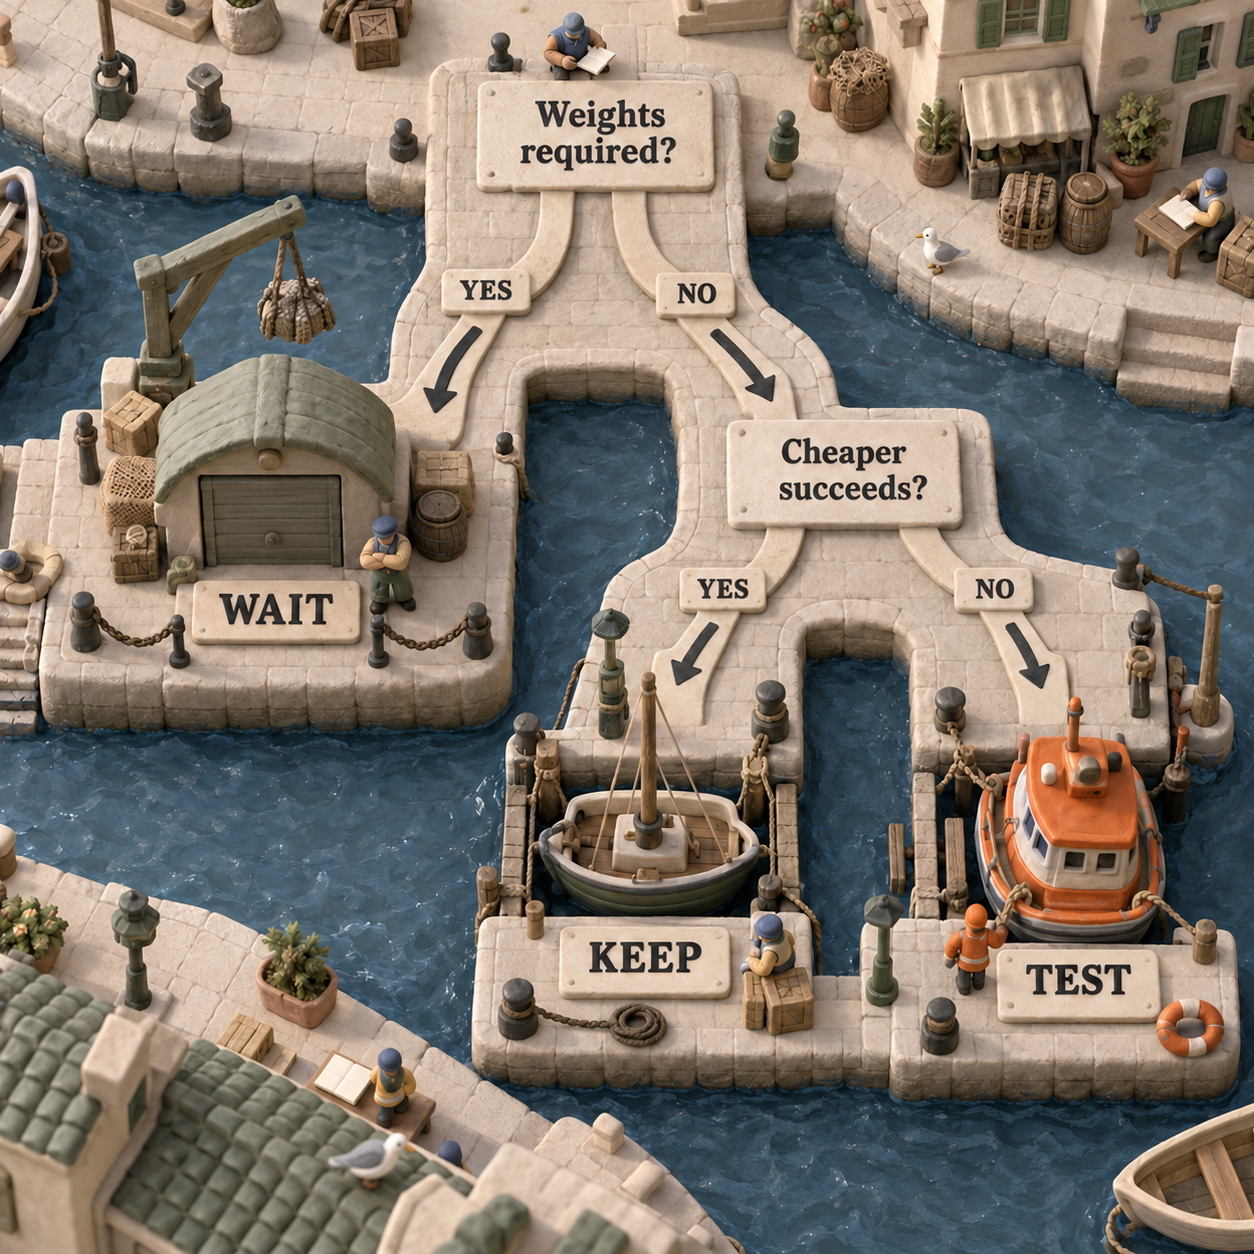
Si los pesos descargables son un requisito de compra, espera a los archivos, su licencia y un despliegue que puedas validar. Ya puedes preparar los casos de evaluación y definir los límites de la integración. La versión preliminar alojada solo puede resolver dudas sobre capacidades cuando tu política de datos permita usarla; una promesa no basta para cumplir un requisito de despliegue en las propias instalaciones.
Dónde se exageran las expectativas
La exageración consiste en tratar tres hitos distintos como si fueran uno: acceso preliminar, publicación futura de los pesos y despliegue en producción. Cada uno responde a preguntas diferentes. La API actual permite evaluar la versión preliminar. Los pesos prometidos podrían hacer posible otro modelo operativo. Un sistema que pueda desplegarse, tenga una licencia adecuada y pueda mantenerse necesita su propia verificación.
La descripción de un modelo como de pesos abiertos no confirma una licencia de código abierto concreta ni derechos comerciales sin restricciones. Revisa las condiciones de la publicación real de Large 4, en lugar de dar por aplicable la licencia de un modelo anterior de Mistral.
Los gráficos de benchmarks tampoco demuestran una superioridad universal. Las negativas por motivos de seguridad, el acceso a herramientas, los entornos de ejecución y las definiciones de las tareas pueden influir en las puntuaciones. Un benchmark jurídico no certifica asesoramiento legal; uno de hojas de cálculo no resuelve si tu flujo de informes conserva las pruebas correctas. Utiliza la afirmación pertinente para elegir una prueba y evalúa después el entregable que necesitas.
El acceso ampliado a capacidades de ciberseguridad tiene sus propios límites. Mistral afirma que responsables de ciberseguridad, socios verificados y autoridades estatales reciben una moderación reducida y capacidades de ciberseguridad ampliadas durante las pruebas de red teaming. Eso no garantiza el mismo acceso a todos los clientes de la versión preliminar pública. Evalúa los permisos y el comportamiento disponibles en tu cuenta. Fuente: descripción del acceso preliminar.
Por último, la tarifa promocional puede hacer que la prueba parezca más económica que el uso continuado. Un ahorro temporal en el precio del modelo dice poco sobre el esfuerzo de migración, el tiempo de revisión o los costos futuros de alojarlo por cuenta propia. Basa esas decisiones en las tarifas permanentes y en las condiciones reales de operación.
El siguiente paso: una prueba piloto con límites claros
La próxima semana, un responsable de ingeniería debería enviar un pequeño conjunto aprobado de casos de evaluación a mistral-large-4-0 y mantener el tráfico de producción en la ruta actual que ya ofrece resultados aceptables. Si una empresa necesita los pesos, debería preparar esos mismos casos y esperar a que existan los archivos prometidos y sus condiciones antes de aprobar un despliegue en infraestructura propia.
Elige casos representativos y define qué resultados aceptarás
Un punto de partida sugerido es 50 casos representativos, incluidos ejemplos difíciles que el sistema actual resuelve mal. Es un tamaño práctico para una prueba piloto, no una garantía estadística. Define qué significa una respuesta correcta, qué pruebas debe aportar y qué acciones tiene permitidas antes de ver las salidas. Para trabajo jurídico y financiero, pide a un revisor cualificado que evalúe el respaldo documental y los cálculos.
Utiliza el modelo de la versión concreta y el endpoint permitido
Prueba la versión preliminar alojada en Mistral Studio o llama a la API documentada de respuestas de chat con
mistral-large-4-0. Mantén las mismas pruebas aportadas y el mismo presupuesto de herramientas para todos los candidatos. Si la ubicación es un requisito, comprueba primero la disponibilidad regional del modelo y de sus funciones.Mide el trabajo aceptado y proyecta la factura de uso continuado
Registra los resultados aceptados, las correcciones, la entrada total y la salida facturada, la latencia, el uso de herramientas y el tiempo de revisión. Aplica las tarifas de lista a la previsión. Conserva esa ruta solo si la mejora compensa su costo adicional o aporta una capacidad o un control que necesitas. Vuelve a revisar el modelo, la licencia y el costo operativo cuando se publiquen los pesos.
Para una comprobación básica de conexión al endpoint global, con tu propia clave de API de Mistral ya definida en MISTRAL_API_KEY, la llamada documentada de respuestas de chat es:
curl https://api.mistral.ai/v1/chat/completions \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-large-4-0",
    "messages": [
      {"role": "user", "content": "Explain the difference between input and output tokens in two sentences."}
    ]
  }'
Esto comprueba la conexión y la selección del modelo, no la calidad del trabajo documental ni el cumplimiento de los requisitos regionales. La decisión de adoptar el modelo depende de la carga de trabajo aprobada y de los resultados que superen tus criterios.
Recibe criterios prácticos para elegir modelos y flujos de trabajo en el boletín.
- Última actualización
- 7 oct 2026
- Categoría
- AI
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.
Lindy AI como asistente de IA: análisis, precios y límites
Analizamos Lindy AI como asistente de IA: precios, créditos, correo, reuniones y límites de aprobación para decidir si encaja con el trabajo de tu empresa.7 oct 2026AI
Precios de Mistral (2026): cuánto cuestan la API y Vibe
Consulta los precios de Mistral: tarifas de API, planes de Vibe y Le Chat, límites gratuitos, alojamiento en la UE y un ejemplo de factura mensual.6 oct 2026AI
Skills de Claude: crea tu informe semanal de clientes
Crea skills de Claude para preparar informes semanales de clientes con datos validados. Guía paso a paso para instalarlas y compartirlas en tu equipo.6 oct 2026AI
Agentes de IA como empleados: qué delegar y cuánto cuestan
Qué tareas delegar a los agentes de IA, precios de seis herramientas y cómo evaluar una prueba de 30 días con revisión humana antes de ampliar sus permisos.6 oct 2026AI
Dictado por voz: qué alternativa a Wispr Flow elegir
Compara alternativas a Wispr Flow para dictado por voz: precios, privacidad sin internet, funciones de equipo y opciones para trabajar con agentes de IA.5 oct 2026AI
Agentes de IA: 13 tareas concretas para pequeñas empresas
Descubre 13 ejemplos de agentes de IA para pequeñas empresas: soporte, llamadas, ventas y código, con precios, límites de uso y puntos de revisión humana.5 oct 2026AI
Claude API pricing 2026: tarifas y tres presupuestos para tu app
Consulta los precios de la API de Claude por modelo y calcula el presupuesto de tu app con ejemplos de tokens, caché, lotes y cargos por herramientas.4 oct 2026AI