Mistral Large 4 : quel budget et quand passer à l’action ?
Mistral Large 4 : tarifs API, remise de lancement et benchmarks. Découvrez quand tester la preview hébergée et quand attendre les poids pour l’héberger.
Mistral Large 4 mérite un pilote en mode hébergé pour les tâches de sécurité et les workflows riches en documents. En revanche, si l’auto-hébergement est indispensable, mieux vaut attendre les poids que Mistral promet pour la fin octobre 2026. Le tarif API annoncé est de $1.36 par million de tokens en entrée et de $4.18 par million de tokens en sortie ; l’offre de lancement à 50% ramène ces montants à $0.68 et $2.09. Gardez un modèle moins cher lorsqu’il suffit et jugez Large 4 sur le coût d’un travail accepté.
Documentation de lancement, de tarification et de déploiement vérifiée le 7 octobre 2026. Les caractéristiques annoncées et les résultats de benchmarks ci-dessous proviennent de l’annonce de Mistral ; les tarifs en vigueur viennent de sa grille API par version. Le budget documentaire repose sur un calcul explicite. Il ne correspond ni à des dépenses mesurées ni à un test de ce modèle réalisé ici.
Mistral Large 4 : ce qui a changé le 6 octobre
Mistral a ouvert une preview publique hébergée le 6 octobre 2026 ; les poids téléchargeables restent annoncés pour plus tard. Le modèle peut donc rejoindre dès maintenant votre sélection à évaluer. Une entreprise ne peut pas encore le télécharger pour l’exécuter sur sa propre infrastructure. Mistral vise la fin octobre et prévoit de publier les poids avec davantage de détails sur l’architecture et le post-entraînement. Source : annonce de lancement.
Selon cette annonce, Mistral Large 4 compte 1T de paramètres au total et 49B de paramètres actifs, avec une architecture Mixture-of-Experts hybride associant suivi d’instructions et raisonnement, ainsi que des entrées multimodales. Les paramètres sont les valeurs numériques apprises par le modèle. Une architecture Mixture-of-Experts, ou MoE, n’active que certaines parties du modèle pour chaque token, au lieu de mobiliser tous les paramètres à chaque étape. L’approche hybride réunit, dans un même modèle, le suivi d’instructions courant et la résolution de problèmes nécessitant un raisonnement plus poussé. Les entrées multimodales permettent d’intégrer des éléments visuels au workflow : graphiques, plans techniques ou pièces justificatives présentes dans les documents. Il s’agit des caractéristiques de l’annonce, pas d’un guide de dimensionnement matériel. Source : description du modèle par Mistral.
L’accès confirmé aujourd’hui passe par Mistral Studio et son API de preview, la plateforme développeur associée à La Plateforme. Pour identifier précisément cette version lors d’une évaluation, utilisez mistral-large-4-0. La fiche de version mentionne aussi le nom abrégé mistral-large-4, ainsi que la prise en charge des chat completions, des sorties structurées, des appels de fonctions et des questions-réponses sur documents. Une sortie structurée permet à une application de demander un format de réponse défini ; les appels de fonctions lui permettent de demander une action à un outil qu’elle met à disposition du modèle.
L’annonce de lancement renvoie vers Studio. Elle ne confirme pas que cette version précise de la preview soit sélectionnable dans Le Chat ou Vibe. Un abonnement grand public et un endpoint développeur propre à une version répondent à des besoins d’achat différents. Pour une évaluation reproductible du modèle, passez donc par l’API.
Une divergence entre les caractéristiques publiées mérite d’être signalée : la fiche de version actuelle indique 1.05T de paramètres au total et 52B de paramètres actifs, contre 1T et 49B dans l’annonce. Ce sont deux descriptions du fournisseur ; il n’y a pas lieu de remplacer discrètement l’une par l’autre. Les chiffres de lancement cités plus haut sont explicitement attribués à l’annonce. L’architecture finale et les exigences de déploiement devront être revérifiées à la sortie des poids. Source : fiche de version actuelle.
Prix de Mistral Large 4 : tarifs catalogue et offre de lancement
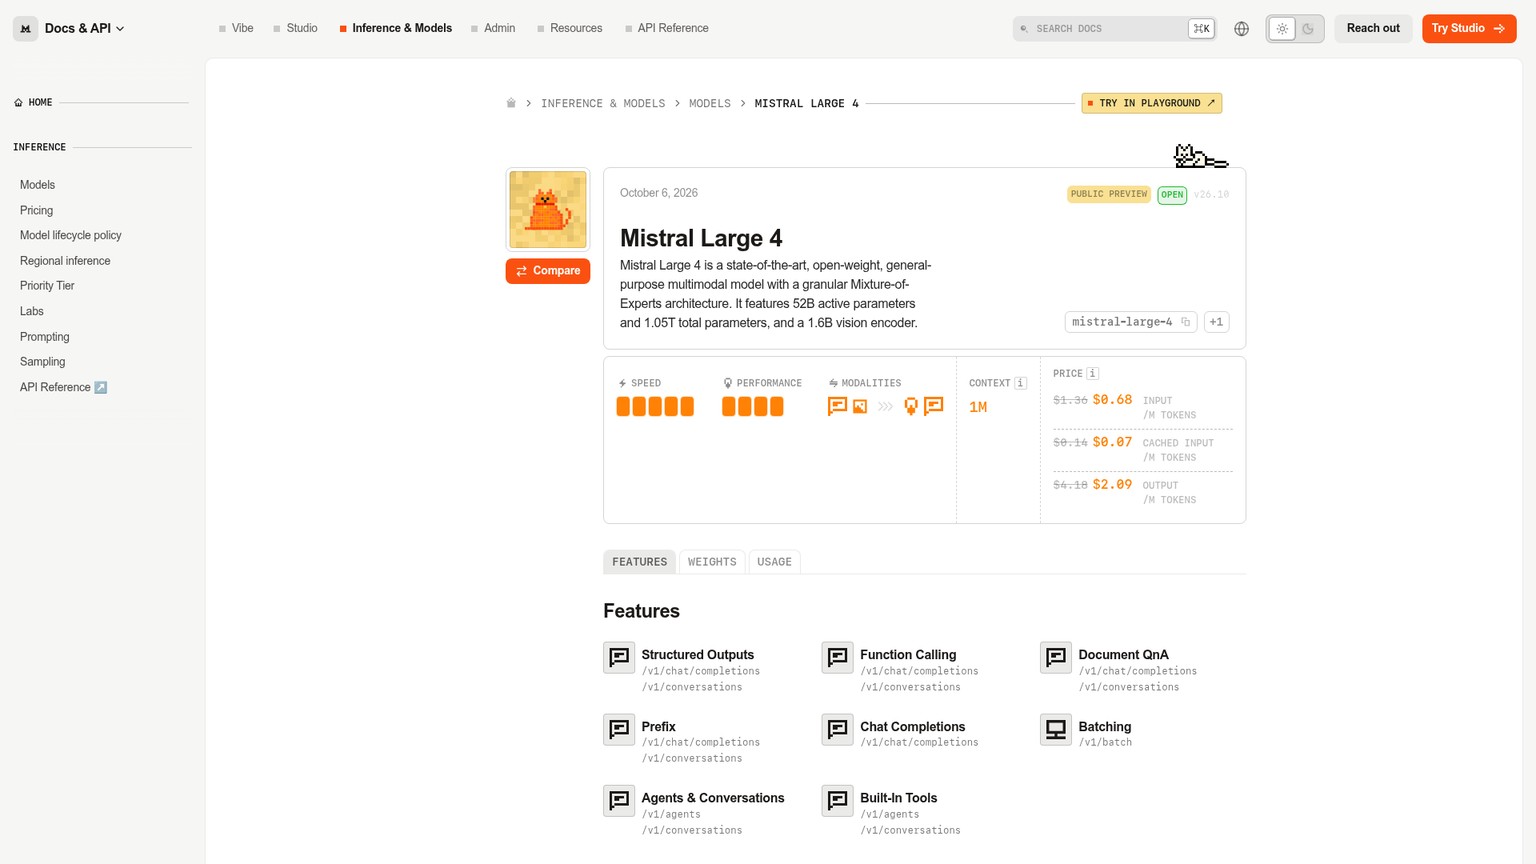
Pour un usage durable, prévoyez $1.36 en entrée et $4.18 en sortie par million de tokens ; réservez le tarif réduit à un pilote éligible à l’offre de lancement. Les tokens sont les unités traitées par le modèle. L’entrée comprend vos instructions et les éléments fournis ; la sortie correspond au contenu généré et facturé par le service. Ces deux catégories ont des prix différents. Un tarif moyen unique peut donc masquer le coût d’un workflow qui génère beaucoup de texte.
L’annonce de Mistral donne les tarifs catalogue. Sa grille Standard actuelle, avec l’inférence régionale désactivée, affiche Large 4 en promotion et barre les tarifs d’origine. Tous les montants indiqués ici sont en dollars américains par million de tokens. Sources : annonce, tarification API.
La même grille indique $0.14 pour l’entrée mise en cache au tarif normal et $0.07 pendant la promotion. Il s’agit de contenus déjà traités, dont la réutilisation est éligible au tarif réduit. Un document envoyé pour la première fois doit rester dans votre estimation des entrées non mises en cache. Source : tarification API.
Combien de temps dure l’offre ? Aucune date de fin précise n’est publiée
Mistral annonce une remise de lancement de 50% pendant deux semaines. Cette durée figure dans son journal des versions ; la fiche du modèle et la grille tarifaire donnent les montants réduits. Les documents publics consultés pour ce guide ne précisent ni la date exacte d’expiration, ni l’heure limite, ni le fuseau horaire. Le tarif affiché dans la console authentifiée n’a pas pu être consulté, car l’écran de tarification exigeait une connexion. Aucune date vérifiée ne permet donc d’indiquer le dernier jour de l’offre : confirmez-le dans votre console avant de planifier des traitements autour de cette promotion.
Pour vos prévisions d’achat, retenez les tarifs d’origine et considérez l’offre comme temporaire. Vous éviterez ainsi qu’un mois d’évaluation peu coûteux conduise à sous-estimer le budget récurrent.
Évitez également d’appliquer à Large 4 l’exemple générique de $0.50 en entrée et $1.50 en sortie affiché sur la page de tarification publique de Mistral. Ces montants correspondent à la ligne Mistral Large 3 dans la grille par version. Le nom d’une famille de modèles ne suffit pas à déterminer le prix de sa version actuelle. Notre guide des tarifs Mistral présente la liste complète des modèles et les différentes formules d’abonnement.
Un mois de revue documentaire revient à $48.10 au tarif catalogue
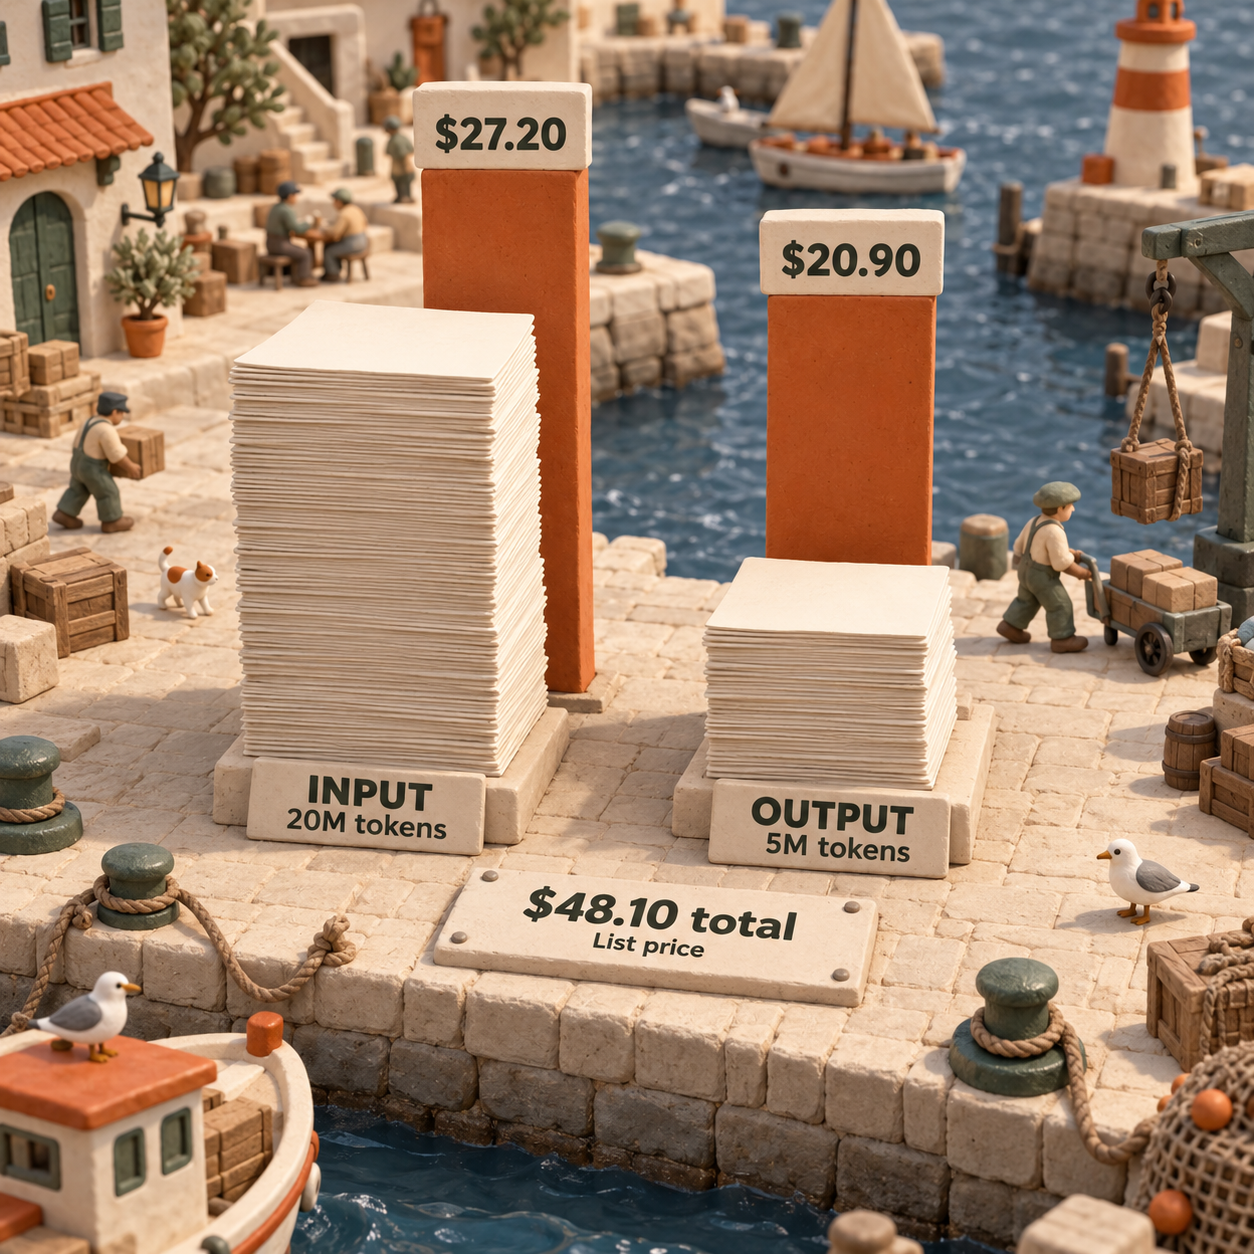
Un volume défini de 1,000 tâches de revue documentaire représente $48.10 de frais de modèle Large 4 au tarif catalogue. Supposons que chaque tâche consomme en moyenne 20,000 tokens d’entrée non mis en cache et 5,000 tokens de sortie facturés, en incluant tous les appels au modèle comptabilisés pour cette tâche. Le mois totalise donc 20 millions de tokens en entrée et 5 millions en sortie. Ce budget d’usage est illustratif : il ne résulte ni d’une conversion du nombre de pages en tokens ni d’un déploiement mesuré.
Le calcul est le suivant :
- Entrée : 20 × $1.36 = $27.20.
- Sortie : 5 × $4.18 = $20.90.
- Total : $27.20 + $20.90 = $48.10.
Pendant l’offre de lancement, ce même volume fixe revient à 20 × $0.68 + 5 × $2.09 = $24.05. Ces estimations excluent les taxes, les crédits, les frais de traitement documentaire et d’utilisation d’outils, ainsi que tout usage supplémentaire du modèle au-delà des totaux de tokens indiqués. Les tarifs viennent de la grille de Mistral ; le calcul est le nôtre.
La sortie ne représente que 20% des tokens de cet exemple, mais environ 43% de la facture au tarif catalogue. Un workflow qui produit de longues analyses ou réécrit un rapport à plusieurs reprises peut faire varier le coût bien plus vite que ne le laisse penser le volume d’entrée. Comptabilisez l’usage renvoyé par le service sur l’ensemble de la tâche, plutôt que de budgéter uniquement le dernier paragraphe visible par l’utilisateur.
Le modèle moins cher fixe le seuil de rentabilité
Mistral Small 4 coûte $6 pour le même volume fixe de tokens, avec ses tarifs affichés de $0.15 en entrée et $0.60 en sortie : 20 × $0.15 + 5 × $0.60. C’est un point de comparaison tarifaire, pas l’affirmation que les deux modèles accomplissent les mêmes tâches aussi bien. Le surcoût mensuel de Large 4 est de $42.10 au tarif catalogue et de $18.05 pendant la promotion. Source : tarifs actuels des modèles.
Si un fondateur valorise en interne le temps de relecture à $60 de l’heure, soit $1 la minute, Large 4 doit faire gagner 42.1 minutes de correction sur le mois pour compenser ce surcoût au tarif catalogue dans notre exemple. C’est ce seuil qu’il faut mesurer. Vous pouvez remplacer l’hypothèse de coût du travail par la vôtre, et la consommation réelle de tokens peut différer d’un modèle à l’autre.
Le raisonnement vaut aussi pour les responsables techniques : un modèle plus grand justifie son utilisation s’il réduit les réponses rejetées, diminue le travail de correction ou satisfait une contrainte de déploiement. Un faible prix par token ne suffit pas à établir un faible coût par résultat accepté. Une remise de lancement ne doit pas non plus dicter l’architecture définitive.
Que permettent vraiment de conclure les benchmarks ?
Les résultats de Mistral justifient d’ajouter le modèle à votre sélection d’évaluation ; ils ne désignent pas le vainqueur pour votre workflow. Un benchmark est un ensemble défini de tâches exécutées dans des conditions particulières. Les scores d’agents de programmation dépendent des outils et des environnements d’exécution, pas seulement de la réponse d’un modèle à un prompt court. L’ancrage visuel mesure la capacité à localiser un élément dans une image. Ces différences déterminent si un résultat est pertinent pour votre application.
Les chiffres suivants sont ceux que Mistral revendique dans son annonce du 6 octobre, y compris les scores qu’il attribue à des dispositifs d’évaluation externes. Ils n’ont pas été produits par ce site, et les pourcentages issus de tests différents ne sont pas interchangeables.
Source de toutes les lignes du tableau : évaluation de lancement de Mistral. Elo est un classement comparatif, pas un pourcentage de tâches correctement accomplies. De même, un score de sécurité ne garantit pas qu’un agent résistera à tous les documents malveillants qu’il rencontrera.
Pour les usages professionnels, Mistral revendique les meilleures performances parmi les modèles ouverts sur le benchmark Legal Agent de Harvey. Il met aussi en avant Vals.ai Finance Agent v2 et FinWorkBench, également appelé Finch, pour la finance et le travail sur tableurs. Il revendique en outre la première place parmi les modèles ouverts sur SciCode-Verified, une évaluation de programmation scientifique. Ces résultats peuvent guider le choix de cas juridiques, financiers ou scientifiques pour un pilote. Ils ne dispensent pas de vérifier chaque réponse à partir des éléments fournis. Source : évaluations par domaine de Mistral.
Un regard indépendant : Artificial Analysis, le 6 octobre 2026
Artificial Analysis a publié sa propre évaluation le 6 octobre 2026, avec un score de 38 à son Intelligence Index et de 50 à son Cyber Index pour Mistral Large 4 Preview. L’organisme a calculé un coût de $1.13 par tâche de l’Intelligence Index au tarif standard, ramené à $0.57 avec la remise de lancement. Il s’agit des coûts mesurés sur les tâches de cet évaluateur, pas du prix d’un document client ou d’un appel API. Source : rapport daté d’Artificial Analysis.
Ce résultat indépendant conforte l’intérêt d’évaluer le modèle pour des usages spécialisés. Son constat sur le coût par tâche invite aussi à mesurer la consommation en sortie. Il ne justifie pas, à lui seul, une migration. Ce site ne propose ici aucun classement issu de ses propres tests face à GPT-6 ou Claude : la décision qui suit repose sur les conditions de déploiement vérifiées, les tarifs annoncés et les critères d’acceptation que vous pouvez appliquer à votre travail.
Faut-il tester Mistral Large 4 ce mois-ci ?
Testez Large 4 lorsqu’un échec précis de votre solution actuelle justifie de payer davantage pour un résultat accepté. Gardez les solutions économiques qui donnent déjà satisfaction. Créateurs de produits, responsables opérationnels et acheteurs en entreprise ont ainsi des raisons différentes d’agir face à la même sortie.
Créateurs de produits : réservez-le aux cas difficiles
Un fondateur disposant de financements devrait commencer par un pilote sur un workflow difficile, avant de changer de modèle par défaut. Un assistant documentaire peut, par exemple, extraire des champs ordinaires à faible coût tout en peinant lorsque les éléments utiles sont répartis entre graphiques, notes de bas de page et pièces contradictoires. Évaluez ce sous-ensemble et mesurez si Large 4 réduit les corrections. Ses capacités multimodales et d’utilisation d’outils annoncées rendent le test pertinent ; seuls vos résultats d’acceptation déterminent ensuite où l’utiliser.
Un développeur indépendant dont le modèle actuel produit déjà des classifications acceptables a peu de raisons de changer. Conservez le modèle plus petit et gardez Large 4 comme candidat pour une tâche qui le met en échec. Pour explorer d’autres modèles destinés aux agents, le guide des modèles compacts pour la programmation offre un point de départ plus ciblé que le remplacement de tous les appels par un nouveau modèle phare.
Responsables opérationnels : priorité à la sécurité et aux documents complexes
Un responsable sécurité a une raison concrète de tester des tâches défensives autorisées. Mistral cite l’analyse de logiciels malveillants, la priorisation des vulnérabilités et la rédaction de règles de détection, ainsi que la reproduction de vulnérabilités et leur correction. Un pilote utile vérifie si le correctif proposé traite le problème fourni et si la règle de détection obtenue correspond aux éléments disponibles. Définissez explicitement les actions autorisées et examinez les résultats avant toute modification des systèmes opérationnels. Source : section cybersécurité de Mistral.
Un responsable des opérations juridiques peut partir d’un corpus approuvé et évaluer si la réponse identifie le passage déterminant, préserve les exceptions et distingue les preuves des déductions. Pour un responsable financier, il faut vérifier que la réponse utilise la bonne période, reproduit le calcul et rattache chaque donnée d’entrée au document source. Une note soignée qui cite la mauvaise clause ou la mauvaise période reste un travail rejeté, quel que soit le benchmark du modèle.
Mistral cite également les plans techniques, l’industrie manufacturière, l’imagerie géospatiale et la programmation scientifique. Ces usages exigent des évaluations distinctes : reconnaître un composant sur un plan, repérer un objet sur une image satellite et implémenter une routine scientifique ne se jugent pas selon les mêmes critères. Cette sortie en fait des pistes à tester ; elle ne prouve pas qu’un score général soit transposable à ces trois tâches. Source : présentation détaillée des capacités par Mistral.
Acheteurs en entreprise : quelle garantie de traitement dans l’UE achetez-vous ?
Les exigences de localisation des données dans l’UE justifient d’examiner Mistral, puis de vérifier le périmètre exact du service. Mistral indique que la preview publique fonctionne sur sa propre infrastructure de datacenters européens. Sa documentation générale sur l’inférence régionale précise, séparément, que l’endpoint global ne garantit pas un lieu de traitement particulier. Il ne faut pas transformer ces deux affirmations en garantie universelle pour toutes les requêtes Mistral. Sources : infrastructure de la preview, inférence régionale.
L’endpoint régional est api.eu.mistral.ai. Vérifiez que le modèle requis y est effectivement disponible, car la disponibilité varie selon les régions. Le tableau régional mentionne des datacenters dans des pays de l’UE et de l’EFTA, l’Association européenne de libre-échange, qui est distincte de l’UE. Une exigence de traitement strictement limitée à l’UE impose donc de confirmer les lieux autorisés. Mistral affiche une majoration de 10% sur les tarifs catalogue standard pour l’inférence régionale ; ne présumez pas qu’elle se cumule avec la promotion de lancement sans faire confirmer le tarif applicable. Mistral précise aussi que les endpoints régionaux ne proposent ni Agents, ni Batch, ni l’API Files, et que les appels de fonctions sont le seul outil régional pris en charge. Source : fonctionnalités et tarifs régionaux.
Ce point compte pour un CTO qui prépare un agent documentaire : la liste de fonctionnalités de la fiche globale ne prouve pas que le même workflow géré soit disponible via l’endpoint régional. La localisation du traitement des requêtes et des réponses ne régionalise pas non plus tous les enregistrements de compte, de facturation ou d’usage, et elle reste distincte de l’absence de conservation des données. Vérifiez les dépendances de traitement, de stockage et d’outils propres à votre système avant d’y transférer des données réglementées.
Que changera la disponibilité des poids ?
Les poids apporteraient davantage de contrôle sur le déploiement, mais imposeraient aussi un nouveau choix d’infrastructure et de coûts d’exploitation. Des poids ouverts sont les fichiers numériques téléchargeables du modèle. Sous réserve de la licence effective et des logiciels pris en charge, ils peuvent permettre d’exécuter l’inférence selon vos propres règles, au lieu de dépendre entièrement d’un endpoint hébergé. Mistral maintient son objectif de publication pour la fin octobre 2026 ; l’annonce ne promet aucun jour précis. Source : calendrier de publication.
Pour un acheteur en entreprise, l’intérêt est de pouvoir choisir l’environnement d’exécution, les limites d’accès et les procédures d’exploitation. Ce contrôle peut être déterminant lorsqu’un changement de politique ou de disponibilité d’un service hébergé risquerait d’interrompre un workflow critique. En contrepartie, la capacité, les mises à jour, la supervision et la reprise après incident relèvent davantage de l’opérateur du déploiement.
49B de paramètres actifs ne signifie pas un téléchargement ou un besoin mémoire dimensionné pour 49B. Les paramètres actifs décrivent les calculs sélectionnés pour un token. L’ensemble des poids doit néanmoins être stocké et accessible au système d’inférence. Le format des poids, les environnements d’exécution pris en charge, la configuration matérielle et les besoins de concurrence détermineront les exigences réelles de l’auto-hébergement. Les chiffres de lancement ne permettent pas de déduire une recommandation matérielle précise ou un tarif d’hébergement.
Pour la comparaison future, rapportez le coût d’infrastructure au nombre de tâches réussies, puis ajoutez le travail d’exploitation et la valeur du contrôle requis. Un déploiement peu sollicité peut supporter le coût d’une capacité inutilisée ; un déploiement très sollicité peut répartir ce coût sur davantage de tâches. Aucun de ces cas ne suffit à établir que l’auto-hébergement coûtera moins cher que l’API.
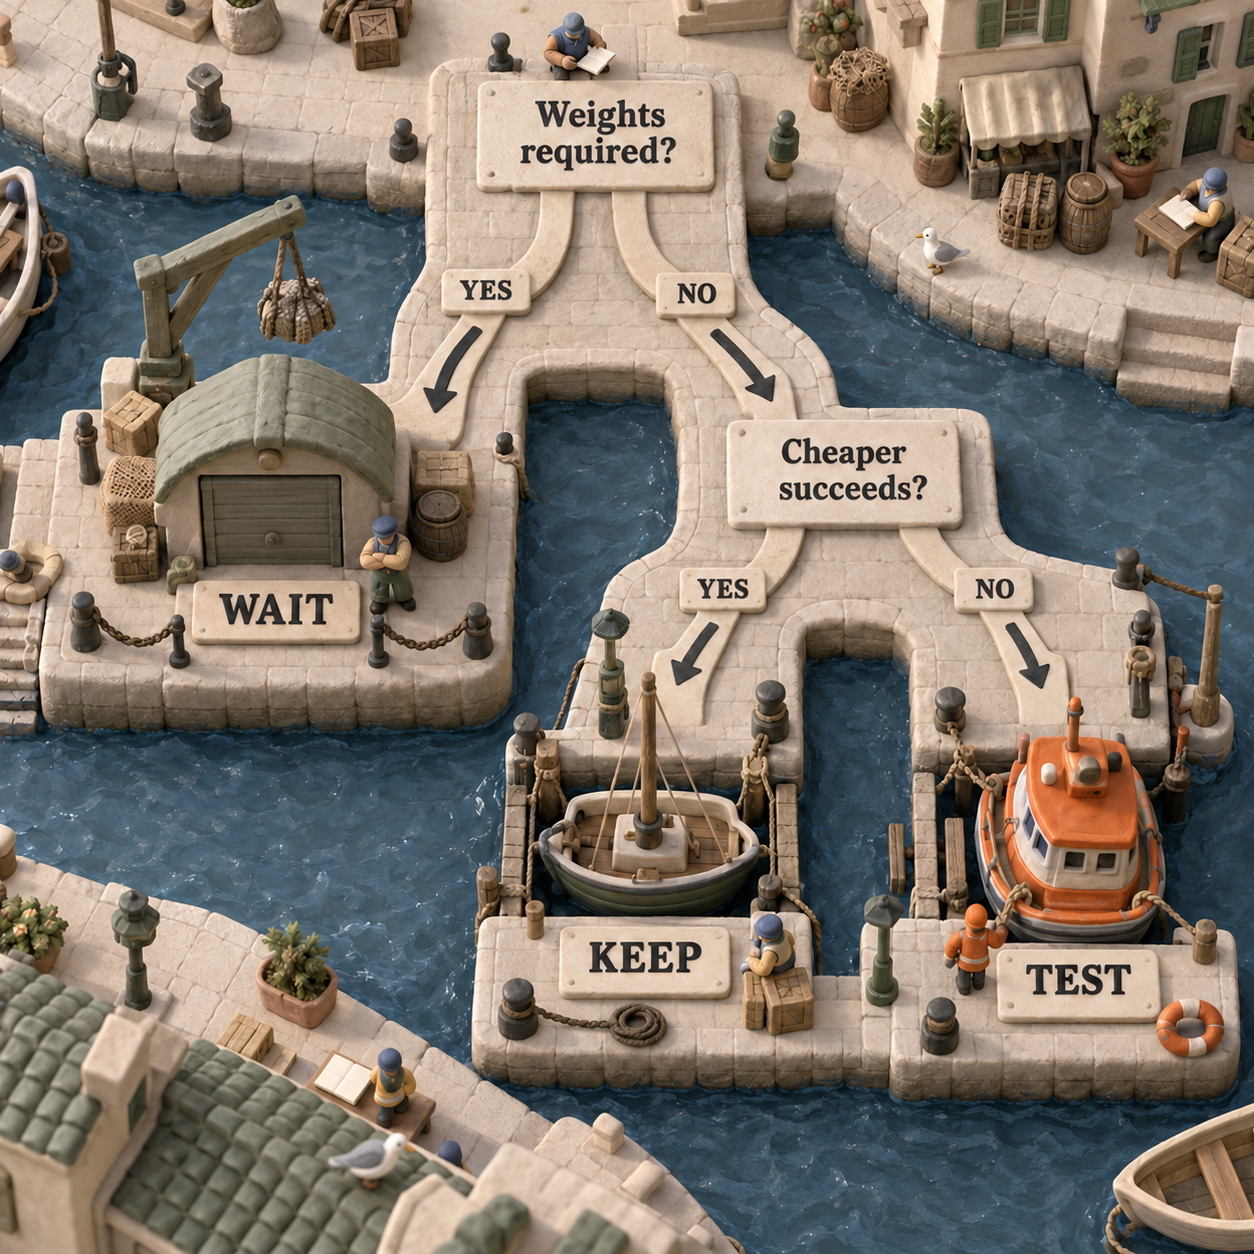
Si des poids téléchargeables sont obligatoires pour l’achat, attendez les fichiers, leur licence et un déploiement que vous pourrez valider. Vous pouvez dès maintenant préparer le jeu d’évaluation et le périmètre d’intégration. La preview hébergée permet d’évaluer les capacités uniquement si votre politique de données en autorise l’usage ; une promesse ne suffit pas à satisfaire une exigence d’hébergement sur site.
Où les promesses vont-elles trop loin ?
L’exagération consiste à confondre trois étapes distinctes : l’accès à la preview, la future publication des poids et un déploiement en production. Chacune répond à une question différente. L’API actuelle permet d’évaluer la preview. Les poids promis pourraient ouvrir un autre mode d’exploitation. Il faudra encore vérifier qu’un système peut être déployé, dispose d’une licence adaptée et peut être maintenu.
La mention de poids ouverts ne garantit ni une licence open source particulière ni des droits commerciaux sans restriction. Consultez les conditions fournies avec la version effective de Large 4, plutôt que de reprendre la licence d’un ancien modèle Mistral.
Les graphiques de benchmarks ne prouvent pas non plus une supériorité universelle. Les refus liés à la sécurité, l’accès aux outils, les environnements d’exécution et la définition des tâches peuvent influer sur les scores. Un benchmark juridique ne certifie pas un conseil juridique ; un benchmark sur tableurs ne garantit pas que votre workflow de reporting conserve les bons justificatifs. Servez-vous du résultat pertinent pour choisir un test, puis évaluez le livrable dont vous avez besoin.
L’accès élargi aux capacités de cybersécurité a lui aussi un périmètre précis. Mistral indique que les responsables de la cybersécurité, les partenaires agréés et les autorités étatiques bénéficient d’une modération réduite et de capacités cyber étendues pendant les exercices de red teaming. Cela ne promet pas le même accès à tous les clients de la preview publique. Évaluez les autorisations et le comportement réellement disponibles pour votre compte. Source : description de l’accès à la preview.
Enfin, le tarif promotionnel peut donner au pilote une apparence moins coûteuse que l’usage durable. Une économie temporaire sur le modèle renseigne peu sur l’effort de migration, le temps de relecture ou l’économie d’un futur auto-hébergement. Fondez ces décisions sur les tarifs permanents et sur le périmètre réel d’exploitation.
Par où commencer ? Un pilote au périmètre défini
La semaine prochaine, un responsable technique devrait envoyer un petit jeu d’évaluation approuvé à mistral-large-4-0, tout en conservant le trafic de production sur la solution actuelle qui donne satisfaction. Un acheteur en entreprise qui exige les poids devrait préparer les mêmes cas, puis attendre que les fichiers et leurs conditions soient disponibles avant d’approuver un déploiement auto-hébergé.
Choisir des cas représentatifs et définir les critères d’acceptation
Un point de départ suggéré est un jeu de 50 cas représentatifs, comprenant des exemples difficiles sur lesquels votre solution actuelle se trompe. C’est une taille pratique pour un pilote, pas une garantie statistique. Définissez ce qui constitue une réponse correcte, les justificatifs requis et les actions autorisées avant de voir les résultats. Pour les tâches juridiques et financières, confiez à une personne qualifiée l’évaluation de l’appui sur les sources et des calculs.
Utiliser la version précise du modèle et l’endpoint autorisé
Essayez la preview hébergée dans Mistral Studio, ou appelez l’API de chat completions documentée avec
mistral-large-4-0. Gardez les éléments fournis et le budget d’utilisation des outils identiques entre les modèles candidats. Si la localisation est une exigence, vérifiez d’abord la disponibilité régionale du modèle et des fonctionnalités.Mesurer le travail accepté et prévoir la facture récurrente
Relevez les résultats acceptés, les corrections, le total des tokens d’entrée et de sortie facturés, la latence, l’usage des outils et le temps de relecture. Appliquez les tarifs catalogue à la prévision. Ne retenez ce modèle pour le workflow que si le gain compense son surcoût ou apporte une capacité ou un contrôle requis. Revérifiez le modèle, la licence et le coût d’exploitation lorsque les poids seront effectivement publiés.
Pour un test élémentaire de l’endpoint global, avec votre propre clé API Mistral déjà définie dans MISTRAL_API_KEY, la requête de chat completions documentée est la suivante :
curl https://api.mistral.ai/v1/chat/completions \
  -H "Authorization: Bearer $MISTRAL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistral-large-4-0",
    "messages": [
      {"role": "user", "content": "Explain the difference between input and output tokens in two sentences."}
    ]
  }'
Ce test vérifie la connectivité et la sélection du modèle, pas la qualité documentaire ni la conformité régionale. La décision d’adoption repose sur le workflow approuvé et ses résultats acceptés.
Retrouvez des conseils pratiques pour choisir vos modèles et vos workflows dans la newsletter.
- Dernière mise à jour
- 7 oct. 2026
- Catégorie
- AI
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
Agent IA Lindy : avis, tarifs et limites en octobre 2026
Notre avis sur Lindy AI : tarifs en USD, coût des crédits, gestion des e-mails et des réunions, limites des intégrations et alternatives adaptées.7 oct. 2026AI
Mistral pricing : quel budget pour l’API et Vibe en 2026 ?
Prix de l’API Mistral, abonnements Vibe, limites gratuites et hébergement UE : comparez les offres et calculez votre facture mensuelle en dollars.6 oct. 2026AI
Claude Skills : construisez votre workflow de reporting client
Créez un skill Claude pour vos rapports clients hebdomadaires : calculs en Python, validation des données, installation et partage dans l’équipe.6 oct. 2026AI
Agent IA en entreprise : missions, tarifs et premiers pas
Comparez les missions et les prix des agents IA pour votre entreprise. Choisissez un rôle, gardez une validation humaine et mesurez un test de 30 jours.6 oct. 2026AI
Superwhisper et les alternatives à Wispr Flow : que choisir en 2026 ?
Superwhisper, VoiceOS, Aqua Voice, Willow ou Monologue : comparez les alternatives à Wispr Flow selon les tarifs, le hors ligne et les besoins d’équipe.5 oct. 2026AI
Agent IA : 13 usages concrets et leurs coûts pour les petites entreprises
Support, appels, prospection, recherche ou code : découvrez 13 usages d’agents IA en petite entreprise, leurs tarifs et les points à faire valider.5 oct. 2026AI
Claude API pricing : quel budget prévoir pour votre application ?
Tarifs de l’API Claude, cache, batch et outils en octobre 2026 : trois budgets d’applications et un comparatif avec Claude Pro et Max pour l’usage personnel.4 oct. 2026AI