Revue de code : quels outils IA choisir pour une petite équipe en 2026 ?
Comparez les outils IA de revue de code : prix pour cinq développeurs, faux positifs, GitHub, GitLab, conservation des données et une PR revue par trois bots.



Pour la revue de code avec l’IA dans une petite équipe, commencez par CodeRabbit Essentials à $150 par mois pour cinq développeurs. Autre point de départ : les abonnements Codex ou Claude Code dont votre équipe dispose déjà, pour relire les changements avant d’ouvrir une PR. Greptile, Cursor Bugbot et la revue gérée de Claude ont leur place si leur workflow et leur facturation à l’usage conviennent ; Codex Security répond à un besoin de sécurité distinct.
Prix et noms des offres vérifiés sur les pages des éditeurs le 2 octobre 2026. Les budgets ci-dessous reposent sur cinq développeurs humains actifs, des prix en dollars américains hors taxes, sans remise promotionnelle, et une facturation mensuelle, sauf mention explicite d’un équivalent annuel. Les exemples d’usage supposent 100 exécutions de revue terminées par mois, réparties à parts égales entre les développeurs. Ce sont des hypothèses budgétaires, pas une moyenne annoncée du secteur.
Revue de code : les outils IA pour petites équipes en un coup d’œil
CodeRabbit est le bot de PR payant à privilégier pour une petite équipe qui veut des revues régulières dans son workflow de pull requests actuel. Si l’équipe demande déjà systématiquement une revue avant de pousser son code, mieux vaut commencer par son abonnement à un agent de développement. Cette différence pèse davantage dans le choix qu’un classement issu des benchmarks d’un éditeur.
L’abonnement achète un accès ou un quota. Il ne couvre pas nécessairement toutes les revues que votre équipe peut déclencher. Une PR relue à l’ouverture, après une correction puis après un rebase peut générer plusieurs exécutions facturables. Le budget pour cinq sièges varie aussi si seuls certains développeurs sont des auteurs actifs, si les agents consomment un quota partagé ou si l’équipe achète des crédits supplémentaires.
La règle d’achat : payez un outil de revue automatique dédié quand votre processus échoue parce que les revues manuelles ne sont pas demandées. Réutilisez un agent si les revues ont déjà lieu régulièrement et que vous voulez un contrôle supplémentaire du bon fonctionnement. Ajoutez un outil de sécurité lorsque la question porte sur ce qu’un attaquant peut atteindre et exploiter.
À quel moment l’IA intervient-elle dans la revue de code ?
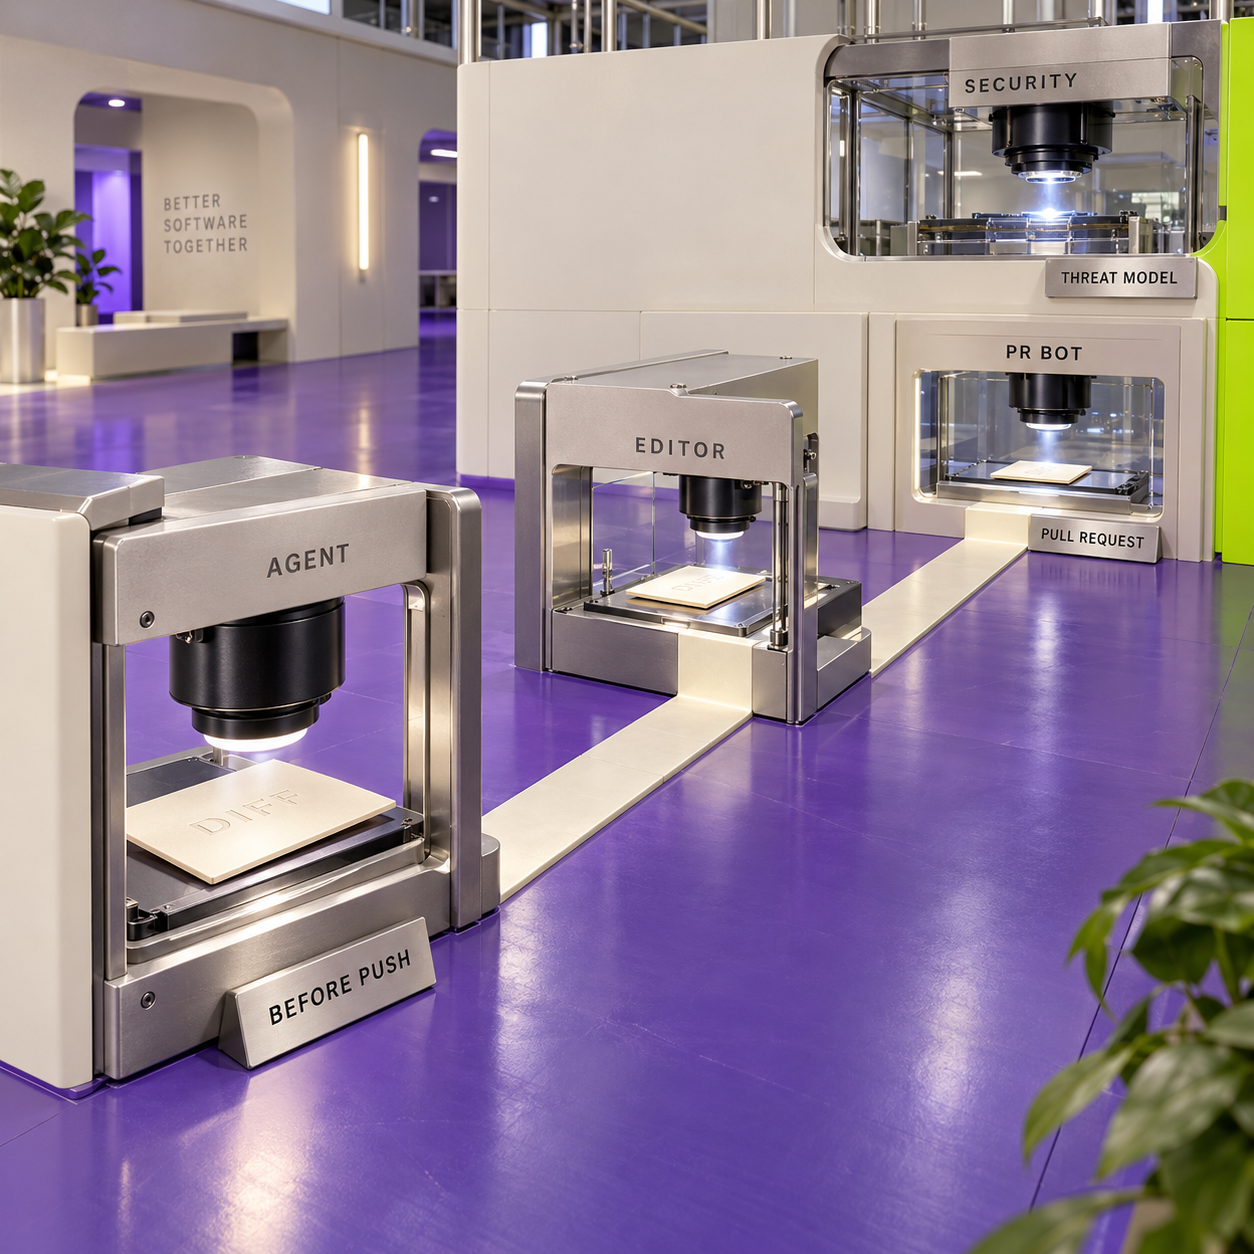
L’endroit où se déroule la revue détermine qui voit le problème, quand l’auteur peut le corriger et si l’équipe peut compter sur cette étape.
Un bot de PR, comme CodeRabbit ou Greptile, surveille un dépôt connecté et publie ses constats dans la pull request. La revue a ainsi lieu là où l’équipe décide déjà de fusionner le code. L’auteur n’a pas à se souvenir d’une commande à lancer dans le terminal.
Un outil de revue proposé par un éditeur de code, comme Cursor Bugbot, relie la revue au workflow de développement et de correction. Bugbot examine aussi les PR hébergées ; tous les contributeurs n’ont donc pas besoin d’écrire leur code dans Cursor. Son intérêt tient au passage entre l’examen d’un changement et sa prise en charge par un agent pour le corriger.
Un agent de développement chargé de la revue peut examiner une branche ou un diff avant la création d’une PR. Codex propose aussi une revue cloud sur des dépôts connectés. Claude Code dispose à la fois d’une commande de revue locale et d’un service GitHub géré, facturé séparément. Le budget et la conservation des données doivent être évalués pour chaque voie.
Un outil de revue de sécurité examine le modèle de menace : ce qu’un attaquant peut contrôler, les frontières que le code franchit et la possibilité qu’un chemin suspect produise une vulnérabilité réelle. Codex Security complète la revue générale avec cet objectif plus ciblé.
Un dépôt récupéré en local ne signifie pas que l’inférence du modèle est locale. Claude Code et Codex peuvent exécuter des commandes sur votre machine tout en envoyant les prompts et le code pertinent à leur service de modèles. De même, supprimer un conteneur cloud ne supprime pas nécessairement le rapport de revue produit.
Bots de PR : CodeRabbit et Greptile
CodeRabbit : le premier choix pour automatiser les revues
CodeRabbit est un outil de revue IA connecté au dépôt, qui publie des synthèses et des commentaires ligne par ligne dans les PR. Choisissez-le si les changements ordinaires arrivent trop souvent en revue humaine sans un premier contrôle systématique. Sa configuration permet de limiter les retours, et ses offres payantes donnent un budget de départ simple à calculer par siège. Attendez de pouvoir nommer la fonctionnalité ou la limite d’usage qui justifie une montée en gamme.
Verdict : CodeRabbit Essentials est le premier bot dédié à essayer pour une équipe de cinq personnes. Son coût de $150 par mois pour les sièges est lisible, à condition que vos pics de revue restent dans les limites de l’offre.
Pour qui : Les petites équipes qui veulent des retours automatiques sur leurs changements courants dans GitHub ou GitLab.
Point fort : Les profils de revue, les instructions par chemin et le contexte enrichi par les retours dans le workflow de PR.
Tarifs : Essentials $30, Team $60, Advanced $90 par développeur et par mois ; Enterprise sur devis.
Essai gratuit : 14 jours. Les fonctionnalités gratuites pour les dépôts privés sont plus limitées que la revue payante des PR.
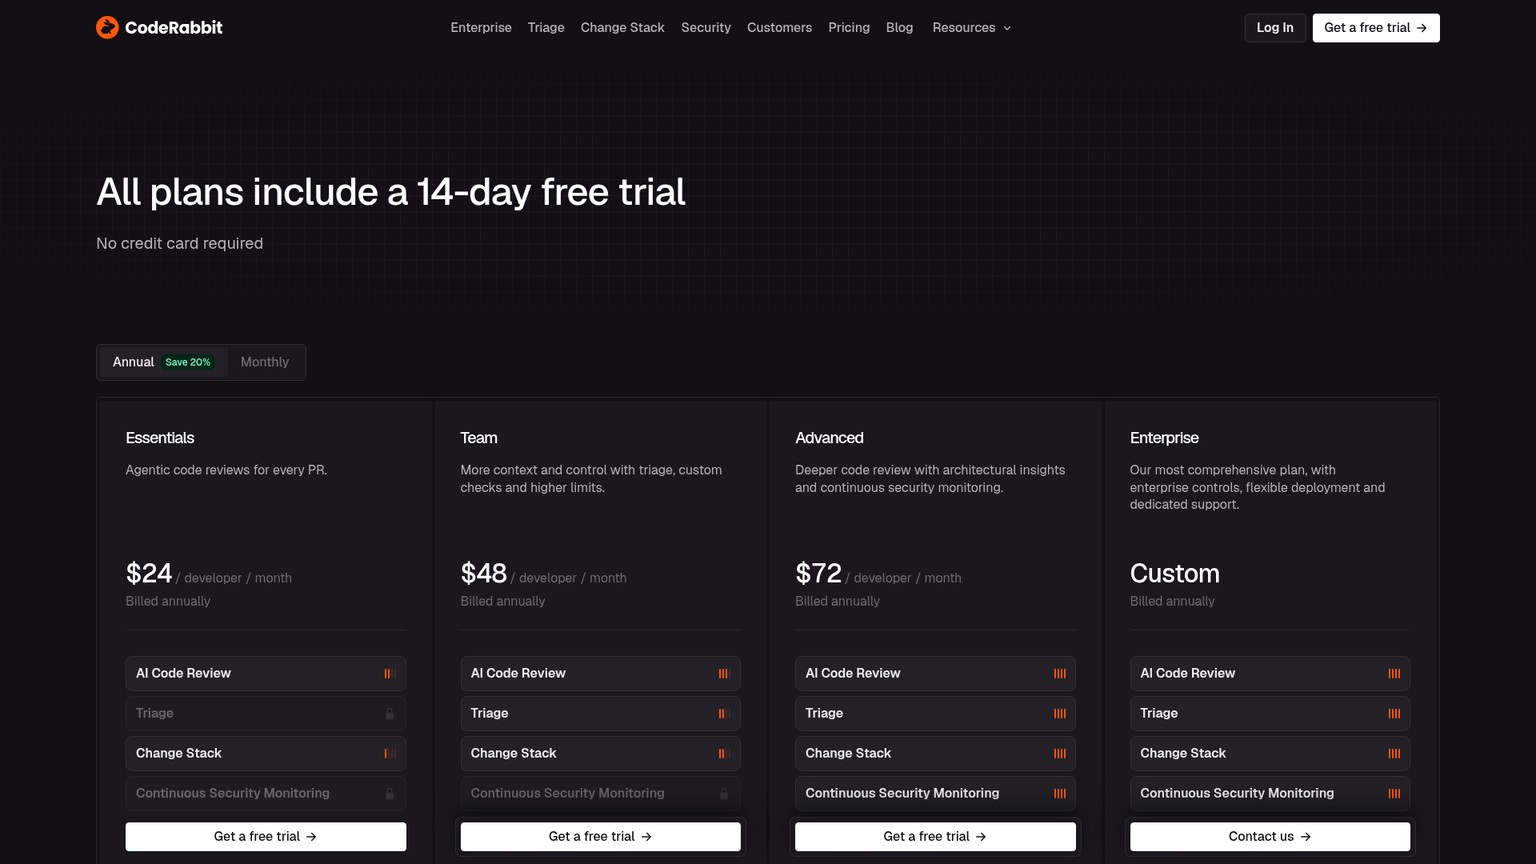
Les offres et leur coût pour cinq développeurs
Les offres actuelles sont Free, Essentials, Team, Advanced et Enterprise. Avec une facturation annuelle, les tarifs payants affichés passent à $24, $48 et $72 par développeur et par mois. Pour cinq développeurs, cela représente donc des équivalents de $120, $240 et $360 par mois, avec des engagements annuels respectifs de $1,440, $2,880 et $4,320. En facturation mensuelle, la même équipe paie $150, $300 ou $450. Enterprise nécessite un devis. Ces montants proviennent de la page tarifaire et de la documentation officielle des offres.
Free fournit des synthèses de PR privées, plutôt que le service complet de revue payante de ces PR. CodeRabbit propose aussi des quotas gratuits de revue locale et des revues gratuites pour le travail open source public. Un CTO qui veut des signalements automatiques sur du code privé doit prévoir une offre payante : une synthèse ne vaut pas une revue du bon fonctionnement.
Essentials est le point de départ raisonnable. Team ajoute notamment un contexte plus étendu entre plusieurs dépôts et des contrôles personnalisés ; Advanced apporte des fonctionnalités de sécurité et d’architecture plus poussées. Achetez-les pour un besoin identifié. Le seul fait d’avoir cinq développeurs n’impose pas l’offre nommée Team.
Faux positifs : comment ajuster les retours
Commencez par le profil quiet si l’équipe ne veut que des retours sur les problèmes qui comptent. Le profil chill, utilisé par défaut, est équilibré ; assertive produit volontairement davantage de commentaires et peut sembler tatillon. Ce sont des réglages de comportement documentés, pas des garanties de précision mesurées. Utilisez les filtres de chemins pour exclure les fichiers générés, et les instructions par chemin pour décrire les invariants réels du code sensible. Ces réglages se trouvent dans .coderabbit.yaml ou dans le tableau de bord. Référence de configuration.
Pour un service de facturation, une consigne utile précise qu’une nouvelle tentative ne doit pas débiter deux fois et qu’un remboursement doit conserver sa piste d’audit. « Soyez rigoureux » aide moins l’outil de revue. Demandez des éléments qui montrent la ligne modifiée, l’appelant qui peut l’atteindre et la condition d’échec. Laissez à la CI les règles de formatage déjà imposées par votre linter.
Si un commentaire est faux, expliquez la condition qui protège le code plutôt que de répondre seulement que le bot se trompe. S’il signale un compromis réel mais volontairement accepté, consignez le périmètre de cette exception. Une consigne générale qui demande d’ignorer toute une catégorie de bugs peut faire taire le prochain défaut réel.
GitHub, GitLab et conservation des données
CodeRabbit documente des intégrations directes avec GitHub.com, GitHub Enterprise Server, GitLab.com et GitLab auto-hébergé. Connecter une forge auto-hébergée est différent d’exécuter l’outil de revue sur votre propre infrastructure. Son option d’auto-hébergement Enterprise est documentée pour 500 sièges ou plus : ce n’est donc pas le choix habituel d’une équipe de cinq personnes. Plateformes prises en charge.
Le cache réutilisable du dépôt et de ses dépendances est activé par défaut et expire au bout de sept jours au maximum. Il accélère les revues et ne sert pas à l’entraînement ; les données en cache sont chiffrées, sauf pour les projets open source. Définissez reviews.disable_cache sur true pour le désactiver. Cette règle de sept jours concerne le cache du dépôt préparé. La politique de confidentialité décrit séparément les embeddings vectoriels utilisés pour personnaliser les revues et une option de refus du stockage, sans délai de suppression publié qui couvre tous les artefacts. Documentation du cache.
Les commentaires de revue restent aussi dans GitHub ou GitLab selon les politiques de votre forge. Lorsque vous rédigez une règle interne de conservation, traitez séparément le cache du code source, le contexte appris et les commentaires publiés.
- Les revues automatiques s’intègrent à la discussion de PR que l’équipe utilise déjà.
- Les profils quiet, équilibré et assertive rendent la politique de retours explicite.
- Les instructions par chemin permettent de décrire des risques différents selon les parties du dépôt.
- GitHub et GitLab font partie des intégrations documentées.
- Les synthèses gratuites de PR privées ne remplacent pas la revue payante du bon fonctionnement.
- Les limites horaires et le nombre de fichiers restent à surveiller malgré l’absence de plafond mensuel de PR.
- L’expiration du cache du dépôt ne définit pas la durée de vie de tout le contexte appris.
Connectez un dépôt représentatif de votre travail
Installez CodeRabbit sur un dépôt actif habituel, en limitant l’accès aux dépôts que vous souhaitez faire examiner. Commencez par Essentials, sauf si un besoin documenté impose une autre offre.
Donnez-lui des consignes de revue courtes
Choisissez quiet, excluez les fichiers générés et décrivez les invariants dans les chemins à risque. Demandez une condition d’échec concrète et évitez de répéter les règles du linter.
Classez les constats avant d’étendre la couverture
Demandez à l’équipe de classer les commentaires : utiles, faux, déjà couverts, ou exacts mais trop mineurs. Pendant le pilote, gardez les retours automatiques à titre consultatif et examinez les pics d’usage horaires autant que la facture.
Greptile : pour une revue adaptée au contexte du dépôt
Greptile est un outil de revue IA des PR qui exploite le contexte du dépôt, avec des règles de revue, des réglages par répertoire et un apprentissage fondé sur les retours. C’est une alternative solide si l’équipe veut adapter le comportement de revue à son code et accepte de gérer l’usage par auteur. Le piège à l’achat consiste à croire qu’un siège à $30 donne droit à un nombre illimité de revues au même coût.
Verdict : Greptile est une alternative crédible à CodeRabbit. Choisissez toutefois le niveau d’effort et le plafond de flex usage avant de l’activer à chaque push.
Pour qui : Les équipes qui veulent des standards propres au dépôt et un contrôle précis sur les commentaires publiés.
Point fort : Des réglages distincts pour l’effort de revue, les catégories de commentaires, l’importance et le comportement par répertoire.
Tarifs : Starter gratuit pour un développeur actif ; Pro $30 par développeur actif et par mois, plus les crédits supplémentaires ; Enterprise sur devis.
Essai gratuit : 14 jours ; les projets open source non commerciaux éligibles peuvent demander un accès gratuit.
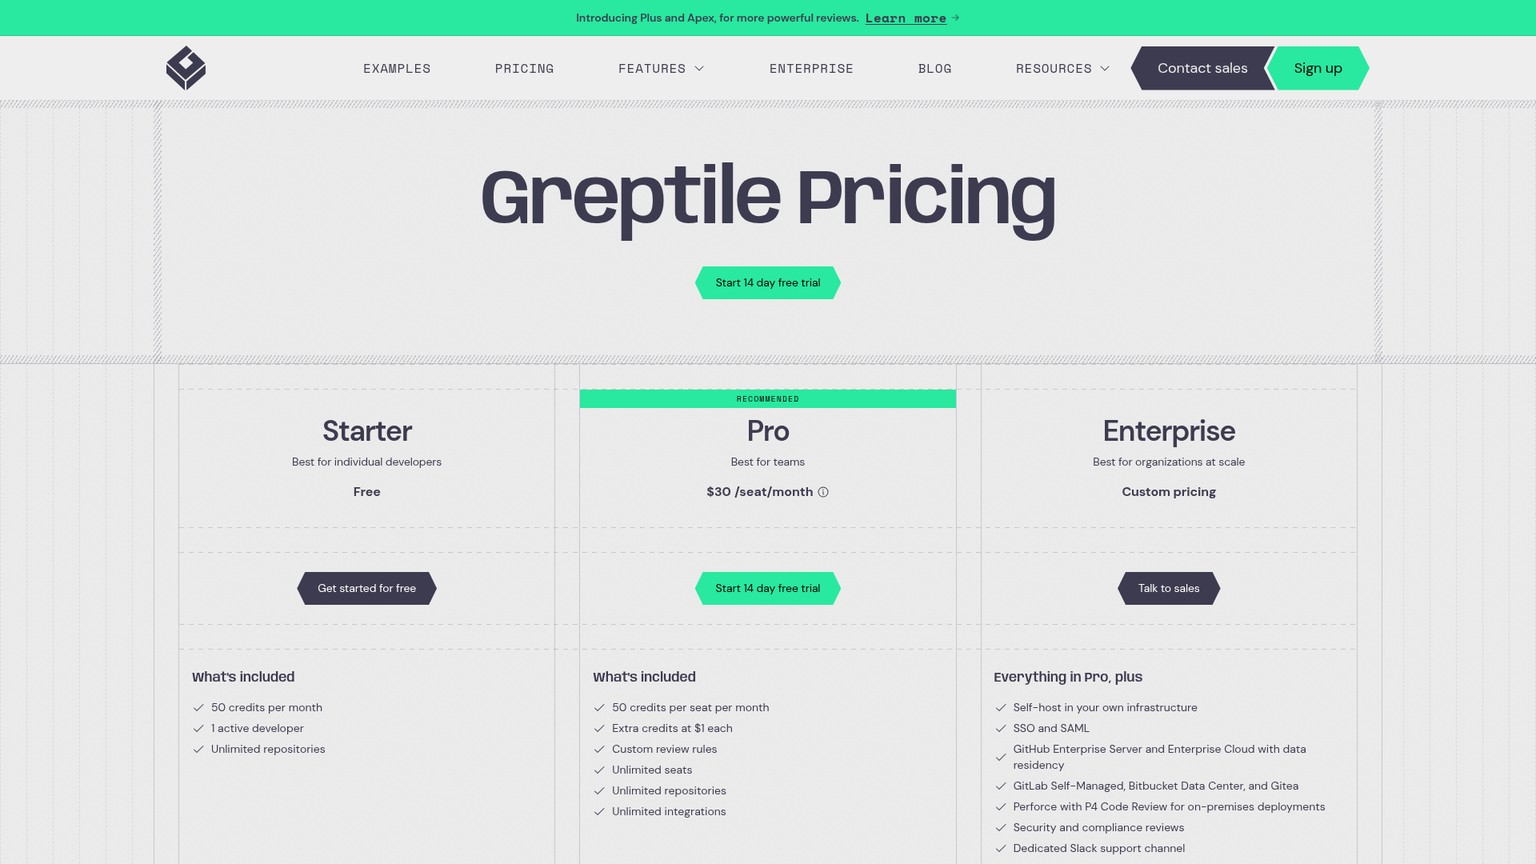
Les offres et leur coût pour cinq développeurs
Starter comprend un développeur actif, un nombre illimité de dépôts et 50 crédits mensuels. Pro inclut 50 crédits par développeur actif, puis facture chaque crédit supplémentaire $1. Enterprise propose des tarifs personnalisés et des options comme l’auto-hébergement, le SSO et les intégrations avec des forges auto-hébergées. Les remises annuelles et pluriannuelles se négocient : aucun tarif annuel unique n’est publié. Tarifs en ligne.
Les niveaux d’effort sont Base à 1 crédit, Plus à 3 et Apex à 10. Auto choisit un niveau pour chaque PR : son coût par revue n’est donc pas fixe. Il s’agit d’unités de travail et de facturation, pas de preuves qu’une revue plus chère aurait un taux de faux positifs inférieur.
Un développeur actif est un auteur auquel une revue terminée a été facturée pendant la période de facturation. Les revues sont imputées à l’auteur de la PR, et les crédits inclus non utilisés ne sont pas mutualisés entre les membres de l’équipe. La facturation compte les revues terminées, y compris les nouvelles exécutions après les événements configurés, et non les PR uniques. La personne qui clique pour déclencher la revue ne récupère pas la facture à son nom. Documentation de facturation.
Par exemple, un auteur qui reçoit 70 revues Base dépasse son quota de 20 crédits. Un autre auteur qui n’en reçoit que 10 ne peut pas lui prêter ses crédits inutilisés. Fixez la Flex Usage Limit de l’organisation au montant supplémentaire que vous acceptez ; une valeur de $0 désactive les revues en flex usage. Les auteurs qui restent dans leur quota inclus peuvent continuer à recevoir des revues après que ce plafond a été atteint.
Faux positifs : comment ajuster les retours
Utilisez strictness pour choisir les constats publiés : 1 donne des retours détaillés, 2 est le réglage équilibré par défaut, et 3 ne conserve que les constats critiques. Utilisez commentTypes pour sélectionner les retours sur la logique, la syntaxe ou le style. Si l’équipe impose déjà le formatage dans la CI, commencer par la logique et la syntaxe élimine une source évidente de doublons. La configuration recommandée dans .greptile/ permet des réglages propres à chaque répertoire ; l’ancienne configuration à la racine dans greptile.json reste disponible. Réglages du bruit.
Strictness et effort répondent à des problèmes différents. Augmenter strictness réduit les commentaires publiés. Passer de Base à Apex change le travail effectué et les crédits consommés. Une facture plus élevée ne remplace pas une définition claire de ce qui mérite une action.
Votez positivement pour les constats utiles et négativement pour ceux qui sont hors sujet, avec une courte explication : par exemple, une garantie documentée selon laquelle la valeur suspectée ne peut pas être nulle. Limitez l’exception au code où elle s’applique. Réduisez les déclenchements automatiques si des pushes fréquents relancent sans cesse la revue avant que le changement soit prêt.
Un détail essentiel sur le périmètre des données : ignorePatterns exclut des fichiers de la revue de PR, mais pas de l’indexation du dépôt. Éviter les commentaires sur un fichier généré et empêcher l’éditeur d’accéder à un répertoire confidentiel répondent à deux besoins différents.
GitHub, GitLab et conservation des données
Greptile prend en charge la revue sur GitHub et GitLab hébergés. GitHub Enterprise Server et GitLab Self-Managed figurent parmi les fonctionnalités Enterprise sur la page tarifaire ; ne supposez pas qu’un siège Pro standard couvre ces déploiements.
Sa page de sécurité indique que le code source chiffré reste en cache jusqu’à la révocation de l’accès dans GitHub ou GitLab, puis est supprimé. Greptile stocke aussi des embeddings de chemins, de documentation et de docstrings générées. La durée du cache dépend donc de l’accès, plutôt que d’une expiration fixe de sept jours. La journalisation des chats peut être désactivée. La politique autorise l’entraînement et l’amélioration à partir de données clients désidentifiées, avec une option au niveau du compte pour refuser les entraînements ultérieurs. Politique de sécurité et de données.
Un administrateur peut demander la suppression des données clients : le délai annoncé de suppression définitive en production est de 24 heures, et les sauvegardes sont détruites sous 30 jours, sauf prolongation liée à une enquête sur un incident. Consignez le choix concernant l’entraînement et la procédure de suppression pendant l’essai. Dire que les données sont chiffrées ne répond pas à la question de leur durée de stockage.
- Les filtres d’importance et les catégories de commentaires offrent des réglages concrets pour réduire le bruit.
- Les réglages par répertoire peuvent convenir à plusieurs équipes dans un monorepo.
- Les retours permettent de préciser pourquoi une suggestion s’applique ou non.
- Un plafond de flex usage explicite permet de contrôler les dépenses supplémentaires de revue.
- Les crédits inclus appartiennent à chaque auteur et ne couvrent pas les pics d’un autre.
- Un effort plus élevé et des réexécutions fréquentes peuvent augmenter sensiblement la facture mensuelle.
- Exclure un chemin de la revue n’empêche pas son indexation.
- Le cache du code source et les préférences d’entraînement doivent être examinés explicitement avant l’achat.
Pour départager ces bots, consultez Greptile vs CodeRabbit. Si aucun ne convient, les alternatives à CodeRabbit présentent davantage de candidats ; vérifiez de la même façon leurs prix actuels et le périmètre des données accessibles.
L’outil de revue de l’éditeur : Cursor Bugbot
Cursor Bugbot : quand la revue et les corrections passent déjà par Cursor
Cursor Bugbot est l’outil de revue IA de Cursor pour les pull requests et les changements avant le push. Choisissez-le si l’équipe utilise déjà Cursor et veut reprendre facilement un constat dans son workflow de correction. C’est aussi un bot connecté aux PR : « l’outil de revue de l’éditeur » décrit son écosystème produit, sans limiter les revues à l’IDE.
Verdict : Bugbot mérite de figurer dans la sélection d’une équipe qui utilise Cursor. Budgétez toutefois l’usage, plutôt que d’ajouter à chaque développeur un ancien siège Bugbot autonome à $40.
Pour qui : Les équipes Cursor qui relient revue de branche, retours de PR et corrections assistées par agent.
Point fort : La revue Bugbot avant le push peut reconnaître ensuite le même diff et éviter de répéter la revue à distance.
Tarifs : Bugbot est facturé à l’usage ; les abonnements Cursor et les dépenses de revue sont des postes budgétaires distincts.
Essai gratuit : Aucun essai Bugbot distinct n’est promis actuellement dans la documentation citée.
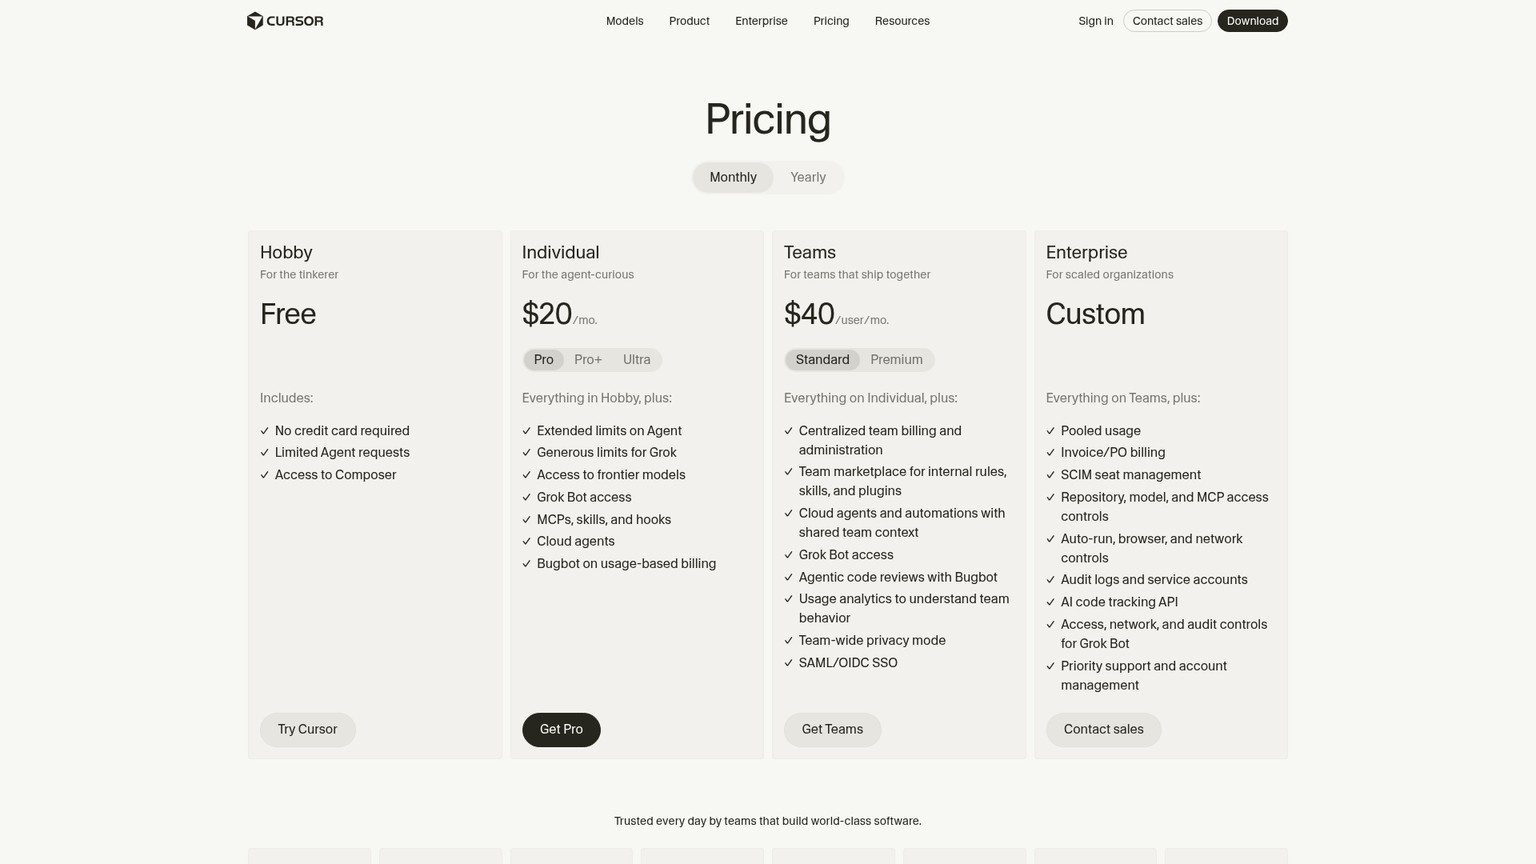
Les offres et leur coût pour cinq développeurs
Les offres américaines de Cursor comprennent Hobby gratuit, Pro à $20 par mois, Pro Plus à $60 et Ultra à $200. Cinq abonnements individuels coûtent $100, $300 ou $1,000 par mois. Teams propose des sièges Standard à $40 par utilisateur et par mois, et Premium à $120, soit des bases de $200 et $600 pour cinq sièges. Enterprise est sur devis. L’offre Start, réservée à l’Inde, coûte ₹649 par mois taxes comprises et exclut Bugbot : ce n’est donc pas une offre de revue moins chère dans ce comparatif. Documentation des offres actuelles.
Bugbot est passé à une facturation à l’usage pour Teams et les abonnements individuels. Teams utilise des dépenses à la demande ; les abonnements individuels consomment d’abord leur usage inclus avant toute dépense supplémentaire. La moyenne publiée par Cursor est de $1.00 à $1.50 par exécution Bugbot, selon la taille et la complexité. Cette moyenne aide à établir un budget ; ce n’est ni un tarif fixe ni une promesse pour votre prochaine PR. Les clients existants quittent l’ancienne facturation par siège lors de leur premier renouvellement après le 8 juin 2026 ; un contrat annuel non encore renouvelé peut donc afficher un ancien montant par siège. Changement de facturation.
Hobby ne garantit pas un service Bugbot automatique gratuit pour une équipe privée de cinq personnes. Les quotas individuels inclus servent aussi à d’autres usages : un abonnement Pro ne doit donc pas être présenté comme la garantie d’un nombre fixe de revues gratuites.
Faux positifs : comment ajuster les retours
Bugbot a besoin de ses propres instructions de revue. Placez les consignes du projet dans .cursor/BUGBOT.md, avec des fichiers à portée limitée pour certains répertoires. Les règles ordinaires de l’éditeur Cursor dans .cursor/rules/*.mdc ne s’appliquent pas à Bugbot. Les règles d’équipe et de dépôt fournissent des consignes supplémentaires ; la sortie détaillée de la revue indique lesquelles ont été incluses. Documentation Bugbot.
Utilisez .cursor/config/bugbot.yaml pour les réglages du dépôt, notamment l’effort et les déclenchements. Bugbot lit ce fichier sur la branche par défaut : une PR ne peut donc pas changer sa propre politique de revue en modifiant sa copie. Cela permet de garder la politique stable pendant que la branche examinée évolue.
Commencez par la revue incrémentale, activée par défaut, et préférez un déclenchement manuel si les mises à jour rapides créent davantage de discussions que l’équipe ne peut en traiter. Les niveaux d’effort Low, Default, High et Smart influent sur le travail et l’usage ; Smart peut suivre des consignes sur les changements qui méritent un examen plus poussé. Un effort plus élevé n’est pas un remède au bruit dont l’efficacité aurait été mesurée.
Bugbot utilise la discussion existante de la PR comme contexte. Gardez dans le fil une explication humaine des compromis acceptés et recherchez d’abord les instructions manquantes avant de supposer que le modèle les a ignorées. La commande avant push /review-bugbot peut reconnaître un patch identique sur la forge connectée et éviter une nouvelle revue à distance. C’est un moyen utile de réduire les revues en double.
GitHub, GitLab et conservation des données
GitHub, y compris Enterprise Server, et GitLab, y compris Self-Hosted, font partie des plateformes documentées. La revue seule et Autofix ont des exigences opérationnelles différentes : Autofix consomme des crédits Cloud Agent et nécessite l’activation du stockage. Intégrez cette activité supplémentaire au budget si l’équipe compte l’activer.
Bugbot suit la politique de traitement de Cursor. En Privacy Mode, Cursor n’entraîne pas ses modèles sur les données clients et maintient avec ses fournisseurs des accords de non-conservation des données, avec des exceptions annoncées pour les enquêtes sur les abus et les modèles non-ZDR explicitement identifiés ou activés par un administrateur. Il existe aussi des caches temporaires de fichiers chiffrés. Désactiver Privacy Mode peut autoriser le stockage et l’entraînement. Utilisation des données par Cursor.
Ces contrôles ne doivent pas devenir une promesse selon laquelle « rien n’est jamais stocké ». Les commentaires de PR et les règles de revue apprises sont des traces du workflow, et les pages citées ne donnent pas une durée de suppression unique pour tous les artefacts Bugbot. Vérifiez le réglage de confidentialité imposé à l’équipe et les éventuelles exceptions liées aux modèles choisis.
- Les constats rejoignent un workflow que l’équipe Cursor utilise déjà pour corriger le code.
- La revue avant le push peut éviter une seconde revue à distance du même patch.
- La configuration sur la branche par défaut contribue à stabiliser la politique de revue.
- GitHub et GitLab sont pris en charge pour les revues.
- La facturation à l’usage fait dépendre le coût de l’activité de revue et de l’effort.
- Les règles existantes de l’IDE ne deviennent pas automatiquement des instructions Bugbot.
- Autofix ajoute des besoins de crédits et de stockage.
Agents de développement : la revue avec Codex et Claude Code
Codex : réutiliser l’agent, puis décider d’automatiser
La revue de code avec Codex est le workflow de revue de l’agent de développement d’OpenAI, disponible en local et sur des dépôts connectés. Choisissez-le si l’équipe utilise déjà Codex et veut un examen supplémentaire des changements avant leur validation humaine. Ses intégrations cloud permettent aussi une revue automatique, au-delà d’une commande que les développeurs doivent penser à lancer.
Verdict : Commencez par l’accès Codex que vous payez déjà. Pour un nouvel espace de travail professionnel, cinq sièges Business mensuels démarrent à $125 ; évaluez séparément la capacité de revue et les crédits supplémentaires.
Pour qui : Les équipes qui adoptent Codex pour développer et relire le code, notamment celles qui veulent des contrôles partagés au niveau de l’espace de travail.
Point fort : Les instructions du dépôt dans AGENTS.md guident la revue, et une revue GitLab native est désormais documentée en bêta.
Tarifs : Plus $20 par mois ; Pro $100, $200 ou $500 ; Business $25/utilisateur/mois ou $20 avec facturation annuelle ; Enterprise et Edu sur devis.
Essai gratuit : Aucun essai de revue distinct ni tarif fixe par PR annoncé.
Les offres et leur coût pour cinq développeurs
ChatGPT Free coûte $0 et Go $8 par mois, avec un accès local léger à Codex selon le déploiement. La page tarifaire mentionne explicitement les intégrations cloud, dont la revue automatique, dans Plus à $20. Pro propose des niveaux mensuels à $100, $200 et $500. Business coûte $25 par utilisateur avec facturation mensuelle, ou un équivalent de $20 par utilisateur et par mois en facturation annuelle, avec un minimum de deux utilisateurs. Enterprise et Edu nécessitent un devis. Tarifs Codex.
Cinq abonnements Plus coûtent $100 par mois. Cinq abonnements Pro identiques coûtent $500, $1,000 ou $2,500. Cinq sièges Business coûtent $125 en facturation mensuelle, ou un équivalent mensuel de $100 avec un engagement annuel de $1,200. Un abonnement grand public peu coûteux et un espace de travail professionnel administré de manière centralisée correspondent à des achats différents, même si les deux permettent des revues de code.
L’usage avec une clé API constitue une autre voie pour la CLI, le SDK ou l’IDE, avec facturation par tokens. Il ne comprend pas les fonctionnalités cloud comme la revue de code GitHub hébergée. N’achetez pas des crédits API en pensant activer le même service de revue connecté.
Faux positifs : comment ajuster les retours
Sur GitHub, le comportement documenté par défaut signale les problèmes P0 et P1, c’est-à-dire les constats urgents et de priorité élevée. Il privilégie volontairement les retours qui ont des conséquences réelles. Ajoutez une section Code Review Rules aux fichiers AGENTS.md applicables et précisez ce qui constitue un défaut significatif dans le chemin concerné. Codex lit les instructions pertinentes pour les fichiers modifiés. Documentation de la revue GitHub.
Les règles utiles décrivent des faits : un endpoint est réservé à un usage interne ; une migration doit prendre en charge les anciens et les nouveaux lecteurs ; un champ nullable est protégé par un appelant précis. Demandez à l’outil de montrer comment une ligne modifiée enfreint ce fait. De longues consignes pour trouver « tous les problèmes possibles » encouragent des hypothèses que la petite équipe devra ensuite réfuter.
Une revue locale ou manuelle est utile avant le push : l’auteur peut examiner les preuves sans lancer un échange de commentaires public. Pour les changements importants, demandez une nouvelle revue centrée sur le diff et les éléments du dépôt. Un agent qui a écrit l’implémentation peut reprendre la même hypothèse erronée dans son explication ; conservez donc la validation humaine et des tests ciblés dans le processus.
GitHub, GitLab et conservation des données
GitHub permet de demander une revue avec @codex review ou de configurer des revues automatiques au niveau du dépôt. La revue de code GitLab native est en bêta et disponible sur toutes les offres ChatGPT, selon la documentation GitLab actuelle. Elle exige un environnement de projet et l’activation de la transmission des événements ; les installations auto-hébergées et Dedicated demandent aussi une configuration administrateur et une identité de revue. Les revues GitLab manuelles peuvent inclure des constats P0, P1 et P2 ; les revues automatiques se limitent par défaut à P0 et P1. Documentation de la revue GitLab.
Considérez cette bêta comme un déploiement à valider sur votre propre instance GitLab. La « prise en charge de GitLab » ne dispense pas de configurer la connexion, les permissions et les hooks, et n’implique pas que toutes les fonctionnalités distinctes de Codex Security disposent de la même intégration.
Pour la conservation, Codex authentifié par ChatGPT suit les politiques de données de l’espace de travail, tandis que l’authentification par API suit les réglages de partage et de conservation de l’organisation API. Business indique que les données professionnelles ne servent pas à l’entraînement par défaut ; Enterprise comprend des contrôles de conservation et de résidence des données. Les pages citées ne publient pas un nombre de jours universel couvrant tous les artefacts des revues cloud Codex. Différence entre authentification et politiques de données.
Demandez au responsable de l’espace de travail la règle réelle pour les tâches cloud et l’historique des revues. Ne reprenez pas une déclaration de conservation de l’API pour valider un outil de revue cloud authentifié par ChatGPT.
- Un abonnement Codex existant peut servir au développement et à la revue.
- Les instructions applicables du dépôt transmettent les hypothèses du projet à l’outil de revue.
- La revue GitHub automatique et la bêta GitLab native offrent des voies hébergées.
- Business fournit un espace de travail partagé plutôt que des comptes grand public séparés.
- La capacité incluse est partagée avec les autres tâches Codex.
- Une clé API n’active pas le service connecté de revue GitHub.
- La bêta GitLab et la configuration auto-hébergée nécessitent une validation sur l’installation de l’équipe.
- Aucune durée publique unique ne décrit la conservation de tous les artefacts des revues cloud.
Claude Code : la revue locale et la revue gérée des PR sont deux achats distincts
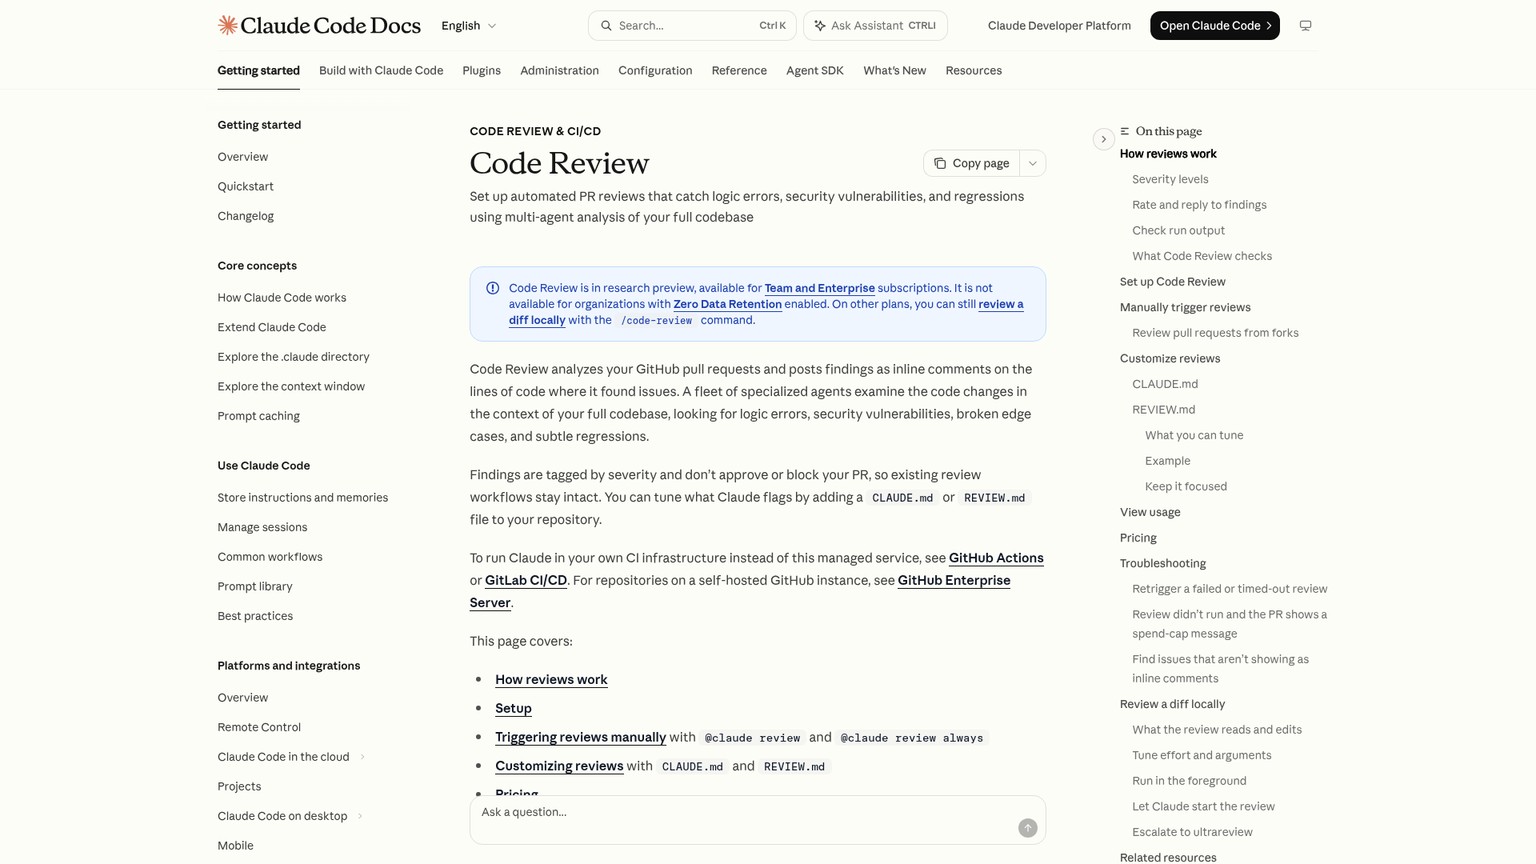
Claude Code est l’agent de développement d’Anthropic. Il dispose d’une commande de revue locale et d’un service géré Code Review distinct. Choisissez la commande locale si votre équipe travaille déjà dans Claude Code et peut demander une revue avant d’ouvrir la PR. Envisagez le service géré pour certains changements GitHub aux conséquences importantes, si une vérification automatique facturée séparément entre dans votre budget.
Verdict : Pour cinq développeurs, réutilisez d’abord la revue locale avec Claude Code. La revue gérée à chaque push courant représente une dépense nouvelle importante, même si l’équipe possède déjà des sièges éligibles.
Pour qui : Les équipes Claude Code qui relisent une branche avant de la transmettre à un humain.
Point fort : La revue locale utilise un contexte séparé ; le service géré dispose d’instructions réservées à la revue et d’une vérification.
Tarifs : Pro $20 par mois en local ; Team Standard $25/utilisateur/mois ; la revue gérée coûte en moyenne $15 à $25 par exécution, facturés séparément.
Essai gratuit : Aucun essai distinct du service géré n’est promis ; ce service est proposé en version expérimentale aux organisations Team et Enterprise éligibles.
Les offres et leur coût pour cinq développeurs
Claude Free coûte $0, mais ne correspond pas à l’abonnement payant Claude Code. Pro coûte $20 par mois, ou $200 payés d’avance pour un an. La page affiche un tarif annuel de $17 par mois, un montant arrondi. Cinq abonnements Pro coûtent donc $100 par mois, ou $1,000 par an, soit un coût mensuel effectif d’environ $83.33. Tarifs Claude en ligne.
Max 5x coûte $100 par mois et Max 20x $200, soit $500 ou $1,000 par mois pour cinq sièges identiques. Ces niveaux définissent l’usage de l’abonnement, pas un nombre fixe de revues. Tarifs Max.
Team Standard coûte $25 par siège et par mois, ou $20 en facturation annuelle : $125 par mois pour cinq personnes, ou un équivalent mensuel de $100 avec l’engagement annuel. Premium coûte $125 par mois ou un équivalent annuel de $100 par siège : $625 par mois pour cinq, ou un équivalent mensuel de $500 en facturation annuelle. Les engagements annuels respectifs sont de $1,200 et $6,000. Enterprise affiche un équivalent de $20 par siège et par mois, facturé annuellement, plus un usage aux tarifs API ; le calcul pour cinq sièges donne un équivalent de $100 avant usage, sous réserve d’éligibilité contractuelle. Education est tarifé par établissement et l’accès API à l’usage : aucun des deux ne propose donc un prix fixe général pour cinq développeurs.
Le service géré est disponible en version expérimentale pour Team et Enterprise, et n’est pas accessible aux organisations dont l’option de non-conservation des données est activée. Sa facture de tokens est distincte de l’usage inclus dans l’offre. Anthropic annonce une moyenne de $15 à $25 par revue, selon le changement, le code et le travail de vérification. Tarifs et éligibilité de la revue gérée.
Les déclenchements manuels du service géré sont raisonnables pour une petite équipe qui réserve un examen supplémentaire aux changements de paiement, d’authentification ou à une migration difficile. Examiner chaque push multiplie les dépenses. Fixez le plafond mensuel du service Code Review et expliquez clairement à l’équipe ce qui se passe lorsqu’il est atteint.
Faux positifs : comment ajuster les retours
La commande locale /code-review exécute en arrière-plan un outil de revue doté de son propre contexte, qui peut cibler un diff, une branche ou une PR. Les niveaux d’effort plus faibles privilégient moins de constats, avec une confiance plus élevée ; une revue plus large peut aussi proposer du nettoyage. Demandez la condition d’échec et distinguez le nettoyage facultatif des problèmes de fonctionnement qui bloquent la validation.
La distinction entre fichiers d’instructions est essentielle. La revue locale lit CLAUDE.md, pas REVIEW.md. Le service géré Code Review utilise CLAUDE.md pour le contexte du projet et REVIEW.md pour le comportement propre à la revue. Une revue locale n’hérite donc pas automatiquement de la politique de revue soigneusement écrite pour le service géré.
Pour la revue gérée, utilisez REVIEW.md afin de définir la gravité, d’écarter les catégories déjà contrôlées par la CI, d’ignorer les fichiers générés et d’exiger des éléments du code source pour les affirmations de comportement. Précisez comment faire converger les revues successives : une fois le problème substantiel corrigé, de nouvelles suggestions cosmétiques ne devraient pas prolonger indéfiniment la même PR. Une politique de revue courte, centrée sur vos risques réels, est plus facile à maintenir qu’un manuel général de développement.
Le service géré ne valide pas la PR et ne bloque pas sa fusion du seul fait qu’il trouve des problèmes. Une équipe qui veut faire des constats une condition de fusion doit définir explicitement le workflow qui les relie à cette décision. L’auteur doit pouvoir contester un constat avec des preuves, plutôt que de voir chaque annotation du bot devenir un veto.
GitHub, GitLab et conservation des données
Le service géré Code Review est destiné aux PR GitHub. La revue locale peut examiner des changements GitLab et, avec un client récent compatible et glab, publier les constats dans une note de merge request. Claude peut aussi fonctionner dans votre propre CI/CD GitLab. Ces voies locales ou opérées par votre équipe ne doivent pas être présentées comme un bot GitLab géré équivalent.
La conservation varie selon le compte et les préférences de données. Les données des offres grand public Pro et Max sont conservées cinq ans lorsque l’amélioration des modèles est autorisée, ou 30 jours lorsqu’elle ne l’est pas. Les usages commerciaux Team, Enterprise et API annoncent une durée standard de 30 jours. La non-conservation des données pour les comptes Enterprise éligibles doit être activée séparément ; elle n’est pas automatique avec un siège Enterprise, et le service géré Code Review ne la prend pas en charge. Utilisation des données de Claude Code.
Les transcriptions de la CLI locale sont aussi stockées en clair dans ~/.claude/projects/, avec un délai de nettoyage par défaut de 30 jours qui peut être modifié. Les sessions Desktop ou Cowork poursuivies dans la CLI ont des exceptions distinctes par défaut. L’envoi de transcriptions via /feedback, /bug ou /share crée une voie de conservation distincte de cinq ans. La règle de l’équipe doit couvrir les fichiers locaux et les envois au support, autant que le stockage chez le fournisseur.
- Un accès payant Claude Code existant peut servir à relire le code avant l’ouverture de la PR.
- Un contexte de revue séparé donne à l’auteur un nouvel examen du diff.
- Les instructions propres à la revue gérée peuvent exiger des preuves et limiter le bruit des revues successives.
- Les workflows locaux et opérés par l’équipe offrent une voie pour GitLab.
- Le coût variable par exécution du service géré s’ajoute aux sièges éligibles.
- Les revues locales et gérées utilisent des fichiers d’instructions différents.
- La revue gérée est centrée sur GitHub et indisponible avec la non-conservation des données.
- Les préférences grand public, les transcriptions locales et les envois de feedback ont des durées de conservation différentes.
Analyse de sécurité : Codex Security
Codex Security : pour analyser les menaces, pas pour multiplier les commentaires généraux
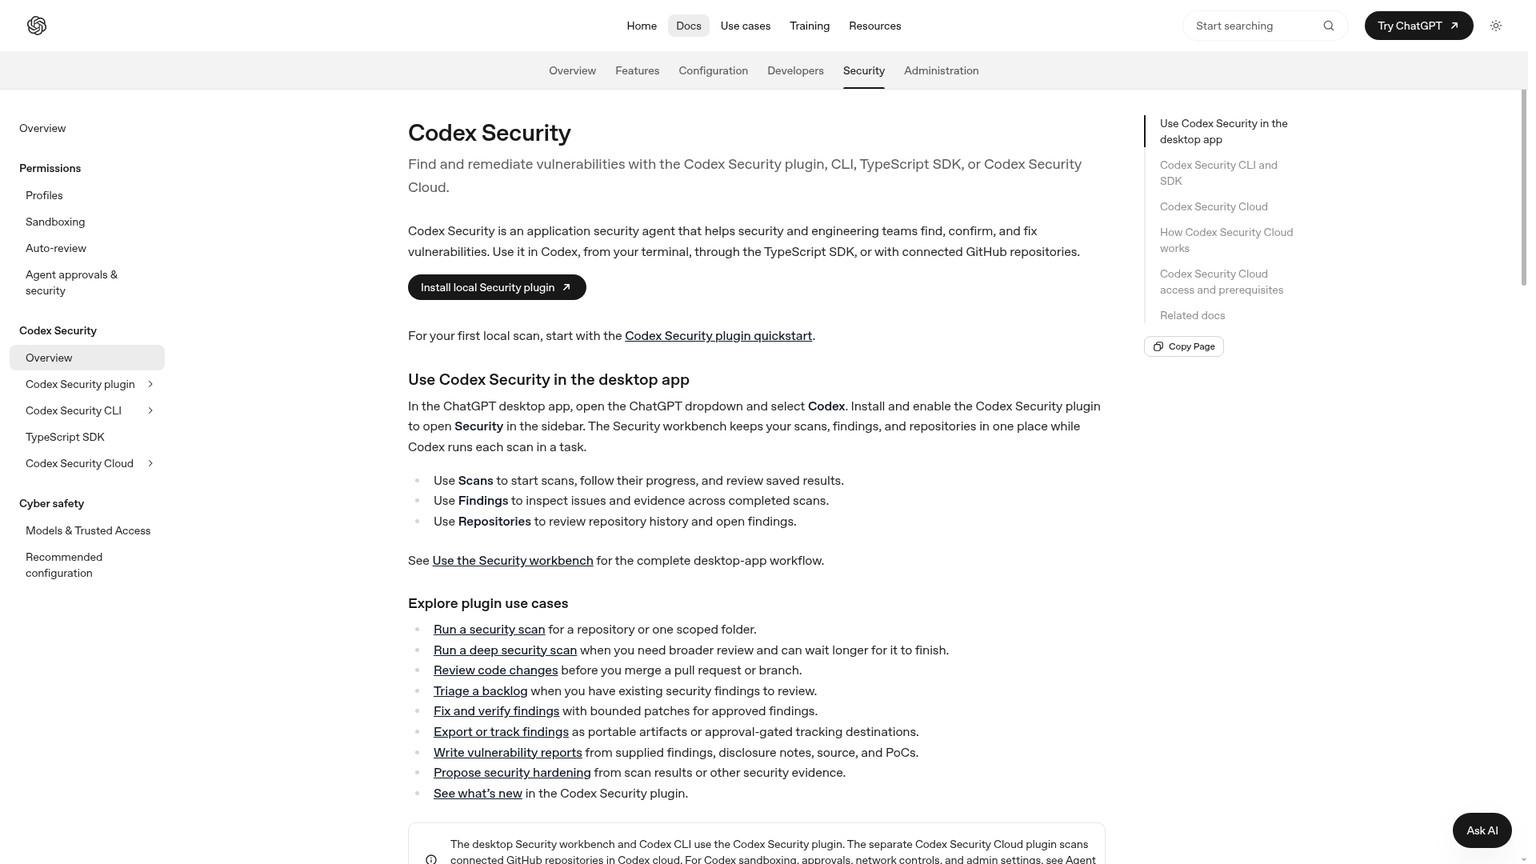
Codex Security est l’agent de sécurité applicative d’OpenAI, qui examine les vulnérabilités en s’appuyant sur le dépôt et le modèle de menace. Choisissez-le si l’équipe doit établir qu’un attaquant peut atteindre et exploiter un chemin suspect. Il complète l’outil de revue du bon fonctionnement et les contrôles déterministes déjà présents dans la CI.
Verdict : Utilisez Codex Security pour la question de sécurité, avec un accès documenté et des seuils de signalement définis. L’absence de commentaires dans une revue générale ne prouve pas que l’application est sûre.
Pour qui : Les petites équipes qui modifient l’authentification, les autorisations, les entrées non fiables ou d’autres frontières de sécurité.
Point fort : L’analyse tient compte du modèle de menace et tente de valider les vulnérabilités, avec des seuils de signalement distincts pour les revues automatiques et manuelles.
Tarifs : Security Review est disponible sur Pro, Business, Enterprise et Edu ; il consomme le quota Codex inclus ou des crédits ChatGPT.
Essai gratuit : Aucun essai distinct garanti. L’éligibilité et l’accès Security de l’espace de travail doivent être vérifiés.
Les offres et leur coût pour cinq développeurs
Aucun abonnement Codex Security autonome à prix fixe par siège n’est publié pour être multiplié par cinq. Security Review n’est pas disponible sur Plus. Les bases Pro éligibles restent à $100, $200 ou $500 par mois, soit $500, $1,000 ou $2,500 pour cinq sièges. Business coûte $25 par utilisateur et par mois ou un équivalent annuel de $20 : $125 ou $100 pour cinq. Enterprise et Edu sont sur devis. La base achète l’offre éligible ; l’accès Security et la consommation de crédits restent à vérifier. Éligibilité à Security Review.
Faux positifs : comment ajuster les retours
Rédigez un modèle de menace qui précise les actifs, les frontières de confiance, les capacités de l’attaquant et les hypothèses de sécurité. L’examen d’un endpoint public sans authentification devrait aboutir à une conclusion différente de celui d’une fonction d’administration à accès restreint. Laisser ce contexte implicite rend les alertes spéculatives plus difficiles à trancher.
Security Review automatique signale par défaut les constats High et Critical ; les demandes manuelles incluent Medium, High et Critical. Les niveaux minimaux peuvent être réglés séparément, avec des exceptions par chemin. Le seuil détermine les constats publiés sur GitHub, tandis que le rapport complet reste dans Codex. Filtrer les commentaires est donc différent de supprimer le rapport sous-jacent.
Les analyses de sécurité peuvent tenter de valider les vulnérabilités. Un constat non validé n’est pas automatiquement un faux positif : l’environnement ou la tentative de reproduction peuvent être incomplets. Demandez le point d’entrée, les conditions nécessaires à l’exploitation et les preuves avant de choisir de corriger, d’écarter ou d’approfondir. La FAQ Security explique le workflow d’analyse et de validation.
La CLI propose une commande pour marquer un faux positif avec un identifiant d’occurrence et une raison, ainsi qu’un échec de CI selon la gravité et un plafond de coût estimé. Utilisez la raison pour consigner la condition qui protège réellement le code. Un plafond estimé aide à contrôler le travail, mais ne doit pas être présenté comme une limite de facture garantie. Référence de la CLI.
GitHub, GitLab et conservation des données
Le service hébergé Security Review documente des déclenchements GitHub, notamment @codex security review, à l’ouverture d’une PR, à chaque push ou en parallèle de la revue générale. La CLI locale peut fonctionner dans GitLab CI/CD et produire du SARIF, un format standard de constats de sécurité lisible par machine. C’est une voie de sécurité GitLab documentée ; elle n’établit pas l’existence d’un bot Security GitLab natif hébergé équivalent à la bêta Codex générale.
Les analyses cloud utilisent des conteneurs de dépôt temporaires et isolés, détruits après extraction des résultats. Les rapports et les artefacts extraits existent toujours. Appliquez la politique de conservation de l’espace de travail, plutôt que de qualifier tout le service de non-conservation au seul motif que le conteneur d’exécution est éphémère.
La CLI conserve aussi par défaut les résultats d’analyse dans $CODEX_HOME/state/plugins/codex-security/scans/, dont une base locale de travail. Votre équipe contrôle la suppression de ces fichiers et des artefacts de CI qu’elle publie. Un rapport de vulnérabilité peut révéler des chemins sensibles du code même après la disparition du clone du dépôt.
- Le contexte du modèle de menace concentre l’analyse sur les risques de sécurité accessibles à un attaquant.
- La validation peut apporter davantage de preuves qu’un commentaire de code spéculatif.
- Des seuils de signalement séparés réduisent les interruptions automatiques pour des problèmes peu graves.
- La CLI et GitLab CI/CD permettent un workflow de sécurité opéré par l’équipe.
- Plus n’inclut pas Security Review, et les offres éligibles exigent tout de même l’accès.
- Le service ne remplace pas la revue courante du bon fonctionnement ni les contrôles de sécurité déterministes.
- La prise en charge de GitLab CI implique une configuration différente d’un bot de revue natif hébergé.
- Une exécution éphémère laisse des rapports et des artefacts locaux ou de CI dont la conservation doit être gérée.
Une PR réelle examinée par trois bots
Un changement public de cache négatif montre pourquoi il faut interpréter les commentaires qui se recoupent et les revues de suivi. La PR #224 de jdx/mise-versions, fusionnée le 6 juin 2026, a ajouté un cache pour les requêtes de releases GitHub en échec. Un cache négatif mémorise temporairement une erreur pour éviter que des requêtes répétées ne sollicitent à nouveau le service amont.
CodeRabbit, Greptile et Cursor Bugbot ont tous publié des commentaires de revue sur cette PR. L’historique comprend les revues initiales et celles de commits révisés. Il montre concrètement ce que les produits ont signalé, mais ne constitue pas une expérience où les trois auraient reçu un commit identique figé et les mêmes réglages.
CodeRabbit a repéré le problème de conservation de l’erreur. Si la requête GitHub échoue et que la tentative de stockage de cet échec lève aussi une exception, celle du cache peut remplacer l’erreur d’origine utile. Un appelant qui attend une erreur du service amont, comme une release absente, peut alors traiter l’échec de manière incorrecte. Le commentaire du bot ciblait un problème précis, plutôt que de demander un refactoring général.
Greptile a repéré la portée de la limite de débit. Un 403 peut signifier qu’un seul token a atteint sa limite. Le mettre en cache comme un échec de la ressource demandée empêche la rotation des tokens, même si un autre pourrait réussir. Dans cette implémentation, cela pouvait créer une fenêtre d’échec de cinq minutes. Greptile a aussi demandé des tests d’expiration et de durées de vie propres aux erreurs. Cette demande concerne la couverture de tests ; elle ne constitue pas un autre bug d’exécution établi indépendamment.
Bugbot a repéré un état obsolète, puis un cas limite. Son premier avertissement sur le cache concernait la conservation d’un résultat négatif après une récupération réussie qui aurait dû l’effacer. Il a aussi signalé le problème du 403 lié à la limite de débit, déjà relevé par Greptile. Après la première correction, un commentaire Bugbot ultérieur a pointé une réponse de limitation de débit secondaire, identifiée par Retry-After, que le classificateur révisé ne reconnaissait toujours pas.
Le premier patch de suivi protège l’erreur d’origine d’un échec d’écriture du cache, efface le cache négatif après un succès, évite de mettre en cache négatif les limites de débit reconnues et ajoute les tests pertinents. Le patch suivant prend en charge la classification de la limite de débit Retry-After et la teste. Ces modifications de code examinées étayent l’utilité pratique des commentaires.
Benchmark de revue de code IA : que prouve cette PR ?
Cette PR permet une comparaison constat par constat, pas un classement des éditeurs. CodeRabbit a apporté un constat sur la gestion des erreurs ; Greptile et Bugbot se sont recoupés sur un problème de limite de débit ; la revue Bugbot ultérieure a examiné une implémentation modifiée et trouvé un autre cas limite. Compter les commentaires exagérerait le nombre de bugs distincts et ignorerait les différences entre les versions examinées.
Le fil ne contient pas un ensemble de tous les constats vrais et faux étiquetés par des humains. Il ne permet donc pas d’établir le taux de faux positifs ni le rappel de chaque outil. Les corrections qui suivent les commentaires sont des preuves utiles, mais elles ne révèlent pas tous les défauts manqués. Pour un CTO, la leçon est d’examiner les constats exploitables, leurs recoupements et le comportement des revues successives, puis de mener un pilote comparable sur les changements de son équipe.
Quel outil choisir selon votre équipe ?
Choisissez d’abord l’endroit où votre équipe peut assurer les revues régulièrement, puis calculez le coût de la charge à cet endroit. Gardez une sélection initiale assez courte pour que l’équipe puisse classer les constats, au lieu de simplement installer des intégrations.
Quelle revue de code IA pour GitHub ?
Choisissez CodeRabbit Essentials si votre besoin immédiat est un outil dédié de revue automatique pour les PR privées courantes et que ses limites conviennent à votre charge. À $150 par mois pour cinq développeurs, il offre un budget de base clair et des réglages directs.
Choisissez Greptile si les règles propres au dépôt et les contrôles par répertoire justifient à vos yeux la gestion des crédits par auteur. Commencez avec un niveau d’effort connu et un plafond de flex usage. Comparez ses constats à ceux de CodeRabbit sur des changements représentatifs ; la PR publique ne tranche pas cet achat pour votre code.
Choisissez Bugbot si Cursor est déjà votre workflow de développement et que l’équipe apprécie le passage entre revue avant le push, discussion de PR et corrections. Évaluez la facture de revue supplémentaire si les sièges existent déjà, et le total abonnement plus usage dans le cas contraire.
Quelle revue de code IA pour GitLab ?
CodeRabbit et Greptile proposent une revue GitLab directe ; vérifiez leurs offres pour vos besoins d’auto-hébergement. Bugbot documente aussi la prise en charge de GitLab et Self-Hosted. Pour installer un bot classique, commencez par ces intégrations natives.
Codex documente désormais une revue GitLab native en bêta, y compris pour les installations auto-hébergées. Essayez-la sur la forge et avec le modèle de permissions réellement utilisés par votre équipe. La revue locale de Claude Code et la CI opérée par l’équipe sont des options GitLab valables, mais votre workflow doit les exécuter. De même, la voie GitLab CI documentée pour Codex Security est une intégration de sécurité à opérer vous-même, plutôt que la promesse d’un bot Security GitLab hébergé.
Quel outil de revue IA si vous payez déjà un agent ?
Commencez par Codex ou Claude Code en local si l’auteur peut demander systématiquement une revue avant de transmettre son changement. Vous disposez déjà d’un accès à l’agent de développement ; il faut déterminer si sa consommation supplémentaire et ses constats sont utiles. Placez les bonnes consignes dans les fichiers que cette voie lit réellement.
Le choix bascule vers un outil automatique de revue des PR lorsque le déclenchement manuel est peu fiable ou que les relecteurs ont besoin d’une discussion partagée durable pour chaque changement. Un abonnement légèrement moins cher ne compense pas les revues que l’équipe oublie de lancer. À l’inverse, un second service automatique est difficile à justifier si la voie actuelle détecte régulièrement des défauts exploitables sans ajouter une nouvelle file de commentaires.
Utilisez la revue gérée de Claude de manière sélective lorsque le changement justifie cette dépense de vérification supplémentaire. Ajoutez Codex Security pour les frontières de sécurité et l’analyse, avec un accès explicite et une gestion définie des rapports. Aucun de ces achats ne devrait reposer sur un classement universel des modèles.
Quels outils gratuits de revue de code IA ?
Greptile Starter est une véritable porte d’entrée gratuite pour un développeur actif, pas pour cinq. Les synthèses de PR privées de CodeRabbit Free ne sont pas le produit complet de revue privée, même si ses quotas open source et locaux peuvent être utiles. L’accès léger à Codex sur Free et Go ne doit pas être supposé équivalent au quota GitHub automatique de Plus ; l’éligibilité documentée à la bêta GitLab est une indication distincte. Claude Free ne constitue pas un siège Claude Code gratuit.
Pour une équipe privée de cinq personnes, réutilisez d’abord les accès déjà achetés et vérifiez leurs limites réelles. « Installation gratuite » et « revue gratuite de chaque PR privée » sont deux promesses budgétaires différentes.
Faux positifs : fixer les règles de revue avant le pilote
Le bruit d’une revue a plusieurs causes, dont certaines seulement sont des faux positifs. Un faux positif affirme l’existence d’un défaut qui ne se produit pas dans les conditions réelles du programme. Une suggestion cosmétique exacte peut tout de même créer du bruit sans grande valeur. Un doublon répète un travail déjà en discussion. Un doute de sécurité spéculatif peut exiger une analyse avant que l’une ou l’autre étiquette soit justifiée.
Exigez que chaque commentaire de fonctionnement appelant une action identifie le comportement modifié, le chemin qui le rend accessible, son impact et les preuves dans le code source. Un appelant précis ou un test est plus utile qu’une étiquette de gravité affichée avec assurance. Demandez à l’auteur d’expliquer les constats contestés et à un autre développeur de trancher les désaccords importants.
Commencez un pilote avec 20 PR représentatives : c’est une proposition d’échantillon d’évaluation, pas une limite produit. Incluez les changements que l’équipe livre réellement : modifications courantes, migration, gestion des échecs et frontière de sécurité. Pour comparer les bots, conservez le commit, les instructions et les réglages de déclenchement. Classez les constats distincts : utiles, faux, déjà couverts, ou exacts mais trop mineurs ; gardez les doutes non vérifiés à part.
Mesurez le travail réellement demandé à l’équipe : quels constats ont modifié le patch ou ses tests, lesquels ont exigé une clarification et lesquels ont été ignorés. Dédupliquez les mêmes causes racines entre les outils. Dans la PR publique, un outil qui repère le bug de cache lié à la limite de débit et un autre qui le répète apportent une corroboration, pas un défaut indépendant supplémentaire.
Ajustez la source précise du bruit. Le profil CodeRabbit réduit les retours ; strictness et les catégories Greptile réduisent les commentaires publiés ; Bugbot demande ses propres instructions et des déclenchements raisonnables ; Codex exige des règles de revue applicables ; Claude a besoin du fichier adapté à la revue locale ou gérée ; Codex Security demande des hypothèses de menace et des preuves. Augmenter l’effort sans clarifier ces entrées peut ajouter du travail sans améliorer la décision.
Gardez une règle de validation humaine explicite. Un bot silencieux peut avoir filtré des constats, ignoré un chemin, épuisé son quota ou mal compris le changement. L’absence de commentaires ne doit pas être interprétée comme un audit complet.
Comment ces outils ont-ils été sélectionnés ?
Ces six produits couvrent les lieux de revue prévus dans le périmètre de l’article : bots de PR dédiés, outil de l’éditeur de code, agents de développement et analyse centrée sur la sécurité. La sélection privilégie un workflow adoptable par une petite équipe, un coût qu’elle peut modéliser et des réglages pour contester ou réduire les retours hors sujet.
Les prix, noms des offres et fonctionnalités ont été vérifiés sur les pages officielles des éditeurs le 2 octobre 2026. Les totaux pour cinq développeurs et les scénarios de répartition égale des revues sont calculés à partir de ces pages. Les éléments de la PR réelle proviennent de commentaires publics des bots et de diffs de commits de suivi examinés. Les produits ont été comparés à partir de la documentation et de preuves publiques, sans essais privés pour cet article.
Les benchmarks annoncés par les éditeurs n’ont pas déterminé les recommandations. Un résultat mesuré sur un autre corpus ne permet pas d’établir le bruit, le travail d’intégration ou la facture sur votre dépôt. Les preuves les plus solides ici sont plus ciblées : des constats identifiés sur une PR traçable, des réglages actuels et des hypothèses budgétaires explicites.
Un catalogue plus large pourrait inclure d’autres bots et analyseurs statiques, mais les ajouter sans le même niveau de détail rendrait cette décision moins utile. Aucun partenaire affilié actif ne correspond honnêtement à cette sélection d’outils de revue IA ; aucun n’a donc été ajouté comme recommandation rémunérée. Les liens vers les outils suivent le système habituel de liens monétisés du site lorsqu’un programme correspondant existe ; la disponibilité commerciale n’a pas déterminé le verdict.
Les choix à éviter
Évitez CodeRabbit Free comme outil obligatoire de revue du bon fonctionnement du code privé. Une synthèse ne fournit pas la revue payante que vous cherchez à acheter. Lancez l’essai payant et évaluez les constats.
Évitez d’acheter Greptile en pensant payer « $30 pour des revues illimitées ». L’effort, les réexécutions et les quotas non mutualisés par auteur modifient le coût. Fixez une limite de flex usage avant de généraliser l’automatisation.
Évitez de budgéter un nouvel achat Bugbot avec l’ancien prix du siège autonome. La facturation actuelle à l’usage, l’abonnement Cursor de l’équipe et l’éventuelle activité Autofix sont les paramètres pertinents.
Évitez la revue gérée de Claude à chaque push courant si la facture d’usage supplémentaire ne convient pas à l’équipe. La revue locale correspond à une autre décision d’achat ; réservez le service géré aux changements dont le risque justifie le coût estimé.
Évitez Codex Security pour remplacer la revue générale. Il répond à une question de sécurité et exige un accès éligible. Il ne peut pas décider si une fonctionnalité répond à l’exigence produit ou si une migration opérationnelle est acceptable.
Évitez toute configuration où l’approbation d’un bot devient l’unique décision de fusion. Conservez la CI, la revue humaine et la possibilité de contester un constat, en lien avec le risque réel de la mise en production.
Questions fréquentes
Existe-t-il des outils IA pour la revue de code ?
Oui. CodeRabbit et Greptile examinent les PR connectées, Cursor Bugbot relie la revue au workflow Cursor, et Codex comme Claude Code peuvent relire le code en tant qu’agents de développement. Codex Security ajoute une voie plus ciblée d’analyse des vulnérabilités. Choisissez d’abord l’endroit où effectuer la revue et la manière de signaler les constats, puis comparez les abonnements.
Quelle IA choisir pour une petite équipe ?
CodeRabbit Essentials est ici le bot dédié recommandé par défaut pour une petite équipe qui veut des retours automatiques sur ses PR courantes : $150 par mois pour cinq développeurs, dans les limites de l’offre. Un workflow Codex ou Claude Code existant est le meilleur point de départ si l’équipe demande déjà ses revues de façon fiable. Le travail de sécurité exige une décision de périmètre distincte.
ChatGPT peut-il faire une revue de code ?
Oui, ChatGPT peut discuter du code fourni, et Codex propose un workflow de développement et de revue tenant compte du dépôt avec un accès éligible. Une réponse de chat fondée sur un extrait collé n’a pas le même contexte qu’une revue Codex connectée. Vérifiez les réglages de données du compte et ne supposez pas que le modèle a examiné des fichiers qu’il n’a jamais reçus.
Quels sont les 5 principaux outils de revue de code ?
Les cinq options de revue générale comparées ici sont CodeRabbit, Greptile, Cursor Bugbot, la revue de code avec Codex et Claude Code. Codex Security est le sixième produit présenté et répond à un besoin de sécurité distinct. Les outils sont regroupés par workflow, plutôt que classés selon un benchmark universel.
La revue de code est-elle devenue obsolète ?
Non. La revue IA peut repérer des défauts et aider l’auteur à préparer un changement, mais l’équipe doit toujours juger l’intention produit, le risque opérationnel et les compromis acceptables. La validation humaine et la CI apportent aussi des preuves que l’absence de commentaires d’un bot ne peut pas fournir.
Quelles différences entre Copilot et CodeRabbit pour la revue de code ?
La revue de code GitHub Copilot fait partie du workflow de l’assistant GitHub. CodeRabbit est un outil de revue dédié, avec des intégrations GitHub et GitLab documentées et sa propre configuration de revue. Les deux ont besoin du bon contexte de dépôt et d’une politique pour contester les constats. La documentation GitHub sur la revue Copilot décrit comment demander et utiliser ses revues.
Pourquoi certaines personnes n’aiment-elles pas Copilot ?
Il n’existe pas de réponse unique et défendable qui explique les préférences de tout le monde. Pour un CTO, il faut évaluer si l’outil manque de contexte sur le dépôt, répète les contrôles existants ou crée des commentaires auxquels l’équipe ne peut pas donner suite. Comparez ces résultats sur vos PR, plutôt que de traiter une plainte ou une affirmation d’éditeur comme un taux de faux positifs mesuré.
Copilot peut-il effectuer une revue de code ?
Oui. GitHub documente la demande de revue Copilot et l’utilisation des retours obtenus. Son existence n’en fait pas le choix automatique pour GitLab ni un substitut à une analyse de sécurité dédiée. Évaluez-le selon le workflow dont votre équipe a réellement besoin.
Existe-t-il une meilleure IA que Copilot ?
Un autre outil peut mieux convenir à une équipe donnée. CodeRabbit ou Greptile peuvent répondre à un besoin de bot de PR dédié, Bugbot à un workflow Cursor, et un agent de développement existant à une revue avant le push. Décidez selon les constats exploitables, le bruit, les forges prises en charge et les dépenses réelles ; aucun benchmark d’éditeur ne tranche ces quatre critères à la fois.
Recevez la checklist de configuration de Claude Code et Codex pour établir votre workflow d’agents de développement avant d’ajouter un autre abonnement de revue.
- Dernière mise à jour
- 2 oct. 2026
- Catégorie
- AI
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
IA mail : quel assistant choisir pour Gmail ou Outlook en 2026 ?
Comparez Fyxer, SaneBox, Superhuman, Shortwave, Gemini et Copilot : tarifs en dollars, fonctions, stockage des mails et critères pour choisir votre assistant.2 oct. 2026AI
Granola AI : les alternatives qui répondent à vos besoins
Comparez les alternatives à Granola AI selon la capture sans bot, le partage en équipe, les intégrations CRM, les langues et les tarifs par utilisateur.1 oct. 2026AI
Gamma gratuit ou payant : quel abonnement choisir en 2026 ?
Gamma gratuit ou payant : comparez Free, Plus, Pro et Ultra, leurs prix en USD, les crédits IA, les exports et le coût d’un abonnement individuel ou d’équipe.1 oct. 2026AI
Wispr Flow pricing : tarifs et budget d’équipe en 2026
Comparez les tarifs de Wispr Flow, les quotas gratuits, le coût pour 1, 5 ou 20 personnes et les alternatives moins chères, avec des prix en USD.1 oct. 2026AI
Analyse réseaux sociaux : utiliser Muse pour sa boutique
Connectez Shopify, Instagram et Facebook à Muse pour préparer un bilan hebdomadaire, vérifier vos sources et garder la main sur chaque action.1 oct. 2026AI
Gemini 4 Argon : le budget à prévoir avant de l’adopter
Gemini 4 Argon : comparez les prix annoncés, les accès prévus et les benchmarks de Google pour décider quand évaluer ce modèle et prévoir votre budget.1 oct. 2026AI
Wispr Flow : avis, prix et limites de la dictée vocale
Wispr Flow : prix vérifiés, retours d’usage, prompts de code et confidentialité. Quand rester sur Free, payer Pro ou choisir Superwhisper pour le hors ligne.1 oct. 2026AI