Gemini 4 Argon : le budget à prévoir avant de l’adopter
Gemini 4 Argon : comparez les prix annoncés, les accès prévus et les benchmarks de Google pour décider quand évaluer ce modèle et prévoir votre budget.




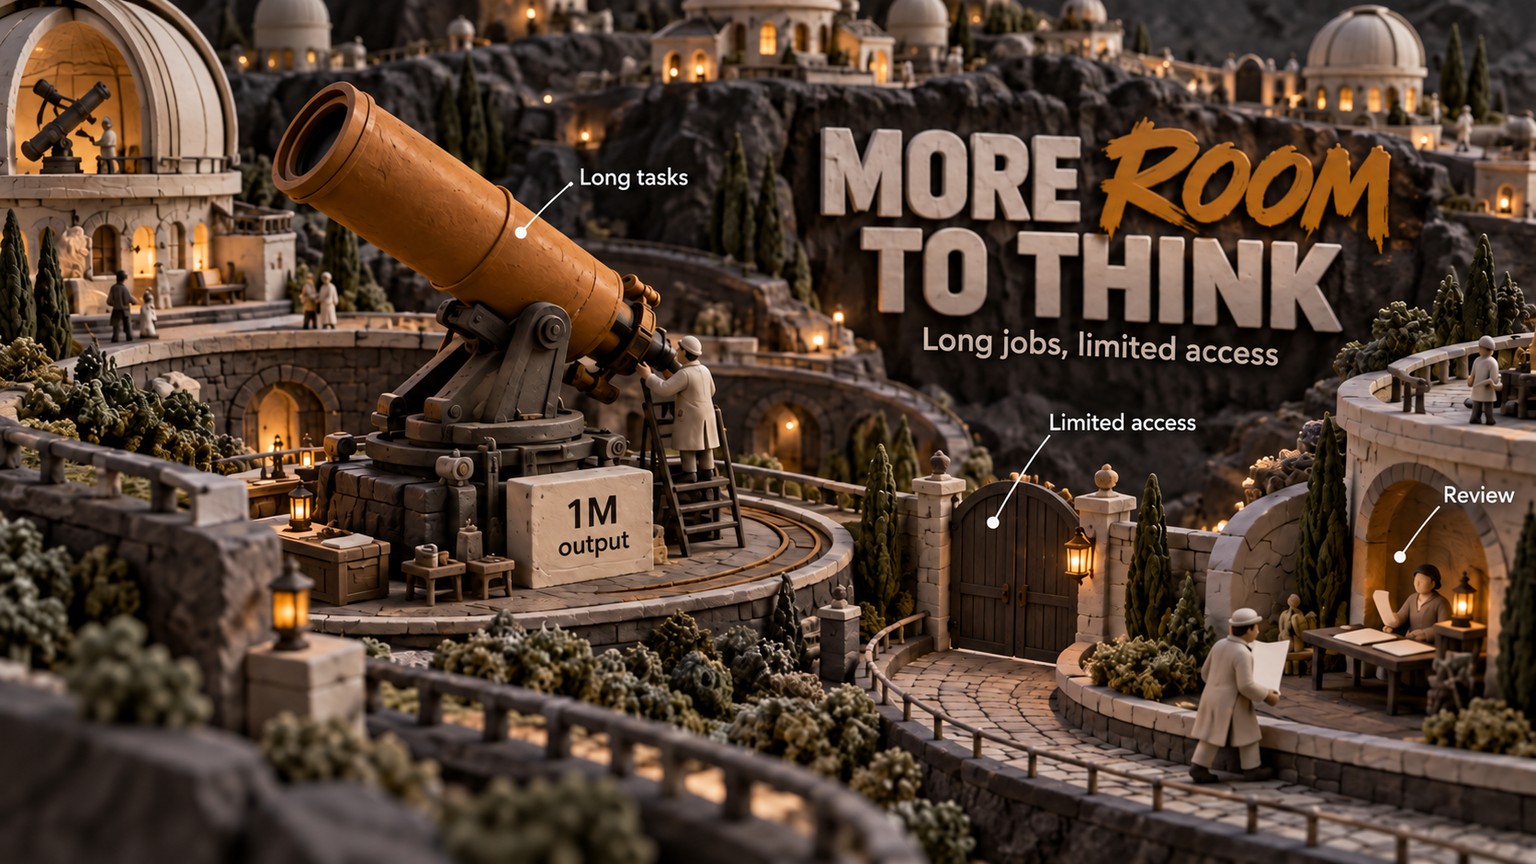
Pour évaluer un passage à Gemini 4 Argon, retenez $4 en entrée et $20 en sortie par million de tokens dans votre budget, même si Google a annoncé un tarif de lancement de $2/$10. Au 1er octobre 2026, l’accès reste restreint : Google n’a fixé de date ni pour l’élargissement du déploiement ni pour la fin du tarif de lancement. L’annonce de Google permet de préparer une évaluation sur des tâches difficiles ; une migration en production exige toutefois un accès confirmé et des résultats sur votre propre charge de travail.
Gemini 4 Argon : quelles tâches faut-il réévaluer ?
Gemini 4 Argon, le nouveau modèle de Google pour les tâches complexes et de longue durée, change d’abord les travaux qui méritent une évaluation, avant de changer votre modèle par défaut en production. Google l’a annoncé le 30 septembre 2026, avec un déploiement restreint à des équipes de cyberdéfense de confiance et à un premier groupe de testeurs de confiance. L’annonce met en avant le raisonnement prolongé, l’ingénierie logicielle, le travail intellectuel en entreprise et la cybersécurité défensive.
En pratique, tout dépend de l’accès. Un modèle peut afficher des tarifs publics et des résultats impressionnants sans que votre organisation puisse l’utiliser. Conservez un fournisseur déjà disponible pour les livrables dont dépend votre trimestre ; inscrivez Argon dans votre plan comme une piste d’évaluation conditionnelle.
Qui peut accéder à Argon aujourd’hui ?
Au 1er octobre 2026, l’annonce de Google cite des acteurs de la cyberdéfense et des testeurs de confiance parmi les premiers utilisateurs. La page Fairwind Program confirme actuellement l’accès à Argon pour un ensemble de partenaires approuvés, et non pour tous les candidats ou tous les clients de Google Cloud.
Fairwind est le programme d’accès anticipé contrôlé de Google pour la cyberdéfense. Google a lancé ce programme le 2 septembre 2026 : cette date concerne le programme, pas le modèle Argon. La priorité va aux gouvernements, aux opérateurs d’infrastructures critiques et aux plateformes technologiques essentielles. Les laboratoires universitaires travaillant sur la cyberdéfense peuvent également candidater.
L’admission passe par une procédure d’approbation. Google examine les candidatures, limite l’accès des employés et interdit aux partenaires de redistribuer l’accès au modèle. Pour un responsable de la sécurité, la première démarche consiste à vérifier que son organisation et les utilisateurs prévus disposent d’un accès approuvé à Argon. Le seul fait d’être un client payant ne suffit pas.
Prochaine étape : clients payants de l’API et abonnés Google AI Ultra
Google désigne les clients payants de l’API et les abonnés Google AI Ultra comme les premiers groupes concernés par le prochain élargissement du déploiement. Son annonce du 30 septembre ne donne aucune date pour cette étape ni pour la disponibilité générale.
Dans cette annonce, l’abonnement Ultra constitue donc une future voie d’accès. Ne le souscrivez pas uniquement en supposant qu’Argon est déjà disponible sur votre compte. La facturation des tokens de l’API et les droits inclus dans un abonnement grand public correspondent à des modalités différentes. L’annonce ne précise pas les quotas d’utilisation d’Argon dans Ultra.
Prix de Gemini 4 Argon : quel tarif retenir pour le budget ?
Le tarif de lancement d’Argon correspond aux tarifs de base de GPT-6.1 Sol et de Claude Sonnet 5.5. Le tarif annoncé pour la suite correspond à celui de Claude Opus 5.5. C’est donc ce second tarif qui sert de comparaison utile pour établir un budget.
Un token est une unité de traitement du texte : vous payez les données envoyées au modèle en entrée et celles qu’il produit en sortie. Le tableau indique des USD par 1M de tokens, aux tarifs catalogue standard des API directes, pour des entrées sans cache. Les prix et les conditions d’accès ont été vérifiés sur les pages de chaque fournisseur le 1er octobre 2026.
OpenAI GPT-6.1 Sol est disponible dans l’API depuis le 29 septembre 2026. Le tarif indiqué de $2/$10 s’applique aux prompts contenant jusqu’à 272K tokens en entrée. Au-delà de ce seuil, OpenAI double les tarifs d’entrée et de cache et multiplie le tarif de sortie par 1.5, pour l’ensemble de la requête. Cette précision compte pour les tâches qui mobilisent beaucoup de données en entrée, même si la réponse est courte. La documentation officielle d’OpenAI précise ce seuil.
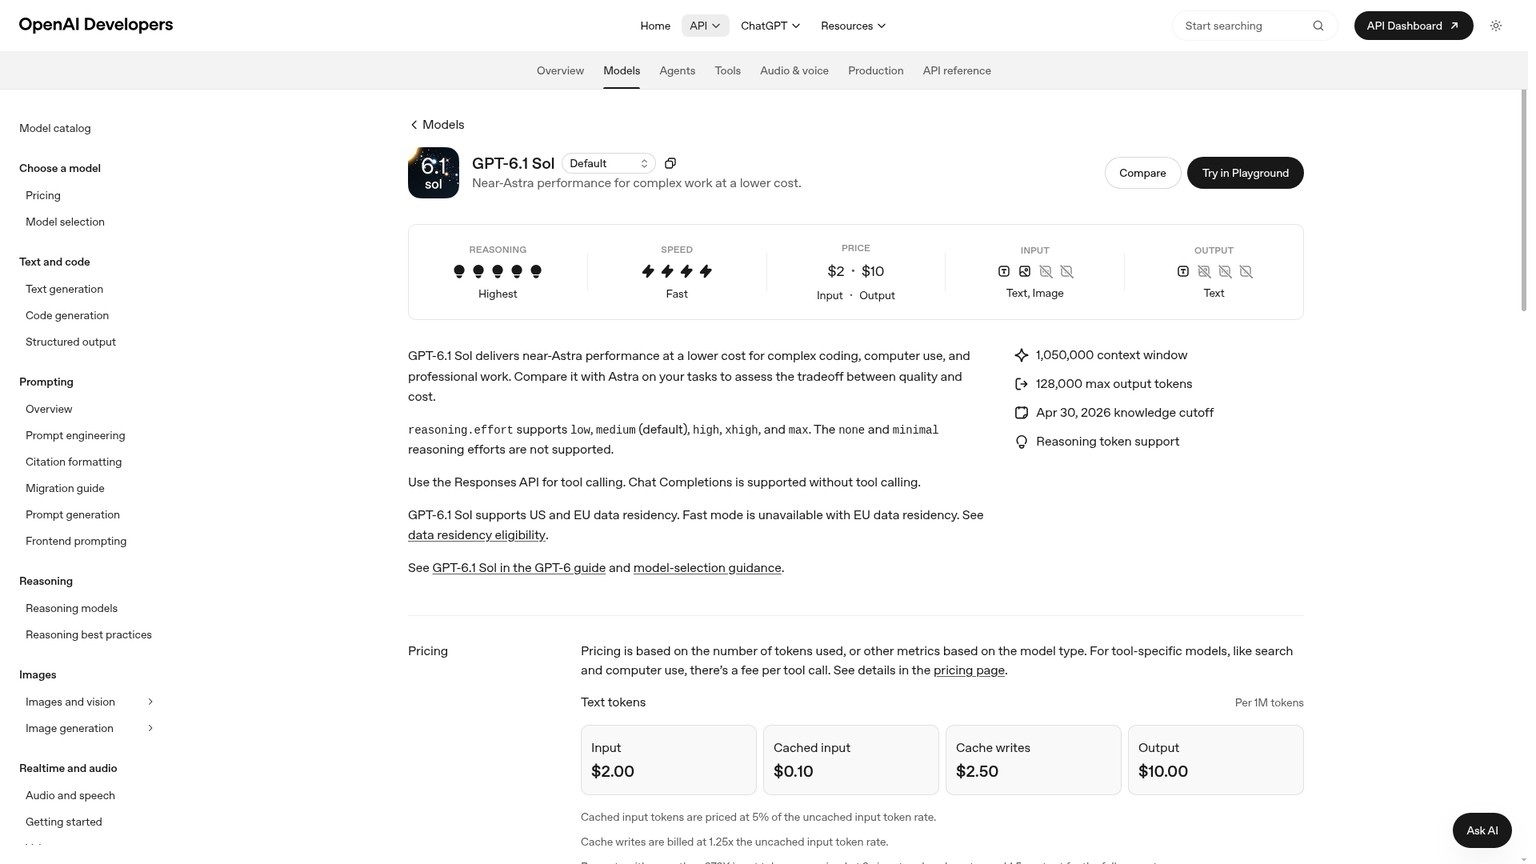
Anthropic Claude Opus 5.5 est actif depuis le 22 septembre 2026. Sa page de documentation mentionne Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry et Claude Platform on AWS. Les acheteurs disposent ainsi d’un candidat accessible au tarif de base prévu pour Argon après sa période de lancement ; cela ne démontre pas des performances équivalentes sur leurs propres tâches.
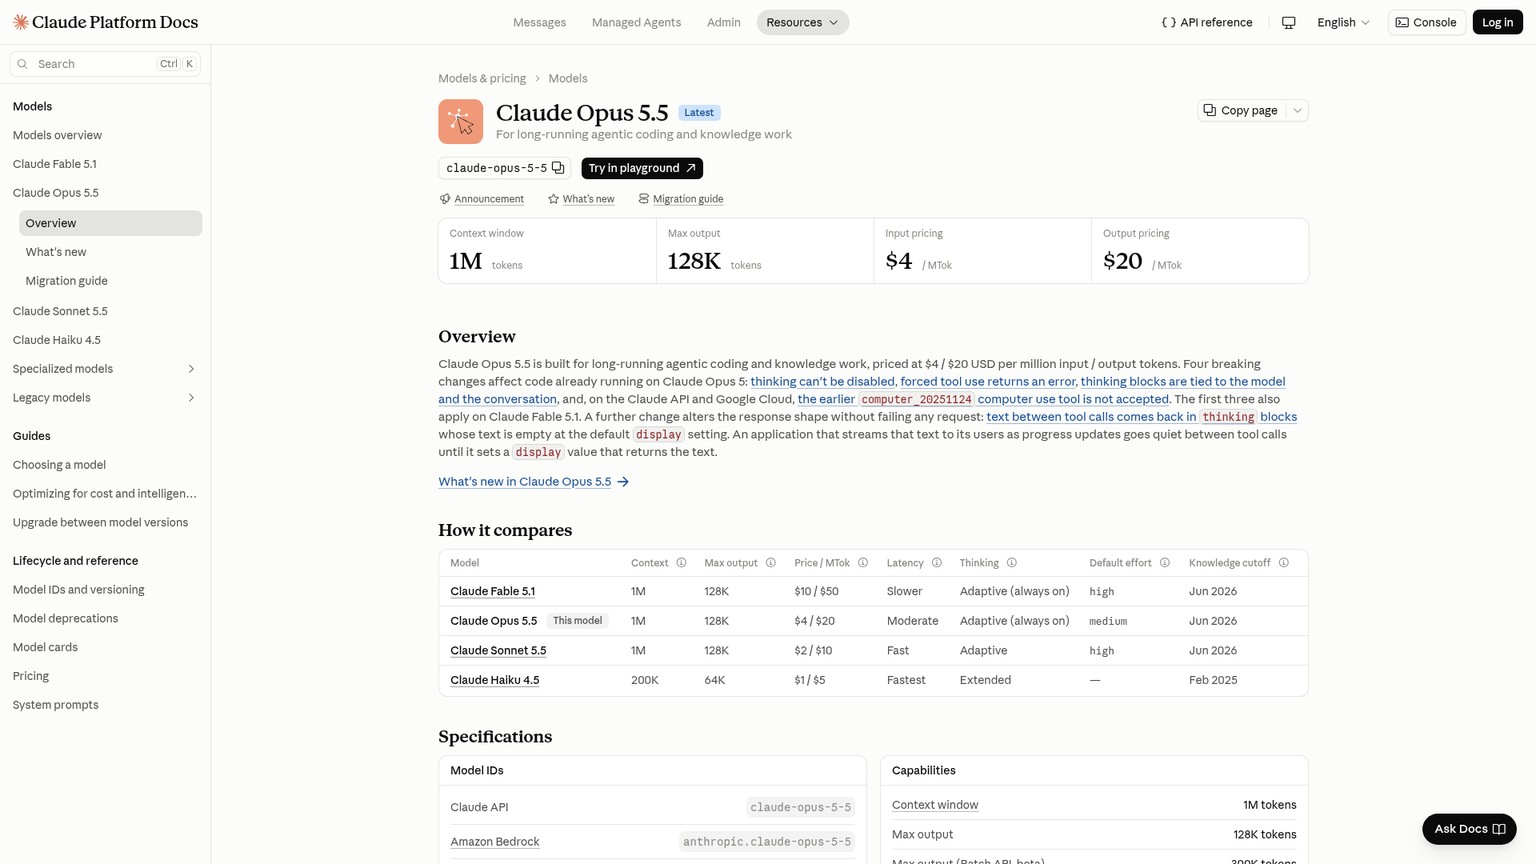
Anthropic Claude Sonnet 5.5 est actif depuis le 28 septembre 2026, avec les mêmes accès par API et plateformes cloud. Sa page de documentation confirme le tarif de base de $2/$10. Il fait partie des références à moindre coût, aux côtés de GPT-6.1 Sol, lorsque l’un ou l’autre peut mener la tâche à bien.
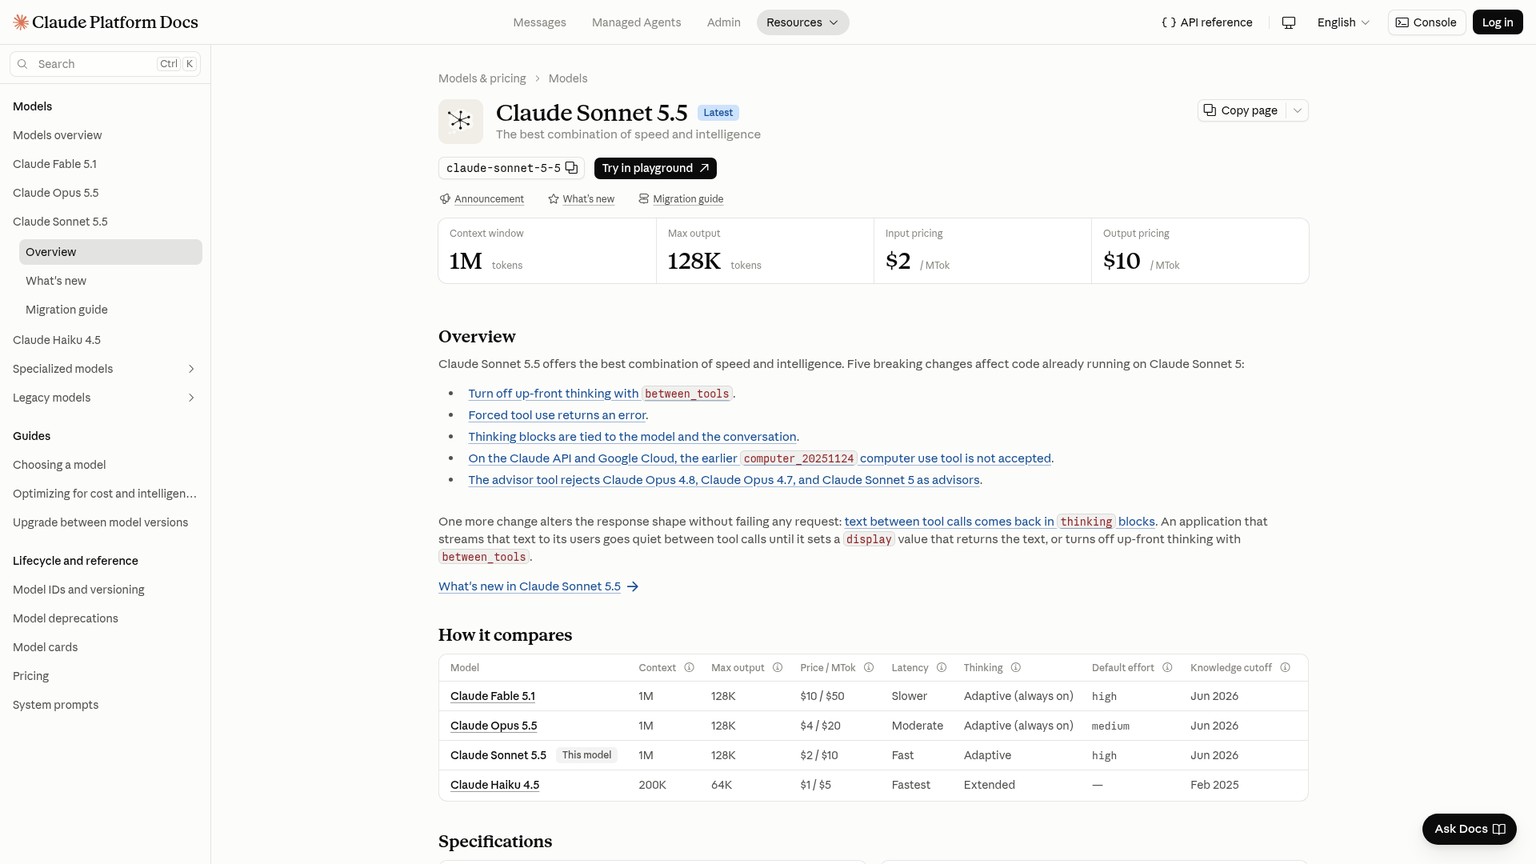
Ces comparaisons portent sur les tarifs. Les différences de tokenisation, la longueur des réponses, les écritures dans le cache, les niveaux de traitement et les frais liés aux outils peuvent modifier la facture. Une disponibilité dans le cloud ne garantit pas non plus des tarifs identiques sur chaque plateforme. Comparez les coûts sur une même tâche, avec les mêmes critères de validation.
Pour choisir une formule plus largement, consultez les tarifs de Gemini. Pour décider d’une évolution vers un modèle OpenAI déjà disponible, lisez GPT-6.1 Sol face à GPT-6 Sol.
À quoi sert la limite de sortie de 1M tokens ?
Le changement de limite concerne surtout la sortie, c’est-à-dire la marge dont dispose le modèle pour raisonner et générer du contenu au fil d’une séquence de travail. Selon Google, le plafond de sortie d’Argon passe de 64K à 1M tokens. Cela représente une capacité nominale environ 15.6 fois supérieure, calculée à partir des chiffres arrondis de Google. Ce chiffre ne prouve ni une fenêtre de contexte d’entrée plus grande ni une exécution plus rapide. La description de cette limite par Google la rattache aux tâches de longue durée.
Le contexte d’entrée correspond à ce que le modèle peut lire en une fois. La capacité de sortie correspond à ce qu’il peut produire. Une immense fenêtre de contexte ne résout pas le problème d’une tâche qui atteint sa limite de sortie pendant la recherche d’une solution ; une immense capacité de sortie ne garantit pas non plus une solution correcte.
Cette marge supplémentaire devient utile lorsqu’une tâche comporte des étapes interdépendantes. Une migration de code peut exiger d’inspecter des fichiers, de modifier des interfaces, de vérifier les tests et de reprendre un patch proposé. Une enquête financière peut demander de rapprocher des documents, de suivre les écarts et de construire une conclusion étayée. Un arrêt prématuré peut laisser inachevée la partie la plus coûteuse du travail.
Google cite les migrations de bases de code, la conception d’algorithmes, la recherche financière en plusieurs étapes, la recherche et la rédaction juridiques, l’analyse de graphiques et la compréhension de vidéos longues. Les tâches à évaluer doivent avoir un critère de fin explicite :
- Pour un développeur indépendant : essayez une migration de dépôt qui aboutit actuellement à un patch incomplet. Évaluez le résultat à partir des tests et de modifications vérifiables, plutôt qu’à la longueur de l’explication.
- Pour le CTO d’une entreprise de taille moyenne : choisissez une tâche de maintenance bien délimitée, avec un responsable et une possibilité de retour arrière. Vérifiez si le modèle réduit les reprises et le travail de revue avant d’envisager une réécriture plus vaste.
- Pour un responsable opérationnel expérimenté : choisissez un dossier de recherche qui exige de rapprocher plusieurs documents et de vérifier des graphiques. Demandez des éléments traçables pour étayer la recommandation finale.
Il s’agit de propositions d’évaluation, pas de résultats issus de tests réalisés pour cet article. Les exemples de migration internes à Google conservent eux aussi des contrôles automatisés et une revue humaine avant la mise en production.
Un fondateur ayant levé des fonds et disposant d’un workflow fiable sur des requêtes courtes a peu de raisons de payer pour une capacité inutilisée. Notre avis sur Gemini examine plus largement l’adéquation du produit aux workflows ; la capacité supplémentaire d’Argon ne compte que si elle lève une contrainte sur une tâche précise.
Budget trimestriel : raisonner en coût par tâche validée
Une charge de travail inchangée, sans cache, coûte deux fois plus après la période de lancement. Les tarifs annoncés doublent à la fois en entrée et en sortie. Google ne donnant aucune date de bascule, une prévision sur un trimestre doit prévoir un scénario au tarif ultérieur, sans supposer la durée de la promotion.
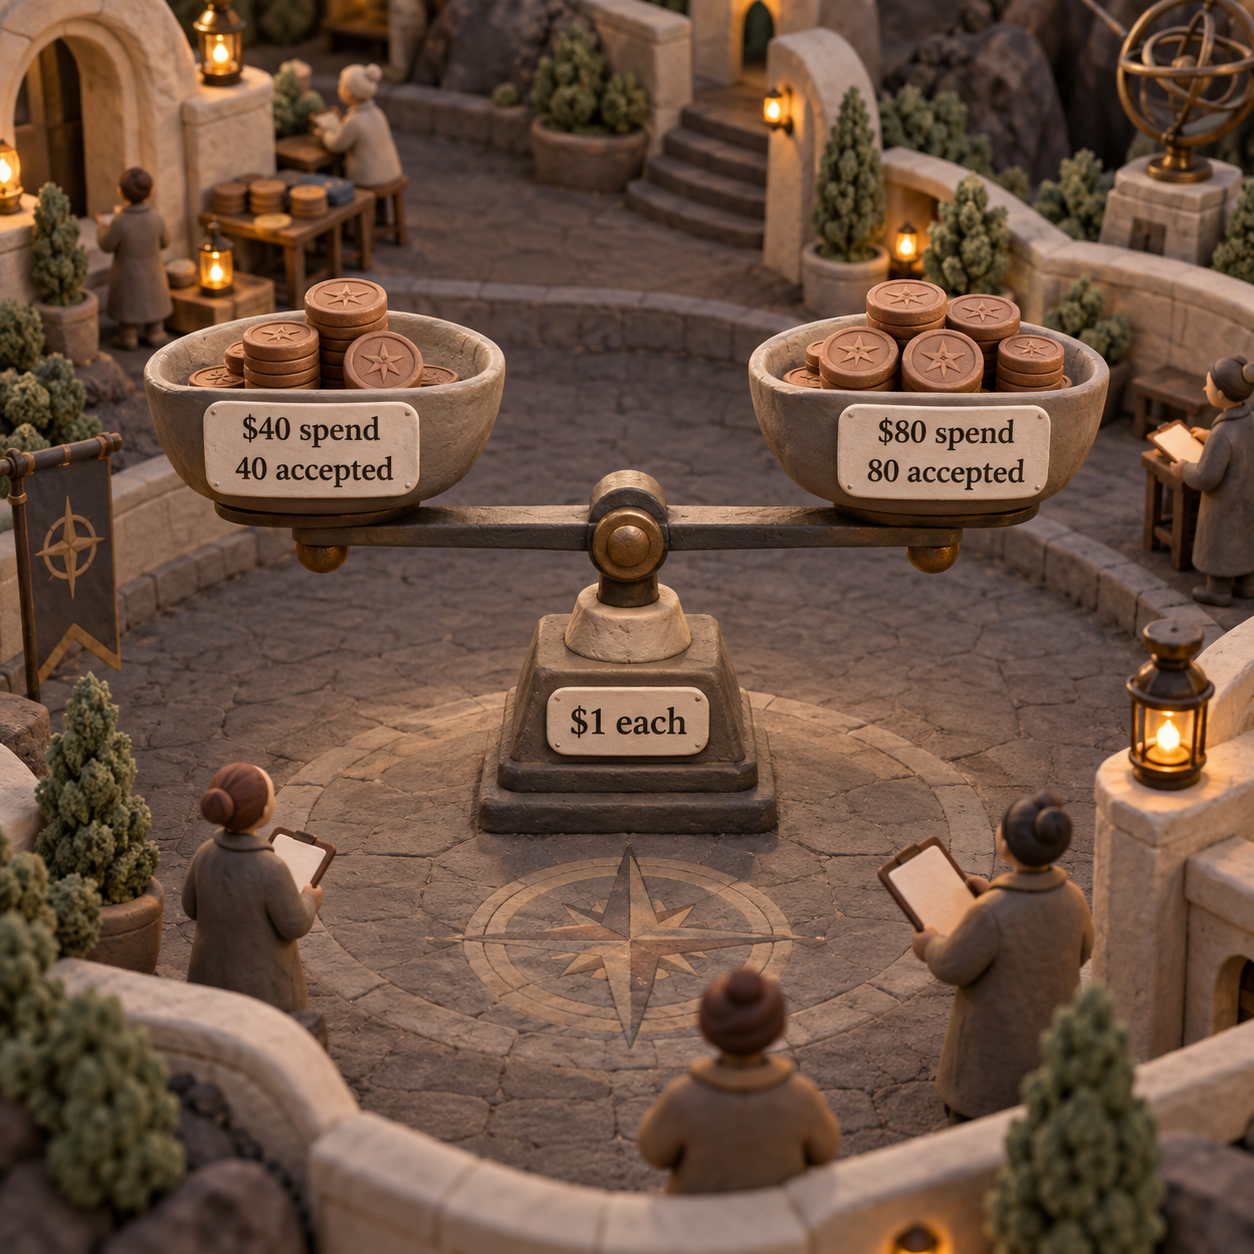
Prenons une charge de travail hypothétique de 100 tâches par mois, chacune consommant 100K tokens en entrée et 20K tokens en sortie. Le total atteint 10M tokens en entrée et 2M tokens en sortie :
- Argon au lancement : 10 × $2 + 2 × $10 = $40 par mois.
- Argon au tarif ultérieur : 10 × $4 + 2 × $20 = $80 par mois.
Si l’accès couvre un trimestre complet de trois mois à ce rythme, les scénarios limités au coût des tokens atteignent $120 si le tarif de lancement s’applique pendant toute la période, ou $240 si le tarif ultérieur s’applique pendant toute la période. Un changement de prix en cours de trimestre donne un montant intermédiaire. Cette fourchette sert à établir un budget, pas à prédire le déploiement.
À quantités facturées identiques, GPT-6.1 Sol et Claude Sonnet 5.5 reviennent également à $40 aux tarifs de base indiqués ; Claude Opus 5.5 revient à $80. L’exemple suppose que chaque requête reste sous le seuil d’entrée du tarif de base de Sol. Il ne suppose pas que tous les modèles découpent le même contenu en un nombre identique de tokens ou consomment autant de tokens en sortie.
Le cache réduit une partie de la facture
Google annonce une réduction de 95% sur le tarif des tokens d’entrée mis en cache, ce qui permet de facturer moins cher les entrées réutilisées. Avec le tarif de lancement de $2, le calcul donne $0.10 par 1M de tokens d’entrée en cache. Ce calcul s’appuie sur les indications tarifaires de Google.
Si 90% des tokens d’entrée de cette charge de travail hypothétique sont retrouvés dans le cache, l’entrée se répartit entre 1M de tokens sans cache et 9M de tokens en cache. À sortie inchangée :
1 × $2 + 9 × $0.10 + 2 × $10 = $22.90 pendant la période de lancement.
Cette illustration se limite aux tarifs des tokens et exclut les autres frais. Une réduction de 95% sur les entrées en cache ne rend pas l’ensemble de la tâche 95% moins cher : la sortie représente encore $20 dans cet exemple. Un dossier de contexte réutilisable sur le dépôt peut réduire le coût d’entrée ; un raisonnement long exige toujours son propre budget de sortie.
La note de bas de page de Google au lancement indique les futurs tarifs de $4/$20 sans dater le changement ni détailler toutes les futures conditions de facturation. Vérifiez à nouveau ces conditions lorsque votre accès sera activé.
Le seuil de rentabilité dépend des résultats validés
Au tarif ultérieur de notre exemple, Argon coûte $0.80 par tentative, contre $0.40 avec un tarif de base de $2/$10. Si le nombre de tokens facturés par tentative reste constant, doubler la proportion de tentatives validées compense le doublement du coût des tokens.
À titre d’illustration, un modèle de référence dont 40% des tentatives sont validées coûte $0.40 ÷ 0.40 = $1 par tâche validée. Un modèle qui obtient 80% de validation à $0.80 coûte lui aussi $1 par tâche validée. Ces taux de validation sont des hypothèses destinées à expliquer le seuil de rentabilité, pas des scores mesurés pour Argon ou un concurrent.
Si votre modèle de référence atteint déjà 60% de validation, il faudrait parvenir à 120% pour effacer ce surcoût par le seul taux de validation, avec les mêmes hypothèses. C’est impossible. La justification économique doit alors reposer sur une consommation de tokens plus faible, moins de revue humaine ou des travaux utiles que votre modèle actuel ne peut pas terminer.
Atteindre le plafond de sortie a aussi un coût. Dans un exemple hypothétique, 1M de tokens de sortie facturés coûterait $10 au lancement ou $20 ensuite, avant l’entrée et les autres frais. Un plafond plus élevé offre une capacité utile ; il faut une raison pour la consommer intégralement.
Quels tests envisager à partir des benchmarks de Google ?
Les chiffres publiés par Google permettent de sélectionner des tâches à évaluer. Ils ne déterminent ni le taux de validation de votre application ni ses économies. Aucun test pratique du modèle n’a été réalisé pour cet article.
Les quatre scores ci-dessous sont les résultats rapportés par Google dans son annonce du 30 septembre.
Ces pourcentages mesurent des choses différentes, dans des conditions d’évaluation différentes. Ne les agrégez pas en une moyenne censée représenter les capacités du modèle et ne remplacez pas votre propre taux de validation du code par le résultat de DeepSWE.
En particulier, la compréhension de vidéos longues ne démontre pas la fiabilité des modifications logicielles. Un résultat en correction de vulnérabilités ne garantit pas les mêmes capacités de cybersécurité ni les mêmes garde-fous pour chaque futur client. Choisissez le benchmark le plus proche de la tâche qui vous bloque, puis vérifiez le résultat avec vos propres contraintes.
Développeurs, responsables opérationnels, acheteurs : que faut-il changer ?
Les développeurs ont intérêt à agir dès maintenant si leur accès approuvé permet d’évaluer une tâche que leur modèle actuel échoue régulièrement à terminer. Commencez par une tâche bien délimitée et comparez les résultats validés, le total des tokens facturés et l’effort de revue. Gardez un fournisseur disponible comme référence.
Les développeurs qui attendent un accès peuvent préparer cette évaluation et continuer à livrer. Pour un développeur indépendant qui produit de petits patchs, ou un fondateur dont le workflow est déjà fiable, le plafond de sortie plus élevé change peu de choses tant qu’une tâche récurrente n’en a pas besoin.
Les responsables opérationnels doivent préparer les contrôles qui rendent un travail long vérifiable. Un CTO qui évalue une migration a besoin d’un périmètre clair, de tests de non-régression et d’une personne responsable de la revue. Un responsable opérationnel expérimenté qui évalue un travail de recherche a besoin d’un corpus de sources et d’un moyen de vérifier la conclusion. Une exécution plus longue augmente la quantité de travail à inspecter.
Les acheteurs doivent réserver le budget au tarif ultérieur et soumettre la migration à des conditions. Il faut un accès approuvé, un résultat terminé et un meilleur coût par résultat validé. Un classement publié ou l’achat d’un abonnement grand public ne remplit pas ces conditions.
Attendez lorsque la tâche se termine déjà de manière fiable à moindre coût, lorsque l’accès n’est pas confirmé ou lorsque vous ne pouvez pas mesurer si le résultat est acceptable.
Les raccourcis qui faussent la décision
Une annonce ne signifie pas un accès pour tous. Google a annoncé Argon, et certains premiers utilisateurs y ont accès. Les groupes suivants sont désignés, mais aucune date de démarrage n’est fixée. Conservez cette distinction dans toute note d’achat.
Un plafond de sortie plus élevé n’est pas un score de fiabilité. Une marge supplémentaire peut permettre au modèle d’aller au bout d’un travail difficile ; elle peut aussi produire davantage de contenu à vérifier. Un travail plus long justifie son coût lorsqu’il améliore un résultat validé.
L’histoire du « Argon checkpoint » sur Arena n’est pas vérifiée pour cette décision. L’annonce de Google ne confirme pas l’identité de ce checkpoint antérieur au lancement. N’intégrez pas des noms de modèles, des spécifications ou des tableaux de benchmarks issus de fuites dans un plan de production. Appuyez-vous sur le modèle nommé et les faits publiés le 30 septembre.
Le tarif de lancement ne suffit pas à démontrer des économies durables. Un dossier économique qui tient à $2/$10 et ne tient plus à $4/$20 dépend d’une promotion dont Google n’a pas donné la date de fin. Calculez les deux scénarios avant de vous engager.
La donnée qui manque vraiment est votre coût par tâche validée au tarif qui s’appliquera à terme. Les résultats publiés par Google donnent une raison de l’évaluer.
Dès lundi : préparer une décision que l’équipe peut mesurer
Confiez la semaine prochaine un protocole d’évaluation concret à un responsable. Il doit aboutir à une décision de changement de modèle que vous pourrez défendre lorsque l’accès sera disponible.
Définir la tâche qui bloque
Choisissez une tâche récurrente : une migration de dépôt inachevée, une correction de vulnérabilité autorisée ou un dossier de recherche mêlant documents et graphiques. Décrivez ce qui constitue un résultat terminé et acceptable.
Mesurer la référence actuelle
Utilisez votre modèle actuellement disponible. Suivez les entrées et sorties facturées, les nouvelles tentatives, la validation et le temps de revue. Gardez la même tâche et les mêmes critères de validation.
Budgéter au tarif ultérieur
Calculez le coût de la charge de travail aux tarifs de $4/$20 annoncés pour Argon. Conservez séparément le scénario de lancement en indiquant que sa date de fin n’est pas fixée. Confirmez l’accès au compte avant de confier à Argon un travail à livrer.
Changer de modèle si le résultat s’améliore
Une fois l’accès obtenu, comparez les travaux terminés et acceptables ainsi que l’effort total. Étendez l’usage lorsque le gain couvre le surcoût des tokens et l’éventuelle revue supplémentaire ; sinon, conservez le modèle de référence.
Les questions fréquentes sur Gemini 4 Argon
Gemini 4 Argon est-il disponible ?
Il a été annoncé le 30 septembre 2026 et son accès anticipé est restreint. Au 1er octobre, les pages de Google citent des acteurs de la cyberdéfense sélectionnés dans Fairwind et des testeurs de confiance ; elles ne confirment pas un accès généralisé à tous les clients payants.
Quand Gemini 4 sera-t-il accessible plus largement ?
Google désigne les clients payants de l’API et les abonnés Google AI Ultra pour le prochain élargissement du déploiement. L’annonce ne donne de date ni pour cette étape ni pour la disponibilité générale.
Quelles sont les restrictions d’utilisation de Gemini ?
Pour Argon accessible via Fairwind, le programme de Google limite l’usage aux finalités défensives et de recherche autorisées, interdit les activités malveillantes et prohibe le partage, la redistribution ou la vente de l’accès. Un accès approuvé ne dispense pas de respecter ces conditions.
Qu’est-ce que Gemini 4 ?
Gemini 4 Argon est le modèle annoncé par Google pour les tâches complexes et de longue durée en ingénierie logicielle, dans le travail intellectuel en entreprise et en cyberdéfense. Sa limite de sortie publiée est de 1M tokens, contre 64K auparavant.
Quelle est la date de sortie de Gemini 4 ?
Google a annoncé Gemini 4 Argon et son déploiement restreint le 30 septembre 2026. Cette date est distincte de celle d’une disponibilité générale par API ou d’une sortie grand public, pour lesquelles Google n’a pas donné de date.
Quels sont les inconvénients de Gemini ?
Pour décider d’adopter Argon, les inconvénients immédiats sont l’accès restreint, le passage à des tarifs de tokens plus élevés à une date inconnue et l’absence de résultats sur votre propre charge de travail. Une grande capacité de sortie augmente aussi la quantité de travail à vérifier.
Combien coûte Gemini par mois ?
Les tarifs annoncés pour l’API d’Argon dépendent de l’usage : $2/$10 par million de tokens en entrée/sortie au lancement, puis $4/$20, sans date de bascule fixée. Google AI Ultra est un abonnement distinct, dont les abonnés figurent parmi les prochains groupes d’accès annoncés. L’annonce ne précise pas les quotas d’utilisation d’Argon dans Ultra.
Quels sont les risques liés à Gemini ?
Pour les workflows longs d’Argon, vérifiez les modifications de code erronées, les conclusions non étayées et les actions non souhaitées des outils. Google décrit des protections contre les utilisations abusives, l’injection de prompt et le désalignement, ainsi que des bacs à sable durcis. Votre organisation reste responsable de vérifier les travaux qu’elle valide.
Gemini vaut-il vraiment le coût ?
Évaluez Argon lorsqu’une tâche longue précise a besoin de sa marge supplémentaire et que le coût par résultat validé, au tarif ultérieur, peut s’améliorer. Gardez votre modèle de production actuel s’il mène déjà la tâche à bien de manière fiable ou si l’accès à Argon n’est pas confirmé.
Pour prendre des décisions concrètes sur les modèles et les workflows à mesure que l’accès évolue, abonnez-vous à la newsletter.
- Dernière mise à jour
- 1 oct. 2026
- Catégorie
- AI
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
Wispr Flow : avis, prix et limites de la dictée vocale
Wispr Flow : prix vérifiés, retours d’usage, prompts de code et confidentialité. Quand rester sur Free, payer Pro ou choisir Superwhisper pour le hors ligne.1 oct. 2026AI
Claude Tag dans Slack : quels accès, quel budget ?
Claude Tag intègre un Claude partagé dans Slack. Accès, facturation à l’usage, plafonds et réponses automatiques : préparez un premier déploiement maîtrisé.30 sept. 2026AI
Agent IA avec GPT-6.1 Sol : configurer Codex et l’API Responses
Configurez un agent IA avec GPT-6.1 Sol dans Codex et l’API Responses : niveau de raisonnement, outils, coûts réels, limites et mise en production.30 sept. 2026AI
GPT-6.1 Sol vs GPT-6 Sol : le comparatif avant de migrer
GPT-6.1 Sol ou GPT-6 Sol ? Comparez le coût du cache, les performances, le raisonnement et les appels d’outils pour décider si la migration vaut le coup.30 sept. 2026AI
Claude Sonnet 5.5 : guide pratique, réglages et cas d’usage
Apprenez à utiliser Claude Sonnet 5.5, à régler son niveau d’effort et à migrer l’API grâce à des workflows fiables, des coûts réels et des garde-fous.28 sept. 2026AI
GLM-5.3-Flash ou Jev : quel modèle de décision IA choisir ?
Jev réduit le coût du routage texte, tandis que GLM-5.3-Flash gère les images. Comparez prix, latence, précision et contraintes avant de choisir.27 sept. 2026AI
Claude Opus 5.5 ou Opus 5 : prix, code et migration
Claude Opus 5.5 coûte moins cher, mais cinq changements d’API compliquent la migration. Comparez les prix, le code, le thinking et les critères de choix.23 sept. 2026AI